Überwachtes und unüberwachtes Lernen in der Computer Vision im Vergleich
Lerne die Unterschiede zwischen überwachtem und unüberwachtem Lernen in der Computer Vision kennen und erfahre, wie du den passenden Ansatz für deine Daten und Projektziele auswählst.
Künstliche Intelligenz (AI) basiert auf der grundlegenden Idee, Maschinen so lernen und schlussfolgern zu lassen, dass es der menschlichen Intelligenz ähnelt. So wie Menschen auf verschiedene Weise lernen, etwa durch direkte Anleitung oder indem sie Muster und Erfahrungen beobachten, sind KI- und Machine-Learning-Systeme darauf ausgelegt, dieselben Ansätze zu verfolgen.
Insbesondere beim maschinellen Lernen werden Systeme darauf trainiert, aus Daten zu lernen, anstatt für jede Aufgabe ausdrücklich programmiert zu werden. Statt sich auf feste Regeln zu stützen, erkennen Machine-Learning-Modelle Muster in Daten und nutzen diese Muster, um Vorhersagen zu treffen oder Entscheidungen zu fällen.
Zum Beispiel ist Computer Vision ein Teilgebiet der KI und des maschinellen Lernens, das sich damit beschäftigt, Systeme in die Lage zu versetzen, visuelle Informationen wie Bilder und Videos zu interpretieren und zu verstehen. Von der Objekterkennung bis zum Aufspüren verborgener Muster in großen Datensätzen hängt viel davon ab, wie diese Systeme trainiert werden.
Je nach verfügbaren Daten und der zu lösenden Aufgabe kommen verschiedene KI-Lernverfahren zum Trainieren dieser Systeme zum Einsatz.
Einige Computer-Vision- Modelle lernen anhand gekennzeichneter Daten, bei denen jede Eingabe einer richtigen Antwort zugeordnet ist. Das bedeutet, dass jedes Bild oder jeder Datenpunkt mit einer vorgegebenen Kennzeichnung versehen ist, die dem Modell mitteilt, was dargestellt wird. So kann das Modell den Zusammenhang zwischen der Eingabe und der erwarteten Ausgabe erlernen und seine Fähigkeit verbessern, genaue Vorhersagen zu neuen, bisher unbekannten Daten zu treffen.
Andere Bildverarbeitungsmodelle lernen anhand nicht gekennzeichneter Daten, für die keine vorgegebenen Antworten bereitgestellt werden, und konzentrieren sich stattdessen darauf, Muster und Zusammenhänge in den Daten selbst zu erkennen. Diese Ansätze werden als überwachtes Lernen beziehungsweise unüberwachtes Lernen bezeichnet und bilden die Grundlage vieler hochmoderner Computer-Vision-Systeme.
In diesem Artikel beschäftigen wir uns mit überwachtem und unüberwachtem Lernen, ihrem Einsatz in Computer Vision und der Auswahl des passenden Ansatzes für dein Vision-KI-Projekt. Los geht's!
Wie Lernverfahren der KI Computer Vision ermöglichen#
Du kannst dir künstliche Intelligenz wie einen Schirm vorstellen, der eine Reihe von Technologien umfasst, mit denen Maschinen Aufgaben ausführen können, für die normalerweise menschliche Intelligenz erforderlich ist. Maschinelles Lernen ist ein wichtiger Bereich innerhalb dieses Schirms und ermöglicht es Systemen, aus Daten zu lernen, statt sich ausschließlich auf feste Regeln zu stützen.
Innerhalb des maschinellen Lernens legen verschiedene Lernverfahren fest, wie ein Modell lernt und sich mit der Zeit verbessert. Ansätze wie überwachtes Lernen (Lernen anhand gekennzeichneter Daten mit richtigen Antworten), unüberwachtes Lernen (Erkennen von Mustern in nicht gekennzeichneten Daten), bestärkendes Lernen (Lernen durch Versuch und Irrtum mithilfe von Rückmeldungen oder Belohnungen) und teilüberwachtes Lernen (Kombination einer kleinen Menge gekennzeichneter Daten mit einer großen Menge nicht gekennzeichneter Daten) bestimmen, wie Systeme Eingabedaten verarbeiten und Ausgabedaten erzeugen.
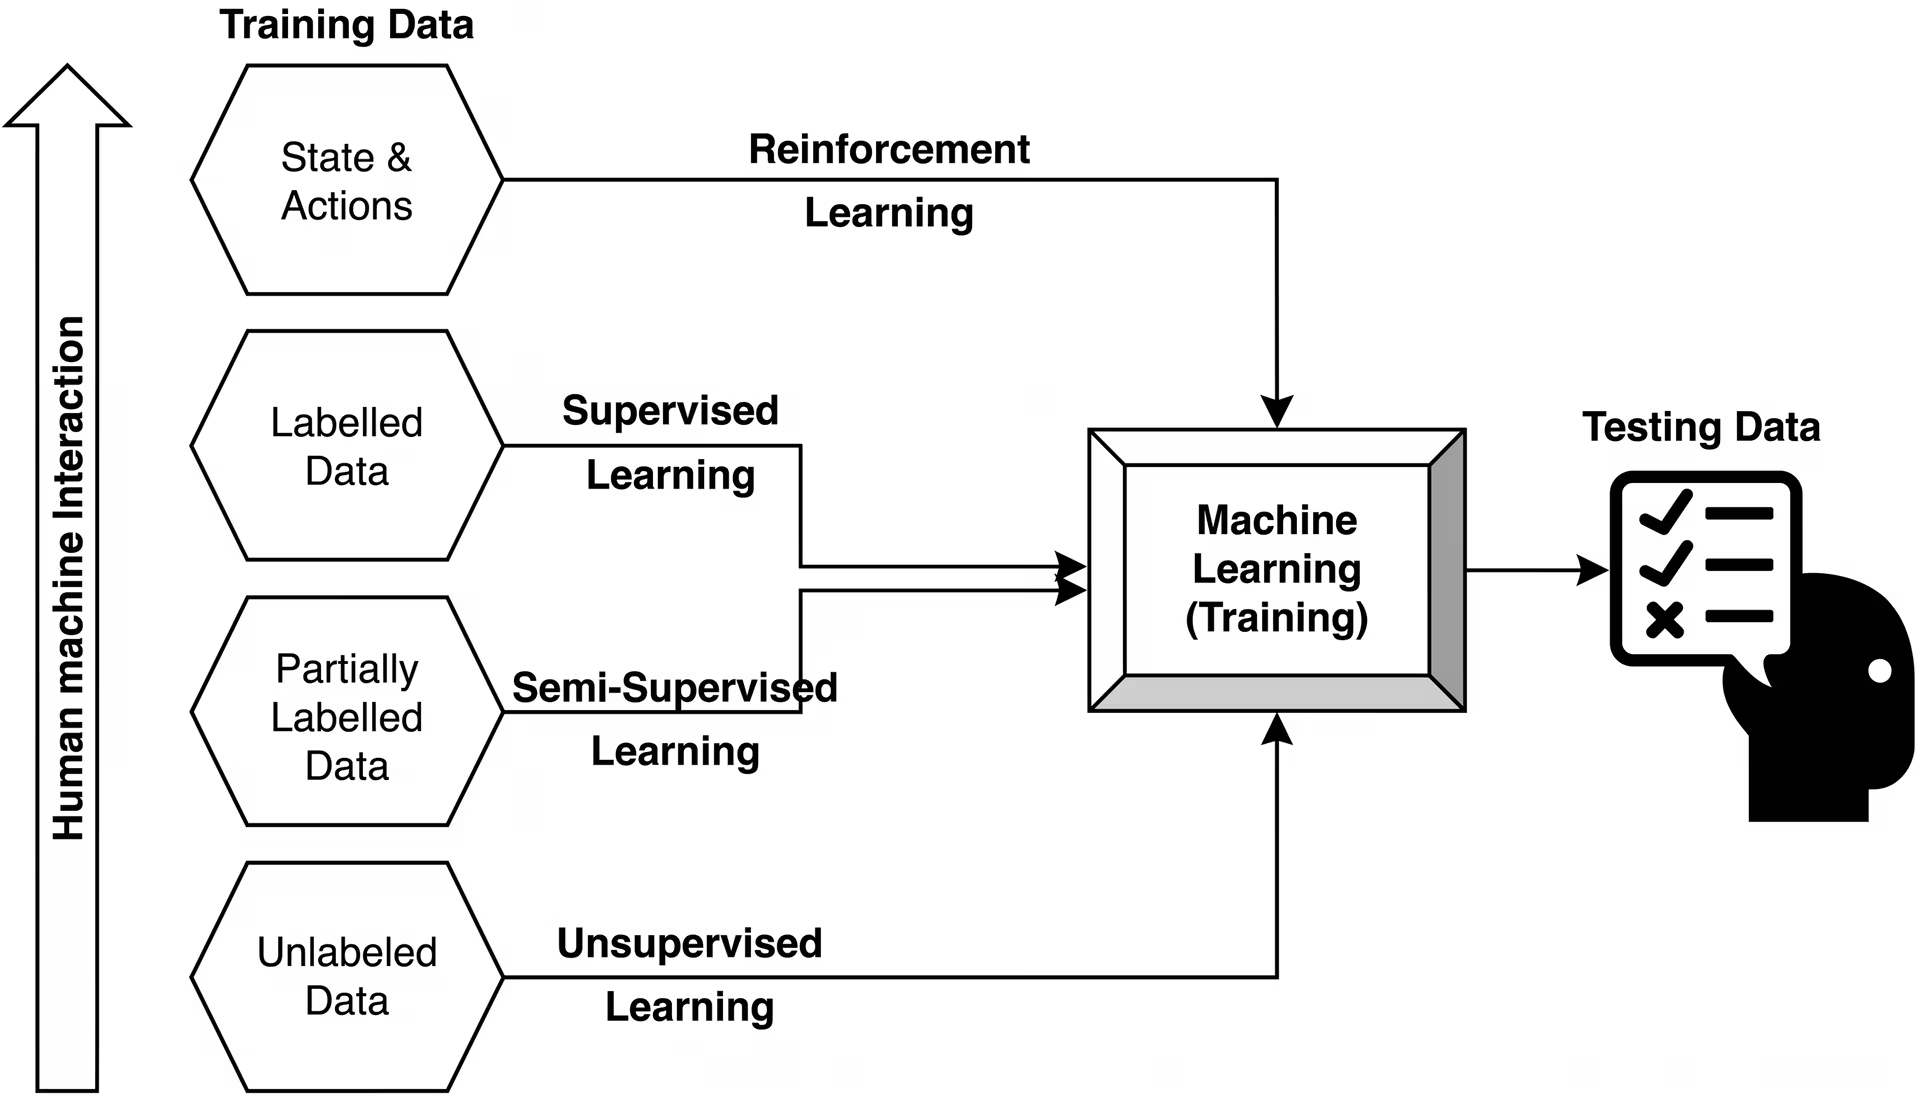
Abb. 1: Übersicht über KI-Lernverfahren (Quelle)
Computer-Vision-Systeme werden insbesondere mithilfe solcher Lernverfahren entwickelt, um visuelle Daten zu interpretieren und zu verstehen. Überwachtes Lernen ist die am häufigsten verwendete Methode, da Modelle damit anhand klar gekennzeichneter Beispiele lernen und genaue, zuverlässige Ergebnisse erzielen können.
Ein Modell kann beispielsweise mit Bildern trainiert werden, die als „Katze“ und „Hund“ gekennzeichnet sind. Dabei lernt es Merkmale wie Form, Ohren und Gesichtsstruktur und kann so neue Bilder mithilfe von Klassifizierungsalgorithmen korrekt einordnen. Auch unüberwachtes und teilüberwachtes Lernen kommen in Computer Vision zum Einsatz, häufig um Muster in Daten zu untersuchen oder die Leistung bei begrenzten gekennzeichneten Daten zu verbessern.
Ein Blick auf den Einsatz überwachter Lernmodelle in Computer Vision#
Du kannst Algorithmen für überwachtes Lernen mit einer Unterrichtssituation vergleichen, in der eine Lehrkraft Beispiele samt richtigen Antworten vorgibt, damit die Lernenden erkennen, was richtig und was falsch ist. Beim maschinellen Lernen lernen Modelle auf ähnliche Weise anhand gekennzeichneter Daten, bei denen jeder Eingabe ein bekannter Ausgabewert zugeordnet ist.
Angenommen, du arbeitest an einem Computer-Vision-System, das die Analyse von Baseballspielen automatisiert. Du könntest ein Modell wie Ultralytics YOLO26 mit Bildern oder Videobildern trainieren, auf denen Objekte wie Ball, Schläger und Spieler gekennzeichnet sind.
Jedes Objekt würde mit seinem Ort und seiner Kategorie markiert, sodass das Modell lernt, wonach es suchen soll. Mit der Zeit kann das Modell diese Objekte in neuem Videomaterial erkennen und lokalisieren und so Anwendungsfälle wie die Ballverfolgung und die Erkennung von Spielern in einzelnen Bildern unterstützen.
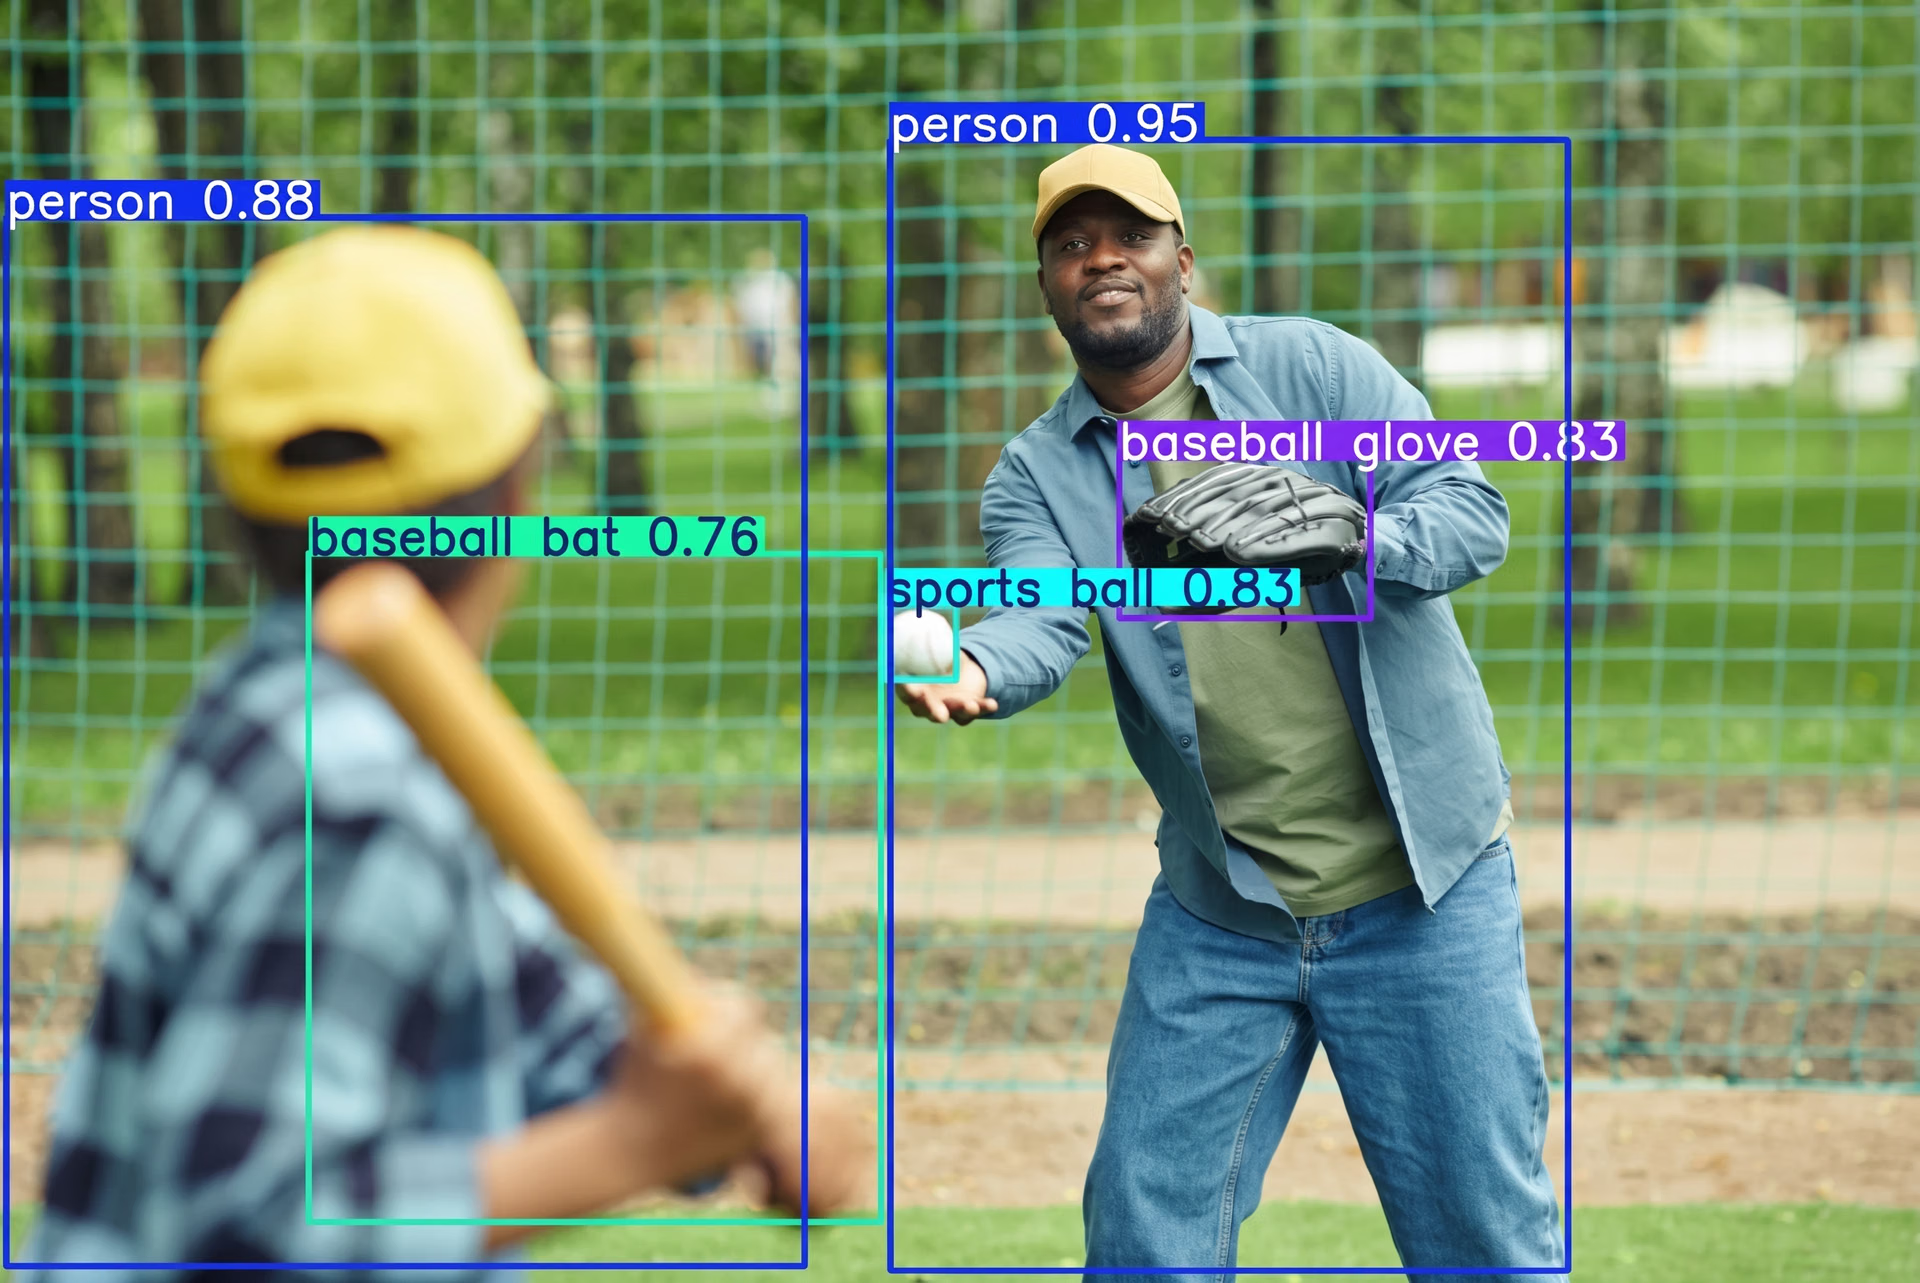
Abb. 2: Beispiel für Objekterkennung mithilfe von überwachtem Lernen (Quelle)
Über die Objekterkennung hinaus wird überwachtes Lernen in vielen Computer-Vision-Aufgaben eingesetzt, etwa bei der Bildklassifizierung, der Instanzsegmentierung und der Posenschätzung, bei denen Genauigkeit und Konsistenz wichtig sind. Bei all diesen Aufgaben lernen Modelle anhand gekennzeichneter Daten, bestimmte Muster zu erkennen und zuverlässige Vorhersagen für neue Eingaben zu treffen.
Diese Modelle werden in der Regel mit Deep Learning entwickelt, einer Form des maschinellen Lernens, bei der neuronale Netze Muster direkt aus Daten lernen. Neuronale Netze verarbeiten Informationen auf eine Weise, die lose davon inspiriert ist, wie das menschliche Gehirn funktioniert. Dadurch können Modelle komplexe visuelle Merkmale aus großen Datensätzen lernen.
Frühere Computer-Vision-Ansätze stützten sich häufig auf manuell entwickelte Merkmale in Kombination mit Algorithmen wie Support-Vektor-Maschinen (SVMs sind Modelle, die Daten klassifizieren, indem sie die beste Grenze zwischen Kategorien bestimmen) oder Entscheidungsbäumen (Modelle, die Entscheidungen treffen, indem sie Daten in Zweige aufteilen).
Im Gegensatz dazu nutzen Computer-Vision-Modelle heute Deep Learning, um diese Merkmale automatisch aus Daten zu lernen. Dadurch können sie umfangreiche und sehr detaillierte visuelle Aufgaben effektiver bewältigen.
Warum unüberwachtes Lernen für Vision-KI-Modelle wichtig ist#
Überwachtes Lernen ist zwar der gängige Ansatz in Computer Vision, doch bei bestimmten Anwendungen sind gekennzeichnete Daten nicht verfügbar oder ihre Erstellung ist zu kostspielig und zeitaufwendig.
In diesen Fällen können Algorithmen für unüberwachtes Lernen eine nützliche Alternative sein. Angenommen, du verfügst über eine große Sammlung nicht gekennzeichneter Fotos von einer Wildtierkamera.
Es gibt keine Kennzeichnungen, die angeben, was auf den einzelnen Bildern zu sehen ist, aber du möchtest die Daten trotzdem ordnen oder verstehen. Ein unüberwachtes Modell kann die Bilder analysieren und ähnliche Bilder gruppieren. So kann es ähnlich aussehende Tiere in Gruppen einteilen, auch wenn ihre genauen Kennzeichnungen unbekannt sind.
So funktioniert unüberwachtes Lernen in Computer Vision#
Wie funktioniert unüberwachtes maschinelles Lernen also? Statt anhand richtiger Antworten zu lernen, erkennt das Modell selbstständig Muster und Strukturen in den Daten. Es sucht in den Daten nach Ähnlichkeiten und Unterschieden, ohne auf gekennzeichnete Beispiele zurückzugreifen.
Ein typischer Anwendungsfall ist die Anomalieerkennung: Das Modell lernt, wie normale Daten aussehen, und erkennt anschließend Abweichungen davon. Die Erkennung von Anomalien und Ausreißern gehört zu den wirkungsvollsten industriellen Anwendungen. Beispiele sind das Aufspüren fehlerhafter Produkte an einer Fertigungslinie, das Markieren ungewöhnlicher medizinischer Aufnahmen zur Prüfung durch Radiologen oder das Erkennen verdächtiger Aktivitäten in Überwachungsvideos. Da Fehler und Anomalien oft selten und vielfältig sind, ist es nicht praktikabel, jeden möglichen Fall zu kennzeichnen. Daher eignen sich unüberwachte Ansätze besonders gut.
Dafür werden häufig Verfahren wie Clustering und Dimensionsreduktion eingesetzt, meist auf Merkmalen, die aus Bildern extrahiert wurden, statt auf den Rohbildern selbst. Clustering-Verfahren wie k-Means gruppieren ähnliche Bilder anhand gemeinsamer Muster, während Verfahren zur Dimensionsreduktion wie die Hauptkomponentenanalyse (PCA) die Daten vereinfachen, indem sie sich auf die wichtigsten Merkmale konzentrieren.
Dadurch kann das Modell bedeutungsvolle Muster und Strukturen in großen und komplexen Datensätzen leichter erkennen. Der wichtigste Vorteil des unüberwachten Lernens ist, dass es mit nicht gekennzeichneten Daten gut funktioniert und Muster aufdecken kann, die nicht sofort erkennbar sind. Im Vergleich zum überwachten Lernen ist die Bewertung jedoch schwieriger und die Kontrolle über das Endergebnis geringer.
Selbstüberwachtes und teilüberwachtes Lernen in Computer Vision#
Wenn du dich mit überwachtem und unüberwachtem Lernen beschäftigst, fragst du dich vielleicht, ob es einen Mittelweg zwischen den beiden Ansätzen gibt. Tatsächlich schließen selbstüberwachtes und teilüberwachtes Lernen die Lücke zwischen überwachtem und unüberwachtem Lernen.
Mit diesen Ansätzen können Modelle effektiver aus nicht gekennzeichneten Daten lernen. Statt sich ausschließlich auf gekennzeichnete Beispiele zu stützen, erstellen sie entweder eigene Lernaufgaben aus den Daten oder kombinieren einen kleinen gekennzeichneten Datensatz mit einem größeren, nicht gekennzeichneten Datensatz.
Beim selbstüberwachten Lernen lernt das Modell, indem es Aufgaben löst, die aus den Daten selbst erstellt werden. Beispielsweise kann es ein Bild mit einem fehlenden Teil erhalten und lernen, vorherzusagen, was in diesen Bereich gehört. Oder es lernt, verschiedene Ansichten desselben Objekts zu erkennen. So kann das Modell nützliche Merkmale lernen, ohne dass manuelle Kennzeichnungen nötig sind.
Beim teilüberwachten Lernen wird hingegen eine kleine Menge gekennzeichneter Daten zusammen mit einer größeren Menge nicht gekennzeichneter Daten verwendet, um die Leistung zu verbessern. In manchen Fällen kann das Modell Kennzeichnungen für die nicht gekennzeichneten Daten erzeugen und damit weiterlernen.
Der entscheidende Vorteil dieser Ansätze ist, dass sie den Bedarf an großen gekennzeichneten Datensätzen verringern, deren Erstellung oft kostspielig und zeitaufwendig ist. Im Vergleich zu vollständig überwachten Verfahren können sie jedoch schwieriger zu entwickeln und zu bewerten sein.
Die wichtigsten Unterschiede zwischen überwachtem und unüberwachtem Lernen#
Der Unterschied zwischen überwachtem und unüberwachtem Lernen hängt davon ab, wie ein Modell lernt und welches Ziel es verfolgt. Überwachtes Lernen stützt sich auf gekennzeichnete Daten und klare Vorgaben, um bestimmte Aufgaben zu erlernen. Unüberwachtes Lernen kommt dagegen ohne vorgegebene Antworten aus und konzentriert sich darauf, Muster und Strukturen in den Daten zu entdecken.
In einem Verkehrsüberwachungssystem kann beispielsweise ein Modell für überwachtes Lernen anhand gekennzeichneter Bilder trainiert werden, um Fahrzeuge, Fußgänger oder Ampeln zu erkennen. Ein unüberwachtes Modell könnte dagegen große Mengen an Videomaterial analysieren, um ähnliche Verkehrsmuster zu gruppieren oder ungewöhnliche Ereignisse wie unerwartete Staus oder abnormale Bewegungen zu erkennen, ohne ausdrücklich vorgegeben zu bekommen, wonach es suchen soll.
Wann du überwachtes Lernen in Computer Vision einsetzen solltest#
Überwachtes Lernen ist eine gute Wahl für Computer-Vision-Aufgaben mit einem klar definierten Ziel, bei denen das Modell Eingabedaten präzisen Ausgaben zuordnen muss. Es eignet sich besonders gut, wenn du über einen zuverlässigen gekennzeichneten Datensatz verfügst und konsistente, vorhersehbare Ergebnisse benötigst.
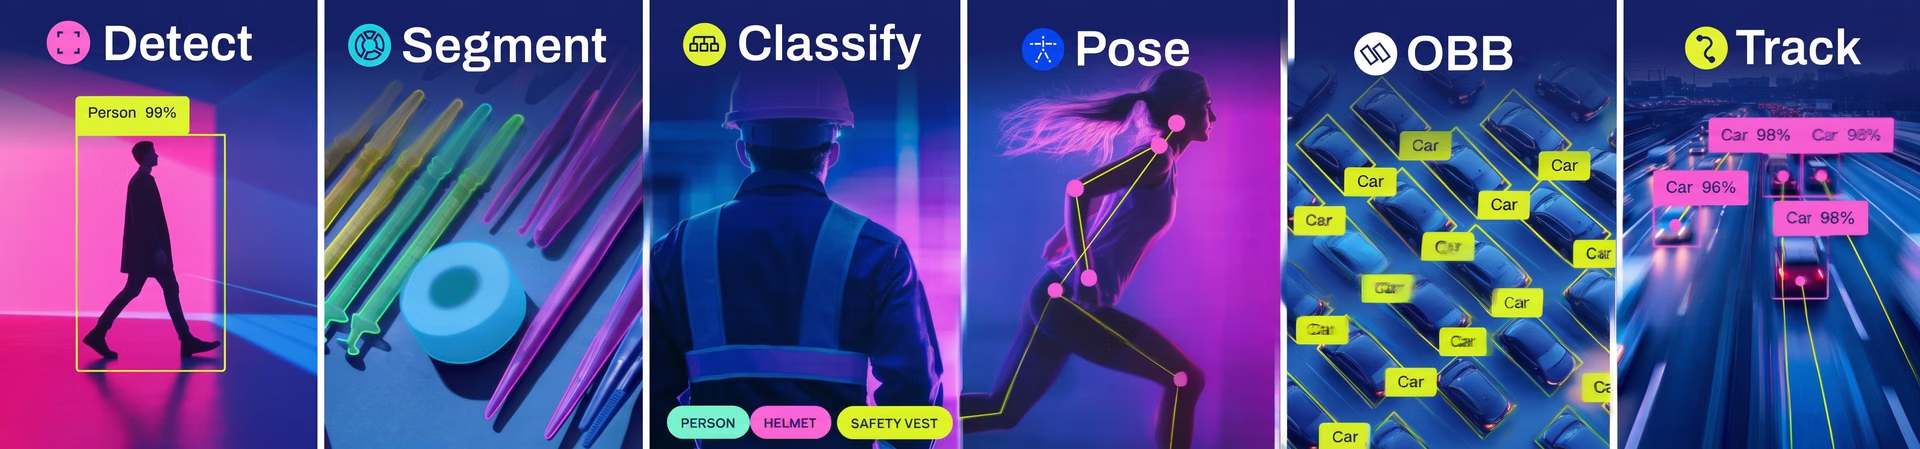
Abb. 3: Computer-Vision-Aufgaben auf Grundlage von überwachtem Lernen (Quelle)
Diese Methode wird häufig für Aufgaben eingesetzt, bei denen das Modell zwischen bekannten Kategorien unterscheiden oder bestimmte Ergebnisse vorhersagen muss. Statt Muster zu untersuchen, geht es darum, präzise Zusammenhänge aus gekennzeichneten Daten zu lernen. So lässt sich das Modell leichter zu einem gewünschten Ergebnis führen.
Ein weiterer wichtiger Vorteil ist die Kontrolle. Beim überwachten Lernen lassen sich die Leistung anhand klarer Kennzahlen messen, das Modell gezielt abstimmen und ein stabiles Verhalten beim Einsatz sicherstellen. Dadurch eignet sich dieser Ansatz hervorragend für Systeme, die dauerhaft konsistent und zuverlässig funktionieren müssen.
Das hat jedoch einen Nachteil: Das Modell hängt stark von der Qualität und dem Umfang der gekennzeichneten Daten ab. Das Sammeln und Annotieren solcher Daten kann zeitaufwendig sein.
Praxisbeispiele für überwachtes Lernen in Computer Vision#
Vision-KI-Modelle wie die Ultralytics-YOLO-Modelle nutzen überwachtes Lernen, um Aufgaben wie die Objekterkennung mit hoher Genauigkeit auszuführen, insbesondere bei Echtzeitanwendungen. Hier sind einige typische praktische Anwendungsfälle für Vision, bei denen überwachtes Lernen einen Unterschied macht:
- Gesundheitswesen und medizinische Bildgebung: Ärzte können Computer-Vision-Systeme verwenden, die anhand gekennzeichneter Aufnahmen wie Röntgenbildern oder MRT-Aufnahmen trainiert wurden. Klassifikatoren helfen dabei, Erkrankungen wie Tumore oder Knochenbrüche zu erkennen und ermöglichen so schnellere und genauere Diagnosen.
- Industrielle Qualitätsprüfung: In der Fertigung können mit gekennzeichneten Daten trainierte Bildverarbeitungssysteme Produkte anhand verschiedener qualitätsrelevanter Merkmale wie Form, Oberflächenfehlern, Textur und Größe prüfen. Indem diese Systeme sowohl anhand einwandfreier als auch fehlerhafter Produkte lernen, können sie Mängel zuverlässig erkennen und Produktionsstandards einhalten.
- Autonomes Fahren: Selbstfahrende Systeme stützen sich auf Modelle, die mit gekennzeichneten Fahrdaten trainiert wurden, um Fahrspuren, Fahrzeuge, Fußgänger und Verkehrszeichen zu erkennen und so eine sichere Navigation in Echtzeit zu ermöglichen.
- Einzelhandel und Kassensysteme: Geschäfte verwenden Modelle, die mit gekennzeichneten Produktbildern trainiert wurden, um Artikel in Regalen oder an der Kasse zu erkennen. Das ermöglicht eine automatisierte Abrechnung und eine effizientere Bestandsverwaltung. In Verbindung mit zusätzlichen Daten können diese Systeme auch Aufgaben wie die Kundensegmentierung unterstützen und Unternehmen dabei helfen, Einkaufsgewohnheiten besser zu verstehen.
- Landwirtschaft und Überwachung von Nutzpflanzen: Landwirte können mit gekennzeichneten Bildern trainierte Modelle einsetzen, um Nutzpflanzen zu erkennen und zu klassifizieren. So lassen sich beispielsweise gesunde und beschädigte Kartoffeln erkennen und zählen, die Qualitätskontrolle verbessern und Verluste verringern.
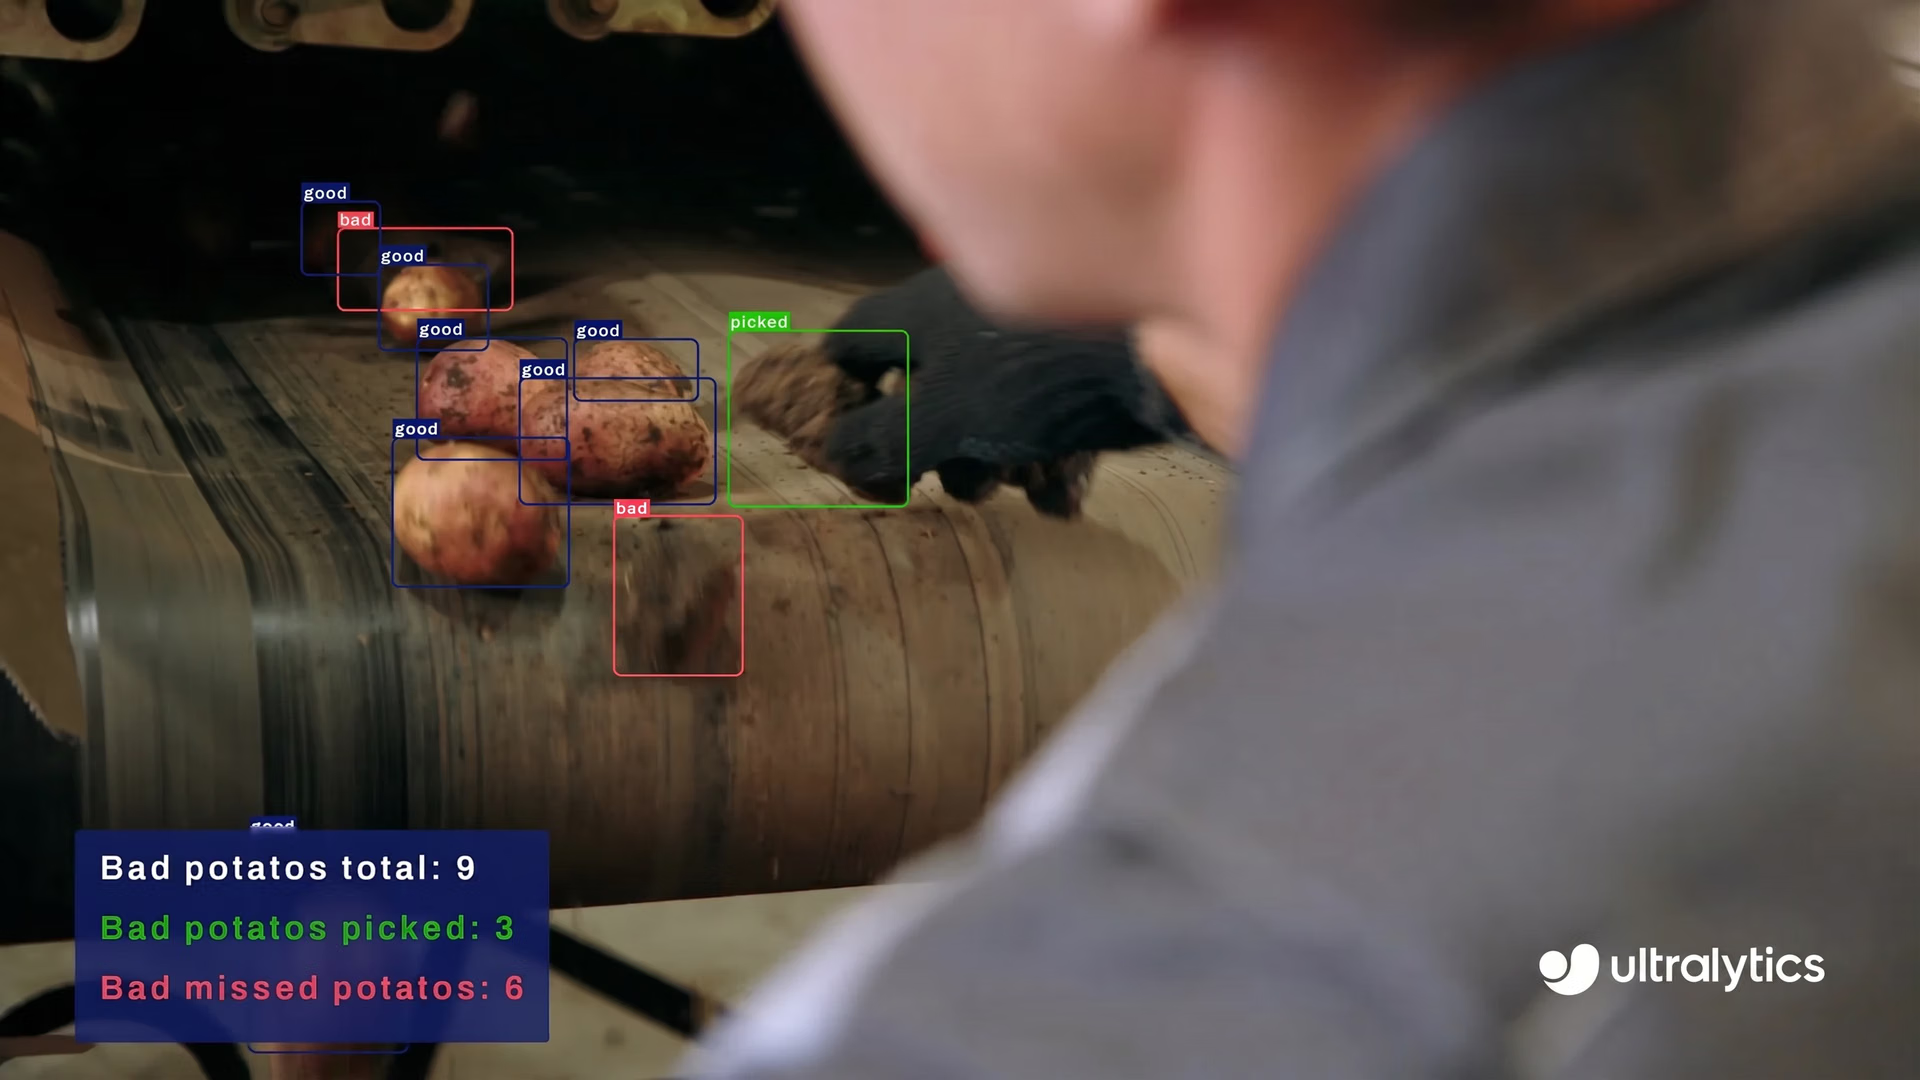
Abb. 4: Mit YOLO gesunde und fehlerhafte Kartoffeln erkennen und zählen
Welche Probleme in Computer Vision lassen sich mit unüberwachtem Lernen lösen?#
Unüberwachtes Lernen ist nützlich, wenn du nicht genügend gekennzeichnete Daten hast oder deine Daten keine klaren Antworten enthalten. In solchen Fällen geht es nicht darum, genaue Vorhersagen zu treffen, sondern Muster und Strukturen in den Daten zu verstehen.
Es wird häufig eingesetzt, wenn ein nicht gekennzeichneter Datensatz zum ersten Mal untersucht wird. Statt dem Modell vorzugeben, wonach es suchen soll, lässt du es selbstständig Ähnlichkeiten erkennen, zusammengehörige Bilder gruppieren oder ungewöhnliche Muster hervorheben.
Bei einer großen Bildersammlung kann ein unüberwachter Ansatz dabei helfen, ähnliche Bilder zusammenzufassen oder Ausreißer zu markieren, die genauer untersucht werden sollten. Das macht ihn zu einem nützlichen Ausgangspunkt für Data-Science-Projekte.
Generative Modelle wie GANs, Variational Autoencoder und Diffusionsmodelle lernen die zugrunde liegende Verteilung von Bildern, um völlig neue Bilder zu erzeugen. Diese Modelle ermöglichen Anwendungen wie Bildsynthese, Inpainting, Superauflösung und Stilübertragung und bilden das Rückgrat der heutigen generativen KI-Systeme.
Bei der unüberwachten Segmentierung gruppieren einige Verfahren Pixel oder Bereiche zu zusammenhängenden Segmenten, ohne auf gekennzeichnete Masken zurückzugreifen. Das ist nützlich, wenn Annotationen zu kostspielig sind oder wenn es darum geht, Strukturen zu entdecken, statt vorgegebene Kategorien abzubilden.
Unüberwachtes Lernen ist auch bei großen Datensätzen wirkungsvoll, deren Kennzeichnung zeitaufwendig oder nicht praktikabel ist. In solchen Fällen kannst du Erkenntnisse aus den Daten gewinnen, ohne auf gekennzeichnete Trainingsdaten angewiesen zu sein.
Es wird auch häufig in Bereichen wie der generativen KI (Modelle, die neue Daten wie Bilder, Texte oder Audiodaten erzeugen) und dem Repräsentationslernen (Modelle, die nützliche Merkmale oder Muster aus Rohdaten lernen) eingesetzt, in denen Modelle allgemeine Merkmale aus großen Datenmengen lernen. Wenn es bei deiner Aufgabe um das Erkunden von Daten, das Entdecken von Mustern oder die Arbeit mit nicht gekennzeichneten Daten geht, ist unüberwachtes Lernen insgesamt ein flexibler und praktischer Ansatz.
Praxisbeispiele für unüberwachtes Lernen in Computer Vision#
Hier sind einige Beispiele für Anwendungsfälle, bei denen unüberwachtes Lernen in Computer Vision zum Einsatz kommt:
- Anomalieerkennung in der Fertigung: Modelle können lernen, wie normale Produkte aussehen, und Fehler oder Unregelmäßigkeiten erkennen, ohne dass Beispiele für jeden möglichen Fehler gekennzeichnet werden müssen.
- Bildorganisation und -suche: Große Bildsammlungen wie Fotobibliotheken oder E-Commerce-Kataloge können automatisch nach visueller Ähnlichkeit gruppiert werden. So können Data Scientists große Datensätze leichter organisieren, untersuchen und durchsuchen.
- Überwachung und Sicherheit: Systeme können Videomaterial analysieren, um ungewöhnliche Muster oder Verhaltensweisen wie unerwartete Bewegungen oder Veränderungen in Menschenmengen zu erkennen, ohne dass sie ausdrücklich anhand gekennzeichneter Ereignisse trainiert wurden.
- Vorverarbeitung und Datenexploration: Unüberwachte Verfahren werden häufig eingesetzt, um Rohbilddaten zu untersuchen und zu strukturieren, bevor überwachte Modelle trainiert werden. So lässt sich die Datenqualität verbessern und der manuelle Aufwand verringern.
Praktische Grenzen des überwachten und unüberwachten Lernens#
Trotz der Vorteile beider Lernansätze gibt es einige Einschränkungen, die du berücksichtigen solltest. Beim Entwickeln von Computer-Vision-Modellen solltest du folgende praktische Faktoren im Blick behalten:
- Überanpassung bei überwachten Modellen: Beim überwachten Lernen kann ein Modell die Trainingsdaten zu genau erlernen, statt allgemeine Muster zu erfassen. Das geschieht häufig, wenn der Datensatz klein oder nicht vielfältig genug ist. Ein Modell, das beispielsweise darauf trainiert wurde, Fehler an einer bestimmten Art von Produkt zu erkennen, kann bei neuen Daten mit leicht abweichenden Produkten oder Lichtverhältnissen versagen.
- Herausforderungen bei Clustering-Algorithmen: Beim unüberwachten Lernen kann ein Modell ähnliche Datenpunkte gruppieren. Bei verrauschten oder uneinheitlichen Daten oder wenn eine klare Struktur fehlt, kann dieser Ansatz jedoch an Grenzen stoßen. Bei der Gruppierung von Bildern können beispielsweise Bilder mit ähnlichen Farben, aber unterschiedlichen Objekten fälschlicherweise derselben Gruppe zugeordnet werden.
- Wichtigkeit einer sorgfältigen Vorverarbeitung: Vor dem Training müssen Daten bereinigt und aufbereitet werden. Dafür kommen üblicherweise Python-Bibliotheken zum Einsatz, die Bildverarbeitung und Datentransformation übernehmen. Das ist in Computer Vision besonders wichtig, da sich Bilder in Größe, Qualität oder Beleuchtung unterscheiden können. Ohne geeignete Vorverarbeitung lernen Modelle möglicherweise Rauschen statt aussagekräftiger Muster, was zu schlechter Leistung führt.
Die wichtigsten Erkenntnisse#
In Computer Vision spielen sowohl überwachtes als auch unüberwachtes Lernen wichtige Rollen. Welcher Ansatz der richtige ist, hängt von der Art deiner Daten ab, davon, ob sie gekennzeichnet sind, sowie von der Aufgabe, die du lösen möchtest, und deinen Anforderungen an den Einsatz.
Wenn du eine hohe Genauigkeit und klar definierte Ausgaben anstrebst, ist überwachtes maschinelles Lernen häufig die bessere Wahl. Wenn du Daten untersuchst oder ohne Kennzeichnungen arbeitest, kann unüberwachtes Lernen geeigneter sein.
Möchtest du mehr über KI erfahren? Sieh dir unsere Community und unser GitHub-Repository an. Entdecke unsere Lösungsseiten zu KI in der Robotik und Computer Vision in der Landwirtschaft. Informiere dich über unsere Lizenzmodelle und fang noch heute an, mit Computer Vision zu entwickeln!









