Exploración de la detección de objetos pequeños con Ultralytics YOLO11
Descubre cómo Ultralytics YOLO11 ofrece una detección de objetos pequeños rápida y precisa en aplicaciones del mundo real, como la vigilancia y la robótica.
 Abirami Vina15 min de lectura
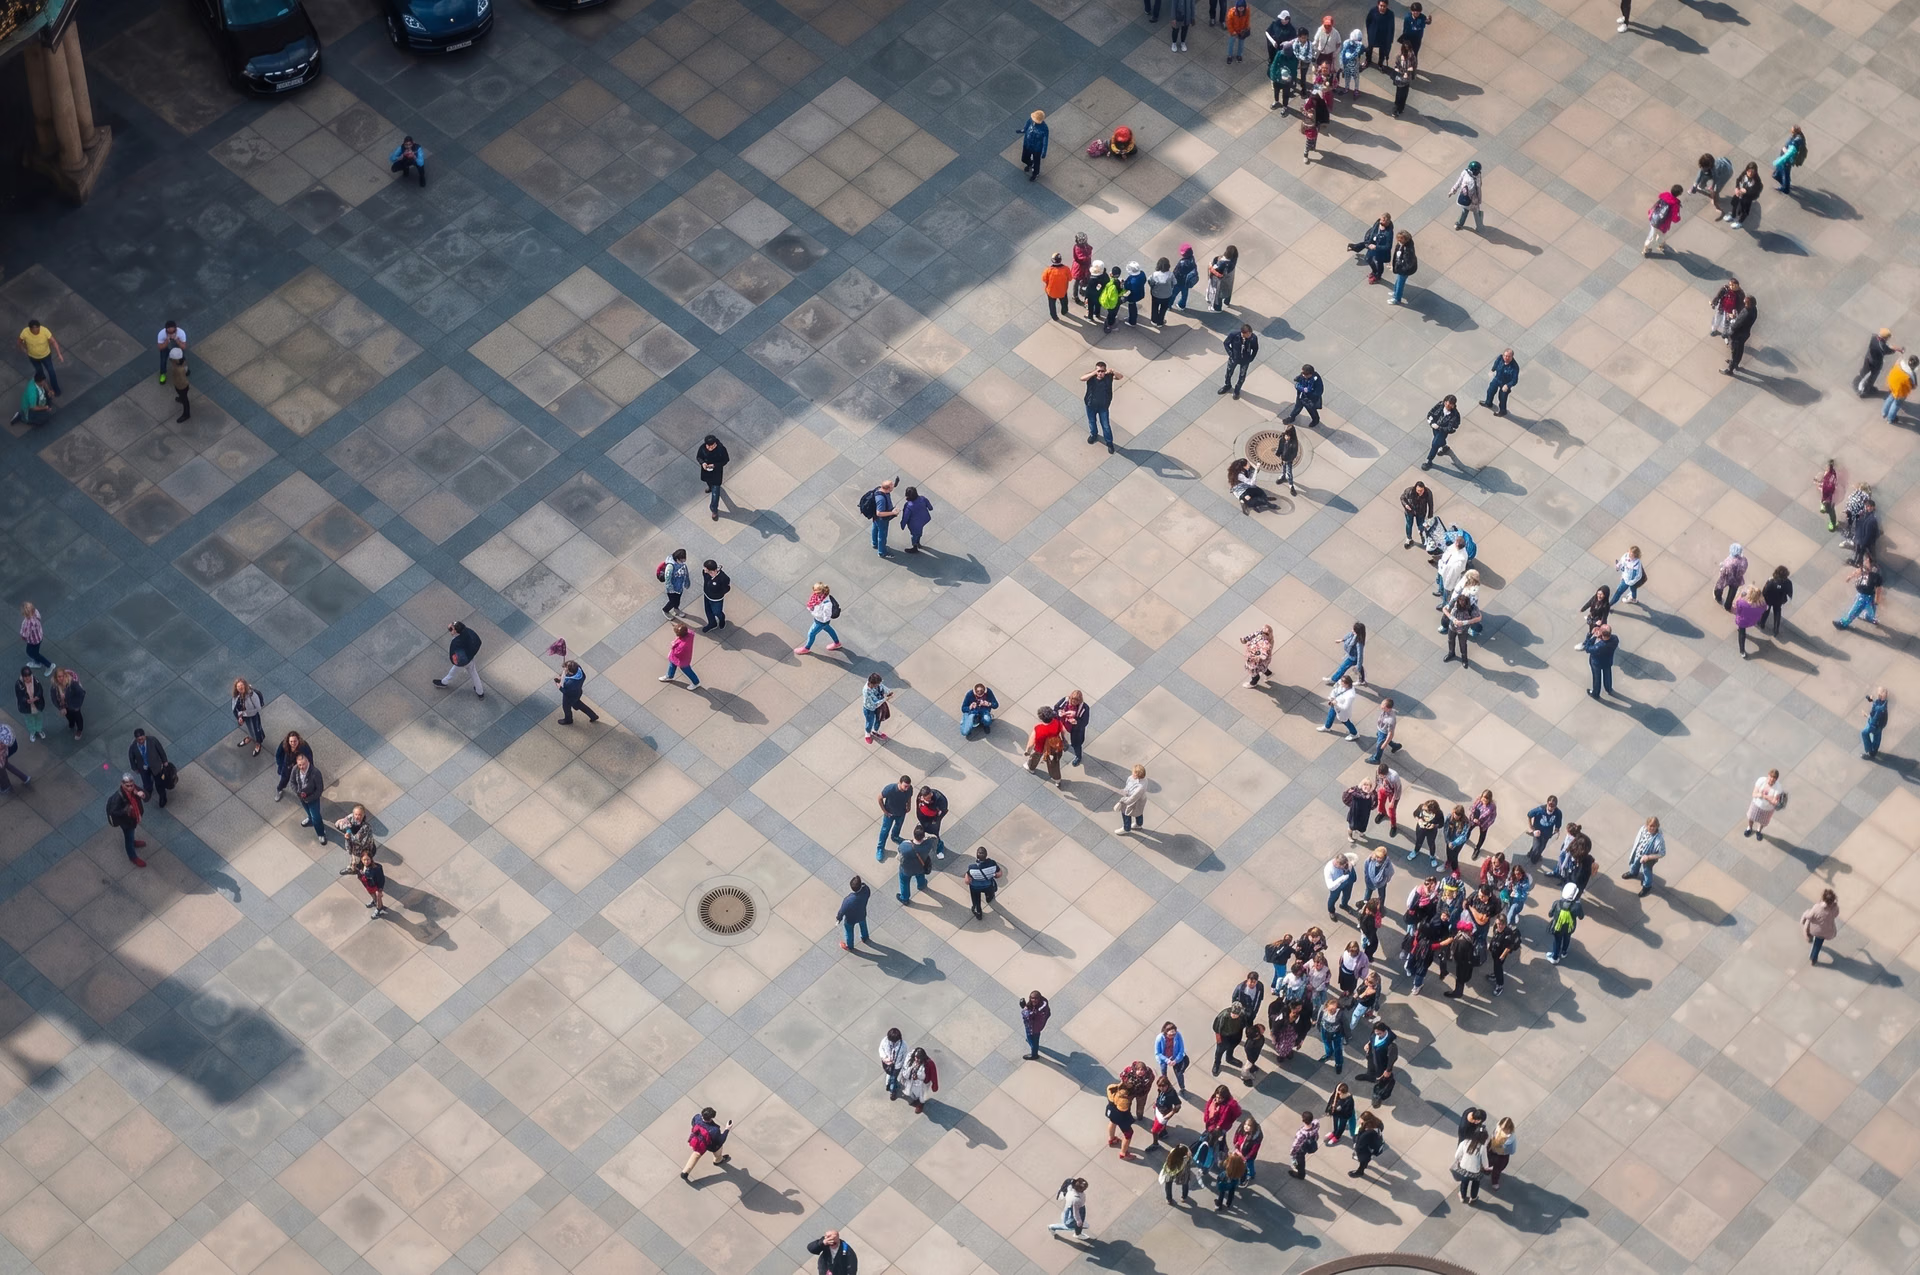
Los drones integrados con IA de visión pueden volar a cientos de metros sobre el suelo y aun así se espera que detecten a una persona que aparece como apenas unos pocos píxeles en su vídeo. De hecho, es un reto habitual en aplicaciones como la robótica, la vigilancia y la teledetección, donde los sistemas deben identificar objetos muy pequeños dentro de una imagen.
Sin embargo, los modelos tradicionales de detección de objetos pueden tener dificultades para hacerlo. Los objetos pequeños en imágenes y vídeos aportan muy poca información visual. En pocas palabras, cuando un modelo los observa, no hay muchos detalles que pueda aprender o reconocer.
Por dentro, estos modelos suelen basarse en una arquitectura basada en redes neuronales convolucionales (CNN). Las imágenes pasan por capas de la red y se transforman en mapas de características o representaciones simplificadas que resaltan patrones relevantes en lugar de píxeles sin procesar.
A medida que la imagen avanza por la red, los mapas de características se hacen más pequeños. Esto acelera el cálculo, pero también puede hacer que desaparezcan los detalles más sutiles.
En los objetos diminutos, esos detalles son fundamentales. Cuando desaparecen, un modelo de visión artificial puede tener dificultades para detectar el objeto, lo que puede dar lugar a cuadros delimitadores menos precisos o incoherentes.
Los sistemas de visión artificial integrales y en tiempo real lo complican aún más. Las imágenes de alta resolución ayudan a conservar los detalles, pero ralentizan la inferencia y requieren más potencia de GPU. Las resoluciones más bajas se procesan más rápido, pero dificultan aún más la detección de objetos pequeños.
Se convierte en un equilibrio constante entre velocidad, precisión y límites del hardware. Gracias a los recientes avances tecnológicos, los modelos de visión artificial como Ultralytics YOLO11 y Ultralytics YOLO26, que se ha publicado desde entonces, están diseñados para gestionar este equilibrio de forma más eficaz.
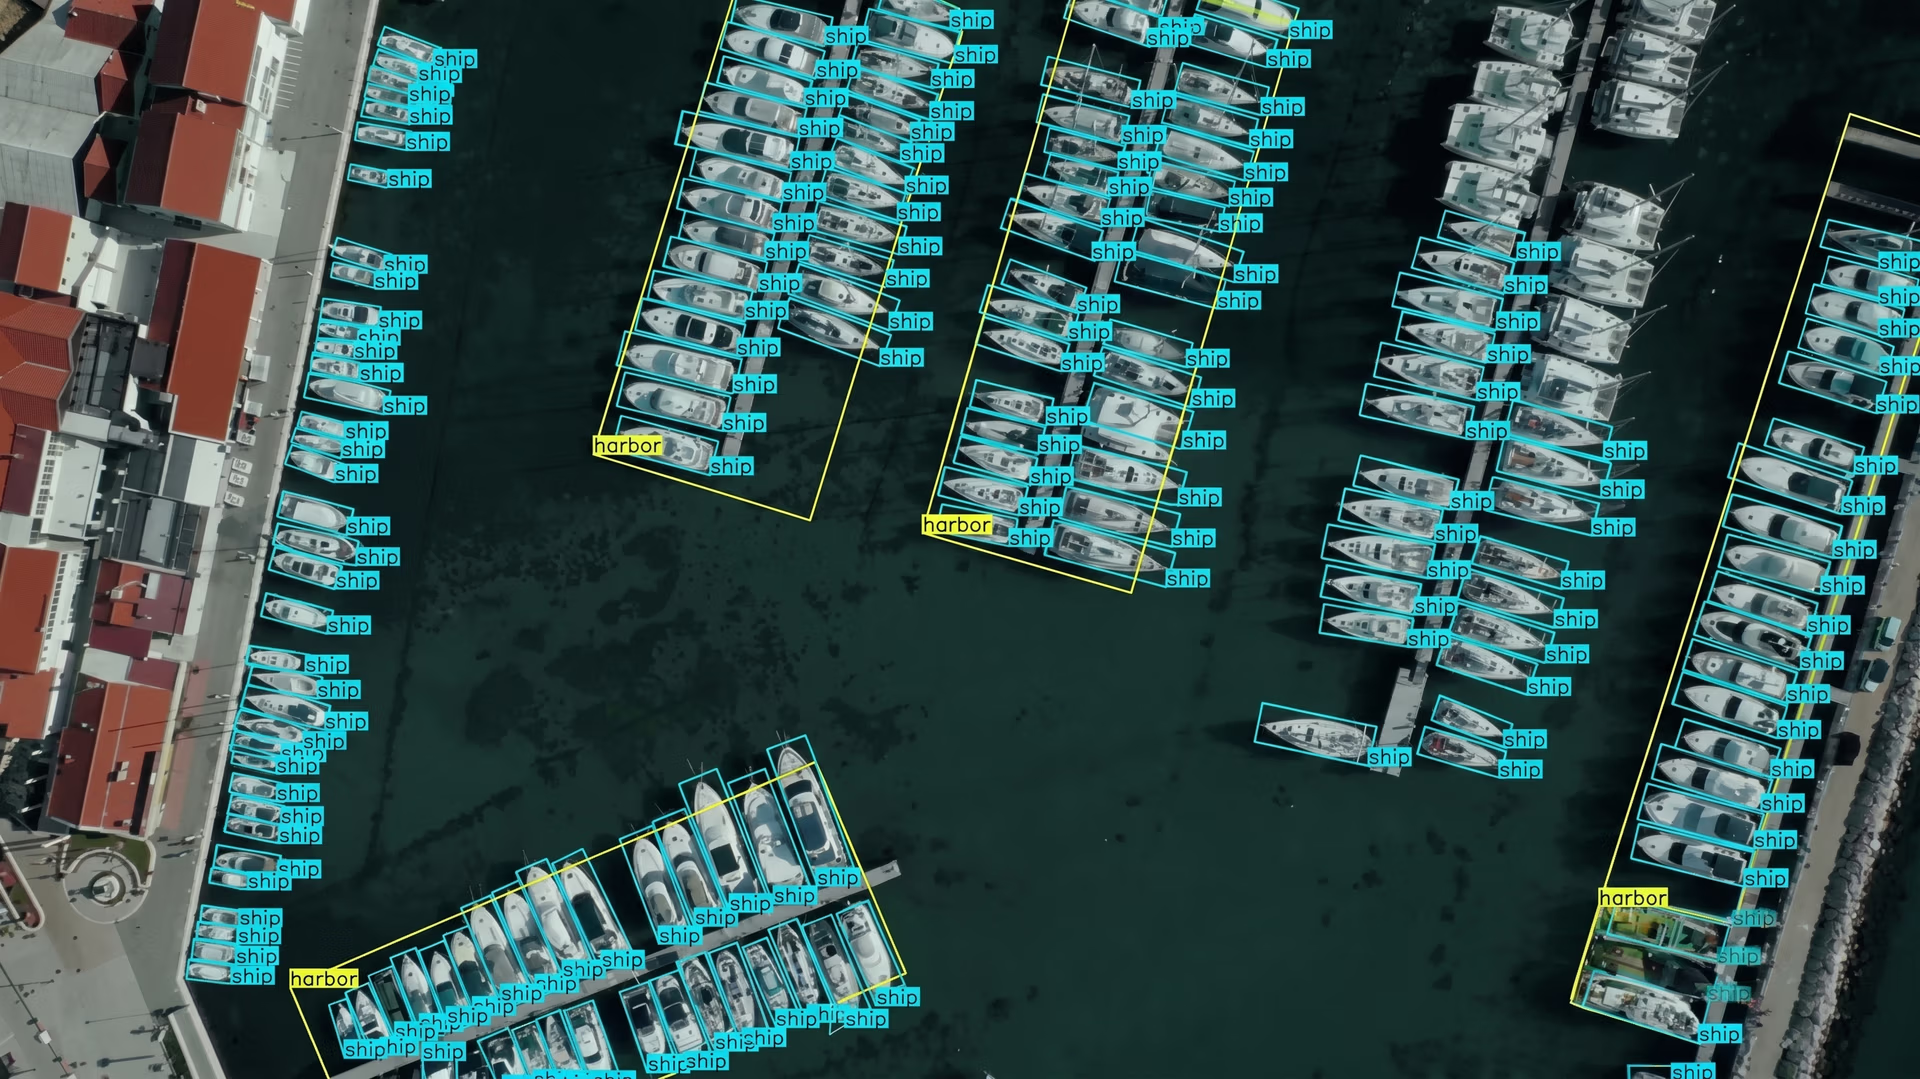
Fig. 1. Uso de YOLO11 para detectar objetos pequeños en imágenes aéreas (Fuente)
En este artículo, veremos por qué es difícil detectar objetos pequeños y cómo Ultralytics YOLO11 puede facilitarlo.
¿Qué es la detección de objetos pequeños y por qué es importante?#
La detección de objetos pequeños es una tarea de visión artificial, una rama de la IA, que se centra en identificar y localizar objetos que ocupan una parte muy pequeña de una imagen. A menudo, estos objetos están representados en la imagen por un número limitado de píxeles, que son las unidades más pequeñas de una imagen digital. Esto hace que sean más difíciles de detectar que los objetivos más grandes y nítidos (que suelen contener más píxeles).
Por ejemplo, los vehículos en imágenes aéreas, las herramientas en el suelo de una fábrica o las personas captadas por cámaras de vigilancia gran angular pueden aparecer como objetos pequeños en la imagen. Detectarlos es importante porque a menudo contienen información crítica y muchas aplicaciones del mundo real, como la vigilancia, dependen de estas detecciones para funcionar correctamente.
Si no se detectan objetos pequeños, el rendimiento del sistema y la toma de decisiones pueden verse afectados. La supervisión de vehículos aéreos no tripulados (UAV) es un buen ejemplo: no detectar un objeto pequeño en movimiento en el suelo puede afectar a la navegación o a la precisión del seguimiento.
Retos relacionados con la detección de objetos pequeños#
Los primeros sistemas utilizaban características diseñadas manualmente y métodos tradicionales de visión artificial, que tenían dificultades en escenas complejas o variadas. Incluso hoy, aunque los modelos de aprendizaje profundo ofrecen un rendimiento mucho mejor, detectar objetivos pequeños sigue siendo difícil cuando ocupan solo una parte diminuta de la imagen.
A continuación, veamos algunos de los retos habituales que surgen al detectar objetos pequeños en distintos escenarios del mundo real.
Tamaño, píxeles y pérdida de información#
Los objetos pequeños contienen muy pocos píxeles, lo que limita la cantidad de detalles visuales que un modelo puede aprender durante etapas como la extracción de características. Como resultado, resulta más difícil detectar patrones como bordes, formas y texturas, por lo que es más probable que los objetos pequeños se confundan con el fondo.
A medida que las imágenes pasan por las capas convolucionales de una red neuronal, la información visual de los píxeles se comprime gradualmente en mapas de características. Esto ayuda a que el modelo sea eficiente, pero también hace que los detalles más sutiles se desvanezcan.
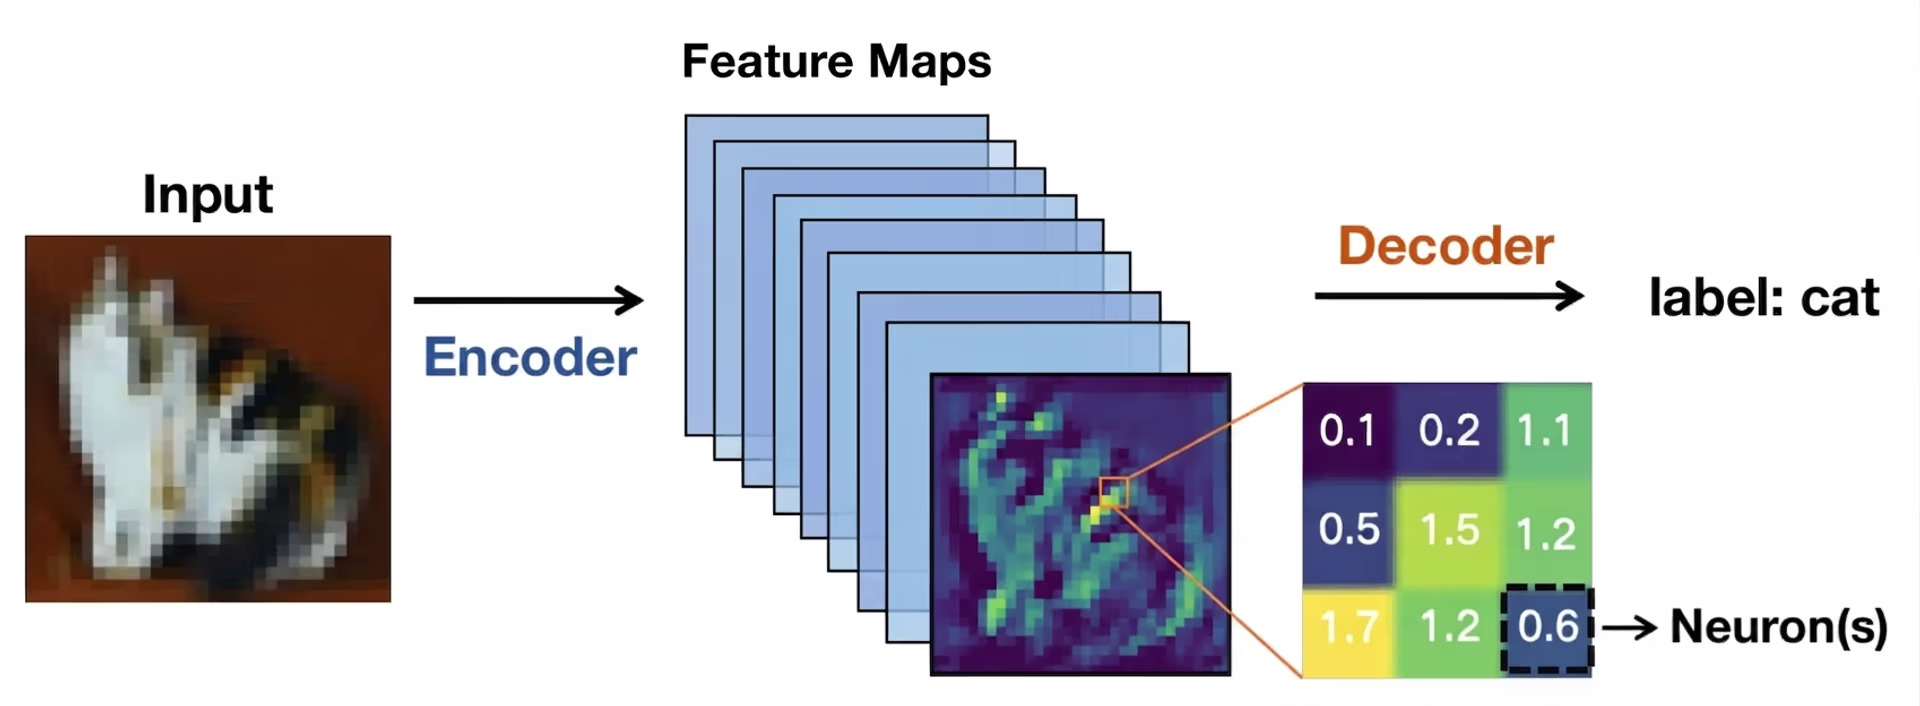
Fig. 2. Los mapas de características representan patrones visuales en una imagen (Fuente)
En los objetivos pequeños, las señales importantes pueden desaparecer antes de que la red de detección tenga la oportunidad de actuar. Cuando esto ocurre, la localización es menos fiable y los cuadros delimitadores pueden desplazarse, solaparse o pasar por alto los objetos objetivo por completo.
Oclusión, variación de escala y contexto#
Los retos relacionados con el tamaño también suelen verse agravados por la oclusión. La oclusión se produce cuando otros objetos de la escena ocultan parcialmente objetos, especialmente los más pequeños.
Esto reduce la zona visible del objetivo y limita la información disponible para el detector de objetos. Incluso una oclusión leve puede confundir a las redes de detección, sobre todo si se combina con una entrada de baja resolución. Un ejemplo interesante se puede ver en conjuntos de datos de UAV como VisDrone, donde los peatones, las bicicletas o los vehículos pueden quedar parcialmente ocultos por edificios, árboles u otros objetos en movimiento.
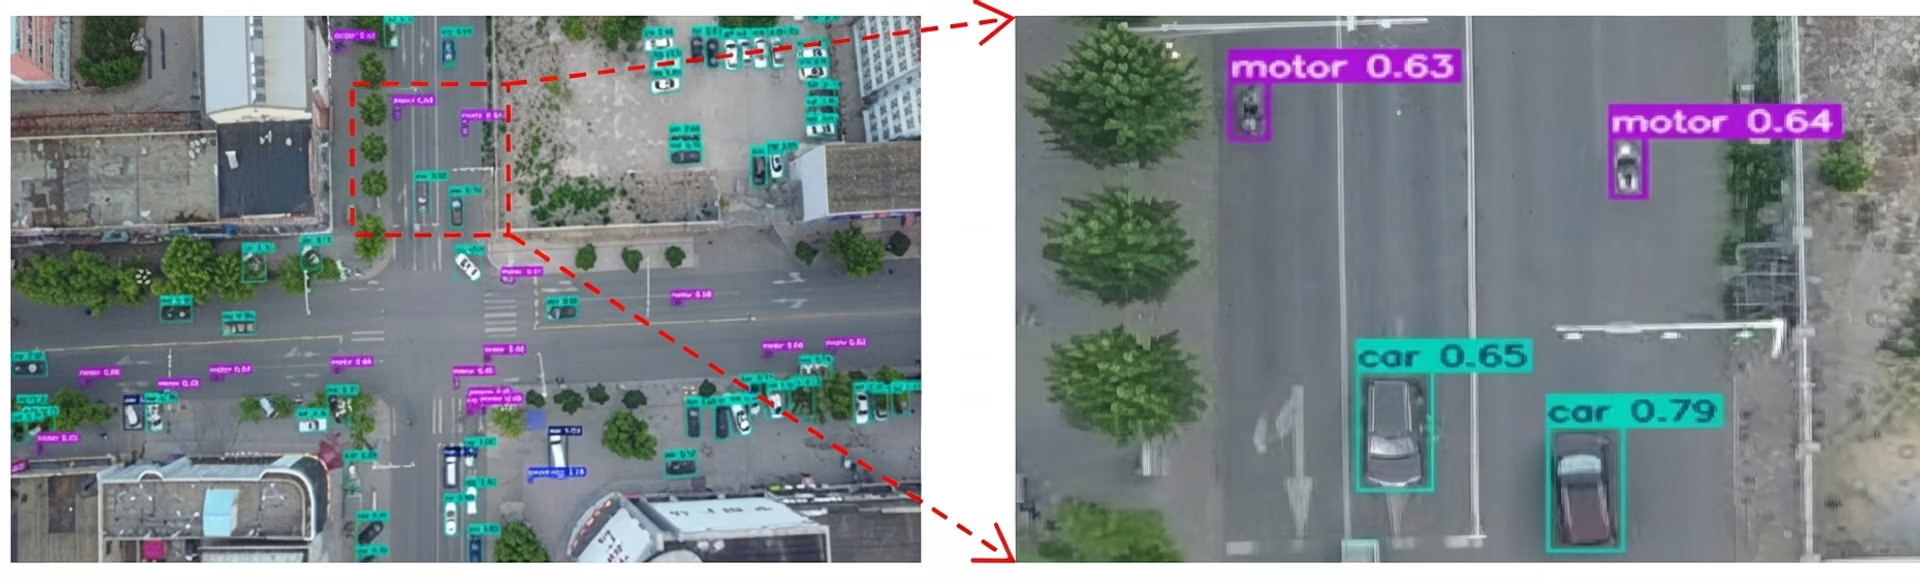
Fig. 3. Ejemplo del conjunto de datos VisDrone que muestra objetos pequeños (Fuente)
Del mismo modo, la variación de escala añade otra dificultad, ya que el mismo objeto puede aparecer muy pequeño o relativamente grande según la distancia y la posición de la cámara. A pesar de estos obstáculos, los algoritmos de detección deben reconocer estos objetos pequeños a distintas escalas sin perder precisión.
El contexto también desempeña un papel importante en la detección. Por ejemplo, los objetos grandes suelen aparecer en entornos despejados que proporcionan señales visuales útiles. En cambio, los objetivos pequeños a menudo carecen de esta información contextual, lo que dificulta el reconocimiento de patrones.
El problema de la métrica oculta en la detección de objetos pequeños#
Las métricas de evaluación habituales, como la intersección sobre unión (IoU), miden cuánto se solapa un cuadro delimitador predicho con el cuadro de referencia. Aunque IoU funciona bien con objetos grandes, su comportamiento es bastante distinto con los pequeños.
Los objetos pequeños ocupan solo unos pocos píxeles, por lo que incluso un pequeño desplazamiento del cuadro predicho puede generar un error proporcional grande y reducir considerablemente la puntuación de IoU. Esto significa que los objetos pequeños a menudo no alcanzan el umbral de IoU estándar necesario para considerar correcta una predicción, incluso cuando el objeto es visible en la imagen.
Como resultado, es más probable que los errores de localización se clasifiquen como falsos positivos o falsos negativos. Estas limitaciones han llevado a los investigadores a replantearse cómo evalúan los sistemas de detección de objetos los objetivos pequeños y difíciles de detectar, y cómo los gestionan.
Características multiescala: la clave para detectar objetos pequeños en tiempo real#
A medida que los investigadores trabajaban para mejorar la detección de objetos pequeños, quedó claro que preservar y representar la información visual a varias escalas es fundamental. Esta idea también aparece en investigaciones recientes de arXiv y en artículos presentados en eventos como las Conferencias Internacionales del IEEE y la Conferencia Europea de Visión por Computador (ECCV).
A medida que las imágenes avanzan por una red neuronal, los objetos pequeños pueden perder detalles o desaparecer por completo. Por eso, los modelos modernos de visión artificial como Ultralytics YOLO11 se centran especialmente en mejorar la extracción de características. A continuación, repasaremos los conceptos fundamentales de los mapas de características y las redes piramidales de características para entenderlos mejor.
Mapas de características y representación de escala#
Cuando una imagen de entrada, como una imagen de teledetección, entra en una red neuronal, se transforma gradualmente en mapas de características. Estos son representaciones simplificadas de la imagen que resaltan patrones visuales como bordes, formas y texturas.
A medida que la red profundiza, los mapas de características se reducen en tamaño espacial. Esta reducción ayuda al modelo a funcionar de forma eficiente y a centrarse en la información de alto nivel. Sin embargo, la reducción y la profundidad de los mapas de características también disminuyen el detalle espacial.
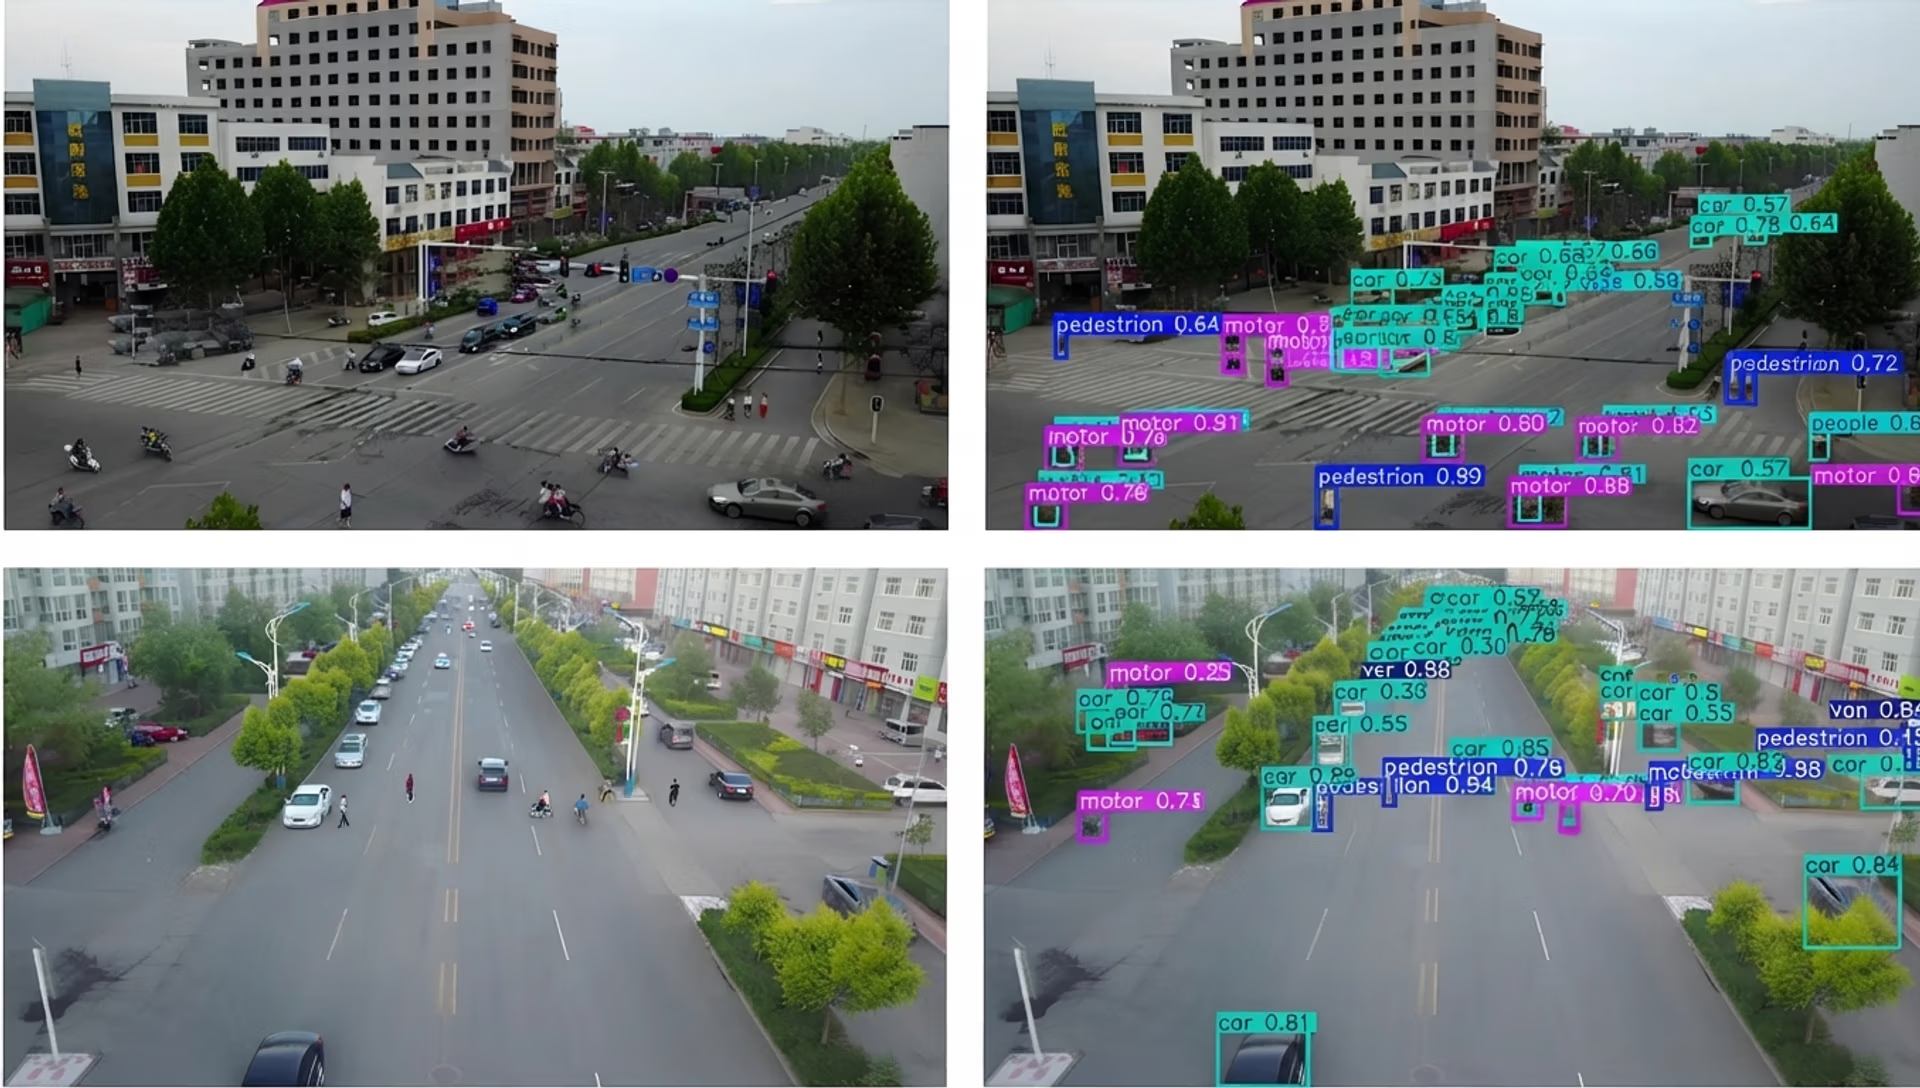
Fig. 4. La extracción de características es fundamental para detectar objetos pequeños. (Fuente)
Aunque los objetos grandes conservan suficiente información visual para detectarlos con precisión, los objetivos pequeños pueden perder detalles fundamentales tras solo unas pocas capas de la red. Cuando esto ocurre, el modelo puede tener dificultades incluso para reconocer que existe un objeto pequeño. Esta es una de las principales razones por las que los modelos profundos de detección de objetos no detectan objetos pequeños.
Redes piramidales de características y aprendizaje multiescala#
Las redes piramidales de características, conocidas a menudo como FPN, se introdujeron para solucionar la pérdida de detalle espacial. Funcionan como un módulo complementario que combina información de varias capas para que los modelos puedan detectar objetos pequeños de forma más eficaz. Este proceso también se conoce como agregación y fusión de características.
Las capas superficiales aportan detalles espaciales precisos, mientras que las capas más profundas añaden contexto semántico, lo que permite un aprendizaje multiescala eficaz de las características. A diferencia del sobremuestreo básico, que simplemente amplía los mapas de características, FPN conserva información significativa y mejora la detección de objetos pequeños.
Los enfoques modernos desarrollan esta idea mediante la fusión adaptativa de características y diseños que tienen en cuenta el contexto para mejorar aún más la detección de objetivos pequeños. En otras palabras, FPN ayuda a los modelos a captar a la vez tanto la imagen general como los detalles diminutos. Esta optimización es fundamental cuando los objetos son pequeños.
Cómo han evolucionado los modelos de detección de objetos para gestionar objetos pequeños#
Este es un breve repaso de cómo han evolucionado y mejorado con el tiempo los modelos de detección de objetos para detectar mejor objetos de distintos tamaños, incluidos los muy pequeños:
- Primeros métodos de detección: Los primeros enfoques de detección de objetos se basaban en características diseñadas manualmente y algoritmos basados en reglas, propios del procesamiento clásico de imágenes. Como estas características eran fijas, el rendimiento empeoraba con imágenes diferentes.
- Introducción del aprendizaje automático y el aprendizaje profundo: La adopción del aprendizaje automático y el aprendizaje profundo supuso un cambio importante en la investigación sobre detección de objetos. En lugar de depender de reglas predefinidas, las redes neuronales aprendían representaciones visuales directamente de los datos de entrenamiento, lo que mejoraba su capacidad de adaptación a distintas escalas de objetos y escenas.
- Redes convolucionales: Estas redes neuronales aprenden a reconocer patrones en imágenes. Cada capa capta distintos detalles: empieza por bordes y colores sencillos, continúa con formas y, finalmente, reconoce objetos completos. Por eso son esenciales para la visión artificial moderna.
- Detectores de objetos de dos etapas: Los detectores de dos etapas, como Faster R-CNN, presentado por Ren et al., primero generaban regiones candidatas y después las clasificaban. Este enfoque mejoraba la precisión con objetos pequeños, pero aumentaba el coste computacional y reducía el rendimiento en tiempo real.
- Detectores de objetos de una etapa: Los detectores de una etapa, como SSD (detector de un solo disparo) y la familia YOLO (Solo miras una vez), que incluye YOLOv3, Ultralytics YOLOv5 y, posteriormente, Ultralytics YOLOv8, realizan la detección en una sola pasada. Este diseño mejora considerablemente la velocidad de inferencia y mantiene una precisión competitiva.
- Modelos de vanguardia más recientes: Los modelos de detección de objetos más nuevos se centran más en el rendimiento en tiempo real y la implementación edge. Las versiones recientes de los modelos Ultralytics YOLO, como Ultralytics YOLO11 y Ultralytics YOLO26, están diseñadas para equilibrar una gran precisión con una inferencia de baja latencia, por lo que son idóneas para detectar objetos de todos los tamaños, incluidos los objetivos pequeños, en dispositivos con una capacidad de cálculo limitada.
Uso de Ultralytics YOLO11 en casos de uso de detección de objetos pequeños#
Ahora que entendemos mejor cómo funciona la detección de objetos pequeños, veamos un par de aplicaciones del mundo real en las que se puede utilizar Ultralytics YOLO11.
UAV e imágenes aéreas#
Imagina un dron que vuela a gran altura sobre una calle concurrida de una ciudad. Desde esa altura, los coches, las bicicletas e incluso las personas se reducen a unos pocos píxeles en una pantalla.
Los módulos de UAV e imágenes aéreas suelen capturar escenas como esta, en las que los objetos de interés son diminutos y están rodeados de fondos recargados, lo que dificulta su detección para los modelos de visión artificial.
En este tipo de situaciones, Ultralytics YOLO11 puede ser una opción ideal. Por ejemplo, un dron equipado con un modelo como YOLO11, ajustado con conjuntos de datos aéreos como VisDrone, podría vigilar el tráfico en tiempo real y detectar vehículos, ciclistas y peatones mientras se desplazan por la escena, aunque cada objeto ocupe solo una pequeña parte de la imagen. Esto permite tomar decisiones más rápido y obtener información más precisa en aplicaciones como la gestión del tráfico, la seguridad pública o la planificación urbana.
Robótica y automatización#
Los robots suelen utilizarse en entornos en los que la precisión y el tiempo son fundamentales. En lugares como almacenes, fábricas y granjas, un robot puede necesitar reconocer objetos muy pequeños, como una pieza en una cadena de montaje, una etiqueta en un paquete o un pequeño brote en un campo, y responder rápidamente.
Detectar objetos de este tamaño puede ser complicado, sobre todo cuando aparecen como apenas unos píxeles en la señal de la cámara o quedan parcialmente ocultos por otros objetos. Pasar por alto estos pequeños detalles puede ralentizar la automatización o afectar a la capacidad del robot para completar una tarea.
Ultralytics YOLO11 puede marcar la diferencia en estas situaciones. La mejora de la extracción de características y la rapidez de inferencia permiten a los robots detectar objetos pequeños en tiempo real y actuar de inmediato.
Ultralytics YOLO11 también admite la segmentación de instancias, que puede ayudar a los robots a comprender con mayor precisión los límites de los objetos y los puntos de agarre, en lugar de limitarse a localizar cuadros delimitadores generales. Por ejemplo, un brazo robótico integrado con YOLO11 podría detectar componentes pequeños en una cinta transportadora, segmentar su forma exacta y recogerlos antes de que salgan de su alcance, lo que ayudaría a mantener la eficiencia y la fiabilidad del sistema.
Qué hace que Ultralytics YOLO11 sea eficaz para detectar objetos pequeños#
Con tantos modelos de visión artificial disponibles hoy en día, quizá te preguntes qué diferencia a Ultralytics YOLO11.
Estas son algunas de las razones por las que Ultralytics YOLO11 es una gran opción para aplicaciones en las que es necesario detectar objetos pequeños:
- Mejor extracción de características: YOLO11 utiliza una arquitectura de backbone y neck mejorada para optimizar la extracción de características y permitir una detección de objetos más precisa.
- Ecosistema y facilidad de uso: el paquete Python de Ultralytics es una biblioteca que ofrece funciones integradas para cargar, entrenar, validar e implementar modelos como YOLO11. Como estos flujos de trabajo requieren solo unas pocas líneas de código, los equipos pueden experimentar y ajustar modelos rápidamente para detectar objetos pequeños.
- Optimizado para la implementación en el edge: Ultralytics YOLO11 puede ejecutarse de forma eficiente en dispositivos edge como NVIDIA Jetson, Raspberry Pi y sistemas de cámaras industriales. En pocas palabras, permite realizar tareas de IA visual en tiempo real directamente en el dispositivo.
Estrategias prácticas para detectar objetos pequeños con Ultralytics YOLO11#
Además de usar un modelo como Ultralytics YOLO11, la forma de preparar las anotaciones, el conjunto de datos en su conjunto y el procedimiento de entrenamiento del modelo pueden marcar una diferencia significativa en el rendimiento de detección. El argumento tile de Ultralytics también puede ayudar a detectar objetos muy pequeños en imágenes grandes: los mosaicos de alta resolución ejecutan el entrenamiento, la validación y la inferencia sobre ventanas superpuestas a resolución nativa.
Este es un breve resumen de los aspectos en los que debes centrarte:
- Aumento de datos adecuado: Un aumento de datos moderado, como el escalado o el recorte, puede ayudar al modelo a generalizar a imágenes nuevas. Sin embargo, un aumento de datos agresivo a gran escala puede deformar o eliminar objetos pequeños y dificultar que el modelo los aprenda.
- Análisis de los casos de fallo: Analizar en qué situaciones el modelo no detecta o identifica mal los objetos ayuda a establecer una referencia y a determinar si los problemas se deben al conjunto de datos, a la pérdida de información durante la extracción de características o a la necesidad de ajustar la configuración del entrenamiento.
- Composición del conjunto de datos: Tu conjunto de datos debe contener suficientes ejemplos de objetos pequeños para que el modelo aprenda patrones significativos y debe mantener el equilibrio, de modo que los objetos grandes no eclipsen a los pequeños durante el entrenamiento.
Conclusiones clave#
La detección de objetos pequeños es difícil porque los objetivos pequeños pierden detalle a medida que las imágenes pasan por un modelo de visión artificial. Ultralytics YOLO11 mejora la conservación de estos detalles, lo que hace que la detección de objetos pequeños sea más fiable sin sacrificar el rendimiento en tiempo real. Este equilibrio permite que YOLO11 ofrezca una detección precisa y eficiente en aplicaciones del mundo real.
¡Únete a nuestra comunidad, que no deja de crecer! Explora nuestro repositorio de GitHub para aprender más sobre IA. Descubre innovaciones como la visión artificial en el comercio minorista y la IA en la industria automovilística visitando nuestras páginas de soluciones. Para empezar hoy mismo a crear con visión artificial, consulta nuestras opciones de licencia.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









