Modelos y aprendizaje multimodales: ampliando las capacidades de la IA
Explora cómo los modelos multimodales integran texto, imágenes, audio y datos de sensores para mejorar la percepción, el razonamiento y la toma de decisiones de la IA.
Los sistemas de IA tradicionales suelen procesar información de una única fuente de datos, como texto, imágenes o audio. Aunque estos enfoques unimodales destacan en tareas especializadas, a menudo no pueden gestionar escenarios complejos del mundo real que implican varias entradas simultáneas. El aprendizaje multimodal aborda este problema al integrar diversos flujos de datos en un marco unificado, lo que permite una comprensión más rica y sensible al contexto.
Inspirados en la percepción humana, los modelos multimodales analizan, interpretan y actúan a partir de entradas combinadas, como hacen las personas al integrar de forma natural la vista, el sonido y el lenguaje. Estos modelos permiten que la IA gestione situaciones complejas con mayor precisión, solidez y adaptabilidad.
En este artículo, veremos cómo han evolucionado los modelos multimodales, explicaremos cómo funcionan, analizaremos sus aplicaciones prácticas en la visión artificial y evaluaremos las ventajas y los retos de integrar varios tipos de datos.
¿Qué es el aprendizaje multimodal?#
Quizá te preguntes qué es exactamente el aprendizaje multimodal y por qué es importante para la inteligencia artificial (AI). Los modelos de IA tradicionales suelen procesar un tipo de dato cada vez, ya sean imágenes, texto, audio o entradas de sensores.
Sin embargo, el aprendizaje multimodal va un paso más allá y permite que los sistemas analicen, interpreten e integren simultáneamente diversos flujos de datos. Este enfoque reproduce fielmente la forma en que el cerebro humano integra de manera natural información visual, auditiva y lingüística para construir una comprensión coherente del mundo.
Al combinar estas distintas modalidades, la IA multimodal logra una comprensión más profunda y matizada de situaciones complejas.
Por ejemplo, al analizar secuencias de vídeo, un sistema multimodal no se limita a procesar el contenido visual, sino que también tiene en cuenta los diálogos hablados, los sonidos ambientales y los subtítulos.
Esta perspectiva integrada permite que la IA capte el contexto y los matices que se perderían si cada tipo de dato se analizara por separado.
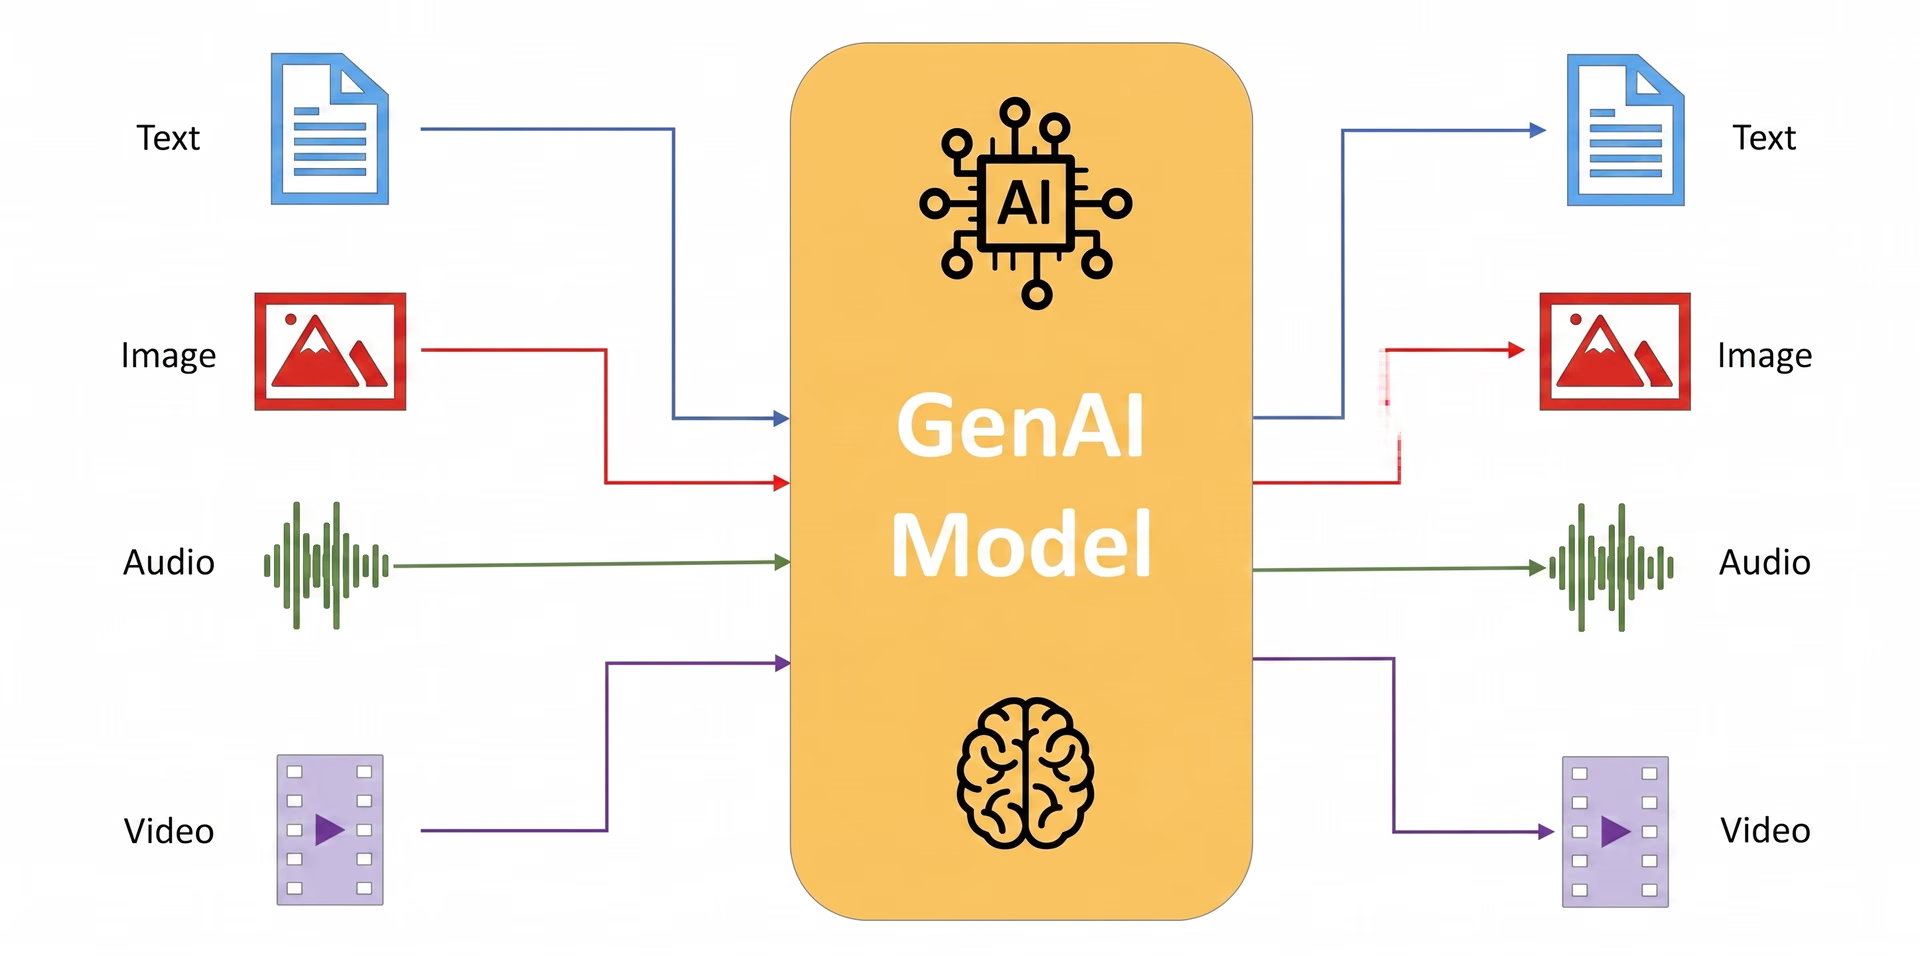
Fig. 1. Los modelos de aprendizaje multimodal integran distintos tipos de datos.
En la práctica, el aprendizaje multimodal amplía las posibilidades de la IA. Impulsa aplicaciones como la generación de descripciones de imágenes, la respuesta a preguntas basadas en el contexto visual, la creación de imágenes realistas a partir de descripciones de texto y la mejora de los sistemas interactivos para hacerlos más intuitivos y sensibles al contexto.
Pero ¿cómo combinan los modelos multimodales estos distintos tipos de datos para obtener esos resultados? Veamos paso a paso los mecanismos fundamentales que explican su eficacia.
¿Cómo funcionan los modelos de IA multimodales?#
Los modelos de IA multimodales logran sus potentes capacidades mediante procesos especializados: extracción de características independiente para cada modalidad (procesar por separado cada tipo de dato, como imágenes, texto o audio), métodos de fusión (combinar los detalles extraídos) y técnicas avanzadas de alineación (garantizar que la información combinada encaje de forma coherente).
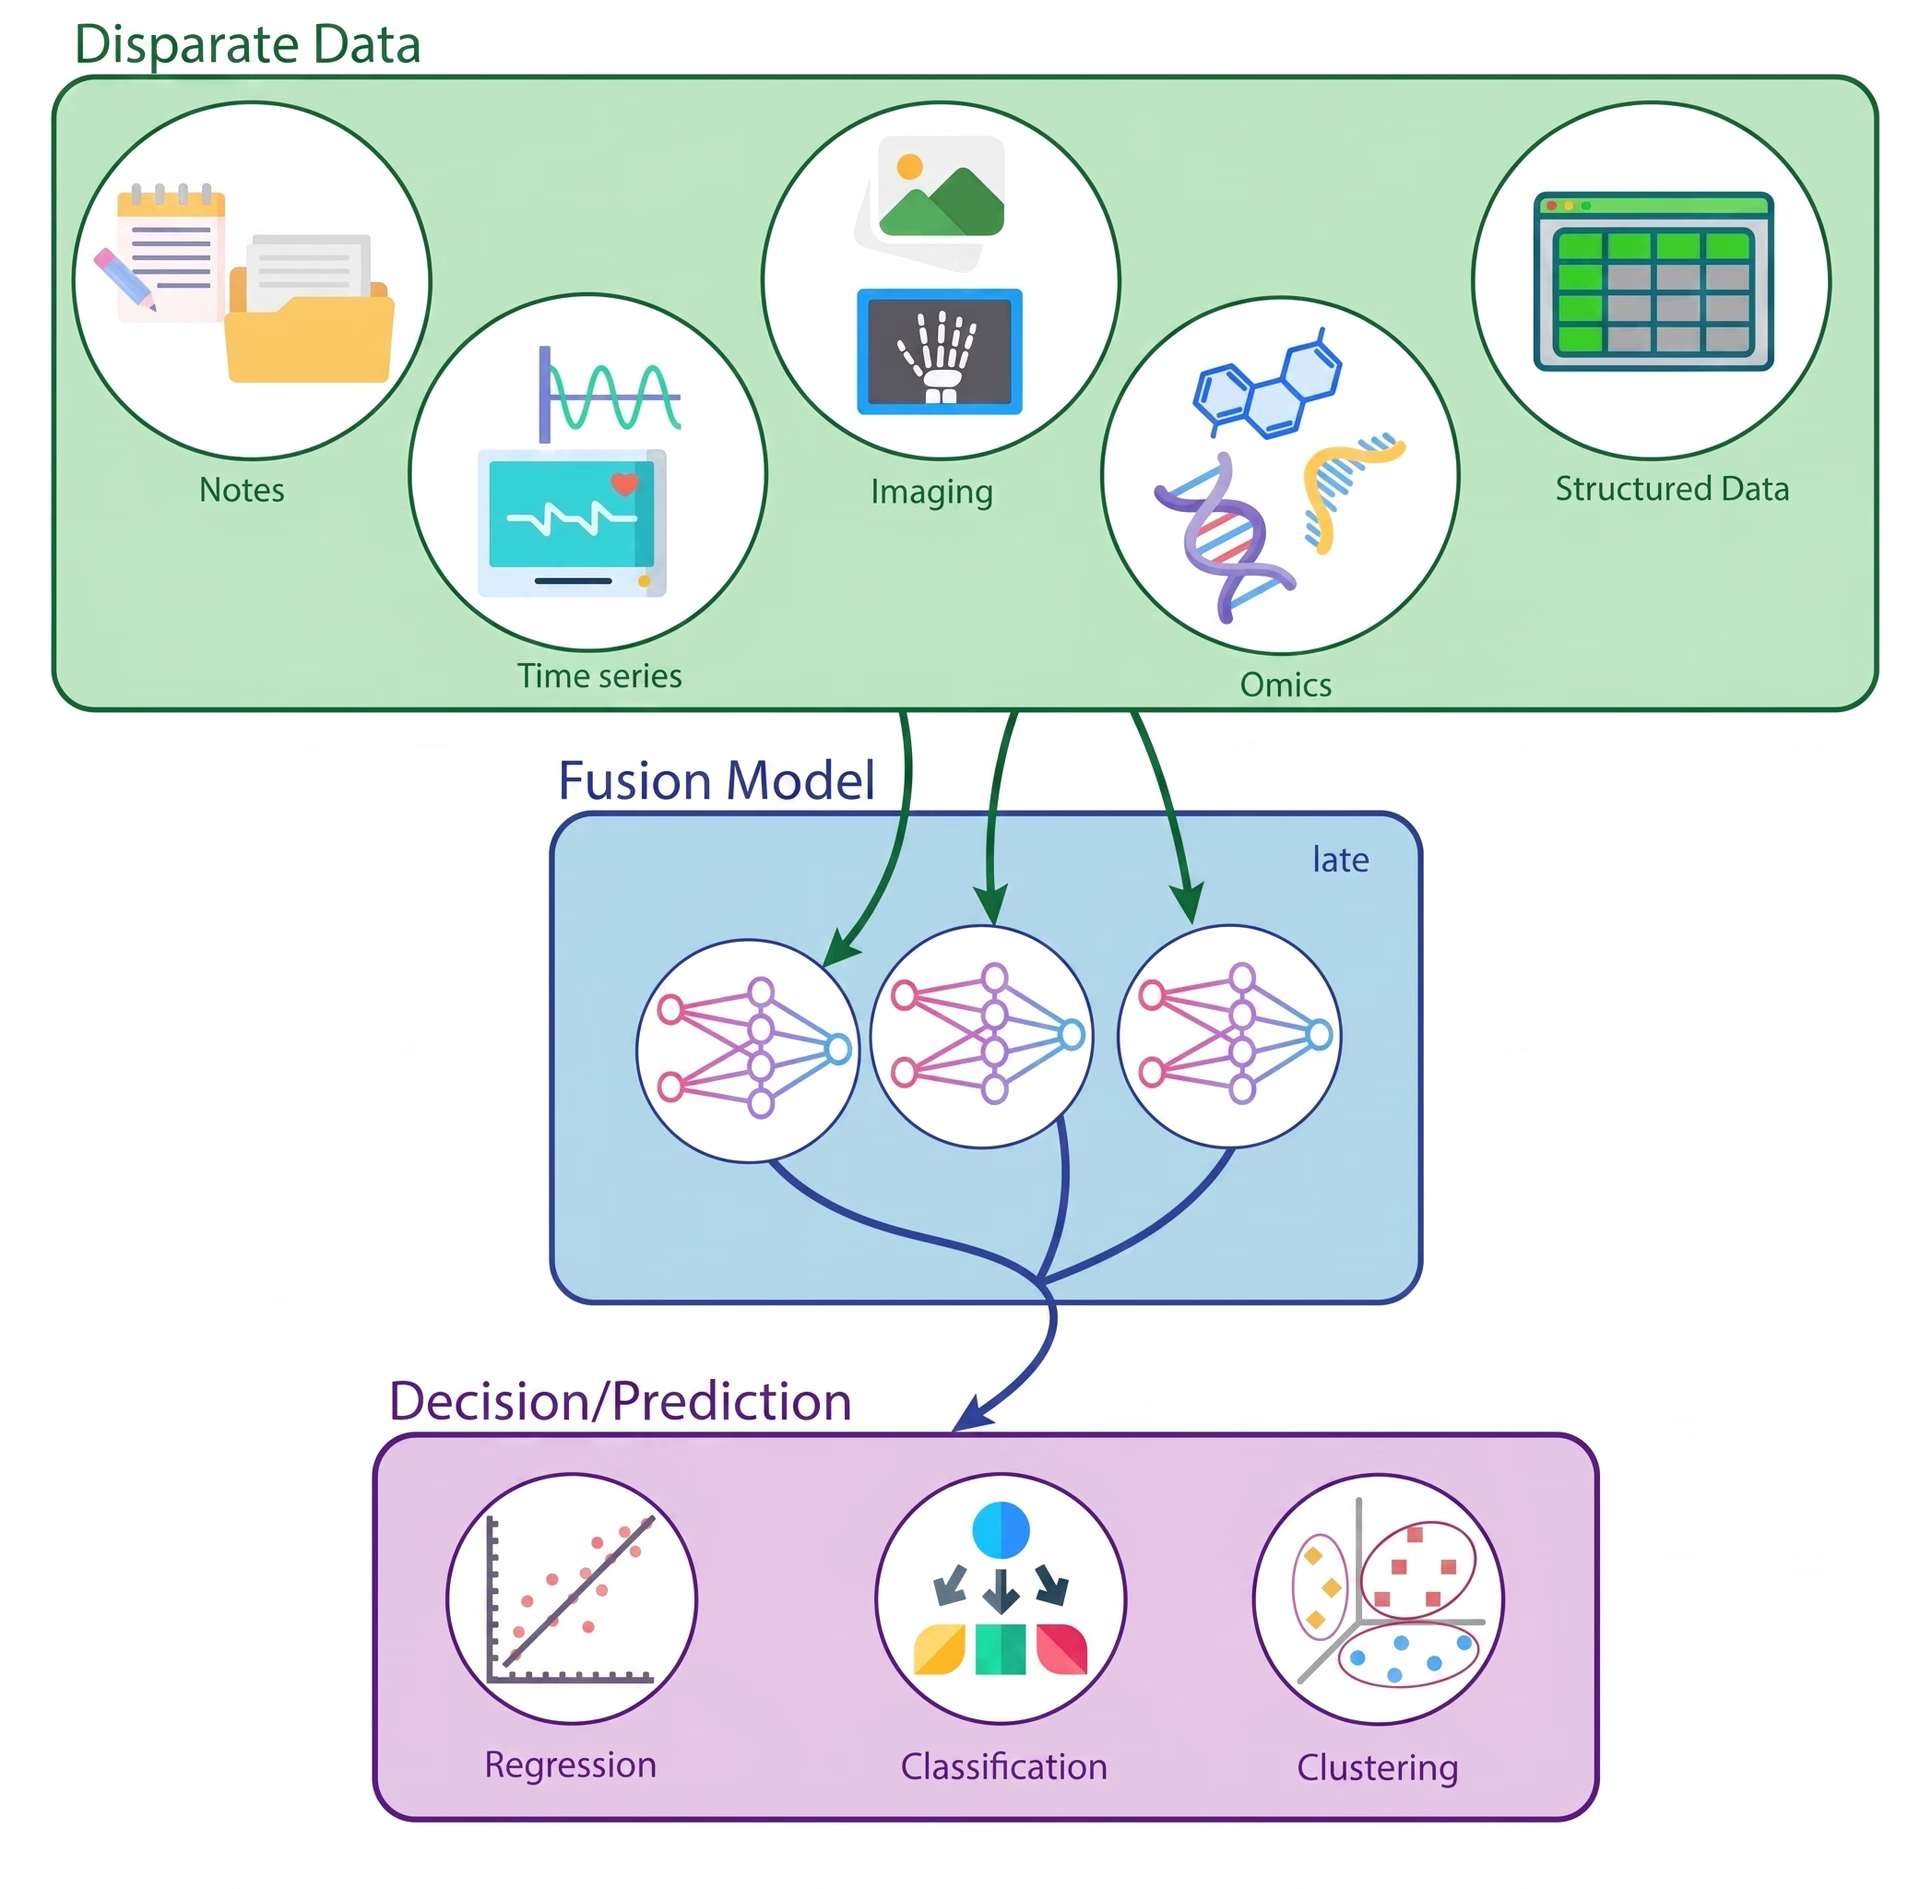
Fig. 2. Flujo de integración y fusión de datos multimodales para tareas predictivas.
Veamos con más detalle cómo funciona cada uno de estos procesos.
Extracción de características independiente para cada modalidad#
Los modelos de IA multimodales utilizan arquitecturas distintas y especializadas para cada tipo de dato. Esto significa que los sistemas diseñados específicamente para ello procesan las entradas visuales, textuales y de audio o sensores. Así, el modelo puede captar los detalles únicos de cada entrada antes de combinarlas.
Estos son algunos ejemplos de cómo se utilizan distintas arquitecturas especializadas para extraer características de varios tipos de datos:
- Datos visuales: Las redes neuronales convolucionales (CNNs) o los Vision Transformers interpretan la información visual de imágenes y vídeos y generan representaciones detalladas de características.
- Datos textuales: Los modelos basados en Transformer, como los de la familia GPT, convierten las entradas de texto en incrustaciones semánticas con significado.
- Datos de audio y sensores: Las redes neuronales especializadas procesan formas de onda de audio o entradas de sensores espaciales para representar con precisión cada modalidad y conservar sus características distintivas.
Una vez procesada por separado, cada modalidad genera características de alto nivel optimizadas para captar la información única que contiene ese tipo de dato concreto.
Técnicas de fusión de características#
Tras extraer las características, los modelos multimodales las combinan en una representación unificada y coherente. Para hacerlo de forma eficaz, se utilizan varias estrategias de fusión:
- Fusión temprana: Combina los vectores de características extraídos justo después de procesar cada modalidad. Esta estrategia favorece interacciones más profundas entre modalidades desde las primeras etapas del proceso de análisis.
- Fusión tardía: Mantiene separadas las modalidades hasta las etapas finales de toma de decisiones, en las que se combinan las predicciones de cada modalidad, normalmente mediante métodos de conjunto como el promedio o la votación.
- Fusión híbrida: Las arquitecturas modernas suelen integrar características varias veces a lo largo de las distintas capas del modelo y utilizan mecanismos de coatención para destacar y alinear dinámicamente las interacciones importantes entre modalidades. Por ejemplo, la fusión híbrida puede dar prioridad a la alineación en tiempo real de palabras habladas o frases de texto concretas con las características visuales correspondientes.
Alineación entre modalidades y mecanismos de atención#
Por último, los sistemas multimodales utilizan técnicas avanzadas de alineación y atención para garantizar que los datos de distintas modalidades se correspondan correctamente.
Métodos como el aprendizaje contrastivo ayudan a alinear estrechamente las representaciones visuales y textuales en un espacio semántico compartido. Así, los modelos multimodales pueden establecer conexiones sólidas y significativas entre distintos tipos de datos y garantizar la coherencia entre lo que el modelo «ve» y «lee».
Los mecanismos de atención basados en Transformer mejoran aún más esta alineación al permitir que los modelos se centren dinámicamente en los aspectos más pertinentes de cada entrada. Por ejemplo, las capas de atención permiten que el modelo conecte directamente descripciones de texto concretas con las regiones correspondientes de los datos visuales, lo que mejora considerablemente la precisión en tareas complejas como la respuesta a preguntas visuales (VQA) y la generación de descripciones de imágenes.
Estas técnicas mejoran la capacidad de la IA multimodal para comprender profundamente el contexto y permiten que la IA ofrezca interpretaciones más matizadas y precisas de datos complejos del mundo real.
La evolución de la IA multimodal#
La IA multimodal ha evolucionado considerablemente y ha pasado de las primeras técnicas basadas en reglas a sistemas avanzados de aprendizaje profundo capaces de integrar datos de forma sofisticada.
En sus inicios, los sistemas multimodales combinaban distintos tipos de datos, como imágenes, audio o entradas de sensores, mediante reglas creadas manualmente por expertos o métodos estadísticos sencillos. Por ejemplo, los primeros sistemas de navegación robótica combinaban imágenes de cámaras con datos de sonar para detectar y evitar obstáculos. Aunque eran eficaces, estos sistemas requerían un amplio trabajo manual de ingeniería de características y tenían una capacidad limitada para adaptarse y generalizar.
Con la llegada del aprendizaje profundo, los modelos multimodales ganaron mucha popularidad. Las redes neuronales, como los autoencoders multimodales, empezaron a aprender representaciones conjuntas de distintos tipos de datos, en particular imágenes y texto, lo que permitió a la IA realizar tareas como la recuperación entre modalidades y encontrar imágenes basándose únicamente en descripciones textuales.
Los avances continuaron con sistemas como la respuesta visual a preguntas (VQA), que integraban CNN para procesar imágenes y RNN o transformers para interpretar texto. Esto permitió a los modelos de IA responder con precisión a preguntas complejas y dependientes del contexto sobre contenido visual.
Más recientemente, los modelos multimodales a gran escala, entrenados con conjuntos de datos masivos de dimensiones propias de Internet, han revolucionado aún más las capacidades de la IA.
Estos modelos aprovechan técnicas como el aprendizaje contrastivo, que les permite identificar relaciones generalizables entre el contenido visual y las descripciones textuales. Al tender puentes entre modalidades, las arquitecturas multimodales modernas han mejorado la capacidad de la IA para realizar tareas complejas de razonamiento visual con una precisión casi humana, lo que demuestra hasta qué punto ha avanzado la IA multimodal desde sus etapas iniciales.
Explorar el aprendizaje multimodal en la visión artificial#
Ahora que hemos visto cómo los modelos multimodales integran flujos de datos diversos, veamos cómo pueden aplicarse estas capacidades a los modelos de visión artificial.
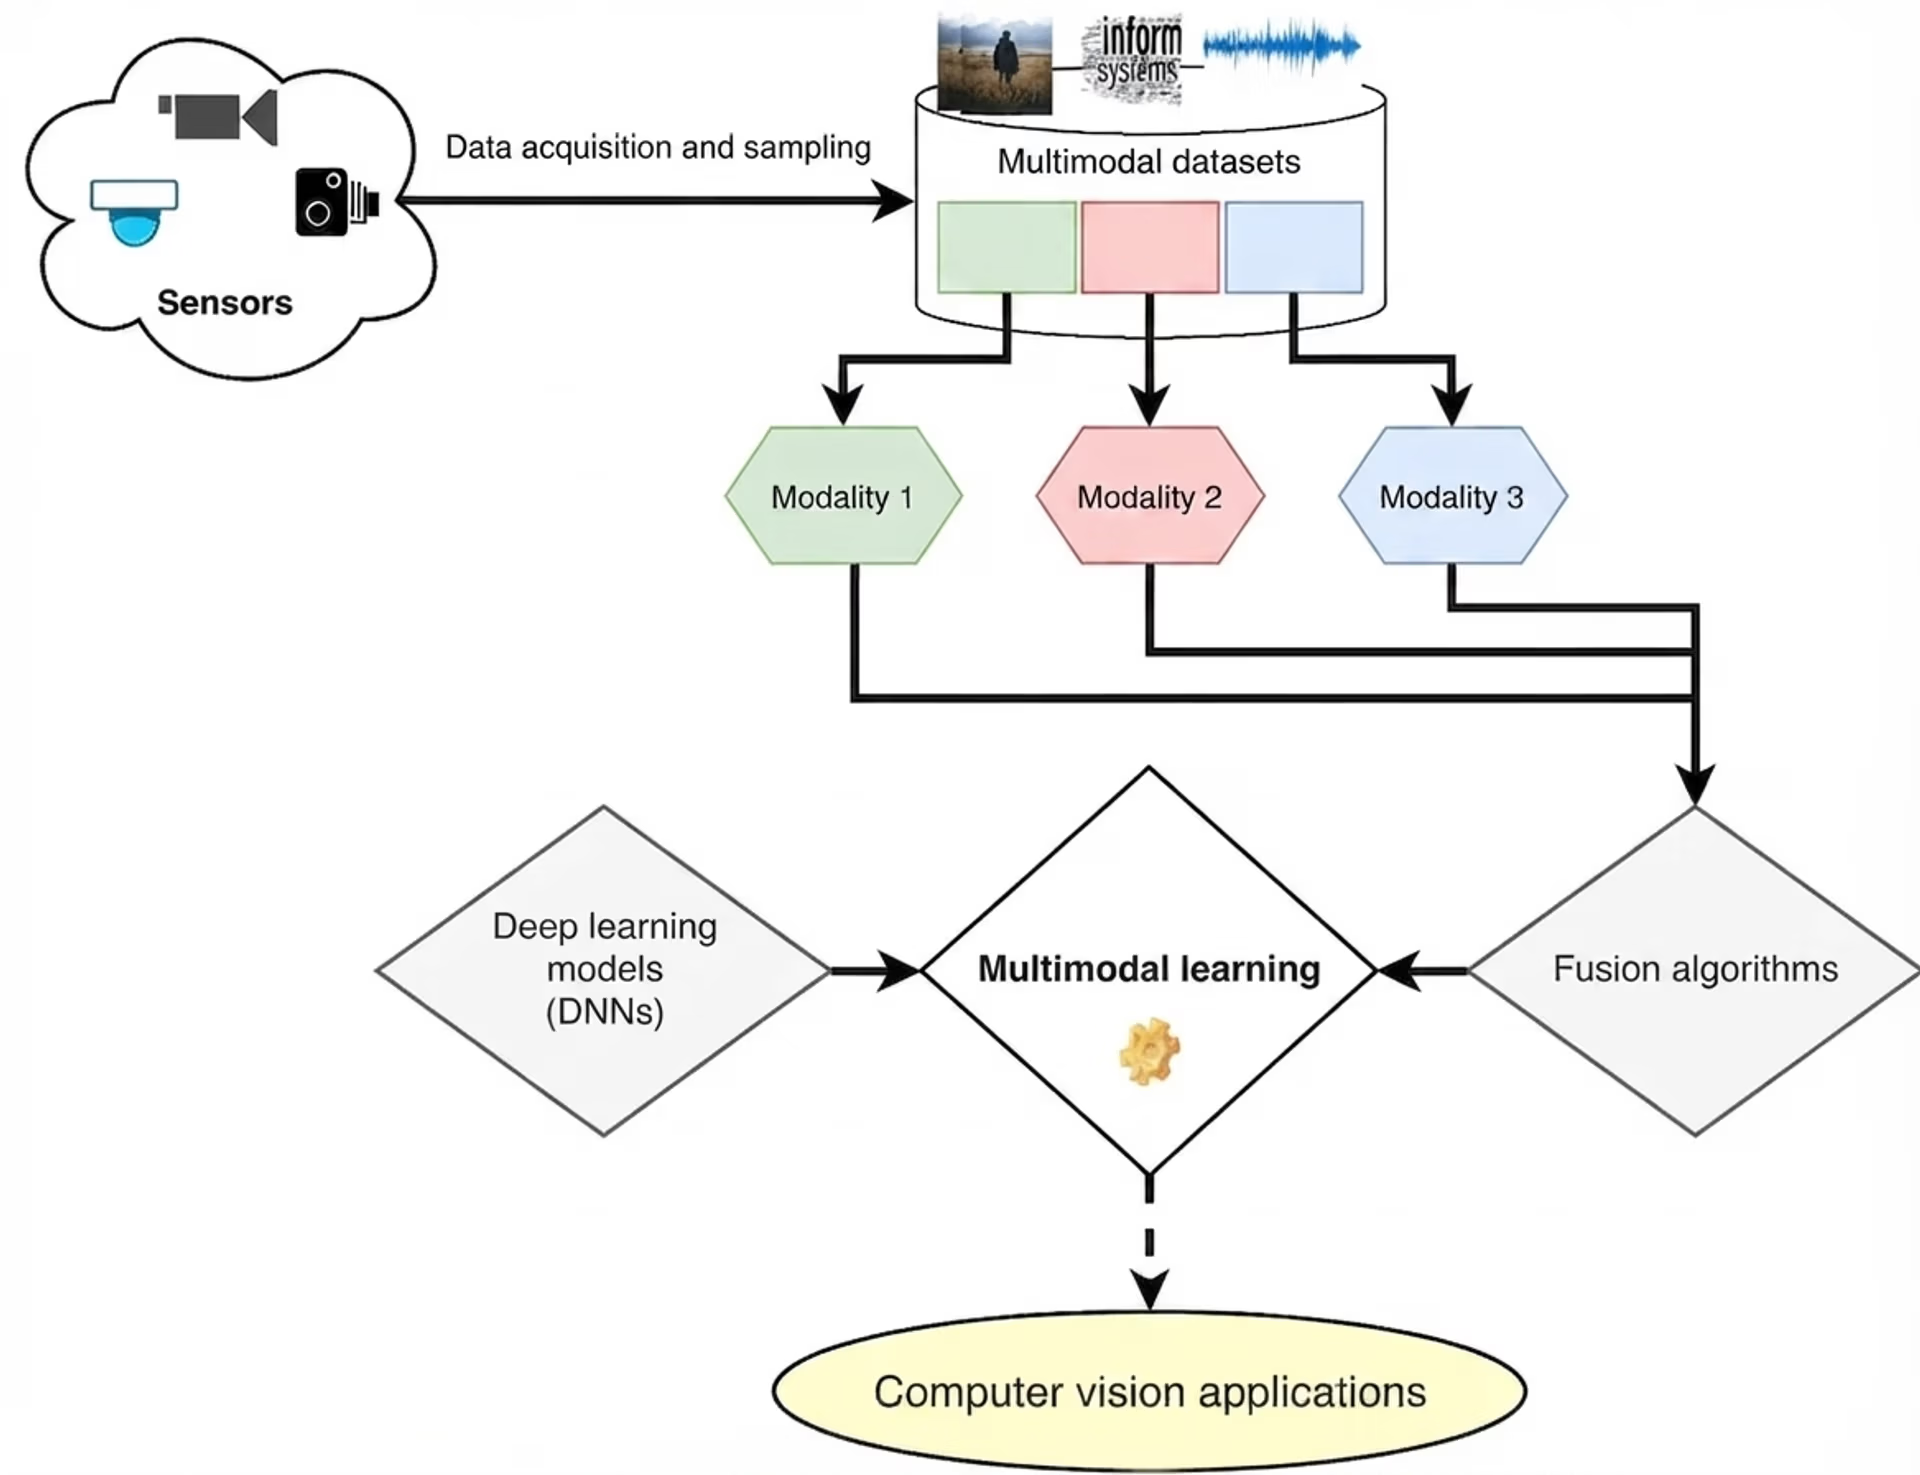
Fig. 3. Flujo de trabajo del aprendizaje multimodal aplicado a la visión artificial.
Al combinar entradas visuales con texto, audio o datos de sensores, el aprendizaje multimodal permite a los sistemas de IA abordar aplicaciones cada vez más sofisticadas y ricas en contexto.
Generación de pies de foto#
La generación de pies de foto consiste en crear descripciones en lenguaje natural para datos visuales. Los métodos tradicionales de detección de objetos identifican objetos individuales, pero la generación multimodal de pies de foto va más allá e interpreta relaciones y contextos.
Por ejemplo, un modelo multimodal puede analizar una imagen de personas en un pícnic y generar un pie de foto descriptivo como «Una familia de pícnic en un parque soleado», ofreciendo un resultado más completo y accesible.
Esta aplicación es importante para la accesibilidad. Puede utilizarse para generar texto alternativo para personas con discapacidad visual y etiquetar contenido en grandes bases de datos. Las arquitecturas Transformer desempeñan aquí un papel fundamental, ya que permiten que el módulo de generación de texto se centre en las áreas visuales pertinentes mediante mecanismos de atención y alinee dinámicamente las descripciones textuales con las características visuales.
Respuesta visual a preguntas (VQA)#
Los modelos VQA responden a preguntas en lenguaje natural basándose en contenido visual y combinan la visión artificial con la comprensión del lenguaje. Estas tareas requieren una comprensión detallada del contenido de la imagen, el contexto y el razonamiento semántico.
Las arquitecturas Transformer han mejorado la VQA al permitir que los componentes textuales y visuales del modelo interactúen dinámicamente y localicen con precisión las regiones de la imagen relacionadas con la pregunta.
Por ejemplo, el modelo PaLI de Google utiliza arquitecturas avanzadas basadas en Transformer que integran transformers visuales (ViT) con codificadores y decodificadores de lenguaje, lo que permite responder con precisión a preguntas sofisticadas como «¿Qué está haciendo la mujer de la imagen?» o «¿Cuántos animales se ven?».
Las capas de atención, que ayudan a los modelos a centrarse en las partes más pertinentes de una entrada, garantizan que cada palabra de la pregunta se vincule dinámicamente con indicios visuales, lo que permite dar respuestas matizadas que van más allá de la detección básica de objetos.
Generación de texto a imagen#
La generación de texto a imagen se refiere a la capacidad de la IA para crear contenido visual directamente a partir de descripciones textuales, tendiendo un puente entre la comprensión semántica y la creación visual.
Los modelos multimodales que realizan esta tarea emplean arquitecturas neuronales avanzadas, como transformers o procesos de difusión, para generar imágenes detalladas y precisas en su contexto.
Por ejemplo, imagina generar datos sintéticos de entrenamiento para modelos de visión artificial encargados de la detección de vehículos. A partir de descripciones textuales como «un sedán rojo aparcado en una calle concurrida» o «un SUV blanco circulando por una autopista», estos modelos multimodales pueden producir imágenes variadas y de gran calidad que representan esas situaciones concretas.
Esta capacidad permite a investigadores y desarrolladores ampliar eficazmente los conjuntos de datos de detección de objetos sin tener que capturar manualmente miles de imágenes, lo que reduce considerablemente el tiempo y los recursos necesarios para recopilar datos.
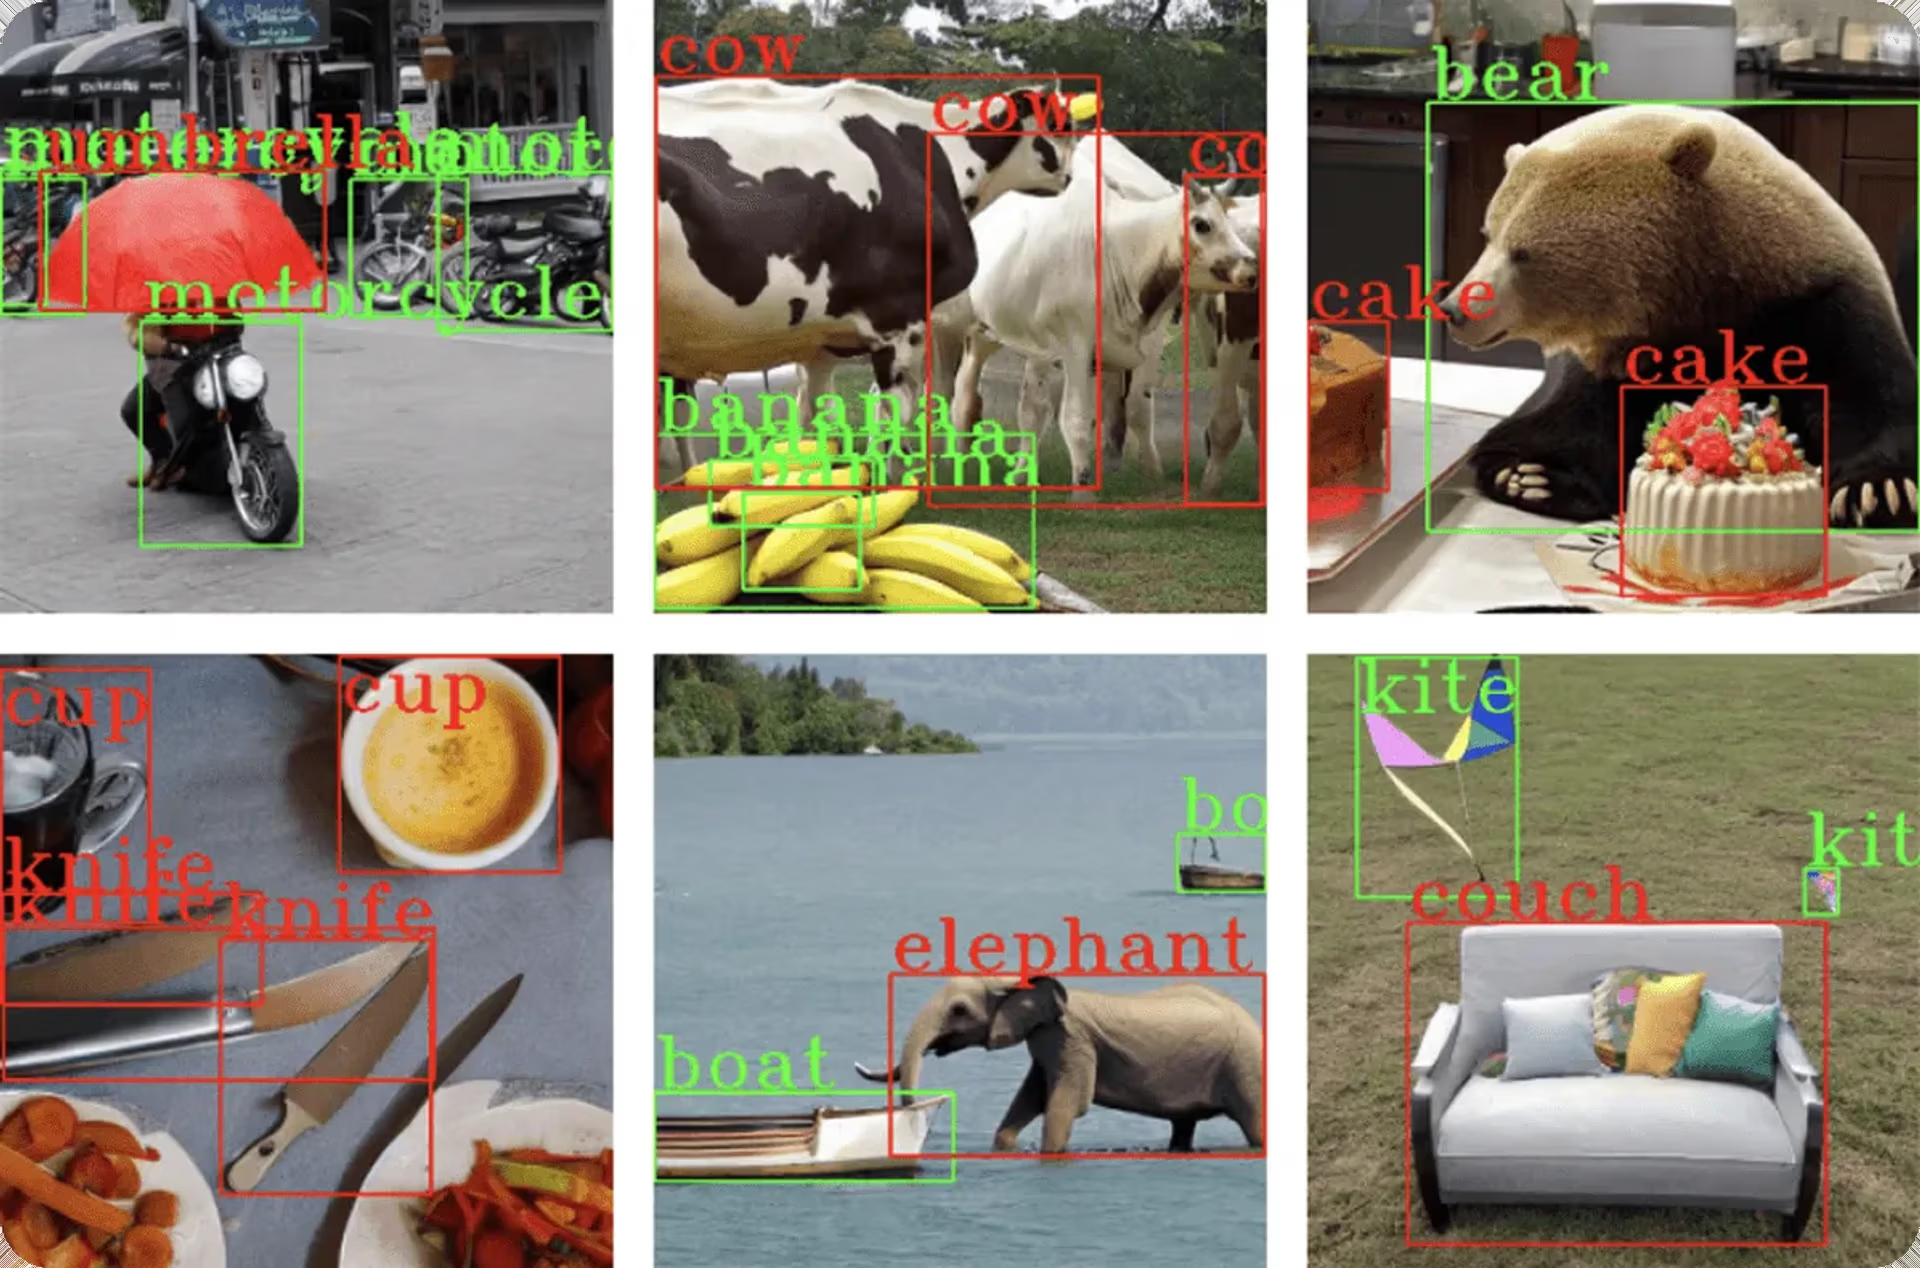
Fig. 4. Ejemplos de resultados de un modelo de detección de objetos entrenado con conjuntos de datos sintéticos.
Los métodos más recientes aplican técnicas basadas en difusión: parten de ruido visual aleatorio y refinan la imagen progresivamente para que se ajuste estrechamente a la entrada textual. Este proceso iterativo puede crear ejemplos realistas y variados, y garantizar datos de entrenamiento robustos que abarquen distintos puntos de vista, condiciones de iluminación, tipos de vehículos y fondos.
Este enfoque resulta especialmente valioso en visión artificial, ya que permite ampliar rápidamente los conjuntos de datos, mejorar la precisión de los modelos y aumentar la diversidad de situaciones que los sistemas de IA pueden reconocer de forma fiable.
Recuperación de imágenes y texto#
Los sistemas de recuperación multimodal facilitan las búsquedas al convertir tanto el texto como las imágenes a un lenguaje común de significado. Por ejemplo, los modelos entrenados con conjuntos de datos enormes —como CLIP, que aprendió a partir de millones de pares de imágenes y texto— pueden relacionar las consultas de texto con las imágenes adecuadas y ofrecer resultados de búsqueda más intuitivos y precisos.
Por ejemplo, una consulta de búsqueda como «atardecer en una playa» devuelve resultados visualmente precisos, lo que mejora considerablemente la eficiencia para descubrir contenido en plataformas de comercio electrónico, archivos multimedia y bases de datos de fotografías de archivo.
El enfoque multimodal garantiza la precisión de la recuperación incluso cuando las consultas y las descripciones de las imágenes están en idiomas distintos, gracias a las alineaciones semánticas aprendidas entre los dominios visual y textual.
Ventajas e inconvenientes de los modelos multimodales en la IA#
El aprendizaje multimodal ofrece varias ventajas clave que mejoran las capacidades de la IA en visión artificial y otros ámbitos:
- Comprensión contextual más rica: Al combinar varios flujos de entrada, los modelos multimodales logran una comprensión más profunda y matizada de situaciones complejas del mundo real.
- Mayor precisión: La comparación cruzada de varias fuentes de datos reduce los errores de reconocimiento y razonamiento, y mejora la fiabilidad general.
- Mayor robustez: Los sistemas multimodales siguen siendo eficaces aunque una fuente de datos se vea afectada (por ejemplo, por una iluminación deficiente en las entradas visuales o por ruido en los datos de audio).
A pesar de estas ventajas, los modelos multimodales también presentan sus propios desafíos:
- Complejidad computacional: Procesar varias modalidades simultáneamente requiere muchos recursos computacionales y aumenta las necesidades de infraestructura.
- Alineación y sincronización de datos: Alinear distintas modalidades con precisión —por ejemplo, hacer coincidir exactamente las señales de audio con los fotogramas visuales— es técnicamente difícil, pero esencial para lograr un rendimiento óptimo.
- Implicaciones éticas: Los sistemas multimodales pueden amplificar involuntariamente los sesgos presentes en los conjuntos de datos de entrenamiento, lo que pone de relieve la importancia de seleccionar cuidadosamente los datos y evaluar continuamente las implicaciones éticas.
Conclusiones clave#
El aprendizaje multimodal está transformando la IA al permitir una comprensión más rica y contextualizada de varios flujos de datos. Aplicaciones de visión artificial como la generación de pies de foto, la respuesta visual a preguntas, la generación de texto a imagen y la mejora de la recuperación de imágenes demuestran el potencial de integrar modalidades diversas.
Aunque persisten los desafíos computacionales y éticos, las innovaciones continuas en arquitecturas, como la fusión basada en Transformer y la alineación contrastiva, siguen abordando estas preocupaciones y acercan la IA multimodal a una inteligencia cada vez más parecida a la humana.
A medida que evolucione este campo, los modelos multimodales serán esenciales para tareas de IA complejas y del mundo real, y mejorarán desde los diagnósticos sanitarios hasta la robótica autónoma. Apostar por el aprendizaje multimodal permite a los sectores aprovechar potentes capacidades que darán forma al futuro de la IA.
¡Únete a nuestra creciente comunidad! Explora nuestro repositorio de GitHub para aprender más sobre la IA. ¿Listo para empezar tus propios proyectos de visión artificial? Consulta nuestras opciones de licencia. Descubre la IA en la industria manufacturera y la IA visual en la conducción autónoma en nuestras páginas de soluciones.









