Comprender la segmentación de conceptos mediante prompts
Descubre la segmentación de conceptos mediante prompts, en qué se diferencia de los métodos tradicionales y cómo modelos relacionados como YOLOE-26 permiten trabajar con vocabulario abierto.
 Abirami Vina15 min de lectura
La IA de visión avanza rápidamente y se utiliza ampliamente para analizar imágenes y vídeos en entornos reales. Por ejemplo, se están integrando modelos de visión artificial en aplicaciones que van desde los sistemas de gestión del tráfico hasta el análisis del comercio minorista.
En muchas de estas aplicaciones, los modelos de visión, como los modelos de detección de objetos, se entrenan para reconocer un conjunto predefinido de objetos, incluidos vehículos, personas y equipos. Durante el entrenamiento, se muestran a estos modelos muchos ejemplos etiquetados para que aprendan el aspecto de cada objeto y a distinguirlo de los demás en una escena.
En las tareas de segmentación, los modelos van un paso más allá y producen contornos precisos a nivel de píxel alrededor de estos objetos. Esto permite a los sistemas entender exactamente dónde se encuentra cada objeto en una imagen.
Este método funciona bien siempre que el sistema solo tenga que reconocer aquello para lo que se ha entrenado. Sin embargo, en entornos reales rara vez ocurre así.
Las escenas visuales suelen ser dinámicas. Aparecen objetos y conceptos visuales nuevos, las condiciones cambian y, a menudo, los usuarios quieren segmentar objetos que no formaban parte de la configuración de entrenamiento original.
Estas limitaciones son especialmente evidentes en la segmentación. A medida que la IA de visión sigue evolucionando, aumenta la necesidad de contar con modelos de segmentación más flexibles, capaces de adaptarse a conceptos nuevos sin tener que volver a entrenarlos continuamente. Por eso está ganando interés la segmentación de conceptos guiada por prompts (PCS).
En lugar de depender de una lista fija de categorías de objetos, los usuarios pueden describir qué quieren segmentar mediante texto, indicaciones visuales o imágenes de ejemplo. A continuación, estos modelos pueden identificar y segmentar todas las regiones que coincidan con el concepto descrito, aunque este no se haya incluido explícitamente durante el entrenamiento.
En este artículo veremos cómo funciona la segmentación de conceptos guiada por prompts, en qué se diferencia de los métodos tradicionales y dónde se utiliza actualmente.
¿Qué es la segmentación de conceptos guiada por prompts?#
En la mayoría de los casos, los modelos de segmentación se entrenan para reconocer una lista reducida de tipos de objetos. Esto funciona bien cuando un sistema de IA de visión solo necesita detectar y segmentar un conjunto específico de objetos.
Sin embargo, en las aplicaciones reales, las escenas visuales son dinámicas. Aparecen objetos nuevos, cambian los requisitos de las tareas y, a menudo, los usuarios necesitan segmentar conceptos que no estaban incluidos en el conjunto de etiquetas original. Para abordar estas situaciones, normalmente hay que recopilar nuevos datos y anotaciones de alta calidad y volver a entrenar el modelo, lo que aumenta los costes y ralentiza la implementación.
La segmentación de conceptos guiada por prompts resuelve este problema al permitir que los usuarios indiquen al modelo qué debe buscar, en lugar de elegir de una lista fija de etiquetas. Los usuarios describen el objeto o la idea que buscan y el modelo resalta todas las zonas coincidentes de la imagen. Así resulta mucho más fácil relacionar la intención del usuario con los píxeles concretos de una imagen.
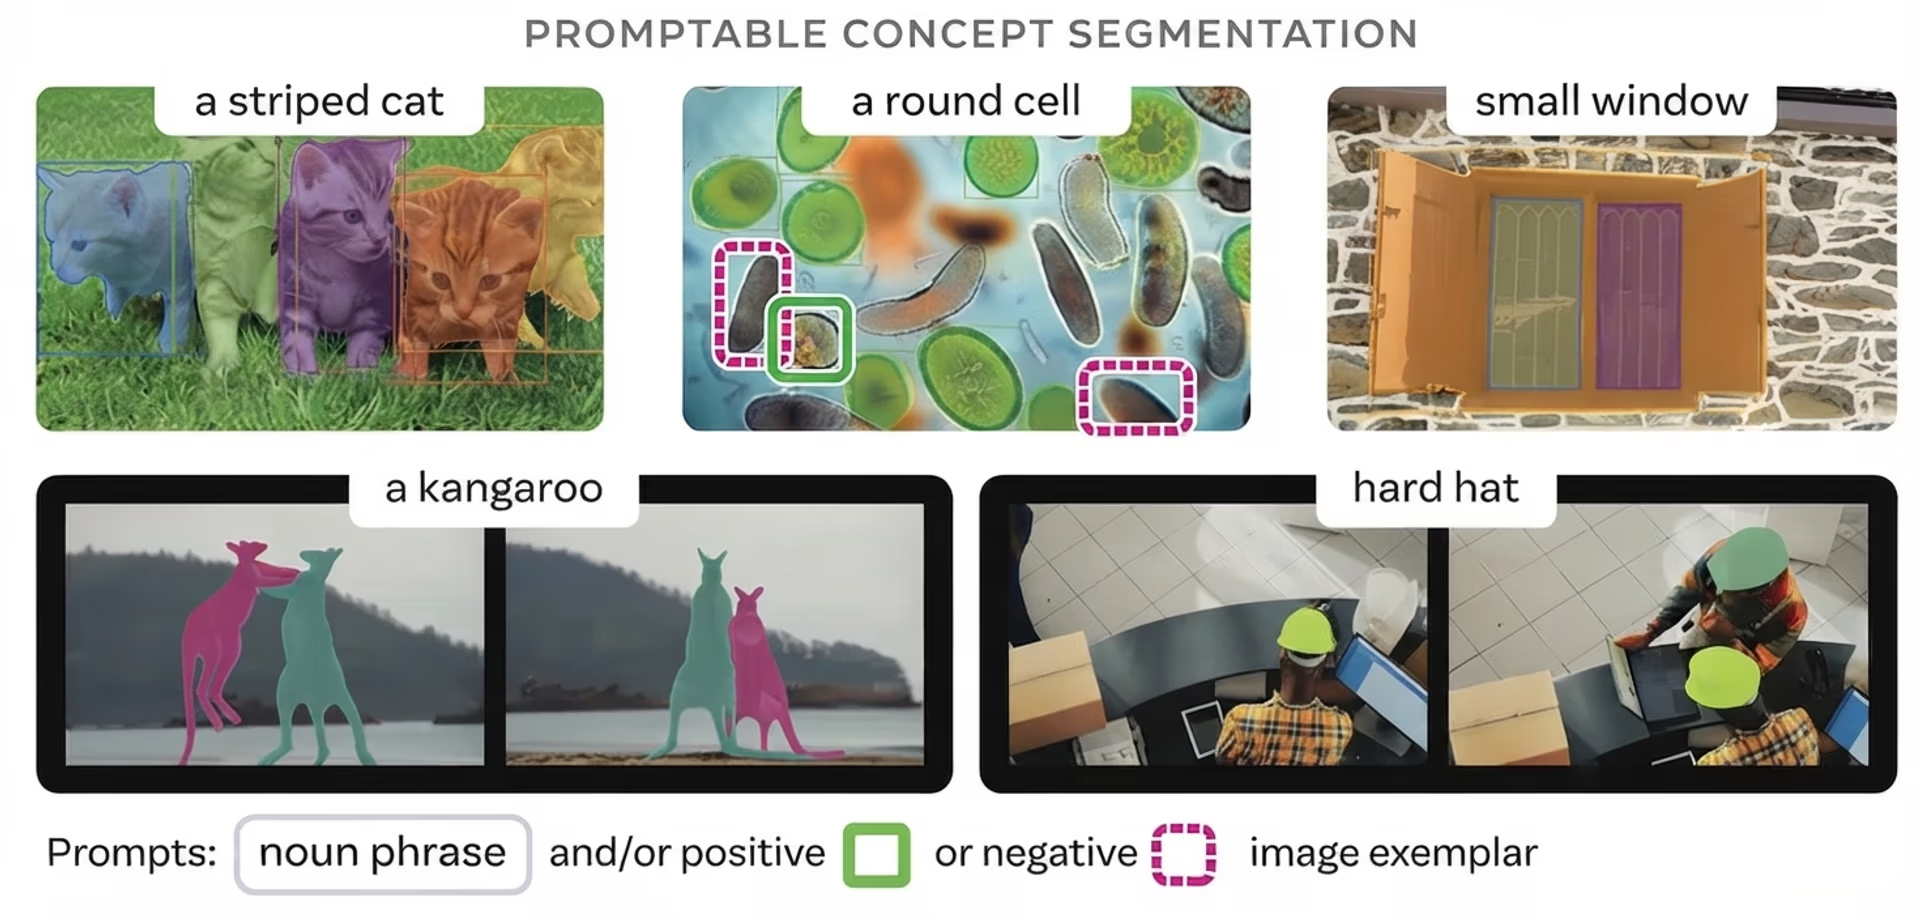
Fig. 1. Ejemplo del uso de prompts de concepto para la segmentación (Fuente)
Guiar la segmentación con distintos tipos de prompts#
Los modelos compatibles con la segmentación de conceptos guiada por prompts son flexibles porque pueden recibir distintos tipos de entradas. En otras palabras, hay varias formas de indicar al modelo qué debe buscar: descripciones de texto, indicaciones visuales o imágenes de ejemplo.
Veamos con más detalle cada método:
- Prompts de texto: Se pueden utilizar frases cortas como «autobús escolar» o «zona tumoral» para describir el concepto que se quiere segmentar. El modelo interpreta el significado de las palabras e identifica las regiones coincidentes.
- Prompts visuales: Estas indicaciones utilizan puntos, recuadros o bocetos aproximados dentro de la imagen como pistas. Estas señales orientan la búsqueda y ayudan a definir el contorno final.
- Imágenes de ejemplo: Las imágenes de referencia o los recortes pequeños representan el concepto de interés. El modelo busca regiones visualmente similares y las segmenta según su aspecto.
Diferencias entre PCS y la segmentación tradicional#
Antes de explicar cómo funciona la segmentación de conceptos guiada por prompts, comparémosla con varios métodos tradicionales de segmentación de objetos.
PCS permite crear modelos de vocabulario abierto y guiados por prompts. Puede trabajar con ideas nuevas descritas mediante prompts, algo que la segmentación tradicional no puede hacer. Hay varios tipos de métodos tradicionales de segmentación, cada uno con sus propias suposiciones y limitaciones.
A continuación, se presentan algunos de los principales tipos de segmentación tradicional:
- Segmentación semántica: Cada píxel de la imagen se etiqueta como parte de una categoría, como carretera, edificio o persona. Se agrupan todos los píxeles con la misma etiqueta, por lo que el modelo no separa las instancias individuales de los objetos.
- Segmentación de instancias: El modelo identifica y segmenta objetos individuales, de modo que trata a dos personas o dos coches como elementos distintos.
- Segmentación panóptica: Esta técnica combina la segmentación semántica y la segmentación de instancias para ofrecer una visión completa de la escena, que abarca tanto las zonas de fondo como los objetos individuales.
Todos estos métodos dependen de una lista predefinida de categorías de objetos. Funcionan bien dentro de ese ámbito, pero no manejan demasiado bien los conceptos que quedan fuera de él. Cuando hay que segmentar un objeto específico nuevo, normalmente se necesitan datos de entrenamiento adicionales y un ajuste fino del modelo.
PCS pretende cambiar esta situación. En lugar de limitarte a categorías predefinidas, te permite describir qué quieres segmentar en una imagen durante la inferencia.
La evolución de los modelos PCS#
A continuación, repasaremos cómo evolucionaron los modelos de segmentación hasta llegar a la segmentación de conceptos guiada por prompts.
Un popular modelo fundacional que marcó un cambio en la segmentación fue SAM, o Segment Anything Model. Se presentó en 2023. En lugar de depender de categorías de objetos predefinidas, SAM permitió a los usuarios guiar la segmentación mediante prompts visuales sencillos, como puntos o cuadros delimitadores.
Con SAM, los usuarios ya no tenían que seleccionar una etiqueta. Bastaba con indicar dónde estaba un objeto para que el modelo generase una máscara. Esto hizo que la segmentación fuera más flexible, pero los usuarios aún tenían que mostrar al modelo dónde buscar.
SAM 2, publicado en 2024, desarrolló esta idea para trabajar con escenas más complejas y ampliar la segmentación guiada por prompts al vídeo. Mejoró la robustez ante distintas condiciones de iluminación, formas de objetos y movimientos, aunque seguía dependiendo principalmente de prompts visuales para guiar la segmentación.
El modelo SAM 3 es el paso más reciente de esta evolución. Se publicó el año pasado y es un modelo unificado que combina la comprensión visual con la orientación lingüística, lo que permite un comportamiento coherente en tareas de segmentación de imágenes y vídeos.
Con SAM 3, los usuarios no tienen que limitarse a señalar objetos o dibujar indicaciones. En su lugar, pueden describir mediante texto qué quieren segmentar, y el modelo busca en la imagen o en los fotogramas del vídeo las regiones que coinciden con esa descripción.
La segmentación se guía por conceptos, no por categorías de objetos fijas, lo que permite utilizar un vocabulario abierto en distintas escenas y a lo largo del tiempo. De hecho, SAM 3 trabaja con un amplio espacio de conceptos aprendido, fundamentado en una ontología derivada de fuentes como Wikidata y ampliada mediante datos de entrenamiento a gran escala.
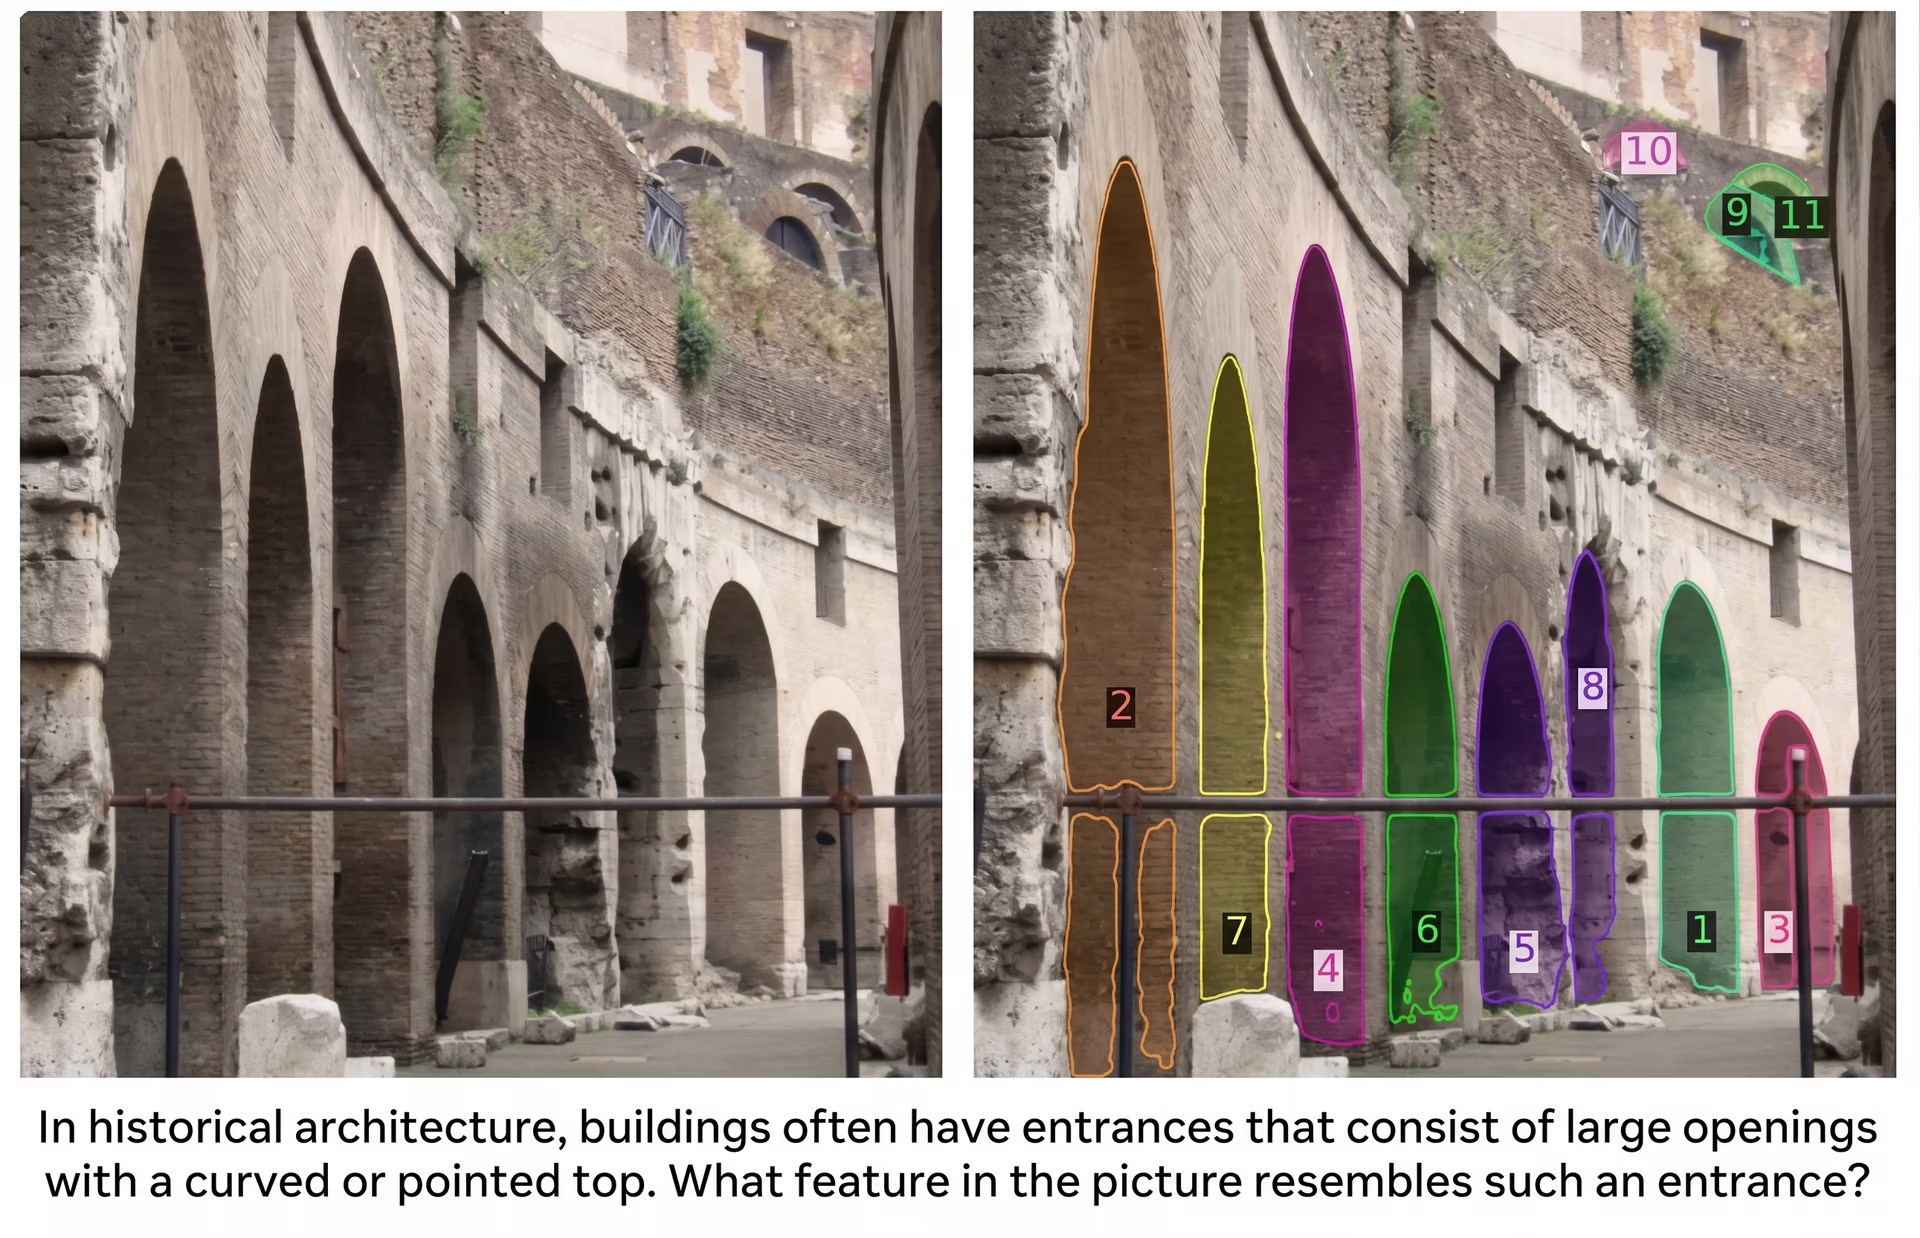
Fig. 2. Ejemplo de cómo indicar a SAM 3 que segmente una sola imagen (Fuente)
En comparación con las versiones anteriores, que dependían sobre todo de indicaciones geométricas, SAM 3 supone un paso hacia una segmentación más flexible y guiada por conceptos. Esto lo hace más adecuado para aplicaciones reales en las que los objetos o ideas de interés pueden cambiar y no siempre se pueden definir de antemano.
Descubre cómo funciona la segmentación de conceptos mediante indicaciones#
Entonces, ¿cómo funciona la segmentación de conceptos guiada por indicaciones? Se basa en grandes modelos de visión y lenguaje preentrenados, entrenados con enormes colecciones de imágenes y, en muchos casos, con textos asociados. Este entrenamiento les permite aprender patrones visuales generales y significado semántico.
La mayoría de los modelos PCS utilizan arquitecturas basadas en Transformer, que procesan una imagen completa de una vez para entender cómo se relacionan entre sí las distintas regiones. Un Transformer de visión extrae características visuales de la imagen, mientras que un codificador de texto convierte las palabras en representaciones numéricas con las que el modelo puede trabajar.
Durante el entrenamiento, estos modelos pueden aprender de distintos tipos de supervisión, incluidas máscaras a nivel de píxel que definen los límites exactos de los objetos, cuadros delimitadores que indican aproximadamente dónde están los objetos y etiquetas a nivel de imagen que describen lo que aparece en ella. El entrenamiento con distintos tipos de datos etiquetados ayuda al modelo a captar tanto los detalles precisos como los conceptos visuales más generales.
En el momento de la inferencia, es decir, cuando el modelo se utiliza realmente para hacer predicciones, PCS sigue un proceso guiado por indicaciones. El usuario proporciona orientación mediante descripciones de texto, referencias visuales como puntos o recuadros, o imágenes de ejemplo. El modelo codifica tanto la indicación como la imagen en una representación interna compartida, o embeddings, e identifica las regiones que coinciden con el concepto descrito.
A continuación, un decodificador de máscaras convierte esta representación común en máscaras de segmentación precisas a nivel de píxel. Como el modelo vincula las características visuales con el significado semántico, puede segmentar conceptos nuevos aunque no se hayan incluido explícitamente durante el entrenamiento.
Además, a menudo se puede perfeccionar el resultado ajustando la indicación o añadiendo instrucciones, lo que ayuda al modelo a gestionar escenas complejas o ambiguas. Este proceso iterativo facilita la optimización práctica durante el despliegue.
Los modelos de segmentación de conceptos guiada por indicaciones suelen evaluarse según su capacidad para segmentar conceptos nunca vistos y la solidez con la que funcionan en distintas escenas. Los benchmarks suelen centrarse en la calidad de las máscaras, la generalización y la eficiencia computacional, aspectos que reflejan los requisitos de despliegue en el mundo real.
Casos de uso de PCS en el mundo real#
A continuación, veamos dónde se está utilizando ya la segmentación de conceptos guiada por indicaciones y dónde empieza a tener un impacto real.
Segmentación flexible para el diagnóstico por imagen#
El diagnóstico por imagen abarca muchas estructuras biológicas, enfermedades y tipos de exploración, y cada día surgen casos nuevos. A los modelos de segmentación tradicionales les cuesta seguir el ritmo de esta variedad.
PCS encaja de forma natural en este ámbito porque permite a los profesionales clínicos describir lo que quieren encontrar, en lugar de elegir de una lista breve y rígida. Con indicaciones de texto o visuales, PCS puede segmentar directamente órganos o zonas preocupantes, sin tener que volver a entrenar el modelo para cada tarea nueva. Esto facilita atender distintas necesidades clínicas, reduce la necesidad de dibujar máscaras manualmente y funciona con muchos tipos de imágenes.
Un buen ejemplo es MedSAM-3, que adapta la arquitectura de SAM 3 para PCS guiada por indicaciones de texto en el diagnóstico por imagen. Este modelo admite indicaciones con términos anatómicos y patológicos específicos, como nombres de órganos —por ejemplo, hígado o riñón— y conceptos relacionados con lesiones, como tumor o lesión. Con una indicación, el modelo segmenta directamente la región correspondiente en la imagen médica.
MedSAM-3 también integra grandes modelos de lenguaje multimodales (MLLMs o LLM multimodales), capaces de razonar tanto sobre texto como sobre imágenes. Estos modelos funcionan en una configuración con un agente en el bucle, en la que los resultados se perfeccionan de forma iterativa para mejorar la precisión en los casos más difíciles.
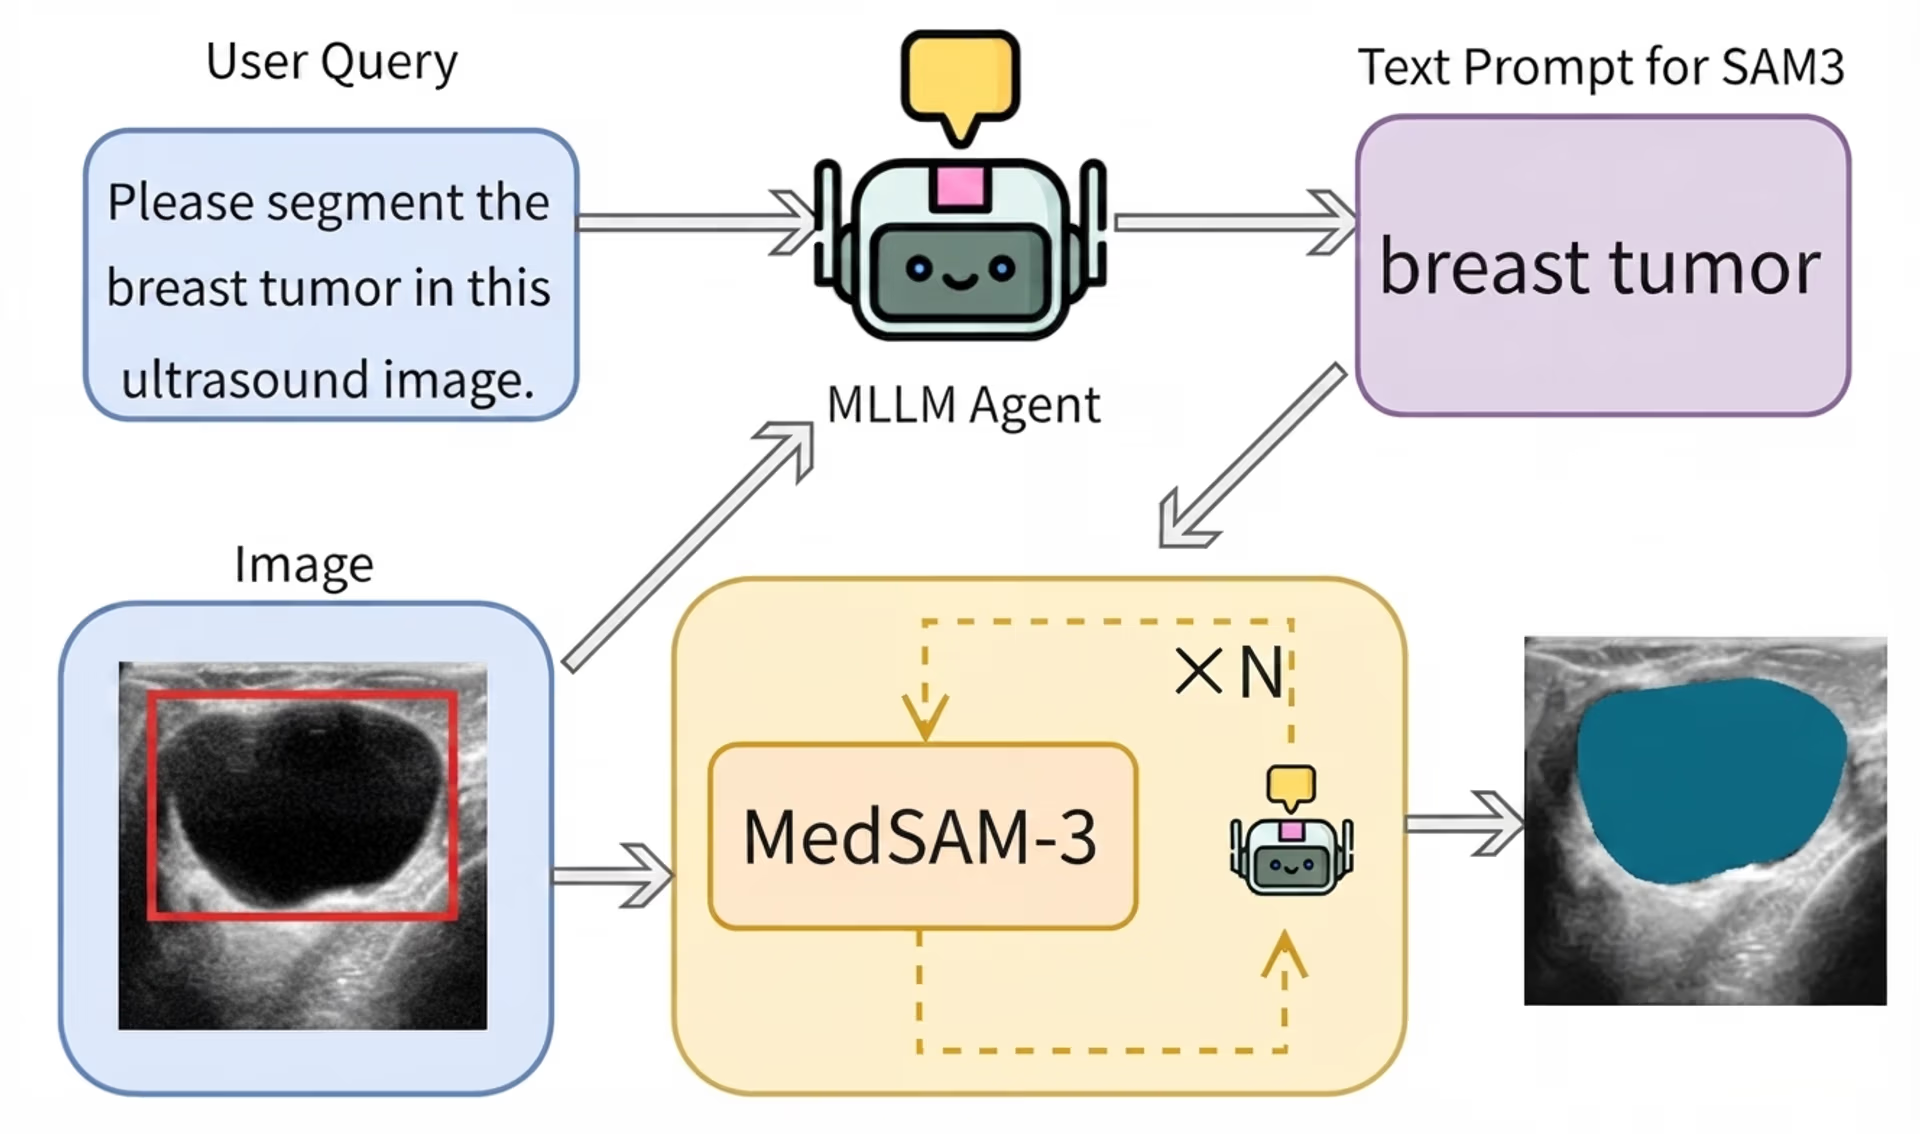
Fig. 3. Flujo de trabajo de MedSAM-3 para segmentar tumores en imágenes médicas mediante indicaciones de texto (Fuente)
MedSAM-3 ofrece buenos resultados con radiografías, resonancias magnéticas, tomografías computarizadas, ecografías y vídeos, lo que pone de manifiesto cómo PCS puede facilitar flujos de trabajo de diagnóstico por imagen más flexibles y eficientes en entornos clínicos reales.
Segmentación adaptativa para cirugía robótica y automatización#
La cirugía robótica depende de sistemas de visión para seguir los instrumentos y comprender las escenas quirúrgicas, que cambian rápidamente. Los instrumentos se mueven deprisa, la iluminación varía y pueden aparecer herramientas nuevas en cualquier momento, lo que dificulta mantener sistemas de etiquetas predefinidos.
Con PCS, los robots pueden seguir instrumentos, orientar cámaras y supervisar las etapas quirúrgicas en tiempo real. Esto reduce el etiquetado manual y facilita la adaptación de los sistemas a distintos procedimientos. Los cirujanos o los sistemas automatizados pueden utilizar indicaciones de texto como «pinza», «bisturí» o «instrumento de cámara» para señalar qué debe segmentarse en una imagen.
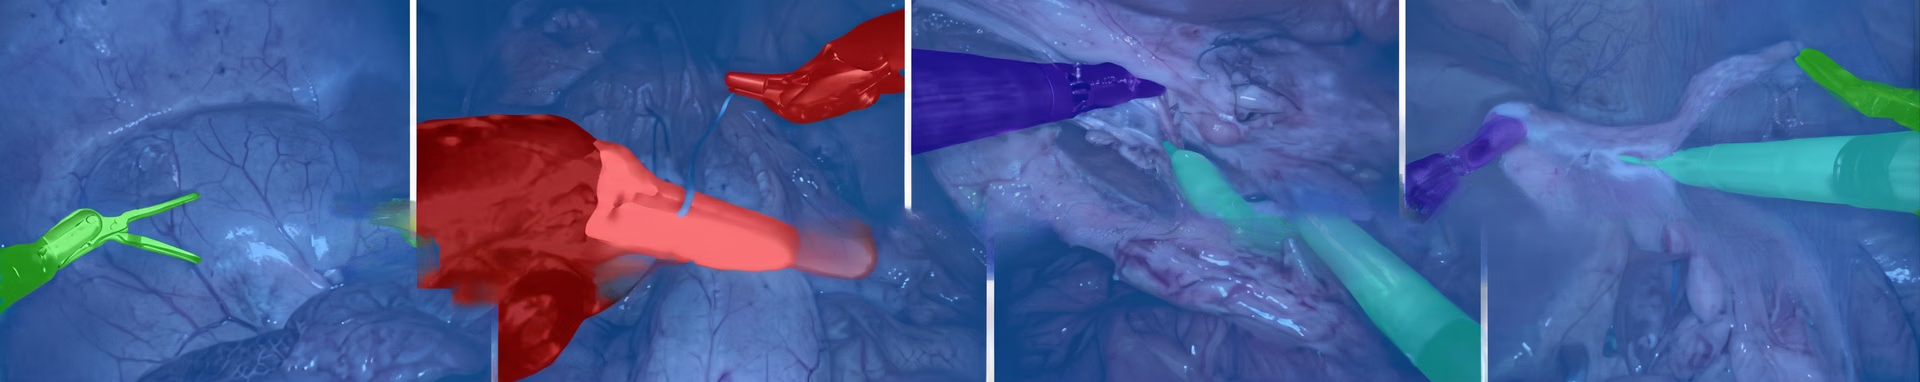
Fig. 4. Segmentación de instrumentos quirúrgicos utilizados durante una intervención robótica (Fuente)
Segmentación con vocabulario abierto con Ultralytics YOLOE-26#
Otro modelo de última generación interesante relacionado con la segmentación de conceptos mediante indicaciones es Ultralytics YOLOE-26. Incorpora la segmentación de vocabulario abierto guiada por indicaciones a la familia de modelos Ultralytics YOLO.
YOLOE-26 se basa en la arquitectura Ultralytics YOLO26 y admite la segmentación de instancias con vocabulario abierto. YOLOE-26 permite guiar la segmentación de varias maneras.
Admite indicaciones de texto, en las que frases breves y vinculadas visualmente especifican el objeto objetivo, así como indicaciones visuales, que proporcionan instrucciones adicionales basadas en pistas de la imagen. Además, YOLOE-26 incluye un modo sin indicaciones para la inferencia de cero disparos, en el que el modelo detecta y segmenta objetos de un vocabulario integrado sin necesidad de indicaciones del usuario.
YOLOE-26 es ideal para aplicaciones como el análisis de vídeo, la percepción robótica y los sistemas de computación en el borde, donde las categorías de objetos pueden cambiar, pero la baja latencia y un rendimiento fiable siguen siendo esenciales. También resulta especialmente útil para el etiquetado de datos y la selección de conjuntos de datos, ya que agiliza los flujos de trabajo al automatizar partes del proceso de anotación.
Ventajas e inconvenientes de la segmentación de conceptos guiada por indicaciones#
Estas son algunas de las principales ventajas de utilizar la segmentación de conceptos guiada por indicaciones:
- Iteración y creación de prototipos más rápidas: Puedes probar rápidamente nuevas tareas de segmentación cambiando las indicaciones, en lugar de reconstruir conjuntos de datos o volver a entrenar modelos, lo que acelera la experimentación y el desarrollo.
- Adaptabilidad a distintos ámbitos: A menudo se puede aplicar el mismo modelo PCS en distintos ámbitos, como el diagnóstico por imagen, la robótica o el análisis de vídeo, con cambios mínimos en el flujo de trabajo.
- Refinamiento interactivo: Los usuarios pueden ajustar iterativamente las indicaciones o añadir instrucciones para mejorar los resultados, lo que facilita la gestión de escenas ambiguas o casos límite sin volver a entrenar el modelo.
Aunque PCS tiene ventajas claras, estas son algunas limitaciones que debes tener en cuenta:
- Sensibilidad a las indicaciones: Los pequeños cambios en la redacción o la forma de proporcionar una indicación pueden afectar al resultado. Las indicaciones demasiado vagas o demasiado específicas pueden dar lugar a una segmentación incompleta o incorrecta.
- Comportamiento menos predecible: Como el modelo interpreta las indicaciones en lugar de elegir entre etiquetas fijas, los resultados pueden variar más entre escenas y entradas, lo que puede suponer un problema en flujos de trabajo estrictamente controlados.
- Interpretación ambigua de los conceptos: Algunos conceptos son subjetivos o están definidos de forma imprecisa, lo que puede dar lugar a resultados de segmentación incoherentes entre usuarios o entre imágenes.
- Fiabilidad limitada para objetivos muy específicos: En general, los modelos basados en indicaciones son menos fiables para tareas muy acotadas y específicas de cada instancia, como la detección de defectos, que requieren identificar características sutiles con precisión y coherencia.
Cómo elegir entre la segmentación guiada por indicaciones y la tradicional#
Al explorar la segmentación guiada por indicaciones, quizá te preguntes para qué aplicaciones es más adecuada y cuándo un modelo de visión artificial tradicional, como Ultralytics YOLO26, es más apropiado para el problema que quieres resolver. La segmentación guiada por indicaciones funciona bien con objetos generales, pero no es adecuada para casos de uso que requieren resultados muy precisos y coherentes.
La detección de defectos es un buen ejemplo. En la fabricación, los defectos suelen ser diminutos y sutiles, como pequeños arañazos, abolladuras, desalineaciones o irregularidades superficiales. Además, pueden variar mucho según los materiales, la iluminación y las condiciones de producción.
Estos problemas son difíciles de describir con una indicación sencilla y aún más difíciles de detectar de forma fiable para un modelo de propósito general. En general, los modelos basados en indicaciones tienden a pasar por alto los defectos o a producir resultados inestables, mientras que los modelos entrenados específicamente con datos de defectos son mucho más fiables en sistemas de inspección del mundo real.
Conclusiones clave#
La segmentación de conceptos guiada por indicaciones facilita la adaptación de los sistemas de visión al mundo real, donde aparecen constantemente objetos e ideas nuevos. En lugar de limitarse a etiquetas fijas, los usuarios pueden describir lo que quieren segmentar y dejar que el modelo se encargue del resto, lo que ahorra tiempo y reduce el trabajo manual. Aunque todavía tiene limitaciones, PCS ya está cambiando la forma de utilizar la segmentación en la práctica y probablemente se convertirá en una parte fundamental de los futuros sistemas de visión.
Descubre más sobre la IA visitando nuestro repositorio de GitHub y uniéndote a nuestra comunidad. Echa un vistazo a nuestras páginas de soluciones para informarte sobre la IA en robótica y la visión artificial en la fabricación. Descubre nuestras opciones de licencia y empieza hoy mismo con la IA visual.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









