Exploration de la détection des petits objets avec Ultralytics YOLO11
Découvre comment Ultralytics YOLO11 assure une détection rapide et précise des petits objets dans des applications réelles, comme la surveillance et la robotique.
 Abirami Vina15 min de lecture
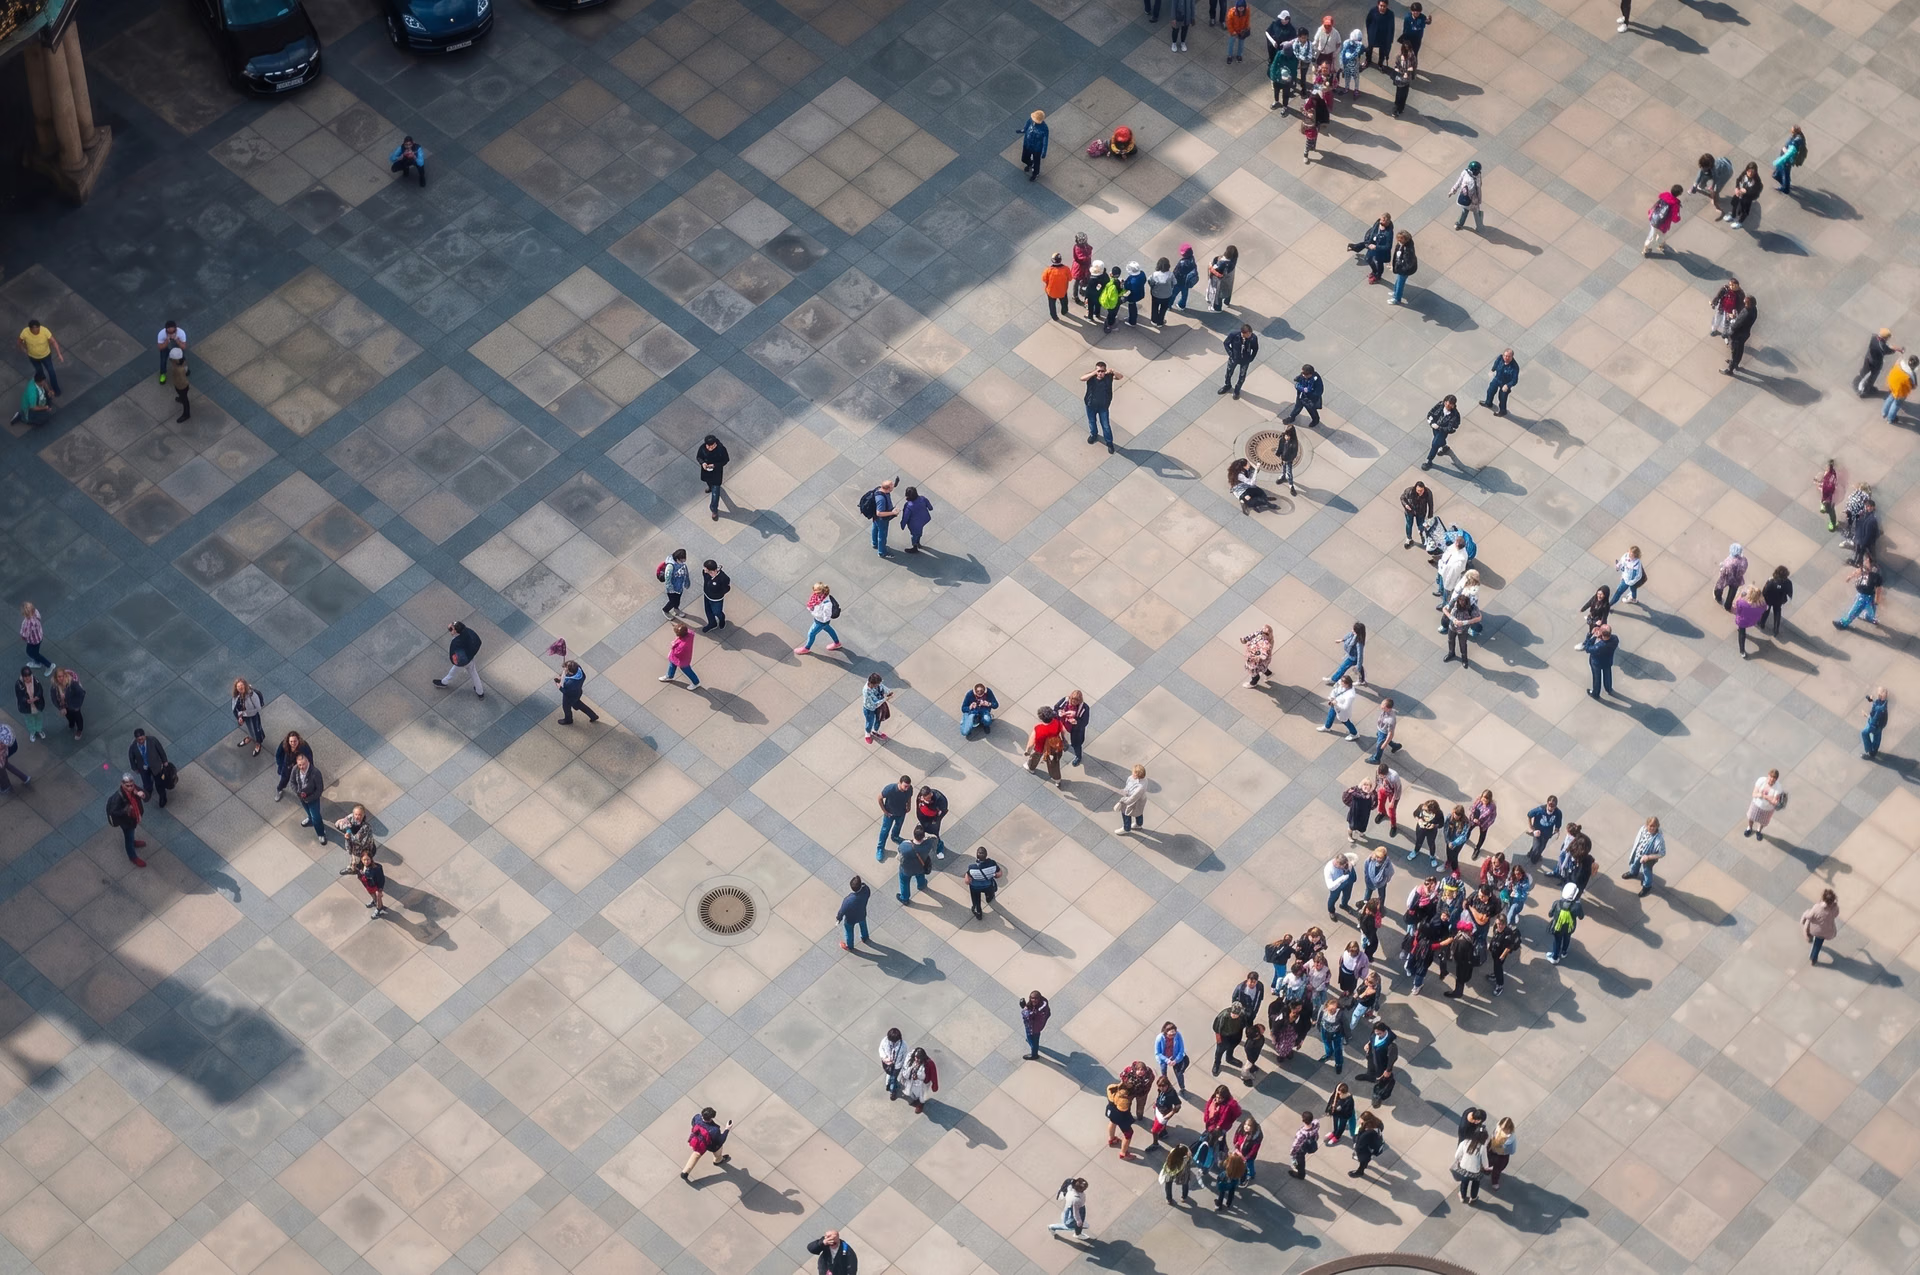
Les drones équipés d’IA visuelle peuvent voler à des centaines de mètres au-dessus du sol tout en étant censés détecter une personne qui n’occupe que quelques pixels dans leur flux vidéo. C’est un défi courant dans des domaines comme la robotique, la surveillance et la télédétection, où les systèmes doivent identifier des objets de très petite taille dans une image.
Mais les modèles traditionnels de détection d’objets peuvent avoir du mal à y parvenir. Les petits objets dans les images et les vidéos fournissent très peu d’informations visuelles. En clair, lorsqu’un modèle les observe, il n’y a pas beaucoup de détails à apprendre ou à reconnaître.
En coulisses, ces modèles s’appuient généralement sur une architecture fondée sur un réseau neuronal convolutif (CNN). Les images traversent les couches du réseau et sont transformées en cartes de caractéristiques ou en représentations simplifiées qui mettent en évidence les motifs pertinents plutôt que les pixels bruts.
À mesure que l’image progresse dans le réseau, ces cartes de caractéristiques deviennent plus petites. Le calcul est ainsi plus rapide, mais cela signifie aussi que les détails fins peuvent disparaître.
Pour les objets minuscules, ces détails sont cruciaux. Lorsqu’ils disparaissent, un modèle de vision par ordinateur peut avoir du mal à détecter l’objet, ce qui peut produire des boîtes englobantes moins précises ou irrégulières.
Les systèmes de vision par ordinateur de bout en bout en temps réel compliquent encore les choses. Les images haute résolution préservent mieux les détails, mais ralentissent l’inférence et nécessitent davantage de puissance GPU. Les résolutions plus faibles accélèrent le traitement, mais rendent les petits objets encore plus difficiles à détecter.
Il faut constamment trouver un équilibre entre vitesse, précision et limites du matériel. Grâce aux récentes avancées technologiques, les modèles de vision par ordinateur comme Ultralytics YOLO11 et Ultralytics YOLO26, désormais disponible, sont conçus pour mieux gérer ce compromis.
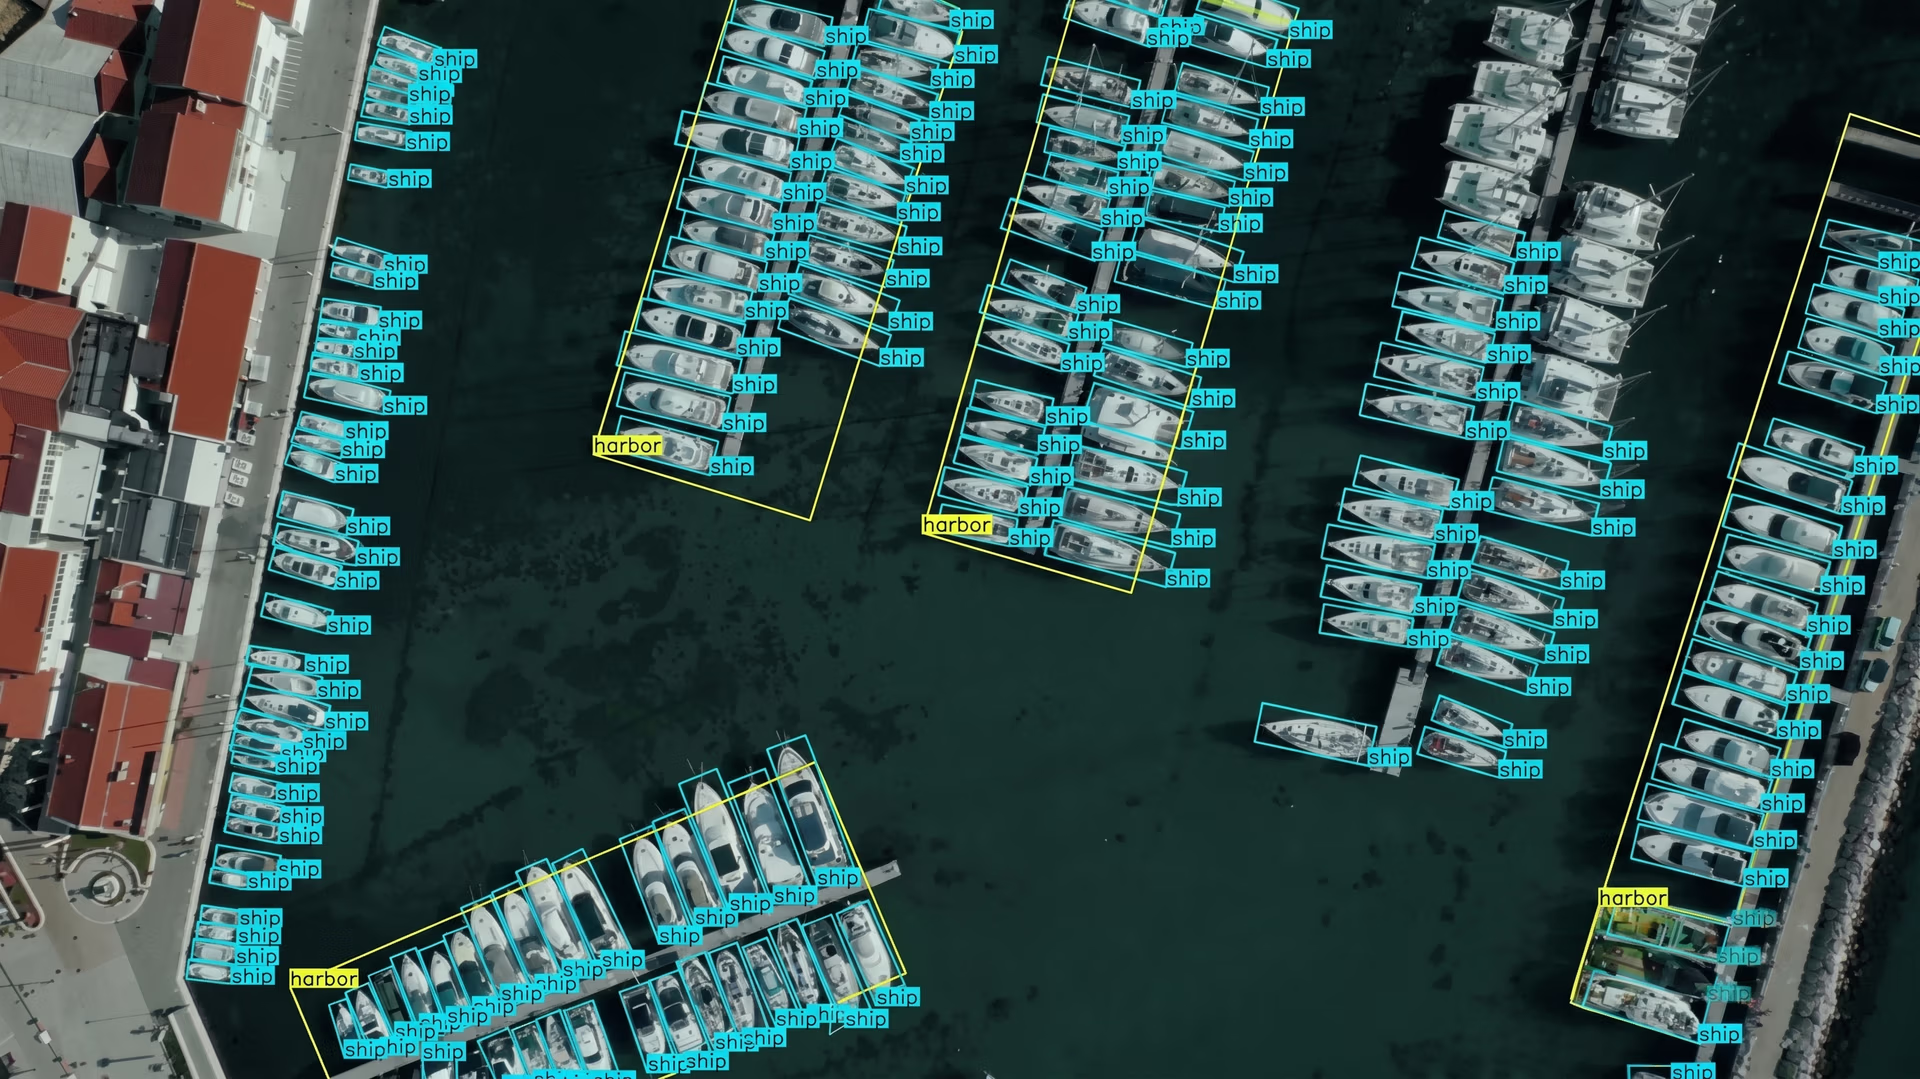
Fig. 1. Utilisation de YOLO11 pour détecter de petits objets dans des images aériennes (Source)
Dans cet article, nous verrons pourquoi la détection de petits objets est difficile et comment Ultralytics YOLO11 peut la faciliter.
Qu’est-ce que la détection de petits objets et pourquoi est-elle importante ?#
La détection de petits objets est une tâche de vision par ordinateur, une branche de l’IA, qui consiste à identifier et à localiser des objets occupant une très petite partie d’une image. Ces objets ne sont souvent représentés que par un nombre limité de pixels, les plus petites unités d’une image numérique. Ils sont donc plus difficiles à détecter que des cibles plus grandes et plus nettes, qui contiennent souvent davantage de pixels.
Par exemple, les véhicules dans des images aériennes, les outils sur le sol d’une usine ou les personnes capturées par des caméras de surveillance grand-angle peuvent tous apparaître comme de petits objets dans l’image. Leur détection est importante, car ils contiennent souvent des informations cruciales et de nombreuses applications du monde réel, comme la surveillance, dépendent de cette détection pour fonctionner correctement.
Lorsque de petits objets ne sont pas détectés, les performances du système et la prise de décision peuvent en pâtir. La surveillance par véhicule aérien sans pilote (UAV) en est un bon exemple : ne pas repérer un petit objet en mouvement au sol peut nuire à la navigation ou à la précision du suivi.
Les défis liés à la détection de petits objets#
Les premiers systèmes utilisaient des caractéristiques conçues manuellement et des méthodes traditionnelles de vision par ordinateur, qui peinaient dans les scènes chargées ou variées. Aujourd’hui encore, malgré les performances nettement supérieures des modèles d’apprentissage profond, la détection de petites cibles reste difficile lorsqu’elles n’occupent qu’une infime partie de l’image.
Examinons maintenant quelques défis courants qui se présentent dans différents scénarios réels lors de la détection de petits objets.
Taille, pixels et perte d’information#
Les petits objets contiennent très peu de pixels, ce qui limite la quantité de détails visuels qu’un modèle peut apprendre lors d’étapes comme l’extraction de caractéristiques. Par conséquent, les motifs tels que les contours, les formes et les textures sont plus difficiles à détecter, et les petits objets risquent davantage de se confondre avec l’arrière-plan.
À mesure que les images traversent les couches convolutionnelles d’un réseau neuronal, les informations visuelles des pixels sont progressivement compressées en cartes de caractéristiques. Cela permet au modèle de rester efficace, mais signifie aussi que les détails fins s’estompent.
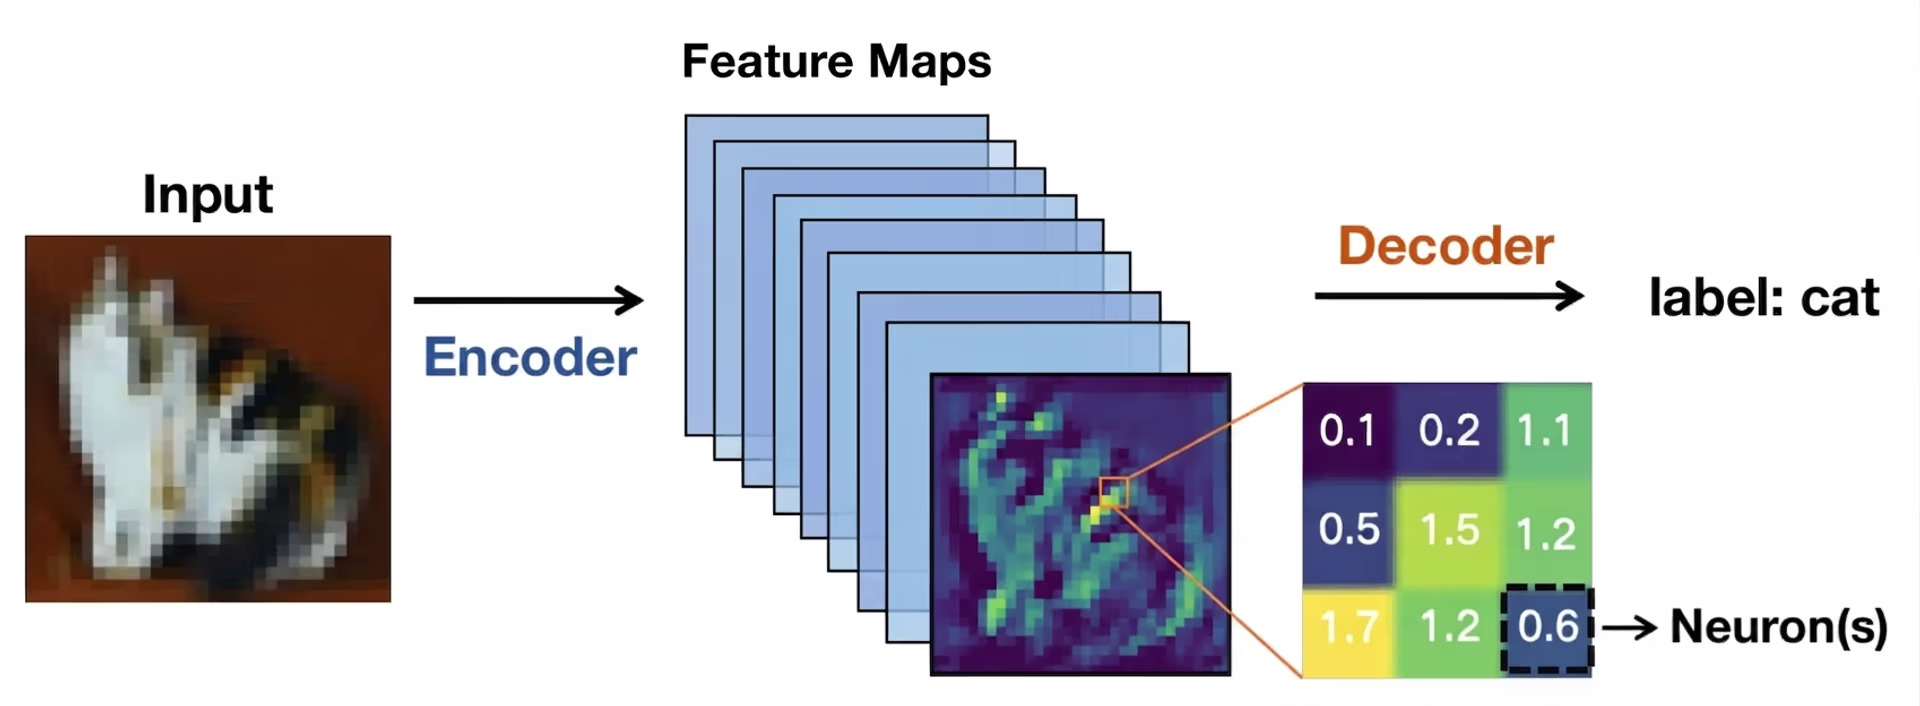
Fig. 2. Les cartes de caractéristiques représentent les motifs visuels d’une image (Source)
Pour les petites cibles, des indices importants peuvent disparaître avant même que le réseau de détection ait pu agir. Dans ce cas, la localisation devient moins fiable et les boîtes englobantes peuvent se décaler, se chevaucher ou ne pas détecter du tout les objets visés.
Occultation, variation d’échelle et contexte#
Les problèmes liés à la taille sont également souvent amplifiés par l’occultation. Il y a occultation lorsque des objets, notamment les plus petits, sont partiellement cachés par d’autres objets de la scène.
Cela réduit la partie visible d’une cible et limite les informations disponibles pour le détecteur d’objets. Même une occultation minime peut perturber les réseaux de détection, surtout lorsqu’elle s’accompagne d’une entrée basse résolution. On peut en voir un exemple intéressant dans des jeux de données UAV comme VisDrone, où des piétons, des vélos ou des véhicules peuvent être partiellement masqués par des bâtiments, des arbres ou d’autres objets en mouvement.
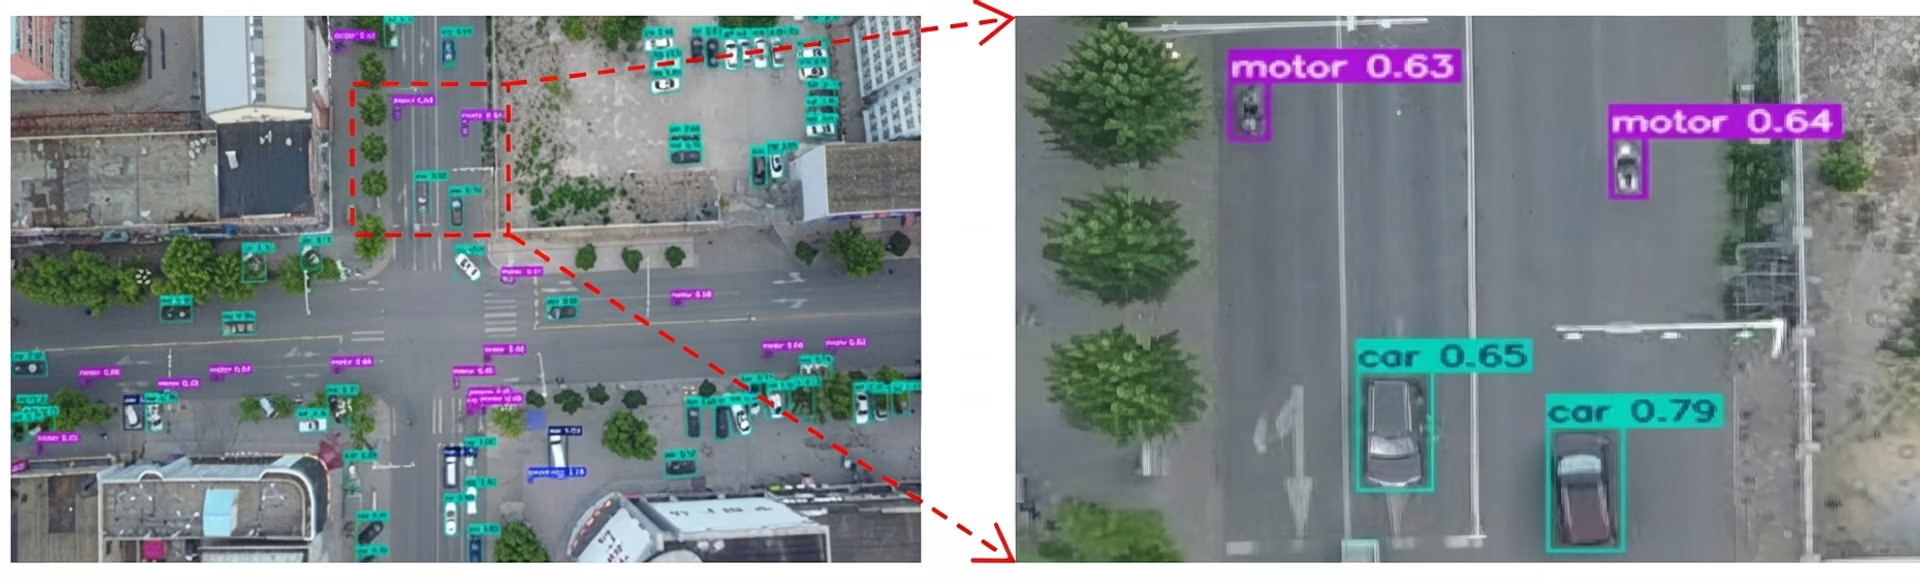
Fig. 3. Exemple de petits objets tiré du jeu de données VisDrone (Source)
De même, la variation d’échelle ajoute une difficulté supplémentaire lorsque le même objet paraît très petit ou relativement grand selon la distance et la position de la caméra. Malgré ces obstacles, les algorithmes de détection doivent reconnaître ces petits objets à différentes échelles sans perdre en précision.
Le contexte joue également un rôle important dans la détection. Par exemple, les grands objets apparaissent généralement dans un environnement bien visible qui fournit des indices visuels utiles. À l’inverse, les petites cibles manquent souvent de ces informations contextuelles, ce qui complique la reconnaissance des motifs.
Le problème de la métrique cachée dans la détection de petits objets#
Les métriques d’évaluation courantes, comme l’intersection sur union (IoU), mesurent le chevauchement entre une boîte englobante prédite et la boîte de référence. Si l’IoU fonctionne bien pour les objets plus grands, son comportement est très différent pour les petits objets.
Les petits objets n’occupent que quelques pixels : même un léger décalage de la boîte prédite peut donc entraîner une erreur proportionnellement importante et faire fortement baisser le score IoU. Ainsi, les petits objets ne dépassent souvent pas le seuil IoU standard utilisé pour considérer une prédiction comme correcte, même lorsque l’objet est visible dans l’image.
Par conséquent, les erreurs de localisation risquent davantage d’être classées comme faux positifs ou faux négatifs. Ces limites ont amené les chercheurs à repenser la manière dont les systèmes de détection d’objets évaluent et traitent les cibles petites et difficiles à détecter.
Caractéristiques multi-échelles : la clé de la détection d’objets petits en temps réel#
Alors que les chercheurs cherchaient à améliorer la détection des petits objets, il est devenu évident qu’il était essentiel de préserver et de représenter les informations visuelles à plusieurs échelles. Cette idée se retrouve dans des recherches récentes sur arXiv et dans des articles présentés lors d’événements tels que les conférences internationales IEEE et la Conférence européenne sur la vision par ordinateur (ECCV).
À mesure que les images progressent dans un réseau neuronal, les petits objets peuvent perdre leurs détails ou disparaître entièrement. C’est pourquoi les modèles modernes de vision par ordinateur comme Ultralytics YOLO11 mettent fortement l’accent sur l’amélioration de l’extraction de caractéristiques. Examinons maintenant les concepts fondamentaux des cartes de caractéristiques et des réseaux pyramidaux de caractéristiques pour mieux les comprendre.
Cartes de caractéristiques et représentation des échelles#
Lorsqu’une image d’entrée, par exemple une image de télédétection, est introduite dans un réseau neuronal, elle est progressivement transformée en cartes de caractéristiques. Ces représentations simplifiées de l’image mettent en évidence des motifs visuels comme les contours, les formes et les textures.
À mesure que le réseau s’approfondit, les dimensions spatiales de ces cartes de caractéristiques diminuent. Cette réduction aide le modèle à fonctionner efficacement et à se concentrer sur les informations de haut niveau. Cependant, la réduction de la taille et la profondeur des cartes de caractéristiques diminuent également le niveau de détail spatial.
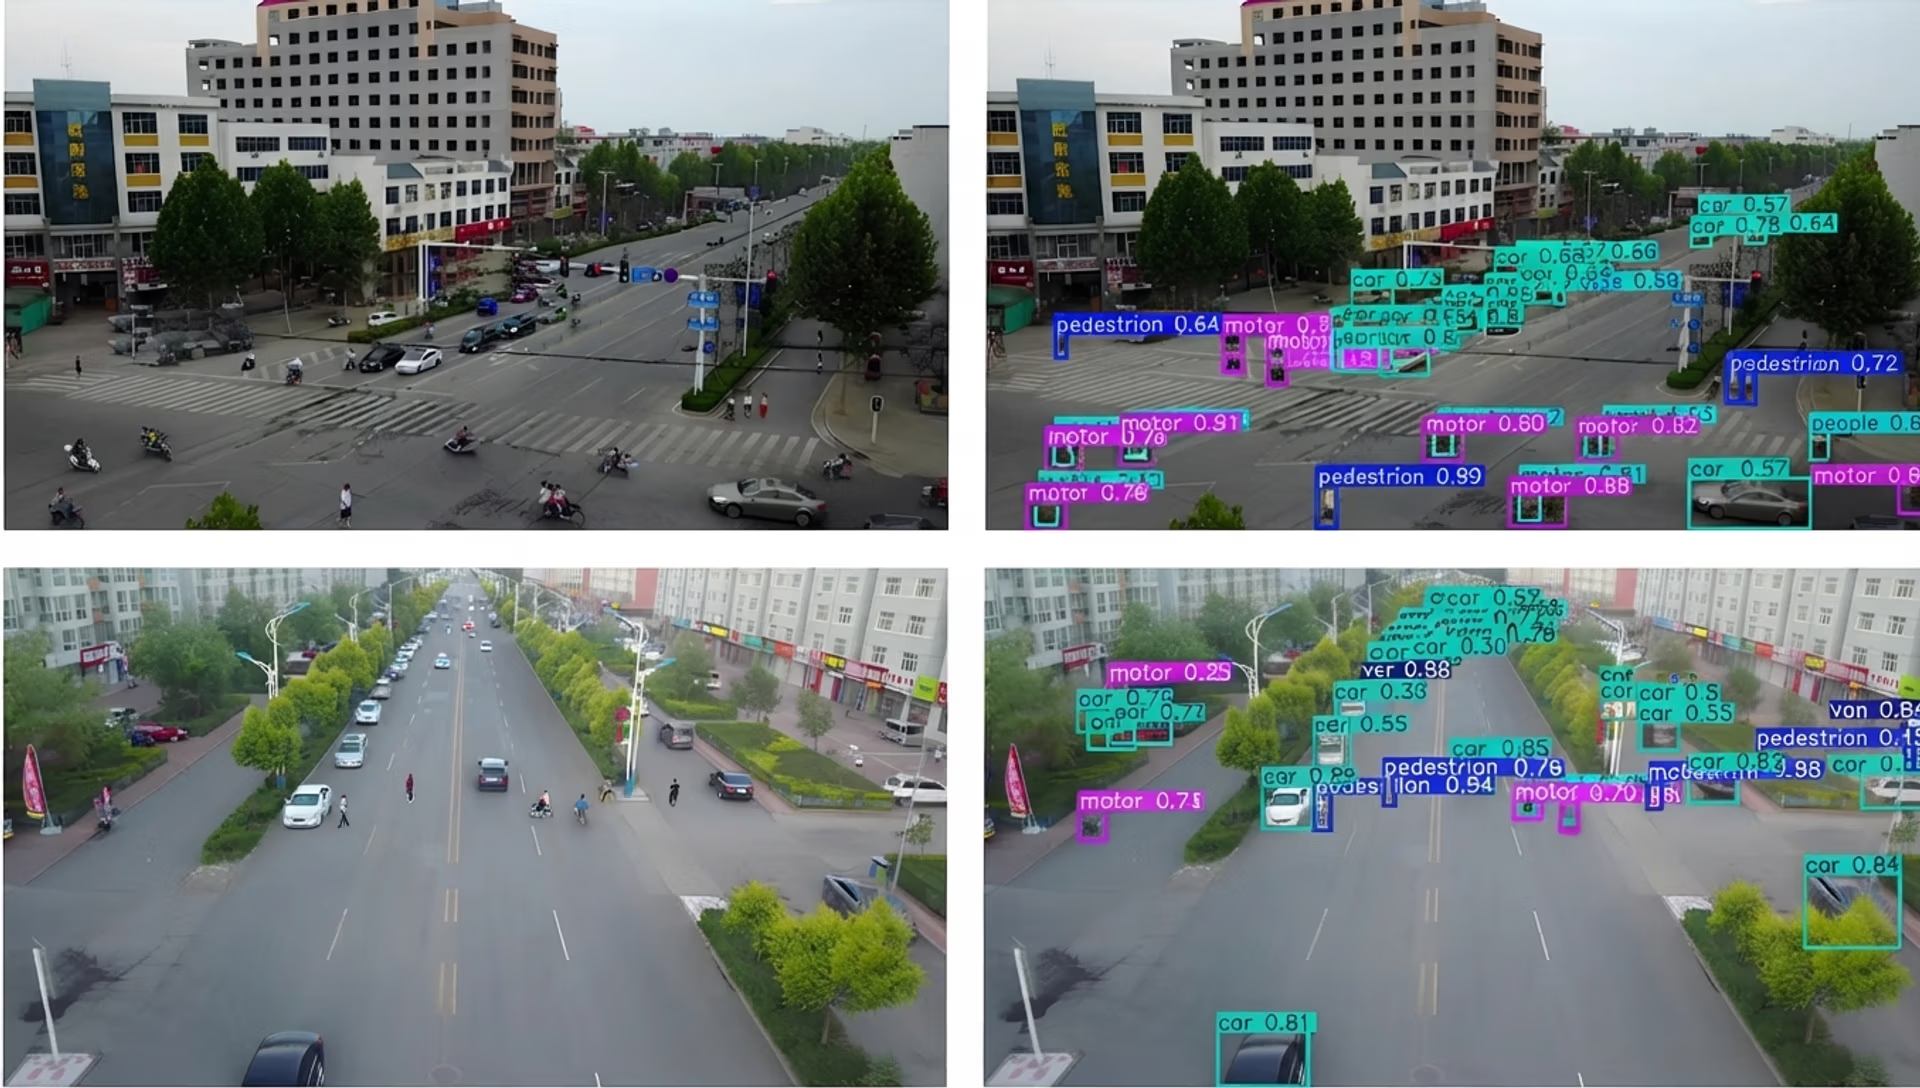
Fig. 4. L’extraction de caractéristiques est essentielle pour détecter de petits objets. (Source)
Les grands objets conservent suffisamment d’informations visuelles pour être détectés avec précision, mais les petites cibles peuvent perdre des détails cruciaux après seulement quelques couches du réseau. Dans ce cas, le modèle peut avoir du mal à reconnaître l’existence même d’un petit objet. C’est l’une des principales raisons pour lesquelles les modèles profonds de détection d’objets ne repèrent pas les petits objets.
Réseaux pyramidaux de caractéristiques et apprentissage multi-échelle#
Les réseaux pyramidaux de caractéristiques, souvent appelés FPN, ont été conçus pour répondre à la perte de détails spatiaux. Ils servent de module complémentaire qui combine les informations de plusieurs couches afin d’aider les modèles à détecter plus efficacement les petits objets. Ce processus est également appelé agrégation et fusion de caractéristiques.
Les couches peu profondes fournissent des détails spatiaux fins, tandis que les couches plus profondes apportent un contexte sémantique, permettant ainsi un apprentissage efficace des caractéristiques à plusieurs échelles. Contrairement au suréchantillonnage naïf, qui se contente d’agrandir les cartes de caractéristiques, FPN préserve les informations pertinentes et améliore la détection de petits objets.
Les approches modernes s’appuient sur cette idée en utilisant une fusion adaptative des caractéristiques et des architectures tenant compte du contexte pour améliorer encore la détection des petites cibles. En d’autres termes, FPN aide les modèles à voir à la fois la vue d’ensemble et les moindres détails. Cette optimisation est essentielle lorsque les objets sont petits.
L’évolution des modèles de détection d’objets pour traiter les petits objets#
Voici un aperçu de l’évolution et des progrès des modèles de détection d’objets pour mieux détecter des objets de différentes tailles, y compris les plus petits :
- Premières méthodes de détection : Les premières approches de détection d’objets reposaient sur des caractéristiques conçues manuellement et des algorithmes à base de règles issus du traitement classique de l’image. Comme ces caractéristiques étaient fixes, les performances se dégradaient avec des images différentes.
- Introduction de l’apprentissage automatique et de l’apprentissage profond : L’adoption de l’apprentissage automatique et de l’apprentissage profond a marqué un tournant majeur dans la recherche sur la détection d’objets. Au lieu de s’appuyer sur des règles prédéfinies, les réseaux neuronaux ont appris des représentations visuelles directement à partir des données d’entraînement, ce qui a amélioré leur adaptabilité aux différentes tailles d’objets et aux diverses scènes.
- Réseaux convolutionnels : Ces réseaux neuronaux apprennent à repérer des motifs dans les images. Chaque couche détecte différents détails, en commençant par les contours simples et les couleurs, puis les formes et enfin les objets complets, ce qui les rend essentiels à la vision par ordinateur moderne.
- Détecteurs d’objets à deux étapes : les détecteurs à deux étapes, comme Faster R-CNN, introduit par Ren et ses collègues, généraient d’abord des régions candidates, puis les classaient. Cette approche a amélioré la précision pour les petits objets, mais a augmenté le coût de calcul et réduit les performances en temps réel.
- Détecteurs d’objets à une étape : Les détecteurs à une étape, comme le détecteur à tir unique (SSD) et la famille YOLO — « tu ne regardes qu’une fois » (YOLO) — notamment YOLOv3, Ultralytics YOLOv5 et, plus tard, Ultralytics YOLOv8, effectuent la détection en un seul passage. Cette architecture améliore considérablement la vitesse d’inférence tout en maintenant une précision compétitive.
- Modèles de pointe les plus récents : les nouveaux modèles de détection d’objets accordent une plus grande importance aux performances en temps réel et au déploiement en périphérie. Les récentes versions des modèles Ultralytics YOLO, comme Ultralytics YOLO11 et Ultralytics YOLO26, sont conçues pour concilier une grande précision et une inférence à faible latence. Elles conviennent donc parfaitement à la détection d’objets de toutes tailles, y compris les petites cibles, sur des appareils dont la puissance de calcul est limitée.
Utiliser Ultralytics YOLO11 pour des cas d’usage de détection de petits objets#
Maintenant que nous comprenons mieux le fonctionnement de la détection de petits objets, examinons quelques applications concrètes auxquelles Ultralytics YOLO11 peut s’appliquer.
Imagerie par UAV et imagerie aérienne#
Imagine un drone qui survole une rue animée d’une ville. De cette hauteur, les voitures, les vélos et même les personnes ne représentent plus que quelques pixels à l’écran.
Les modules d’imagerie par UAV et d’imagerie aérienne capturent souvent ce type de scènes, où les objets d’intérêt sont minuscules et entourés d’arrière-plans encombrés, ce qui complique leur détection par les modèles de vision par ordinateur.
Dans ce type de situation, Ultralytics YOLO11 peut être un excellent choix de modèle. Par exemple, un drone équipé d’un modèle comme YOLO11, ajusté à partir de jeux de données aériennes tels que VisDrone, pourrait surveiller la circulation en temps réel et détecter les véhicules, les cyclistes et les piétons au fil de leurs déplacements, même si chaque objet n’occupe qu’une petite partie de l’image. Cela permet de prendre des décisions plus rapidement et d’obtenir des informations plus précises dans des applications comme la gestion de la circulation, la sécurité publique ou l’urbanisme.
Robotique et automatisation#
Les robots sont souvent utilisés dans des environnements où la précision et le respect du timing sont essentiels. Dans des lieux comme les entrepôts, les usines et les exploitations agricoles, un robot peut devoir reconnaître très rapidement de petits objets, comme une pièce sur une chaîne de montage, une étiquette sur un colis ou un jeune bourgeon dans un champ.
Détecter des objets de cette taille peut être compliqué, surtout lorsqu’ils ne représentent que quelques pixels dans le flux de la caméra ou sont partiellement occultés par d’autres objets. Ne pas repérer ces petits détails peut ralentir l’automatisation ou nuire à la capacité du robot à accomplir une tâche.
Ultralytics YOLO11 peut faire la différence dans ces situations. Son extraction de caractéristiques améliorée et sa rapidité d’inférence permettent aux robots de détecter de petits objets en temps réel et d’agir immédiatement.
Ultralytics YOLO11 prend également en charge la segmentation d’instances, qui peut aider les robots à comprendre plus précisément les contours des objets et les points de préhension, au lieu de simplement localiser des boîtes englobantes générales. Par exemple, un bras robotisé équipé de YOLO11 pourrait repérer de petites pièces sur un tapis roulant, segmenter leur forme exacte et les saisir avant qu’elles ne deviennent hors de portée, afin de maintenir l’efficacité et la fiabilité du système.
Pourquoi Ultralytics YOLO11 est efficace pour détecter de petits objets#
Avec le grand nombre de modèles de vision par ordinateur disponibles aujourd’hui, tu te demandes peut-être ce qui distingue Ultralytics YOLO11.
Voici quelques raisons pour lesquelles Ultralytics YOLO11 est une excellente option pour les applications qui nécessitent la détection de petits objets :
- Extraction de caractéristiques améliorée : YOLO11 utilise une architecture de backbone et de neck améliorée pour optimiser l’extraction de caractéristiques et détecter les objets avec plus de précision.
- Écosystème et simplicité d’utilisation : Le package Python Ultralytics est une bibliothèque qui fournit des fonctions intégrées pour charger, entraîner, valider et déployer des modèles comme YOLO11. Comme ces processus ne nécessitent que quelques lignes de code, les équipes peuvent rapidement tester et affiner des modèles pour détecter de petits objets.
- Optimisé pour le déploiement en périphérie : Ultralytics YOLO11 peut fonctionner efficacement sur des appareils de périphérie comme NVIDIA Jetson, Raspberry Pi et les systèmes de caméras industrielles. En clair, il permet d’exécuter directement sur l’appareil des tâches d’IA visuelle en temps réel.
Stratégies pratiques pour détecter de petits objets avec Ultralytics YOLO11#
En plus d’utiliser un modèle comme Ultralytics YOLO11, la préparation de tes annotations, le jeu de données dans son ensemble et la procédure d’entraînement du modèle peuvent avoir un effet considérable sur les performances de détection. Lors de l’inférence, l’inférence par tuiles SAHI peut également aider à détecter de très petits objets dans des images haute résolution.
Voici un aperçu rapide des points à privilégier :
- Augmentation de données adaptée : Une augmentation modérée des données, comme le changement d’échelle ou le recadrage, peut aider le modèle à généraliser à de nouvelles images. Cependant, une augmentation à grande échelle trop agressive peut déformer ou supprimer les petits objets et rendre leur apprentissage plus difficile pour le modèle.
- Analyse des cas d’échec : Analyser les cas où le modèle ne détecte pas ou identifie mal des objets aide à établir une référence et à déterminer si les problèmes viennent du jeu de données, de la perte d’informations pendant l’extraction de caractéristiques ou de la nécessité d’ajuster les paramètres d’entraînement.
- Composition du jeu de données : Ton jeu de données doit contenir suffisamment d’exemples de petits objets pour que le modèle apprenne des motifs pertinents, tout en restant équilibré afin que les objets plus grands ne prennent pas le dessus pendant l’entraînement.
Points clés à retenir#
La détection de petits objets est difficile, car les petites cibles perdent leurs détails à mesure que les images traversent un modèle de vision par ordinateur. Ultralytics YOLO11 améliore la préservation de ces détails, ce qui rend la détection de petits objets plus fiable sans sacrifier les performances en temps réel. Cet équilibre permet à YOLO11 d’assurer une détection précise et efficace dans des applications du monde réel.
Rejoins notre communauté en pleine croissance ! Explore notre dépôt GitHub pour en savoir plus sur l’IA. Découvre des innovations comme la vision par ordinateur dans le commerce de détail et l’IA dans l’industrie automobile en consultant nos pages de solutions. Pour commencer dès aujourd’hui à créer avec la vision par ordinateur, découvre nos options de licence.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









