U-Netアーキテクチャとその活用例のガイド
U-Netアーキテクチャと画像セグメンテーションへの活用方法、用途、コンピュータービジョンの発展における重要性をご紹介します。
コンピュータービジョンは、視覚データの分析に焦点を当てた人工知能(AI)の一分野です。工場での製品検査の自動化や、自動運転車の道路走行支援など、多くの最先端システムの実現につながっています。
コンピュータービジョンで最もよく知られているタスクの1つが物体検出です。このタスクでは、バウンディングボックスを使って画像内の物体の位置を特定し、識別できます。バウンディングボックスはさまざまな用途で役立ちますが、物体の位置を大まかに示すにすぎません。
しかし、精度が重要な医療などの分野では、ビジョンAIのユースケースにおいて、物体を識別するだけでは不十分です。多くの場合、物体の正確な形状や位置に関する情報も必要になります。
まさにこの目的のために設計されたコンピュータービジョンタスクが、セグメンテーションです。バウンディングボックスを使う代わりに、セグメンテーションモデルはピクセル単位で物体を検出します。長年にわたり、研究者たちはセグメンテーション用の専用コンピュータービジョンモデルを開発してきました。
そのようなモデルの1つがU-Netです。より新しく高度なモデルが性能面で上回るようになりましたが、U-Netはコンピュータービジョンの歴史において重要な位置を占めています。この記事では、U-Netのアーキテクチャ、その仕組みや活用分野、そして現在利用できる最新のセグメンテーションモデルとの比較について詳しく見ていきます。
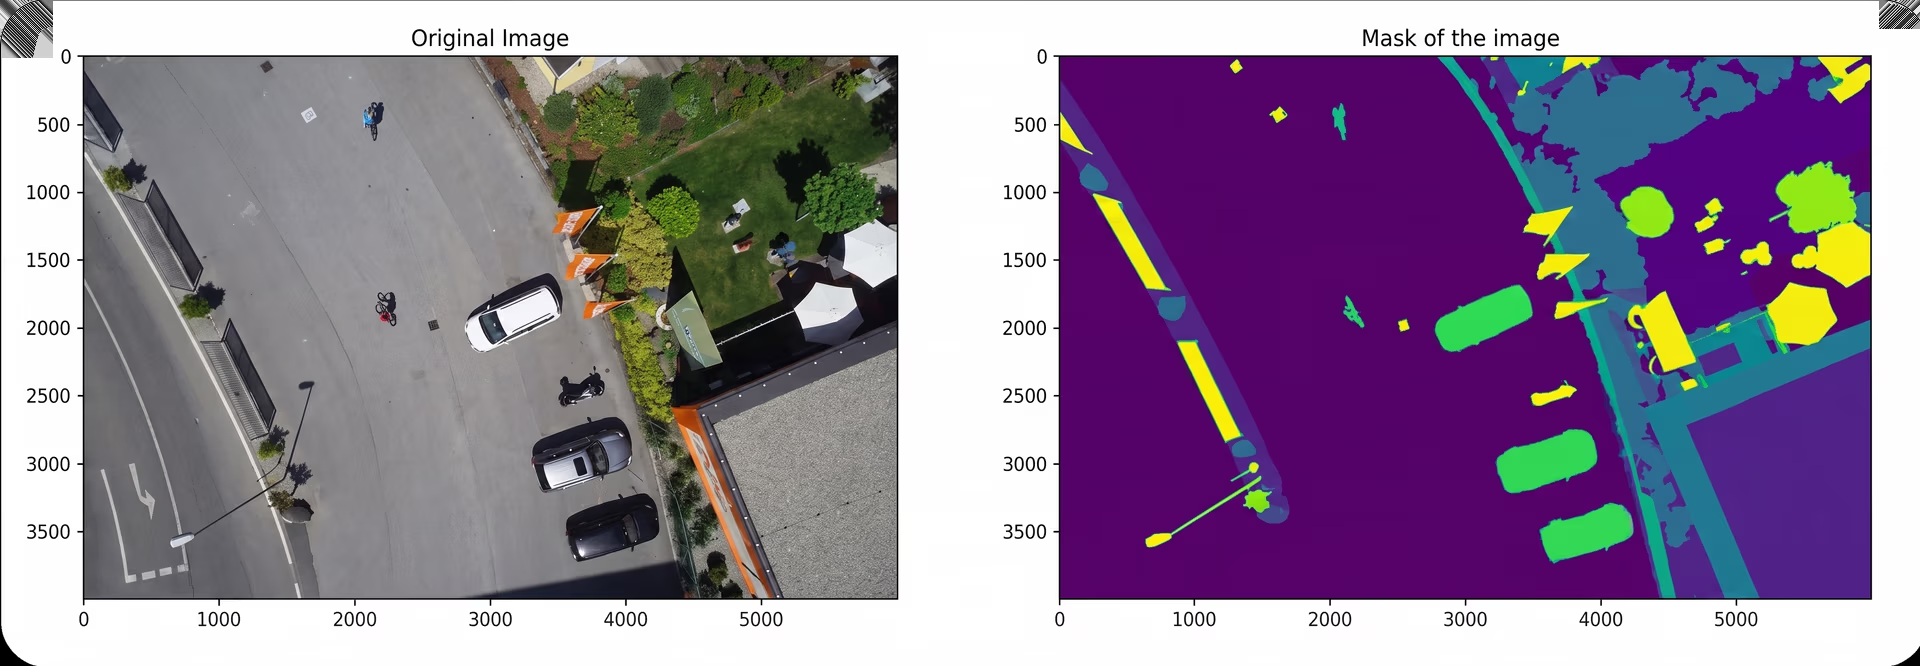
図1。U-Netディープラーニングモデルを使用したセグメンテーションの例です。(出典)
画像セグメンテーションの歴史#
U-Netの説明に入る前に、まず画像セグメンテーションモデルがどのように進化してきたかを見てみましょう。
当初、コンピュータービジョンでは、エッジ検出、しきい値処理、領域拡張などの従来型の手法を使って画像内の物体を分離していました。これらの手法では、エッジを使って物体の境界を検出し、ピクセル強度に基づいて領域を分割し、類似したピクセルをグループ化していました。単純なケースでは機能しましたが、画像にノイズや重なり合う形状、不明瞭な境界がある場合には、うまく機能しないことが多くありました。
2012年にディープラーニングが台頭すると、研究者たちは2014年に、セマンティックセグメンテーションなどのタスク向けに全畳み込みネットワーク(FCNs)の概念を導入しました。これらのモデルは、畳み込みネットワークの一部を置き換えることで、画像を小さく分割するのではなく、コンピューターが画像全体を一度に処理できるようにしました。これにより、画像内の内容をより明確に示す詳細なマップをモデルが生成できるようになりました。
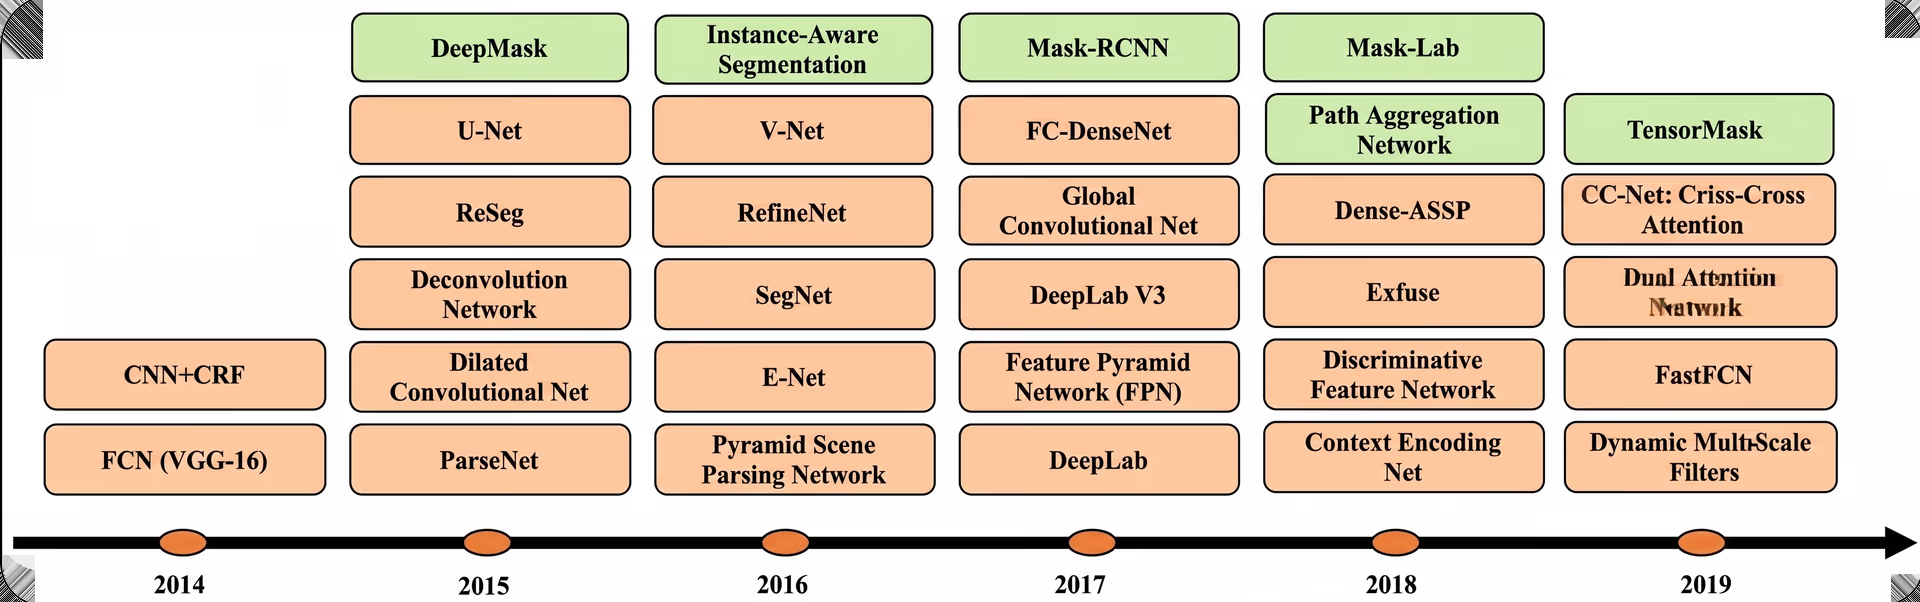
図2。ディープラーニングベースのセグメンテーションアルゴリズムの進化です。(出典)
全畳み込みネットワーク(FCNs)を基盤として、2015年にフライブルク大学の研究者たちがU-Netを発表しました。U-Netは当初、生物医学画像のセグメンテーション向けに設計されました。特に、アノテーション済みデータが限られた状況でも高い性能を発揮するよう設計されています。
一方、後続のUNet++やTransUNetでは、アテンションレイヤーや特徴抽出の改善などの機能強化が加えられました。アテンションレイヤーはモデルが重要な領域に焦点を当てるのに役立ち、特徴抽出の強化によってより詳細な情報を捉えられます。
U-Netとは何ですか?モデル内で特徴はどのように流れますか?#
U-Netは、画像セグメンテーション専用に構築されたディープラーニングモデルです。画像を入力として受け取り、各ピクセルを属する物体や領域に応じて分類するセグメンテーションマスクを出力します。
このモデルの名前は、U字型のアーキテクチャに由来します。画像を圧縮して特徴を学習するエンコーダーと、画像を元のサイズに戻すデコーダーという、2つの主要な部分で構成されています。この設計によって対称的なU字型が形成され、画像の全体構造と細部の両方をモデルが理解しやすくなります。
U-Netの重要な特徴の1つは、エンコーダーからデコーダーへ情報を直接渡すスキップ接続です。これにより、画像の圧縮時に失われる可能性のある重要な詳細をモデルが保持できます。
U-Netのアーキテクチャの概要#
U-Netのアーキテクチャの仕組みを簡単に見てみましょう。
- 入力画像: U-Netは、医療スキャンや衛星写真などの2D画像から処理を開始します。目的は、画像内のすべてのピクセルにクラスラベルを割り当てることです。
- ダウンサンプリング: 画像は、重要な視覚的特徴を学習する畳み込みレイヤーを通過します。画像が複数のレイヤーを進むにつれて解像度が下がり、モデルはより大局的なパターンを識別します。
- ボトルネックレイヤー: ネットワークの中央で、特徴マップは高レベルの意味的特徴を捉えながら、空間解像度が最小になります。簡単に言えば、この圧縮された特徴マップ表現が入力全体のコンテキストになります。
- アップサンプリング: 次に、ネットワークは解像度を徐々に高めながら画像を再構築します。転置畳み込みによって特徴マップを元のサイズに近づけます。
- スキップ接続: ダウンサンプリング経路の特徴マップを、アップサンプリング経路の特徴マップと連結します。これにより、高レベルのコンテキスト情報を統合しながら、空間的な細部を保持できます。
- 出力はセグメンテーションマップ: 最終出力は、入力と同じサイズのピクセル単位のセグメンテーションマスクです。各ピクセルは、物体、背景、関心領域などのカテゴリに分類されます。
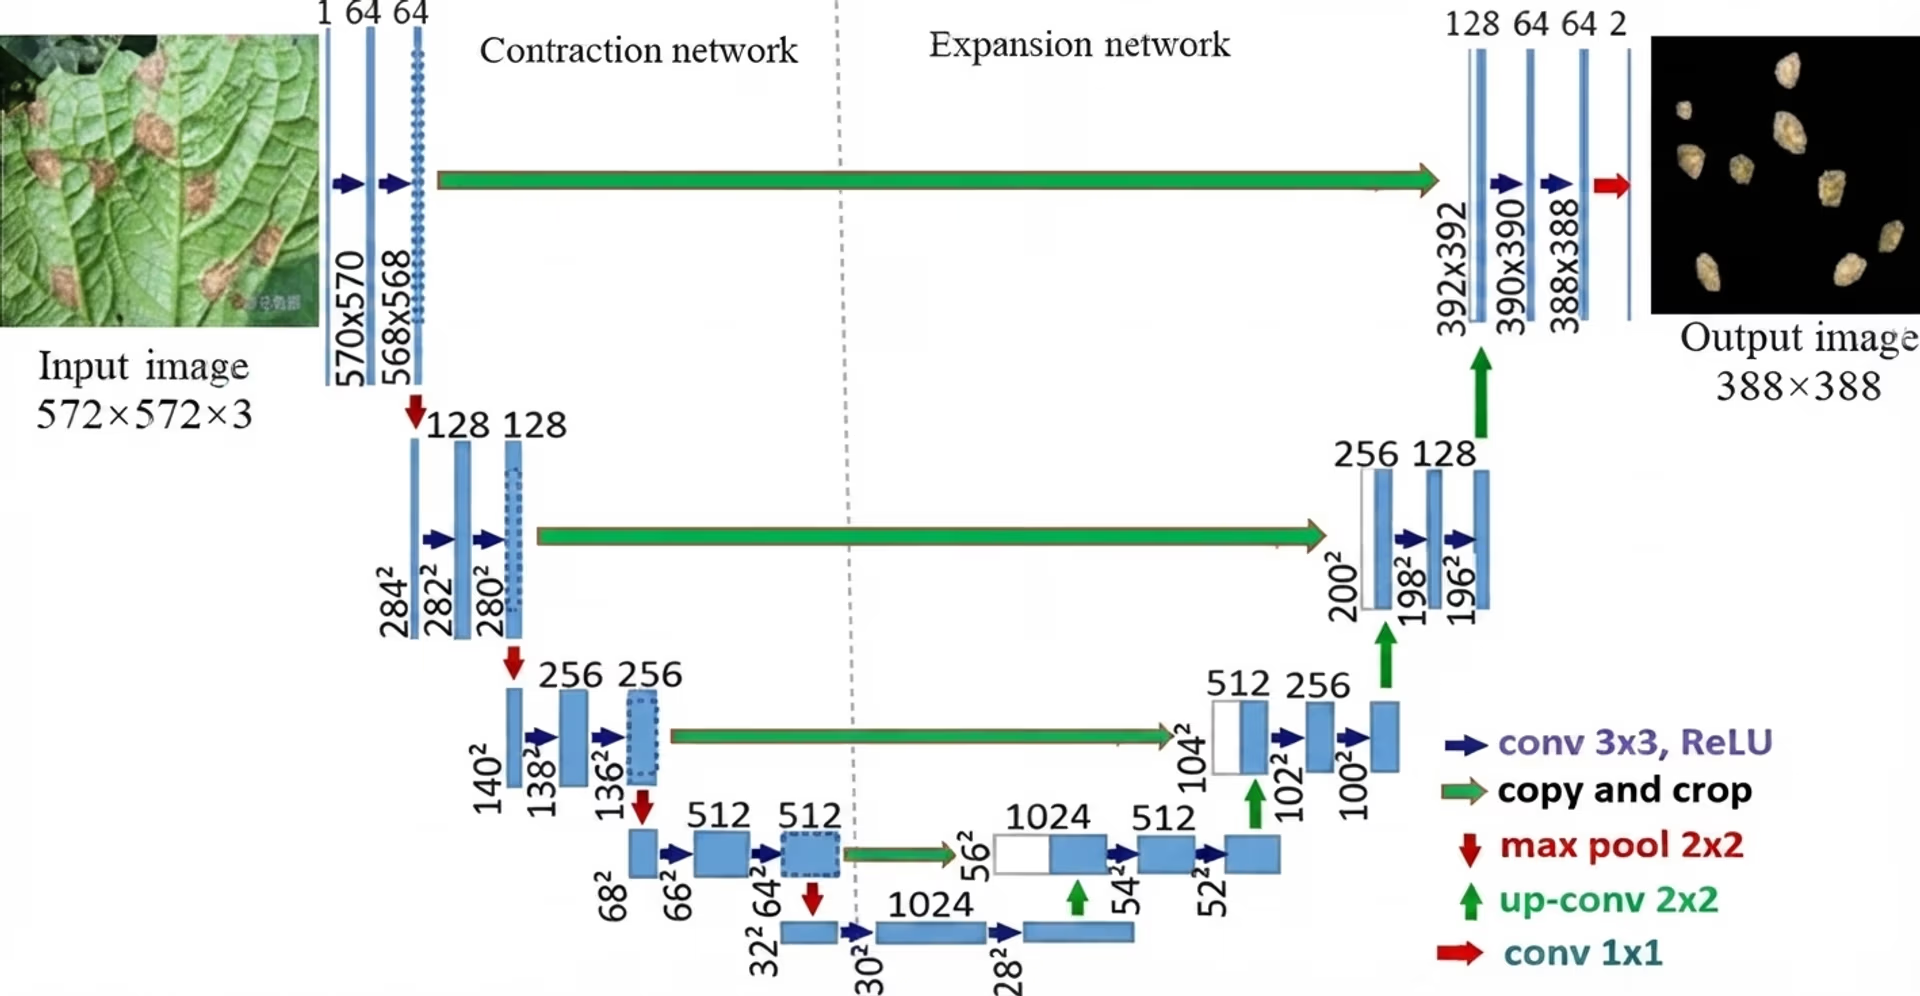
図3。U-Netのアーキテクチャ図です。(出典)
ViTとU-Netの違いを理解する#
U-Netについて調べていると、セグメンテーションタスクも実行できるビジョントランスフォーマー(ViT)など、ほかのディープラーニングモデルとの違いが気になるかもしれません。どちらのモデルも類似したタスクを実行できますが、構築方法やセグメンテーションの処理方法は異なります。
U-Netは、エンコーダー・デコーダー構造の畳み込みレイヤーを通じて、画像をピクセル単位で処理します。医療スキャンや自動運転車のシーンなど、精密なセグメンテーションが必要なタスクでよく使用されます。
一方、ビジョントランスフォーマー(ViT)は画像をパッチに分割し、アテンション機構を通じて同時に処理します。自己注意(画像の各部分の重要度を相互に比較してモデルが評価できる仕組み)を使い、画像内の各部分が互いにどのように関連しているかを捉えます。これは、U-Netの畳み込みベースのアプローチとは異なります。
もう1つの重要な違いは、ViTは十分に機能するために一般により多くのデータを必要としますが、複雑なパターンの把握に優れている点です。一方、U-Netは小規模なデータセットでも良好に機能し、学習が速く、多くの場合、学習時間も短くて済みます。
U-Netモデルの応用例#
U-Netとは何か、その仕組みについて理解が深まったところで、さまざまな分野でのU-Netの応用例を見ていきましょう。
医用画像における脳出血のセグメンテーション#
U-Netは、特に研究の最盛期において、複雑な医用画像をピクセル単位でセグメンテーションする信頼性の高い手法となりました。研究者たちは、CT画像やMRI画像から腫瘍や内出血の兆候など、重要な領域を強調するために使用しました。このアプローチは、研究環境における診断精度を大幅に高め、複雑な医療データの分析を効率化しました。
医療研究におけるU-Netの影響を示す例として、医用画像から脳卒中や脳出血を特定する用途があります。研究者はU-Netを使って頭部スキャンを分析し、懸念される領域を強調することで、早急な対応が必要な症例をより迅速に特定できました。
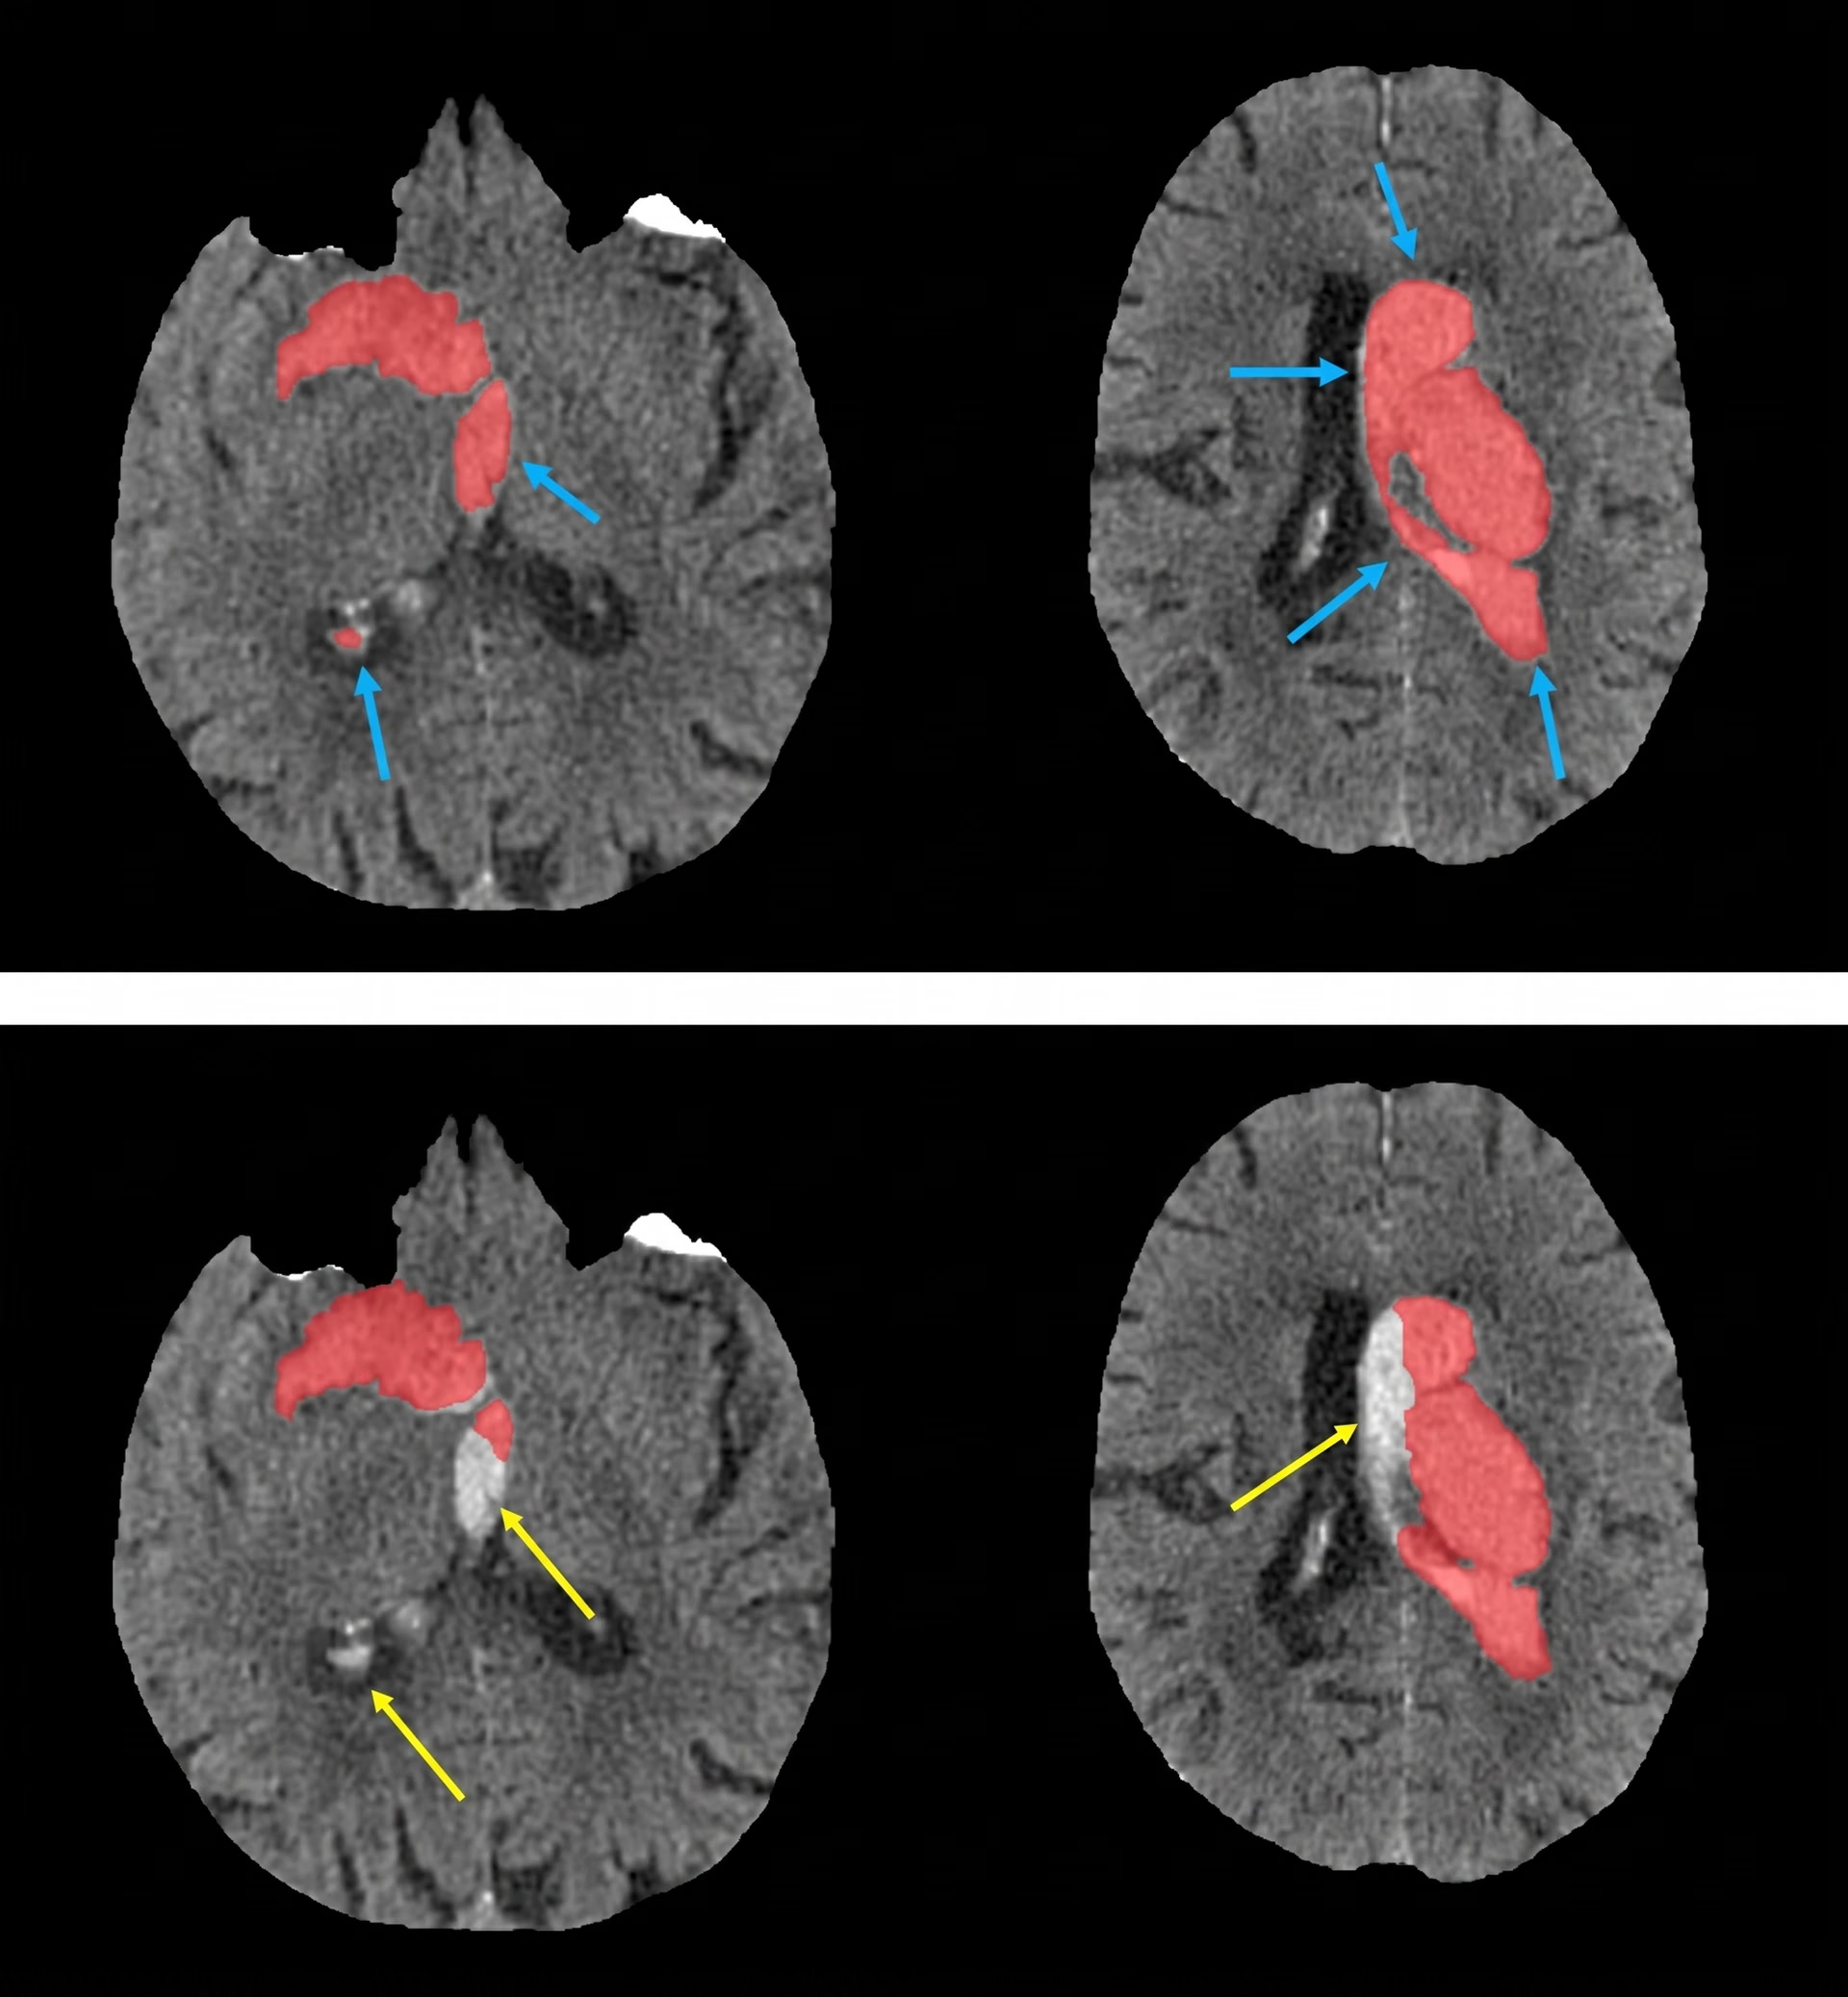
図4。3D U-Netを使用した出血性脳卒中病変のセグメンテーションです。(出典)
農業における作物のセグメンテーション#
研究者たちがU-Netを利用してきたもう1つの分野が農業で、作物、雑草、土壌のセグメンテーションに特に活用されています。農家が植物の健康状態を監視し、収量を推定し、広大な農地全体でより適切な判断を下すのに役立ちます。たとえば、U-Netは作物と雑草を分離できるため、除草剤の散布効率を高め、無駄を減らせます。
ドローン画像のモーションブラーなどの課題に対処するため、研究者たちは画像のデブラー処理技術を使ってU-Netを改良してきました。これにより、航空調査中など、移動しながらデータを収集した場合でも、より明瞭なセグメンテーションが可能になります。
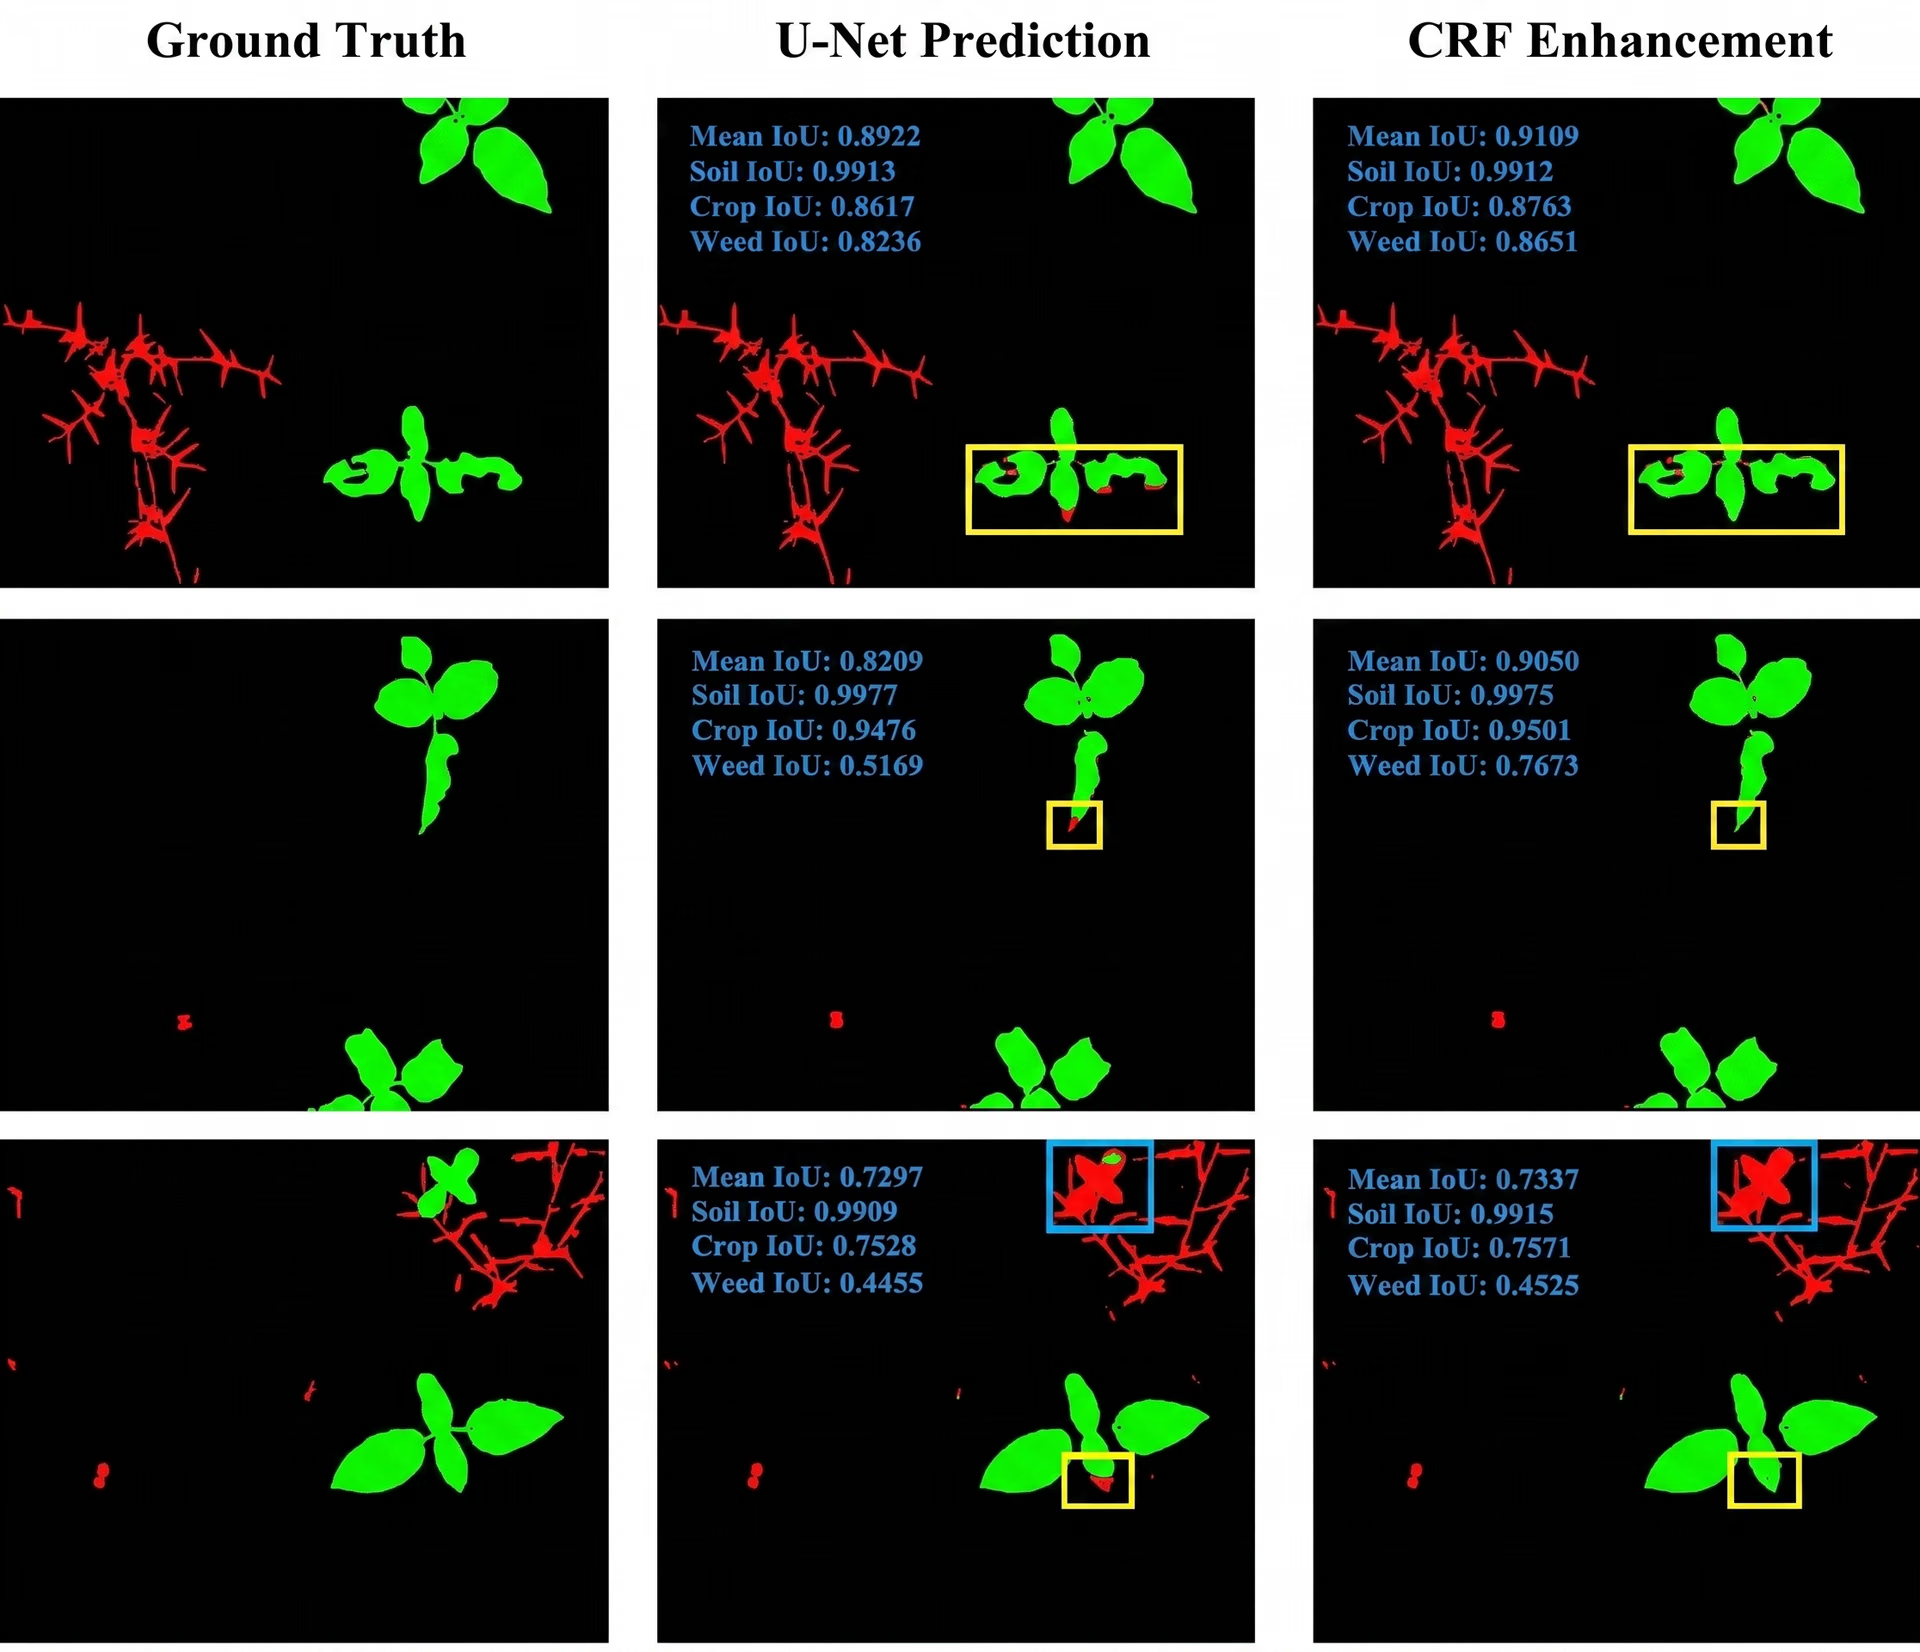
図5。U-Netによる農地での作物と雑草の分離です。(出典)
自動運転#
より高度なAIモデルが登場する前、U-Netはセグメンテーションが自動運転をどのように強化できるかを探るうえで重要な役割を果たしました。自動運転車では、U-Netのセマンティックセグメンテーションを使い、画像内の各ピクセルを道路、車両、歩行者、車線標示などのカテゴリに分類できます。これにより、車両は周囲の状況を明確に把握でき、安全な走行と効果的な意思決定に役立ちます。
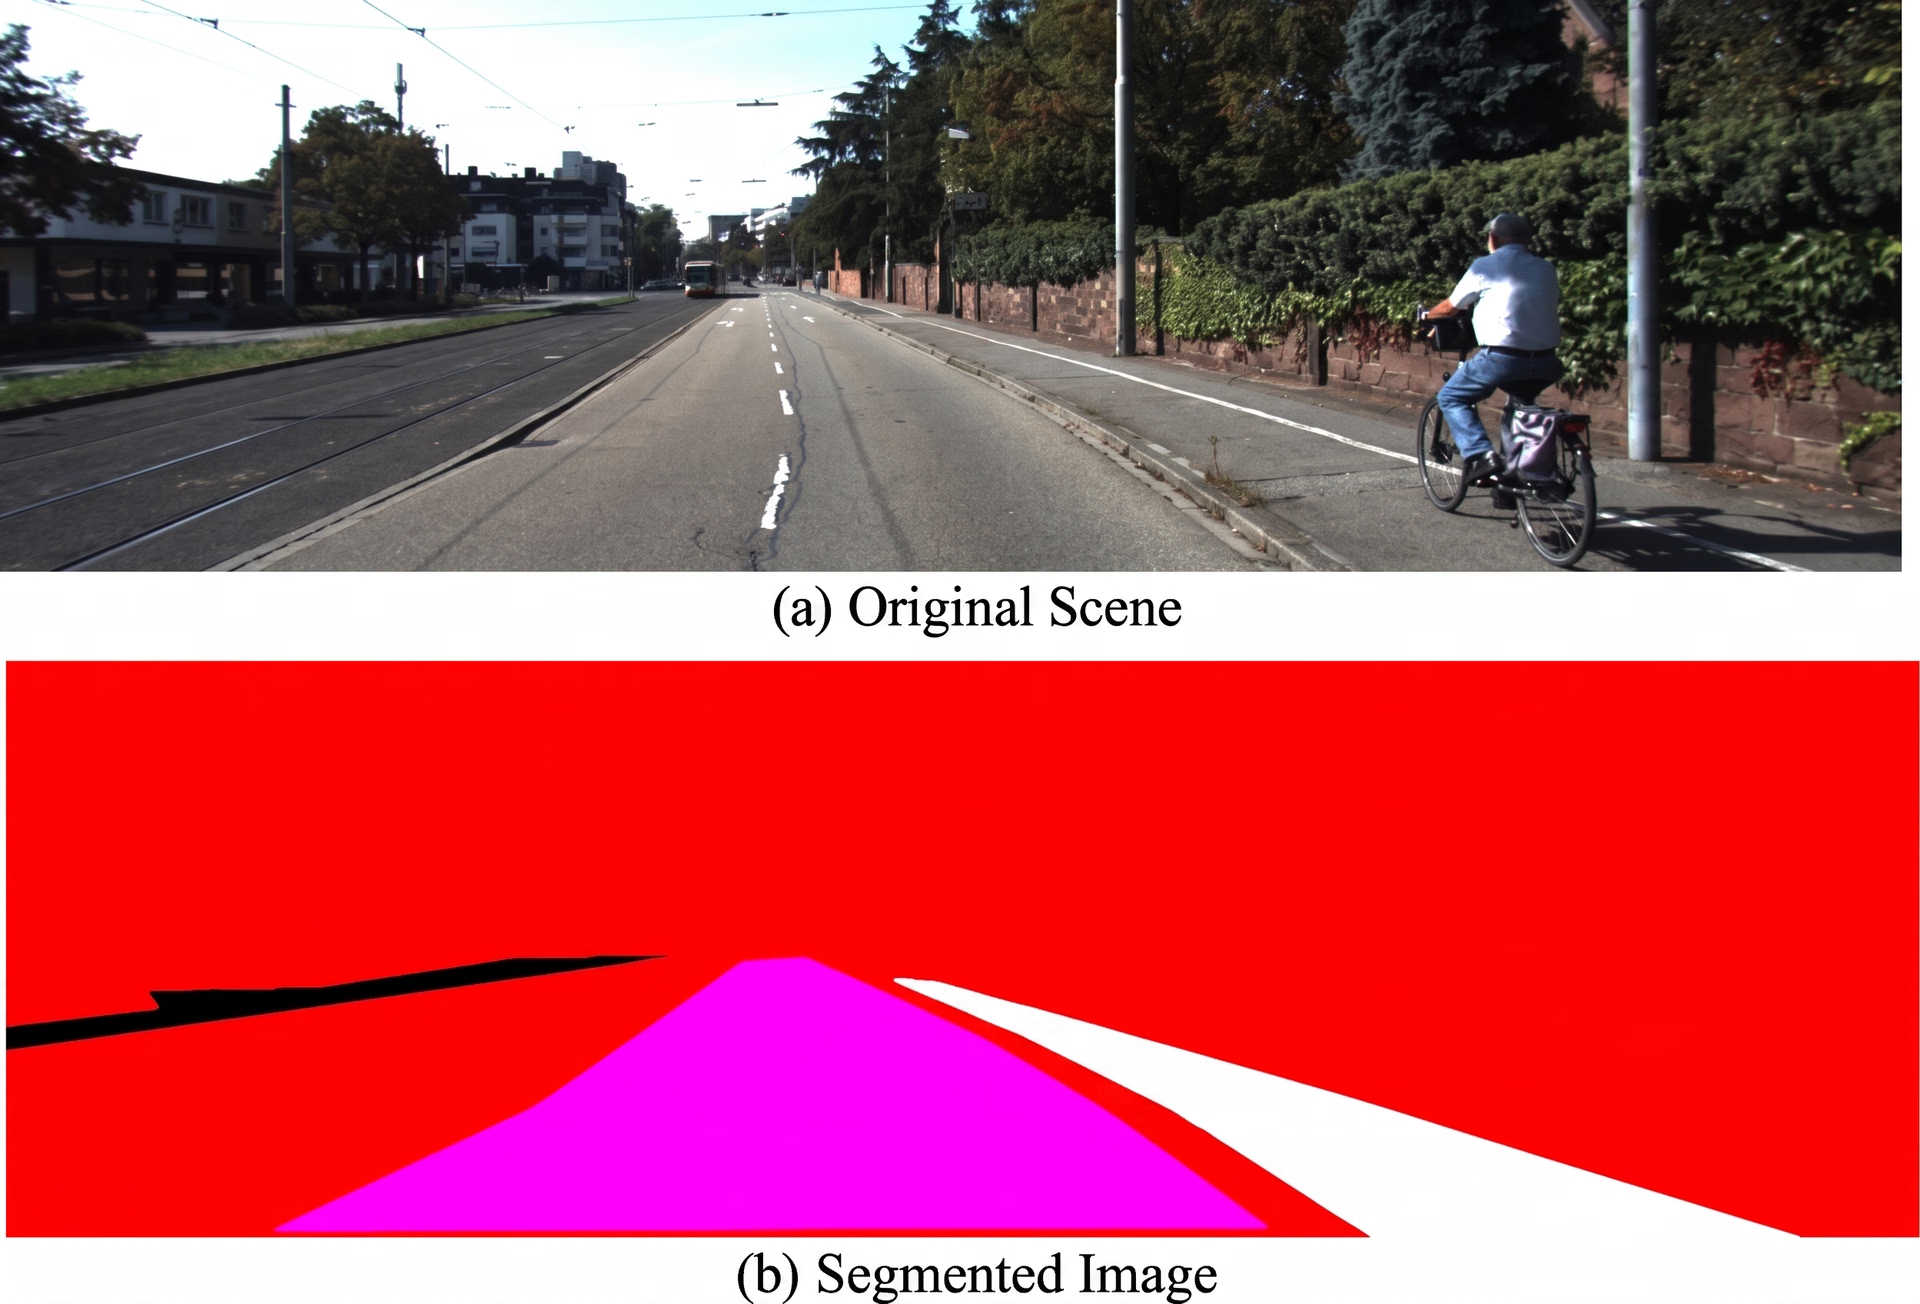
図6。U-Netで走行可能領域をセグメンテーションした道路シーンです。(出典)
U-Netの長所と短所#
現在でもU-Netは、シンプルさ、精度、適応性のバランスに優れているため、研究者にとって画像セグメンテーションの有力な選択肢です。U-Netの主な利点をいくつかご紹介します。
- さまざまなモダリティに適応: U-Netは、3D医療スキャン、衛星画像、動画フレームなど、さまざまな種類のデータに適応されています。
- 最適化時の高速な推論: 適切に調整すれば、U-Netは効率的に実行でき、リアルタイムまたはほぼリアルタイムのアプリケーションに適しています。
- オープンソースとコミュニティ: U-Netは主要なディープラーニングライブラリで利用でき、多くの開発者や研究者から成る大規模なコミュニティに支えられています。
U-Netには多くの強みがありますが、留意すべき制約もいくつかあります。検討すべき点をご紹介します。
- データ品質の影響を受けやすい: ノイズの多い画像や低解像度の画像など、データ品質が低いとU-Netの性能に悪影響を及ぼす可能性があります。
- 小規模なデータセットでは過学習しやすい: U-Netは限られたデータでも良好に機能しますが、適切な正則化を行わない場合、特にデータセットが小さすぎる場合や多様性に欠ける場合には、過学習のリスクがあります。
- 計算リソース: U-Netは、特に大規模なデータセットを扱う場合、計算コストが高くなることがあり、学習には多くのハードウェアリソースが必要です。
重要なポイント#
U-Netは、画像セグメンテーションの進化における重要な節目となりました。特に医用画像などの分野で、ディープラーニングモデルが小規模なデータセットを使っても高精度な結果を得られることを実証しました。
この画期的な成果は、さまざまな分野におけるより高度な応用への道を開きました。コンピュータービジョンが進化し続ける中、U-Netのようなセグメンテーションモデルは、機械が視覚データを高精度に理解し解釈するための基盤であり続けています。
独自のコンピュータービジョンプロジェクトの構築をお考えですか?GitHubリポジトリでAIについて詳しく学び、ライセンスオプションをご確認ください。医療分野のコンピュータービジョンが効率をどのように向上させているかを学び、ソリューションページで小売分野のAIの影響をご覧ください。成長を続けるコミュニティに今すぐご参加ください。









