Florence-2:Microsoftの最新視覚言語モデル
Microsoftの視覚言語モデルFlorence-2をご紹介します。物体検出、セグメンテーション、キャプション生成、グラウンディングに対応し、ゼロショット性能にも優れています。
 Abirami Vina8 分で読めます
2024年6月、Microsoftは、物体検出、セグメンテーション、画像キャプション生成、グラウンディングなど幅広いタスクに対応するよう設計された、マルチモーダルな視覚言語モデル(VLM)であるFlorence-2を発表しました。Florence-2は、特定の事前学習なしでタスクを実行できるゼロショット性能で新たなベンチマークを打ち立て、ほかの最先端の視覚言語モデルよりも小さなモデルサイズを実現しています。
Florence-2は単なる新しいモデルではありません。その汎用性と向上した性能は、精度を高め、広範なトレーニングの必要性を減らすことで、さまざまな業界に大きな影響を与える可能性があります。この記事では、Florence-2の主な機能を紹介し、ほかのVLMとの性能を比較するとともに、用途の可能性について説明します。
Florence-2とは何ですか?#
Florence-2は、統一された1つのフレームワーク内でさまざまなタスクに対応できます。その能力の一部は、FLD-5Bと呼ばれる大規模なトレーニングデータセットによるものです。FLD-5Bには、1億2,600万枚の画像に対する54億件のアノテーションが含まれています。この包括的なデータセットは、Florence-2が幅広いビジョンタスクを高い精度と効率で処理するために必要な能力を備えられるよう、専用に作成されました。
Florence-2が対応するタスクを詳しく見ていきましょう。
- 物体検出: 画像内の物体を高い精度で識別し、その位置を特定できます。
- セグメンテーション: 画像を意味のあるセグメントに分割し、分析や解釈を容易にするタスクです。
- 画像キャプション生成: Florence-2は、画像の背景や詳細を伝える説明的なキャプションを生成できます。
- ビジュアルグラウンディング: キャプション内の特定の語句や単語を、画像内の対応する領域に関連付けることができます。
- ゼロショット性能: 個別のトレーニングなしでタスクを実行できます。
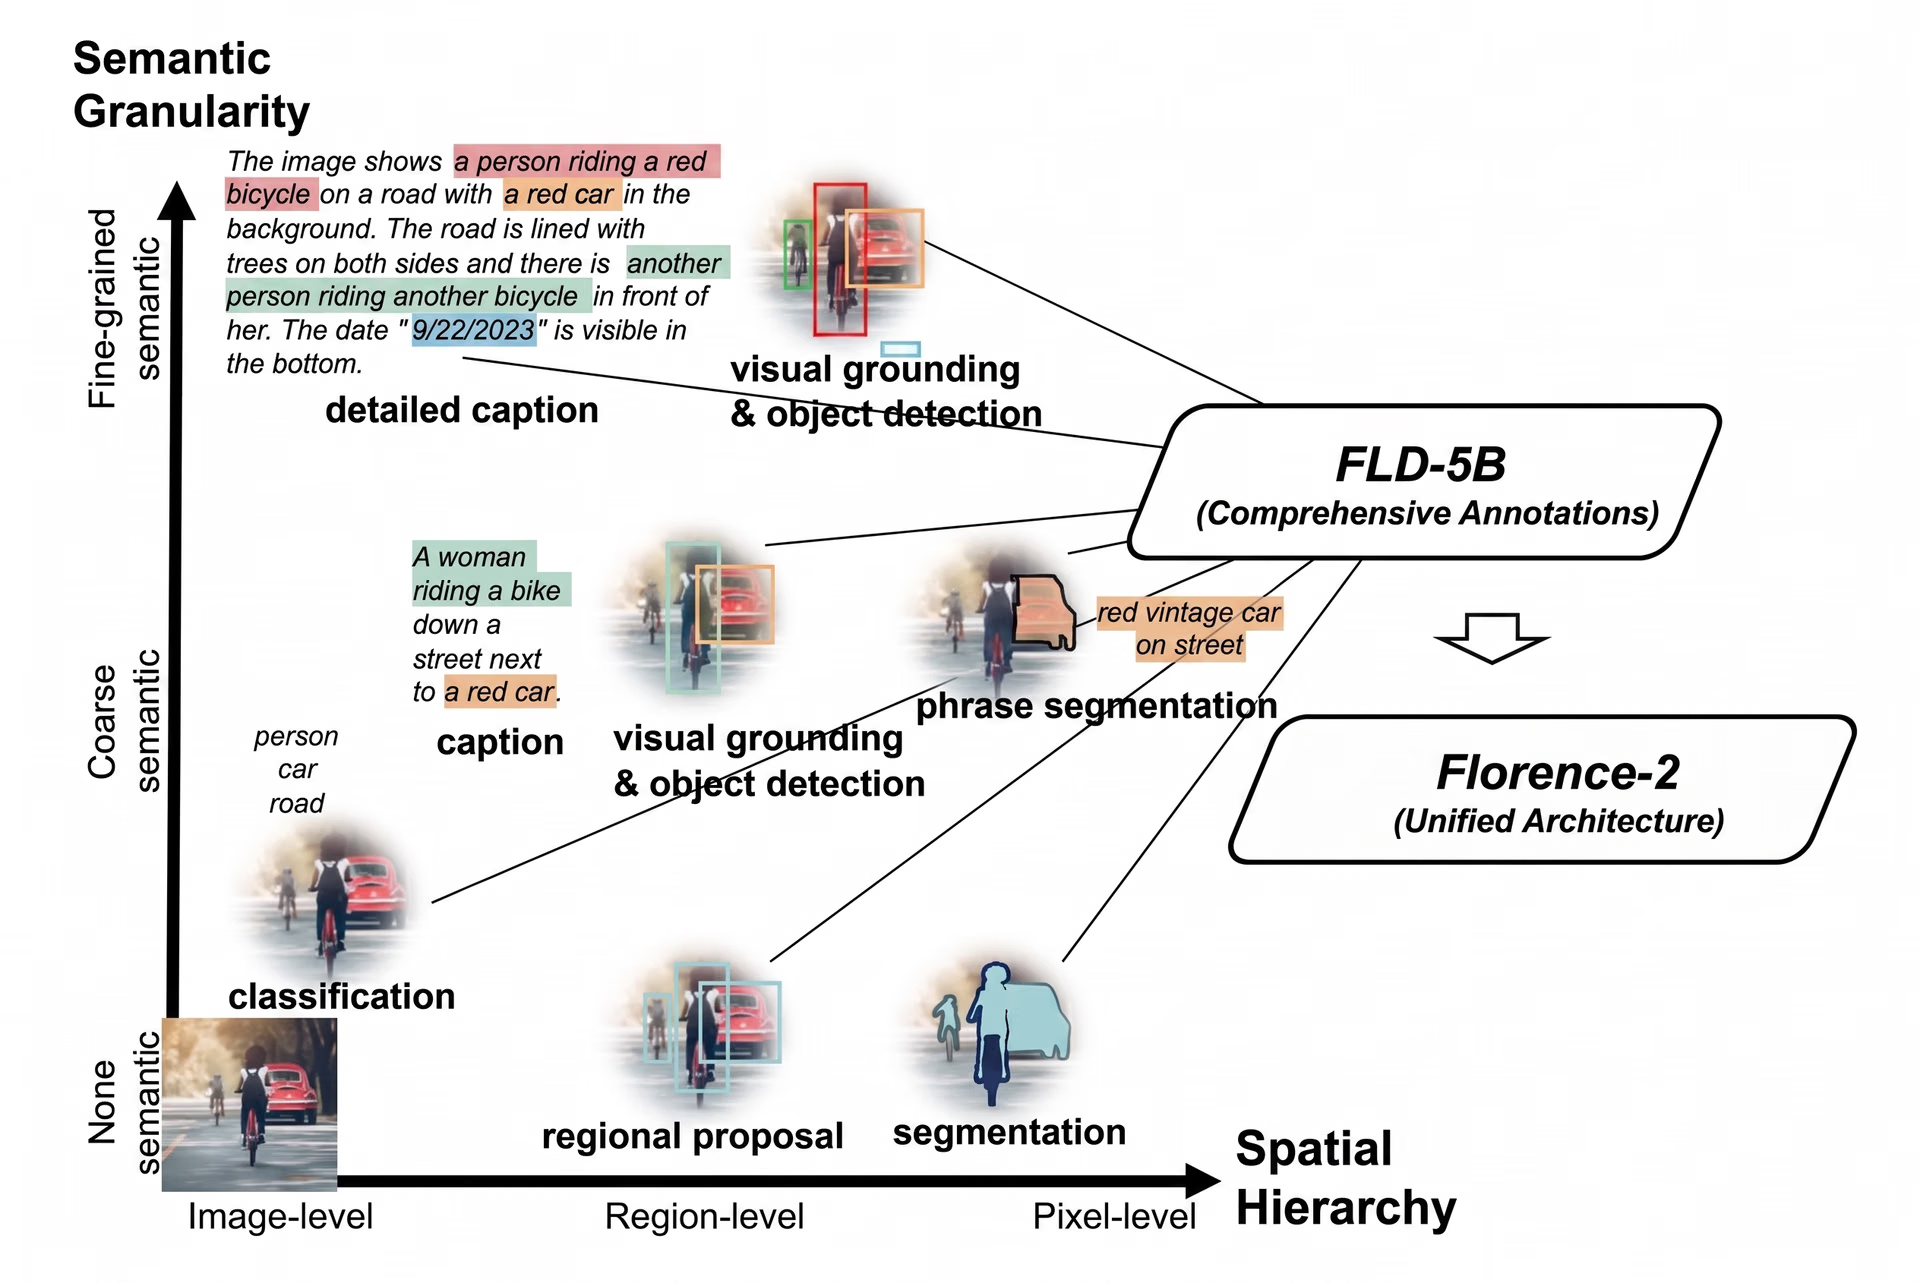
図1。Florence-2のトレーニング方法。
このモデルは、テキストベースのタスクと領域ベースのタスクの両方に対応しています。画像内の特定領域を扱うタスク向けに、位置を示す特殊なトークンがモデルの語彙に追加されています。これらのトークンにより、物体を囲む長方形(ボックス表現)、四辺形(四角形ボックス表現)、多辺形(ポリゴン表現)など、さまざまな形状をモデルが理解できます。モデルは標準的な交差エントロピー損失関数を使ってトレーニングされ、予測と正解を比較し、それに応じて内部パラメーターを調整することで学習します。
FLD-5Bデータセットの作成#
FLD-5Bデータセットには、テキストによる説明、領域とテキストのペア、テキスト・フレーズ・領域の組み合わせなど、さまざまな種類のアノテーションが含まれています。このデータセットは、データ収集とアノテーションを含む2段階のプロセスで作成されました。画像はImageNet-22k、Objects365、Open Images、Conceptual Captions、LAIONなどの一般的なデータセットから取得されました。FLD-5Bデータセットのアノテーションはほとんどが合成データであり、手動ではなく自動で生成されています。
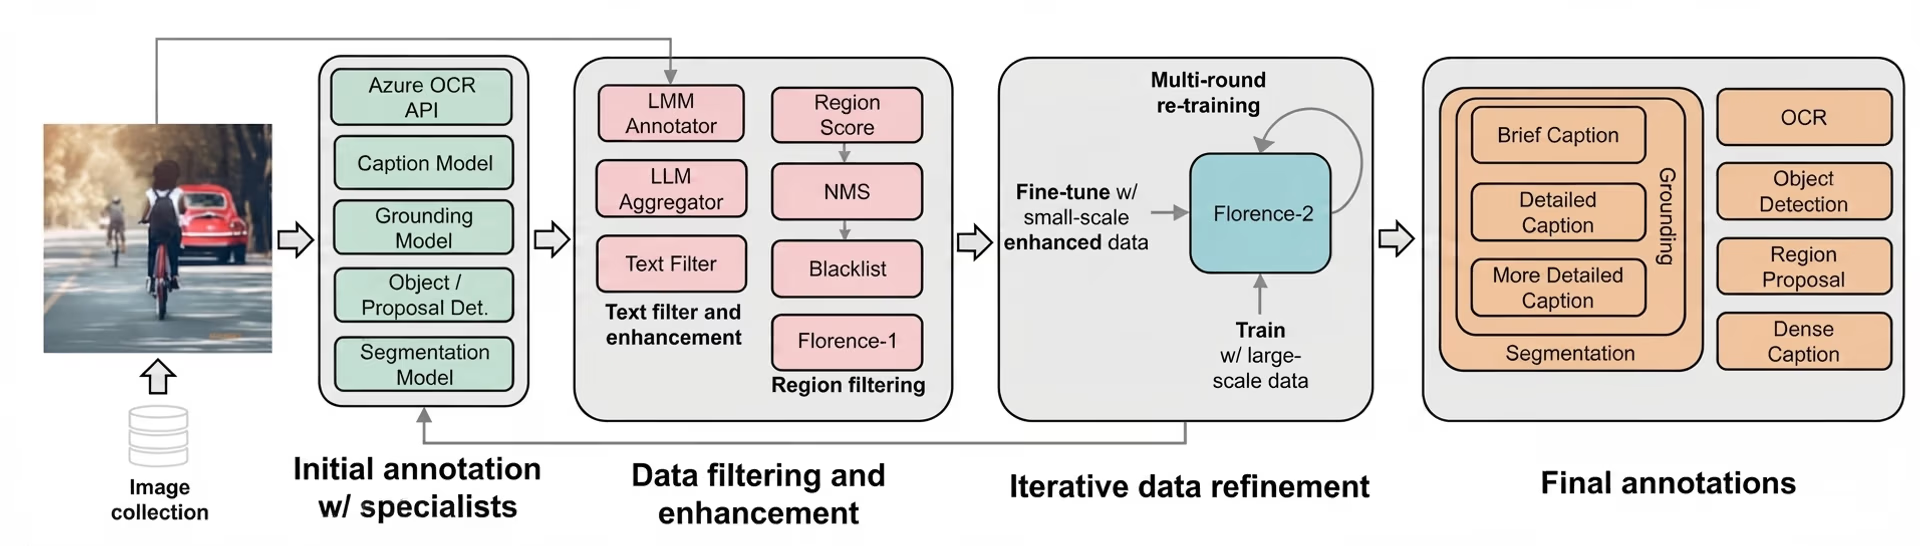
図2。FLD-5Bデータセットの作成。
最初に、物体検出やセグメンテーションなど、特定のタスクに特化した専門モデルがアノテーションを作成しました。次に、アノテーションの詳細度と正確性を確保するため、フィルタリングと強化のプロセスを実施しました。ノイズを除去した後、データセットを反復的に改良し、Florence-2の出力を使ってアノテーションを継続的に更新・改善しました。
Florence-2のモデルアーキテクチャを理解する#
Florence-2のモデルアーキテクチャは、シーケンス間学習のアプローチを採用しています。つまり、モデルは入力シーケンス(画像とテキストプロンプトなど)を処理し、出力シーケンス(説明やラベルなど)を段階的に生成します。シーケンス間のフレームワークでは、各タスクを翻訳問題として扱います。モデルは入力画像とタスク固有のプロンプトを受け取り、対応する出力を生成します。
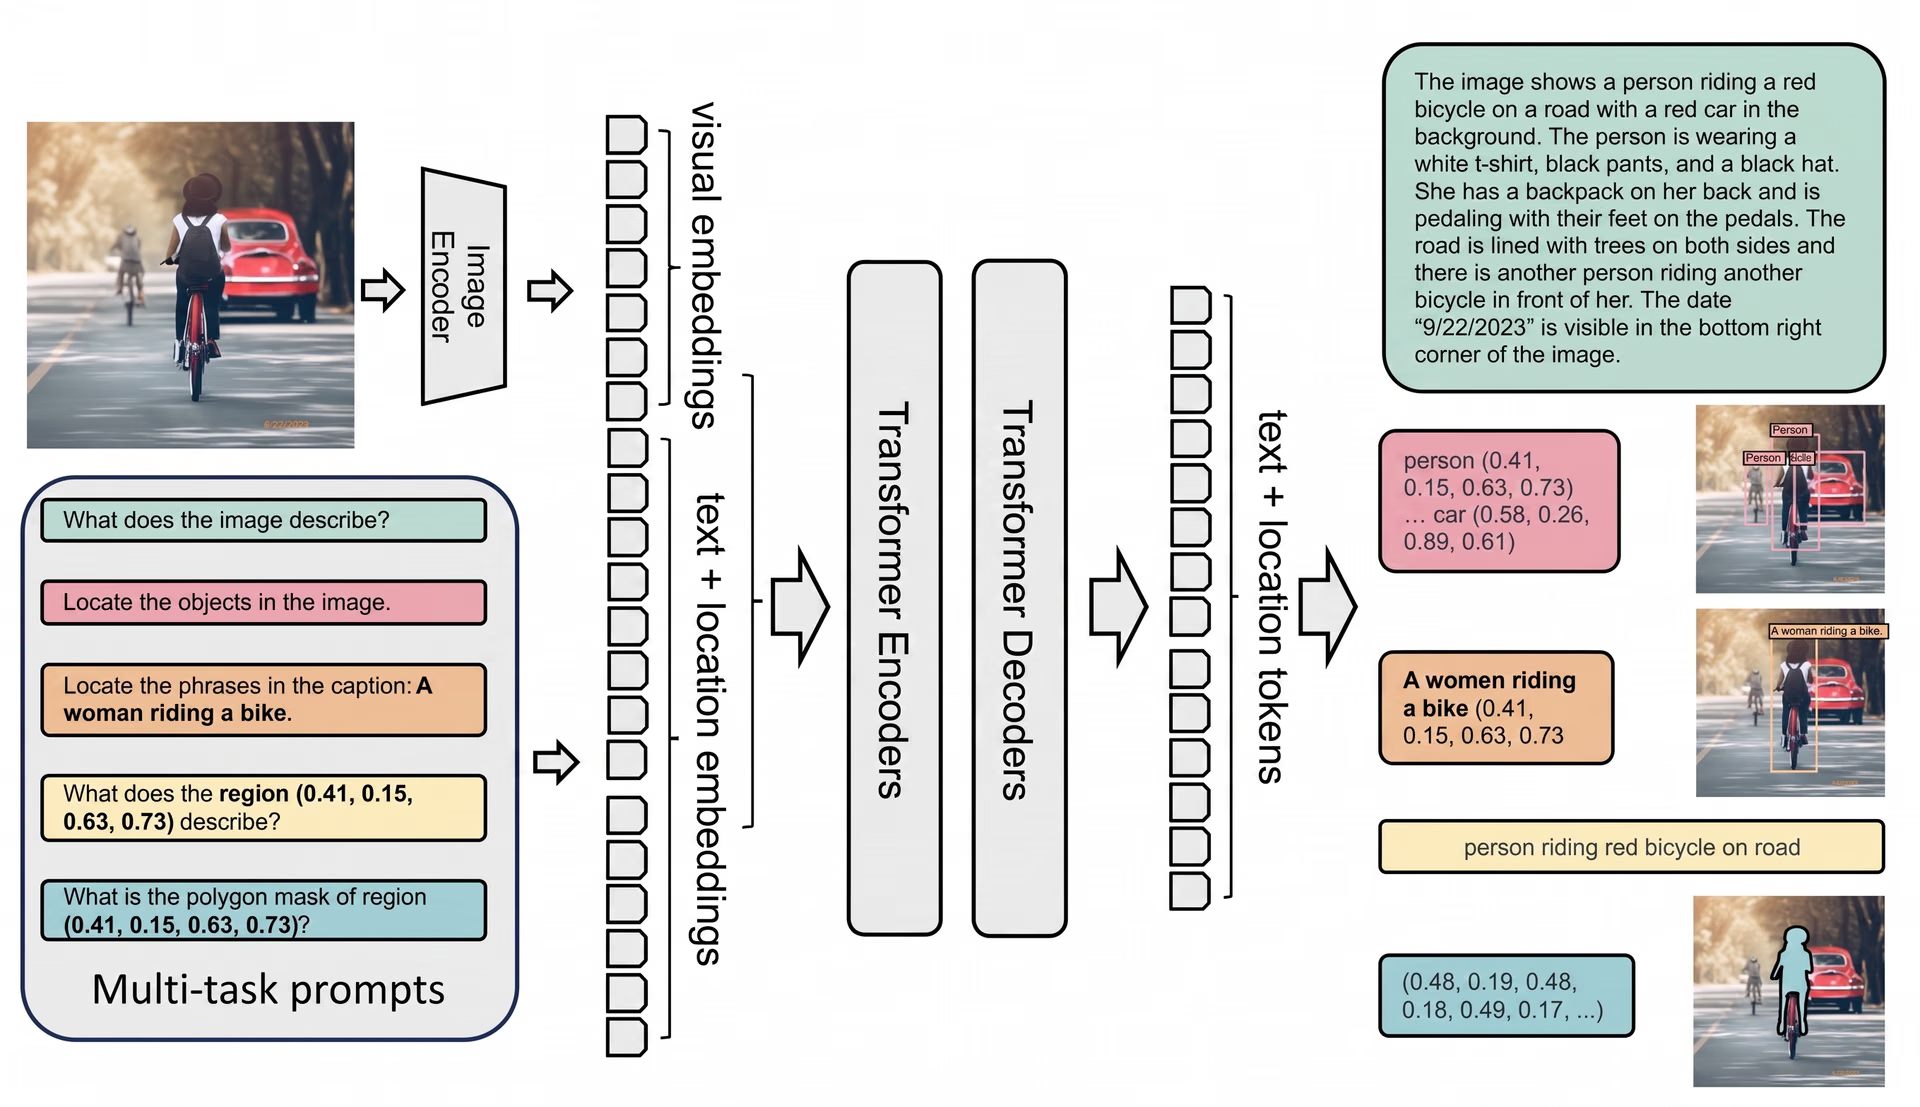
図3。Florence-2の視覚言語モデルアーキテクチャ。
モデルアーキテクチャの中核となるのは、画像エンコーダーとマルチモダリティのエンコーダー・デコーダーを組み合わせた、マルチモダリティのエンコーダー・デコーダーTransformerです。DaViT(Dual Attention Vision Transformer)と呼ばれる画像エンコーダーは、入力画像を視覚トークンの埋め込みに変換して処理します。これは、空間情報(物体の位置)と意味情報(物体の内容)の両方を捉えた、画像のコンパクトな表現です。これらの視覚トークンをテキスト埋め込み(テキストの表現)と組み合わせることで、モデルはテキストデータと視覚データを統合できます。
Florence-2と他のVLMとの比較#
Florence-2は、優れたゼロショット能力により、ほかの視覚言語モデルと一線を画しています。さまざまなタスクに適応するために大規模なファインチューニングを必要とするPaliGemmaなどのモデルとは異なり、Florence-2はすぐに高い性能を発揮します。また、Florence-2はGPT-4VやFlamingoなどのより大規模なモデルとも競合できます。こうしたモデルはパラメーター数がはるかに多いことがよくありますが、常にFlorence-2と同等の性能を発揮するとは限りません。たとえば、Kosmos-2のパラメーター数は2倍以上ですが、Florence-2はゼロショット評価でKosmos-2を上回る結果を達成しています。
ベンチマークテストでは、Florence-2はCOCOキャプション生成や参照表現理解などのタスクで優れた性能を示しています。COCOデータセットを使った物体検出とセグメンテーションのタスクでは、PolyFormerやUNINEXTなどのモデルを上回りました。性能とリソース効率の両方が重要な実世界のアプリケーションで、非常に競争力の高い選択肢です。Ultralytics PlatformではFlorence-2を使って検出データセットに自動アノテーションを行い、VLM Leaderboardでほかの視覚言語モデルと比較できます。
Florence-2の応用#
Florence-2は、エンターテインメント、アクセシビリティ、教育など、さまざまな業界で活用できます。理解を深めるため、いくつかの例を見ていきましょう。
画像キャプション生成の応用#
ストリーミングプラットフォームで視聴する作品を選ぶとき、参考として映画のあらすじを読むことがあるでしょう。プラットフォームが映画ポスターの詳細な説明も提供できるとしたらどうでしょうか。Florence-2は、画像の説明文を生成する画像キャプション生成によって、それを実現できます。Florence-2は映画ポスターの詳細な説明を生成し、視覚障害のあるユーザーにとってストリーミングプラットフォームをより利用しやすくします。登場人物、風景、テキストなどの視覚要素を分析することで、ポスターの内容や雰囲気を伝える詳細な説明を作成できます。以下の画像は、Florence-2が説明で提供できる詳細度を示しています。
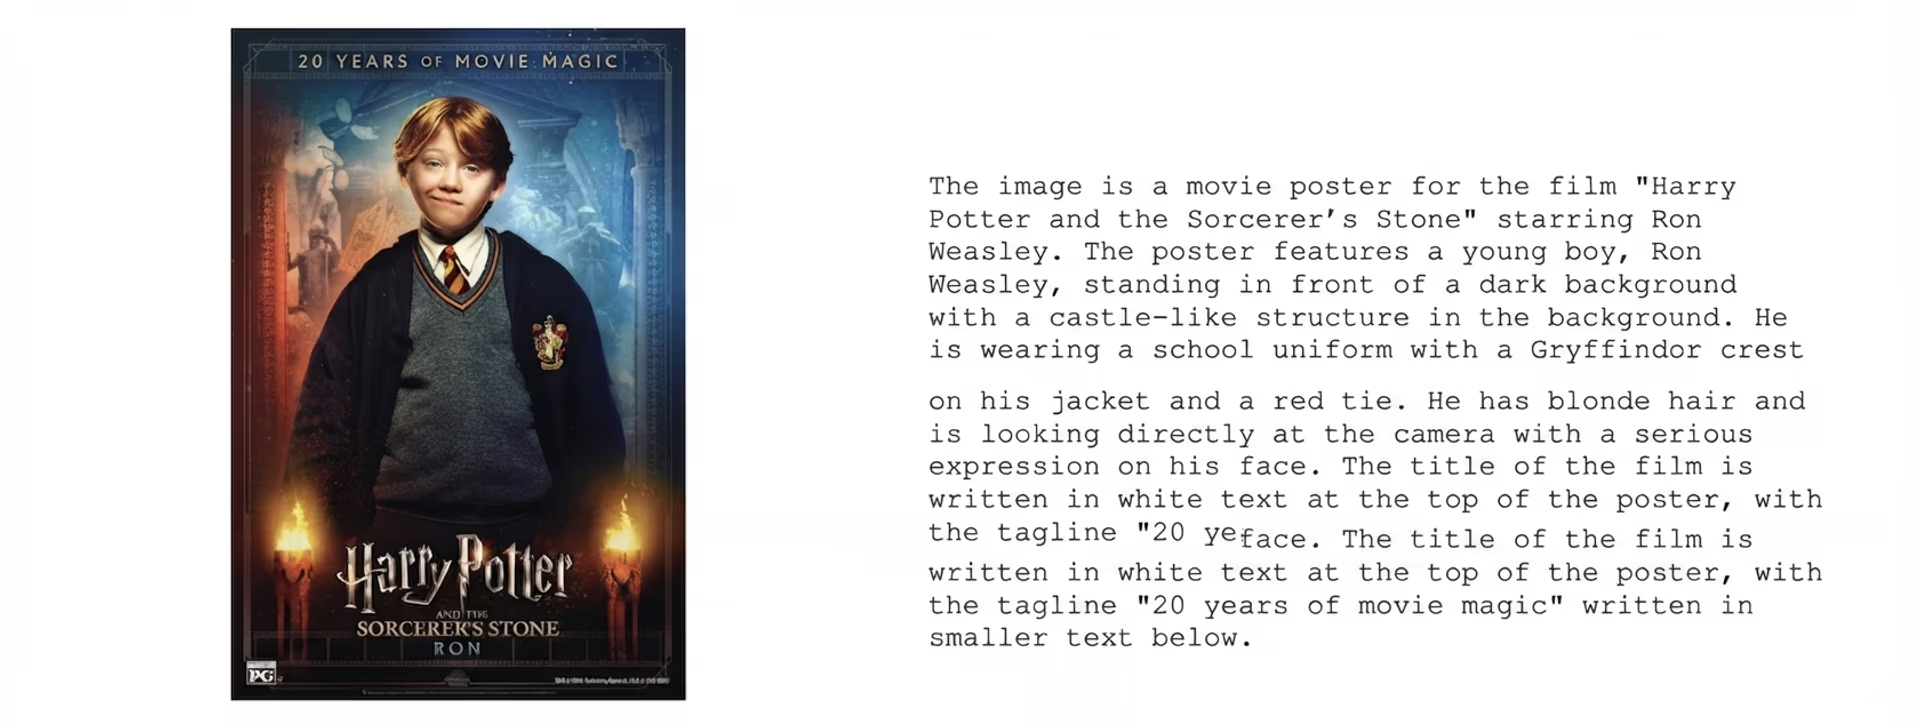
図4 Florence-2が生成した画像キャプションの例
画像キャプション生成が役立つその他の例を紹介します。
- Eコマース:画像キャプション生成で商品画像を詳しく説明することで、顧客が商品の特徴や詳細をより明確に理解できるようになります。
- 旅行・観光: 旅行ガイドやアプリで、ランドマークや観光名所の詳細な説明を提供できます。
- 教育: 画像キャプション生成を使って、教材の画像や図にラベルを付けて説明することで、教育や学習を支援できます。
- 不動産: 物件画像の詳細な説明を提供し、購入希望者に向けて特徴や設備を紹介できます。
調理におけるビジュアルグラウンディングの活用#
Florence-2は、料理体験の向上にも活用できます。たとえば、オンラインの料理本でFlorence-2を使い、複雑なレシピ画像内の各部分をビジュアルグラウンディングで識別してラベル付けできます。ビジュアルグラウンディングは、画像内の特定部分を対応する説明テキストに関連付けます。材料や手順を正確にラベル付けして説明できるため、家庭で料理をする人がレシピに従い、料理における各要素の役割を理解しやすくなります。
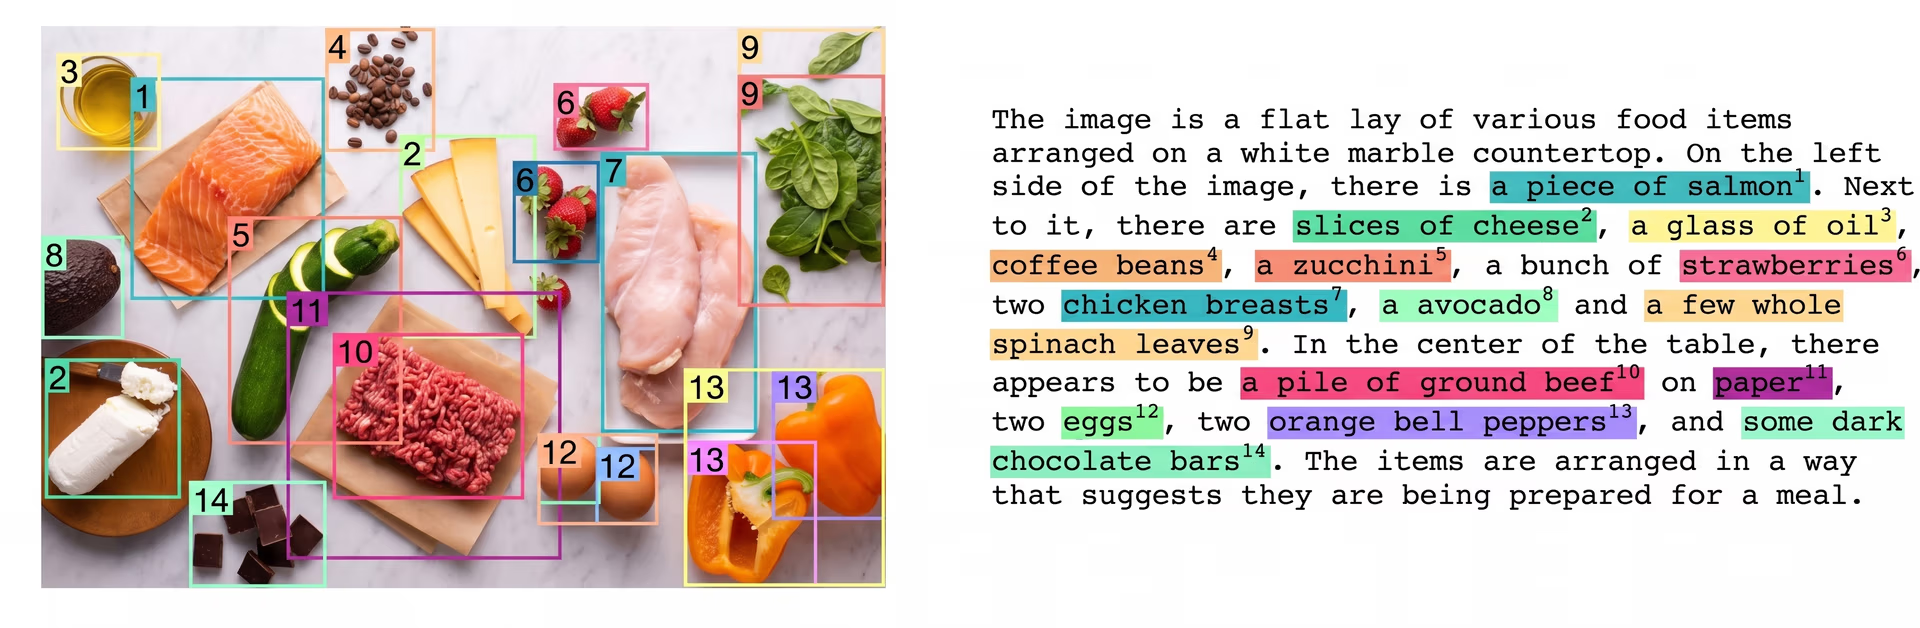
図5 Florence-2を使ったビジュアルグラウンディングの例
金融文書における領域ベースのOCR#
文書内の特定領域からテキストを抽出する領域ベースの処理を用いたOCRは、会計などの分野で役立ちます。金融文書の指定領域を分析して、取引の詳細、口座番号、期日などの重要な情報を自動抽出できます。手作業でのデータ入力を減らすことで、エラーを最小限に抑え、処理時間を短縮できます。金融機関は、請求書の処理、領収書の照合、小切手の決済などを効率化するために活用でき、取引の迅速化と顧客サービスの向上につながります。
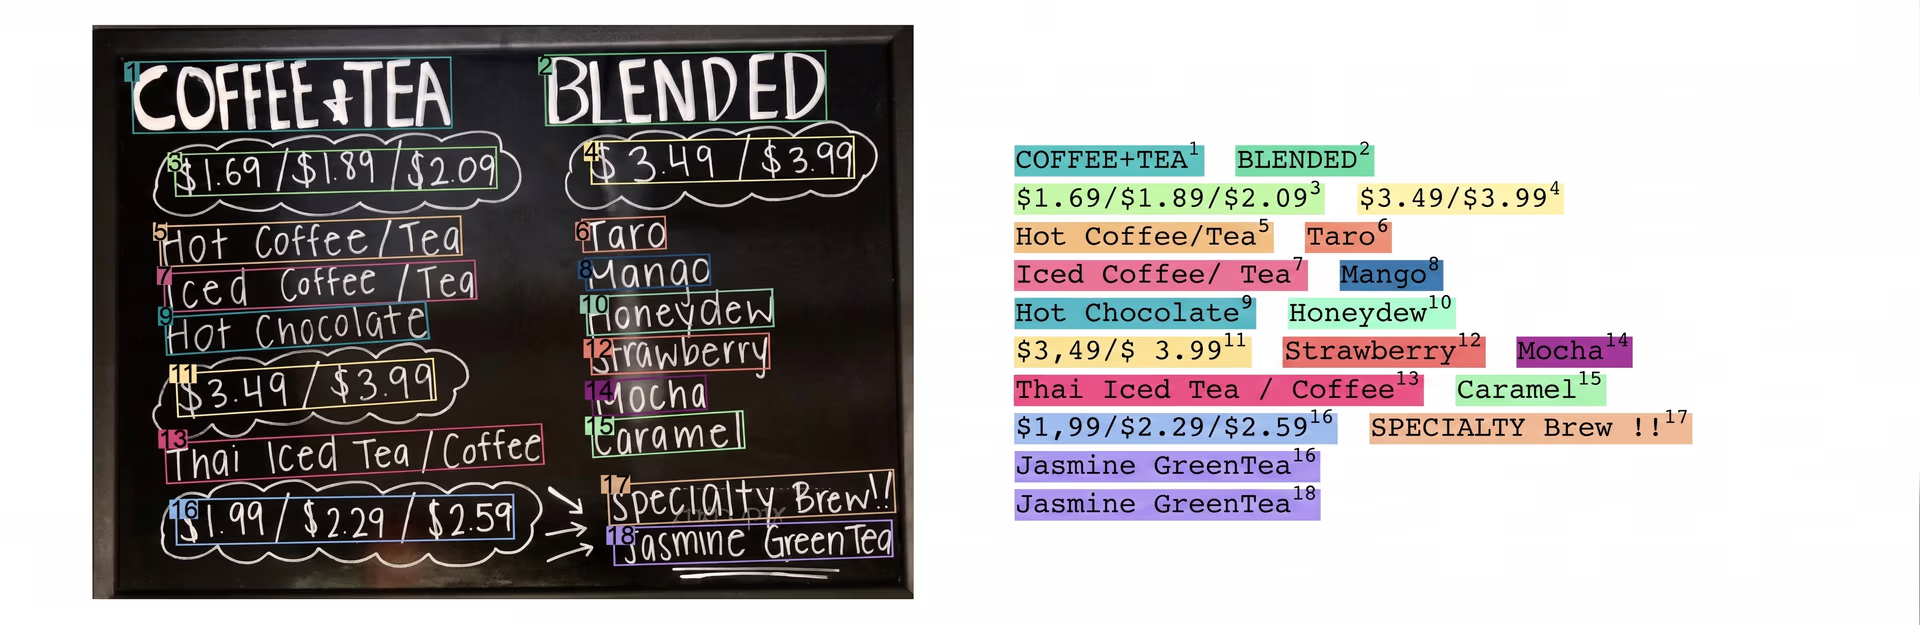
図6 Florence-2を使った領域ベースのOCRテキスト抽出の例
産業用途における領域ベースのセグメンテーション#
画像を意味のある部分に分割して重点的な分析や詳細な検査を行う領域ベースのセグメンテーションは、さまざまなプロセスの精度と効率を高める産業用途を支援できます。画像内の特定領域に焦点を当てることで、部品や製品を詳細に検査・分析できます。品質管理では、素材のひび割れや位置ずれなどの欠陥や不整合を検出し、最高品質の製品だけが市場に出るようにできます。
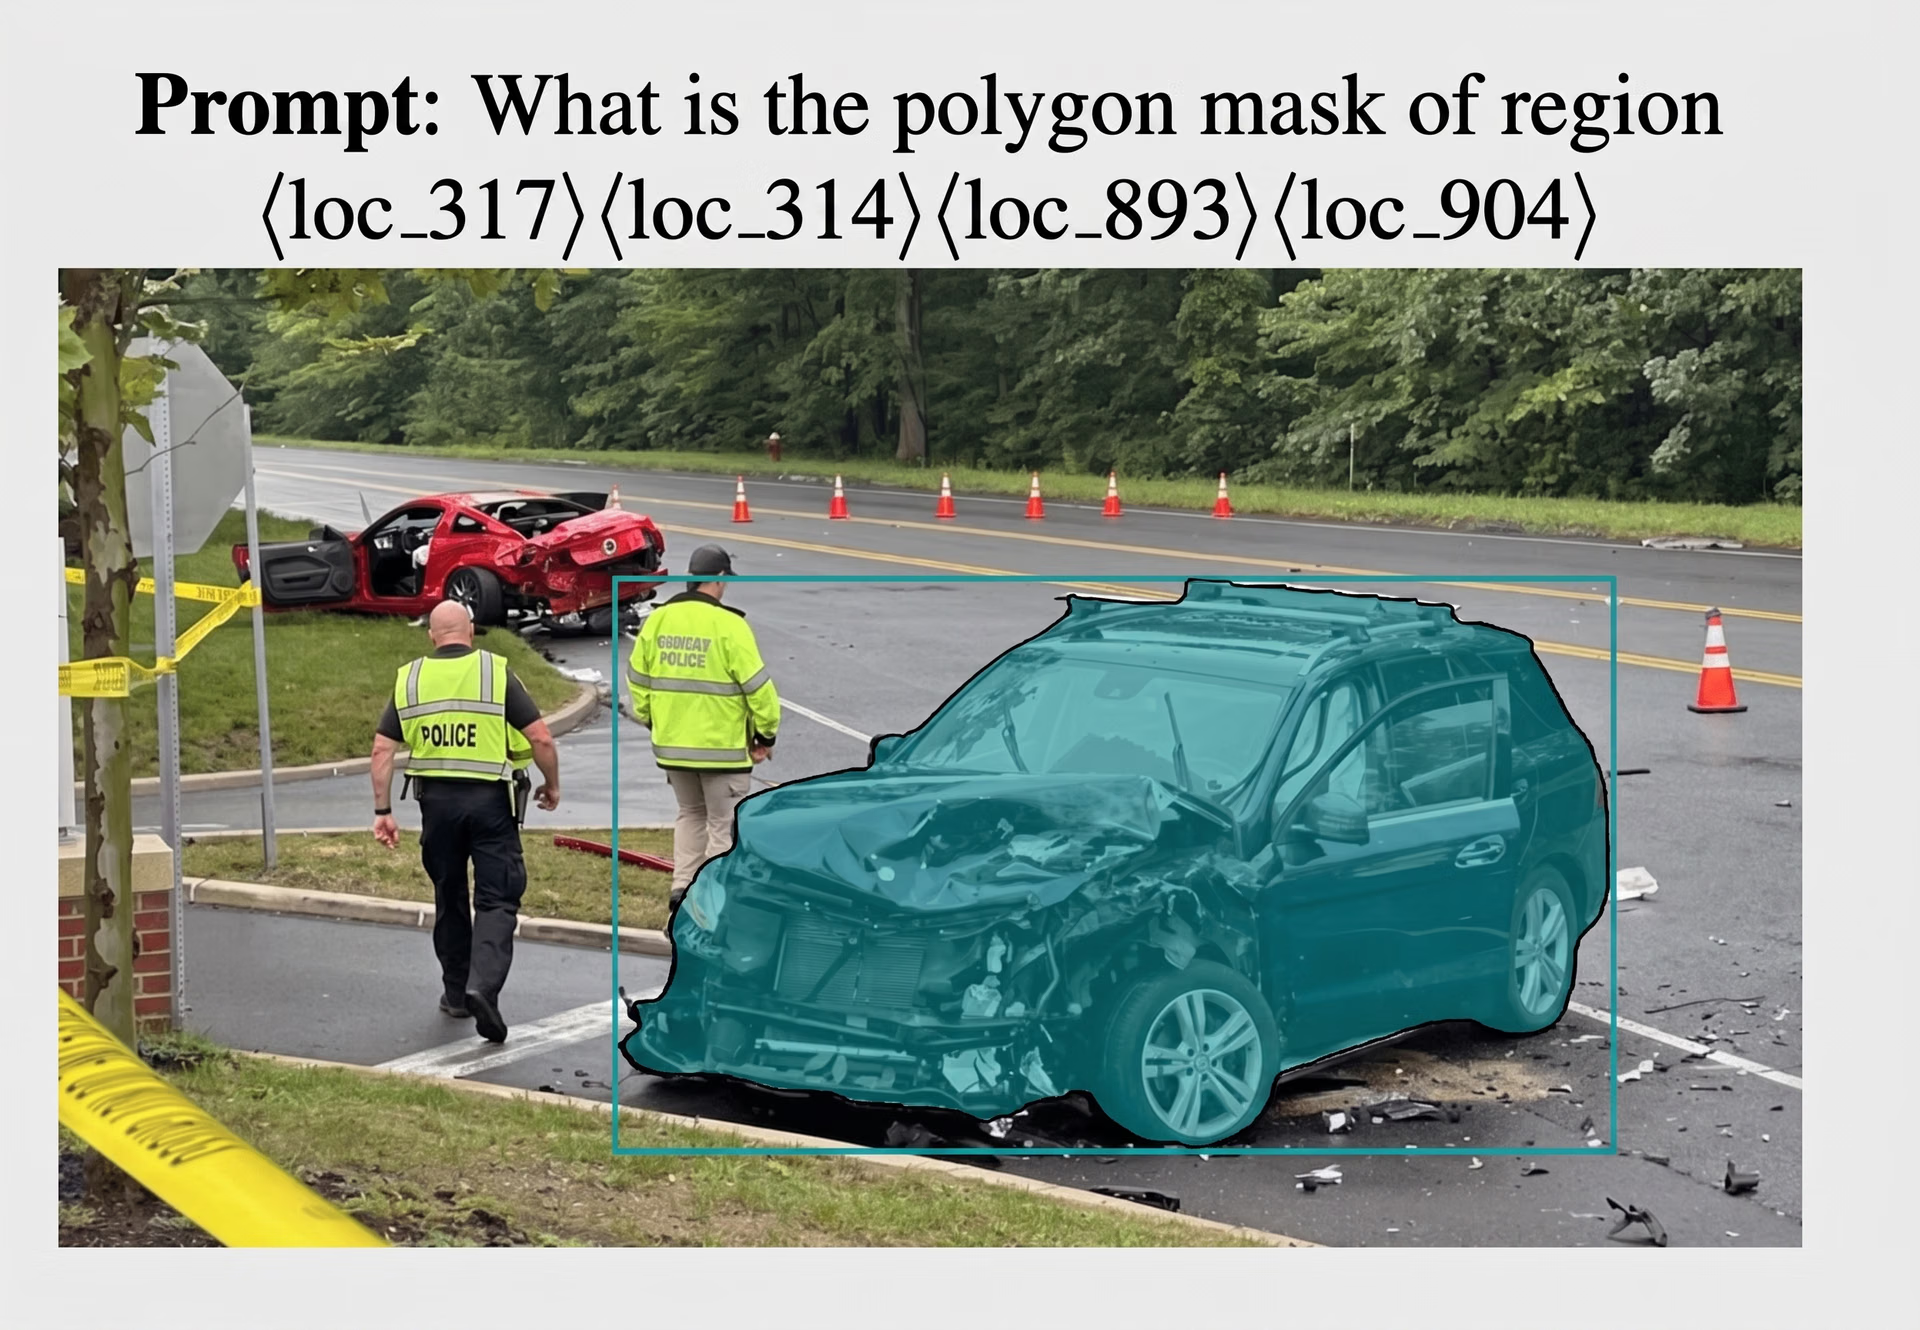
図7 Florence-2を使った領域ベースのセグメンテーションの例
また、ロボットアームを特定の部品へ誘導し、部品の配置や組み立てを最適化することで、自動組立ラインの効率も高めます。同様に、在庫管理では、商品の状態や場所の追跡・監視を支援し、物流の効率化とダウンタイムの削減につながります。総じて、領域ベースのセグメンテーションは精度と生産性を向上させ、産業現場でのコスト削減と製品品質の向上を実現します。
重要なポイント#
AIモデルが高い性能を維持しながら軽量化される傾向が見られるようになっています。Florence-2は、視覚言語モデルにとって大きな前進です。優れたゼロショット性能で、物体検出、セグメンテーション、画像キャプション生成、グラウンディングなど、さまざまなタスクに対応できます。小型ながら効率性と多機能性を備えており、さまざまな業界のアプリケーションに役立ちます。Florence-2のようなモデルは、AIイノベーションの可能性を広げ、より多くの選択肢をもたらしています。
GitHubリポジトリをご覧いただき、コミュニティに参加して、AIについてさらに詳しく知りましょう。ソリューションページでは、製造や農業におけるAIの活用事例をご覧いただけます。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









