Ultralytics YOLO27:
YOLOのライセンス
ビジョンAI

ビジョン言語モデルとその応用を理解する

ビジョン言語モデルとは何か、その仕組みやAIにおけるさまざまな応用について解説します。これらのモデルが視覚と言語の機能をどのように組み合わせるかをご紹介します。
ABAbirami Vina8 分で読めます
画像とテキストの理解を組み合わせるビジョン言語モデル

以前の記事では、GPT-4oが画像を理解し、言葉で説明する方法を紹介しました。Google GeminiやClaude 3など、ほかの新しいモデルでもこの機能が確認されています。今回はこの概念をさらに掘り下げ、Vision Language Modelの仕組みと、視覚データと言語データをどのように組み合わせるかを説明します。

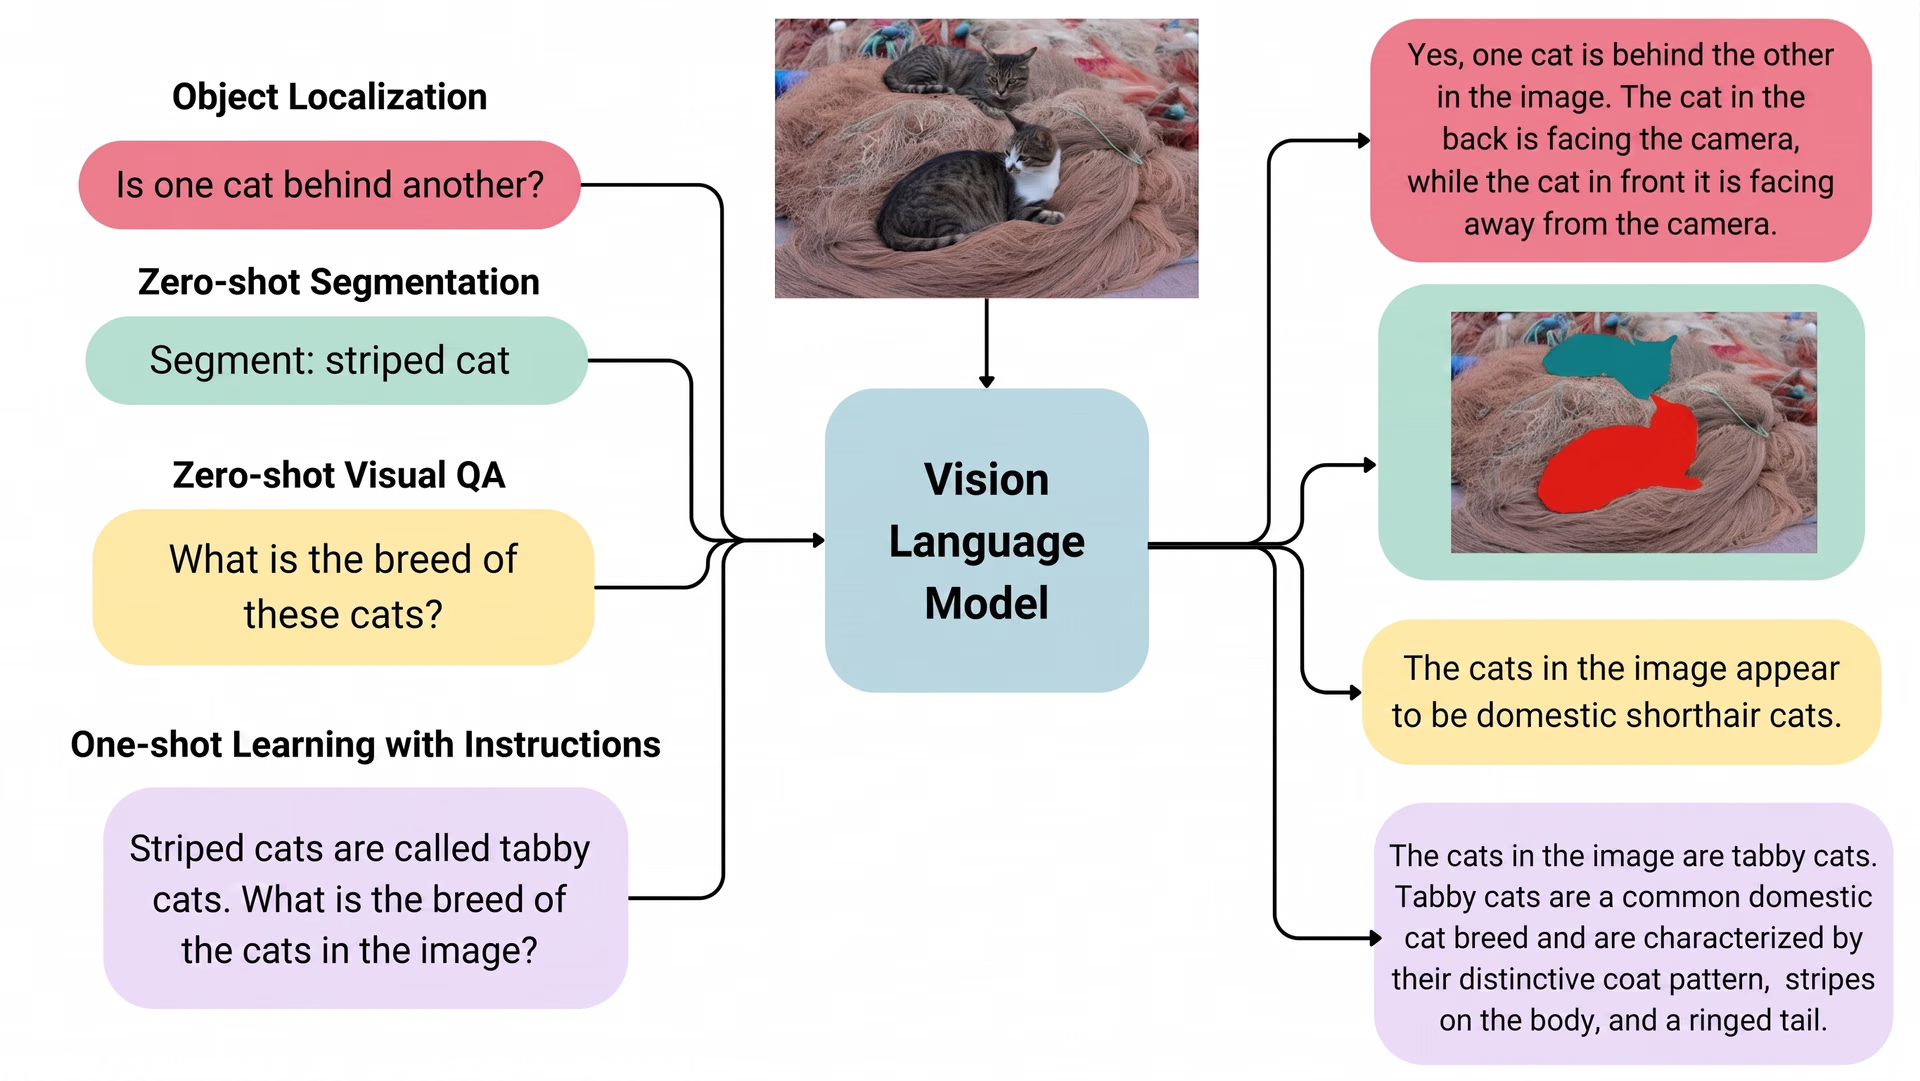
これらのモデルは、写真の詳細なキャプションの生成、画像に関する質問への回答、テキストの説明に基づく新しいビジュアルコンテンツの作成など、さまざまな優れたタスクに利用できます。視覚情報と言語情報をシームレスに統合することで、Vision Language Modelはテクノロジーとの関わり方や、周囲の世界の理解の仕方を変えています。

Vision Language Modelの仕組み#

Vision Language Model(VLM)の活用先を見る前に、VLMとは何か、どのように機能するのかを理解しましょう。VLMは、画像とテキストの両方を扱うために、ビジョンモデルと言語モデルの能力を組み合わせた高度なAIモデルです。これらのモデルは、画像とその説明文を入力として受け取り、両者の関連付けを学習します。モデルのビジョン部分は画像の詳細を捉え、言語部分はテキストを理解します。この連携により、VLMは画像とテキストの両方を理解し、分析できます。

Vision Language Modelの主な機能は次のとおりです。

  • 画像キャプション生成: 画像の内容に基づいて説明文を生成します。
  • 画像に関する質問応答(VQA): 画像の内容に関する質問に回答します。
  • テキストからの画像生成: テキストの説明に基づいて画像を作成します。
  • 画像・テキスト検索: 指定されたテキストクエリに関連する画像を検索し、逆に画像に関連するテキストも検索します。
  • マルチモーダルコンテンツ作成: 画像とテキストを組み合わせて新しいコンテンツを生成します。
  • シーン理解と物体検出: 画像内の物体や詳細を識別し、分類します。

Vision Language Modelの機能例

図1 Vision Language Modelの機能例。

次に、CLIP、SimVLM、VisualGPTなどのよく知られたモデルで使われている、一般的なVLMのアーキテクチャと学習手法を見ていきましょう。

対照学習#

対照学習は、データポイント間の違いを比較することでモデルの学習を支援する手法です。個々のデータの類似度や相違度を計算し、それらの差を測る対照損失を最小化することを目指します。少数のラベル付きサンプルを使ってモデルに新しい未知のデータへのラベル付けを学習させる半教師あり学習で、特に有用です。たとえば、猫の見た目を理解するために、モデルは猫の画像と、似た猫や犬の画像を比較します。顔の構造、体の大きさ、毛皮などの特徴を識別することで、対照学習の手法は猫と犬を区別できます。
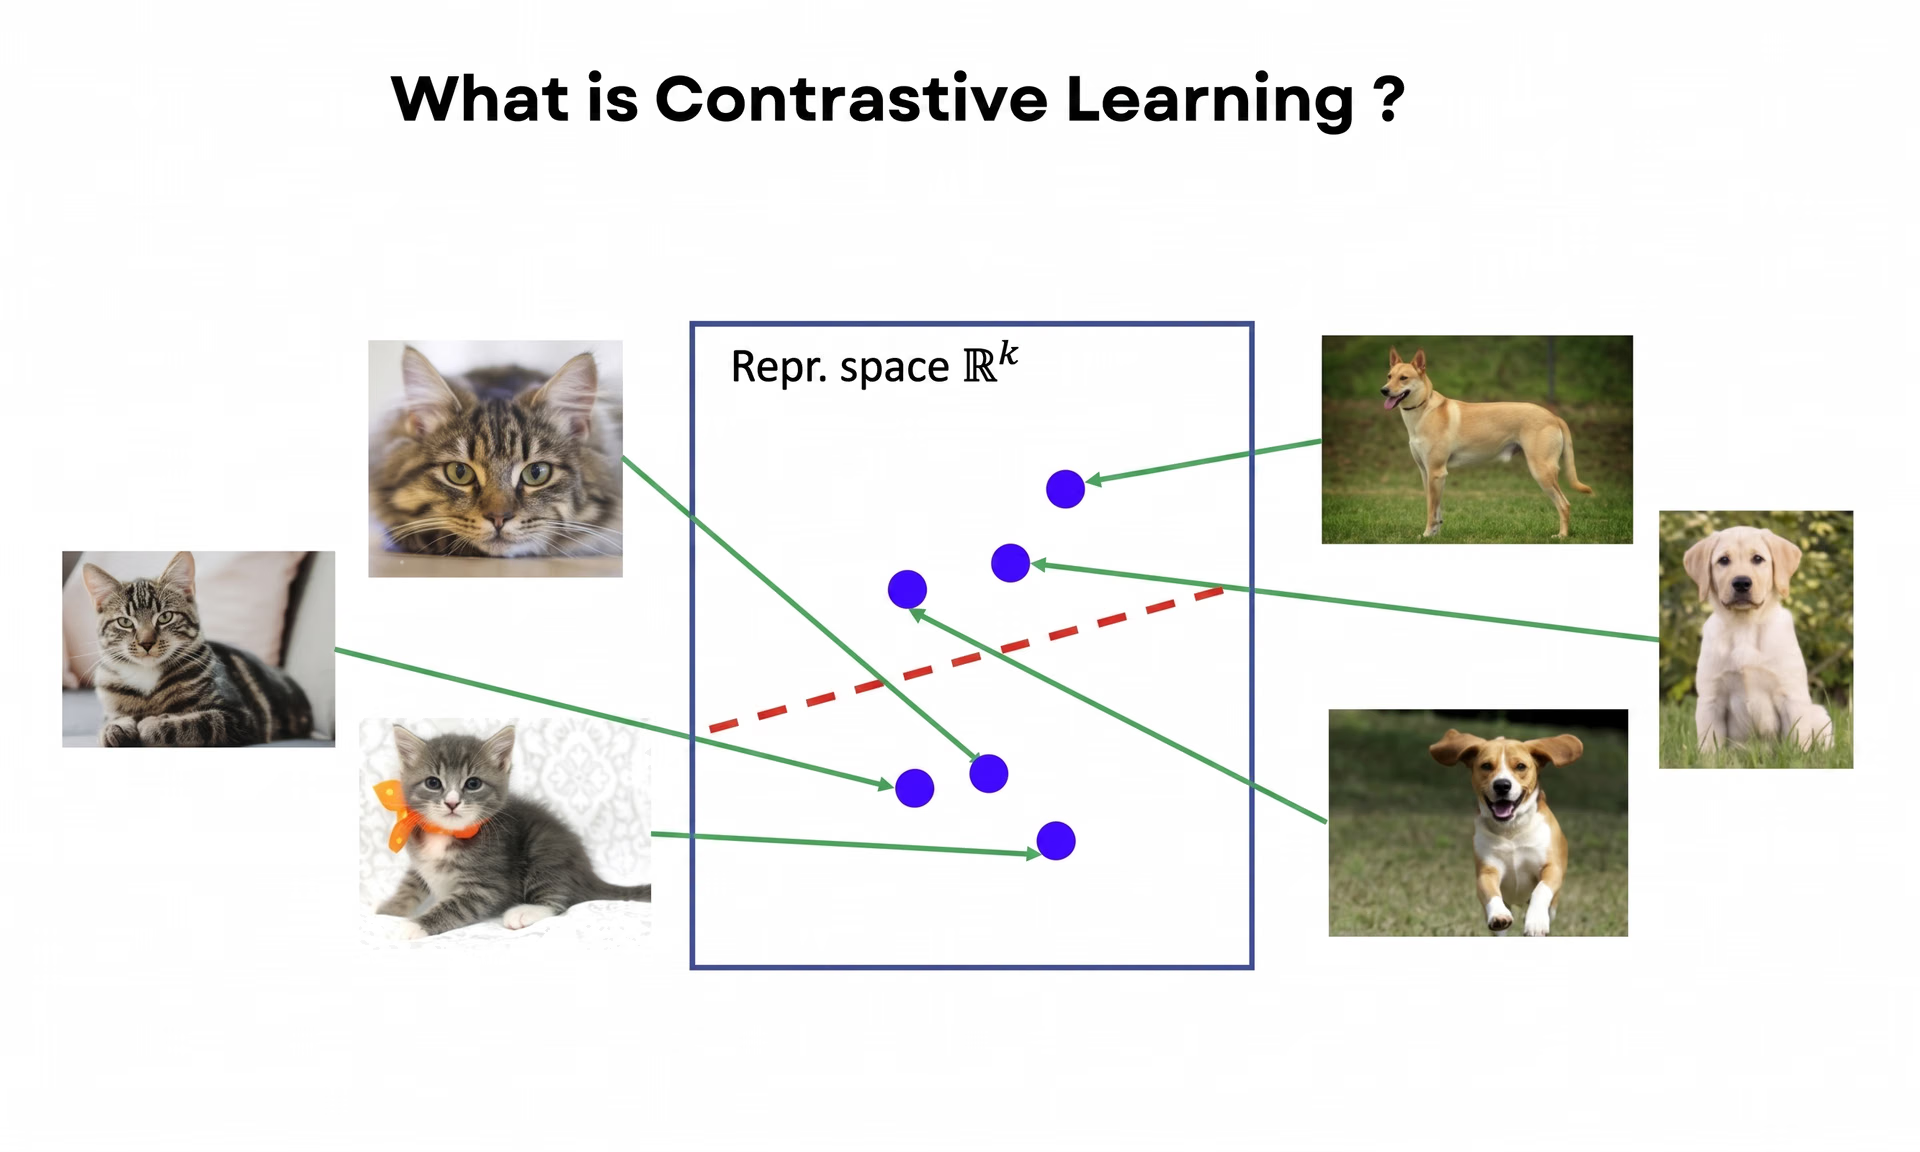
対照学習の仕組みを示す図

図2 対照学習の仕組み。

CLIPは、対照学習を使ってテキストの説明と画像を対応付けるVision-Language Modelです。シンプルな3つのステップで動作します。まず、テキストと画像の両方を理解するモデルの部分をトレーニングします。次に、データセット内のカテゴリをテキストの説明に変換します。最後に、画像に最もよく一致する説明を特定します。この手法により、CLIPモデルは、特定のタスク向けにトレーニングされていなくても正確な予測を行えます。

PrefixLM#

PrefixLMは、モデルのトレーニングに使われる自然言語処理(NLP)の手法です。文の一部(プレフィックス)から始めて、次の単語を予測するように学習します。Vision-Language Modelでは、PrefixLMにより、画像と与えられたテキストの一部に基づいて次の単語を予測できます。画像を小さなパッチに分割し、それぞれを画像の一部として順番に処理するVision Transformer(ViT)を使用します。
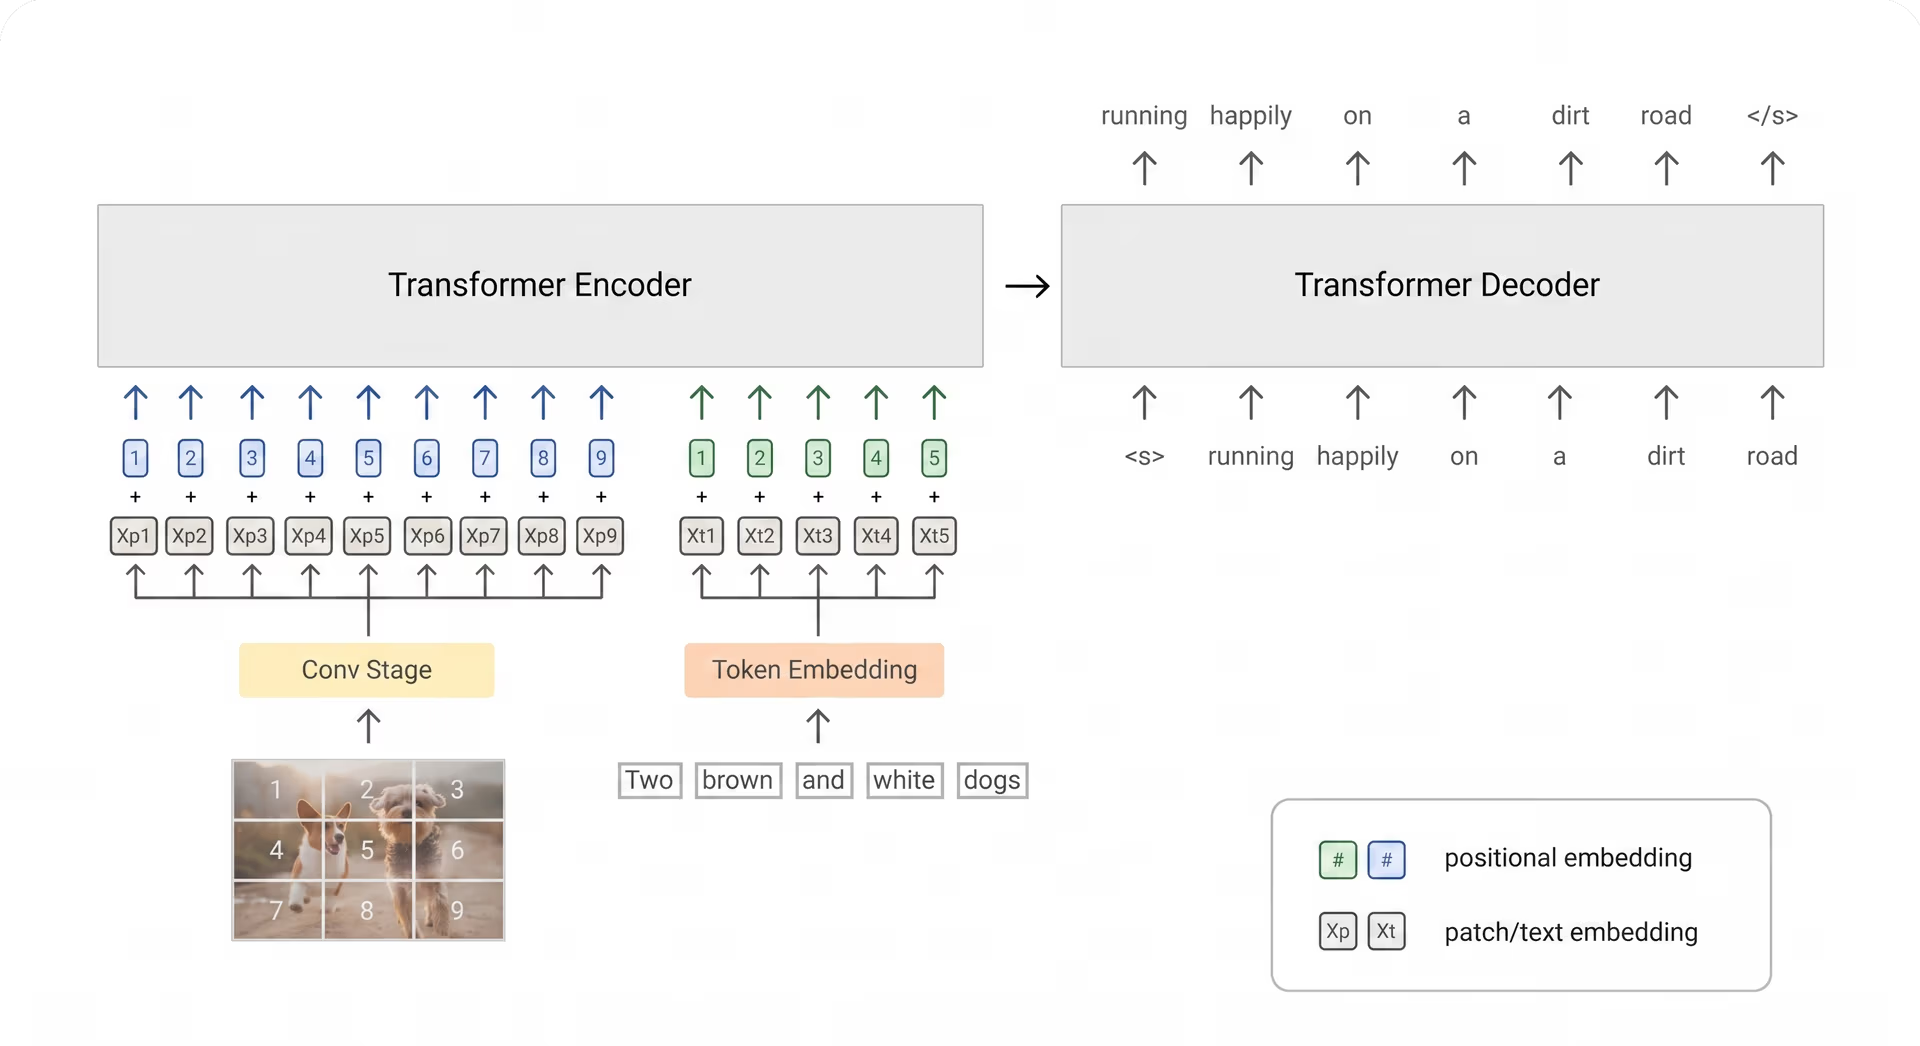
PrefixLM手法を使ったVLMのトレーニング例

図3 PrefixLM手法を使うVLMのトレーニング例。

SimVLMは、PrefixLM学習手法を使うVLMです。以前のモデルに比べてシンプルなTransformerアーキテクチャを採用しながら、さまざまなテストでより優れた結果を達成します。そのモデルアーキテクチャでは、Transformerエンコーダーを使って画像とテキストのプレフィックスの関連付けを学習し、その後、Transformerデコーダーを使ってテキストを生成します。

クロスアテンションによるマルチモーダル融合#

クロスアテンションによるマルチモーダル融合は、事前学習済みVision Language Modelの視覚データを理解し処理する能力を高める手法です。モデルにクロスアテンション層を追加することで、視覚情報とテキスト情報の両方に同時に注目できるようにします。

仕組みは次のとおりです。

  • 画像内の重要な物体を特定し、強調表示します。
  • 強調表示された物体をビジュアルエンコーダーで処理し、視覚情報をモデルが理解できる形式に変換します。
  • 視覚情報をデコーダーに渡し、事前学習済み言語モデルの知識を使って画像を解釈します。

VisualGPTは、この手法を使うモデルの好例です。VisualGPTには、自己再活性化ユニット(SRAU)と呼ばれる特別な機能があり、勾配消失という一般的な問題を回避するのに役立ちます。勾配消失によってトレーニング中にモデルが重要な情報を失うことがありますが、SRAUはモデルの性能を維持します。
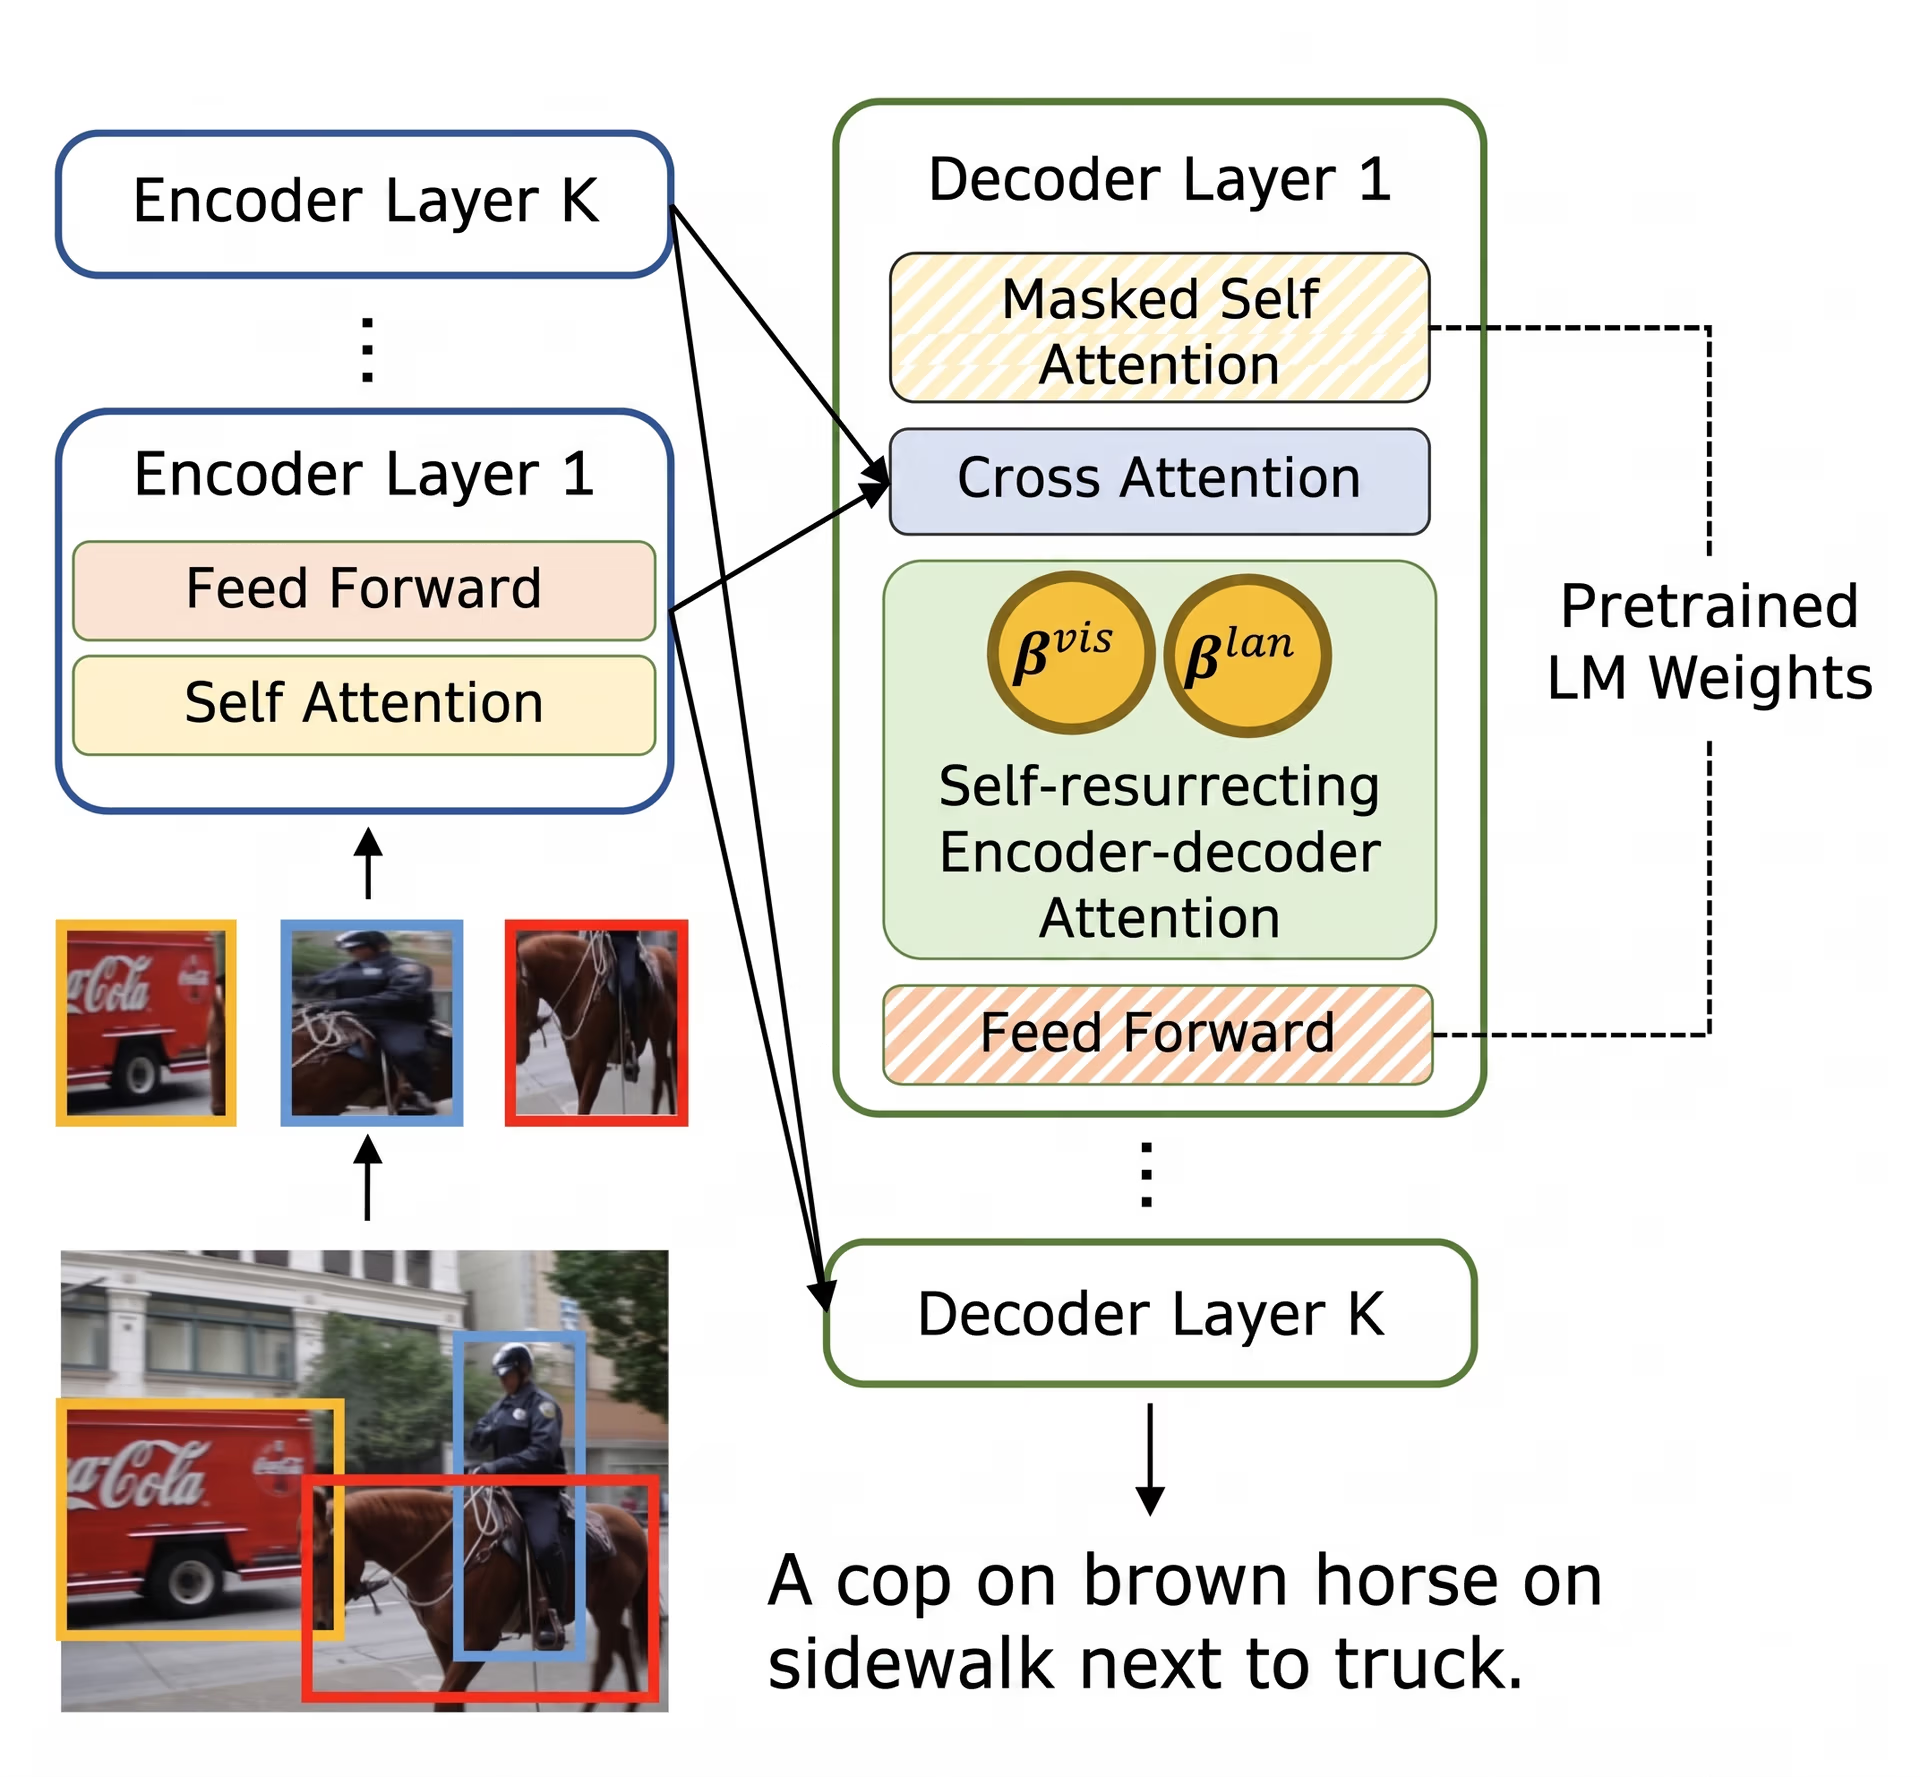
VisualGPTのモデルアーキテクチャを示す図

図4 VisualGPTのモデルアーキテクチャ。

Vision Language Modelの活用例#

Vision Language Modelはさまざまな業界に影響を与えています。eコマースプラットフォームの機能強化から、インターネットのアクセシビリティ向上まで、VLMの活用可能性は大きな期待を集めています。いくつかの活用例を見ていきましょう。

商品説明の生成#

オンラインショッピングでは各商品の詳細な説明を目にしますが、その説明の作成には時間がかかることがあります。VLMは説明の生成を自動化し、このプロセスを効率化します。オンライン小売業者は、Vision Language Modelを使って商品画像から詳細かつ正確な説明を直接生成できます。

質の高い商品説明があれば、検索エンジンは説明に記載された特定の属性に基づいて商品を特定できます。たとえば、「長袖」や「コットンの襟」を含む説明があれば、顧客は「長袖のコットンシャツ」を見つけやすくなります。また、顧客が欲しい商品をすばやく見つけられるため、売上と顧客満足度の向上にもつながります。
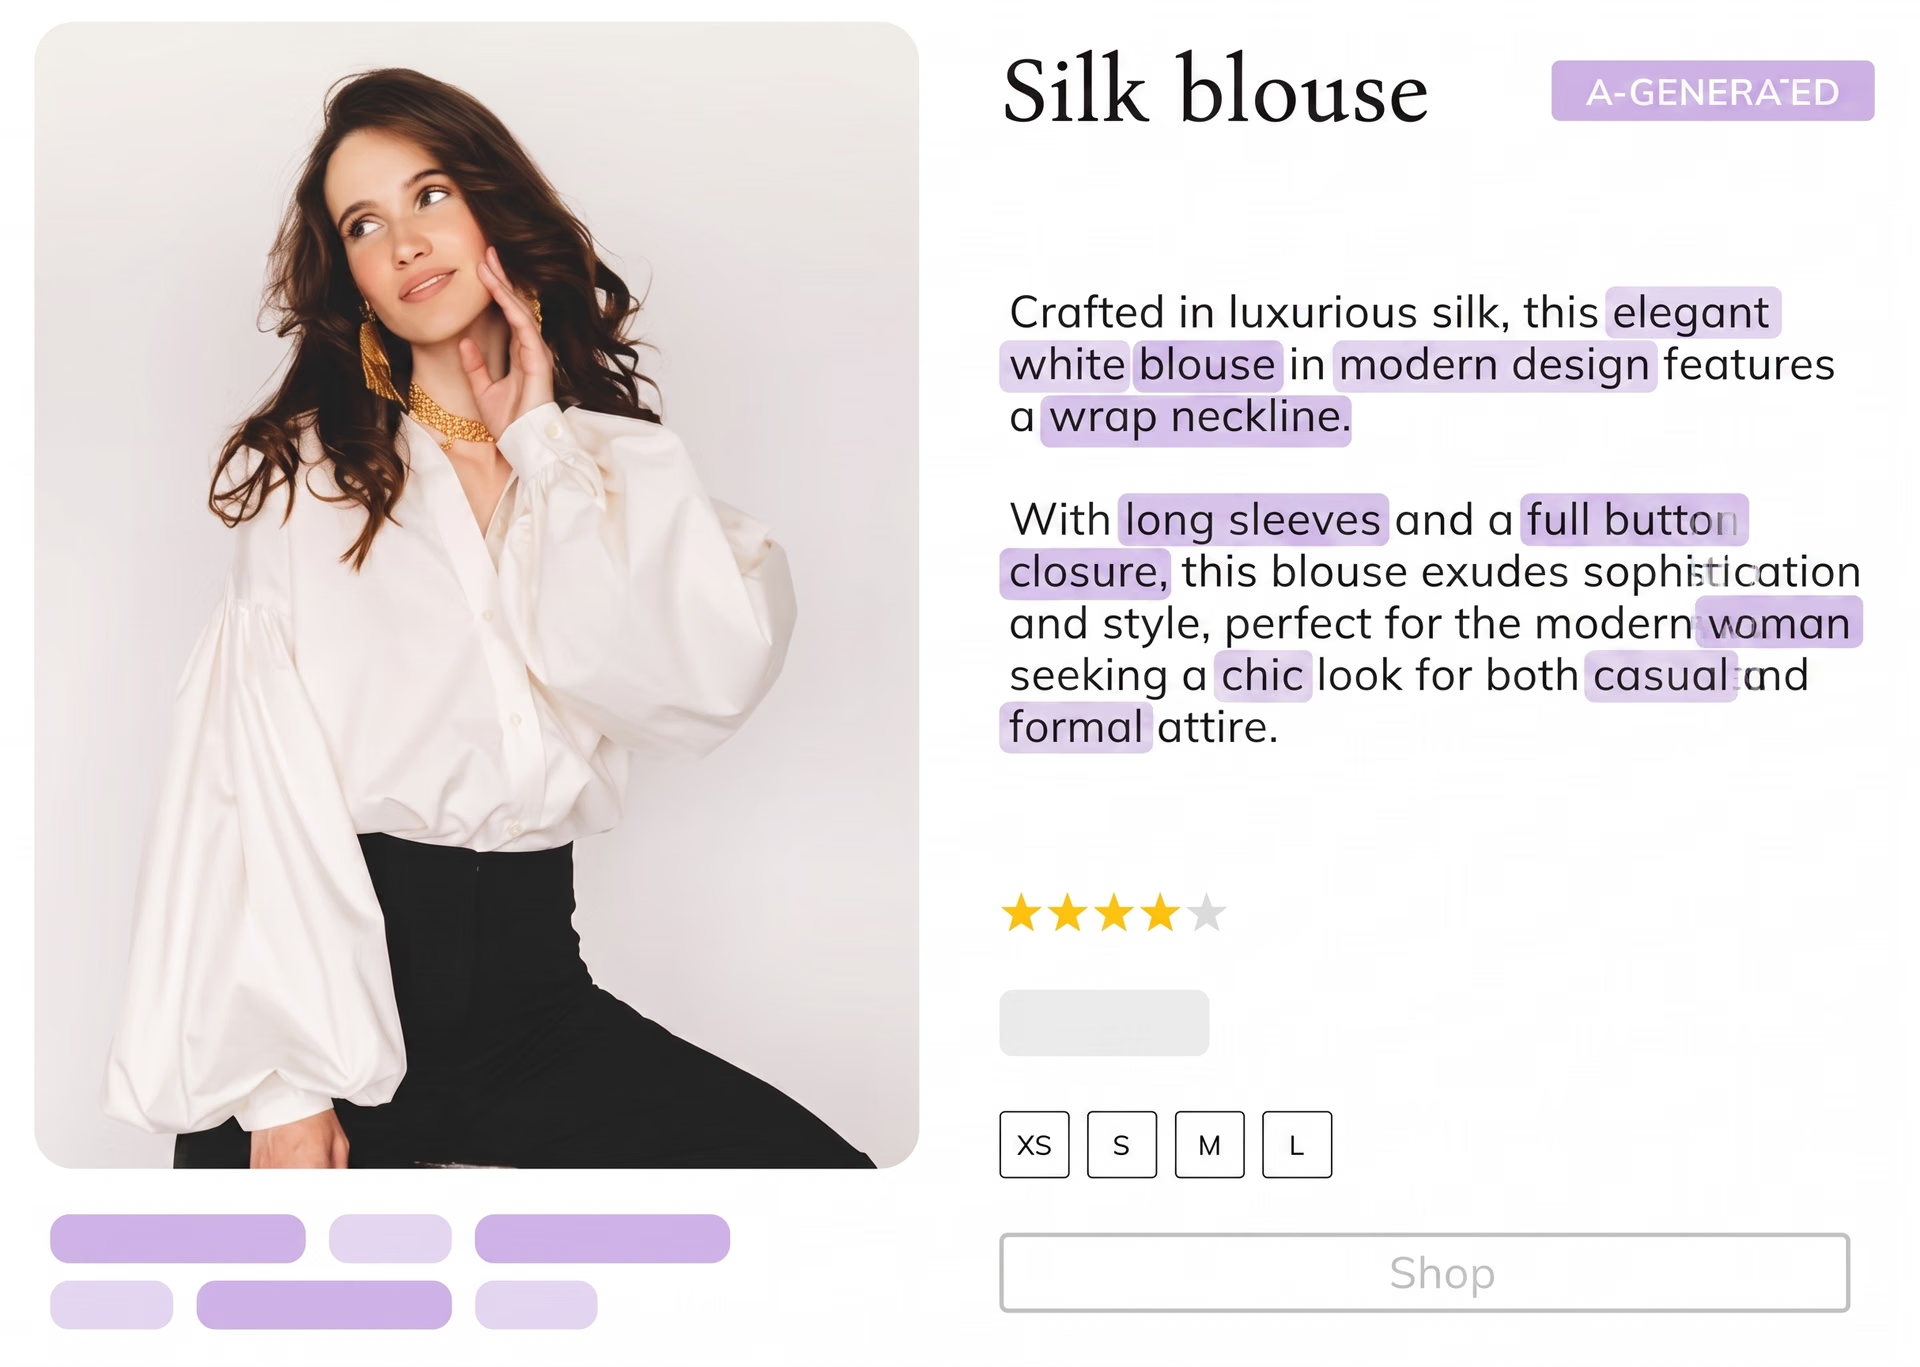
AIが生成した商品説明の例

図5 AIが生成した商品説明の例。

生成AIモデルであるBLIP-2などは、画像から商品属性を直接予測できる高度なVLMの例です。BLIP-2は、複数のコンポーネントを使ってeコマース商品を正確に理解し、説明します。まず、画像エンコーダーで商品の視覚的な側面を処理し、理解します。次に、クエリ変換器が、特定の質問やタスクに関連付けてこの視覚情報を解釈します。最後に、大規模言語モデルが詳細かつ正確な商品説明を生成します。

インターネットのアクセシビリティ向上#

Vision Language Modelは画像キャプション生成を通じて、特に視覚障害のある人にとってインターネットをよりアクセシブルにできます。従来、ユーザーはウェブサイトやソーシャルメディア上の視覚コンテンツについて説明を入力する必要がありました。たとえば、Instagramへの投稿では、スクリーンリーダー向けに代替テキストを追加できます。一方、VLMはこのプロセスを自動化できます。

VLMはソファに座っている猫の画像を見ると、「ソファに座っている猫」というキャプションを生成し、視覚障害のあるユーザーにも場面が分かるようにできます。VLMは、画像とキャプションのペアを少数の例から学習する少数ショットプロンプティングや、複雑な場面を論理的に分解するのに役立つ思考連鎖プロンプティングなどの手法を使います。こうした手法により、生成されるキャプションの一貫性と詳細さが向上します。
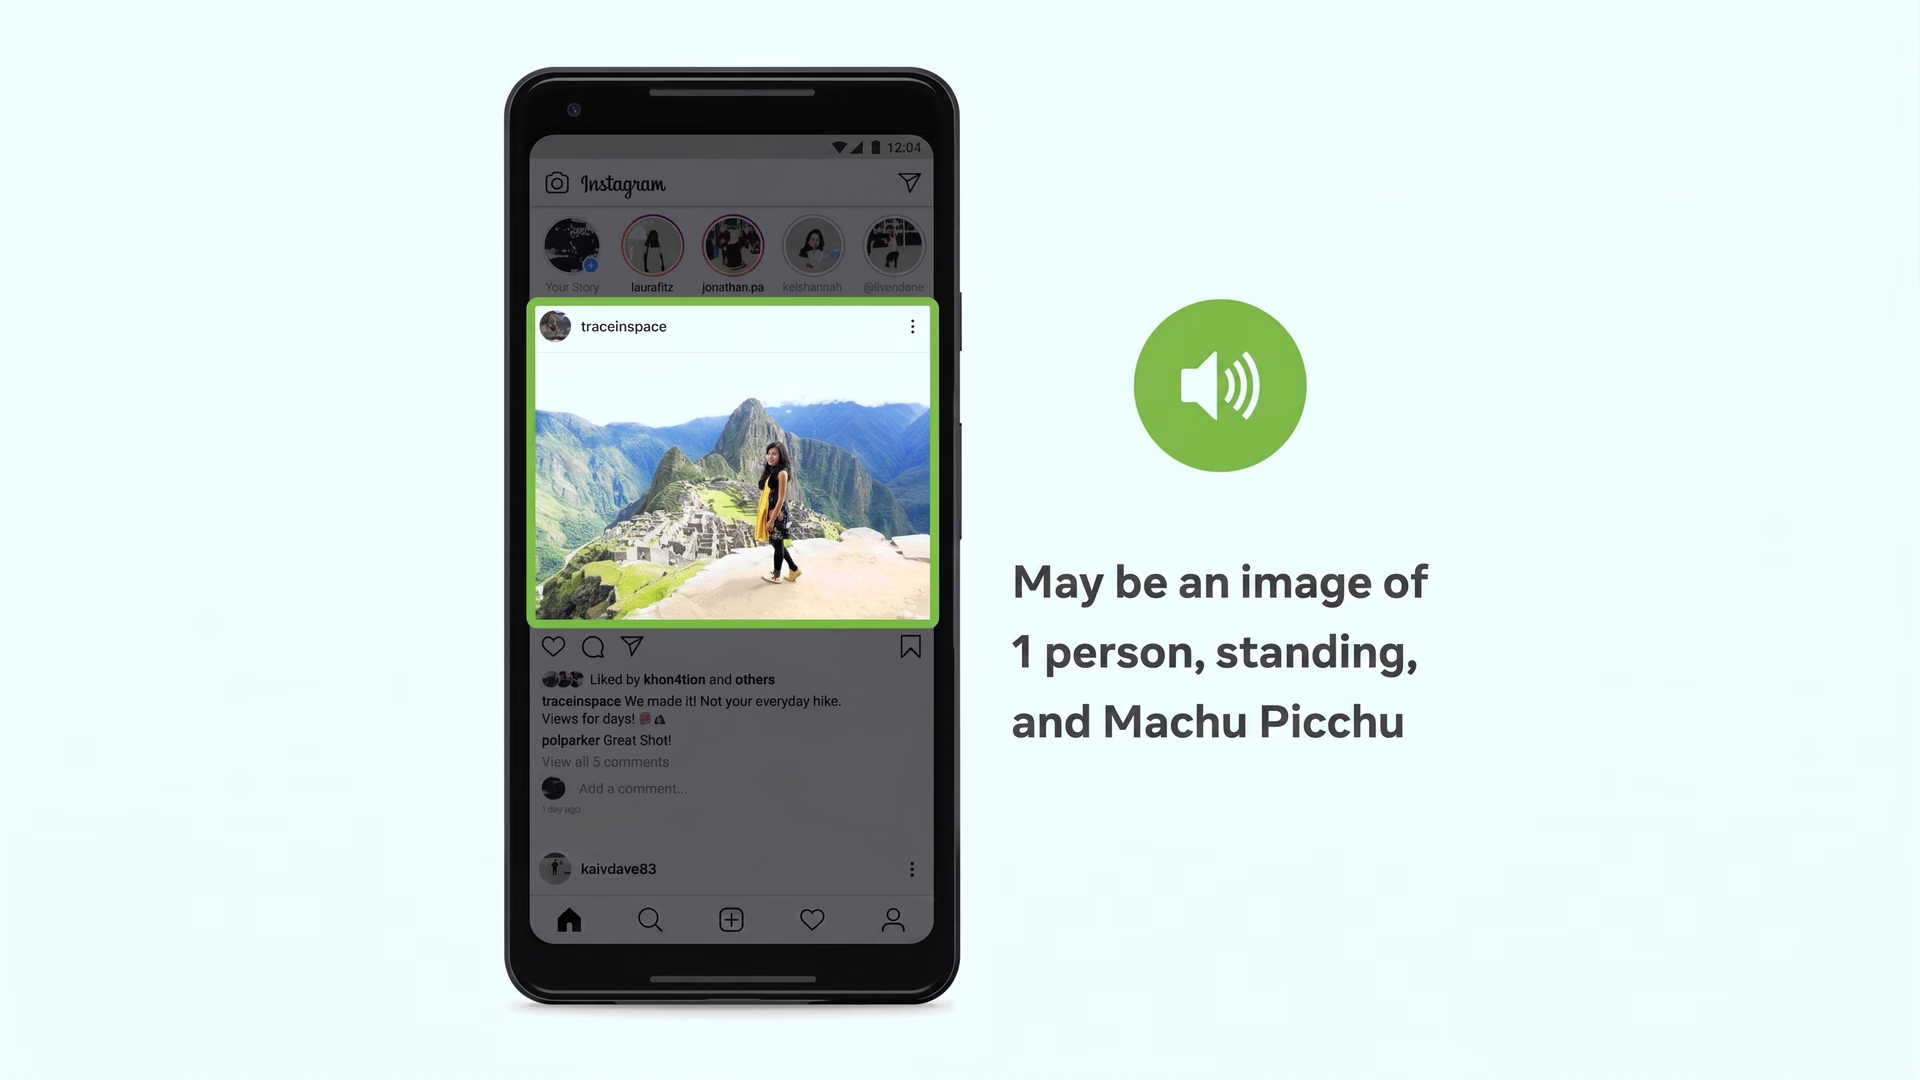
AIを使った画像キャプションの生成

図6 AIを使った画像キャプションの生成。

この目的で、GoogleのChromeに搭載されている「Googleで画像の説明を取得」機能は、代替テキストのない画像の説明を自動生成します。AIが生成した説明は人間が書いたものほど詳細ではないかもしれませんが、それでも貴重な情報を提供します。

Vision Language Modelの利点と限界#

Vision Language Model(VLM)は、視覚データとテキストデータを組み合わせることで多くの利点をもたらします。主な利点は次のとおりです。

  • 人間と機械のより良いインタラクション: システムが視覚入力とテキスト入力の両方を理解して応答できるようになり、バーチャルアシスタント、チャットボット、ロボティクスが向上します。
  • 高度な診断と分析: 画像を分析して説明を生成することで医療分野を支援し、医療従事者によるセカンドオピニオンの取得や異常検知をサポートします。
  • インタラクティブなストーリーテリングとエンターテインメント: 視覚入力とテキスト入力を組み合わせて魅力的な物語を生成し、ゲームやバーチャルリアリティにおけるユーザー体験を向上させます。

優れた機能を備える一方で、Vision Language Modelにはいくつかの限界もあります。VLMを利用する際は、次の点に留意してください。

  • 高い計算要件: VLMのトレーニングとデプロイには多大な計算リソースが必要で、コストが高く、利用しにくくなる可能性があります。
  • データへの依存とバイアス: VLMは、多様性に欠ける、または偏りのあるデータセットでトレーニングすると、偏った結果を生成する可能性があり、固定観念や誤情報を助長するおそれがあります。
  • 文脈理解の限界: VLMは全体像や文脈の理解に苦労し、過度に単純化された出力や誤った出力を生成することがあります。

重要なポイント#

Vision Language Modelは、eコマースやヘルスケアなど、さまざまな分野で大きな可能性を秘めています。視覚データとテキストデータを組み合わせることで、イノベーションを促進し、業界を変革できます。ただし、公平に利用されるようにするには、こうしたテクノロジーを責任ある倫理的な方法で開発することが不可欠です。VLMの進化に伴い、画像ベースの検索や支援技術などのタスクも向上していくでしょう。

AIについて学び続けるために、ぜひコミュニティにご参加ください。GitHubリポジトリでは、製造やヘルスケアなどの業界で、AIを活用して革新的なソリューションを生み出す取り組みをご覧いただけます。🚀

Explore solutions

スポーツにおけるコンピュータービジョン

スポーツにおけるコンピュータービジョン

Ultralytics YOLOが、選手やボールの追跡、パフォーマンス分析、コーチングへの知見、アスリートのリハビリを通じて、スポーツビジョンをどのように支えるかをご紹介します。
詳しく見る
航空画像向けコンピュータービジョン

航空画像向けコンピュータービジョン

Ultralytics YOLOを活用して、ドローンや航空画像をリアルタイムの知見に変換し、農業、水産養殖、環境モニタリング、自然保護、地理空間分析に役立てましょう。
詳しく見る
航空宇宙分野のコンピュータービジョン

航空宇宙分野のコンピュータービジョン

Ultralytics YOLOモデルで航空モニタリングにビジョンAIを導入しましょう。コンピュータービジョンソリューションで、ドローン、航空宇宙のワークフロー、環境保全、地理空間業界を支援します。
詳しく見る
セキュリティ分野のコンピュータービジョン

セキュリティ分野のコンピュータービジョン

Ultralytics YOLOモデルであらゆる施設を保護しましょう。ビジョンAIは、周辺監視、脅威検知、ナンバープレート認識、職場の安全管理を支援します。
詳しく見る
ロボティクス分野のコンピュータービジョン

ロボティクス分野のコンピュータービジョン

Ultralytics YOLOモデルで、よりスマートなマシンを実現しましょう。ロボティクスにおけるビジョンAIは、自律ナビゲーション、認識、物体追跡、リアルタイム制御を支援します。
詳しく見る
物流におけるコンピュータービジョン

物流におけるコンピュータービジョン

Ultralytics YOLOモデルで物流を効率化しましょう。ビジョンAIにより、荷物検査、仕分け、車両追跡、倉庫のリアルタイム安全監視を実現します。
詳しく見る
小売業におけるコンピュータービジョン

小売業におけるコンピュータービジョン

Ultralytics YOLOモデルで小売のあり方を変革しましょう。ビジョンAIにより、在庫追跡、棚の監視、行列管理、より高度な顧客インサイトを実現します。
詳しく見る
医療分野におけるコンピュータービジョン

医療分野におけるコンピュータービジョン

Ultralytics YOLOモデルで医療ソリューションを構築しましょう。医療分野のビジョンAIは、医用画像処理の高速化、より高度な診断、患者モニタリングを実現します。
詳しく見る
製造業におけるコンピュータービジョン

製造業におけるコンピュータービジョン

Ultralytics YOLOモデルで製造を最適化しましょう。ビジョンAIは、品質管理、欠陥検出、PPE準拠、組立ラインの自動化を推進します。
詳しく見る
自動車分野におけるコンピュータービジョン

自動車分野におけるコンピュータービジョン

Ultralytics YOLOモデルで自動車分野にコンピュータービジョンを導入しましょう。ビジョンAIは、道路の安全性、運転支援、車両の自動化を向上させ、よりスマートな道路を実現します。
詳しく見る
農業におけるコンピュータービジョン

農業におけるコンピュータービジョン

Ultralytics YOLOモデルでスマート農業にビジョンAIを導入しましょう。作物のモニタリング、家畜の追跡、精密農業を支援し、より高く効率的な収量を実現します。
詳しく見る
スポーツにおけるコンピュータービジョン

スポーツにおけるコンピュータービジョン

Ultralytics YOLOが、選手やボールの追跡、パフォーマンス分析、コーチングへの知見、アスリートのリハビリを通じて、スポーツビジョンをどのように支えるかをご紹介します。
詳しく見る
航空画像向けコンピュータービジョン

航空画像向けコンピュータービジョン

Ultralytics YOLOを活用して、ドローンや航空画像をリアルタイムの知見に変換し、農業、水産養殖、環境モニタリング、自然保護、地理空間分析に役立てましょう。
詳しく見る
航空宇宙分野のコンピュータービジョン

航空宇宙分野のコンピュータービジョン

Ultralytics YOLOモデルで航空モニタリングにビジョンAIを導入しましょう。コンピュータービジョンソリューションで、ドローン、航空宇宙のワークフロー、環境保全、地理空間業界を支援します。
詳しく見る
セキュリティ分野のコンピュータービジョン

セキュリティ分野のコンピュータービジョン

Ultralytics YOLOモデルであらゆる施設を保護しましょう。ビジョンAIは、周辺監視、脅威検知、ナンバープレート認識、職場の安全管理を支援します。
詳しく見る
ロボティクス分野のコンピュータービジョン

ロボティクス分野のコンピュータービジョン

Ultralytics YOLOモデルで、よりスマートなマシンを実現しましょう。ロボティクスにおけるビジョンAIは、自律ナビゲーション、認識、物体追跡、リアルタイム制御を支援します。
詳しく見る
物流におけるコンピュータービジョン

物流におけるコンピュータービジョン

Ultralytics YOLOモデルで物流を効率化しましょう。ビジョンAIにより、荷物検査、仕分け、車両追跡、倉庫のリアルタイム安全監視を実現します。
詳しく見る
小売業におけるコンピュータービジョン

小売業におけるコンピュータービジョン

Ultralytics YOLOモデルで小売のあり方を変革しましょう。ビジョンAIにより、在庫追跡、棚の監視、行列管理、より高度な顧客インサイトを実現します。
詳しく見る
医療分野におけるコンピュータービジョン

医療分野におけるコンピュータービジョン

Ultralytics YOLOモデルで医療ソリューションを構築しましょう。医療分野のビジョンAIは、医用画像処理の高速化、より高度な診断、患者モニタリングを実現します。
詳しく見る
製造業におけるコンピュータービジョン

製造業におけるコンピュータービジョン

Ultralytics YOLOモデルで製造を最適化しましょう。ビジョンAIは、品質管理、欠陥検出、PPE準拠、組立ラインの自動化を推進します。
詳しく見る
自動車分野におけるコンピュータービジョン

自動車分野におけるコンピュータービジョン

Ultralytics YOLOモデルで自動車分野にコンピュータービジョンを導入しましょう。ビジョンAIは、道路の安全性、運転支援、車両の自動化を向上させ、よりスマートな道路を実現します。
詳しく見る
農業におけるコンピュータービジョン

農業におけるコンピュータービジョン

Ultralytics YOLOモデルでスマート農業にビジョンAIを導入しましょう。作物のモニタリング、家畜の追跡、精密農業を支援し、より高く効率的な収量を実現します。
詳しく見る

AIの未来を一緒に築きましょう!

機械学習の未来に向けた歩みを始めましょう