OpenVINO™を使ってUltralytics YOLO11をシームレスにデプロイ
Ultralytics YOLO11をOpenVINO™形式にエクスポートすると、Intel®ハードウェアで非常に高速な推論が可能になり、速度、スケーラビリティ、精度が向上します。
AIの導入にはAIソリューションを利用しやすくすることが欠かせません。そのためには、多くの人がすでに所有しているハードウェアに簡単にデプロイできるようにすることが重要です。GPU(グラフィックス処理ユニット)上でAIモデルを実行することは、パフォーマンスと並列処理能力の点で優れた選択肢です。
しかし実際には、特にエッジ環境や一般的なノートパソコンでは、誰もが高性能GPUを利用できるわけではありません。そのため、中央処理装置(CPU)、統合GPU、ニューラル処理装置(NPU)など、より広く利用されているハードウェア上で効率よく動作するよう、モデルを最適化することが非常に重要です。
たとえば、コンピュータービジョンは、機械が画像や動画ストリームをリアルタイムで分析・理解できるようにするAIの一分野です。Ultralytics YOLO11のようなビジョンAIモデルは、物体検出やインスタンスセグメンテーションなどの主要タスクに対応し、小売分析から医療診断まで、さまざまなアプリケーションを支えています。
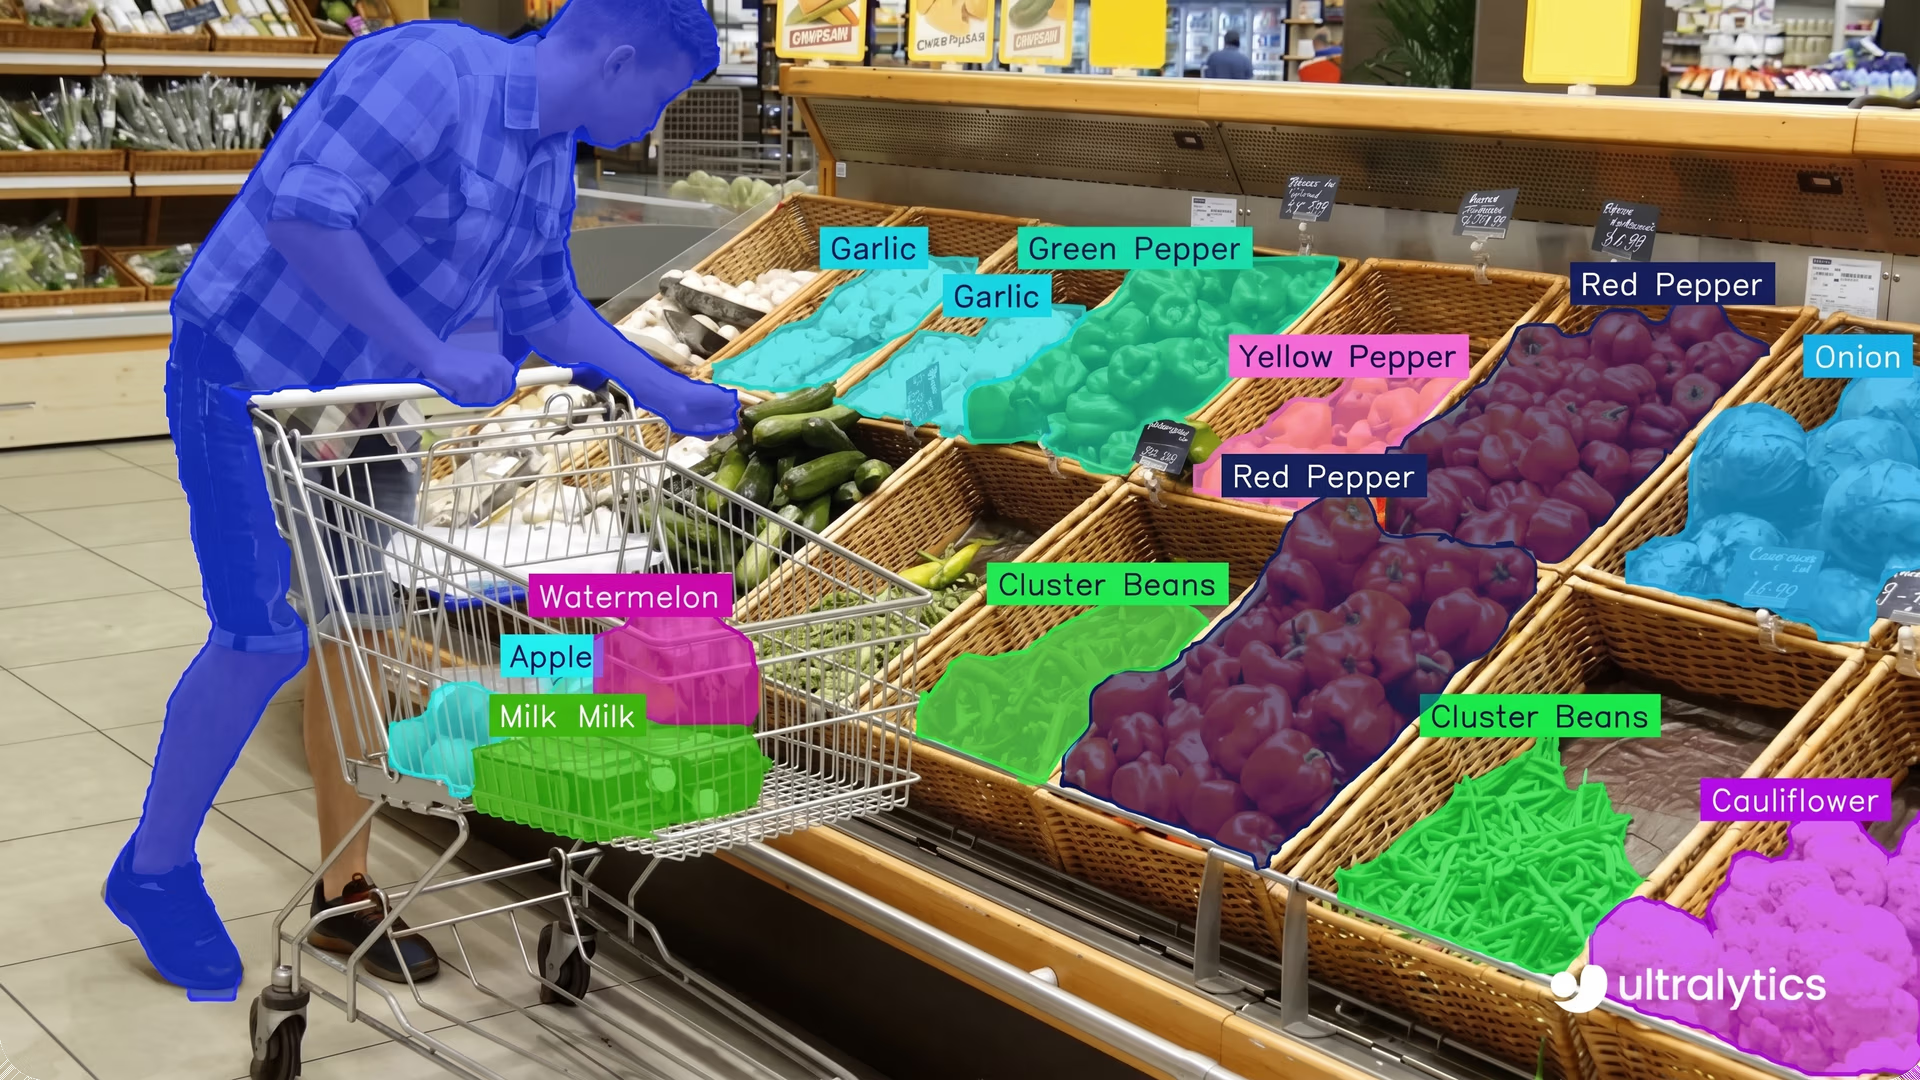
図1. Ultralytics YOLO11を使用した小売店内の物体の検出とセグメンテーション。
コンピュータービジョンをより幅広く利用できるようにするため、UltralyticsはOpenVINOツールキットとの連携をアップデートして公開しました。OpenVINOは、CPU、GPU、NPUでAI推論を最適化して実行するためのオープンソースプロジェクトです。
この連携により、YOLO11モデルを簡単にエクスポートしてデプロイでき、CPUで最大3倍高速な推論を実現し、Intel GPUとNPUでパフォーマンスを向上できます。この記事では、Ultralytics Pythonパッケージを使ってYOLO11モデルをOpenVINO形式にエクスポートし、推論に使用する方法を説明します。さっそく始めましょう。
Ultralytics YOLO11の概要#
UltralyticsがサポートするOpenVINO連携の詳細に入る前に、YOLO11が信頼性と実用性を兼ね備えたコンピュータービジョンモデルである理由を詳しく見てみましょう。YOLO11はUltralytics YOLOシリーズの最新モデルで、速度と精度の両方が大幅に向上しています。
主な特長の1つは効率性です。たとえば、Ultralytics YOLO11mはUltralytics YOLOv8mよりパラメーター数が22%少ない一方、COCOデータセットでより高い平均適合率(mAP)を達成します。つまり、より高速に動作し、物体をより正確に検出できるため、パフォーマンスと応答性が重要となるリアルタイムアプリケーションに最適です。
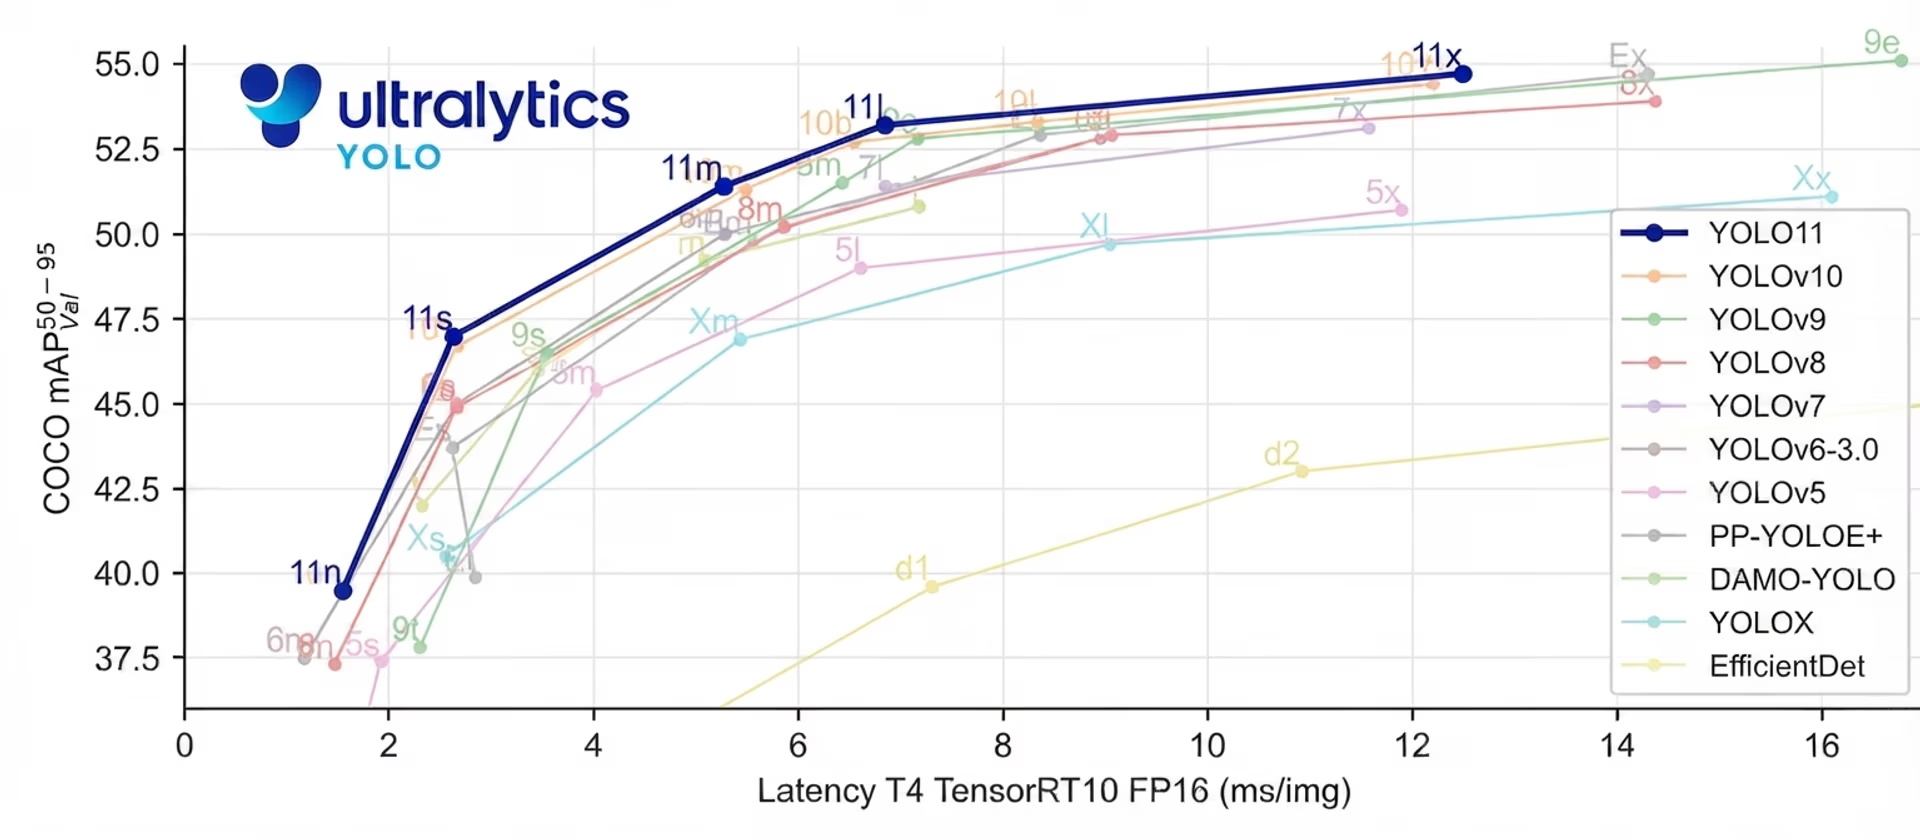
図2 Ultralytics YOLO11のパフォーマンスベンチマーク。
物体検出に加えて、YOLO11はインスタンスセグメンテーション、姿勢推定、画像分類、物体追跡、回転バウンディングボックス検出など、さまざまな高度なコンピュータービジョンタスクに対応しています。また、Ultralytics Pythonパッケージがモデルのトレーニング、評価、デプロイにシンプルで一貫性のあるインターフェースを提供するため、YOLO11は開発者にとって使いやすいモデルです。
さらに、Ultralytics Pythonパッケージは、OpenVINO、ONNX、TorchScriptなど、さまざまな連携機能と複数のエクスポート形式に対応しているため、YOLO11をさまざまなデプロイパイプラインに簡単に組み込めます。クラウドインフラストラクチャ、エッジデバイス、組み込みシステムのいずれを対象とする場合でも、エクスポートプロセスはシンプルで、ハードウェアの要件に合わせて柔軟に対応できます。
OpenVINO™とは#
OpenVINO™(オープンなビジュアル推論とニューラルネットワーク最適化)は、幅広いハードウェアでAI推論を最適化し、デプロイするためのオープンソースツールキットです。CPU、統合型およびディスクリートGPU、NPU、フィールド・プログラマブル・ゲート・アレイ(FPGAs)など、さまざまなIntelプラットフォームで高性能な推論アプリケーションを効率的に実行できます。
OpenVINOは、デバイス固有のプラグインを通じてハードウェアの違いを抽象化する、統一されたランタイムインターフェースを提供します。これにより、開発者は一度コードを書くだけで、一貫したAPIを使って複数のIntelハードウェアを対象にデプロイできます。
OpenVINOがデプロイに適している主な機能をいくつか紹介します。
- モデルコンバーター: このツールは、PyTorch、ONNX、TensorFlow、PaddlePaddleなどの主要なフレームワークのモデルを変換して準備し、Intelハードウェア上で効率的に推論できるよう最適化します。
- ヘテロジニアス実行: Intelのハードウェアごとにコードを書き換える必要はありません。OpenVINOを使えば、CPUからGPUまで、サポートされているあらゆるハードウェアで同じモデルを簡単に実行できます。
- 量子化のサポート: このツールキットは、FP16(デフォルト)やINT8などの低精度形式に対応しています。これらの形式は、精度への影響を抑えながらモデルサイズを縮小し、推論を高速化します。
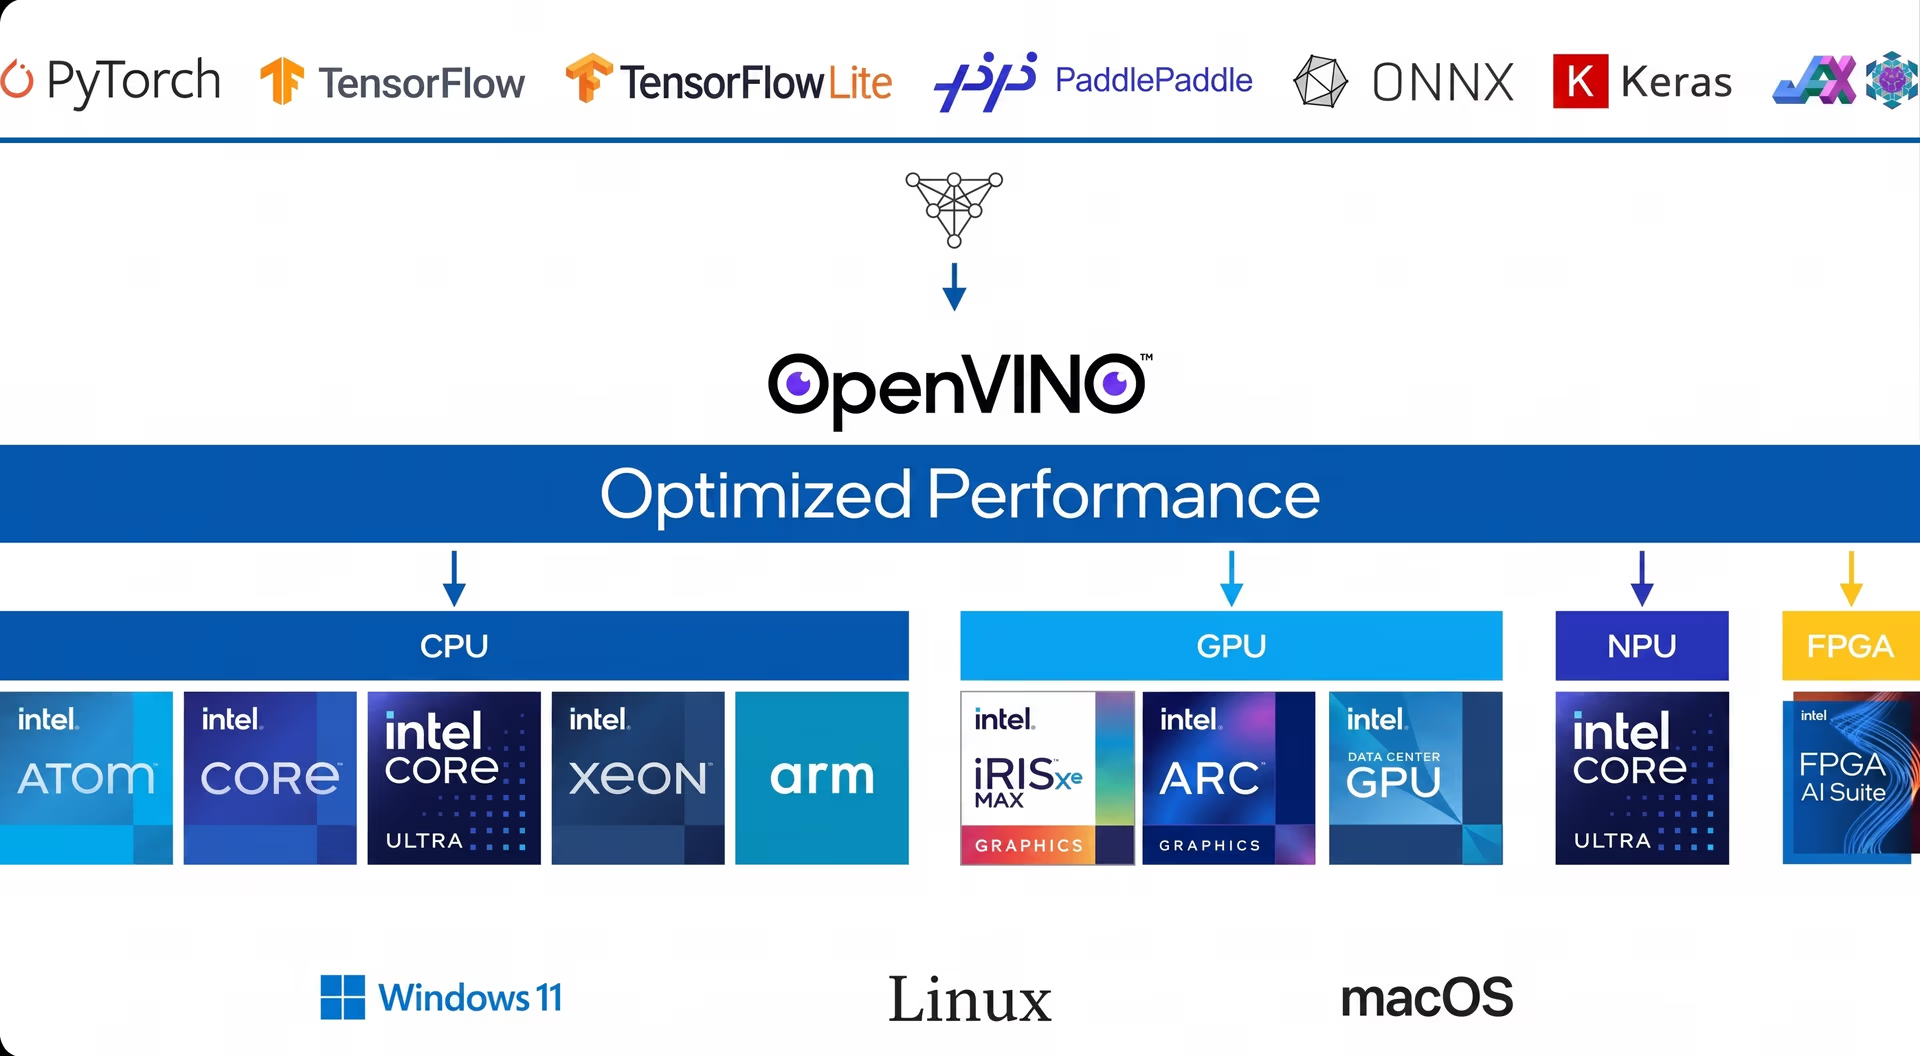
図3 OpenVINOは多様なデプロイオプションを実現します。
UltralyticsとOpenVINOの連携について#
OpenVINOとは何か、そしてその重要性について見てきたところで、Ultralytics YOLO11モデルをOpenVINO形式にエクスポートし、Intelハードウェア上で効率的な推論を実行する方法を説明します。
ステップ1:Ultralytics Pythonパッケージをインストールする#
モデルをOpenVINO形式にエクスポートするには、まずUltralytics Pythonパッケージをインストールする必要があります。このパッケージには、YOLO11を含むYOLOモデルのトレーニング、評価、エクスポートに必要な機能がすべて含まれています。
ターミナルまたはコマンドプロンプトで「pip install ultralytics」を実行するとインストールできます。Jupyter NotebookやGoogle Colabなどのインタラクティブ環境を使用する場合は、コマンドの前に感嘆符を付けてください。
インストール中やエクスポート中に問題が発生した場合は、Ultralyticsのドキュメントやトラブルシューティングガイドが解決の助けになります。
ステップ2: Ultralytics YOLO11モデルをOpenVINO形式にエクスポートする#
Ultralyticsパッケージのセットアップが完了したら、次にYOLO11モデルを読み込み、OpenVINO互換形式に変換します。
以下の例では、事前トレーニング済みのYOLO11モデル(「yolo11n.pt」)を使用しています。エクスポート機能を使って、モデルをOpenVINO形式に変換します。このコードを実行すると、変換済みモデルは「yolo11n_openvino_model」という名前の新しいディレクトリに保存されます。
from ultralytics import YOLO

model = YOLO("yolo11n.pt")
model.export(format="openvino")
ステップ3: エクスポートしたモデルで推論を実行する#
YOLO11モデルをOpenVINO形式にエクスポートしたら、Ultralytics PythonパッケージまたはネイティブのOpenVINO Runtimeを使って、2通りの方法で推論を実行できます。
Ultralytics Pythonパッケージを使用する#
以下のコードスニペットに示すように、Ultralytics Pythonパッケージを使うと、エクスポートしたYOLO11モデルを簡単にデプロイできます。この方法は、Intelハードウェア上で迅速に実験し、効率よくデプロイする場合に最適です。
システムで利用可能なIntelハードウェアに応じて、「intel:cpu」、「intel:gpu」、「intel:npu」など、推論に使用するデバイスも指定できます。
ov_model = YOLO("yolo11n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
上記のコードを実行すると、出力画像は「runs/detect/predict」ディレクトリに保存されます。
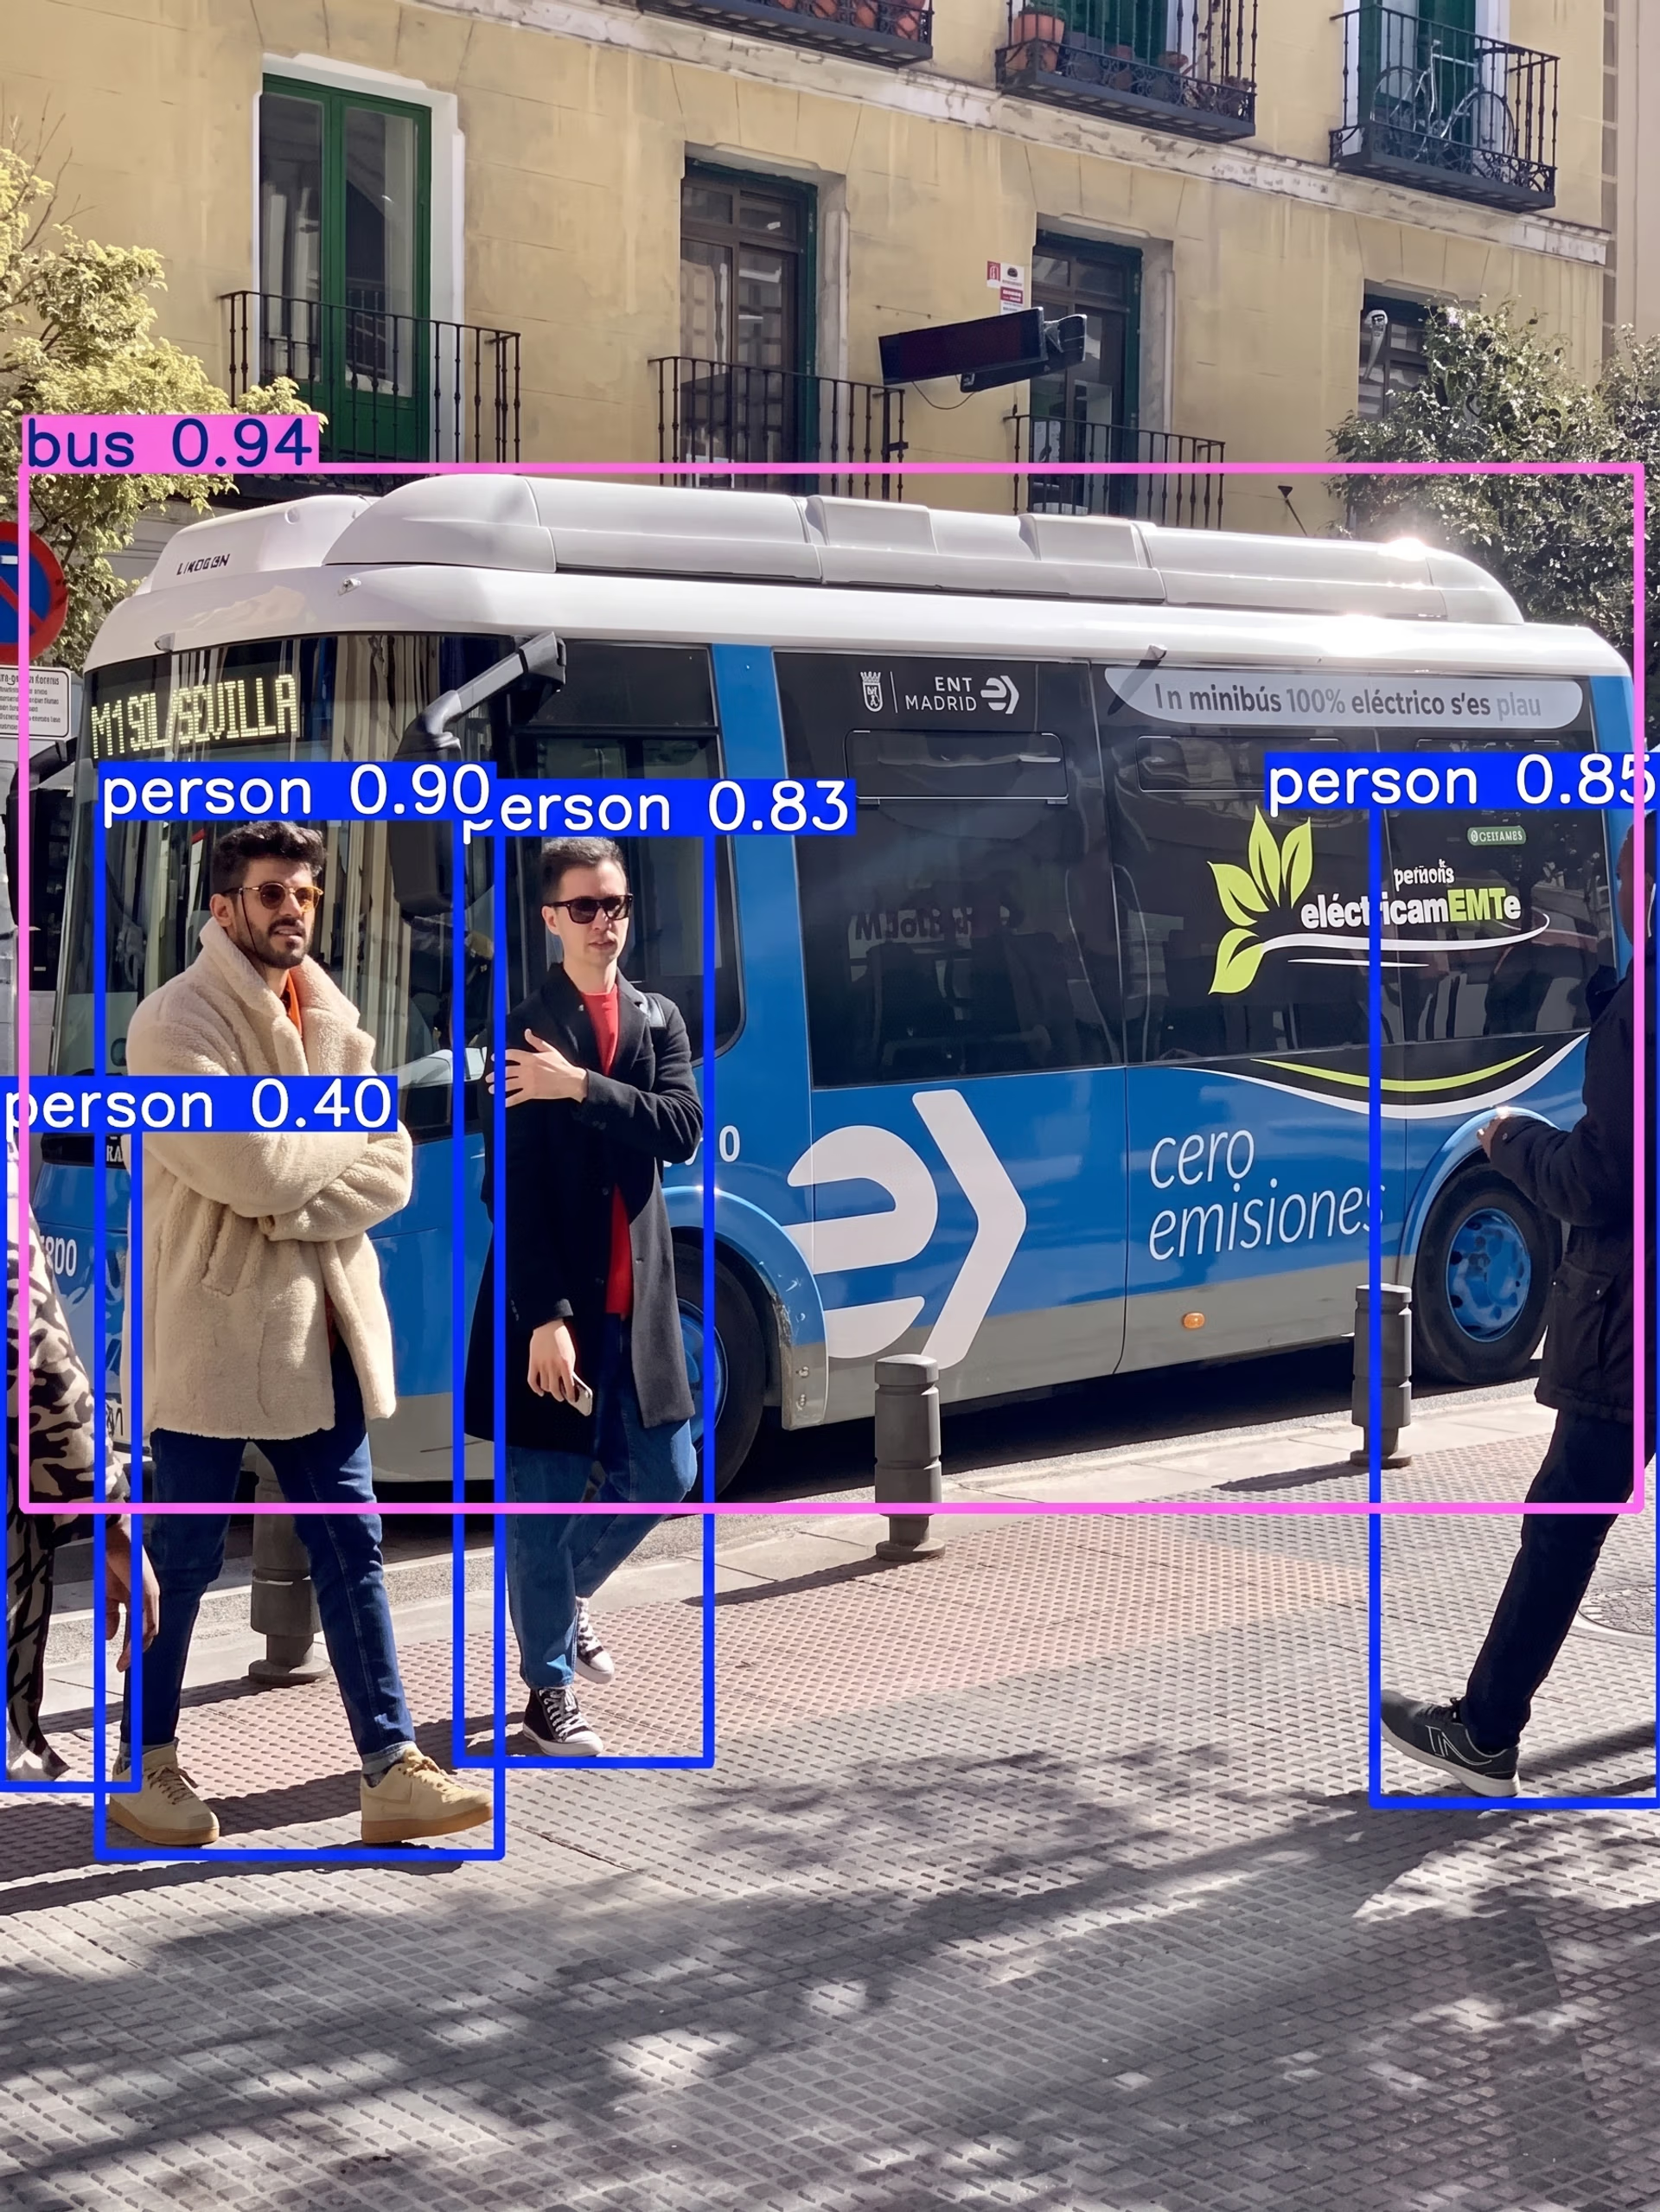
図4. エクスポートしたUltralytics YOLO11モデルを使った画像内の物体検出。
ネイティブのOpenVINO Runtimeを使用する#
特に本番環境で、推論の実行方法を柔軟にカスタマイズしたい場合は、OpenVINO Runtimeを使うとモデルの実行をより細かく制御できます。非同期実行(複数の推論リクエストを並行して実行)や負荷分散(Intelハードウェア全体に推論処理を効率よく分配)などの高度な機能に対応しています。
ネイティブランタイムを使用するには、エクスポートしたモデルファイルが必要です。ネットワーク構造を定義する.xmlファイルと、モデルの学習済み重みを格納する.binファイルです。アプリケーションに応じて、入力の寸法や前処理などの追加パラメーターも設定できます。
一般的なデプロイの流れには、OpenVINOコアの初期化、対象デバイス向けのモデルの読み込みとコンパイル、入力の準備、推論の実行が含まれます。詳しい例と手順については、Ultralytics公式OpenVINOドキュメントをご覧ください。
UltralyticsとOpenVINOの連携を選ぶ理由#
Ultralyticsの連携機能を調べると、Ultralytics PythonパッケージがYOLO11モデルのTorchScript、CoreML、TensorRT、ONNXなど、さまざまな形式へのエクスポートに対応していることがわかります。では、OpenVINO連携を選ぶ理由は何でしょうか。
OpenVINO形式がIntelハードウェアへのモデルのデプロイに適している理由をいくつか紹介します。
- パフォーマンスの向上: Intel CPUで最大3倍高速な推論を実現でき、統合型GPUとNPUではさらなる高速化が可能です。
- 再トレーニング不要: 既存のUltralytics YOLO11モデルを変更したり再トレーニングしたりせずに、OpenVINO形式へ直接エクスポートできます。
- 大規模展開に対応: エクスポートした同じモデルを、低消費電力のエッジデバイスから大規模なクラウドインフラストラクチャまでデプロイでき、スケーラブルなAIデプロイを簡素化します。
OpenVINO™ Model Hubでは、さまざまなIntel®プラットフォームでUltralytics YOLO11モデルのパフォーマンスベンチマークを評価することもできます。OpenVINO Model Hubは、Intelハードウェア上でAIモデルを評価し、Intel CPU、内蔵GPU、NPU、ディスクリートグラフィックスにおけるOpenVINOのパフォーマンス上の利点を確認できる開発者向けリソースです。
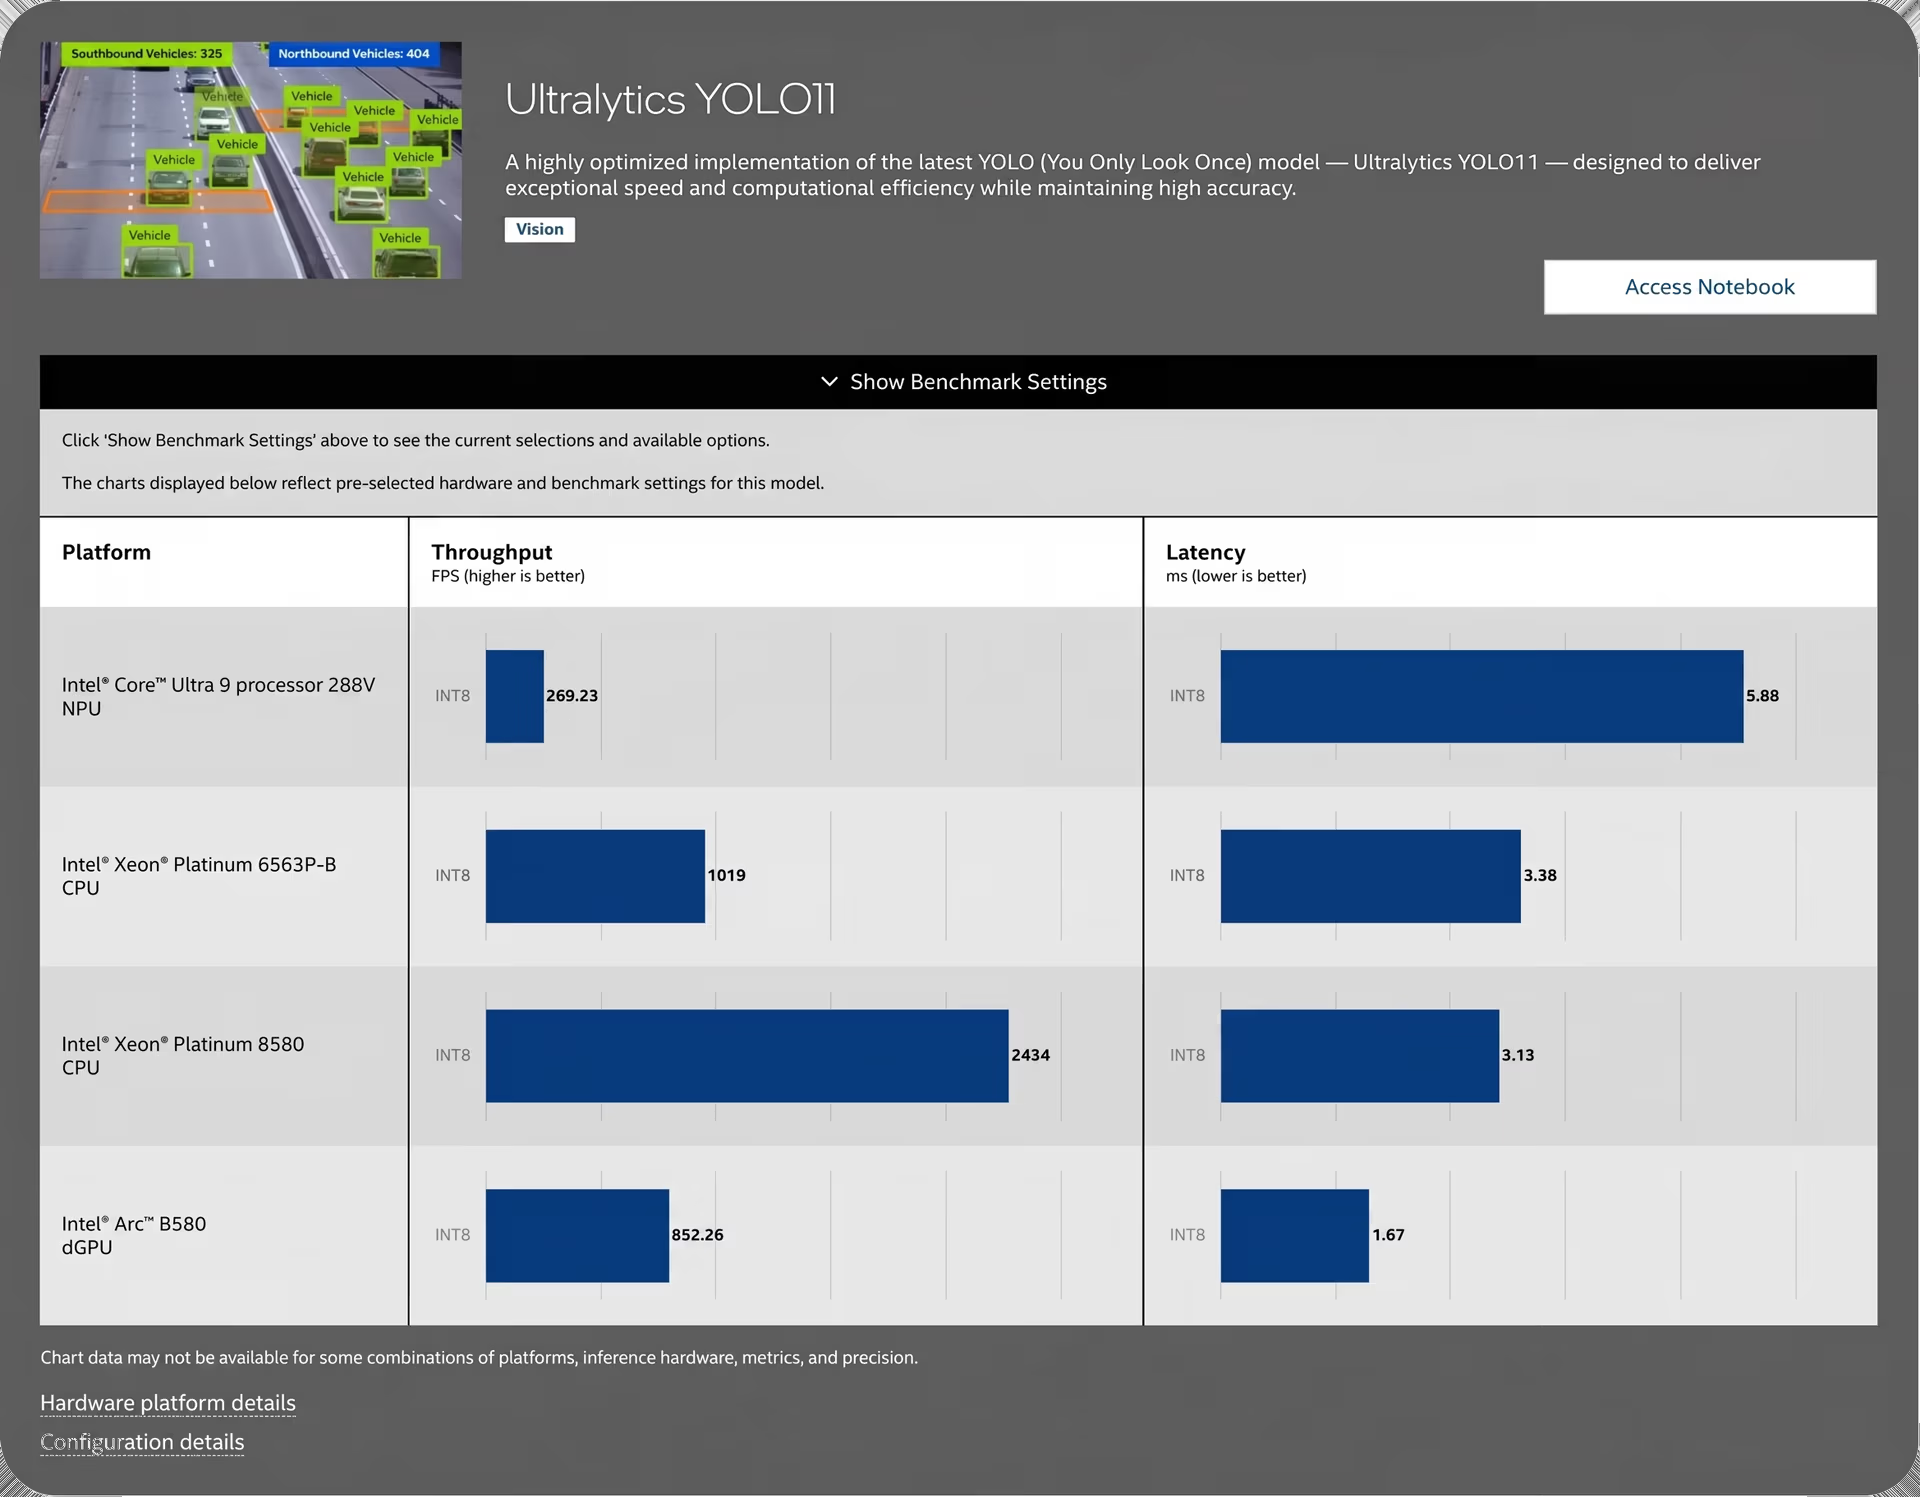
図5. OpenVINO™ Model Hub: さまざまなIntel®プラットフォームにおけるUltralytics YOLO11モデルのパフォーマンスベンチマーク。
Ultralytics YOLO11とOpenVINOエクスポート形式の活用例#
OpenVINO連携により、現実のさまざまな状況でIntelハードウェア全体にUltralytics YOLO11モデルをデプロイする作業が大幅に簡単になります。
スマートリテールはその好例です。Ultralytics YOLO11を使うと、空の商品棚をリアルタイムで検出し、在庫が少なくなっている商品を追跡し、店内での顧客の動きを分析できます。これにより、小売業者は在庫管理を改善し、顧客エンゲージメントの向上に向けて店舗レイアウトを最適化できます。
同様に、スマートシティでは、YOLO11を使って車両の台数を数え、歩行者を追跡し、信号無視をリアルタイムで検出することで、交通状況を監視できます。これらの分析結果は、交通の流れの最適化、道路の安全性向上、自動取り締まりシステムの支援に役立ちます。
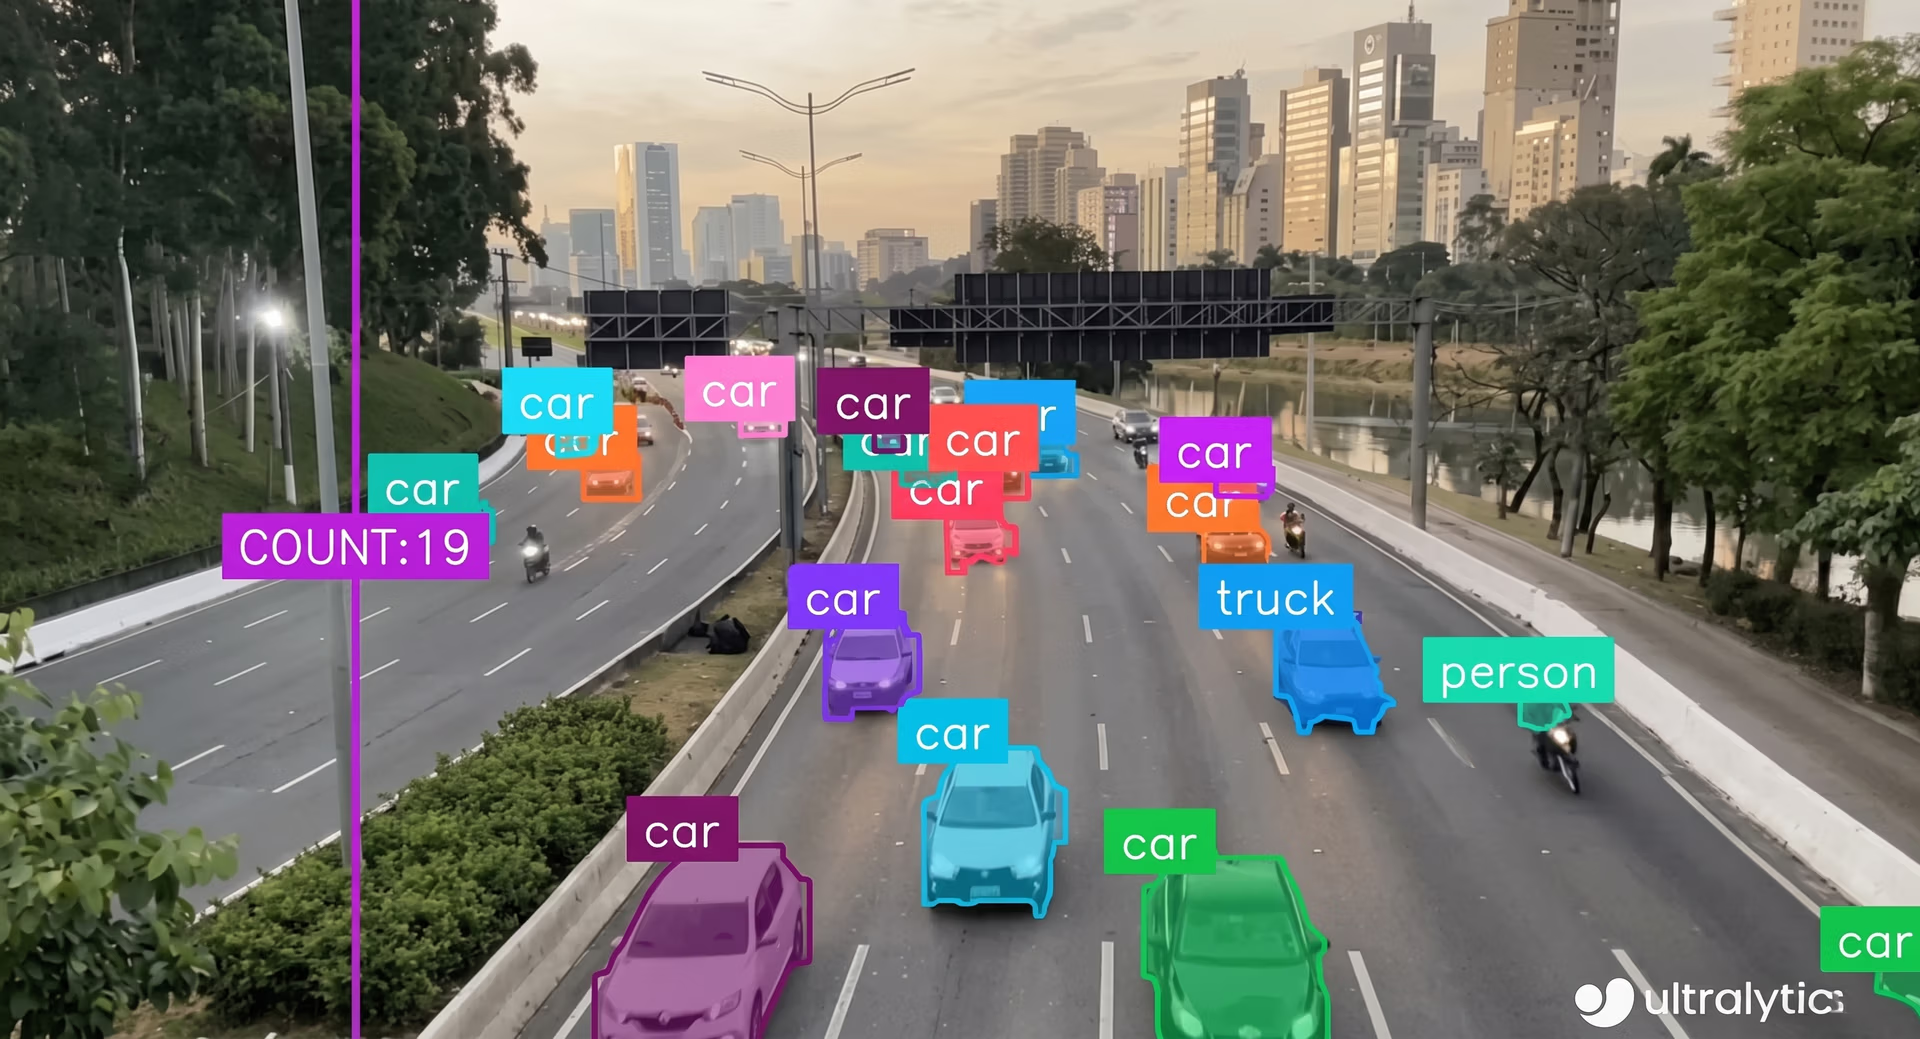
図6 YOLO11を使った車両カウント。
もう1つの興味深い活用例は産業検査です。Ultralytics YOLO11を生産ラインに導入すると、部品の欠落、位置ずれ、表面の損傷などの外観上の欠陥を自動検出できます。これにより、効率が向上し、コストが削減され、製品品質の改善につながります。
OpenVINOツールキットを使用する際に考慮すべき主なポイント#
OpenVINOを使ってUltralytics YOLO11モデルをデプロイする際、最良の結果を得るために留意すべき重要な点をいくつか紹介します。
- ハードウェアの互換性を確認する: CPU、統合型GPU、NPUなど、お使いのIntelハードウェアがOpenVINOでサポートされていることを確認し、モデルを効率よく実行できるようにしてください。
- 適切なドライバーをインストールする: Intel GPUまたはNPUを使用する場合は、必要なドライバーがすべて正しくインストールされ、最新の状態になっていることを確認してください。
- 精度のトレードオフを理解する: OpenVINOはFP32、FP16、INT8のモデル精度に対応しています。それぞれ速度と精度の間にトレードオフがあるため、パフォーマンス目標と利用可能なハードウェアに応じて適切な選択肢を選ぶことが重要です。
重要なポイント#
Ultralytics YOLO11をOpenVINO形式にエクスポートすると、Intelハードウェア上で高速かつ効率的なビジョンAIモデルを簡単に実行できます。再トレーニングやコードの変更をせずに、CPU、GPU、NPU全体にデプロイできます。シンプルさとスケーラビリティを保ちながら、パフォーマンスを高める優れた方法です。
Ultralytics Pythonパッケージに組み込みで対応しているため、OpenVINOへのエクスポートと推論の実行は簡単です。わずか数ステップでモデルを最適化し、さまざまなIntelプラットフォームで実行できます。スマートリテール、交通監視、産業検査のいずれに取り組む場合でも、このワークフローを使えば、開発からデプロイまで迅速かつ確実に進められます。
YOLOコミュニティに参加し、GitHubリポジトリを確認して、Ultralyticsがサポートする有用な連携機能について詳しくご覧ください。また、コンピュータービジョンを今すぐ始めるために、Ultralyticsのライセンスオプションもご確認ください。
今後開催予定のウェビナーに登録して、UltralyticsとOpenVINOの連携が実際に動作する様子をご覧ください。また、OpenVINOのウェブサイトで、AIを大規模に最適化してデプロイするためのツールをご確認ください。









