コンピュータービジョンタスクのすべて
物体追跡、インスタンスセグメンテーション、画像分類などのコンピュータービジョンタスクの仕組みと、Ultralytics YOLO11がそれらをどのようにサポートするかをご紹介します。
 Abirami Vina9 分で読めます
カメラと人工知能(AI)の進歩により、コンピューターや機械は人間に似た方法で世界を見られるようになりました。たとえば、人を認識し、物体を追跡し、動画内で起きていることの背景まで理解できます。
具体的には、コンピュータービジョンは、機械が周囲の世界から視覚情報を理解・解釈できるようにするAIの分野です。コンピュータービジョンにはさまざまなタスクがあり、それぞれ画像や動画から特定の種類の知見を抽出するよう設計されています。たとえば、物体検出は画像内のさまざまな物体を識別して位置を特定するのに役立ち、追跡、セグメンテーション、姿勢推定などのタスクは、機械が動き、形状、位置をより正確に理解するのに役立ちます。
特定のアプリケーションに使用するコンピュータービジョンタスクは、必要な分析情報の種類によって異なります。Ultralytics YOLO11のようなコンピュータービジョンモデルは、さまざまなコンピュータービジョンタスクに対応しており、実環境向けのVision AIシステムを構築する際に信頼できる選択肢となります。
このガイドでは、YOLO11などのモデルがサポートするコンピュータービジョンタスクを詳しく見ていきます。それぞれのタスクの仕組みと、さまざまな業界での活用方法を解説します。
コンピュータービジョンタスクとは?#
コンピュータービジョンタスクは、さまざまな方法で人間の視覚能力を再現することを目指します。これらのタスクにより、機械は物体を検出し、その動きを追跡し、姿勢を推定し、画像や動画内の個々の要素の輪郭を描き出すこともできます。通常、コンピュータービジョンタスクは、視覚データを小さな要素に分解して、状況をより明確に解釈できるようにするモデルによって実現されます。
Ultralytics YOLOのようなVision AIモデルは、1つのフレームワークで検出、追跡、セグメンテーションなど複数のタスクに対応しています。この汎用性により、YOLO11モデルは幅広いユースケースに簡単に導入できます。
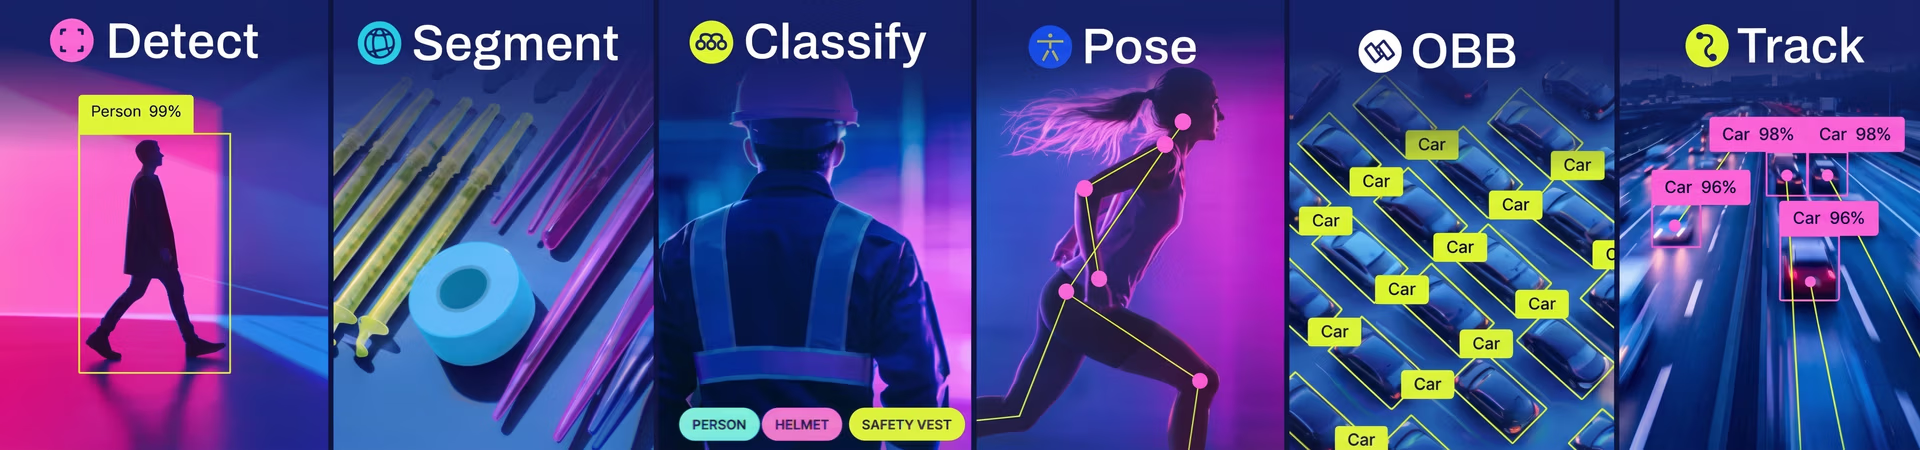
図1. Ultralytics YOLO11が対応するコンピュータービジョンタスク。
その好例がスポーツ分析です。YOLO11では、物体検出でフィールド上の各選手を検出し、物体追跡で試合中の選手を追跡できます。また、YOLO11の姿勢推定機能は選手の動きや技術の分析に役立ち、インスタンスセグメンテーションは各選手を背景から分離して分析の精度を高めます。
YOLO11を活用したこれらのコンピュータービジョンタスクを組み合わせると、試合中の状況を包括的に把握でき、チームは選手のパフォーマンス、戦術、全体的な戦略についてより深い分析情報を得られます。
Ultralytics YOLO11が対応するコンピュータービジョンタスクの概要#
コンピュータービジョンタスクとは何かを確認したところで、実例を交えながら、YOLO11がサポートする各タスクを詳しく見ていきましょう。
Ultralytics YOLO11の画像分類への対応#
写真を見れば、多くの人は犬、山、交通標識のどれが写っているかを簡単に判断できます。それらがどのように見えるかを学んできたからです。画像分類は、「車」「バナナ」「骨折のあるX線画像」など、画像の主要な対象に基づいて分類し、ラベルを付ける方法を機械に学習させることで、同じことを実現します。このラベルを利用すると、コンピュータービジョンシステムは視覚コンテンツを理解し、それに応じて対応したり判断したりできます。
このコンピュータービジョンタスクの興味深い活用例の1つが野生動物のモニタリングです。画像分類を使うと、野外で撮影した写真からさまざまな動物種を識別できます。画像に自動でラベルを付けることで、研究者は個体数を追跡し、移動パターンを監視し、絶滅危惧種をより簡単に特定して、保全活動に役立てることができます。
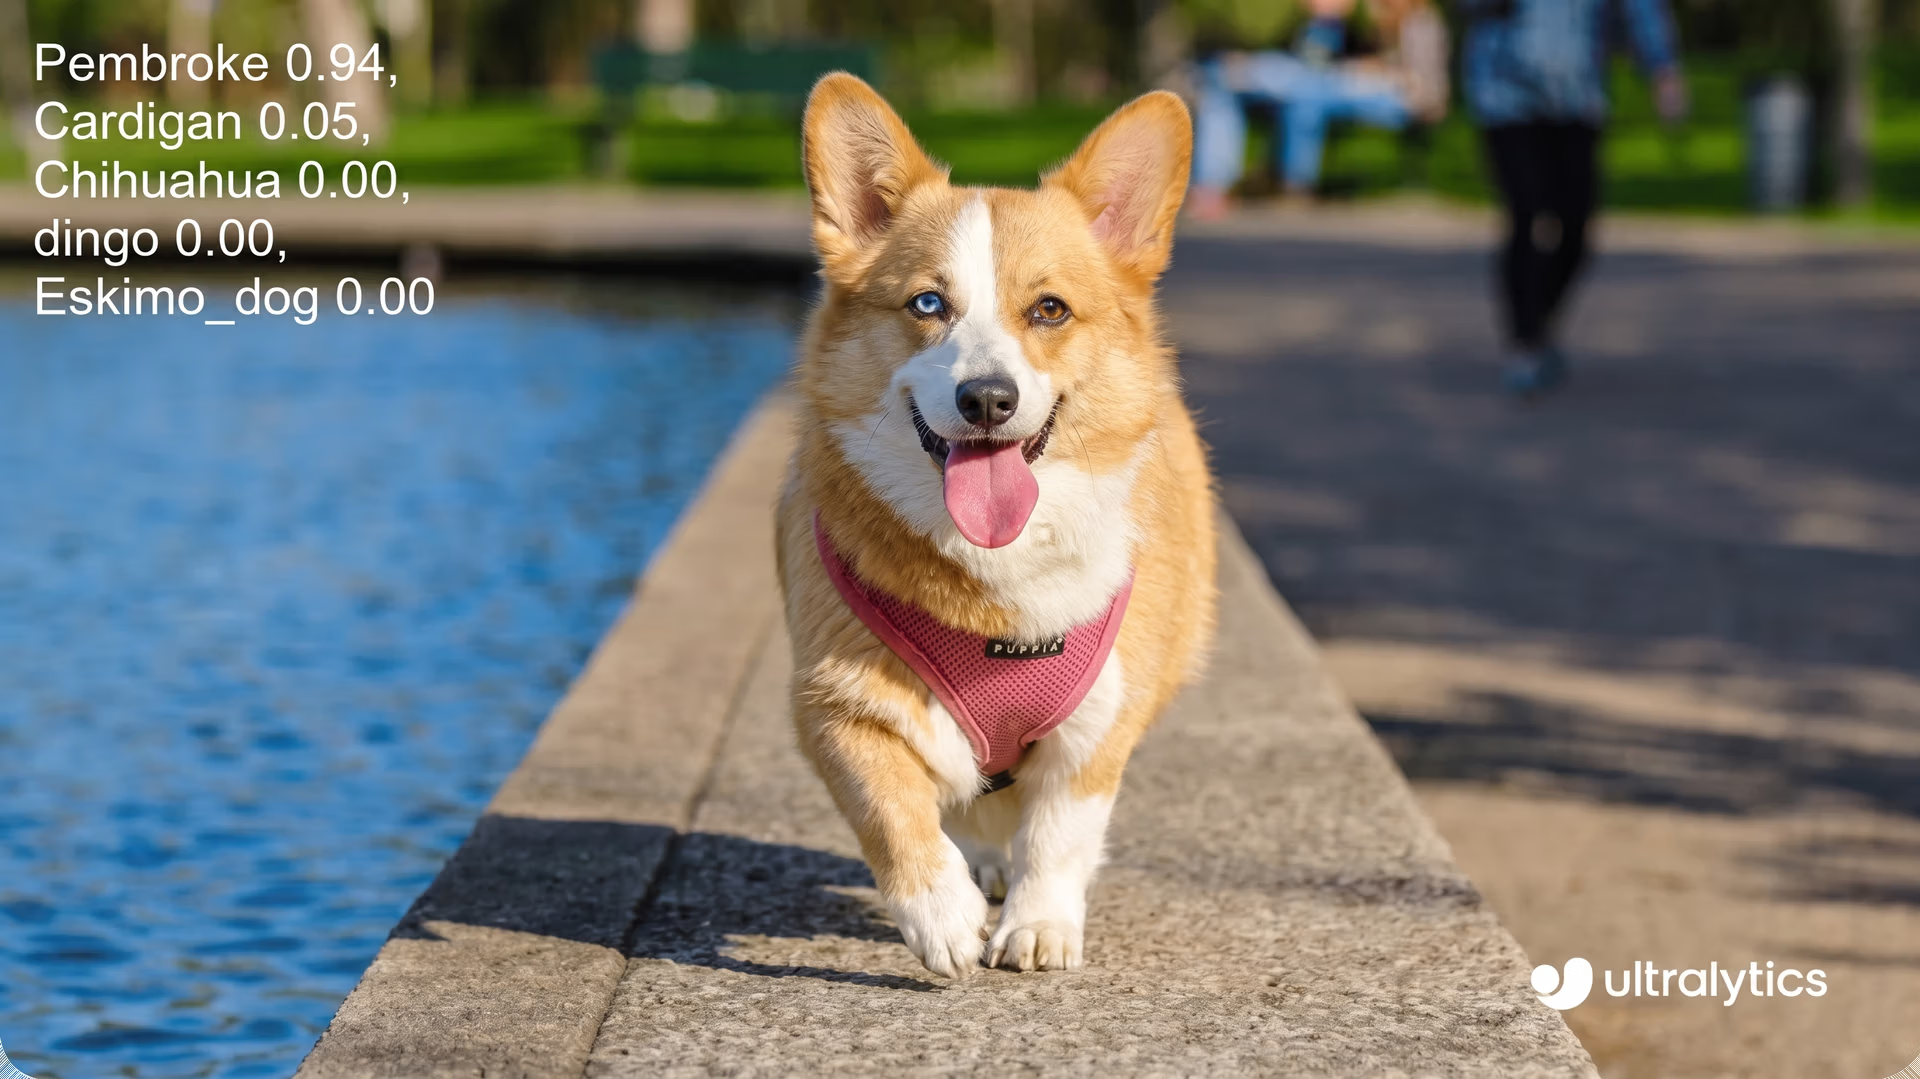
図2. YOLO11を画像分類に使用する例。
Ultralytics YOLO11の物体検出機能#
画像分類は画像に何が含まれているかを全体的に把握するのに役立ちますが、画像全体に1つのラベルを付けるだけです。複数の物体の正確な位置や識別情報など、詳細な情報が必要な場合は、物体検出が不可欠です。
物体検出とは、通常は物体の周囲にバウンディングボックスを描画して、画像内の個々の物体を識別し、その位置を特定するプロセスです。Ultralytics YOLO11はリアルタイムの物体検出に特に優れており、幅広いアプリケーションに適しています。
たとえば、小売店の商品棚の補充に使われるコンピュータービジョンソリューションを考えてみましょう。物体検出を使うと、果物、野菜、その他の商品を数えて、在庫を正確に把握できます。農地では、同じテクノロジーで作物の成熟度を監視し、農家が最適な収穫時期を判断できるようにします。熟した農産物と未熟な農産物を見分けることも可能です。
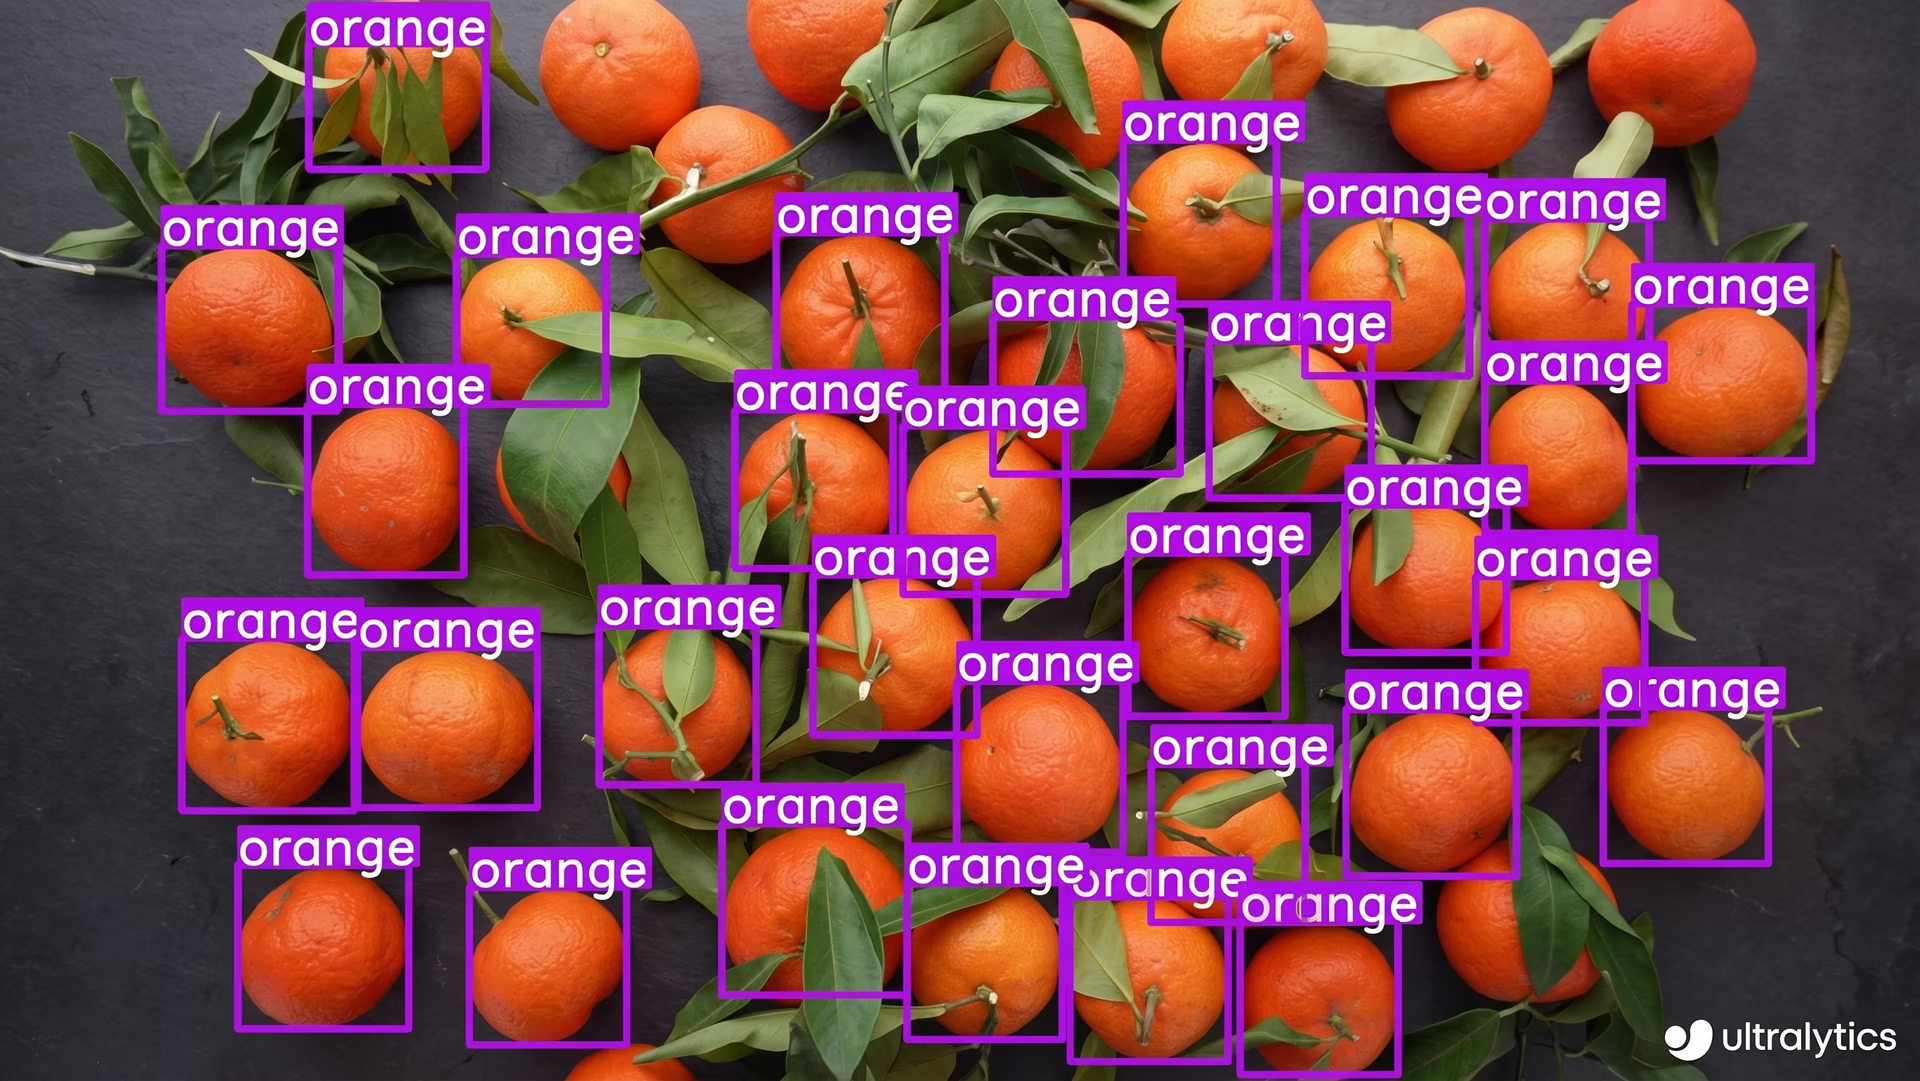
図3. Ultralytics YOLO11を使った果物の検出。
インスタンスセグメンテーションにYOLO11を使用する#
物体検出では、バウンディングボックスを使用して画像内の物体を特定し、その位置を検出しますが、正確な形状までは捉えられません。そこで役立つのがインスタンスセグメンテーションです。物体を囲むボックスを描く代わりに、インスタンスセグメンテーションでは物体の輪郭を正確にトレースします。
次のように考えると分かりやすいでしょう。「この領域にリンゴがある」と示すだけでなく、リンゴの正確な形状を丁寧に輪郭で示し、塗りつぶします。この詳細な処理により、AIシステムは物体の境界を明確に把握できます。特に、物体同士が近接している場合に役立ちます。
インスタンスセグメンテーションは、インフラ点検から地質調査まで、幅広い用途に適用できます。たとえば、地質調査のデータをYOLO11で解析し、大小の地表亀裂や異常をセグメンテーションできます。こうした異常の境界を正確に描画することで、エンジニアは問題箇所を特定し、プロジェクト開始前に対処できます。
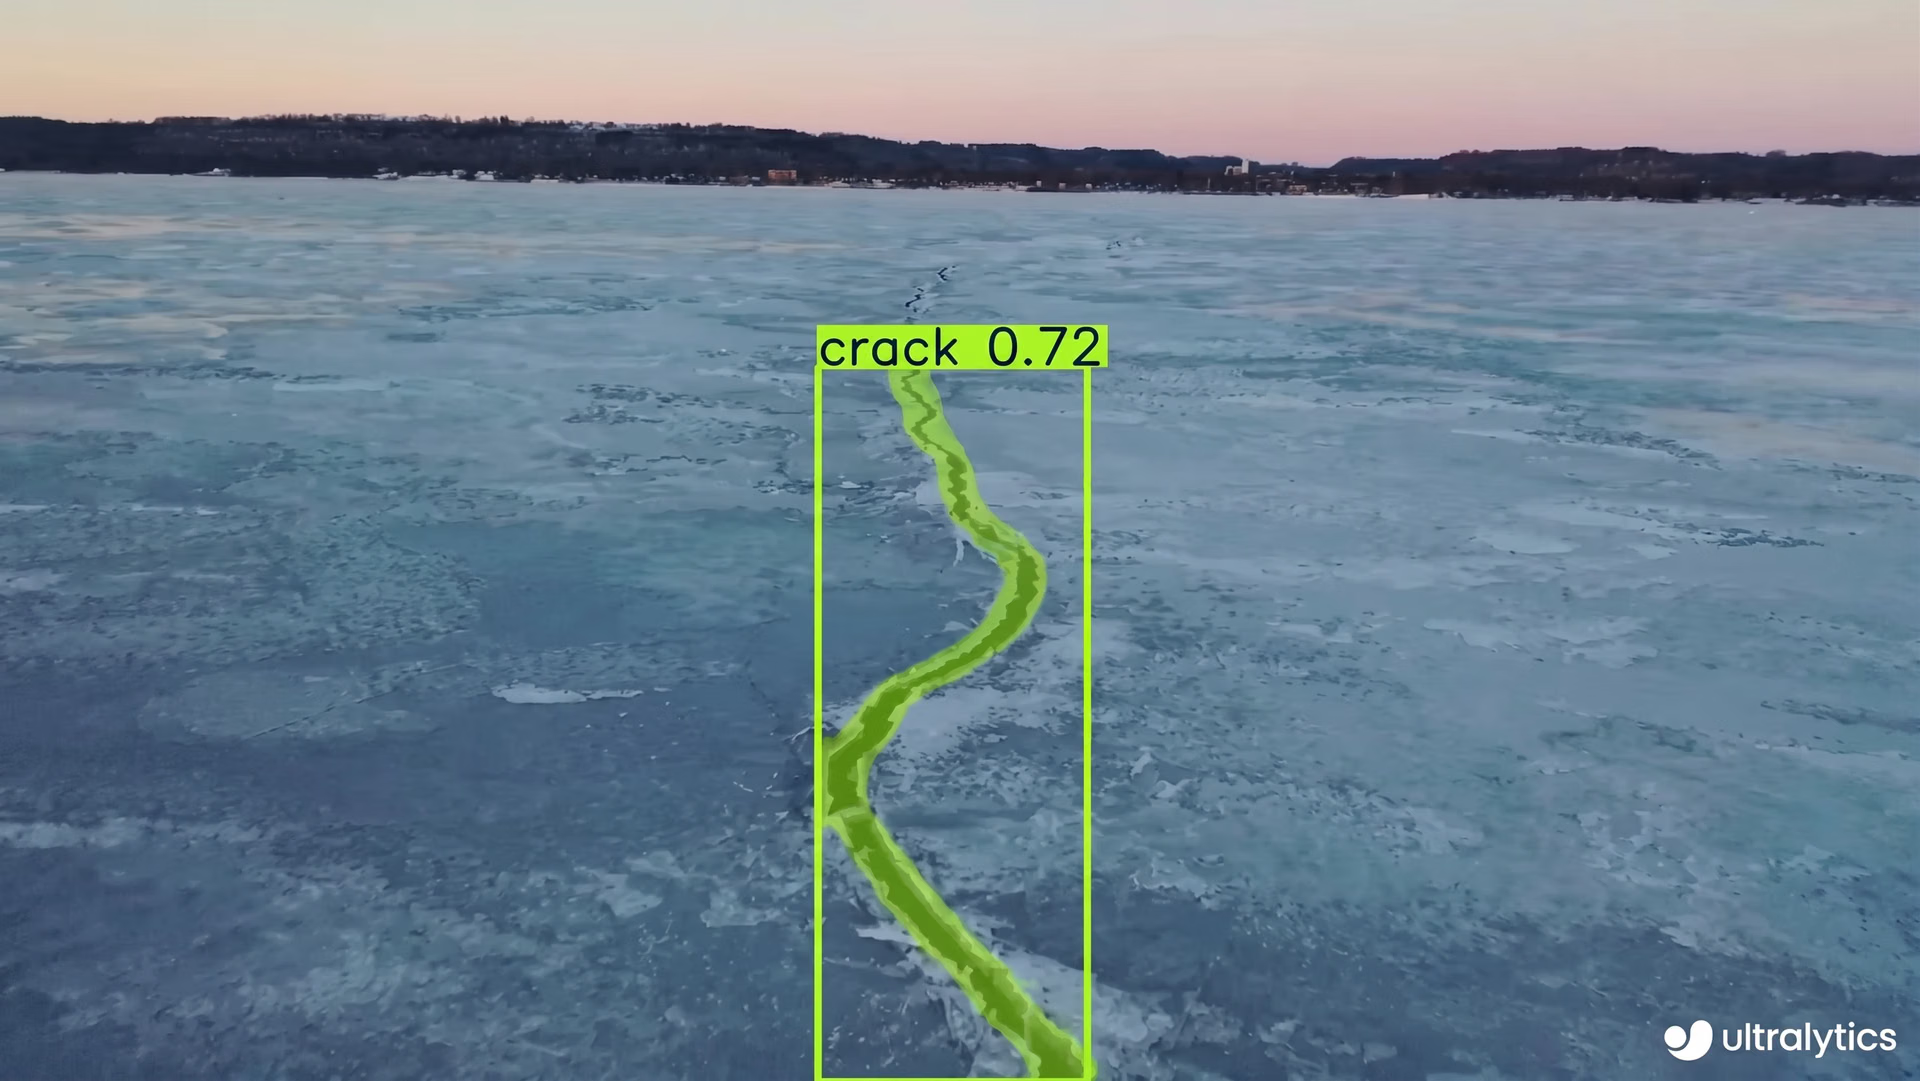
図4. YOLO11を活用した亀裂のセグメンテーション。
物体追跡:YOLO11によるフレーム間の物体追跡#
ここまで見てきたコンピュータービジョンのタスクは、1枚の画像に何が写っているかに焦点を当てています。しかし、動画では1フレームを超える情報が必要です。この場合は、物体追跡を利用できます。
YOLO11の物体追跡機能では、人や車などの特定の物体が一連の動画フレームを移動する様子を追跡できます。カメラの角度が変わったり、ほかの物体が現れたりしても、システムは同じ対象を追跡し続けます。
これは、交通中の車を追跡するなど、時間経過に沿った監視が必要なアプリケーションで重要です。実際、YOLO11は車両を正確に追跡し、各車を追うことでリアルタイムの速度推定を支援できます。そのため、物体追跡は交通監視などのシステムに欠かせない要素です。
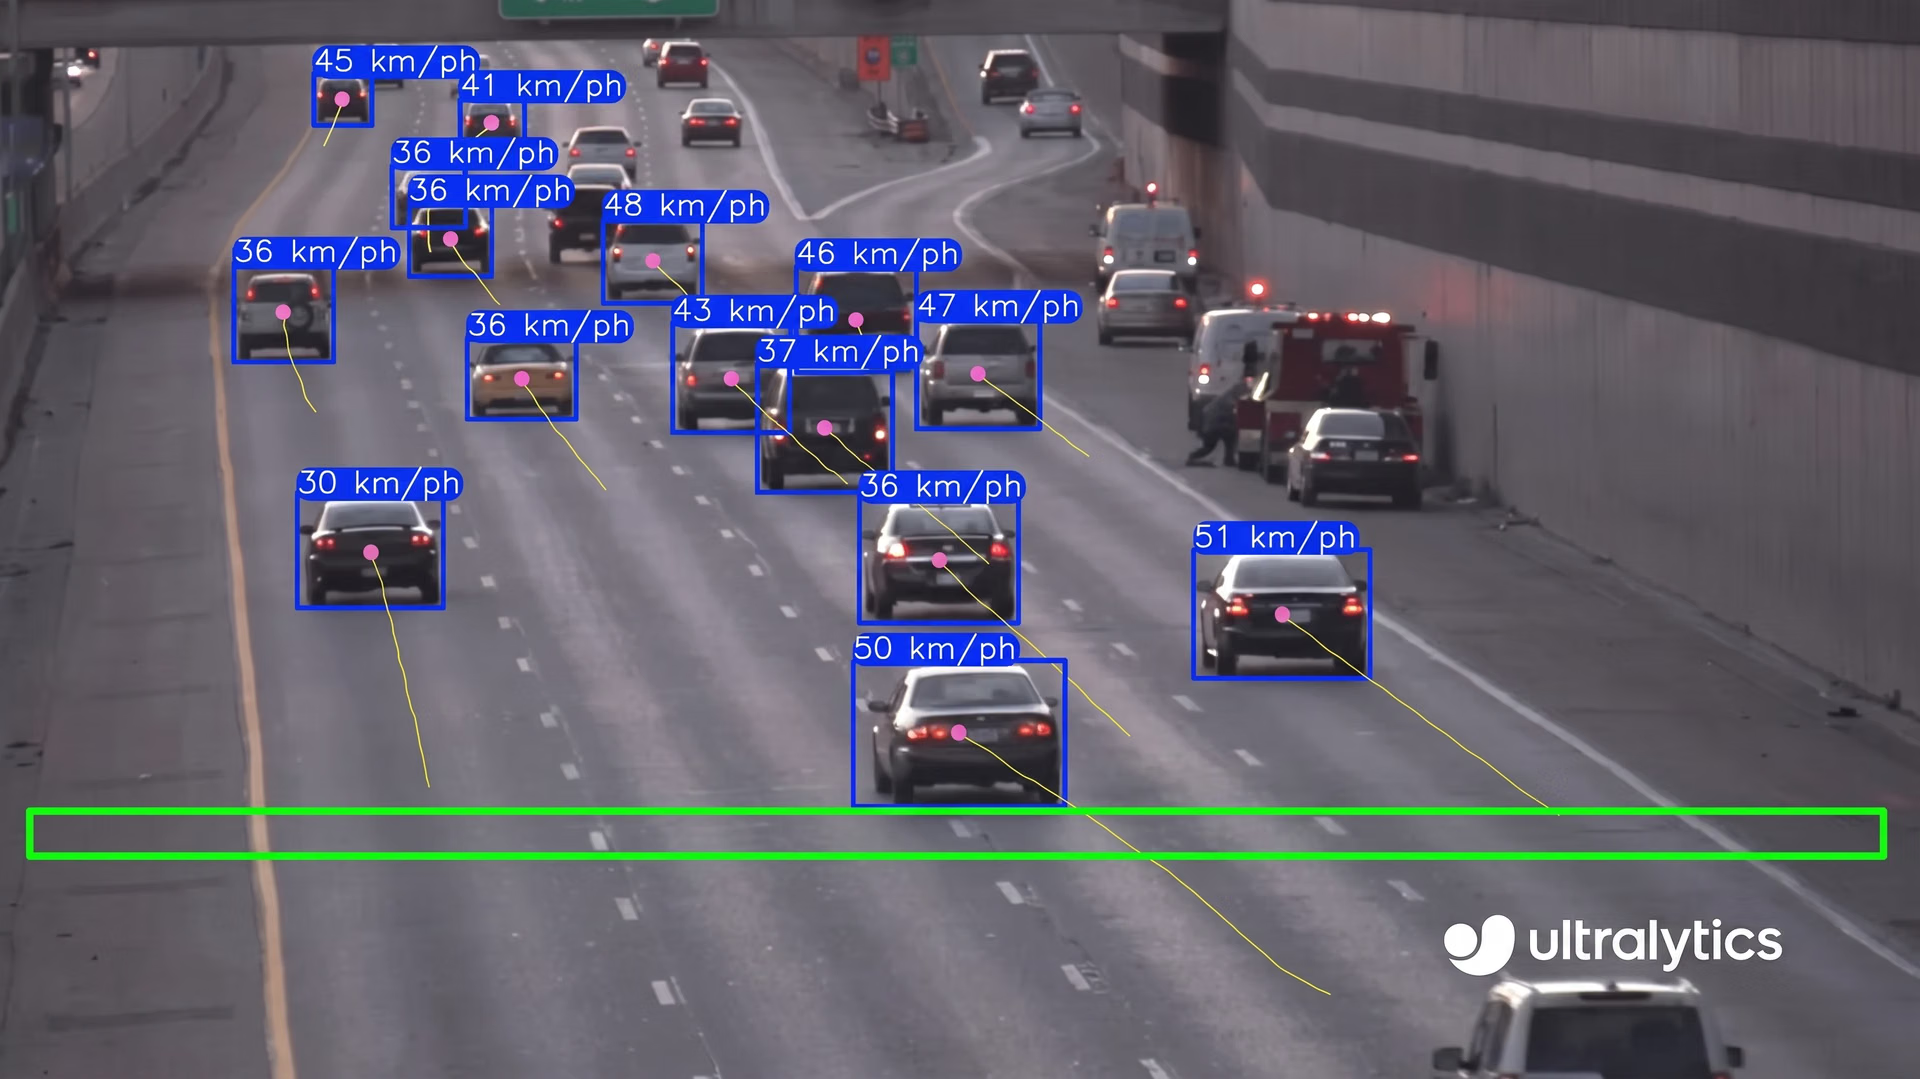
図5. YOLO11の物体追跡機能は、速度推定に活用できます。
YOLO11による方向付きバウンディングボックス(OBB)の検出#
現実世界の物体は常にきれいに整列しているわけではなく、傾いていたり、横向きだったり、不規則な角度に配置されていたりします。たとえば衛星画像では、船や建物が回転して見えることがよくあります。
従来の物体検出手法では、物体の向きに合わせて調整されない固定の長方形ボックスを使用するため、回転した形状を正確に捉えるのは困難です。方向付きバウンディングボックス(OBB)検出では、物体の角度に合わせて回転するボックスを使用し、物体にぴったり沿わせることで、より正確な検出を実現します。
港湾監視では、YOLO11のOBB検出機能により、船舶の向きに関係なく正確に識別して追跡できます。これにより、港に出入りするすべての船舶を適切に監視できます。この高精度な検出によって、船舶の位置や動きに関するリアルタイム情報を取得でき、混雑した港の管理や衝突防止に役立ちます。
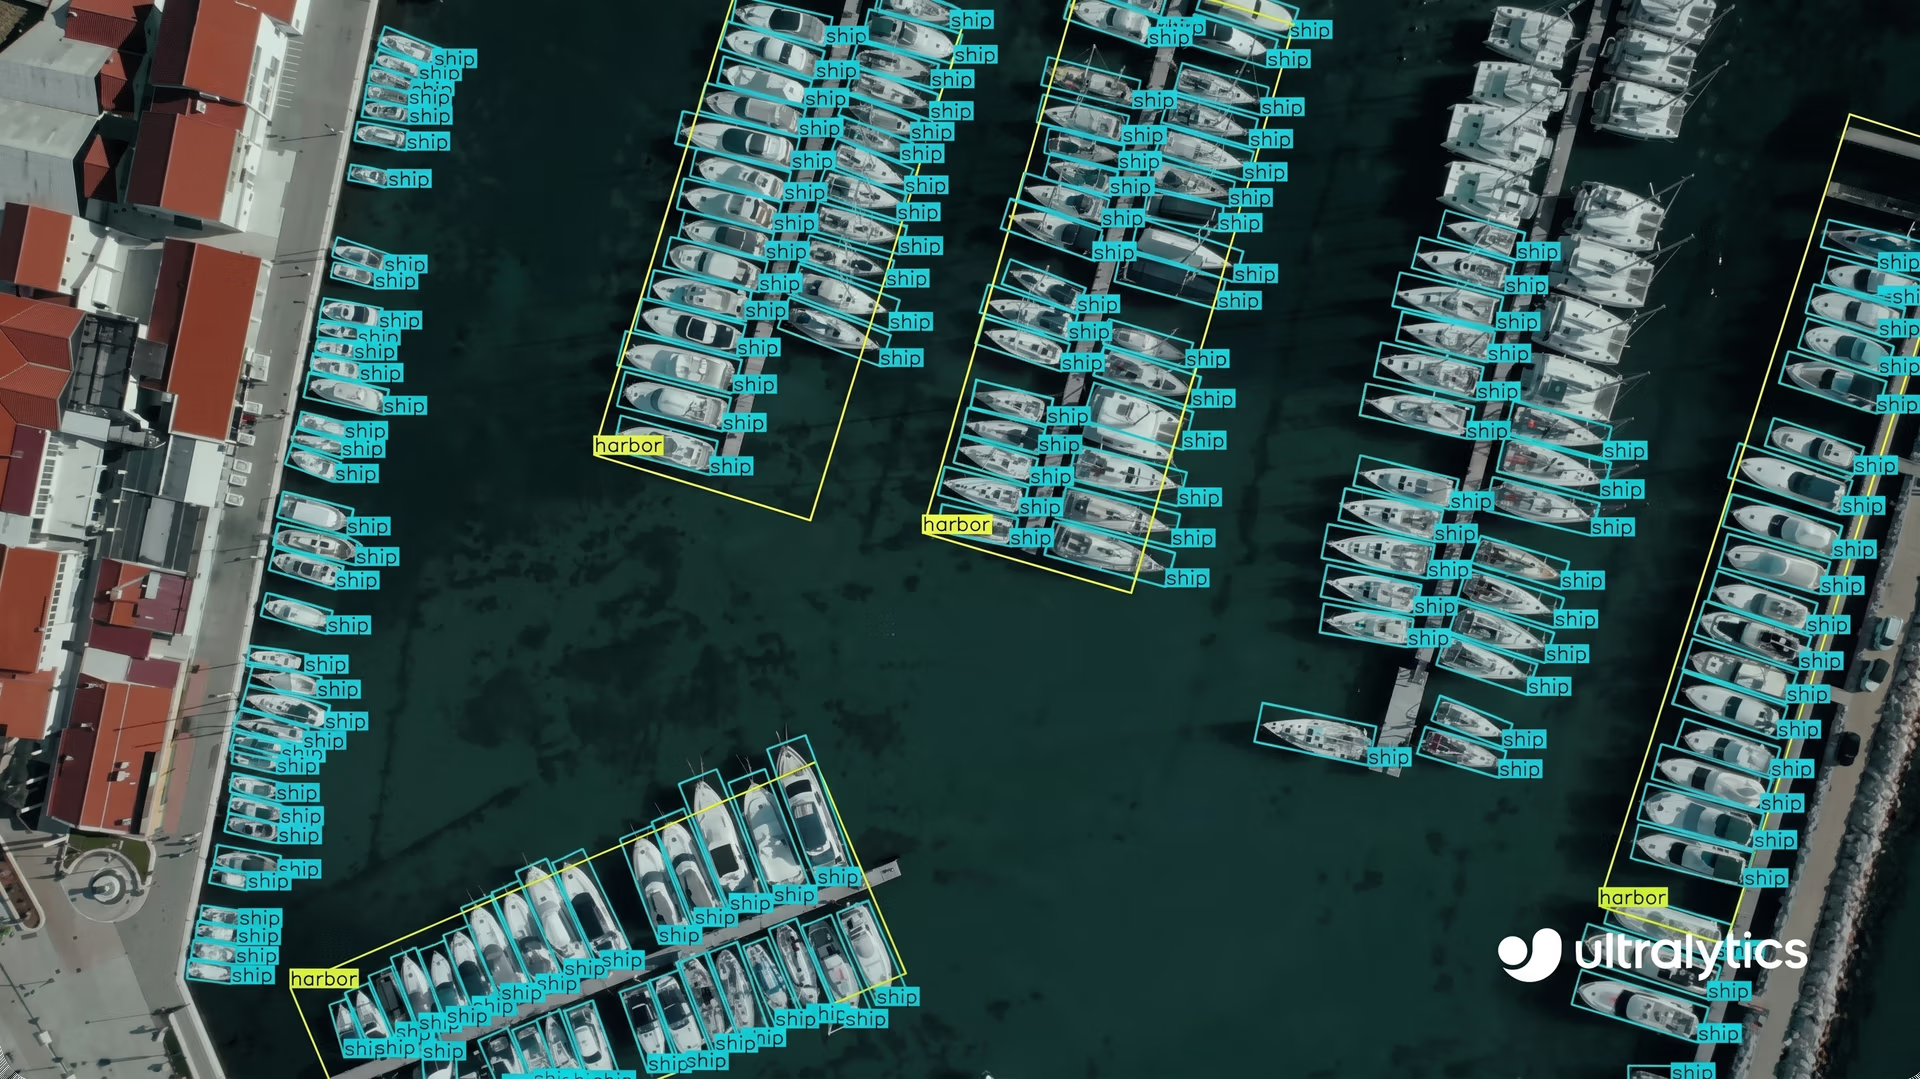
図6. OBB検出とYOLO11を使った船の検出。
姿勢推定とYOLO11:キーポイントの追跡#
姿勢推定は、関節や手足、その他のマーカーなどのキーポイントを追跡して、物体の動きを把握するコンピュータービジョン技術です。物体や身体全体をひとまとまりとして扱うのではなく、主要な部分に分解します。これにより、動作、ジェスチャー、相互作用を詳細に分析できます。
この技術の一般的な用途の1つが、人の姿勢推定です。さまざまな身体部位の位置をリアルタイムで追跡することで、人の動きを明確に把握できます。この情報は、ジェスチャー認識や活動のモニタリングから、スポーツのパフォーマンス分析まで、さまざまな目的に利用できます。
同様に、理学療法では、セラピストが人の姿勢推定とYOLO11を使用して、患者の運動中の動きをモニタリングできます。これにより、時間の経過に伴う進捗を追跡しながら、各動作が正しく行われていることを確認できます。
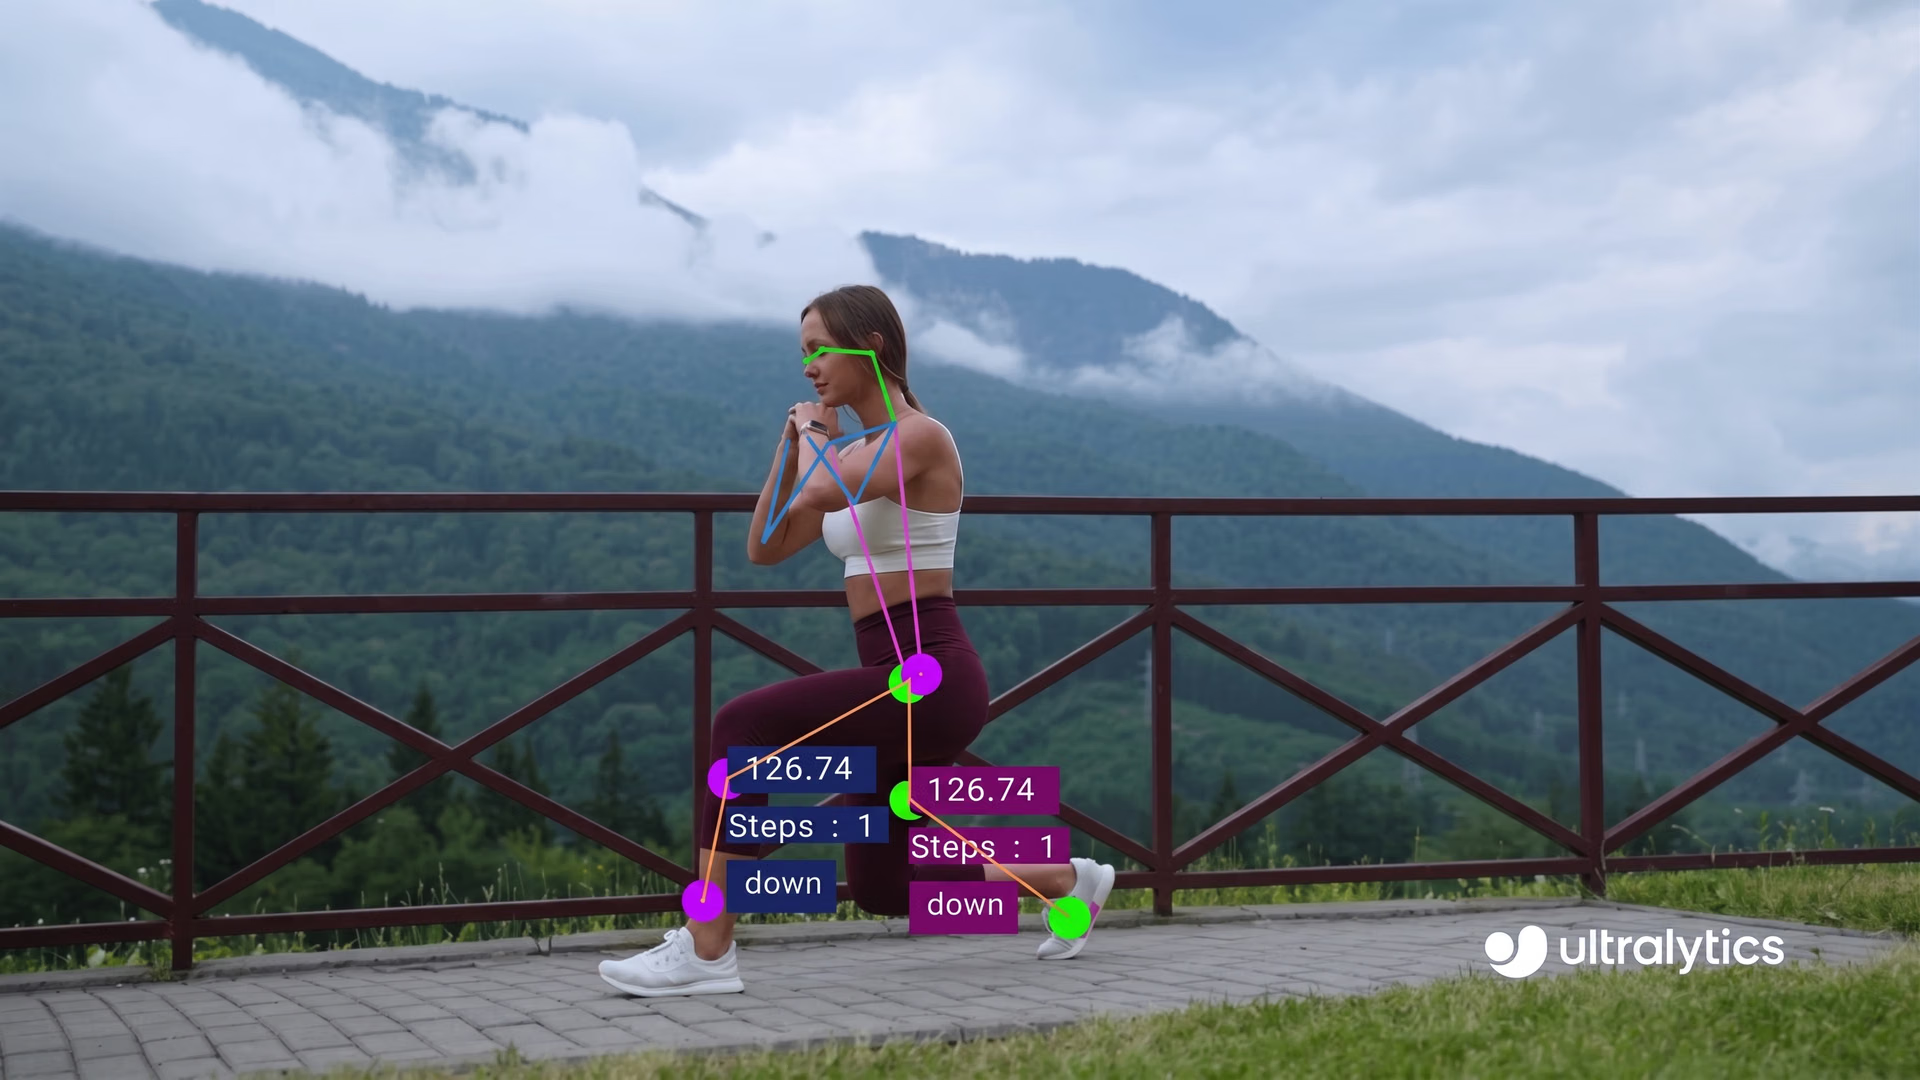
図7. YOLO11は姿勢推定を使用してトレーニングをモニタリングできます。
YOLO11がさまざまなコンピュータービジョンタスクをどのようにサポートするか#
YOLO11がサポートするすべてのコンピュータービジョンタスクを詳しく見てきたところで、次はYOLO11がそれらをどのようにサポートするかを説明します。
YOLO11は単一のモデルではなく、それぞれ特定のコンピュータービジョンタスク向けに設計された、複数の専用モデルバリアントで構成されるスイートです。そのため、YOLO11は幅広い用途に適応できる汎用性の高いツールです。また、カスタムのデータセットでこれらのモデルをファインチューニングし、プロジェクト固有の課題に対応することもできます。
特定のビジョンタスク向けに事前学習されたYOLO11モデルのバリアントを以下に示します。
- YOLO11:このモデルは複数の物体をリアルタイムで検出してラベル付けするため、高速な視覚認識に適しています。
- YOLO11-seg:このバリアントはセグメンテーションに特化しており、詳細なマスクを使用して物体を背景から分離します。
- YOLO11-cls:このバリアントは、画像全体の内容に基づいて単一のカテゴリラベルを割り当て、画像を分類します。
- YOLO11-pose:このモデルは身体のキーポイントを推定し、姿勢、手足の位置、動きを追跡します。
- YOLO11-obb:このモデルは、物体の向きに合わせたバウンディングボックスを描画し、回転した物体を検出するように設計されています。
各バリアントはさまざまなサイズで利用できるため、ユーザーは個々のニーズに応じて速度と精度の適切なバランスを選択できます。新しいUltralytics YOLO26は同じタスクに対応し、セマンティックセグメンテーションと深度推定も追加しています。
重要なポイント#
コンピュータービジョンタスクは、機械が世界を理解し、世界と関わる方法を変えています。画像や動画を主要な要素に分解することで、これらの技術は物体、動き、相互作用を詳細に分析しやすくします。
交通安全やスポーツのパフォーマンス向上から、産業プロセスの効率化まで、YOLO11のようなモデルはイノベーションを促進するリアルタイムの洞察を提供できます。Vision AIが進化し続けるにつれ、視覚データを解釈し日常的に活用するうえで、その重要性はますます高まるでしょう。
コミュニティに参加し、GitHubリポジトリにアクセスして、AIの活用例をご覧ください。ライセンスオプションを確認し、ソリューションページで農業分野のAIや製造業におけるコンピュータービジョンについて詳しくご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









