ビジョンAIシステムにおけるAIバイアスとデータセットバイアスを理解する
データセットのバイアスがコンピュータービジョンモデルに与える影響と、Ultralytics YOLO11がスマートなデータ拡張や柔軟なトレーニングツールでバイアスを軽減する方法をご紹介します。
人工知能(AI)モデルは問題解決の方法を変えつつありますが、完璧ではありません。自動運転車から医療の診断ツールまで、私たちはAIによるデータ解釈と意思決定に頼っています。では、データそのものに欠陥がある場合はどうなるのでしょうか。
AIのバイアスとは、モデル内で生じる一貫性のないパターンのことで、多くの場合、誰も気づかないうちに発生します。こうしたバイアスにより、モデルは不正確、一貫性のない、あるいは有害な予測をすることがあります。コンピュータービジョンにおけるバイアスは、通常、重要な一つの要因、つまりデータセットに起因します。モデルの学習に使うデータのバランスが取れていない、または代表性に欠けている場合、モデルにもその偏りが反映されます。
データセットのバイアスがどのように生じ、コンピュータービジョンモデルにどのような影響を与えるのか、また開発者がそれを検出、防止するために取れる対策を詳しく見ていきましょう。さらに、Ultralytics YOLO11などのモデルが、より公平で汎化性能の高いAIシステムの構築をどのように支援できるかも紹介します。ここでいう汎化性能とは、新しい未知のデータにも適切に対応し、より多くの人々に公平に役立つ能力です。
AIのバイアスとは何でしょうか。また、なぜ重要なのでしょうか。#
AIのバイアスとは、AIシステムで一貫して発生し、偏りのある結果や不正確な結果につながるエラーを指します。簡単に言えば、モデルがある種類の視覚入力をほかより優先するようになり、モデルの公平性に影響を及ぼします。これはモデルの性能が優れているからではなく、学習方法に起因します。
視覚データから学習するコンピュータービジョンでは、特にこの問題が起こりやすい場合があります。データセットに特定の種類の物体、場面、人物ばかりが含まれていると、モデルはそのケースでしかうまく機能しないパターンを学習します。
大都市の交通画像を中心に学習したモデルを想像してみてください。地方で導入すると、見慣れない道路の形状を誤分類したり、これまで見たことのない車両の種類を検出できなかったりする可能性があります。これがAIのバイアスが実際に現れる例です。精度の低下や汎化性能の制限につながります。汎化性能とは、新しい入力や多様な入力に対してモデルが適切に機能する能力です。
医療やセキュリティなど、精度が不可欠な用途では、こうした誤りは単に困るだけでなく、危険につながる可能性があります。バイアスへの対処は、性能、信頼性、安全性に関わる問題です。
データセットのバイアスがモデルの挙動に与える影響#
データセットのバイアスとは、モデルの学習に使うデータに偏りや制約があることを指します。学習データが、モデル化しようとする現実世界の多様性を十分に反映していない場合に発生します。
コンピュータービジョンモデルは世界を理解しているのではなく、パターンを理解しています。モデルが見る犬の画像が、裏庭にいるゴールデンレトリバーだけなら、雪道にいるハスキーを認識できないかもしれません。
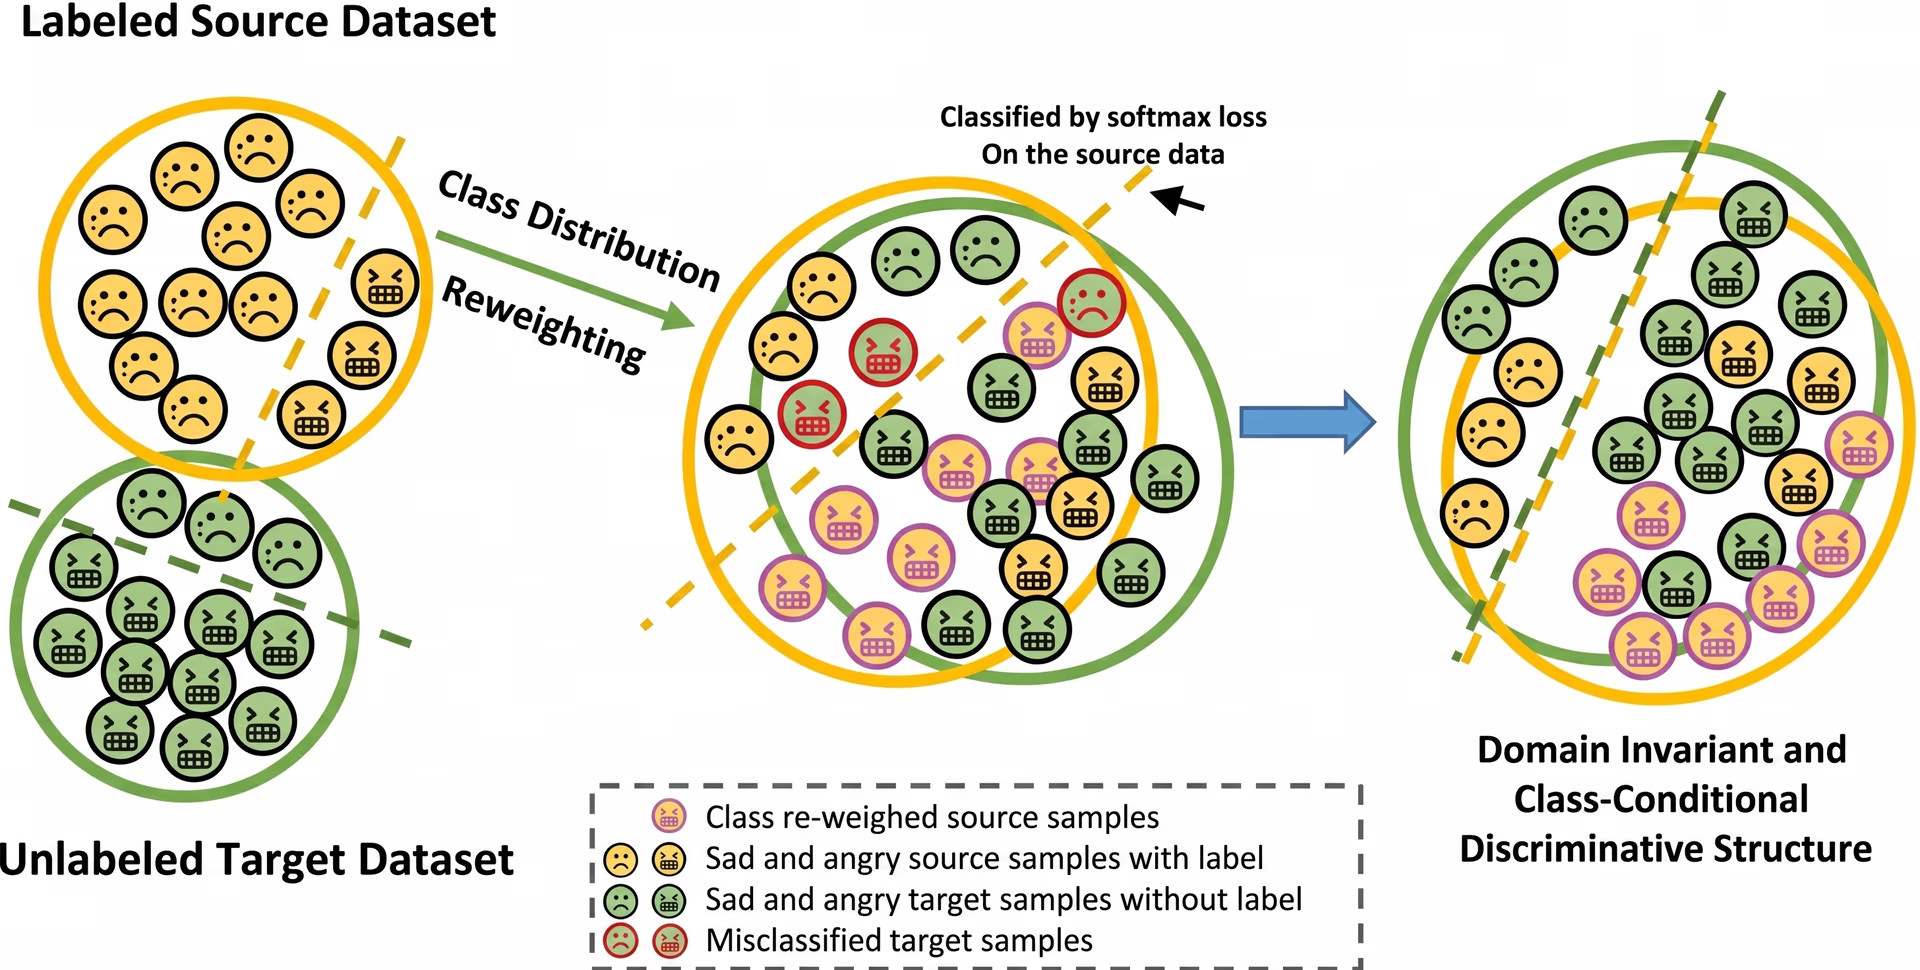
図1. 元データの再重み付けにより、モデルの精度を向上させられます。
これは、データセットのバイアスによって生じる主な課題の一つを示しています。モデルは、提示された内容に基づいて理解を形成します。学習データが現実世界の多様性を反映していなければ、モデルの挙動は限定的になり、未知の条件での有効性が低下します。
画像分類モデルは、同じタスク向けに構築されたデータセット同士であっても、学習時とは異なるデータセットでテストすると、性能が大幅に低下することがよくあります。照明、背景、カメラアングルのわずかな違いでも、精度が目に見えて低下することがあります。このことから、データセットのバイアスがモデルの汎化能力にいかに容易に影響するかが分かります。
これは例外的なケースではありません。データパイプラインがモデルアーキテクチャと同じくらい重要であることを示す兆候です。
AIの学習データに見られるバイアスの種類#
バイアスは、データ収集、ラベリング、キュレーションの過程など、開発プロセスにおいて気づきにくい形で現れることがあります。学習データに影響する主なバイアスを三つ紹介します。
選択バイアス#
データセットが実際の利用場面に見られる多様性を代表していない場合、選択バイアスが発生することがあります。歩行者検出モデルを、晴れた昼間の画像だけで学習すると、夜間や霧の中ではうまく機能しません。そのため、データの選択過程で重要なケースが見落とされていることになります。
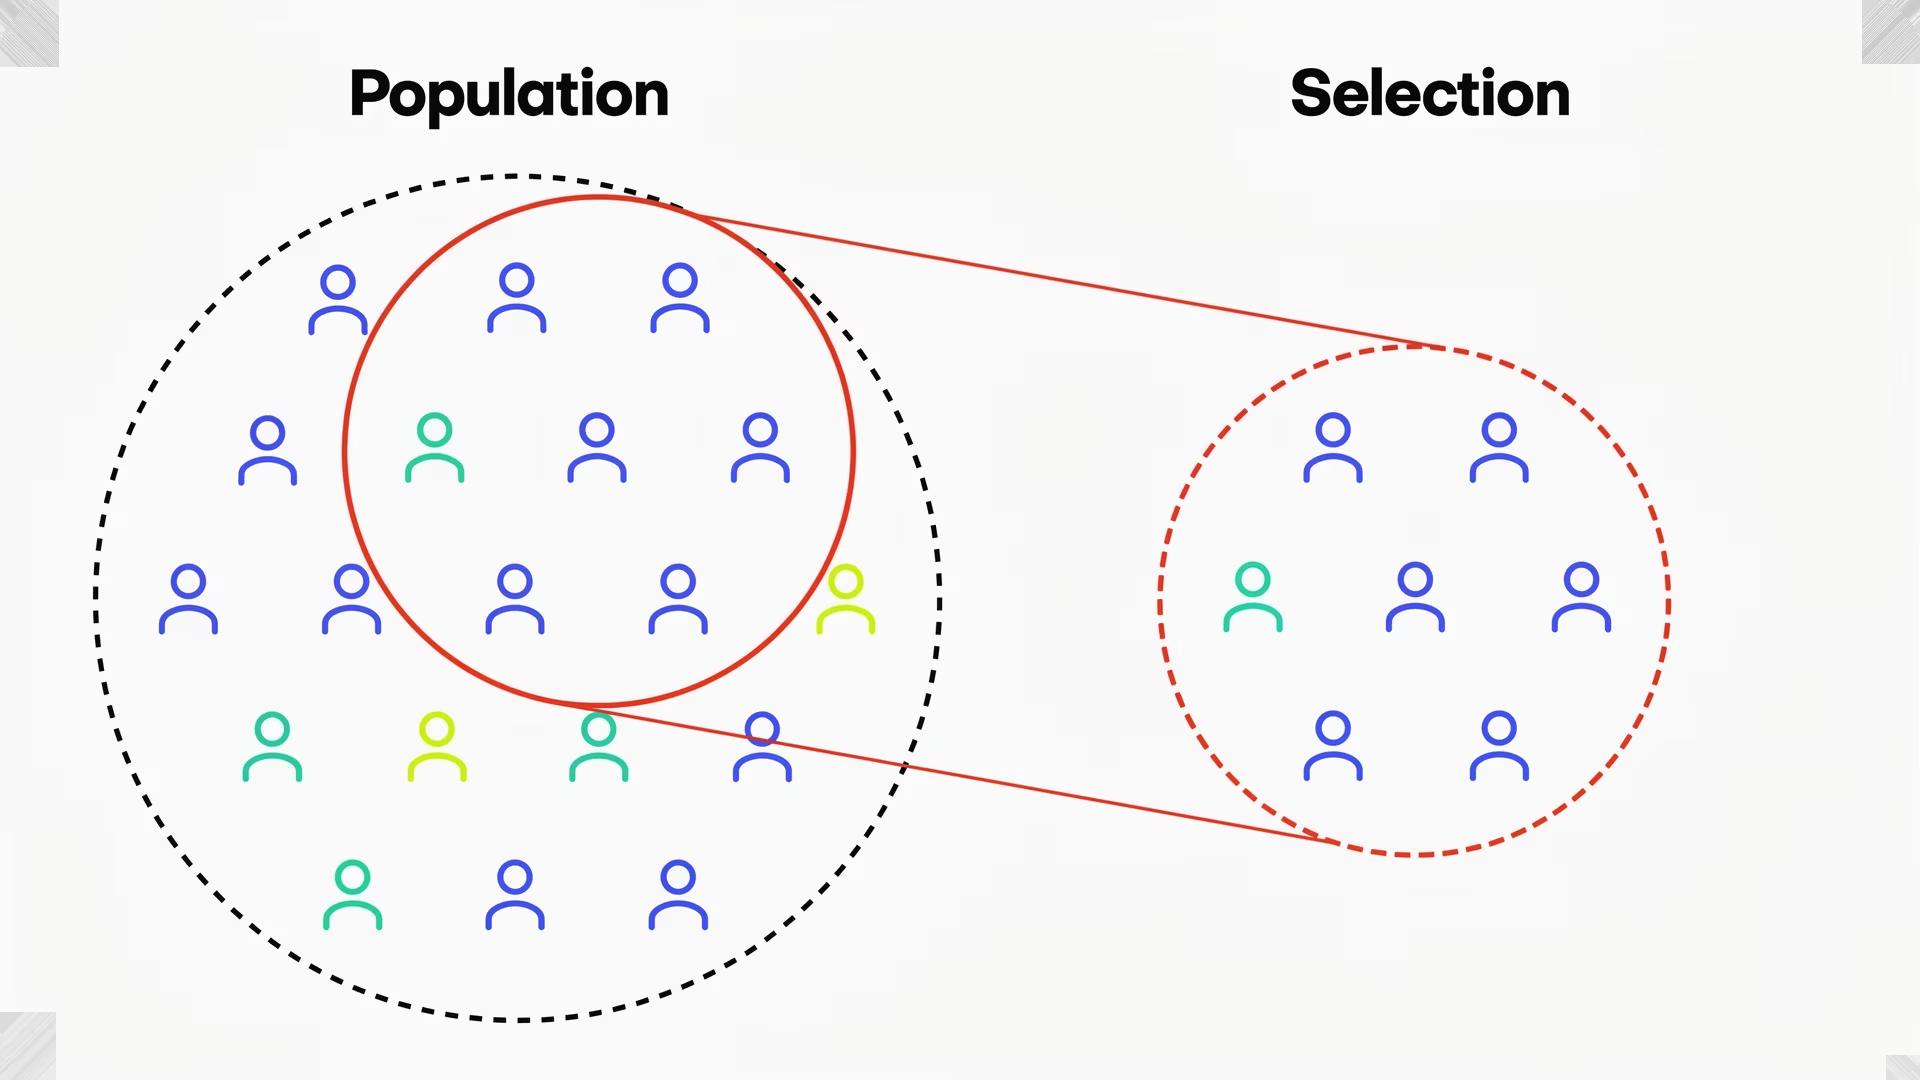
図2. 多様性のない一部のデータだけが選ばれた場合に生じる選択バイアスの視覚的な例です。
データ収集の方法により、データセットが現実世界のシナリオ全体を捉えられない場合に、このバイアスが発生します。たとえば、晴れた昼間の画像だけで学習した歩行者検出モデルは、霧、雪、暗所では検出に失敗する可能性があります。データが理想的または都合のよい条件下で収集されると、この問題が起きやすくなり、さまざまな環境でのモデルの性能が制限されます。より多様な環境を含めて収集範囲を広げることで、この種のバイアスを軽減できます。
オンラインの情報源から構築したデータセットでも、特定の地域、言語、社会経済的背景に偏ったコンテンツが多く含まれ、バイアスが生じることがあります。意識的にデータセットの多様性を高めなければ、モデルはこうした制約を引き継ぎます。
ラベルバイアス#
人間のアノテーターが誤ったラベルや一貫性のないラベルを付けると、ラベルバイアスが発生します。誤ったラベルは無害に見えるかもしれませんが、頻繁に起きると、モデルは誤った関連性を学習し始めます。
ラベルの不整合は、特に物体検出のような複雑なタスクで、学習中にモデルを混乱させることがあります。たとえば、あるアノテーターが車両を「乗用車」とラベル付けし、別のアノテーターが似た車両を「トラック」とラベル付けする場合があります。こうした不整合は、モデルが信頼性の高いパターンを学習する能力に影響し、推論時の精度低下につながります。
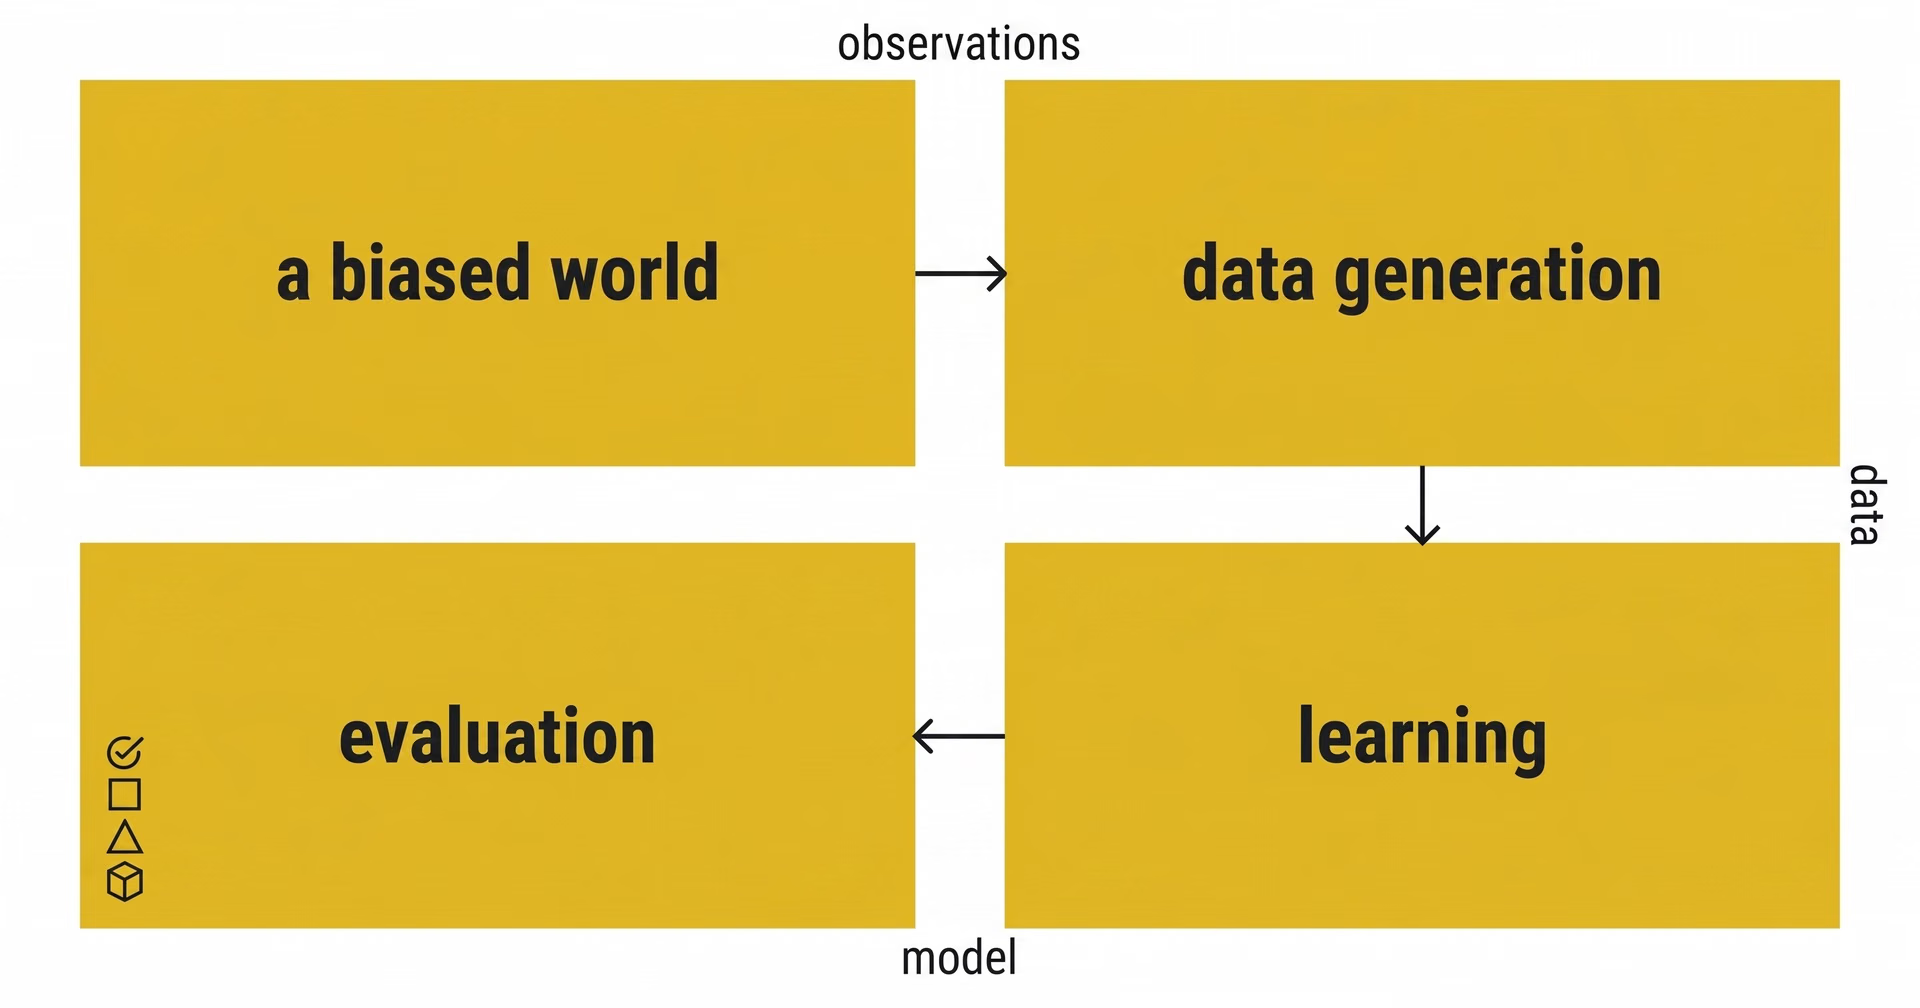
図3. データパイプラインのバイアスは、現実世界の不均衡に起因します。
アノテーションのガイドラインが不明確な場合や、同じデータに対する解釈が異なる場合にも、ラベルバイアスが生じることがあります。十分に文書化されたラベリング基準を確立し、品質管理チェックを実施することで、こうした課題を大幅に軽減できます。
アノテーター向けの継続的なトレーニングと、複数のアノテーターが各サンプルを確認する合意形成型のラベリングは、ラベルバイアスを最小限に抑え、データセットの品質を高める効果的な方法です。
表現バイアス#
表現バイアスは、より広範な社会的不平等を反映していることがよくあります。裕福な地域やネットワーク接続環境の整った地域で収集されたデータでは、十分に代表されていない人々や環境の多様性を捉えられないことがあります。このバイアスに対処するには、見落とされている集団や状況を意図的に含める必要があります。
特定の集団やクラスがデータセット内で十分に代表されていない場合に、表現バイアスが発生します。対象には、人口統計上のグループ、物体カテゴリ、環境条件などがあります。モデルが一つの肌の色、一種類の物体、または一つの背景スタイルしか見ていない場合、その予測にはその不均衡が反映されます。
特定の集団やカテゴリが、ほかと比べて著しく少ない数しか含まれていない場合に、この種のバイアスが見られます。これにより、データセット内で多数を占める例にモデルの予測が偏る可能性があります。たとえば、主に一つの人口統計グループを対象に学習した顔認識モデルは、すべての利用者に対して正確に機能するのが難しくなる場合があります。データの多様性に関わる選択バイアスとは異なり、表現バイアスはグループ間のバランスに関わります。
多様性の監査や、対象を絞ったデータ拡充戦略は、学習データセット全体で関連する人口統計グループやカテゴリが適切に表現されていることを確認するのに役立ちます。
データセットのバイアスを検出し、軽減する方法#
実環境でAIを導入する場合、AIのバイアスは単に誤った予測がいくつか出ることを意味するのではありません。一部の人にはうまく機能しても、すべての人には機能しないシステムにつながる可能性があります。
自動車分野のAIでは、歩行者検出モデルの性能が歩行者グループによって一貫せず、十分に代表されていない人々の安全性が低下することがあります。問題はモデルの意図ではなく、学習に使った視覚入力にあります。農業においても、物体検出のバイアスによって、さまざまな照明や天候条件下で作物を適切に識別できないことがあります。これらは、限られたデータセットやバランスの取れていないデータセットでモデルを学習した場合によく起こる結果です。
AIのバイアスを解消するには、まず問題の所在を把握する必要があります。学習データセットに重要な例が欠けていたり、狭い範囲のデータに偏っていたりすると、モデルにもその偏りが反映されます。そのため、AI開発の各パイプラインでバイアスを検出することが重要です。
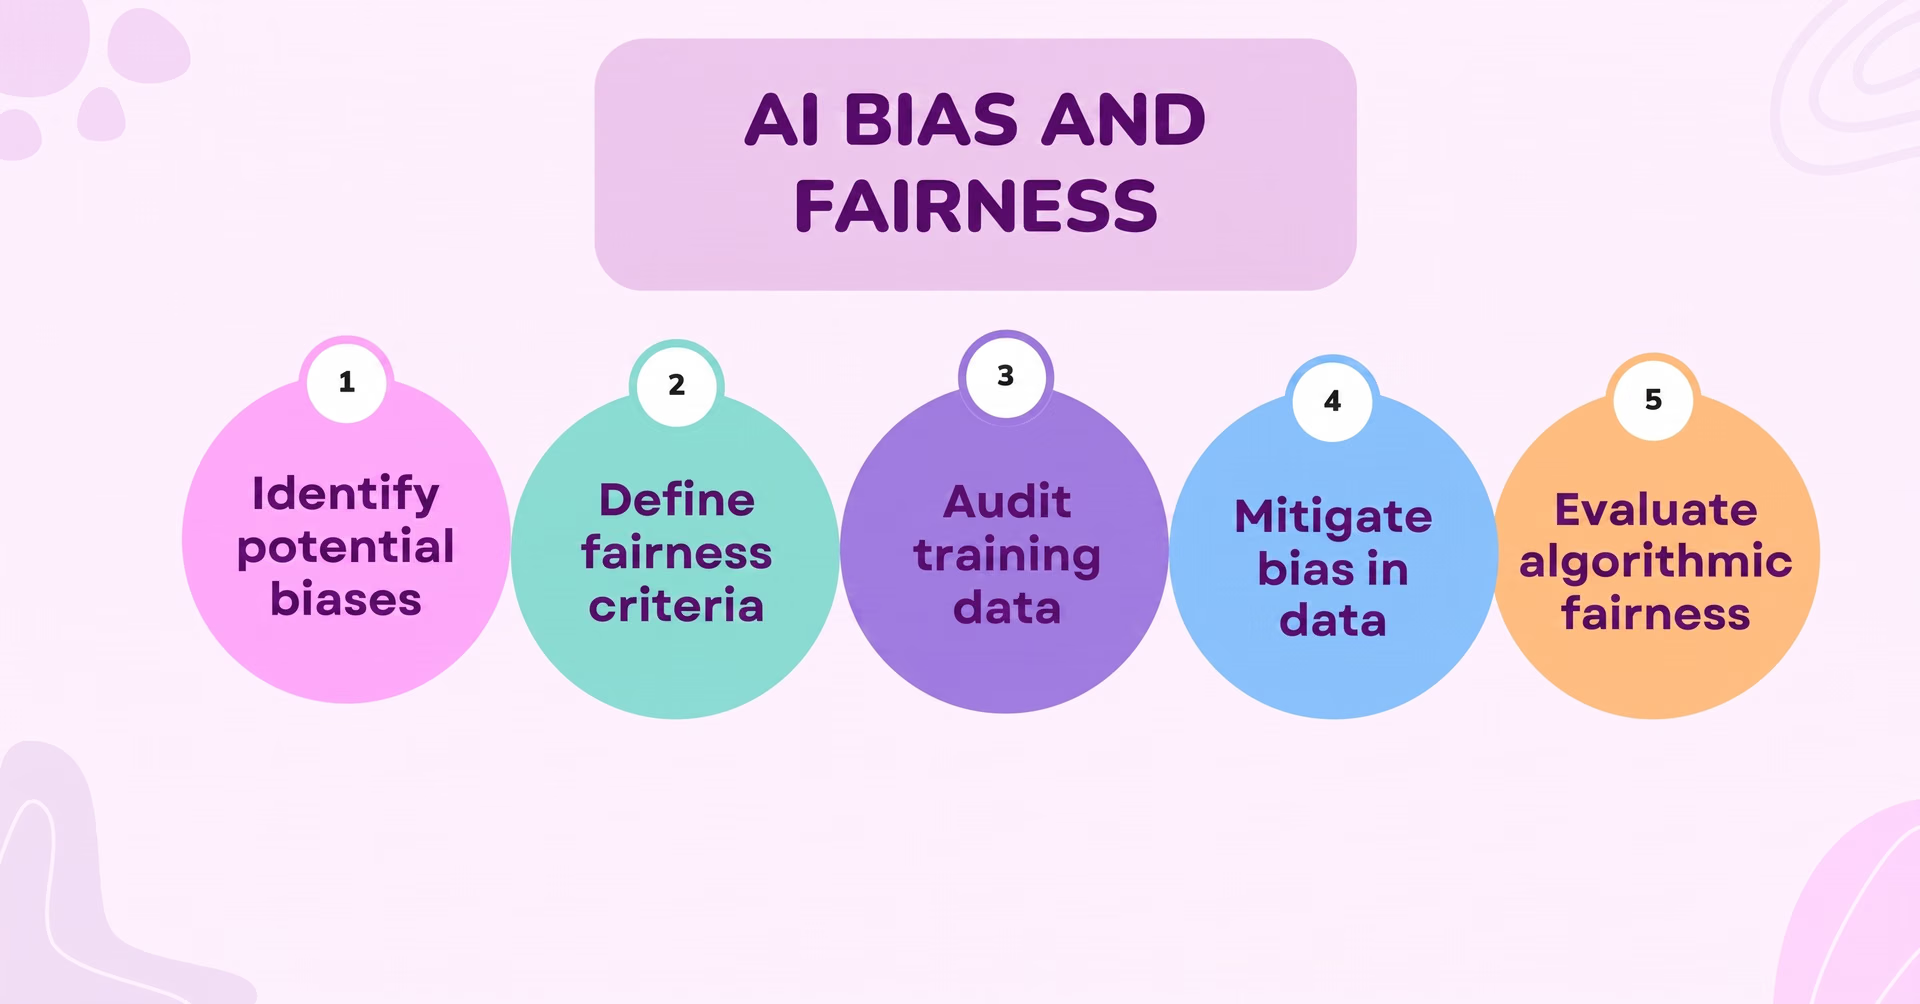
図4. AIのバイアスを軽減し、公平性を向上させるための主な手順です。
まず、データセットを分析します。クラス、環境、照明、物体のスケール、人口統計グループごとの分布を確認してください。特定のカテゴリが大半を占めている場合、モデルはほかのカテゴリで十分な性能を発揮できない可能性があります。
次に、性能を確認します。特定の環境や物体の種類でモデルの性能が低下していないでしょうか。そうであれば、学習されたバイアスの兆候であり、通常はデータに原因があります。
スライス単位の評価が重要です。平均精度が90%のモデルでも、特定のグループや条件では60%にとどまることがあります。こうした部分ごとに確認しなければ、そのことに気づけません。
学習と評価に公平性指標を使うことも、強力な手段です。これらの指標は標準的な精度スコアにとどまらず、データのさまざまなサブセットにおけるモデルの挙動を評価します。ほかの方法では見過ごされる可能性のある盲点を明らかにするのに役立ちます。
データセットの構成とモデルのテストについて透明性を高めることで、より優れたモデルにつながります。
データの多様性と拡張による公平性の向上#
バイアスを特定したら、次はその格差を埋めます。効果的な方法の一つは、AIモデルのデータの多様性を高めることです。つまり、異なる集団の医療画像や珍しい環境条件など、十分に代表されていない状況からサンプルをさらに収集します。
データを追加することは、特に多様性の向上につながる場合に有効です。ただし、公平性の改善には、適切な種類の例を収集することも重要です。これらの例は、モデルが遭遇する可能性のある現実世界の多様性を反映している必要があります。
データ拡張も有効な戦略です。画像の反転、回転、照明の調整、物体のスケーリングにより、現実世界のさまざまな条件を再現できます。データ拡張はデータセットの多様性を高めるだけでなく、外観、照明、文脈の変化に対するモデルの堅牢性も向上させます。
最新の学習パイプラインの多くでは、データ拡張がデフォルトで組み込まれていますが、公平性の向上に効果を発揮するには、タスク固有のニーズに応じた調整など、戦略的に活用することが重要です。
不足を補うための合成データの活用#
合成データとは、現実世界の例を模倣するよう人工的に生成されたデータです。特定の状況が非常にまれな場合や、実環境での収集に慎重さが求められる場合に役立ちます。
たとえば、機械のまれな欠陥や、交通違反の特殊なケースを検出するモデルを構築する場合、合成データを使ってその状況をシミュレーションできます。これにより、学習データセットではあまり遭遇しない可能性のある事象からも、モデルが学習できるようになります。
研究では、学習に対象を絞った合成データを導入することで、データセットのバイアスを軽減し、人口統計グループや環境をまたいだ性能を向上できることが示されています。
合成データは、実世界のサンプルと組み合わせることで最も効果を発揮します。合成データはデータセットを補完するものであり、置き換えるものではありません。
Ultralytics YOLO11による倫理的なAIの支援#
バイアスのないAIモデルの構築には、使用するツールも関係します。Ultralytics YOLO11は柔軟で、ファインチューニングしやすく、高い適応性を備えているため、データセットのバイアスを軽減するのに適しています。
Ultralytics YOLO11はモデルの学習中に高度なデータ拡張技術をサポートし、さまざまな画像の文脈や合成例を導入することで、モデルの汎化性能を高め、過学習を軽減します。
Ultralytics YOLO11は、特徴抽出をより効果的に行うために、バックボーンとネックのアーキテクチャも改良されています。この改良により、細かな特徴を検出する能力が高まります。これは、標準的なモデルでは対応が難しい、十分に代表されていないケースや特殊なケースで特に重要です。
Ultralytics YOLO11は再学習が容易で、エッジ環境やクラウド環境に導入できるため、チームは性能のギャップを特定し、現場でバイアスが見つかった際にモデルを迅速に更新できます。
公平なAIの実現は、一度きりの目標ではありません。評価、学習、調整を繰り返すサイクルです。Ultralytics YOLO11のようなツールは、このサイクルをより迅速かつ生産的に進めるのに役立ちます。
重要なポイント#
AIのバイアスは、公平性から性能に至るまで、あらゆる面に影響します。コンピュータービジョンのバイアスは、データセットの収集、ラベリング、バランス調整の方法に起因することがよくあります。幸い、バイアスを検出し、軽減するための実証済みの方法があります。
まず、データを監査し、さまざまなシナリオでモデルの性能をテストしてください。対象を絞ったデータ収集、データ拡張、合成データを活用して、学習データのカバー範囲を改善します。
Ultralytics YOLO11は、カスタムモデルの学習、強力なデータ拡張技術の適用、バイアス発見時の迅速な対応を容易にし、このワークフローを支援します。
公平なAIを構築することは、単に正しいことをするためだけではありません。よりスマートで信頼性の高いシステムを構築することにもつながります。
成長を続けるコミュニティにご参加ください。GitHubリポジトリでAIについてさらに詳しく学べます。独自のコンピュータービジョンプロジェクトを始めませんか。ライセンスオプションをご覧ください。ソリューションページでは、製造業におけるAI活用や農業におけるビジョンAIをご紹介しています。









