ノイズ除去のための自己教師あり学習:手順を追った解説
ノイズ除去のための自己教師あり学習の仕組み、画像にノイズが生じる理由、鮮明な視覚情報を復元するための主要な手法と手順をご紹介します。
 Abirami Vina15 分で読めます
カメラは常に、私たちが見るとおりに世界を捉えるとは限りません。暗い場所で撮影した人物写真や、高速で走る車の写真は、ざらついたり、ぼやけたり、ゆがんだりすることがあります。
センサーの反応が遅いこと、暗い環境、動きなどによって、小さなノイズが生じ、輪郭がぼやけて重要な細部が見えにくくなることがあります。鮮明さが失われると、画像の内容を理解するうえで細部に依存する多くの高度なAIや機械学習システムでさえ、認識が難しくなる場合があります。
たとえば、コンピュータービジョンは、機械が画像や動画を解釈できるようにする人工知能の一分野です。しかし、正確に解釈するには、ビジョンAIモデルが学習に使用する、ノイズのない高品質な視覚データが必要です。
具体的には、Ultralytics YOLO11やUltralytics YOLO26(2026年1月にリリース)などのモデルが、物体検出、インスタンスセグメンテーション、姿勢推定などのタスクに対応しており、さまざまなユースケースに合わせてカスタムトレーニングできます。これらのタスクは、エッジ、テクスチャ、色、細かな構造の詳細など、明確な視覚的手掛かりに依存しています。
ノイズがこうした特徴を覆い隠すと、モデルが受け取る学習信号が弱まり、正確なパターンを学習しにくくなります。その結果、わずかなノイズでも実際のアプリケーションで性能が低下する可能性があります。
以前の記事では、自己教師あり学習による画像のノイズ除去について解説しました。この記事では、自己教師ありノイズ除去技術の仕組みと、意味のある視覚情報の復元にどう役立つのかをさらに詳しく見ていきます。
実世界の画像に見られる一般的なノイズの種類#
自己教師あり学習を画像のノイズ除去にどのように活用するかを見ていく前に、まず、そもそも画像にノイズが生じる理由を振り返りましょう。
実世界の物体や場面を撮影した画像が完全な状態であることは、ほとんどありません。照明不足、センサー品質の制限、速い動きなどによって、画像内の個々のピクセルにランダムな乱れが生じることがあります。ノイズと呼ばれるこうしたピクセルレベルの乱れは、全体的な鮮明さを損ない、重要な細部を見えにくくします。
ノイズによって輪郭、テクスチャ、微妙なパターンが隠れると、コンピュータービジョンシステムは物体の認識や場面の正確な解釈が難しくなります。条件によって異なる種類のノイズが発生し、それぞれが画像に異なる影響を与えます。
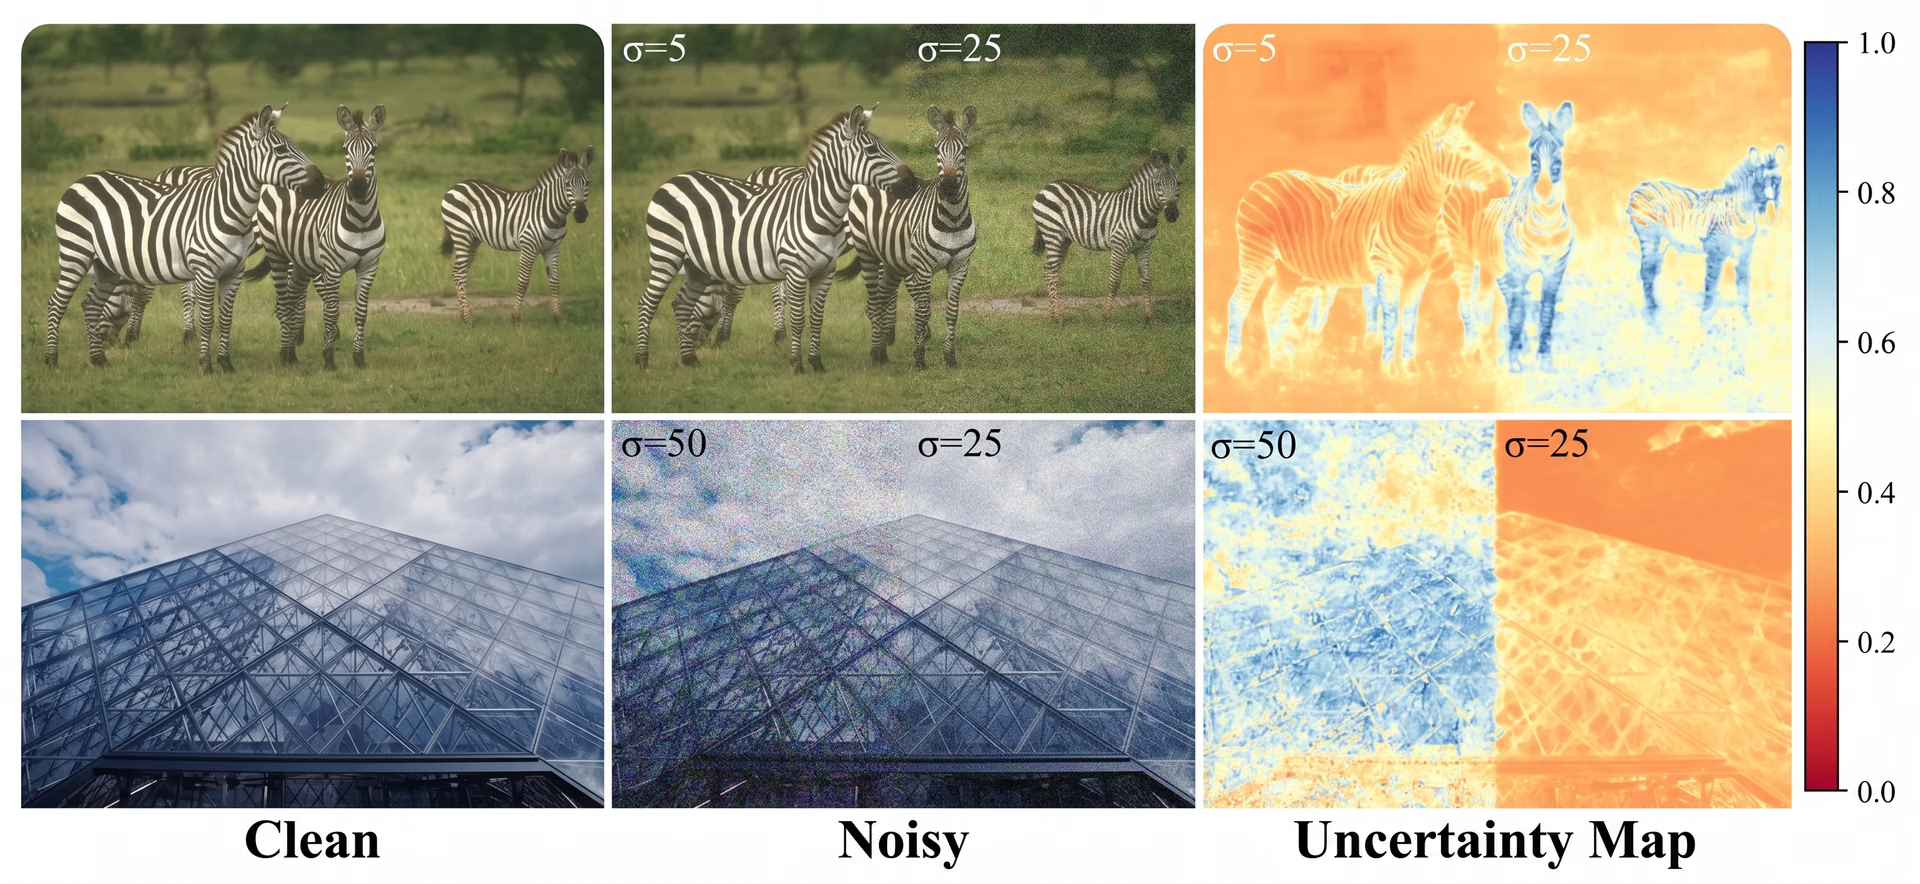
図1。ノイズによって画像の不確実性が増す例。(出典)
画像に見られる最も一般的なノイズの種類をいくつか紹介します。
- ガウスノイズ:電子センサーの干渉や熱変動によって発生する、柔らかくランダムな粒状ノイズです。ガウス(正規)分布に従い、小さなピクセルの変動が細部をぼかし、全体の鮮明さを低下させます。
- ポアソンノイズ:ショットノイズとも呼ばれ、暗所や露光時間が短い場合に発生します。分散は明るさに応じて増加しますが、撮影される光子が少なく信号対雑音比が低くなるため、暗い領域でより目立つことがよくあります。
- ごま塩ノイズ:黒または白の鋭いピクセル状の点として現れるノイズです。通常、伝送エラー、ビット破損、カメラセンサーの故障によって発生し、ピクセル値の欠落や破損につながることがよくあります。
- スペックルノイズ:粒状の斑点模様として現れ、医用画像、レーダー画像、超音波画像でよく見られるノイズです。信号の干渉や散乱によって発生し、コントラストを低下させ、輪郭を検出しにくくします。
自己教師ありノイズ除去はどのような場合に使うべきですか?#
では、自己教師ありノイズ除去の特徴は何でしょうか。クリーンな正解画像が存在しない、または撮影が非常に難しい状況で特に効果を発揮します。
これは、低照度撮影、高ISO撮影、医用・科学画像、あるいはノイズが避けられず、完全な参照データの収集が現実的でないあらゆる環境でよく見られます。クリーンな画像の例を必要とせず、すでに手元にあるノイズの多い画像から直接モデルを学習させるため、カメラやセンサー固有のノイズパターンに適応できます。
データセット内に一貫性のない画像やノイズの多い画像が含まれているものの、後続のコンピュータービジョンタスクの性能を高めたい場合にも、自己教師ありノイズ除去は有効な選択肢です。輪郭、テクスチャ、構造をより鮮明に復元することで、YOLOなどのモデルが場面をより確実に検出、セグメント化、理解できるようになります。つまり、ノイズの多いデータを扱っていて、クリーンな学習画像を入手できない場合、自己教師ありノイズ除去は最も実用的で効果的なソリューションとなることがよくあります。
自己教師ありノイズ除去を支える中核技術#
これまでに見てきたように、自己教師ありノイズ除去は、クリーンなラベルに頼らず、ノイズのある画像から直接モデルを学習させるディープラーニングベースのAIアプローチです。データ自体からモデルが学習信号を生成する自己教師あり学習の原則に基づいています。
言い換えると、ノイズの多い画像を入力と学習信号の両方に使うことで、モデルは自ら学習できます。同じ画像の異なる破損バージョンを比較したり、マスクされたピクセルを予測したりすることで、モデルは実際の構造を表すパターンと単なるノイズを区別できるようになります。反復的な最適化とパターン認識を通じて、ネットワークは意味のある画像内容とランダムな変動を見分ける能力を徐々に向上させます。
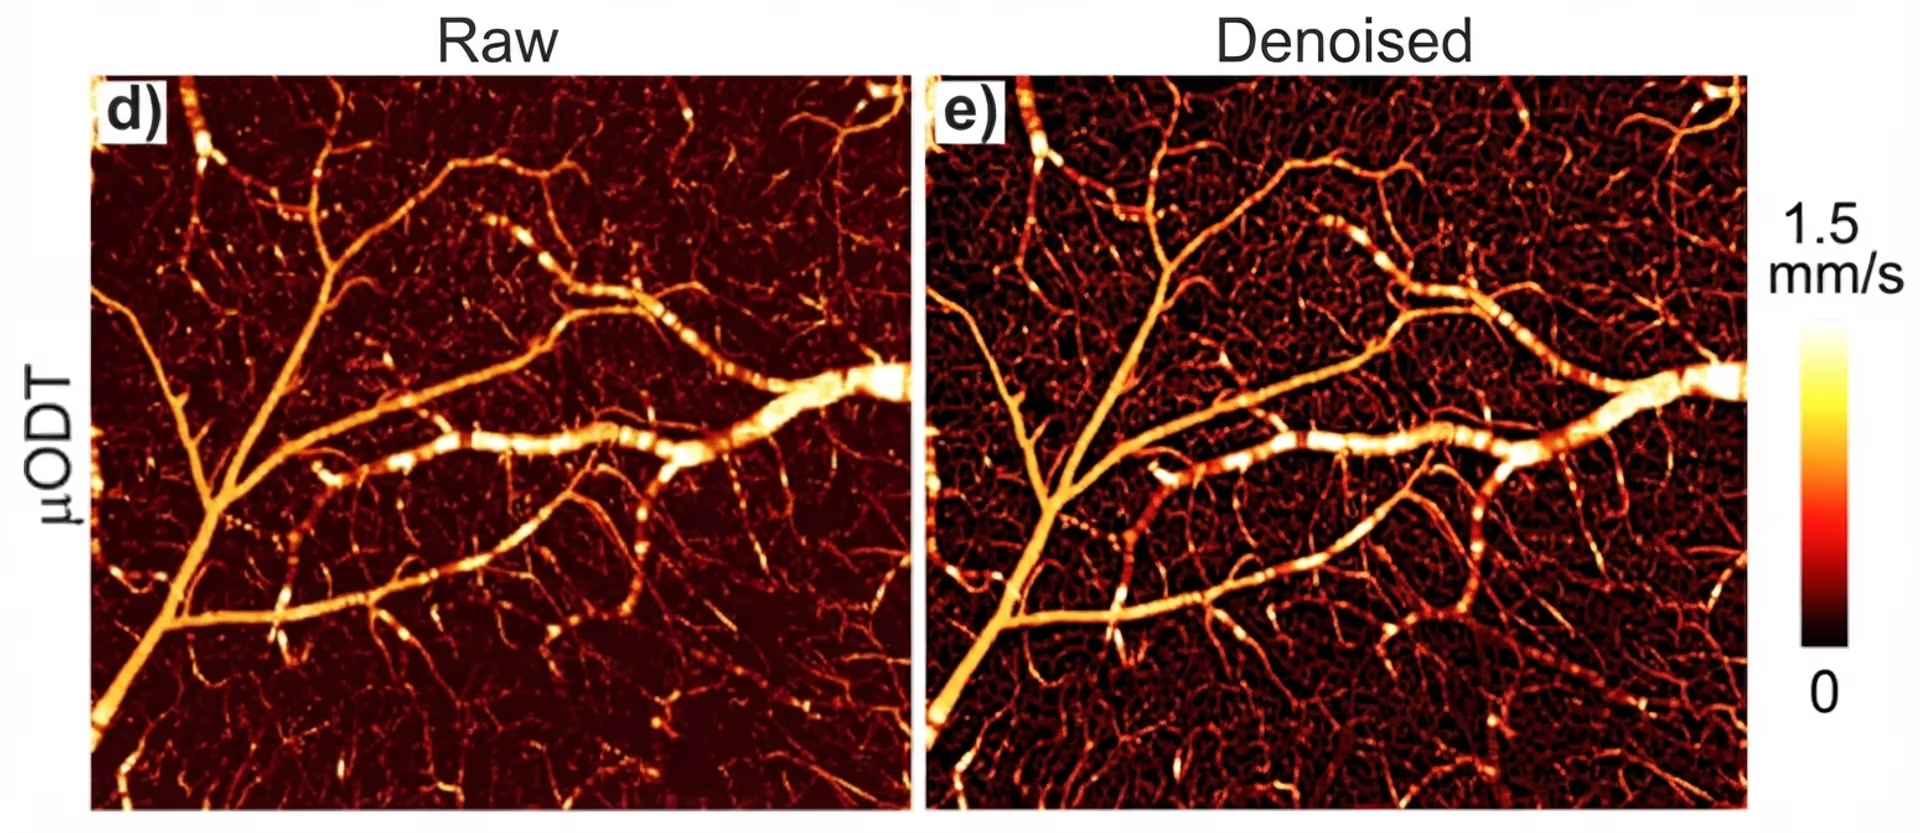
図2。元画像とノイズ除去後の画像。(出典)
モデルが画像内の安定した構造とランダムなノイズを分離できるように導く、特定の学習戦略によって実現されます。次に、このプロセスを効率化する中核技術とアルゴリズム、それぞれの手法がより鮮明で信頼性の高い画像の再構成にどのように役立つかを詳しく見ていきましょう。
ペア画像によるノイズ除去手法#
初期の自己教師ありノイズ除去手法の多くは、同じ画像のノイズを含む2つのバージョンを比較することで機能していました。画像を撮影または破損するたびにノイズはランダムに変化しますが、実際の構造は変わりません。そのため、こうした差異をモデルの学習信号として利用できます。
これらのアプローチは、トレーニング中にノイズを含む画像のペアを使う、または生成することから、一般にペア画像によるノイズ除去手法と呼ばれます。たとえば、Noise2Noiseは、Jaakko Lehtinenとその研究チームが提案した手法で、同じ場面を独立にノイズ付加した2枚の画像を使ってモデルを学習させます。2つの画像でノイズパターンが異なるため、モデルは実際の元画像を表す一貫した細部を特定するように学習します。
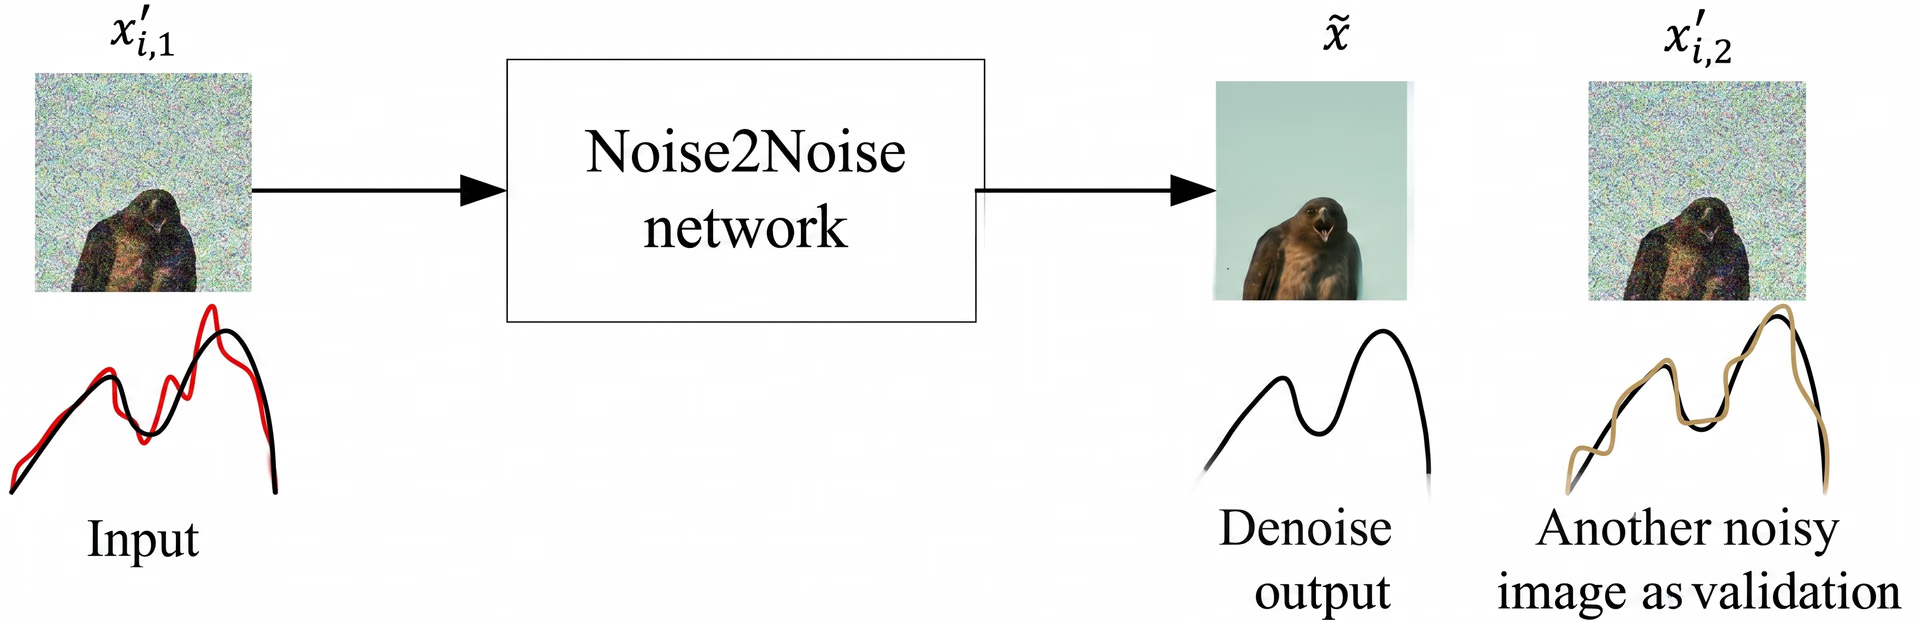
図3。Noise2Noiseの仕組み(出典)
時間をかけて学習することで、クリーンな参照画像を一度も見なくても、ネットワークはランダムなノイズを抑え、実際の構造を保持できるようになります。夜間の暗い通りを2枚撮影する簡単な例を考えてみましょう。
どちらの画像にも同じ建物、明かり、影が写っていますが、ざらついたノイズの位置は異なります。学習中にこの2枚のノイズの多い写真を比較することで、自己教師ありモデルは安定した視覚パターンとノイズによるものを見分ける方法を学び、最終的に、より鮮明な画像を再構成する能力を高めます。
ノイズ除去のためのブラインドスポットベース自己教師あり学習手法#
ペア方式では、同じ画像を異なる形で破損させた2つのバージョンを比較しますが、ブラインドスポット方式は異なるアプローチを取ります。選択したピクセルを隠してネットワークが破損した値を見られないようにすることで、1枚のノイズの多い画像からモデルを学習させます。
その後、モデルは周囲の情報だけを使って隠されたピクセルを予測する必要があります。基本となる考え方は、ノイズはランダムに変化しますが、画像の基礎となる構造は変化しないというものです。
モデルがピクセルのノイズを含む値をコピーできないようにすることで、ブラインドスポット方式は、近くの輪郭、テクスチャ、色のグラデーションなど、画像内の安定したパターンに基づいてピクセルの値を推論するよう促します。Alexander Krullとその研究チームが提案したNoise2Voidや、Joshua BatsonとLoïc Royerが開発したNoise2Selfなどの手法では、個々のピクセルまたは小さな近傍領域をマスクし、それらを再構成するようモデルを学習させることで、この原理を実現しています。
Noise2SameやPN2Vなどのより高度なアプローチでは、複数のマスクバージョン間で予測の一貫性を保つことや、ノイズ分布を明示的にモデル化して不確実性を推定することにより、頑健性を高めます。これらの手法はノイズの多い画像を1枚用意するだけでよいため、顕微鏡画像、天文学、生物医学画像、低照度撮影など、クリーンな画像やペア画像の撮影が実用的でない、または不可能な分野で特に有用です。
Transformerを活用したノイズ除去手法#
ペアワイズ方式とブラインドスポット方式の自己教師ありノイズ除去手法の多くは、畳み込みニューラルネットワーク(CNN)またはノイズ除去ネットワークに依存しています。CNNは、エッジ、テクスチャ、小さなディテールなどの局所的なパターンに注目するため、こうしたアプローチに適しています。
U-Netのようなアーキテクチャは、細かな特徴とマルチスケール情報を組み合わせるため、広く利用されています。ただし、CNNの処理範囲は主に限られた近傍領域であるため、画像の広い範囲にわたる重要な関係を捉えられないことがあります。
この制約に対処するため、Transformerを活用した最先端のノイズ除去手法が登場しました。近傍のピクセルだけを見るのではなく、これらの手法はアテンション機構を使用して、画像内の異なる部分が互いにどのように関連するかを把握します。
全体に適用するグローバルアテンションを使うモデルもあれば、計算量を抑えるためにウィンドウベースや階層型のアテンションを使うモデルもありますが、一般に、CNNだけでは捉えにくい長距離にわたる構造を捉えるように設計されています。この広い視野によって、画像全体の情報を必要とする反復テクスチャ、滑らかな表面、大きな物体をモデルが復元しやすくなります。
その他の画像ノイズ除去手法#
自己教師あり手法以外にも、ノイズの多い画像をきれいにする方法はいくつかあります。バイラテラルフィルタリング、ウェーブレットノイズ除去、非局所平均法などの従来手法では、重要な細部を保持しながらノイズを平滑化するために、シンプルな数学的ルールを使います。
一方、クリーン画像とノイズ画像のペアから学習する教師ありモデルや、より鮮明でリアルな結果を生成する敵対的生成ネットワーク(GAN)など、深層学習ベースのアプローチもあります。ただし、これらの手法では通常、学習により高品質な画像が必要です。
自己教師あり画像ノイズ除去の仕組みを段階的に解説#
さまざまな手法をいくつか見てきたところで、それぞれが独自のアーキテクチャを使っているため、仕組みもまったく異なるのではないかと思われるかもしれません。しかし、どの手法もデータの準備から始まり、モデルの評価で終わる、共通のパイプラインに従います。
続いて、自己教師あり画像ノイズ除去の全体的なプロセスを、手順を追って詳しく見ていきましょう。
ステップ1:前処理と正規化#
モデルがノイズの多い画像から学習を始める前に、まず、すべての画像の見た目が一貫するようにします。実際の写真には大きなばらつきがあります。
明るすぎる画像もあれば、暗すぎる画像もあり、色合いがわずかにずれている画像もあります。こうしたばらつきをそのままモデルに入力すると、ノイズの特徴を学習することに集中しにくくなります。
この処理に対応するため、各画像に正規化と基本的な前処理を適用します。これには、ピクセル値を標準的な範囲にスケーリングすること、輝度のばらつきを補正すること、画像をクロップしてリサイズすることなどが含まれます。重要なのは、モデルに一貫性があり、安定した比較可能な入力として使えるデータを与えることです。
ステップ2:自己教師あり学習信号の作成#
画像を正規化したら、次は、モデルがクリーンな画像を一度も見ずに学習できるようにする学習信号を作成します。自己教師ありノイズ除去手法では、モデルが入力されたノイズの多いピクセル値をそのままコピーできないようにします。
その代わり、予測できないノイズではなく、安定した構造を含む画像の周辺情報にモデルが依存する状況を作ります。手法によって具体的な方法は少し異なりますが、基本的な考え方は同じです。
一部の手法では、特定のピクセルを一時的に隠す、またはマスクすることで、モデルが周囲のピクセルから値を推測するようにします。別の手法では、同じノイズ画像を別の形で破損させたバージョンを生成し、入力とターゲットに互いに独立したノイズを含めます。いずれの場合も、ターゲット画像には意味のある構造情報が含まれますが、ネットワークは予測対象となるピクセルの元のノイズ値にアクセスできません。
ノイズはランダムに変化する一方で、画像の基礎となる構造は一貫しているため、この設定によってモデルは本来の構造を学習し、バージョンごとに異なるノイズを無視するようになります。
ステップ3:画像構造を復元するためのノイズ除去学習#
学習信号を用意すると、モデルのトレーニングを通じて、意味のある画像構造とノイズを分離する方法を学習できるようになります。マスクされたピクセルや再びノイズを加えたピクセルを予測するたびに、元の場所にあったノイズの値ではなく、周囲の情報を頼りにする必要があります。
多くの反復処理やエポックを経ることで、ネットワークは輪郭、テクスチャ、滑らかな表面など、画像内で安定しているパターンを認識できるようになります。また、ノイズに特徴的なランダムな変動を無視する方法も学習します。
たとえば、表面が非常にざらついて見える低照度写真を考えてみましょう。ノイズはピクセルごとに異なりますが、基礎となる表面は滑らかなままです。こうした領域の隠されたピクセルを繰り返し推測することで、モデルはノイズの下にある安定したパターンを特定し、より鮮明に再構成する能力を徐々に高めます。
モデルのトレーニングを通じて、ネットワークは画像構造の内部表現を学習します。これにより、入力に大きな破損があっても、一貫性のある細部を復元できます。
ステップ4:検証とノイズ低減の結果#
モデルが隠されたピクセルや再びノイズを加えたピクセルを予測できるようになった後、最後に、画像全体に対する性能を評価します。テスト時には、モデルはノイズの多い画像全体を受け取り、画像構造について学習した内容に基づいて、ノイズ除去後の画像全体を出力します。この処理の有効性を測定するため、出力をクリーンな参照画像または標準ベンチマークデータセットと比較します。
一般的に使われる指標は2つあります。PSNR(ピーク信号対雑音比)は、再構成結果がクリーンな正解画像にどれだけ近いかを測定し、SSIM(構造的類似性指標)は、輪郭やテクスチャなどの重要な特徴がどれだけ保持されているかを評価します。一般に、スコアが高いほど、ノイズ除去の精度と視覚的な信頼性が高いことを示します。
トレーニングとベンチマークに使われる画像データセット#
IEEEのジャーナル、CVPR、ICCV、ECCVなどのCVFカンファレンス、arXivで発表される自己教師ありノイズ除去の研究では、制御された条件と実用的な条件の両方でディープラーニング手法のモデル性能を評価するため、合成データセットと実世界のデータセットを組み合わせて使用することがよくあります。一方、合成データセットはクリーンな画像を基に人工的なノイズを加えるため、PSNRやSSIMなどの指標を用いて手法を簡単に比較できます。
ベンチマーク用に合成ノイズを追加してよく使用される、代表的なデータセットをいくつか紹介します。
- Kodak24: このデータセットには、ノイズ除去の結果を視覚的に比較する際によく使用される、高品質な自然風景の写真が含まれています。
- DIV2K: この高解像度データセットには、テクスチャの忠実度と全体的な復元品質の評価に使用される、多様で詳細な画像が含まれています。
一方、実世界のノイズ画像データセットには、低照度や高ISOなどの厳しい条件下でカメラセンサーが直接撮影した画像が含まれています。これらのデータセットでは、簡単にはシミュレーションできない複雑な非ガウス性ノイズにモデルが対応できるかを検証します。
代表的な実世界のノイズ画像データセットをいくつか紹介します。
- SIDD: このデータセットには、さまざまな照明環境でスマートフォンのセンサーを使って撮影した、実際のノイズ画像とクリーン画像のペアが含まれています。
- DND: このデータセットには、コンシューマー向けカメラで見られる現実的なセンサーノイズのパターンを捉えた、高ISOの写真が含まれています。
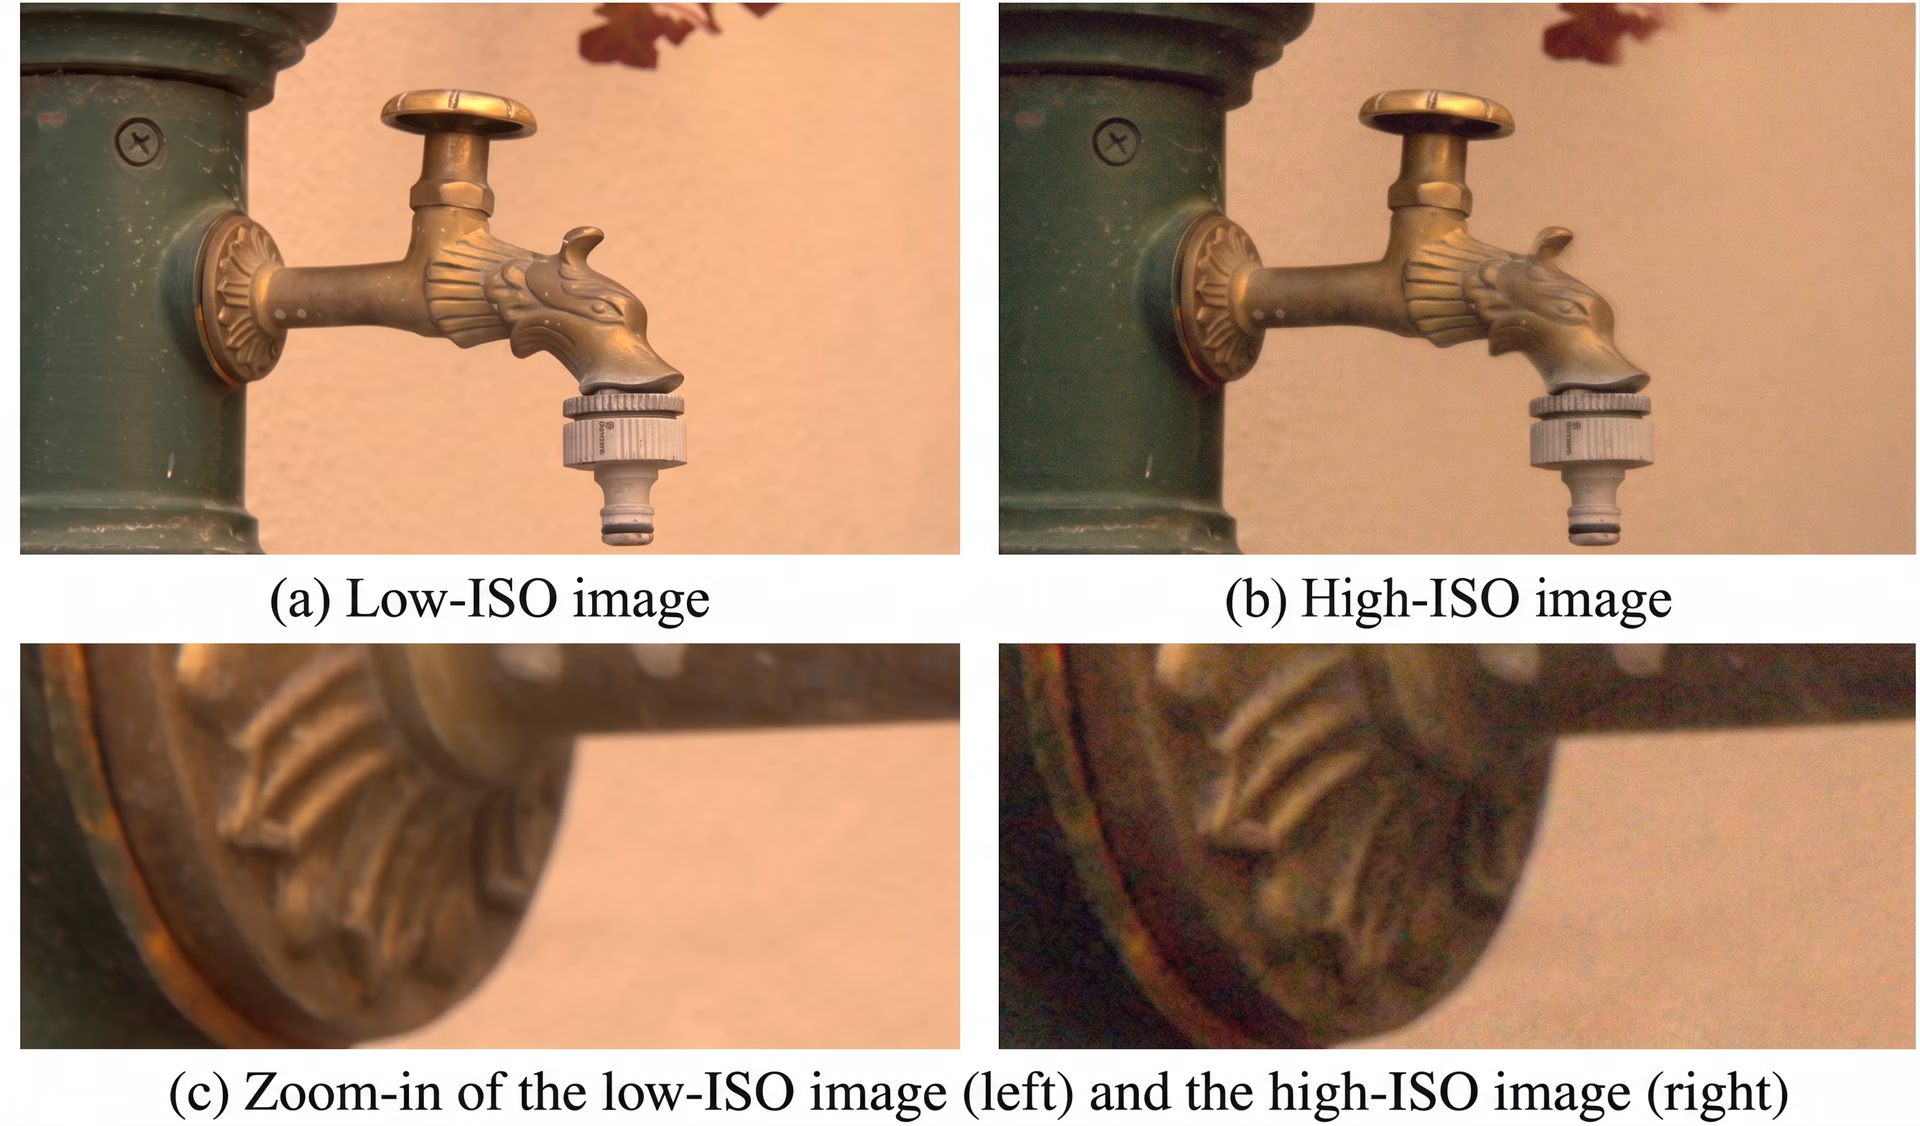
図4. DNDデータセットの例。(出典)
自己教師ありノイズ除去モデルのトレーニングで考慮すべき要素#
深層学習ベースの自己教師ありノイズ除去モデルをトレーニングする場合、考慮すべき要素と制約をいくつか紹介します。
- ノイズ分布を一致させる: トレーニングに使うノイズ画像には、実際の利用時にモデルが遭遇するノイズを反映させる必要があります。ノイズが一致していないと、汎化性能が低下します。
- トレーニングデータの多様性を確保する: データのばらつきが限られていると、複雑なテクスチャで過学習や過度な平滑化が起こることがあります。
- ノイズの種類による制約に注意する: 自己教師あり手法は、構造化ノイズ、相関ノイズ、またはランダムでないノイズへの対応がより困難です。
- デバイスやセンサーをまたいでテストする: ノイズ除去の性能は、カメラや撮像システムによって大きく異なる場合があります。
重要なポイント#
自己教師ありノイズ除去は、すでにあるノイズデータだけを使って画像をきれいにする実用的な方法を、AI愛好家に提供します。ノイズの下にある実際の構造を認識するように学習することで、こうした手法は重要な視覚的詳細を復元できます。ノイズ除去技術が向上し続けるにつれ、日常的な環境で幅広いコンピュータービジョンタスクの信頼性を高める可能性があります。
成長を続けるコミュニティにぜひご参加ください。GitHubリポジトリでAIについてさらに詳しく学べます。コンピュータービジョンソリューションの構築をお考えの場合は、ライセンスオプションをご覧ください。小売業におけるコンピュータービジョンのメリットを探り、製造業におけるAIがどのように変化をもたらしているかをご確認ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









