単眼深度推定とは?概要
単眼深度推定の仕組み、センサーを使った深度推定手法との違い、ビジョンシステムでスケーラブルな3D認識を可能にする方法をご紹介します。
 Abirami Vina18 分で読めます
自動運転車は、周囲で起きていることを理解し、安全に走行できるよう設計されています。そのためには、歩行者や他の車両などの物体を認識するだけでは不十分です。
さらに、適切に対応するために、それらの物体までの距離を把握する必要があります。しかし、機械に距離感を持たせるのは簡単ではありません。人間とは異なり、機械は画像から自然に奥行きを認識できないため、その方法を明示的に学習させる必要があります。
その理由の一つは、ほとんどのカメラが世界を平面的な2次元画像として捉えることです。こうした画像を、現実世界の奥行きや3D構造を反映する情報に変換するのは困難です。特に、システムを日常的な環境で安定して動作させる必要がある場合は、なおさらです。
興味深いことに、視覚データの解釈と理解に焦点を当てたAIの一分野であるコンピュータービジョンにより、機械は画像から世界をよりよく理解できるようになります。たとえば、単眼深度推定は、単一のカメラ画像のみを使って物体までの距離を推定するコンピュータービジョン技術です。
物体の大きさ、遠近感、テクスチャ、陰影などの視覚的な手がかりを学習することで、これらのモデルはLiDAR(光検出と測距)やステレオカメラなどの追加センサーに頼らずに深度を推定できます。この記事では、単眼深度推定とは何か、どのように機能するのか、実世界でどのように応用されているのかを解説します。
単眼深度推定の概要#
単眼深度推定を使うと、機械は単一の画像だけから、物体までの距離を理解できます。単一のカメラだけを使うため、コストが低く、ハードウェア要件がシンプルであるなど、いくつかの利点があります。
たとえば、単一のカメラで動作する手頃な価格の家庭用ロボットに利用できます。1枚の画像からでも、ロボットシステムは近くにある壁と遠くにあるドアを識別し、空間全体の奥行きを推定できます。
多くの場合、単一の画像には正確なスケールを把握するための情報が含まれていないため、単眼深度推定では通常、相対的な奥行きを扱います。つまり、正確な距離がわからなくても、どの物体が近く、どの物体が遠いかを判断できます。
LiDARなどのセンサーで測定した深度情報のように、正解となる距離や絶対深度を含むデータでモデルをトレーニングすると、メートルなどの実世界の単位で距離を予測できるようになります。このような参照データがなければ、モデルは相対的な奥行きを推定できますが、絶対距離を安定して推定することはできません。
単眼深度推定の出力は通常、深度マップです。深度マップは、各ピクセルがシーン内のその部分までの距離を表す画像です。深度マップにより、ビジョンシステムは環境の3D構造を基本的に把握できます。
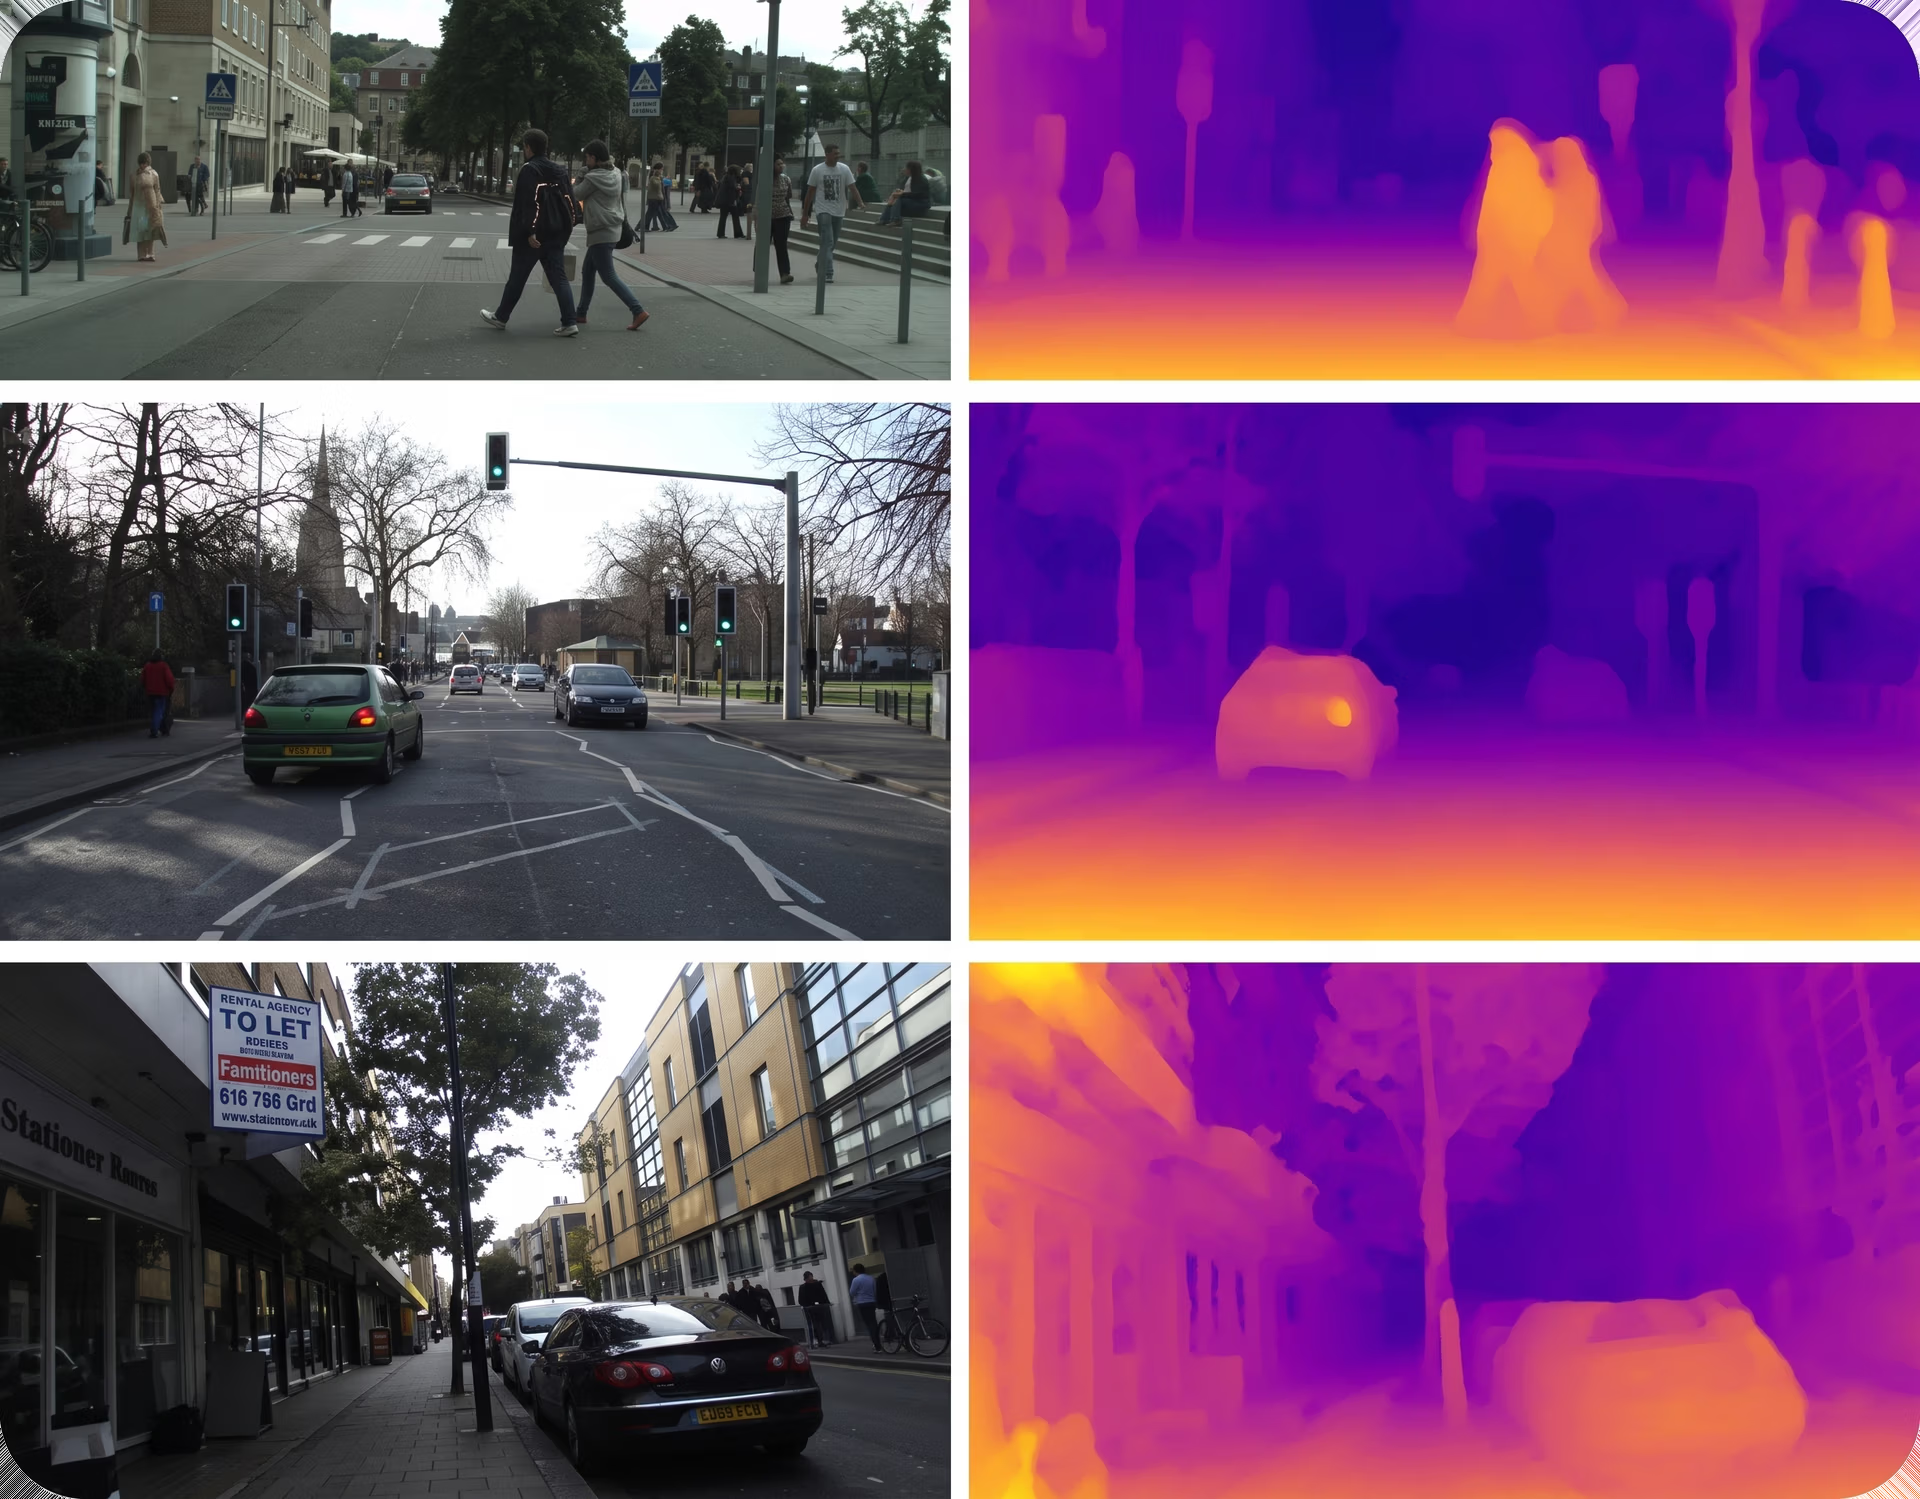
図1. 単眼深度推定で生成した深度マップの予測例(出典)
センサーから画像まで:深度の推定#
深度推定には、利用可能なセンサー、ハードウェアの制約、必要な精度に応じて、いくつかのアプローチがあります。従来の手法では、距離を直接測定するために複数の視点や専用センサーを使用することがよくあります。
一般的なアプローチの一つがステレオビジョンです。これは、わずかに異なる視点から撮影した同期画像を2枚比較して深度を推定します。2枚の画像で対応する点の差を測定することで、システムは物体までの距離を推定できます。
もう一つのアプローチはRGB-D(赤、緑、青、深度)システムです。アクティブ深度センサーを使い、各ピクセルの距離を直接測定します。こうしたシステムは、管理された環境で正確な深度情報を提供できますが、追加のハードウェアが必要です。
一方、LiDARベースの手法では、レーザーパルスを使ってシーンの高精度な3次元表現を生成します。LiDARセンサーは非常に高精度ですが、多くの場合高価で、ハードウェアの複雑さも大幅に増します。
これに対して、単眼深度推定では、単一のRGB画像だけから奥行きを推定します。複数のカメラや専用センサーに依存しないため、大規模なデプロイが容易で、コストやハードウェアリソースに制約がある場合に適しています。
単一画像から奥行きを学習する#
単一画像から奥行きを推定する際、単眼深度モデルは、人間が直感的に距離を判断するために使う視覚的な手がかりを認識するよう学習します。遠近法を示す線、物体の大きさ、テクスチャの密度、物体の重なり、陰影などがその手がかりであり、いずれも物体がカメラからどれほど離れているかを示します。
こうした手がかりが組み合わさり、奥行きの感覚が生まれます。小さく見える物体や一部が隠れている物体は遠くにあることが多く、細部がはっきり見えたり大きく見えたりするものは、通常、近くにあることを示します。
こうしたパターンを学習するため、単眼深度モデルは大規模な画像データセットでトレーニングされます。多くの場合、LiDARやステレオシステムなど、別の情報源から得た深度情報が画像に付与されています。トレーニング中にモデルは、視覚的な手がかりと奥行きの関係を学習し、推論時に単一画像から距離を推定できるようになります。
多様なトレーニングデータを使うことで、最新のビジョンモデルは、屋内外のシーンを含む幅広い環境に学習した知識を汎化させ、未知の視点にも対応できます。
さまざまな単眼深度推定手法#
次に、単一画像から奥行きを推定するために使われる主なアプローチと、これらの手法がどのように進化してきたかを見ていきます。
古典的な手法と幾何学ベースの手法#
初期の深度推定手法は、カメラ幾何学に基づく単純な視覚的ルールに依存していました。遠近法、物体の大きさ、ある物体が別の物体を遮っているかといった手がかりを使って、距離を推定していました。
たとえば、似た2つの物体が異なる大きさで見える場合、小さいほうが遠くにあると推定していました。照明、カメラの位置、シーンのレイアウトなどの条件が一定に保たれた管理環境では、こうしたアプローチは比較的うまく機能しました。
しかし、実世界のシーンでは、こうした前提が成り立たないことがよくあります。照明の変化、視点の変化、シーンの複雑化によって深度の推定が不安定になり、制御されていない環境では古典的な手法の有効性が限られます。
初期の機械学習アプローチ#
初期の機械学習手法では、データからパターンを直接学習することで、深度推定の柔軟性が高まりました。固定された幾何学的ルールだけに頼るのではなく、エッジ、テクスチャ、色の変化などの手がかりをもとに、視覚情報と距離の関係を学習することを目指しました。深度予測を回帰問題として扱っていたのです。
特徴量の選択は、このプロセスの重要な要素でした。エンジニアは、どの視覚信号を抽出し、どのように表現するかを決める必要があり、モデルの性能はそうした選択に大きく左右されました。
このアプローチは従来の手法より優れていましたが、それでも限界がありました。選択した特徴量に重要なコンテキストが欠けていると、深度予測の精度が低下しました。シーンがより複雑で多様になるにつれて、こうしたモデルでは安定した結果を出すのが難しくなりました。
ディープラーニングアルゴリズム#
最新の単眼深度推定システムの多くはディープラーニングを使用しています。ディープラーニングとは、データから複雑なパターンを学習できる、多数の層を持つニューラルネットワークを指します。こうしたモデルは、画像から直接深度を予測し、深度マップを生成するよう学習します。
多くのアプローチは、エッジや形状などのパターンを検出して画像を処理するニューラルネットワークである畳み込みニューラルネットワーク(CNN)を使って構築されています。こうしたモデルでは、エンコーダー・デコーダー構成がよく使われます。エンコーダーが画像から視覚的特徴を抽出し、デコーダーがその特徴を深度マップに変換します。画像を複数のスケールで処理すると、明確な物体の境界を捉えながら、シーン全体のレイアウトも把握できます。
より新しいモデルでは、画像の異なる領域間の関係を理解することに重点が置かれています。TransformerベースのモデルやVision Transformer(ViT)モデルはアテンション機構を使用し、画像内のどの領域が最も重要かを特定したり、離れた領域同士を関連付けたりできます。これにより、シーン全体の奥行きをより一貫して理解できます。
両方の考え方を組み合わせたシステムもあります。ハイブリッドCNN–Transformerモデルでは、CNNが細かな局所情報を捉え、Transformerがシーン全体のコンテキストをモデル化します。精度が向上することが多い一方で、追加のメモリや処理能力など、より多くの計算リソースが通常必要になります。
ビジョンAIシステムにおける奥行き理解の重要性#
単眼深度推定について学ぶ中で、ビジョンベースのAIシステムにおいて奥行きの理解がなぜそれほど重要なのか、疑問に思うかもしれません。
システムが物体や表面までの距離を推定できると、シーンの配置や、さまざまな要素同士の関係をよりよく理解できます。こうした空間認識は、特に自動運転のような実世界のアプリケーションで、信頼性の高い判断を行うために不可欠です。
深度情報は、他のコンピュータービジョンタスクにも価値のあるコンテキストを加えます。たとえば、Ultralytics YOLO26のようなモデルが対応する物体検出によって、システムはシーンに何があるかを把握できます。一方、深度情報を使うと、カメラや他の物体に対して、それらの物体がどこにあるかを把握できます。
これらの機能を組み合わせることで、3Dマップの作成、複雑な環境でのナビゲーション、シーン全体の理解など、幅広いビジョンAIアプリケーションが可能になります。
ロボットや自動運転車は、安全な移動、障害物の回避、リアルタイムでの変化への対応に、この情報を活用します。たとえば、Teslaのビジョンのみを用いた運転方式では、LiDARではなく、カメラ画像と深度推定を組み合わせて、物体までの距離や道路上での位置を把握します。
単眼深度推定モデルの仕組み#
モデルのアーキテクチャはさまざまですが、ほとんどの単眼深度推定モデルは、単一画像を深度マップに変換するために同様のプロセスをたどります。主な手順を簡単に見てみましょう。
- 入力と前処理:ワークフローは入力画像から始まります。モデルに入力する前に、通常、元の画像をリサイズして正規化し、テンソルに変換します。テンソルは、ニューラルネットワークが画像データを効率よく処理するために使う形式です。
- 特徴抽出:エンコーダーネットワークが画像を解析し、意味のある視覚的特徴を抽出します。これらの特徴には、テクスチャ、物体の境界、シーン全体のレイアウトなどの情報が含まれます。ほとんどのモデルは複数のスケールで処理し、細部と全体構造の両方を理解できるようにします。
- 深度の推論:モデルは抽出した特徴を使い、局所的な詳細と全体的なコンテキストを組み合わせて、シーン内の空間的な関係を推論します。この段階で、画像内のどの領域がカメラに近く、どの領域が遠いかを学習します。
- 深度マップの生成:次に、デコーダーがこの情報を密な深度マップに変換します。画像内の各ピクセルに深度値が割り当てられます。精度と一貫性を高めるため、異なるスケールの予測を組み合わせることもよくあります。
単眼深度推定モデルのトレーニング方法#
ここまでに説明したプロセスでは、トレーニング済みまたは事前トレーニング済みのモデルがすでにあることを前提としています。では、単眼深度推定モデルのトレーニングは実際にどのように行うのでしょうか。
トレーニングは、ネットワークで効率よく処理できるように画像データを準備することから始まります。入力画像を一定のスケールにリサイズして正規化し、モデルに入力して、各ピクセルの距離を推定する深度マップを予測します。
次に、予測された深度マップを損失関数を使って参照深度データと比較します。損失関数は、モデルの予測が正解の深度からどれだけ離れているかを測定します。この損失値はモデルの現在の誤差を表し、改善のための信号となります。
オプティマイザーはこの信号を使い、モデル内部の重みを調整してモデルを更新します。そのために、損失が各モデルパラメーターに対してどのように変化するかを示す勾配を計算し、エポック(トレーニングデータセット全体を一巡する処理)を複数回繰り返して更新を適用します。
この反復的な教師ありトレーニングプロセスは、各更新ステップの大きさを制御する学習率や、一度に処理する画像の数を決めるバッチサイズなどのハイパーパラメーターによって制御されます。トレーニングでは大量の数学的演算が行われるため、通常は並列計算に優れたグラフィックス処理装置(GPU)を使って高速化します。
トレーニングが完了すると、トレーニングには使用していない画像で構成された検証セットを使い、標準的な評価指標でモデルを評価します。この評価により、モデルが新しいデータにどの程度汎化できるかを測定できます。
トレーニング済みのモデルは、新しいシナリオで再利用したり、ファインチューニングしたりできます。全体として、このトレーニングプロセスによって単眼深度推定モデルは一貫した深度推定を生成できるようになり、3D再構築や実世界へのデプロイなどの下流タスクに不可欠な機能を提供します。
最先端モデルと研究トレンド#
モデルが小さな視覚的詳細だけでなく、シーン全体をよりよく理解できるようになるにつれて、単眼深度推定は急速に進歩しています。初期のアプローチでは、特に複雑な環境において、むらのある深度マップが生成されることがよくありました。
arXivで最近公開された研究に見られるように、新しいモデルはグローバルコンテキストをより重視し、安定して現実的に見える深度予測を実現しています。よく知られたモデルであるMiDaSやDPTは、多様な高解像度データセットから深度を学習し、多くのシーンにうまく汎化することで、この変化を後押ししました。
ZoeDepthやDepth Anything V2などのより新しいモデルは、この研究を基盤に、幅広い条件で高い性能を維持しながらスケールの一貫性を高めています。この種の進歩は、屋外と屋内の両方のシーンを含む、KITTIやNYU Depth V2などの一般的なベンチマークデータセットを使って評価されることがよくあります。
もう一つの明確な傾向は、精度と実用性のバランスです。小型モデルは速度を重視して最適化され、エッジデバイスやモバイルデバイス上でリアルタイムに実行できます。一方、大型モデルはより高い解像度と長距離の深度推定精度を重視します。たとえば、Ultralytics YOLO26深度モデルには、リアルタイムのエッジ利用に適した軽量なYOLO26n-depthから、より大型で高精度なYOLO26x-depthまであります。
単眼深度推定の活用例#
次に、単一画像からシーンの3D構造を推論するために、単眼深度推定がどのように使われているかを示す実例を見ていきましょう。
いずれのケースでも、深度情報は視覚的な手がかりから推定されたものであり、正確な測定値ではないことを忘れないようにすることが重要です。そのため、単眼深度推定は相対的な配置や空間的な関係を理解するのに役立ちますが、LiDARやステレオシステムなど、距離を正確に測定するために設計されたセンサーの代わりにはなりません。
ドローンによる地形マッピングとナビゲーション#
ドローンは、森林、建設現場、災害地域、人口密度の高い都市部など、GPS信号が不安定な環境で動作することがよくあります。こうした環境で安全に飛行するには、周囲の地形を理解し、障害物までの距離を把握する必要があります。従来はLiDARやステレオカメラなどのセンサーを追加するのが一般的でしたが、これにより重量、消費電力、総コストが増加します。
単眼深度推定は、よりシンプルな代替手段です。単一のRGBカメラだけを使い、ドローンは画像から奥行きを推定し、周囲の環境の基本的な3D情報を構築できます。これにより、建物、木、地形の急な変化などの障害物を検出し、飛行経路をリアルタイムで調整できます。
こうした深度推定は、障害物回避、高度制御、安全な着陸など、重要なナビゲーションタスクを支えます。その結果、軽量なドローンは、専用の深度センサーに頼らずにマッピング、点検、ナビゲーションのタスクを実行できます。
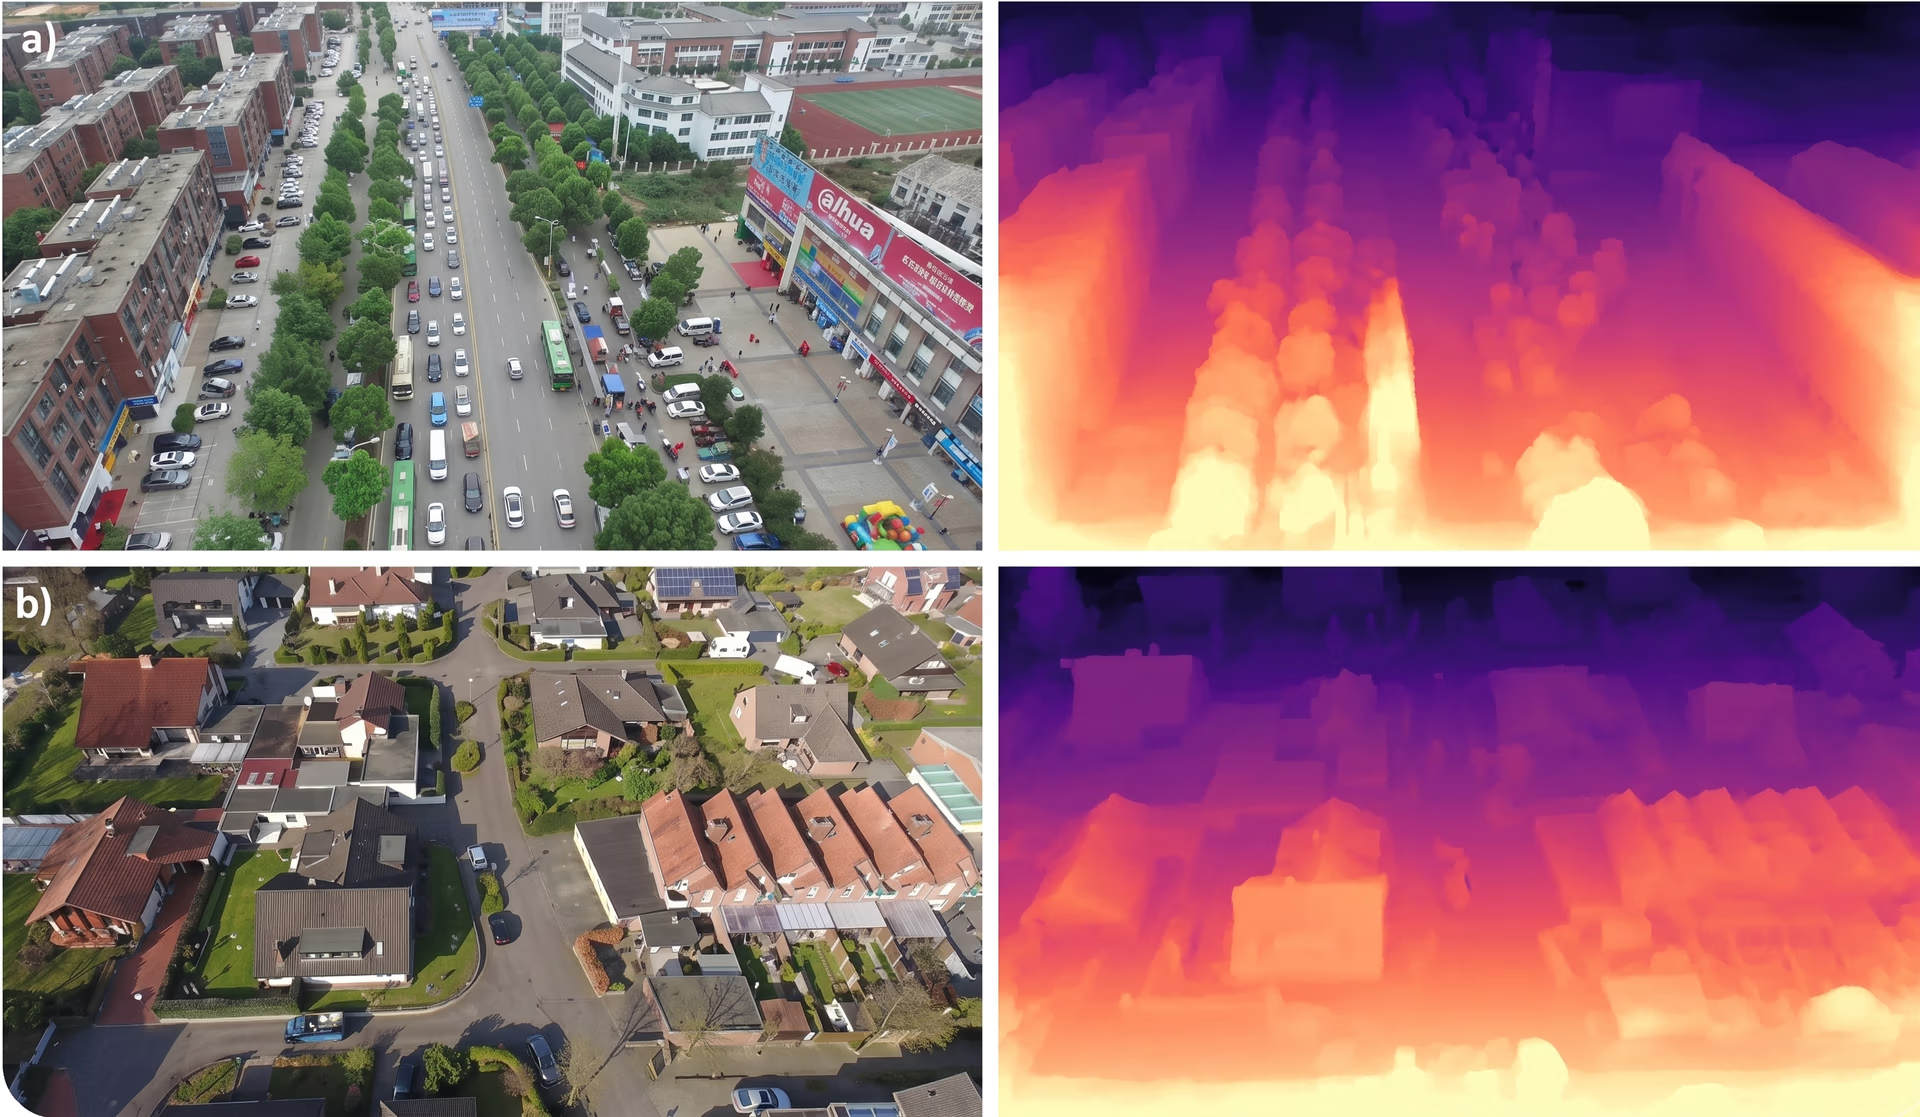
図2. 単眼深度推定はドローン画像の分析に使用できます(出典)
自動運転レース車両の死角を補完する#
自動運転車は通常、レーザーパルスで距離を測定し、道路の3Dビューを構築するLiDARセンサーに大きく依存しています。LiDARは非常に高精度ですが、道路の急な頂部や急斜面、遮蔽、車両の急なピッチ変化などに弱く、深度データがまばらになったり、欠落したりすることがあります。
単眼深度推定は、LiDARデータが不完全な場合でも、単一のRGB画像から高密度な深度情報を提供し、こうした不足を補うのに役立ちます。自動運転車が高速で丘の頂上に近づいている状況を考えてみましょう。LiDARのレーザーが頂上の先の道路まで届いてしまい、その先に何があるのか不確かになることがあります。
一方、カメラベースの深度推定では、遠近法やテクスチャなどの視覚的手がかりから道路の形状を推測できるため、LiDARデータが安定するまで車両の信頼性の高い認識を維持するのに役立ちます。LiDARと単眼深度推定を組み合わせることで、困難な走行条件下でも、より安定した認識と安全な制御が可能になります。
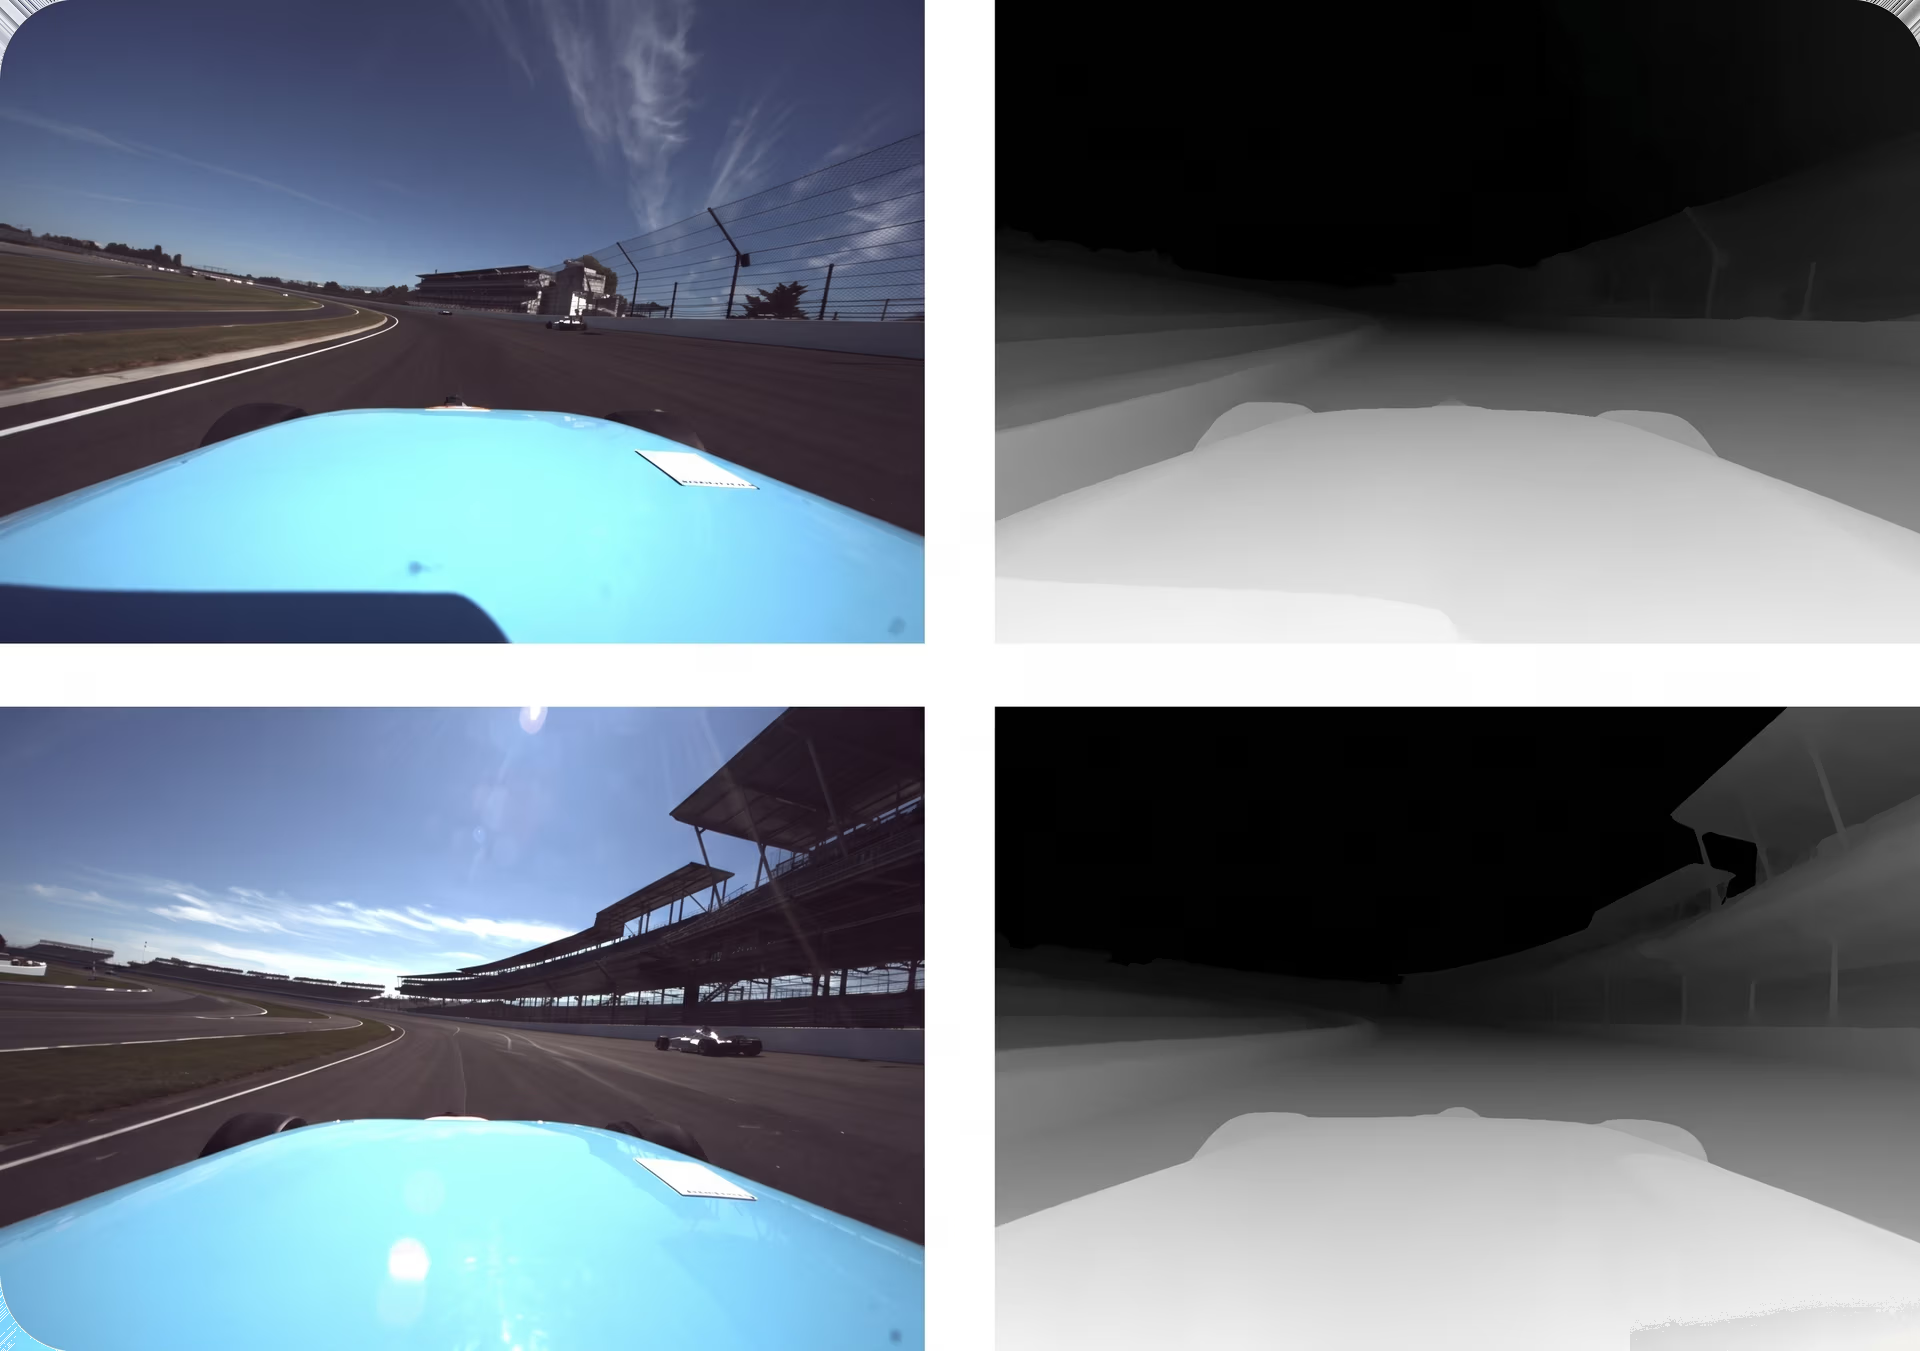
図3. 自律走行レースで単眼深度推定を活用する様子の可視化(出典)
ロボットのナビゲーションと障害物回避#
ロボットは、詳細な地図が利用できず、状況が絶えず変化する場所で稼働することがよくあります。安全に移動するには、周囲にどれだけの空間があるか、障害物がどこにあるかを正確に把握する必要があります。
単眼深度推定は、高価で重いハードウェアに頼らず、単一のRGBカメラを使ってこうした空間認識を実現できます。スケールや遠近法などの視覚的手がかりを学習することで、深度推定モデルは周囲の高密度な深度マップを生成できます。これにより、ロボットは表面や物体までの距離を明確に把握できます。
特に、深度情報を物体検出やセマンティックセグメンテーションなどのコンピュータービジョンタスクと組み合わせると、ロボットは環境をより包括的に把握できます。物体を特定し、その距離を理解したうえで、安全に移動できる場所を判断できます。これにより、障害物回避、走行可能領域の検出、リアルタイムの経路計画が可能になります。
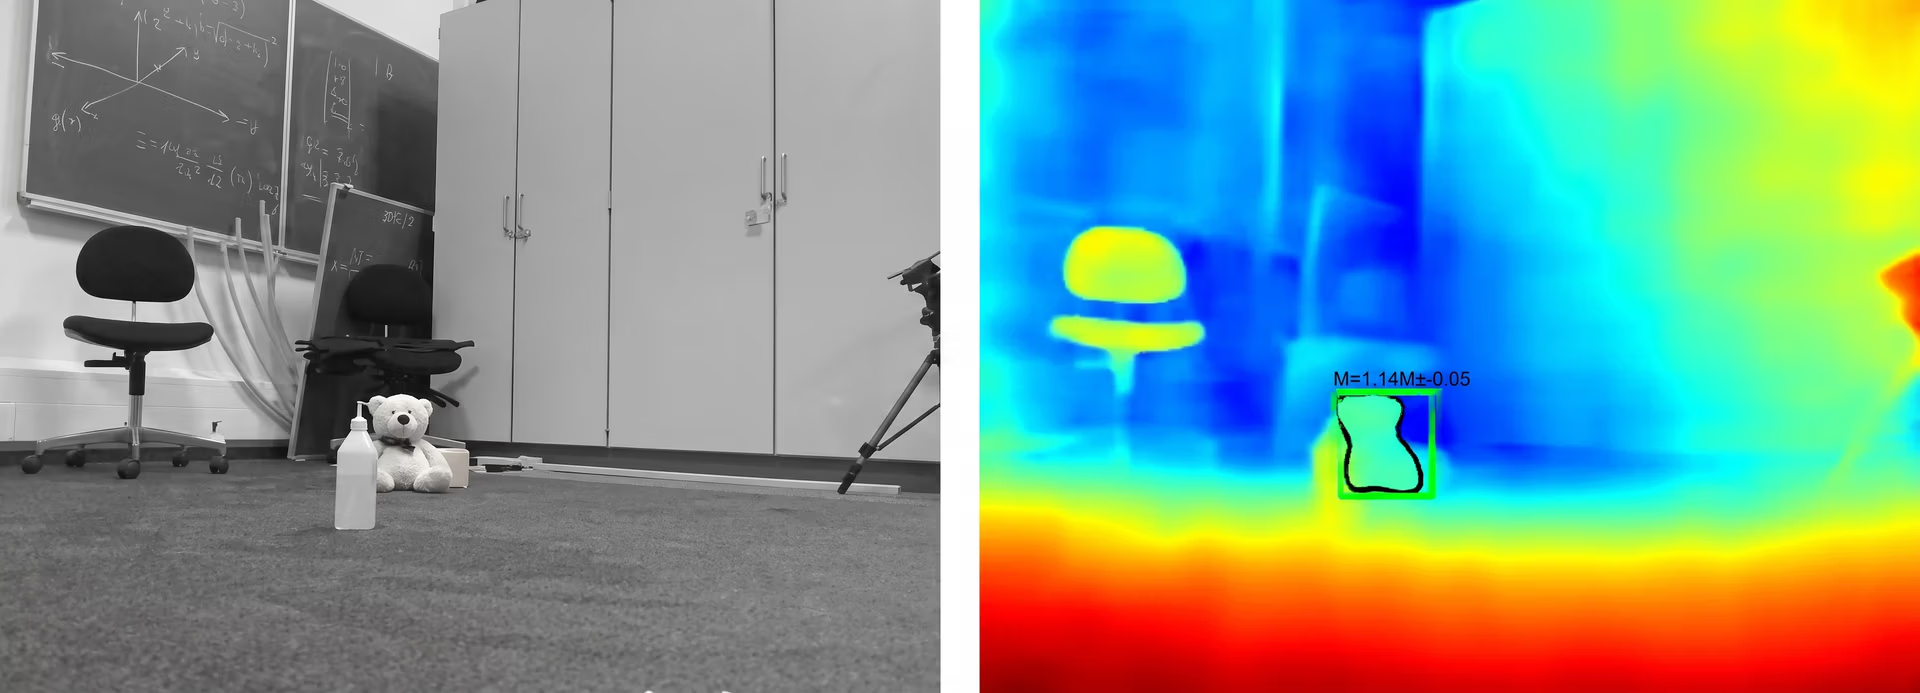
図4. 単眼深度推定と物体検出を使った物体の検出(出典)
単眼深度推定のメリットとデメリット#
単眼深度推定を利用する主なメリットをいくつか紹介します。
- 軽量で電力効率に優れる: カメラを1台だけ使うことで、システムの重量と消費電力を抑えられます。これは、モバイルロボット、ドローン、組み込みシステムにおいて特に重要です。
- センサーフュージョンとの相性がよい: 単眼深度は、LiDARやレーダーなどの他のセンサーを補完し、データの欠落を埋めたり、冗長性を確保したりできます。
- さまざまな環境で動作: 同じカメラベースのアプローチを、ハードウェアを変更せずに、屋内、屋外、さまざまなプラットフォームで使用できます。
単眼深度推定には明確なメリットがありますが、考慮すべき制約もあります。
- アクティブセンサーより精度が低い: 急速に向上しているものの、単眼深度推定は一般に、制御された条件下でのLiDARや構造化光センサーの絶対精度には及びません。
- 照明条件への感度: 低照度環境、強い影、グレア、テクスチャの乏しいシーンでは、性能が低下する場合があります。
- 汎化の課題: ある環境で学習したモデルは、適応やファインチューニングを行わないと、未知のドメインに常に安定して適用できるとは限りません。
単眼深度推定に頼るべきでない場合#
単眼深度推定は興味深い研究分野ですが、実際に利用できる場面と利用できない場面を理解することが重要です。出力される距離は、現実世界で測定した正確な値ではなく、画像内でモデルが捉えた情報に基づく推定値です。
そのため、照明、シーンの複雑さ、モデルの学習データとシーンの類似度などの要因によって、結果の品質が変わることがあります。単眼深度推定は、何が近く、何が遠くにあるかを判断するのは得意ですが、正確な距離が必要な場合には信頼できません。
安全性が重要なシステム、産業検査、物体と非常に精密にやり取りする必要があるロボットなど、精度が特に重要な状況では、深度を直接測定する必要があります。LiDAR、レーダー、ステレオカメラ、構造化光システムなどのセンサーは、そのために設計されており、より信頼性の高い距離情報を提供します。
単眼深度推定は、視覚的に難しい条件でも性能が低下することがあります。照明不足、強い影、反射面や透明面、霧、煙、視覚的なテクスチャが非常に乏しいシーンはいずれも、深度推定の信頼性を損なう可能性があります。長距離の深度推定も、専用センサーのほうが一般に適している状況の一つです。
実環境のソリューションでは、単眼深度推定は単独のソリューションではなく、補助ツールとして使うのが最適です。有用な空間コンテキストを加え、他のセンサーに制約がある場合に不足を補い、シーン全体の理解を向上させることができます。ただし、精度、安全性、厳格な信頼性要件が重要な場合に、深度情報の唯一の情報源にすべきではありません。
重要なポイント#
単眼深度推定は、単一のカメラ画像だけを使って物体までの距離を機械が推定できるようにするコンピュータービジョン技術です。遠近法、物体の大きさ、テクスチャ、陰影などの視覚的手がかりを学習することで、これらのAIモデルはLiDARやステレオカメラなどのセンサーに頼らずにシーンの3D構造を推測できます。このため、単眼深度推定は、自動運転、ロボティクス、3Dシーン理解などの用途に適した、費用対効果が高くスケーラブルなアプローチです。
ビジョンAIについてさらに詳しく知るには、GitHubリポジトリをご覧いただき、コミュニティにご参加ください。ロボティクスにおけるAIと製造業におけるコンピュータービジョンについては、ソリューションページをご覧ください。コンピュータービジョンを今すぐ始めるには、ライセンスの選択肢をご確認ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









