データセット蒸留とは?簡単な概要
大規模なデータセットを最適化された少数の合成サンプルに置き換えることで、データセット蒸留がモデルの学習を高速化し、計算コストを削減する仕組みをご紹介します。
 Abirami Vina16 分で読めます
モデルのトレーニングは、データサイエンティストの仕事の中で最も時間がかかる部分に思えるかもしれません。しかし、実際には作業時間の多く、しばしば60~80%が、データの収集、クリーニング、モデリングに向けた整理といったデータの準備に費やされています。データセットが大きくなるにつれて準備時間も増え、実験の進行が遅くなり、反復作業も難しくなります。
この課題に対処するため、研究者は長年にわたりトレーニングを効率化する方法を模索してきました。合成データ、データセット圧縮、より優れた最適化手法などは、大規模データセットを扱うコストや負担を減らし、機械学習のワークフローを高速化することを目指しています。
ここから生まれる重要な問いは、データセットを大幅に縮小しながら、完全なデータでモデルをトレーニングした場合と同じ性能を達成できるかどうかです。データセット蒸留は、その有望な解決策の1つです。
データセット蒸留では、大規模なトレーニングデータセットをコンパクトな形にしながら、モデルが効果的に学習するために必要な重要なパターンを保持します。これにより、トレーニングの高速化、計算リソースの削減、実験の効率化が可能になります。モデル用の学習カンニングペーパーのようなものと考えることができます。つまり、完全なデータセットと同じ基本パターンを教えるために設計された、少量の合成データの例です。
この記事では、データセット蒸留の仕組みと、実世界のアプリケーションにおけるスケーラブルな機械学習およびディープラーニングをどのように支援するかを紹介します。
データセット蒸留について#
データセット蒸留とは、大規模なトレーニングデータセットを、元のデータセットとほぼ同じ情報をモデルに学習させられる、はるかに小さなデータセットに圧縮するプロセスです。目標はデータセット全体に含まれる重要なパターンを捉えることにあるため、多くの研究者はこのプロセスをデータセット凝縮とも呼んでいます。
蒸留されたデータセットは、ランダムに生成した合成データや、実画像から単純に小さなサブセットを選ぶ方法とは異なります。ランダムな偽データセットでも、元のデータセットを切り詰めたものでもありません。
その代わり、最も重要なパターンを捉えるよう意図的に最適化されています。このプロセスでは、ピクセルや特徴が1つずつ調整・最適化されるため、蒸留データでトレーニングしたニューラルネットワークは、データセット全体でトレーニングした場合とほぼ同じように学習します。
この考え方は、2018年にTongzhou Wang、Jun-Yan Zhu、Antonio Torralba、Alexei A. Efrosが発表したarXiv論文で初めて示されました。初期のテストでは、MNISTやCIFAR-10のような単純なデータセットが使われ、少数の蒸留サンプルで数千枚の実画像を代替できることを簡単に示せました。
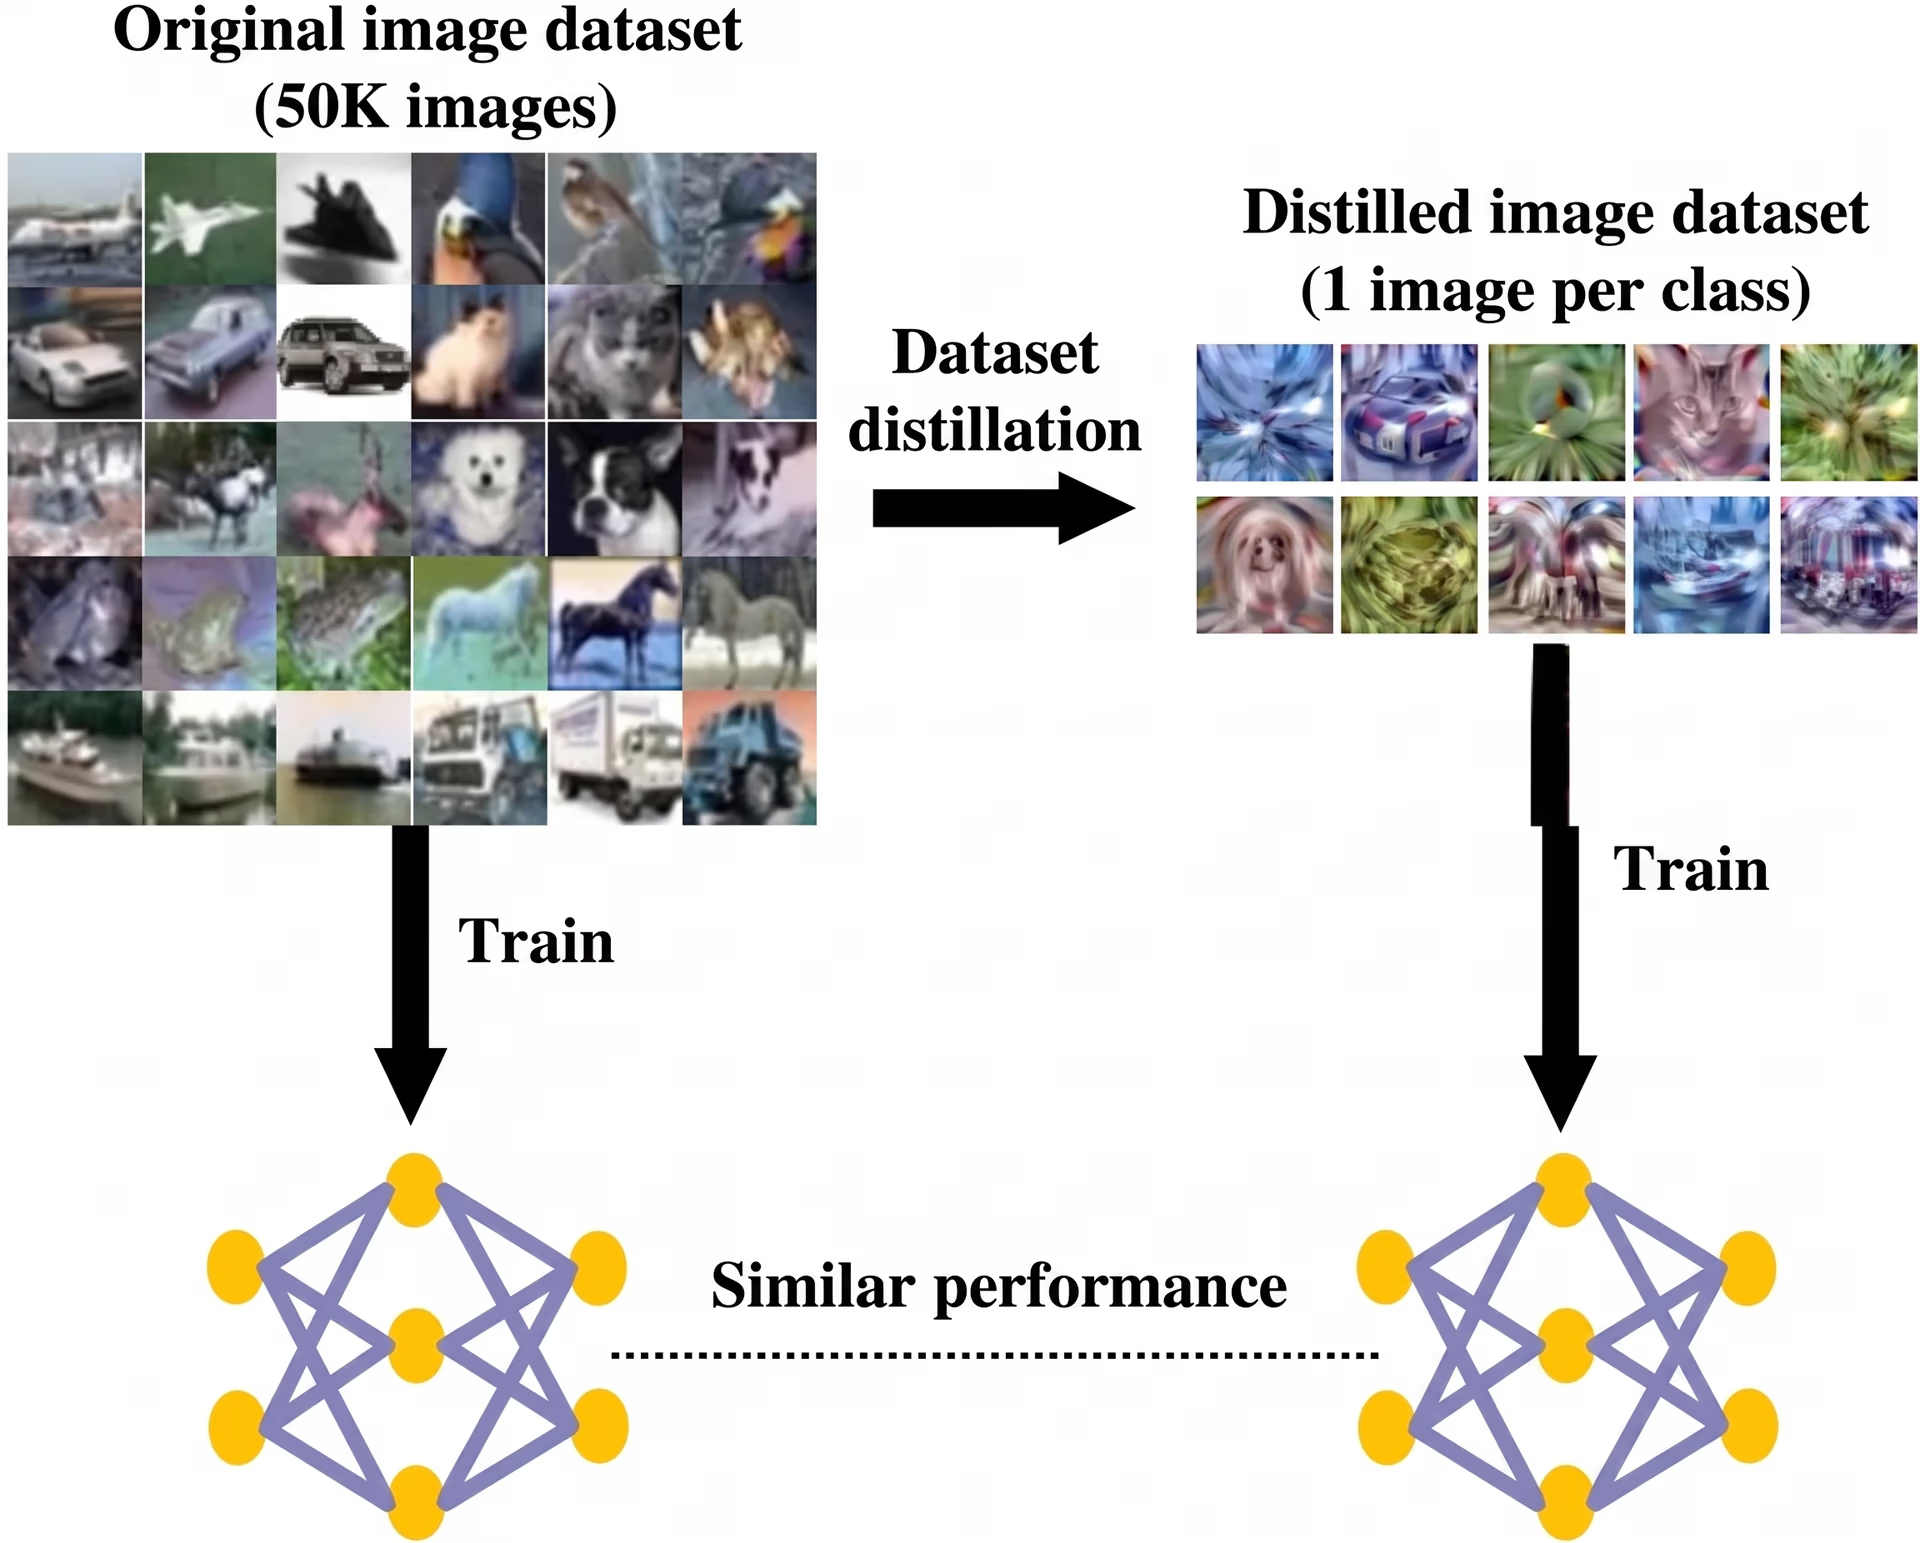
図1. 画像データへのデータセット蒸留の適用(出典)
それ以降、ICMLやICLRで発表された手法など、後続の研究によってデータセット蒸留はさらに発展し、凝縮の効率とスケーラビリティが向上しました。
データセット蒸留の重要性#
データセット蒸留はトレーニング効率を高め、開発サイクルを短縮します。モデルが学習に必要とするデータ量を減らすことで、計算要件を抑えます。
これは、モデルを継続的に更新する継続学習、多数のモデル設計を試すニューラルアーキテクチャ検索、メモリや電力が限られた小型デバイスでモデルを実行するエッジトレーニングで特に役立ちます。全体として、こうした利点により、データセット蒸留は迅速な初期化、短時間のファインチューニング、さまざまな機械学習ワークフローでの初期プロトタイプ構築に適しています。
データセット蒸留の仕組みの概要#
データセット蒸留では、合成、つまり人工的に生成されたトレーニングサンプルを作成します。これらのサンプルにより、実データでトレーニングした場合に近い形でモデルを学習させられます。通常のトレーニング中に、3つの重要な要素を追跡して処理します。
1つ目は損失関数です。これは、予測がどれほど間違っているかを示すモデルの誤差スコアです。2つ目はモデルのパラメーターです。学習に応じて更新される、ネットワーク内部の重みを指します。
3つ目はトレーニングの軌跡で、誤差と重みが時間の経過とともに段階的にどう変化するかを示します。その後、合成サンプルを最適化し、モデルがそれらを使ってトレーニングした際に、完全なデータセットを使った場合と同じように誤差が減少し、重みが更新されるようにします。
データセット蒸留をステップごとに見る#
データセット蒸留のプロセスを詳しく見ていきましょう。
- ステップ1 - 合成ピクセルを初期化する: このプロセスは、学習可能な入力として機能する合成画像から始まります。最初、これらの画像には構造がほとんどなく、白紙のように見えます。時間の経過とともに最適化され、情報量の多いサンプルになります。
- ステップ2 - 勾配マッチングと誤差逆伝播で最適化する: モデルがこれらの合成画像でトレーニングされると、実データのトレーニング動作により近づけるために各ピクセルをどう変化させるべきかを示す勾配が生成されます。誤差逆伝播は、ネットワークが誤りから学習するために使う手法です。誤差をモデル内で逆方向に伝え、原因となったピクセルや重みを特定してから、それらを少しずつ更新します。誤差逆伝播はこれらの勾配を使って合成画像を段階的に調整し、トレーニングに役立つ情報を増やします。
- ステップ3 - トレーニングステップ全体で動作を一致させる: この手法では、学習中にモデルが段階的に変化する様子を示すトレーニング軌跡も一致させます。これにより、蒸留データセットがモデルを、完全なデータセットを使った場合と同様の学習過程へ導きます。
- ステップ4 - 検証と汎化: 最後に、実際の検証データを使って蒸留データセットを評価し、トレーニングしたモデルが新しいサンプルでどの程度の性能を発揮するかを確認します。これにより、モデルが特定のサンプルを記憶するのではなく、幅広く有用なパターンを合成データから学習しているかを検証できます。
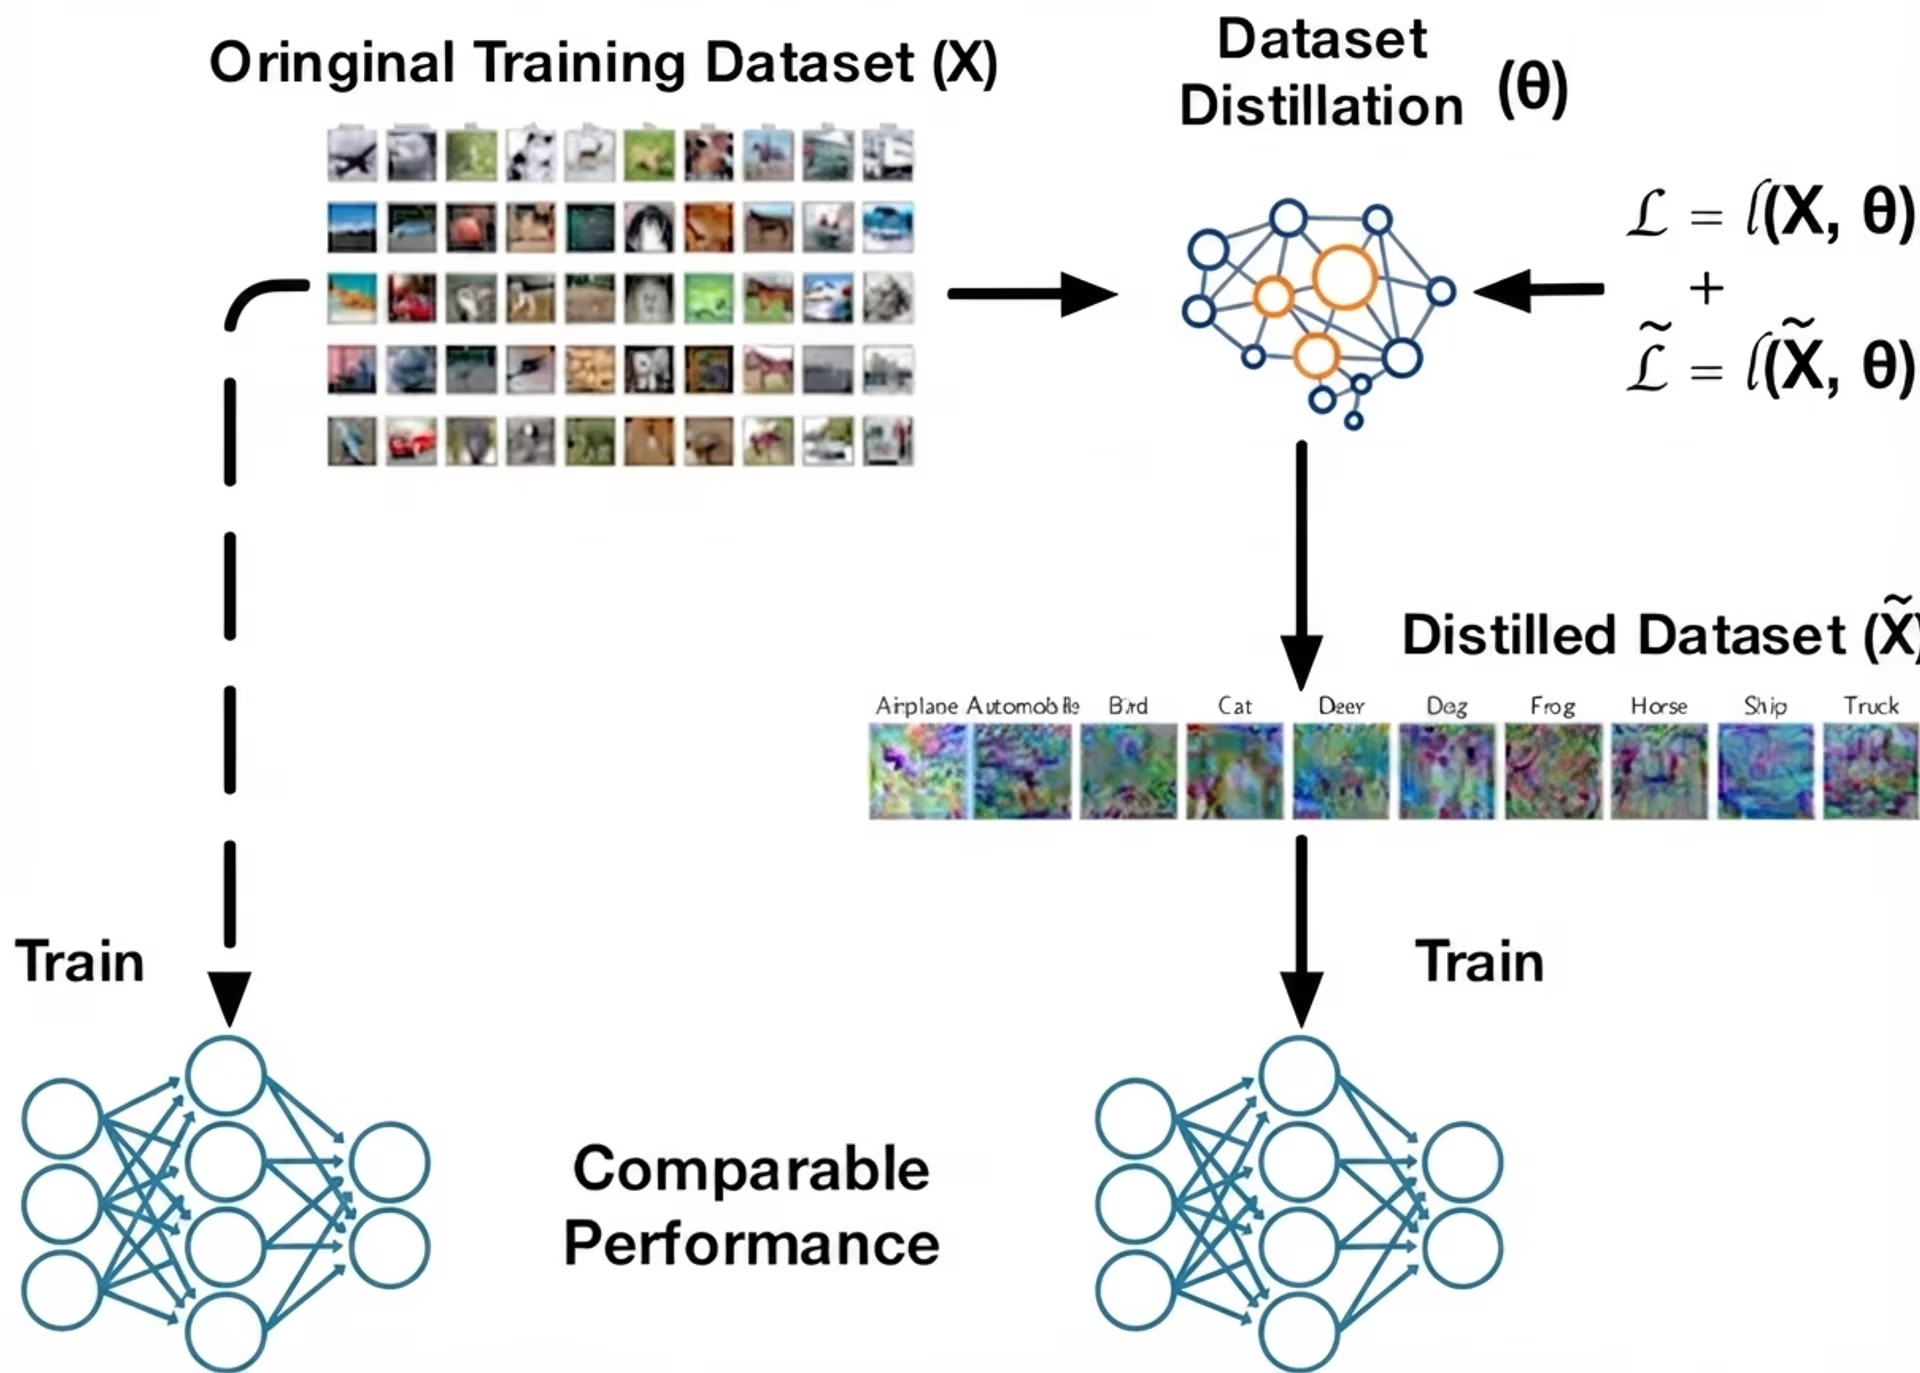
図2. データセット蒸留の概要(出典)
データセット蒸留の主要な手法#
データセット蒸留の手法は、実現に異なるアルゴリズムを用いていても、すべて同じ基本的な考え方に基づいています。ほとんどの手法は、性能マッチング、分布マッチング、パラメータマッチングの3つに分類されます。
それぞれの手法を見て、仕組みを確認しましょう。
性能マッチング#
データセット蒸留における性能マッチングでは、モデルが完全な元のデータセットでトレーニングされた場合とほぼ同じ精度に到達できる、小規模で最適化されたトレーニングセットの作成に重点を置きます。ランダムなサブセットを選ぶのではなく、蒸留サンプルを最適化し、それらでトレーニングしたモデルが、元のデータセットでトレーニングしたモデルと類似した予測、トレーニング中の損失の推移、または最終精度を示すようにします。
このプロセスの改善には、メタ学習がよく使われます。蒸留データセットは、繰り返し行うトレーニングエピソードを通じて更新され、さまざまな状況で効果を発揮するようになります。
これらのエピソードでは、現在の蒸留サンプルから生徒モデルが学習する様子をシミュレーションし、そのモデルが実データでどの程度の性能を発揮するかを確認したうえで、蒸留サンプルをより優れた教師となるよう調整します。時間の経過とともに、蒸留セットは、生徒モデルの初期重みやアーキテクチャが異なっていても、迅速な学習と高い汎化性能を支えられるようになります。これにより、蒸留データセットの信頼性が高まり、単一のトレーニング実行に依存しなくなります。
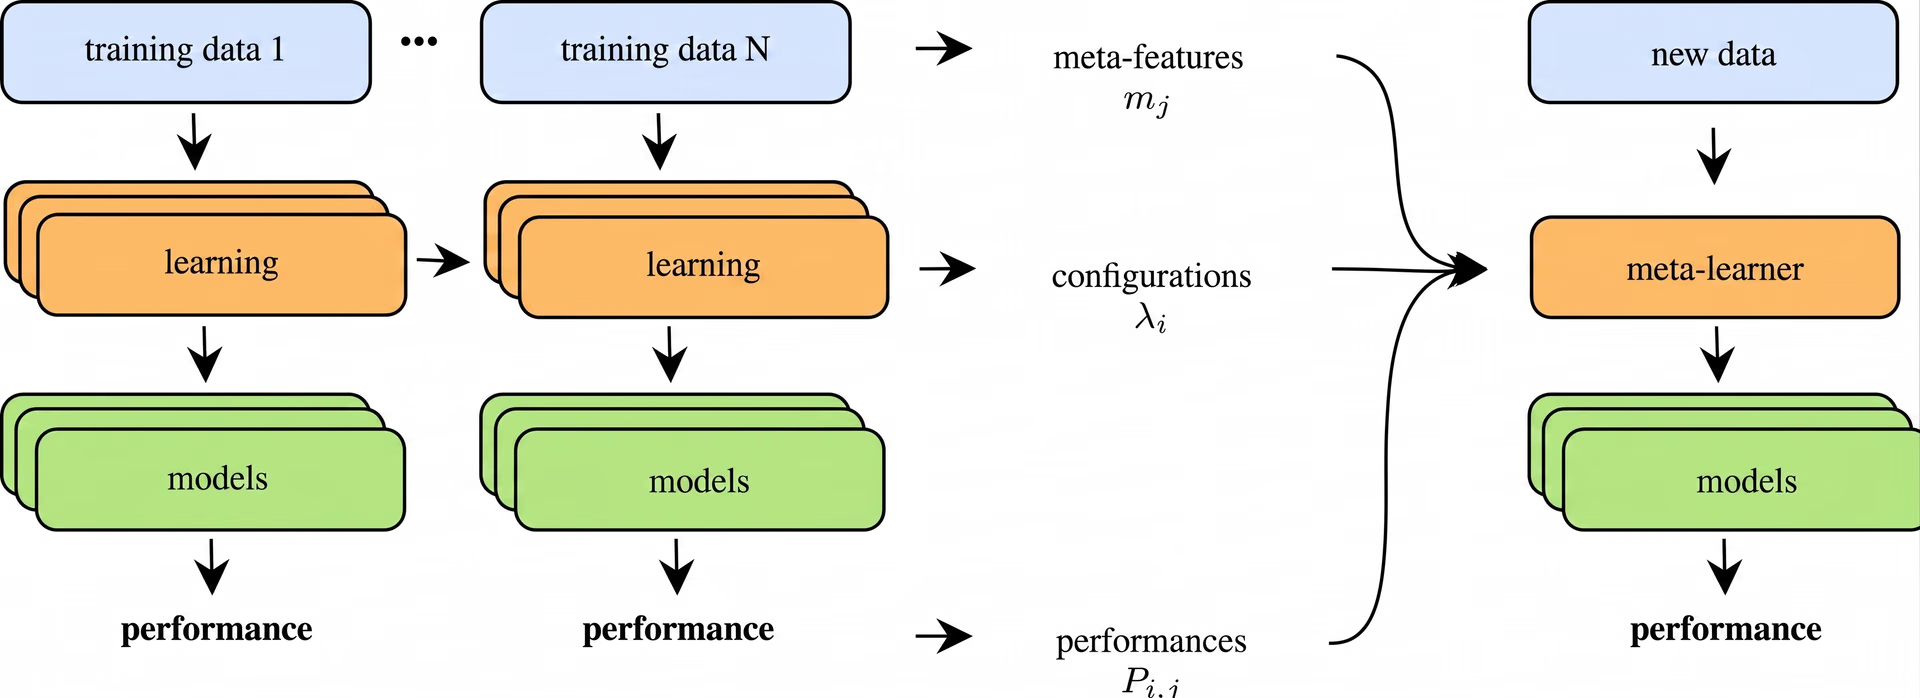
図3. メタ学習のプロセス(出典)
分布マッチング手法#
一方、分布マッチングでは、実際のデータセットの統計的パターンに一致する合成データを生成します。モデルの最終精度だけに注目するのではなく、学習中にニューラルネットワークが生成する内部特徴に焦点を当てます。
次に、分布マッチングを支える2つの手法を見ていきましょう。
単一層の分布マッチング#
単一層の分布マッチングでは、ニューラルネットワークの1つの層に焦点を当て、実データと合成データに対してその層が生成する特徴を比較します。活性化とも呼ばれるこれらの特徴は、ネットワークのその時点までにモデルが学習した内容を捉えています。
合成データから類似した活性化が得られるようにすることで、この手法は、蒸留されたデータセットが元のデータセットと同じ重要なパターンを反映するよう促します。実際には、選択した層の活性化が実画像の活性化とよく一致するまで、合成サンプルを繰り返し更新します。
一度に1つの表現レベルだけを調整するため、このアプローチは比較的シンプルです。深い多段階の特徴階層を一致させる必要がない小規模なデータセットやタスクでは、特に効果を発揮します。1つの特徴空間を明確に調整することで、単一層のマッチングは、蒸留データセットを用いた学習に安定した有意義な信号を提供します。
複数層の分布マッチング#
複数層の分布マッチングは、ニューラルネットワークの1つの層だけでなく複数の層で実データと合成データを比較するという考え方に基づいています。層ごとに捉える情報は異なり、初期層では単純なエッジやテクスチャを、深い層では形状やより複雑なパターンを捉えます。
これらの層全体で特徴を一致させることで、蒸留データセットがモデルの複数のレベルにおける学習内容を反映するようにします。ネットワーク全体の特徴を調整するため、このアプローチは、クラスを区別するためにモデルが利用する、より豊かな信号を合成データに保持させるのに役立ちます。
これは、モデルが画像や動画を理解するタスクを指すコンピュータービジョンで特に有用です。これは、役立つパターンが多くの層に分散しているためです。複数の深さで特徴分布がよく一致すると、蒸留データセットは元の学習データのより強力で信頼性の高い代替として機能します。
パラメーターのマッチング手法#
データセット蒸留におけるもう1つの重要なカテゴリは、パラメーターのマッチングです。精度や特徴分布を一致させるのではなく、学習中にモデルの重みがどのように変化するかを一致させます。蒸留データセットでの学習によって、実データでの学習と同様のパラメーター更新が生じるようにすることで、モデルはほぼ同じ学習経路をたどります。
次に、主要な2つのパラメーターのマッチング手法を見ていきます。
単一ステップのマッチング#
単一ステップのマッチングでは、実データで1回だけ学習した後にモデルの重みがどう変化するかを比較します。次に、蒸留データセットを調整し、そのデータセットで1ステップ学習したモデルが非常によく似た重み更新を行うようにします。この1回の更新だけに焦点を当てるため、手法はシンプルで実行も高速です。
ただし、1ステップでは学習プロセス全体を反映できず、より豊かな特徴を構築するために多くの更新が必要な難しいタスクでは特に不十分です。そのため、単一ステップのマッチングは、有用なパターンをすばやく学習できる単純な問題や小規模なデータセットで最も効果を発揮します。
複数ステップのパラメーターのマッチング#
これに対して、複数ステップのパラメーターのマッチングでは、1回だけでなく複数の学習ステップにわたるモデルの重みの変化を調べます。この一連の更新が、モデルの学習軌跡です。
モデルが合成サンプルで学習したときに、実データで学習した場合の軌跡を忠実にたどるよう、蒸留データセットを構築します。より長い学習過程を一致させることで、蒸留データセットは元の学習プロセスに含まれる構造をより多く捉えます。
学習が時間とともにどのように進むかを反映するため、複数ステップのマッチングは、有用なパターンの学習に多くの更新を必要とする大規模または複雑なデータセットで、通常より効果を発揮します。複数のステップを追跡する必要があるため計算量は増えますが、単一ステップのマッチングより汎化性能とパフォーマンスに優れた蒸留データセットを生成できることがよくあります。
合成データセットの生成と最適化の仕組み#
主要な蒸留アプローチについて理解したところで、次に合成データの作成方法を見ていきます。データセット蒸留では、最も重要な学習信号を捉えるように合成サンプルを最適化し、少数のサンプルで大規模なデータセットを置き換えられるようにします。
次に、この蒸留データがどのように生成、評価されるかを見ていきます。
蒸留画像の作成と評価#
データセット蒸留では、合成画像のピクセルを多くの学習ステップにわたって更新します。ニューラルネットワークは現在の合成画像から学習し、勾配に基づくフィードバックを返します。このフィードバックは、実データセットのパターンによりよく一致するよう、各ピクセルをどのように変えるべきかを示します。
このプロセスは微分可能です(つまり、各ステップが滑らかで明確に定義された勾配を持ち、小さなピクセルの変化が損失の予測可能な変化につながります)。そのため、勾配降下法を用いてモデルが合成データを滑らかに調整できます。
最適化を続けると、合成画像には、モデルが認識する形状やテクスチャなどの意味のある構造が現れ始めます。こうして洗練された合成画像は、分類器の学習に必要な主要な視覚的手掛かりを捉えているため、画像分類タスクによく利用されます。
蒸留データセットは、そのデータセットでモデルを学習させ、実データで学習させたモデルと結果を比較して評価します。研究者は検証精度を測定し、クラスを区別するために必要な識別特徴(モデルがクラス間の違いを判断する際に利用するパターンや信号)が合成データセットに保持されているかを確認します。また、蒸留データによって過学習が生じないよう、異なる実行やモデル構成における安定性と汎化性能もテストします。
データ蒸留の実世界での応用#
次に、データが限られている場合や高度に専門化されている場合でも高いパフォーマンスを維持しながら、蒸留データセットによって学習を高速化し、計算コストを削減できる事例を詳しく見ていきます。
コンピュータービジョンへのデータセット蒸留の活用#
コンピュータービジョンの目的は、画像や動画などの視覚データを理解するようモデルを学習させることです。モデルはエッジ、テクスチャ、形状、物体などのパターンを学び、画像分類、物体検出、セグメンテーションなどのタスクに活用します。ビジョンの問題では、照明、背景、視点に大きなばらつきがあることが多いため、コンピュータービジョンシステムが良好に汎化するには通常、大規模なデータセットが必要となり、学習に時間とコストがかかります。
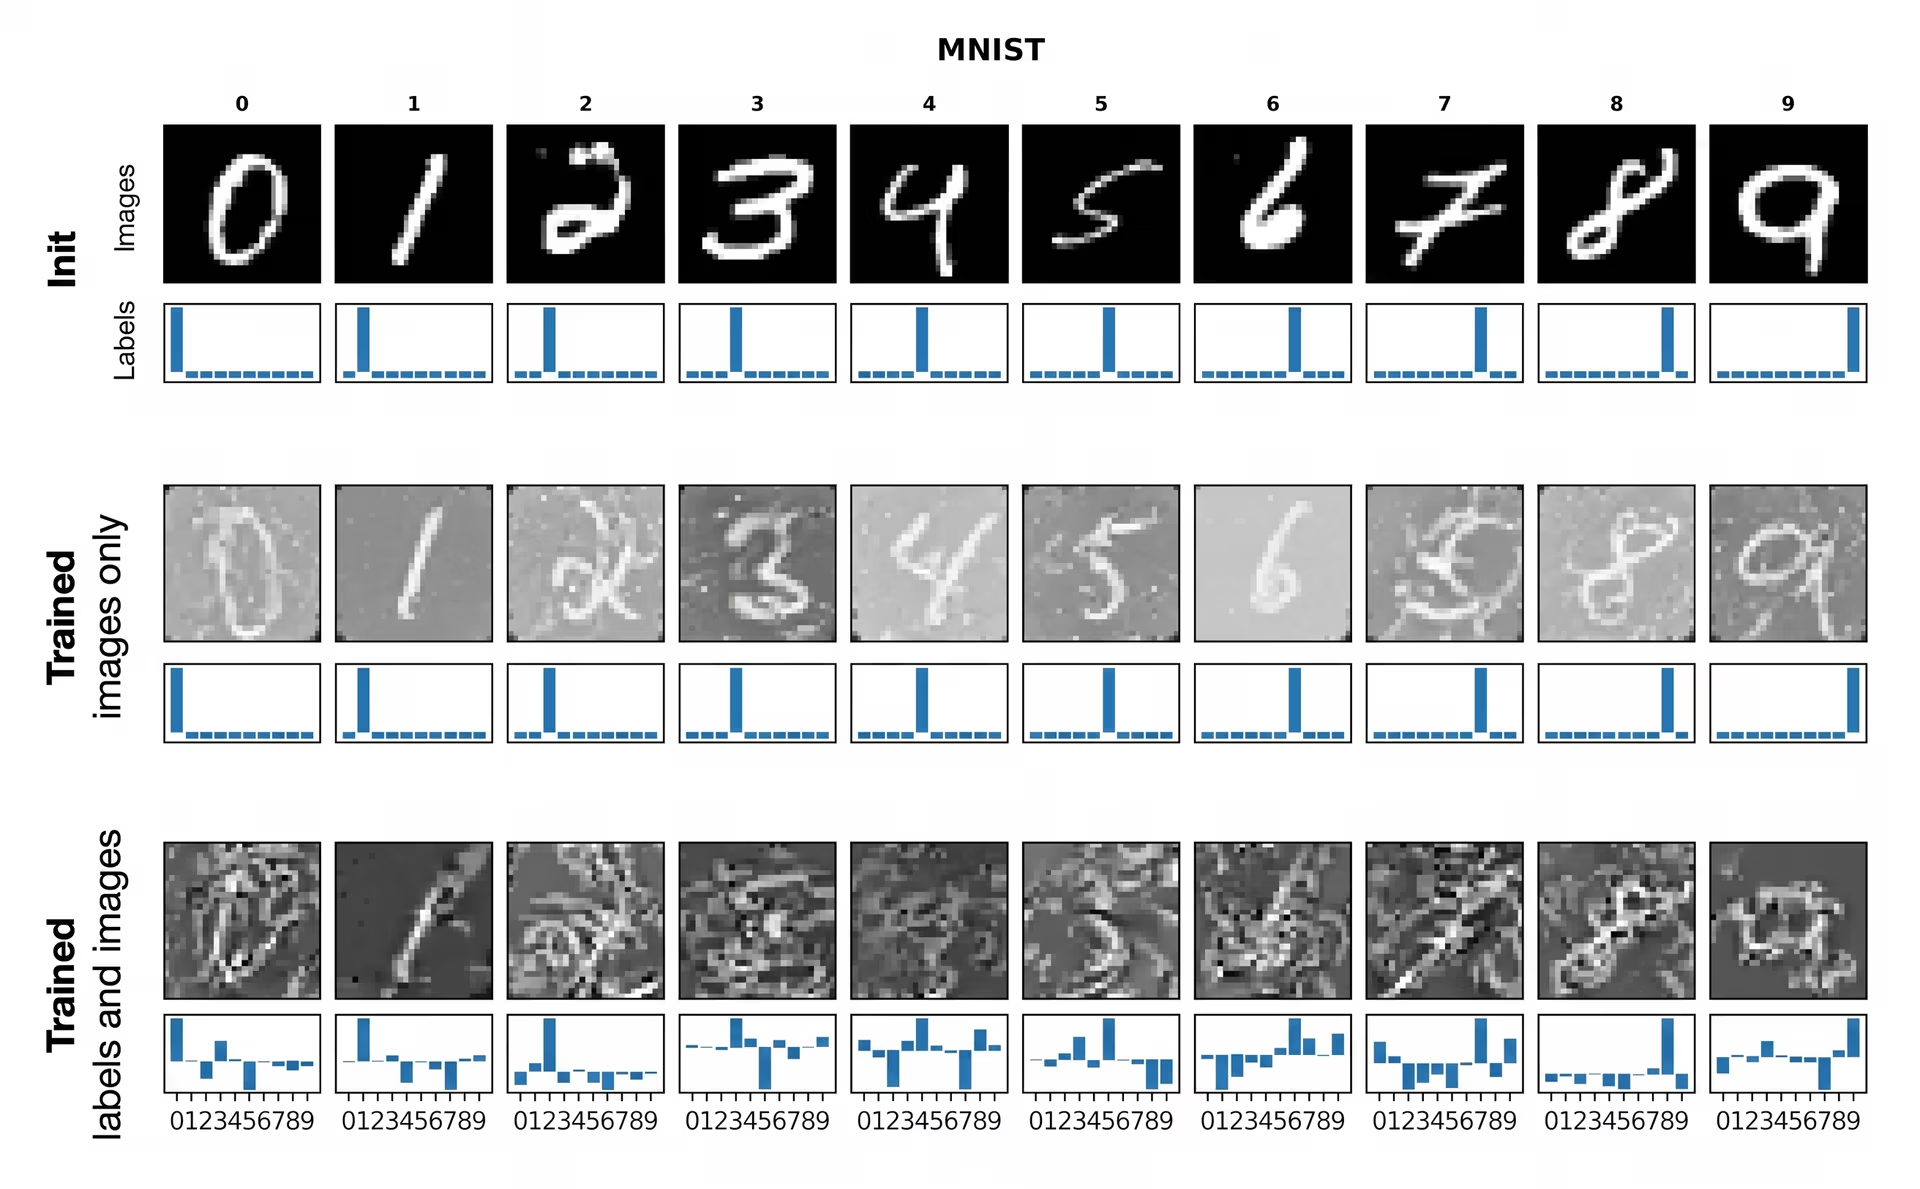
図4. データセット蒸留の例(出典)
医療画像、野生生物のモニタリング、工場の欠陥検出などの画像分類の用途では、モデルは精度と学習コストの難しいトレードオフに直面することがよくあります。これらのタスクでは、通常、大規模なデータセットを扱います。
データセット蒸留では、元の学習セットを、分類器に必要な最も重要な視覚的手掛かりを保持した少数の合成画像に圧縮できます。ImageNetのような大規模ベンチマークでは、元の画像の約4.2%のみを使用する蒸留データセットでも、高い分類精度を維持できることが示されています。つまり、ごく小さな合成データが、計算量を大幅に抑えながら数百万枚の実サンプルを代替できます。
ニューラルアーキテクチャ探索#
ニューラルアーキテクチャ探索、すなわちNASは、多数のニューラルネットワーク設計候補を自動的に探索し、タスクに最適なものを見つける手法です。NASでは多数の候補モデルをトレーニングして評価する必要があるため、完全なデータセットで実行すると時間がかかり、計算負荷も非常に高くなります。
データセット蒸留では、元データの主要な学習信号を保持する小さな合成学習セットを作成することで、各候補アーキテクチャをはるかに高速にテストできます。これにより、良いアーキテクチャと悪いアーキテクチャの順位を比較的信頼できる形で保ちながら、NASによる設計比較を効率化できます。最終的なモデル品質を大きく損なわずに、探索コストを削減できます。
継続学習とエッジデプロイ#
新しいデータが届くたびに更新され、一度だけトレーニングするのではないモデルを使う継続学習システムでは、高速かつメモリ効率の良い更新が必要です。カメラ、スマートフォン、センサーなどのエッジデバイスも、計算能力とストレージの予算が限られているため、同様の制約を受けます。
データセット蒸留は、大規模な学習セットを小さな合成セットに圧縮することで、どちらの場合にも役立ちます。これにより、モデルは完全なデータセットではなく、小規模なリプレイセットを使って適応や再学習を行えます。たとえば、カーネルベースのメタ学習の研究では、蒸留サンプルがわずか10個でも、標準的な画像分類ベンチマークであるCIFAR-10で64%を超える精度を達成できることが示されました。リプレイセットが非常にコンパクトなため、特にモデルを頻繁に更新する必要がある場合、更新をはるかに高速かつ実用的に行えます。
データセット蒸留は、大規模言語モデルの知識蒸留と組み合わせて活用することもできます。小規模な蒸留データセットは、教師モデルから重要なタスク情報を保持できるため、圧縮された生徒モデルを性能をほとんど損なわずに効率的にトレーニングまたは更新できます。こうしたデータセットは非常に小さいため、ストレージと計算能力が限られているエッジやデバイス上での利用に特に役立ちます。また、更新後もモデルの精度を維持できます。
データ蒸留の長所と短所#
データセット蒸留を利用するメリットは次のとおりです。
- 手早い実験に最適です。 毎回大規模なデータセットで再学習することなく、新しいアーキテクチャ、損失関数、ハイパーパラメーターを試せます。
- プライバシー面で有利な可能性があります。 蒸留された合成サンプルの共有は、生のユーザーデータが直接公開されないため、実データの共有より安全な場合があります。
- 単純なサブセット選択より優れた結果が得られることがよくあります。 サンプルを選ぶだけでなく、蒸留ではサンプルを積極的に最適化し、情報量を最大化します。
データセット蒸留にはいくつかの利点がありますが、次のような制約にも注意が必要です。
- 過学習。 蒸留データは、蒸留に使われたアーキテクチャで最も効果を発揮することが多く、大きく異なるモデルにはうまく適用できない場合があります。
- ハイパーパラメーターに敏感です。 結果は、学習率、初期化、蒸留ステップ数などの要因に大きく左右される場合があります。
- 実世界の複雑さに対応したスケーリングが困難です。 ベンチマークでうまく機能する手法でも、大規模で雑然としたデータセットや高解像度のデータセットでは精度が低下することがあります。
重要なポイント#
データセット蒸留を使えば、少数の合成サンプルで、完全なデータセットとほぼ同じ効果をモデルに学習させることができます。これにより、機械学習を高速化し、効率を高め、スケールしやすくできます。モデルの規模が拡大してより多くのデータが必要になる中、蒸留データセットは精度を損なわずに計算コストを削減する実用的な方法となります。
コミュニティに参加し、GitHubリポジトリをチェックして、AIについてさらにご覧ください。独自のビジョンAIプロジェクトを構築する場合は、ライセンスオプションをご確認ください。ソリューションページでは、医療におけるAIや小売業におけるビジョンAIなどの応用についてもご紹介しています。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









