Mask R-CNNとは何ですか?また、どのように機能しますか?
Mask R-CNNの仕組みを、バックボーンや領域提案ネットワークからROI Align、マスク予測まで解説し、用途、限界、後継となるYOLOモデルもご紹介します。
 Abirami Vina9 分で読めます
倉庫内のロボット、混雑した道路を安全に走行する自動運転車、作物を確認するドローン、工場で製品を検査するAIシステムなどのイノベーションは、AIの導入拡大に伴い、一般的になりつつあります。こうしたイノベーションを支える重要なテクノロジーが、視覚データを機械が理解して解釈できるようにするAIの一分野であるコンピュータービジョンです。
たとえば、物体検出は、バウンディングボックスを使って画像内のオブジェクトを識別し、位置を特定するコンピュータービジョンタスクです。バウンディングボックスは有用な情報を提供しますが、オブジェクトの位置を大まかに示すだけで、正確な形状や境界を捉えられません。そのため、正確な識別が必要なアプリケーションでは効果が低くなります。
この問題を解決するために、研究者はオブジェクトの正確な輪郭を捉え、より高精度な検出と解析のためのピクセルレベルの詳細を提供するセグメンテーションモデルを開発しました。
Mask R-CNNはこうしたモデルの1つです。2017年にFacebook AI Research(FAIR)が発表し、R-CNN、Fast R-CNN、Faster R-CNNなどの先行モデルを基盤としています。コンピュータービジョンの歴史における重要な節目として、Mask R-CNNはUltralytics YOLO11など、より高度なモデルへの道を切り開きました。
この記事では、Mask R-CNNとは何か、その仕組みや用途、そしてUltralytics YOLO11につながる後続の改良について解説します。
Mask R-CNNの概要#
Mask R-CNNは、Mask Region-based Convolutional Neural Networkの略で、物体検出やインスタンスセグメンテーションなどのコンピュータービジョンタスク向けに設計されたディープラーニングモデルです。
インスタンスセグメンテーションは、画像内のオブジェクトを識別するだけでなく、それぞれの輪郭を正確に描くことで、従来の物体検出を超える機能を提供します。検出されたオブジェクトごとに固有のラベルを割り当て、ピクセルレベルで正確な形状を捉えます。この詳細なアプローチにより、重なり合うオブジェクトを明確に区別し、複雑な形状を正確に処理できます。
Mask R-CNNはFaster R-CNNを基盤としています。Faster R-CNNはオブジェクトを検出してラベルを付けますが、正確な形状は定義しません。Mask R-CNNは各オブジェクトを構成する正確なピクセルを特定することでこれを改善し、より詳細で正確な画像解析を可能にします。
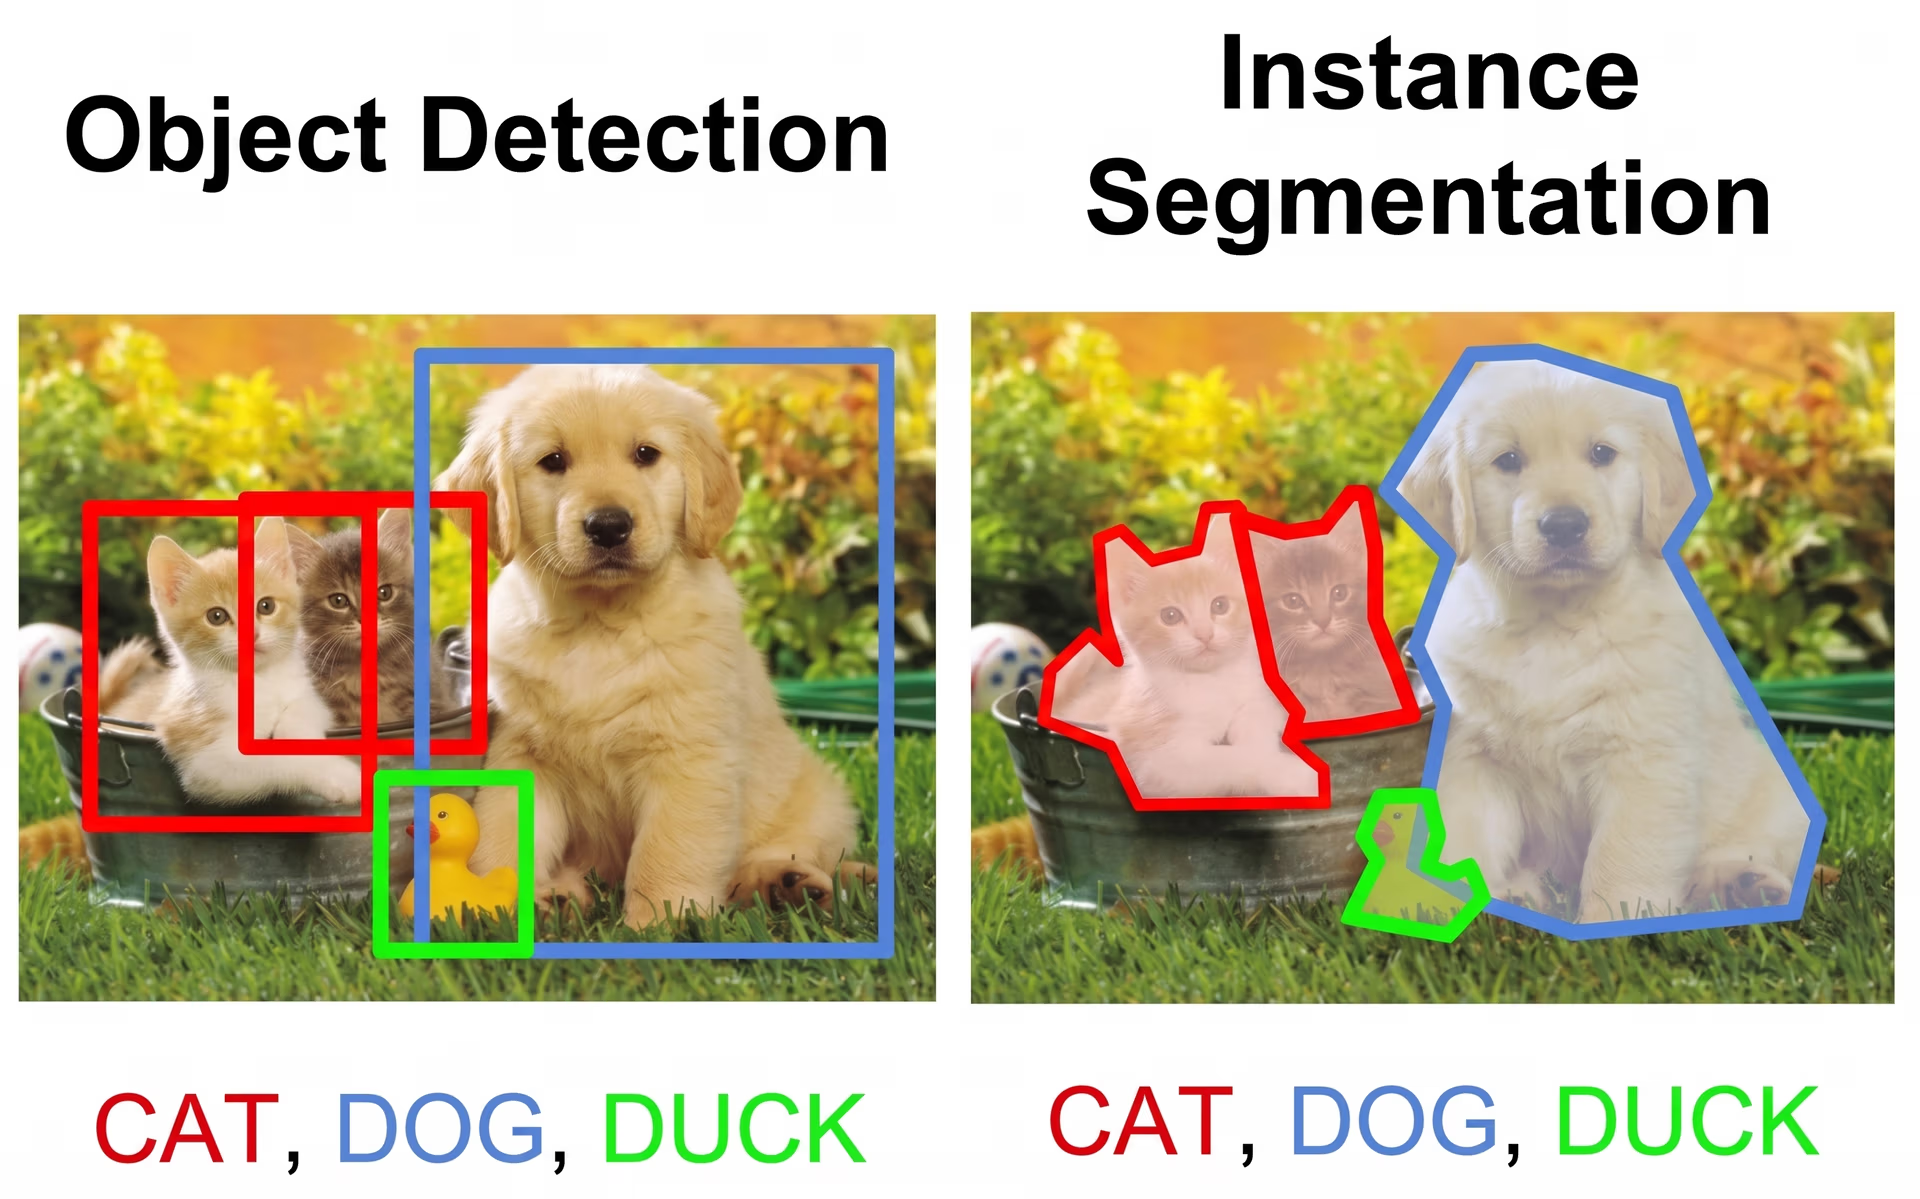
図1. 物体検出とインスタンスセグメンテーションの比較。
Mask R-CNNのアーキテクチャと仕組み#
Mask R-CNNは、オブジェクトを正確に検出してセグメンテーションするために、段階的なアプローチを採用します。まず、ディープニューラルネットワーク(データから学習する多層モデル)を使って重要な特徴を抽出します。次に、領域提案ネットワーク(オブジェクトがありそうな領域を提案するコンポーネント)でオブジェクト候補領域を特定し、最後に、詳細なセグメンテーションマスク(オブジェクトの精密な輪郭)を作成して領域をさらに調整し、各オブジェクトの正確な形状を捉えます。
次に、Mask R-CNNの仕組みをよりよく理解するため、各ステップを順に見ていきましょう。
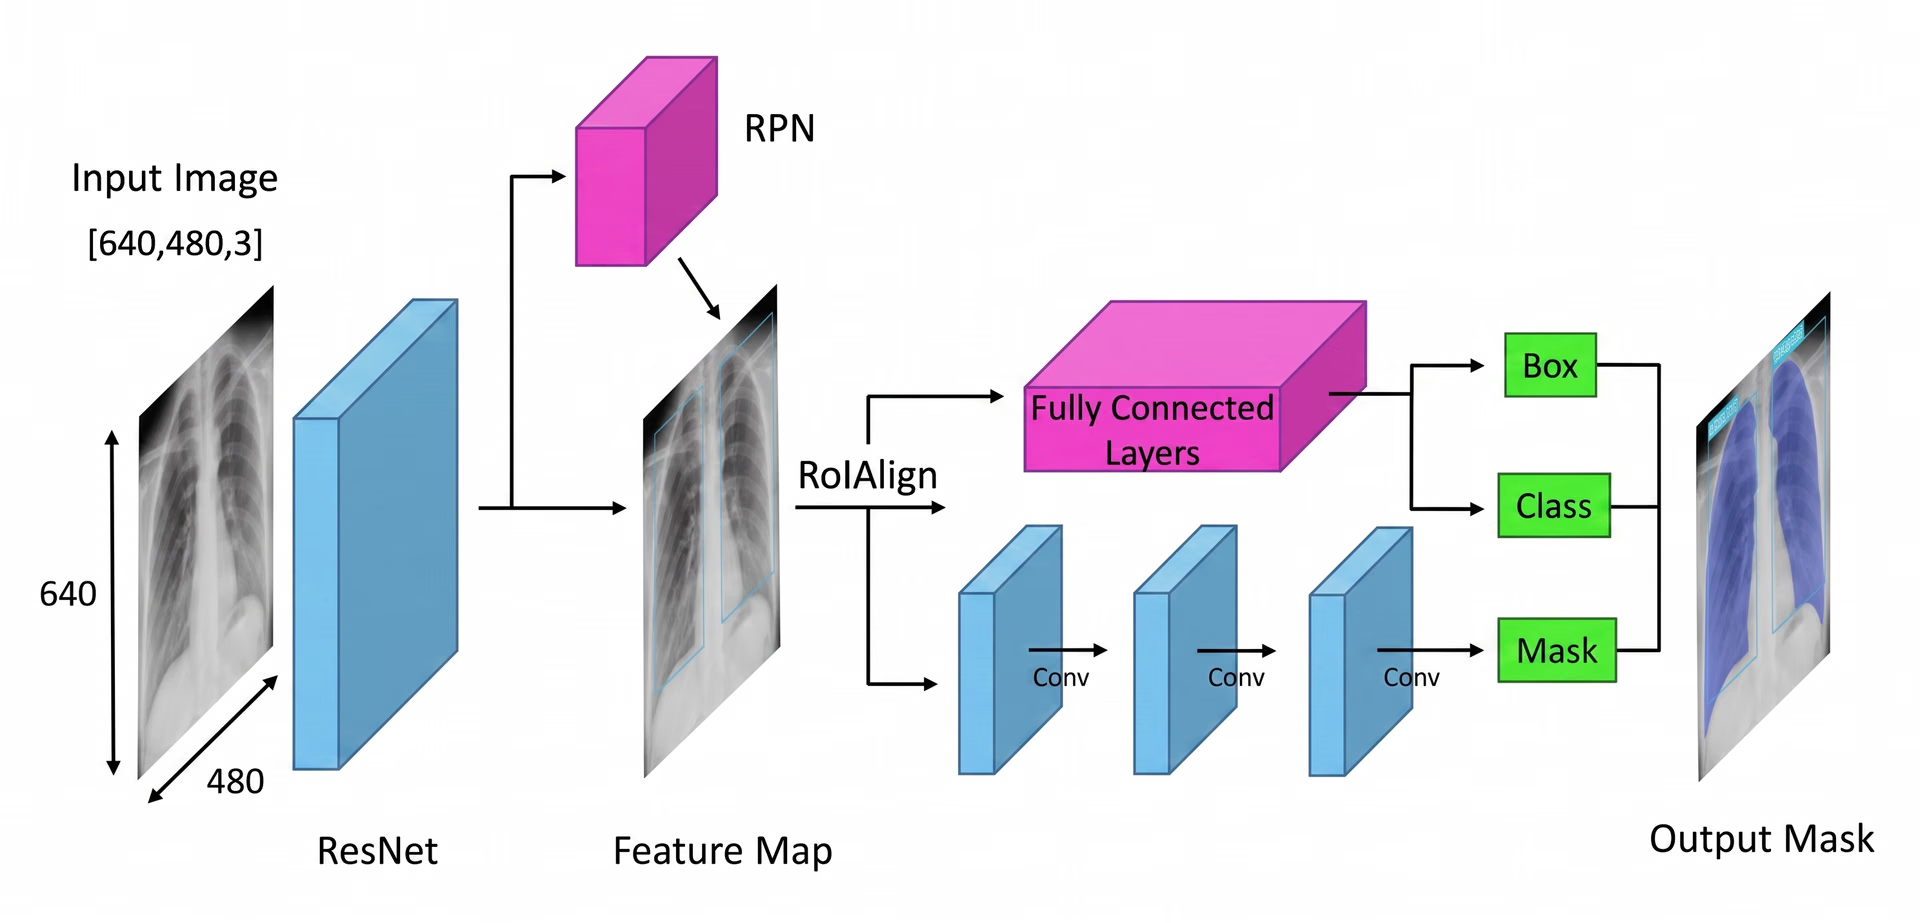
図2. Mask R-CNNのアーキテクチャの概要(出典: researchgate.net)。
特徴抽出から始める#
Mask R-CNNのアーキテクチャでは、まず画像を主要な部分に分解し、モデルが画像内の内容を理解できるようにします。写真を見たときに、形状、色、輪郭などの細部に自然と気づくのと似ています。モデルも同様の処理を、「バックボーン」と呼ばれるディープニューラルネットワーク(多くの場合、ResNet-50またはResNet-101)で行います。このネットワークは目のような役割を果たし、画像をスキャンして重要な特徴を捉えます。
画像内の物体は非常に小さい場合も大きい場合もあるため、Mask R-CNNは特徴ピラミッドネットワークを使用します。これは、さまざまな倍率の拡大鏡を使うようなもので、モデルが細部と全体像の両方を捉え、あらゆるサイズの物体を検出できるようにします。
これらの重要な特徴が抽出されると、モデルは画像内のオブジェクト候補の位置特定に進み、その後の解析に備えます。
画像内のオブジェクト候補領域の提案#
画像の重要な特徴の処理が終わると、領域提案ネットワークが処理を引き継ぎます。このモデルの部分は画像を調べ、オブジェクトが含まれている可能性の高い領域を提案します。
複数のオブジェクト候補位置、すなわちアンカーを生成してこれを行います。次に、ネットワークがこれらのアンカーを評価し、さらに解析する有望なものを選択します。これにより、画像内のすべての場所を調べるのではなく、興味深い対象がある可能性の高い領域だけにモデルの処理を集中できます。
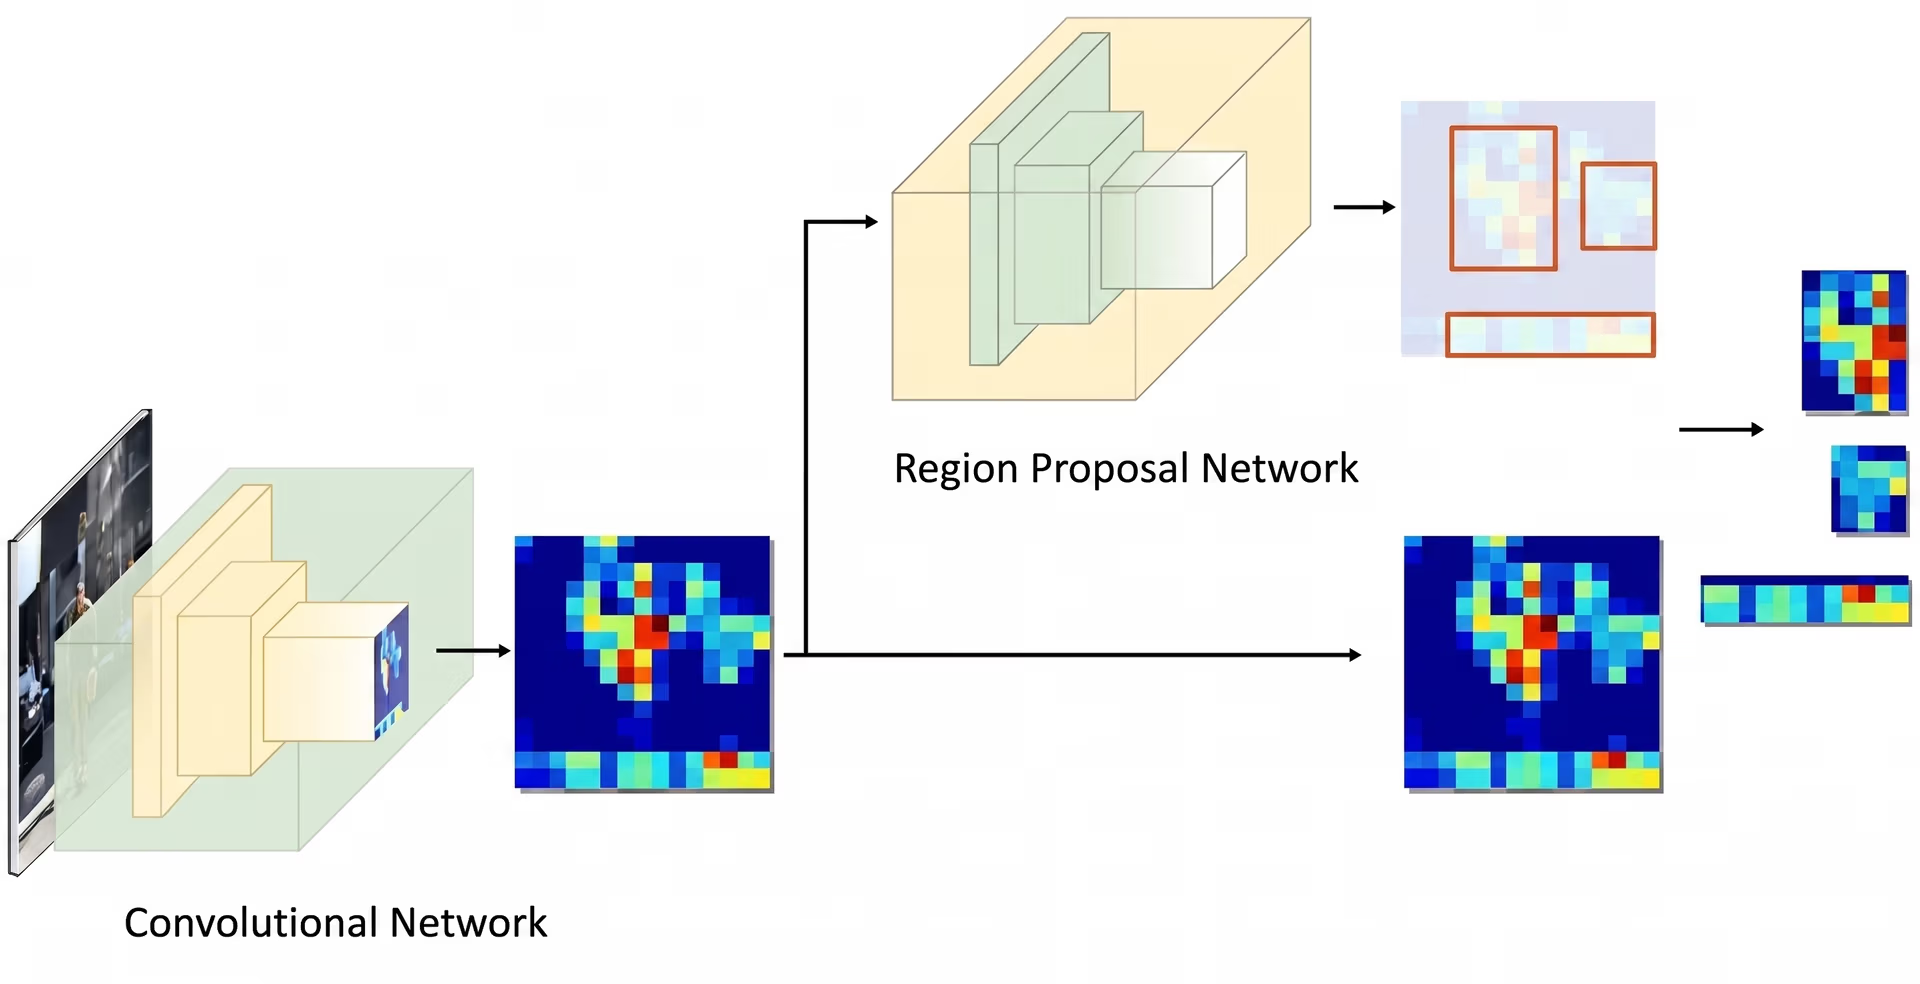
図3. 領域提案ネットワークの例。
抽出された特徴の強化#
重要な領域を特定したら、次はそれらの領域から抽出した詳細を調整します。従来のモデルでは各領域から特徴を取り出すためにROI Pooling(関心領域プーリング)という手法を使っていましたが、領域のサイズ変更時にわずかな位置ずれが生じることがあり、特に小さいオブジェクトや重なり合うオブジェクトでは効果が低下していました。
Mask R-CNNは、ROI Align(関心領域の位置合わせ)と呼ばれる手法を使用してこれを改善します。ROI Poolingのように座標を丸めるのではなく、ROI Alignはバイリニア補間を使用してピクセル値をより正確に推定します。バイリニア補間とは、最も近い4つの隣接ピクセルの値を重み付け平均して新しいピクセル値を算出する方法で、より滑らかな変化を生み出します。これにより、特徴が元の画像と適切に位置合わせされ、物体検出とセグメンテーションの精度が向上します。
たとえば、サッカーの試合で2人の選手が近くに立っていると、バウンディングボックスが重なり、互いに混同される場合があります。ROI Alignは、それぞれの形状を明確に保つことで、選手を区別しやすくします。
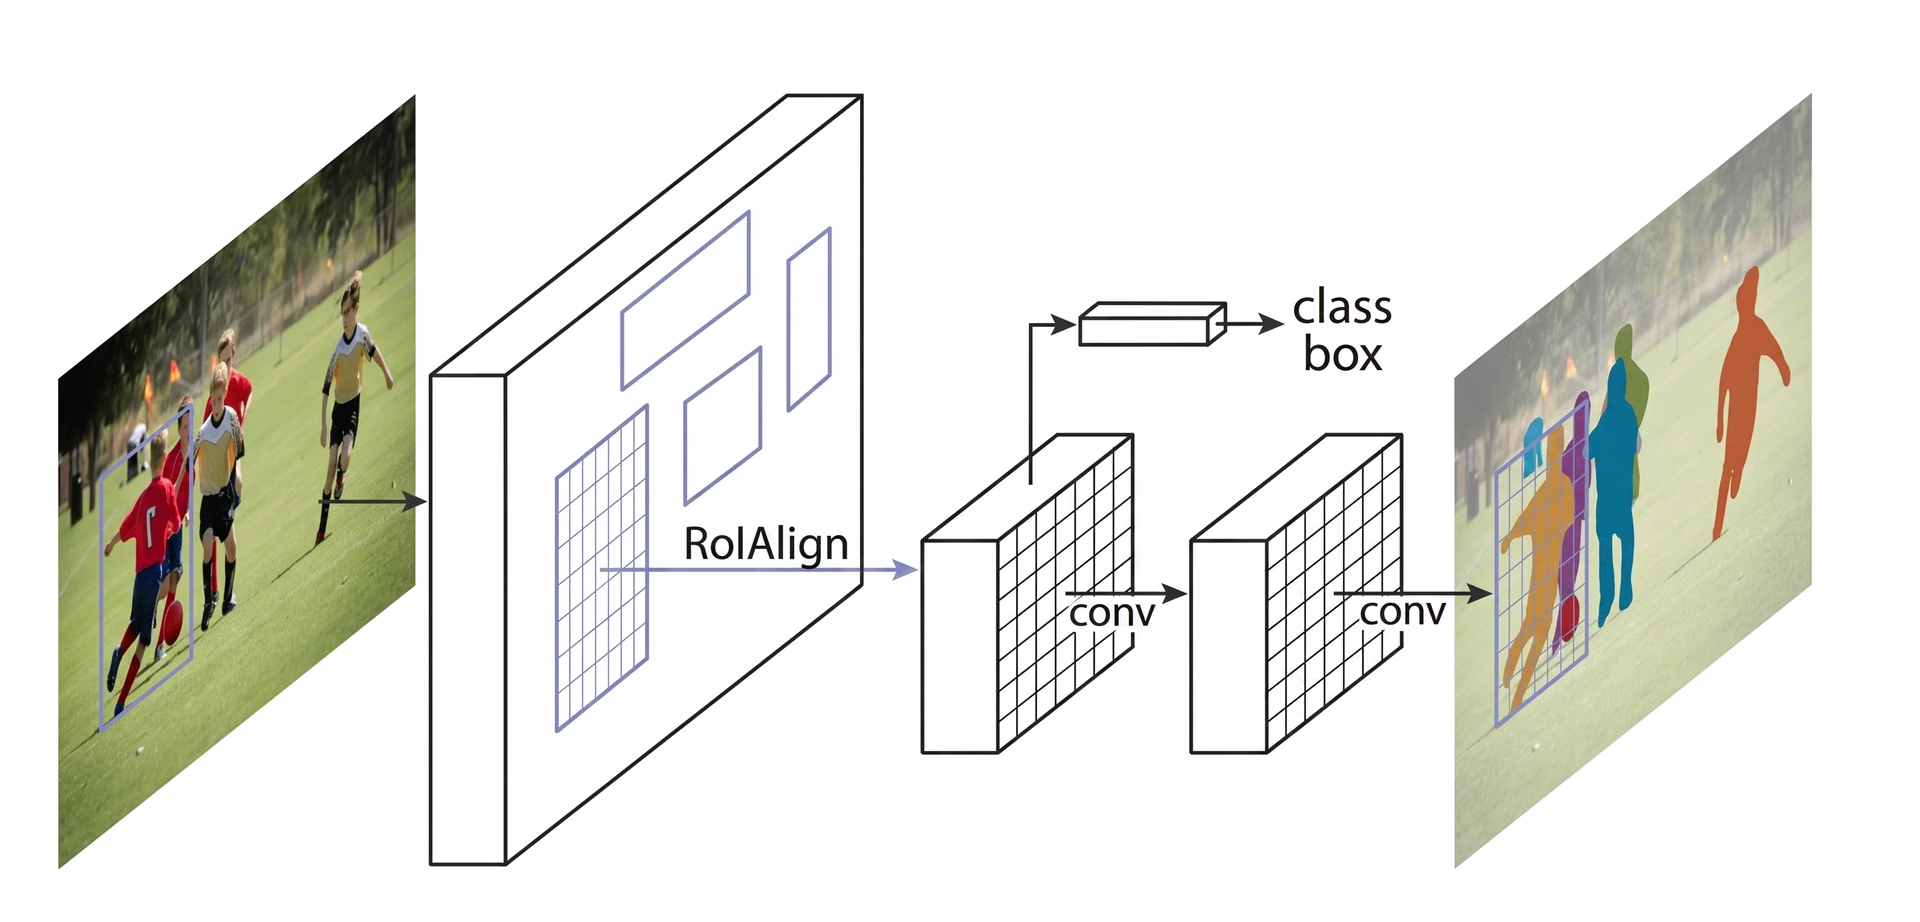
図4。Mask R-CNNはROI Alignを使用します。
オブジェクトの分類とマスクの予測#
ROI Alignで画像を処理した後、次のステップではオブジェクトを分類し、位置を微調整します。モデルは抽出した各領域を調べ、そこに含まれるオブジェクトを判断します。複数のカテゴリに確率スコアを割り当て、最も適合するものを選択します。
同時に、オブジェクトにより適合するようバウンディングボックスを調整します。初期ボックスの位置が最適とは限らないため、各ボックスが検出したオブジェクトをぴったり囲むようにすることで、精度を高めます。
最後に、Mask R-CNNはさらに一歩進み、各オブジェクトの詳細なセグメンテーションマスクを並行して生成します。
Mask R-CNNと実世界での活用例#
このモデルの登場時、AIコミュニティは大きな期待を寄せ、間もなくさまざまなアプリケーションで使われるようになりました。ピクセル単位の精度で物体を検出・セグメンテーションできる能力により、幅広い業界で普及しました。
たとえば、野生環境での絶滅危惧動物の追跡は困難な作業です。多くの種は密林の中を移動するため、保全活動家が追跡するのは容易ではありません。従来の方法では、カメラトラップ、ドローン、衛星画像を利用しますが、これらのデータを手作業で確認するには時間がかかります。誤認や目撃情報の見落としは、保全活動の遅れにつながる可能性があります。
トラの縞模様、キリンの斑点、ゾウの耳の形といった固有の特徴を認識することで、Mask R-CNNは画像や動画内の動物をより高い精度で検出・セグメンテーションできます。動物が木に部分的に隠れていたり、互いに近くに立っていたりする場合でも、モデルは動物を分離して個別に識別できるため、野生動物のモニタリングを迅速かつ確実に行えます。
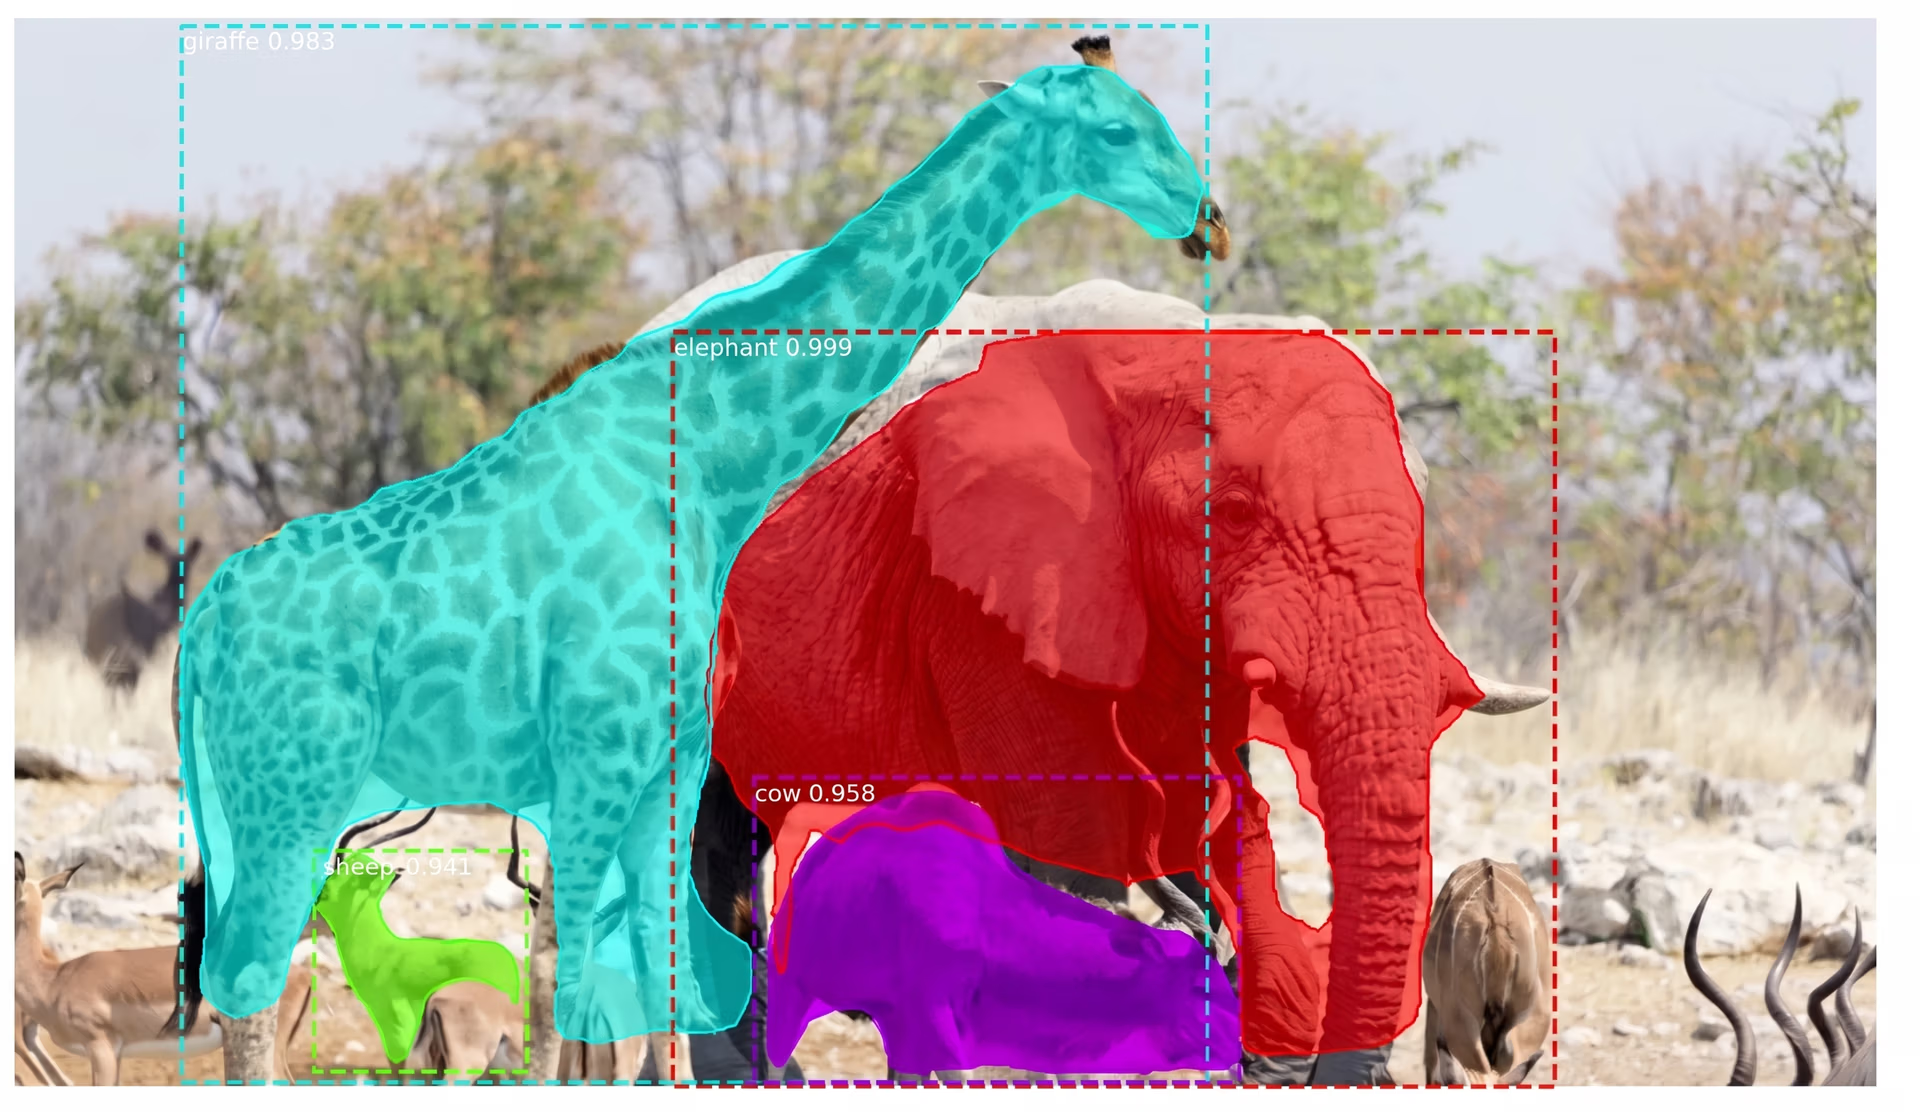
図5. Mask R-CNNによる動物の検出とセグメンテーション。
Mask R-CNNの限界#
オブジェクト検出とセグメンテーションの歴史において重要な意味を持つ一方、Mask R-CNNにはいくつかの大きな欠点もあります。Mask R-CNNに関連する課題を以下に示します。
- 高い計算負荷:高性能なGPUに依存するため、実行コストが高く、大量のデータを処理する際に時間がかかる場合があります。
- 処理速度が遅い:多段階の処理により、YOLOのような高速なリアルタイムモデルと比べて処理が遅く、時間的制約のあるタスクには適さない場合があります。
- 高品質なデータへの依存:モデルは、鮮明で適切にラベル付けされた画像で最も高い性能を発揮します。ぼやけた画像や照明が不十分な画像では、精度が大幅に低下する可能性があります。
- 実装が複雑:多段階のアーキテクチャは、特に大規模なデータセットや限られたリソースを扱う場合、セットアップや最適化が難しいことがあります。
Mask R-CNNからUltralytics YOLO11へ#
Mask R-CNNはセグメンテーションタスクに優れていましたが、多くの業界では、速度とリアルタイム性能を重視しながらコンピュータービジョンを導入する方法が求められていました。この要件を受けて、研究者たちは1回のパスでオブジェクトを検出する1ステージモデルを開発し、効率を大幅に向上させました。
Mask R-CNNの複数段階の処理とは異なり、YOLO(1回だけ見る)のような1段階のコンピュータービジョンモデルは、リアルタイムのコンピュータービジョンタスクに重点を置いています。検出とセグメンテーションを別々に処理するのではなく、YOLOモデルは1回の処理で物体を検出し、セグメンテーションできます。そのため、迅速な意思決定が重要となる自動運転、医療、製造、ロボティクスなどのアプリケーションに適しています。
特にUltralytics YOLO11は(後継モデルはUltralytics YOLO26です)、高速性と精度を兼ね備えることで、さらに一歩進んでいます。YOLOv8mよりパラメーター数が22%少ない一方で、COCOデータセットにおける平均適合率(mAP)はより高く、物体をより正確に検出できます。処理速度も向上しているため、ミリ秒単位の差が重要となるリアルタイムアプリケーションに適しています。
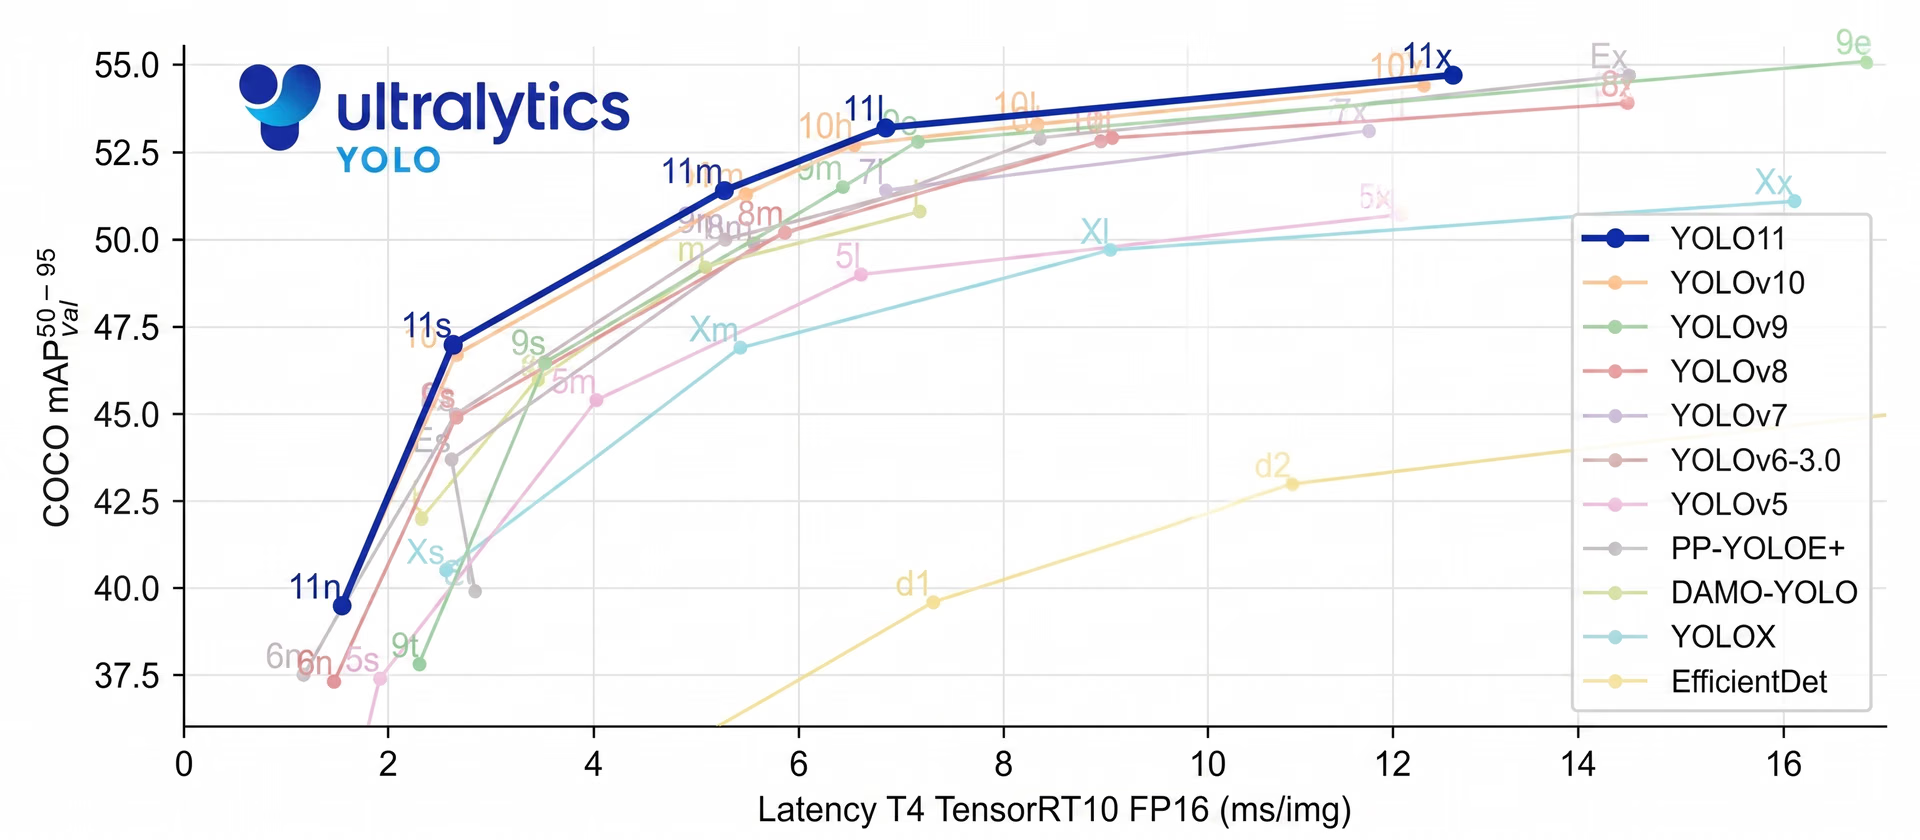
図6。他のモデルと比較したYOLO11の性能。
重要なポイント#
コンピュータービジョンの歴史を振り返ると、Mask R-CNNはオブジェクト検出とセグメンテーションにおける大きなブレークスルーとして知られています。詳細な多段階処理により、複雑な状況でも非常に高精度な結果を出します。
しかし、この処理のため、YOLOのようなリアルタイムモデルと比べて速度が遅くなります。速度と効率への需要が高まるにつれ、現在では多くのアプリケーションで、物体検出を高速かつ高精度に行えるUltralytics YOLO11などの1段階モデルが使われています。Mask R-CNNはコンピュータービジョンの進化を理解するうえで今も重要ですが、リアルタイムモデルへの移行は、より高速で効率的なソリューションへの需要の高まりを反映しています。
成長を続けるコミュニティに参加しましょう!GitHubリポジトリでAIについて詳しく学べます。独自のコンピュータービジョンプロジェクトを始めませんか?ライセンスオプションをご確認ください。農業分野のAIと医療分野のビジョンAIについては、ソリューションページをご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









