Computer Vision (CV)
コンピュータービジョン(CV)は、機械が画像や動画を解釈できるようにするAI分野です。仕組み、主要タスク、用途、課題を解説します。
コンピュータービジョン(CV)は、画像、動画、その他の視覚データから、どの物体が存在するか、どこにあるか、どのように動くか、シーンで何が起きているかといった意味をコンピューターが抽出できるようにする人工知能(AI)の分野です。現代のシステムは、例からこうした能力を学習します。数千枚のラベル付き画像で学習したモデルは、車、ひび割れ、腫瘍を特徴付ける視覚パターンを学び、未見の画像にも適用します。そのため、この分野は現在、機械学習(ML)、そして何よりも深層学習(DL)を基盤としています。
コンピュータビジョンの仕組み#
コンピューターにとって、カラー画像は数値のグリッドです。640×480ピクセルの写真には921,600個の値があり、3つのカラーチャンネルごとに各ピクセルの値を1つずつ持ちます。それぞれの値は0から255までの輝度を表します。コンピュータービジョンパイプラインは、このグリッドを5つの段階で判定に変換します。
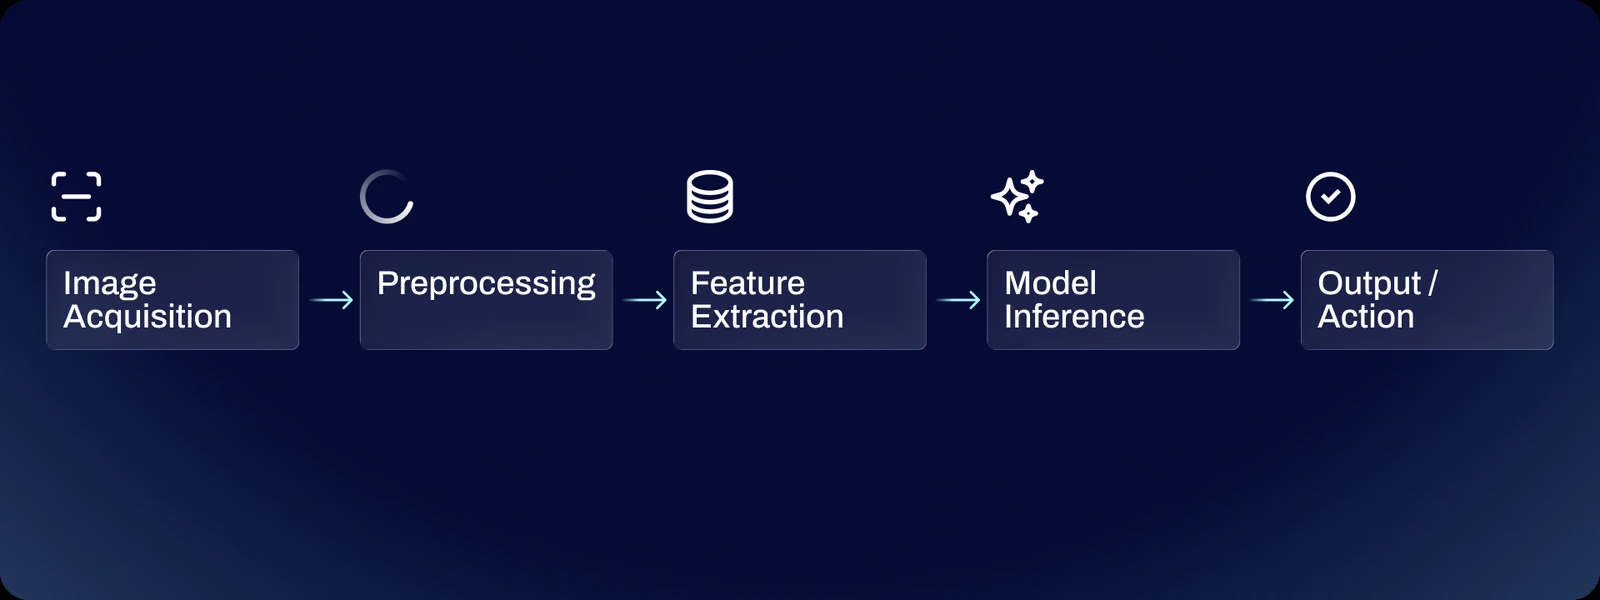
カメラまたはセンサーが画像を取り込み、前処理では多くの場合OpenCVを使って画像のサイズ変更と正規化を行い、モデルが常に同じ形式の入力を受け取るようにします。次にモデルは特徴抽出を行います。畳み込みニューラルネットワーク(CNN)の初期層はエッジや色の勾配に反応し、中間層はそれらを組み合わせてテクスチャや部品を捉え、深い層は物体全体に反応します。Vision Transformer(ViT)は画像をパッチに分割し、自己注意機構を使ってすべてのパッチ間の関係を捉えることで、同様の表現を獲得します。タスク固有のヘッドが特徴量を、クラスラベル、バウンディングボックスの集合、ピクセルマスクなどの出力に変換します。周辺のシステムは、その出力に基づいて不良部品を除外したり、車両にブレーキをかけたり、アラートを発したりします。
モデルは教師あり学習を通じてこれらの特徴量を学習します。学習中、モデルはラベル付き画像に対して予測を行い、損失関数が各予測と正解ラベルの差を測定し、誤差逆伝播法が重みを調整して誤差を縮小します。ラベル付き画像が1,400万枚を超えるImageNetや、日常的な物体を80カテゴリ含むCOCOなどの大規模な公開データセットは、多くのカスタムモデルが転移学習で利用する事前学習の基盤になります。
手作業の特徴量から深層学習へ#
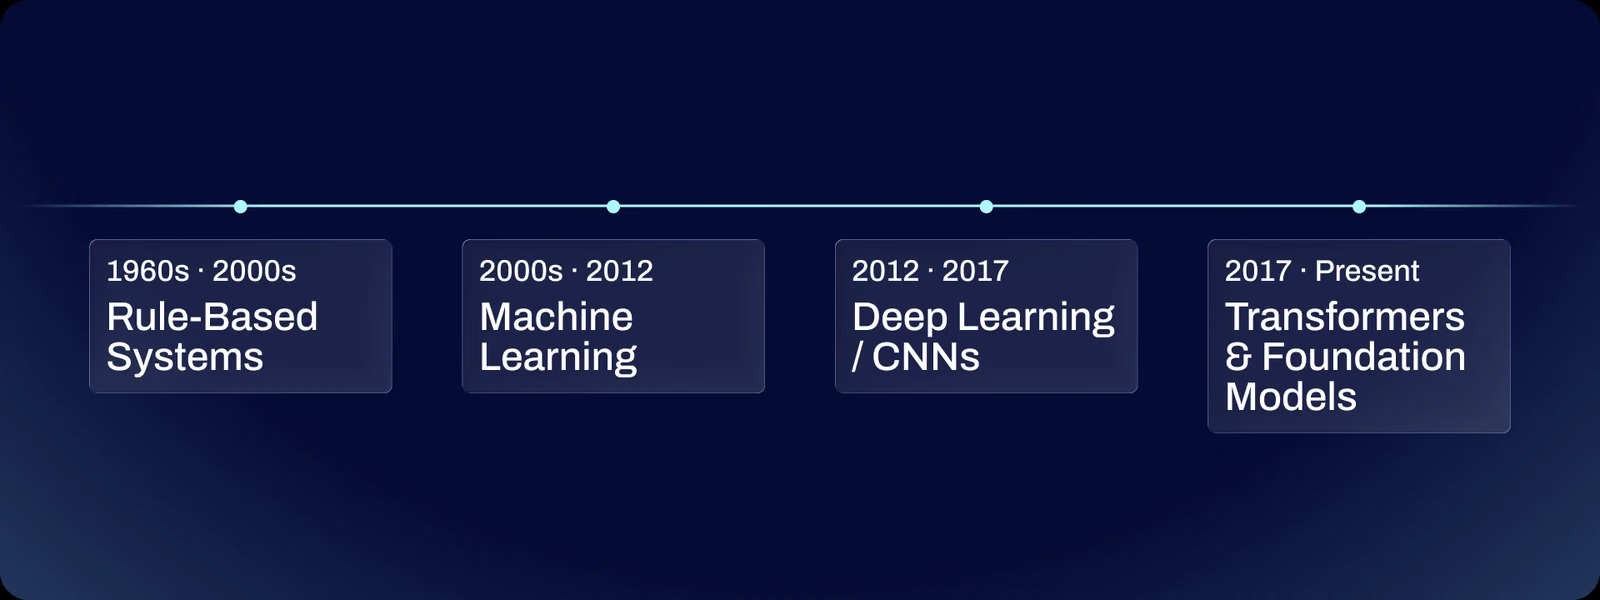
初期のコンピュータービジョンでは、人手で設計した特徴量が使われていました。エンジニアはSIFTやHOGのようなエッジ、コーナー、勾配パターンの検出器を作成し、特徴量を分類器に渡していましたが、照明、視点、背景が変わるとシステムは機能しなくなりました。転換点は2012年に訪れました。AlexNetがImageNetチャレンジでトップ5エラー率15.3%を達成し、次点の26.2%を大きく上回りました。それ以降、CNNや、2020年以降のVision Transformerは、データから直接特徴量を学習しています。視覚言語モデル (VLM)は現在、画像とテキストを組み合わせているため、1つのモデルで写真について自由形式の質問に答えたり、平易な言葉で説明された物体を見つけたりできます。VLM Leaderboardでは、実世界のデータセットでこれらのモデルがどれほど正確に物体を検出するかを測定します。
コンピュータビジョンの主なタスク#
各タスクは、画像について異なる問いに答えます。
- 物体検出:各物体を見つけ、その周囲にクラスと信頼度スコアを付けたボックスを描画します。これにより、物体の位置特定や数え上げが可能になります。
- インスタンスセグメンテーション:各物体に個別のピクセルマスクを割り当てるため、並んで立っている2人を別々に扱えます。
- セマンティックセグメンテーション:各ピクセルに、道路、歩道、空などのクラスを割り当てます。
- 深度推定:単一画像から、各ピクセルがカメラからどれだけ離れているかを予測します。
- 画像分類:画像全体に「不良」や「OK」などのラベルを1つ割り当てます。
- 姿勢推定:身体の関節などのキーポイントを特定し、姿勢や動きを測定します。
- 回転バウンディングボックス(OBB):衛星画像内の船や航空機など、任意の角度にある物体に合わせて回転したボックスを当てはめます。
- 物体追跡:動画フレーム間で検出結果を対応付け、各物体が一貫したIDを保てるようにします。
タスクの選択は、アプリケーションに必要な出力から始めます。
Ultralytics YOLO26は、7つのタスクに1つのPython APIで対応します。同じYOLO()呼び出しで、検出、インスタンスセグメンテーション、セマンティックセグメンテーション、深度推定、分類、姿勢推定、OBBのいずれかのモデルを読み込めます。また、model.track()を追加すると動画のトラッキングが可能です。この例では、サンプル画像に対して物体検出を実行します。
from ultralytics import YOLO

# 学習済みのYOLO26 nano物体検出モデルを読み込む
model = YOLO("yolo26n.pt")

# サンプルの街路画像で推論を実行する
results = model("https://ultralytics.com/images/bus.jpg")
result = results[0]

# クラスごとの検出物体数を出力し、アノテーション画像を保存する
print(result.verbose())
result.save(filename="bus_detections.jpg")出力行にはクラスごとの検出数が示され、保存された画像には各検出結果のボックス、ラベル、信頼度スコアが描画されます。
コンピュータービジョンと関連分野#
- 画像処理:シャープ化、ノイズ除去、リサイズ、コントラスト調整などにより、画像を別の画像へ変換します。コンピュータービジョンパイプラインでは、シーンを解釈する前の前処理としてこうした処理を使います。
- マシンビジョン:検査やロボットのガイダンスにコンピュータービジョンを応用する産業分野です。通常、生産ラインで固定カメラ、制御された照明、専用ハードウェアを使用します。
- 画像認識:画像分類と同義で使われる一般的な用語です。画像に何が含まれているかを特定するあらゆるタスクを指す、広い意味で使われることもあります。
実際のアプリケーション#
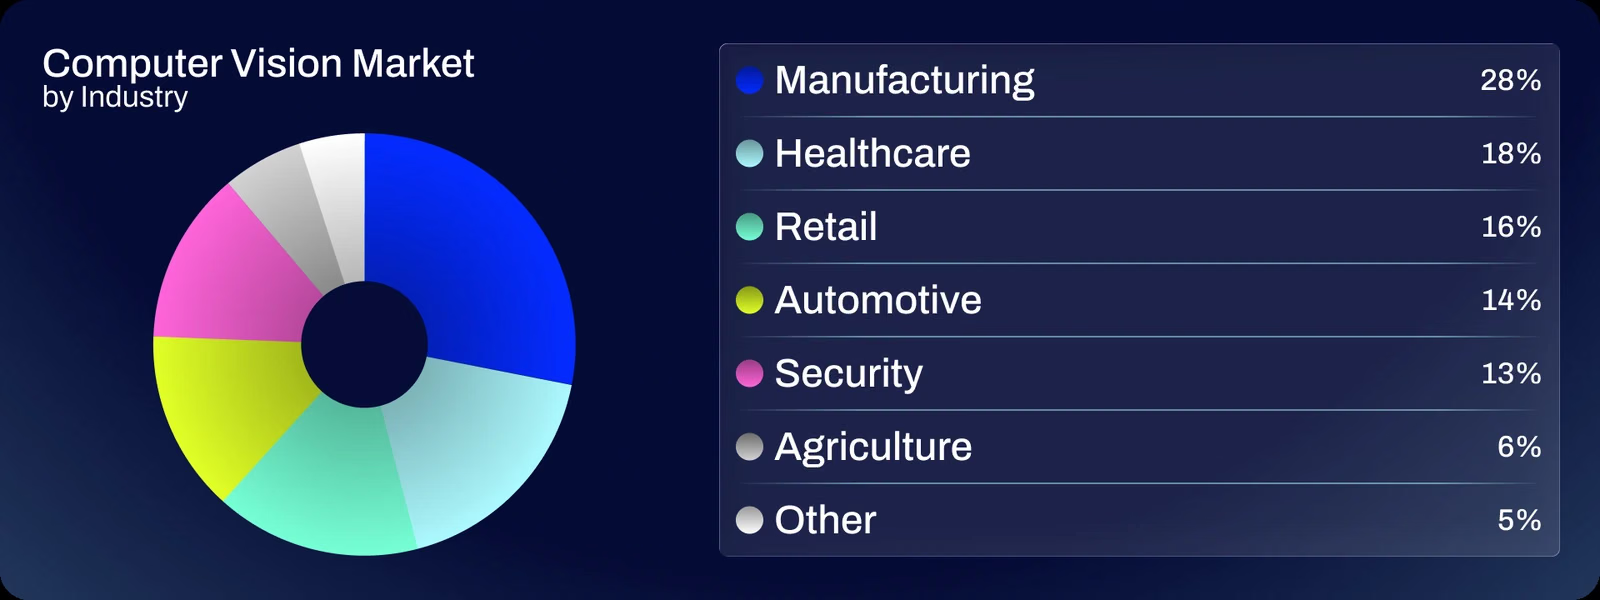
- 製造業:カメラが生産ラインの速度に合わせてすべての部品を検査し、ひび割れ、傷、部品のずれを見つけます。また、機械が故障する前に摩耗を追跡します。
- 医用画像:モデルがX線、CTスキャン、眼底写真から腫瘍、骨折、網膜疾患の疑いを検出し、放射線科医による確認を支援します。
- 自動運転車:車両はリアルタイムで車線、標識、歩行者、他の車両を検出し、カメラの出力をレーダーやLiDARと統合して周囲の3Dモデルを作成します。
- 小売業:棚のカメラで商品棚の空きや商品の置き間違いを検出します。また、レジなし店舗では、買い物客が手に取った商品を追跡します。
- 農業:ドローンや散布機が植物ごとに作物と雑草を見分けるため、除草剤や肥料を必要な場所だけに散布できます。
- セキュリティとスマートシティ:システムは人や車両の数を数え、交通の流れを監視し、異常検知を使って制限区域内の不審な出来事を検出します。
課題と限界#
モデルの性能は学習セットの品質に左右されます。数千枚の画像にボックスやマスクを描くデータラベリングには、モデル自体の学習より多くの労力がかかることもよくあります。デプロイ後には、雨、まぶしさ、夜間照明、遮蔽、カメラの移動などによって、入力が学習時にモデルが見たデータからずれることもあります。データ拡張は学習時にこうした状況を再現し、学習に使わなかった画像での検証はリリース前に過学習を検出します。
次の制約となるのは計算資源です。カメラ、ドローン、スマートフォンは厳しい電力とメモリの上限内でモデルを実行するため、エッジAIのデプロイでは、小型モデルとモデル量子化を活用して、動画をクラウドに送信せずにリアルタイム処理速度を実現します。
人を分析するシステムには、バイアスやプライバシーに関する懸念があります。一部のグループを十分に含まないデータセットでは、グループによって性能に差が生じるモデルが作られます。また、ほとんどのプライバシー法では、顔や身体のデータは機微な個人データに該当します。2025年2月以降、EU AI Actは、誘拐被害者の捜索や差し迫ったテロの脅威の防止など、限られた例外を除き、法執行機関が一般に公開されている場所でリアルタイムの遠隔生体認証を行うことを禁止しています。









