人間参加型アノテーションが重要な理由を解説
人手でアノテーションしたデータがコンピュータービジョンモデルの精度を高める仕組みと、信頼性の高いビジョンAIシステムに人間の専門知識が今も不可欠な理由をご紹介します。
 Abirami Vina10 分で読めます
20年前、家事を手伝ってくれるロボットを導入しようと考えていると言えば、かなり現実離れした話に聞こえたでしょう。しかし今、私たちはAIブームの真っただ中にあり、ロボットが同様の状況でテストされています。
この進歩を牽引するAIの重要な分野がコンピュータービジョンです。コンピュータービジョンによって、機械は画像や動画を理解できるようになります。つまり、Ultralytics YOLO11や新しいUltralytics YOLO26などのコンピュータービジョンモデルは、視覚データとアノテーションで構成されるデータセットを使って学習できます。
アノテーションは、モデルが視覚データを理解するのに役立ちます。たとえば、物体検出データセットでは、関心対象の物体を長方形で囲むバウンディングボックスを使います。これにより、シーンが複雑な場合や物体の一部が隠れている場合でも、モデルは新しい画像内でそれらの物体を検出して位置を特定できます。
ほかのコンピュータービジョンタスクでは、それぞれ異なる種類のアノテーションを使用します。セグメンテーションデータセットでは物体の正確な輪郭をピクセル単位でラベル付けし、キーポイントデータセットでは人物の関節など、特定の目印を示します。
ただし、すべての形式において重要なのは、ラベルの品質と一貫性です。モデルは学習に使うデータから直接学習するため、ラベルに一貫性がなかったり誤りがあったりすると、モデルはその間違いを予測に反映してしまうことがよくあります。
自動化が進んでも、特に医用画像のような重大な影響を伴う分野では、人手でアノテーションしたデータセットが依然として重要です。腫瘍の境界が不正確だったり、異常を見逃したりする小さなラベル付けの誤りが、モデルに誤ったパターンを学習させ、後に安全性を損なう予測につながる可能性があります。人間の専門家は、こうした用途に必要な正確なグラウンドトゥルースと判断を提供します。
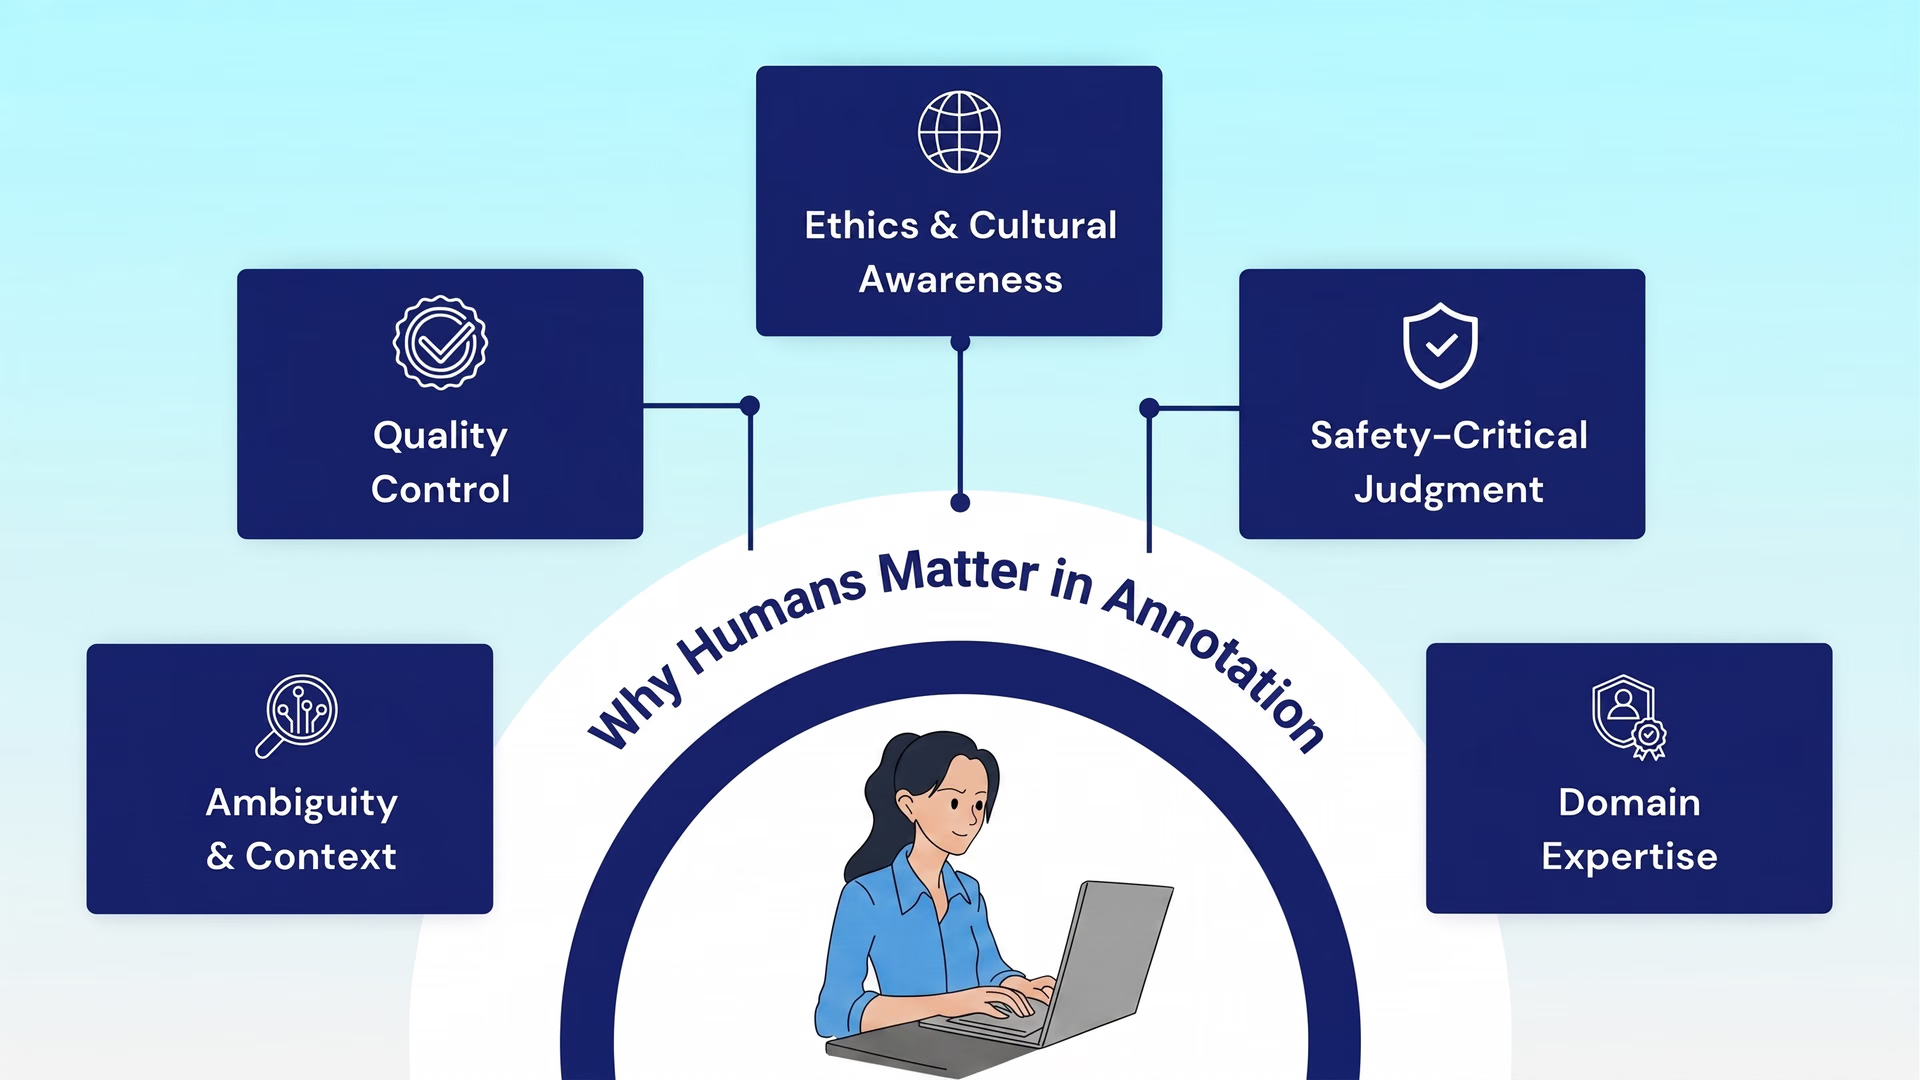
図1. 人手でアノテーションしたデータセットが必要です。画像提供: 著者。
この記事では、AIが進化し続けるなかでも、人手でアノテーションしたデータが不可欠である理由を詳しく見ていきます。
画像と動画のアノテーションの必要性#
コンピュータービジョンモデルは、私たちと同じように、多くの例を見ることで学習します。異なるのは、人間があらかじめラベルを付けた大量の画像や動画のデータセットで学習する点です。これらのラベルがグラウンドトゥルースとなり、「これは歩行者です」「ここが腫瘍の境界です」「あの物体は自動車です」といった情報をモデルに教えます。
現実世界の画像は、きれいで一貫しているとは限りません。照明が変化すると、同じ物体でも違って見えることがあります。人や車両が重なったり、一部が隠れたりすることもあります。背景が複雑で、注意をそらす場合もあります。こうした状況を含むデータセットに、丁寧で一貫性のあるラベルが付けられていれば、モデルは制御された環境の外で直面する状況に、はるかに適切に備えられます。
データアノテーションは、単にボックスを描いたり輪郭をなぞったりするだけではありません。ガイドラインを適用し、何を対象物とみなすか、その境界をどこに設定するか、不明瞭な場合にどう対処するかについて、実務的な判断を下す作業も含まれます。人間の判断によって、データの正確性と実用性が保たれます。
最終的に、コンピュータビジョンシステムの性能は、学習に用いるラベル付きデータの品質に左右されます。スキャン画像からがんを発見したり、自動運転車向けに道路上の危険を検出したりするような、影響の大きい用途では、熟練者による正確なラベル付けが精度と安全性に大きな違いをもたらします。
データアノテーションにおける自動化の広がり#
コンピュータービジョンが拡大し、データセットが増えるにつれて、アノテーションを迅速化する一般的な方法として自動化が広がっています。すべてを手作業でラベル付けする代わりに、チームはAIモデルを使ってラベルの初稿を作成します。
その後、人間が結果を確認し、誤りを修正し、モデルが確信を持ってラベル付けできないケースに対応します。この方法により、品質を高く保ちながらアノテーションを迅速化できます。
自動化がデータアノテーションに役立つ一般的な方法をいくつか紹介します。
- 自動セグメンテーション:モデルは物体の輪郭やピクセル単位のマスクを自動的に提案できるため、アノテーターが手作業で輪郭を描く作業を減らせます。
- オプティカルフロートラッキング:動画では、トラッキング手法によってフレーム間で移動する物体を追跡し、そのラベルを次のフレームに引き継げるため、時間の経過に伴うアノテーションの一貫性を保ちやすくなります。
- フレーム補間:ツールは動きやトラッキングの手掛かりを使い、ラベル付け済みの2つのフレームの間にあるフレームのラベルを補完できます。そのため、アノテーターがすべてのフレームにラベルを付ける必要はありません。
- アクティブラーニング:学習パイプラインは、モデルが不確実または通常と異なると判断したサンプルを特定し、優先的に人間へ送ることができます。そのため、手作業の労力を性能向上に最も役立つデータに集中できます。
人間によるデータアノテーションが今も重要な理由#
自動化によってラベル付けを迅速化できますが、AIモデルの正確性と信頼性を保つには、今も人間の判断が必要です。
データアノテーションで人間の専門知識が力を発揮する主な領域をいくつか紹介します。
- 文脈の理解:現実の画像や動画は複雑なことがよくあります。影、反射、モーションブラー、物体の重なりは、自動化ツールを混乱させることがあります。人間のアノテーターは実際に何が起きているかを解釈できるため、より正確なラベルを付けられます。
- ラベルの一貫性の維持:データセットが大きくなるにつれ、自動生成されたラベルにばらつきが生じたり、バッチごとに変化したりすることがあります。人間がラベルを監査、修正、調整することで、データセット全体の一貫性を保てます。
- バイアスと害の低減:人間は、センシティブなコンテンツ、文化的なニュアンス、バイアスにつながる可能性のあるパターンを見つけることに長けています。人間による監督は、データセットの公平性を高め、意図しない害を防ぐのに役立ちます。
- 専門分野の知識の適用:医療上の異常や産業上の欠陥の特定など、一部のタスクには専門分野の知識が必要です。専門家は正確なラベルを付け、曖昧なケースを解決することで、モデルが適切な詳細を学習できるようにします。
人間参加型アノテーションの概要#
Roboflowなどのアノテーションツールやプラットフォームは、自動化を統合してラベル付けを効率化しています。その際、Segment Anything Model 3やSAM 3などの基盤モデルがよく使用されます。SAM 3は、Meta AIのプロンプト対応セグメンテーション基盤モデルです。
このモデルは、クリック、バウンディングボックス、短いテキストフレーズなどの簡単なプロンプトを使って、画像や動画内の物体を検出、セグメンテーション、追跡できます。新しいカテゴリごとにタスク固有の学習を行わなくても、該当する物体のセグメンテーションマスクを生成します。
こうした高度な手法を使っても、アノテーションの確認と仕上げには人間の専門家が必要です。自動ツールで初稿を作成し、人間が内容を検証、修正、改良するワークフローは、人間参加型アノテーションと呼ばれます。これにより、アノテーションを迅速に行いながら、信頼性の高いモデルの学習に十分な精度と一貫性を備えた最終ラベルを確保できます。
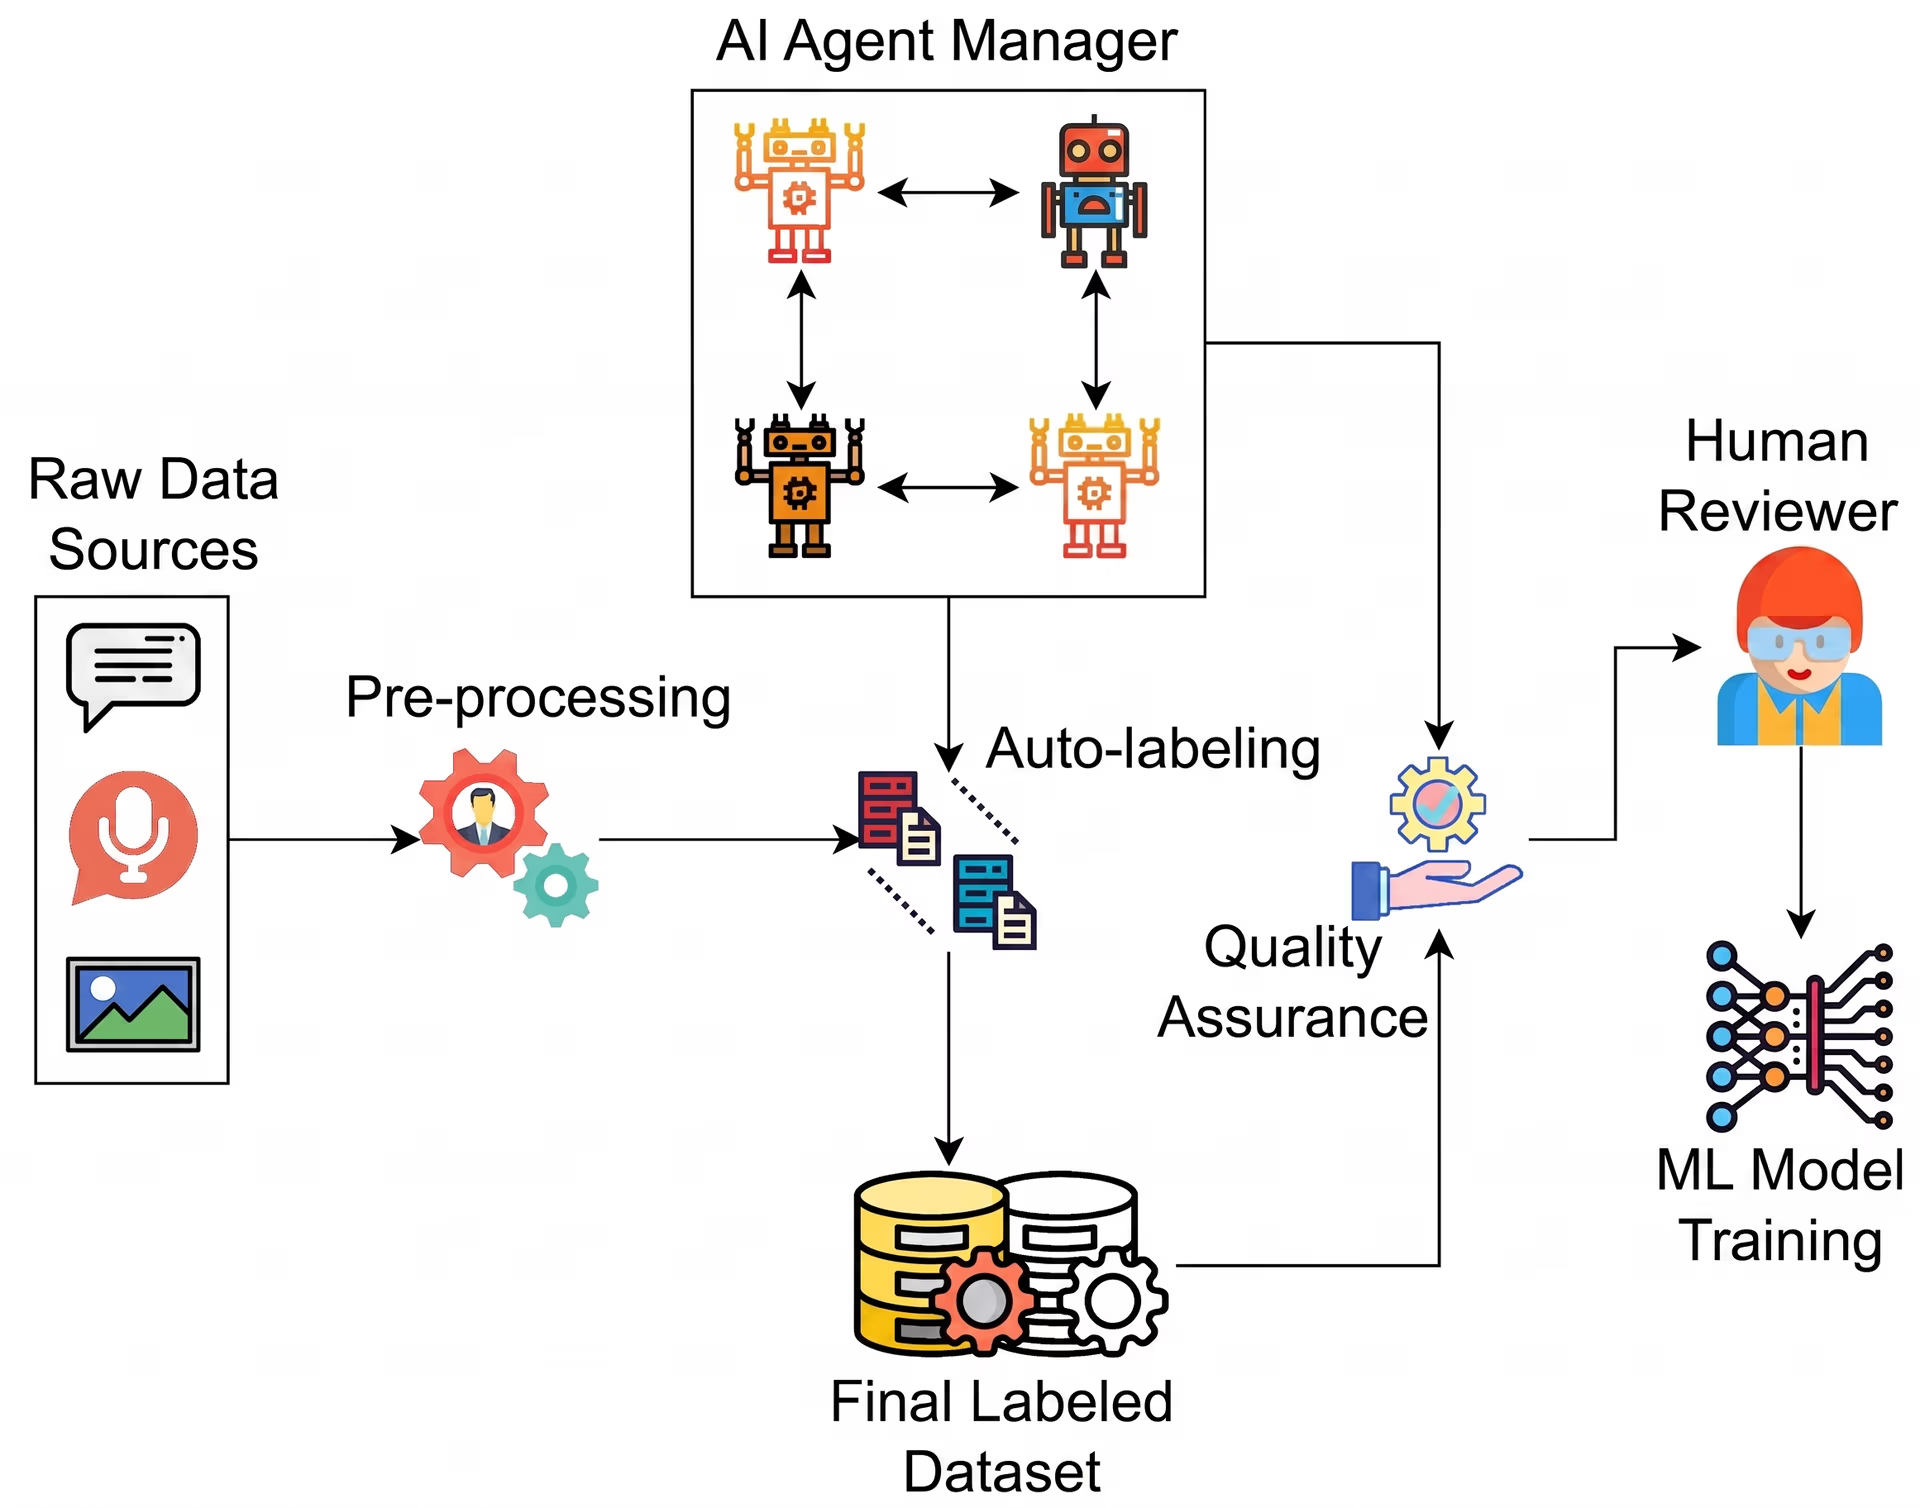
図2. 人間参加型アノテーションの概要。(出典)
アノテーションの自動化が有効な場合とそうでない場合#
自動アノテーションは、管理された環境から得られたデータに最も効果を発揮します。工場、倉庫、小売店の通路で収集された画像は、照明が安定し、物体がはっきり見えることが一般的です。そのため、自動化ツールで正確にラベル付けしやすく、手作業を減らしながらチームの規模を迅速に拡大できます。
管理が行き届いていない環境のデータは、より複雑です。屋外映像は時間帯や天候によって変化し、道路や住宅のシーンには、散らかった背景、モーションブラー、物体同士の遮蔽、重なりが多く含まれます。小さな物体、細かな境界、まれな状況も、誤りが生じる可能性をさらに高めます。きれいな屋内データで優れた性能を発揮するモデルでも、雑多な現実世界の画像では苦戦することがあります。
そのため、人間の関与が今も重要です。モデルが確信を持てないときに人間が介入し、難しい文脈を解釈し、最終的なデータセットに反映される前に誤りを修正できます。人間参加型アノテーションは、自動化を現実世界の状況に即したものにし、デプロイ後もモデルの信頼性を保つのに役立ちます。
人間参加型アノテーションは、どのような場面で役立つのでしょうか?#
自動化が有効な場面と限界がある場面を確認したところで、人間参加型アノテーションが重要な役割を果たす用途をいくつか見ていきましょう。
製造業における欠陥検出#
毎分何百もの部品がカメラの下を通過する、工場のコンベヤーベルトを想像してください。ほとんどの欠陥は明らかですが、ときには微細な亀裂が不自然な角度で現れたり、照明の反射に隠れたりします。自動化システムは見逃したり、無害な表面の質感としてラベル付けしたりするかもしれませんが、人間のレビュアーなら欠陥を見つけ、アノテーションを修正し、モデルが違いを学習できるようにします。
これが、産業検査における人間参加型アノテーションの役割です。自動化によって一般的な欠陥の種類に事前にラベルを付け、大量の画像を迅速に処理できますが、結果の検証、境界の精緻化、学習時にあまり現れないまれな不具合への対応には、依然として人間の作業が必要です。
自動運転車とスマート交通#
同様に、自動運転車はコンピュータビジョンで歩行者を検知し、標識を読み取り、交通状況を把握しますが、実際の道路は予測できません。たとえば、夜間に駐車車両の陰から歩行者が現れると、一部が隠れ、まぶしい光の下で見えにくいことがあります。
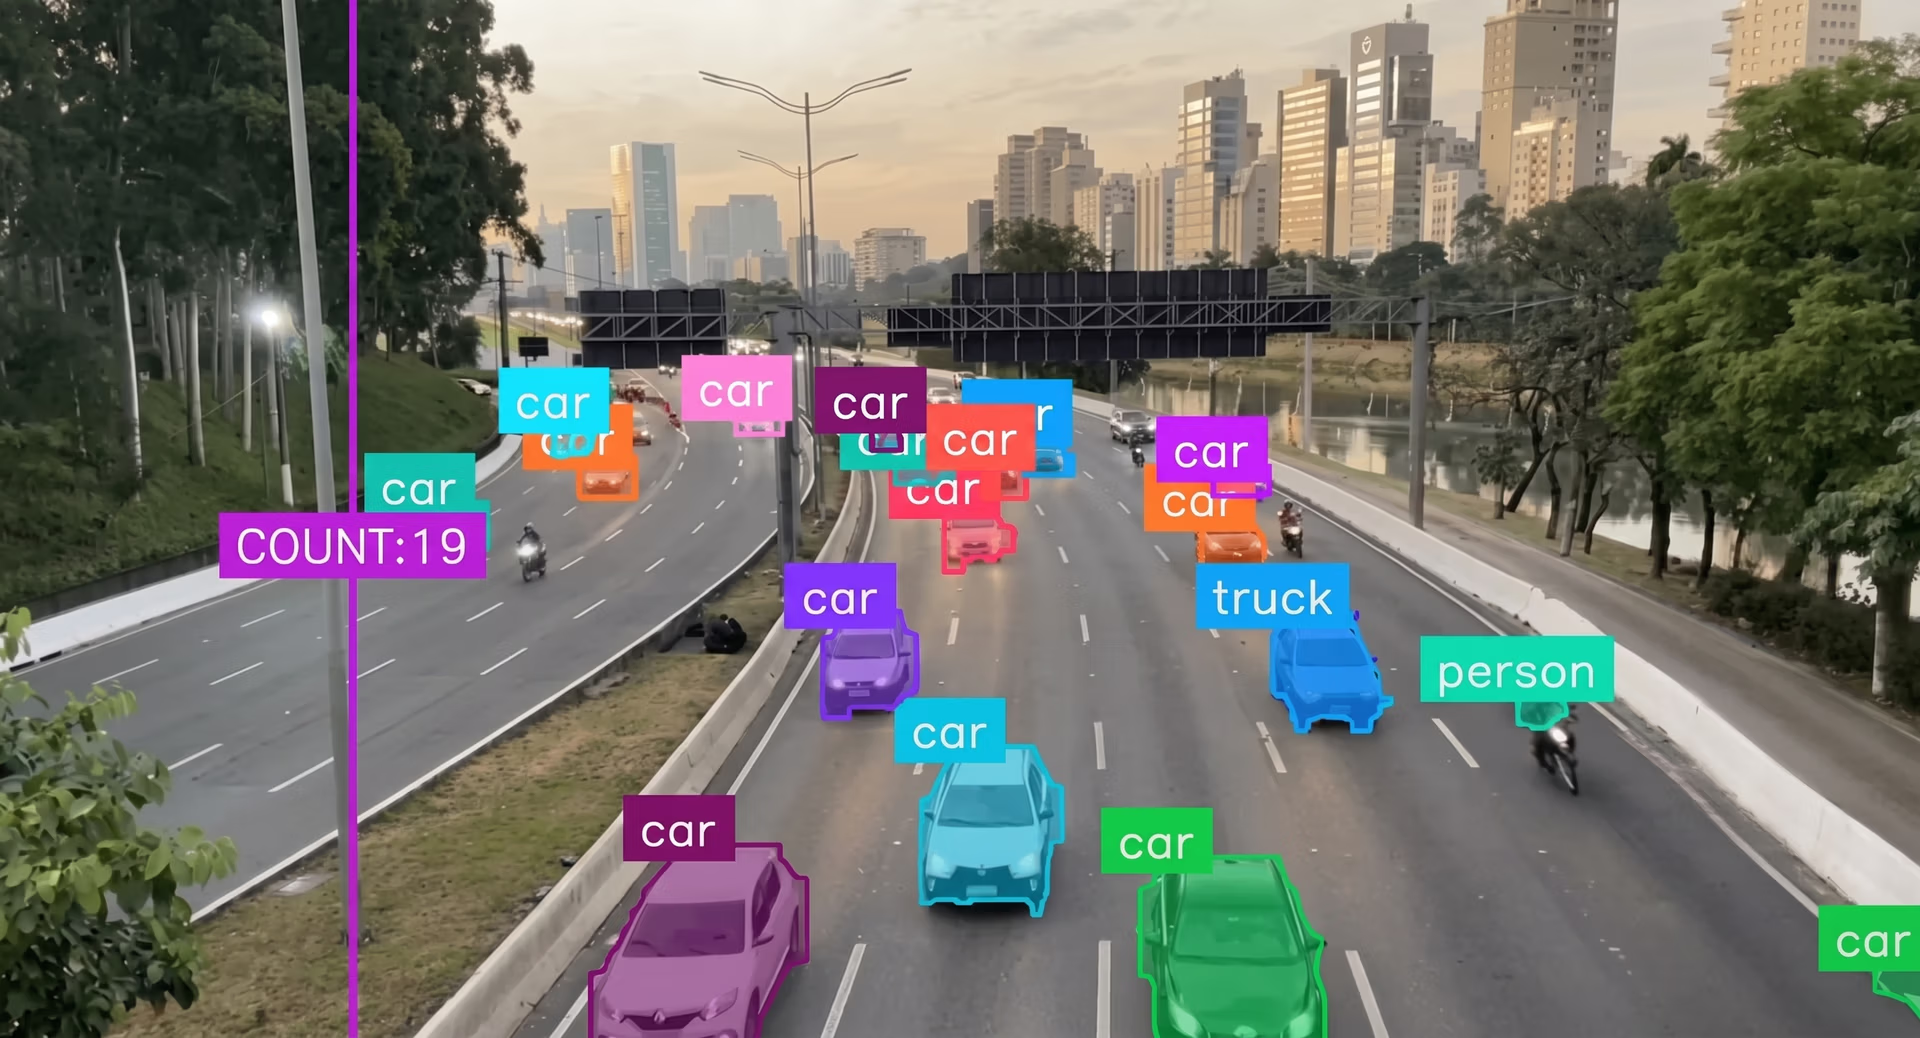
図3. コンピュータビジョンを使った交通状況の分析例。(出典)
人間のアノテーターは、こうしたまれで安全性に関わるエッジケースに学習時のラベルを付け、通常の状況だけでなく、最も重要な場面でもモデルが適切に対応できるようにします。この人間参加型の工程は、自動化だけでは捉えにくい低頻度の事象への対処をシステムに学習させるうえで重要です。
人間がアノテーションしたデータセットの今後#
技術の進歩に伴い、人間参加型アノテーションはより協調的になっています。興味深いことに、画像とテキストの両方から学習する視覚言語モデル(VLM)が、ラベルの初稿を作成したり、簡単なプロンプトから修正案を提案したりするために使われ始めています。
そのため、アノテーターは各画像を手作業で確認してラベルを決める代わりに、VLMに「歩行者、車、信号機をすべてラベル付けして」や「この部品の欠陥をすべてセグメンテーションして」のようなフレーズを入力し、確認用のアノテーション案を取得できます。Ultralytics Platformでは、チームが視覚言語モデルを使って検出データセットを自動アノテーションでき、VLM Leaderboardでは各モデルが実世界の画像をどれほど正確にラベル付けするかを比較できます。
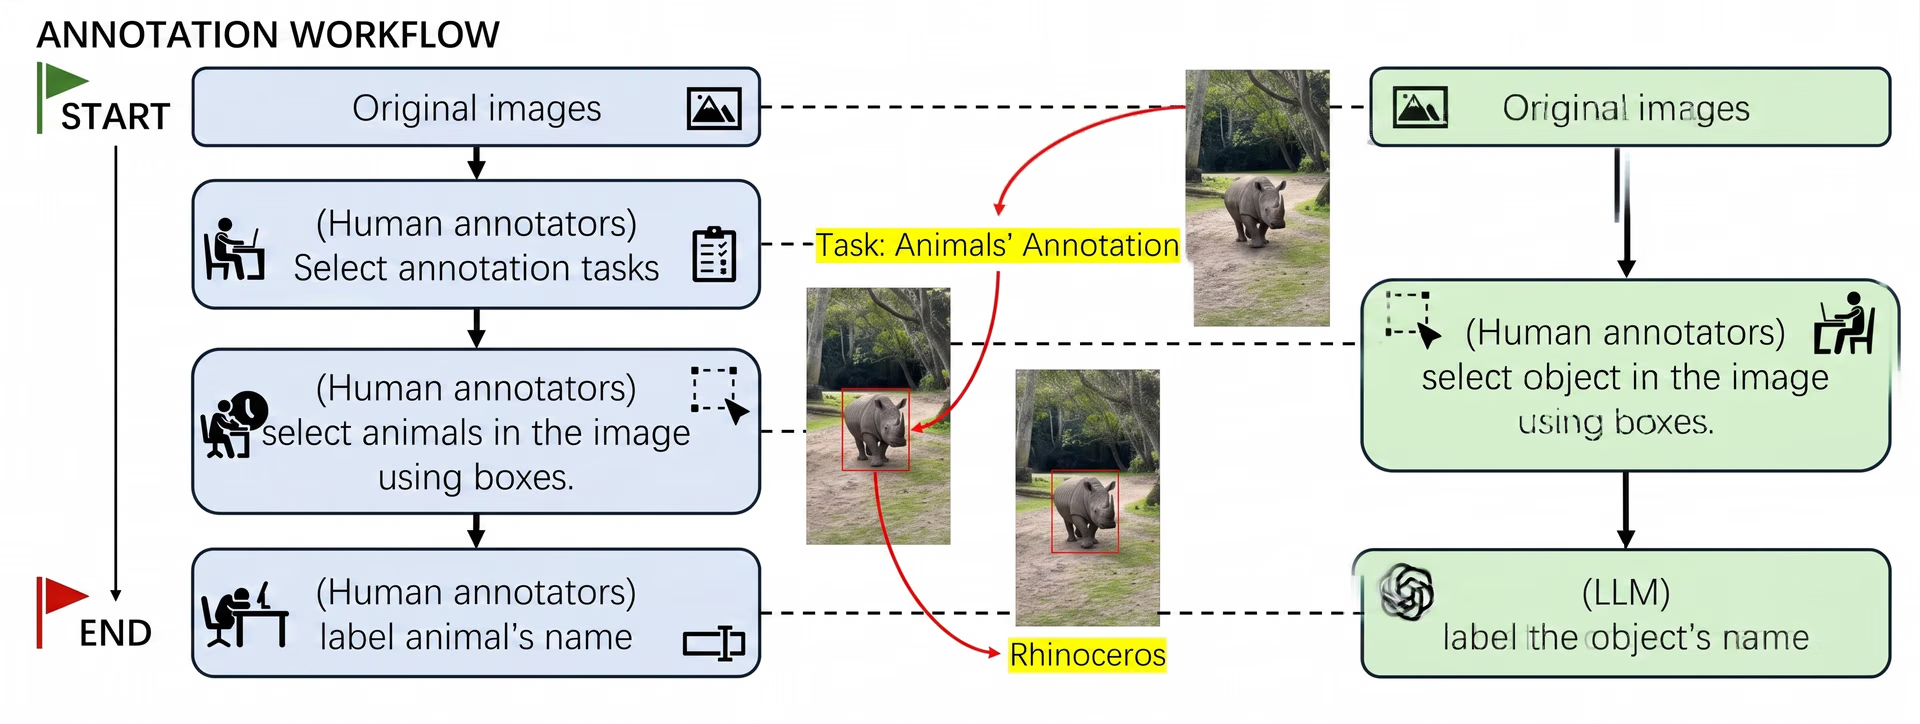
図4. 大規模マルチモーダルモデルは人間のアノテーターと連携できます。(出典)
モデルが多くの単純なケースを先に処理できるため、アノテーションにかかる時間が短縮され、人間は結果の確認、難しい例の修正、データセットの一貫性維持に集中できます。大規模マルチモーダルモデルは、確信度が最も低いサンプルへアノテーターを誘導し始めており、人間の作業をより的確に振り向け、データセット全体の品質を高めています。
重要なポイント#
コンピュータビジョンは、機械が見たものを解釈して反応するのに役立ちますが、人間の専門知識を組み合わせることで最も効果を発揮します。人間がアノテーションしたデータは、モデルを現実世界の状況に即したものにし、性能の信頼性を高めます。自動化と人間の判断を組み合わせることで、チームは大きな効果をもたらすビジョンシステムを構築できます。
活発なコミュニティに参加し、物流におけるAIやロボティクスにおけるビジョンAIなどのイノベーションをご覧ください。GitHubリポジトリでは、さらに詳しい情報を確認できます。今すぐコンピュータービジョンを始めるには、ライセンスの選択肢をご覧ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









