Acelerando o Ultralytics YOLO26 com OpenVINO na Intel Core Ultra Series 3 (Panther Lake)
Saiba como exportar modelos Ultralytics YOLO26 para o formato OpenVINO e acelerar a inferência em hardware Intel, incluindo CPU, GPU e NPU.
Nos últimos anos, a IA e a visão computacional deixaram de ser experimentais e passaram a ser parte essencial das operações diárias das empresas. De fato, pesquisas mostram que cerca de 88% das organizações já usam IA em pelo menos uma área dos seus negócios.
No entanto, transformar essa adoção em valor real, seja em sistemas de produção ou em projetos pessoais, muitas vezes depende de quão bem os modelos realmente funcionam depois de implantados. Em muitos cenários do mundo real, modelos de visão computacional, como o Ultralytics YOLO26, são implantados em dispositivos de borda e em diversos tipos de hardware, geralmente CPUs, GPUs integradas ou NPUs, em vez de GPUs de ponta.
É aí que o desempenho pode começar a variar e que a otimização se torna essencial. Um modelo que funciona bem em um ambiente pode ter dificuldades em outro se não for otimizado adequadamente para o hardware subjacente.
Para simplificar esse processo, o pacote Python da Ultralytics permite exportar modelos YOLO26 para formatos otimizados, como OpenVINO, para que funcionem sem problemas em hardware Intel sem exigir mudanças no seu fluxo de trabalho.
Por exemplo, quando um modelo Ultralytics YOLO26 é exportado para o formato OpenVINO, ele pode funcionar com mais eficiência nos processadores Intel Core Ultra Series 3, com velocidades de inferência na GPU até três vezes maiores.
Neste artigo, vamos explorar como a integração atualizada entre Ultralytics e OpenVINO facilita a implantação de modelos YOLO26 em hardware Intel Core Ultra Series 3. Vamos começar!
Visão geral da integração entre Ultralytics e OpenVINO#
O pacote Python da Ultralytics oferece uma única interface para treinar, executar inferência e implantar modelos Ultralytics YOLO, como o YOLO26. Ele oferece suporte a várias integrações que ajudam em diferentes etapas do fluxo de trabalho de IA de visão, desde o treinamento e a experimentação até a implantação e a otimização.
Uma das integrações voltadas à implantação é com o kit de ferramentas OpenVINO, que permite exportar modelos Ultralytics YOLO26 para um formato otimizado para hardware Intel. Esse processo converte modelos YOLO para um formato que funciona com mais eficiência em CPUs, GPUs e NPUs Intel, incluindo sistemas equipados com processadores Intel® Core™ Ultra™.
Isso simplifica a execução de modelos em diferentes dispositivos Intel, sem precisar ajustá-los manualmente para cada configuração. Seja em uma máquina local, em um dispositivo de borda ou em uma implantação de maior escala, o mesmo modelo exportado pode ser reutilizado.
O que torna essa integração especialmente prática é a facilidade com que ela se encaixa no fluxo de trabalho existente da Ultralytics. Você pode exportar um modelo pela mesma interface que usa para treinamento e inferência, sem precisar de ferramentas adicionais ou de uma configuração complexa.
Depois de exportado, o modelo pode ser usado para inferência pelo pacote Python da Ultralytics ou pelo OpenVINO Runtime, dependendo do nível de controle e flexibilidade de que você precisa.
Um olhar mais atento ao OpenVINO e ao hardware Intel Panther Lake para inferência de IA#
Antes de vermos com que eficiência um modelo Ultralytics YOLO26 exportado pode funcionar em hardware Intel, vamos dar um passo atrás e entender como o OpenVINO e o hardware Intel trabalham juntos para permitir inferência eficiente.
O OpenVINO é um kit de ferramentas de código aberto projetado para otimizar e executar inferência de IA em hardware Intel, incluindo CPUs, GPUs integradas e NPUs. Ele oferece um ambiente de execução unificado, permitindo executar o mesmo modelo nessas diferentes unidades de computação sem precisar reescrevê-lo.
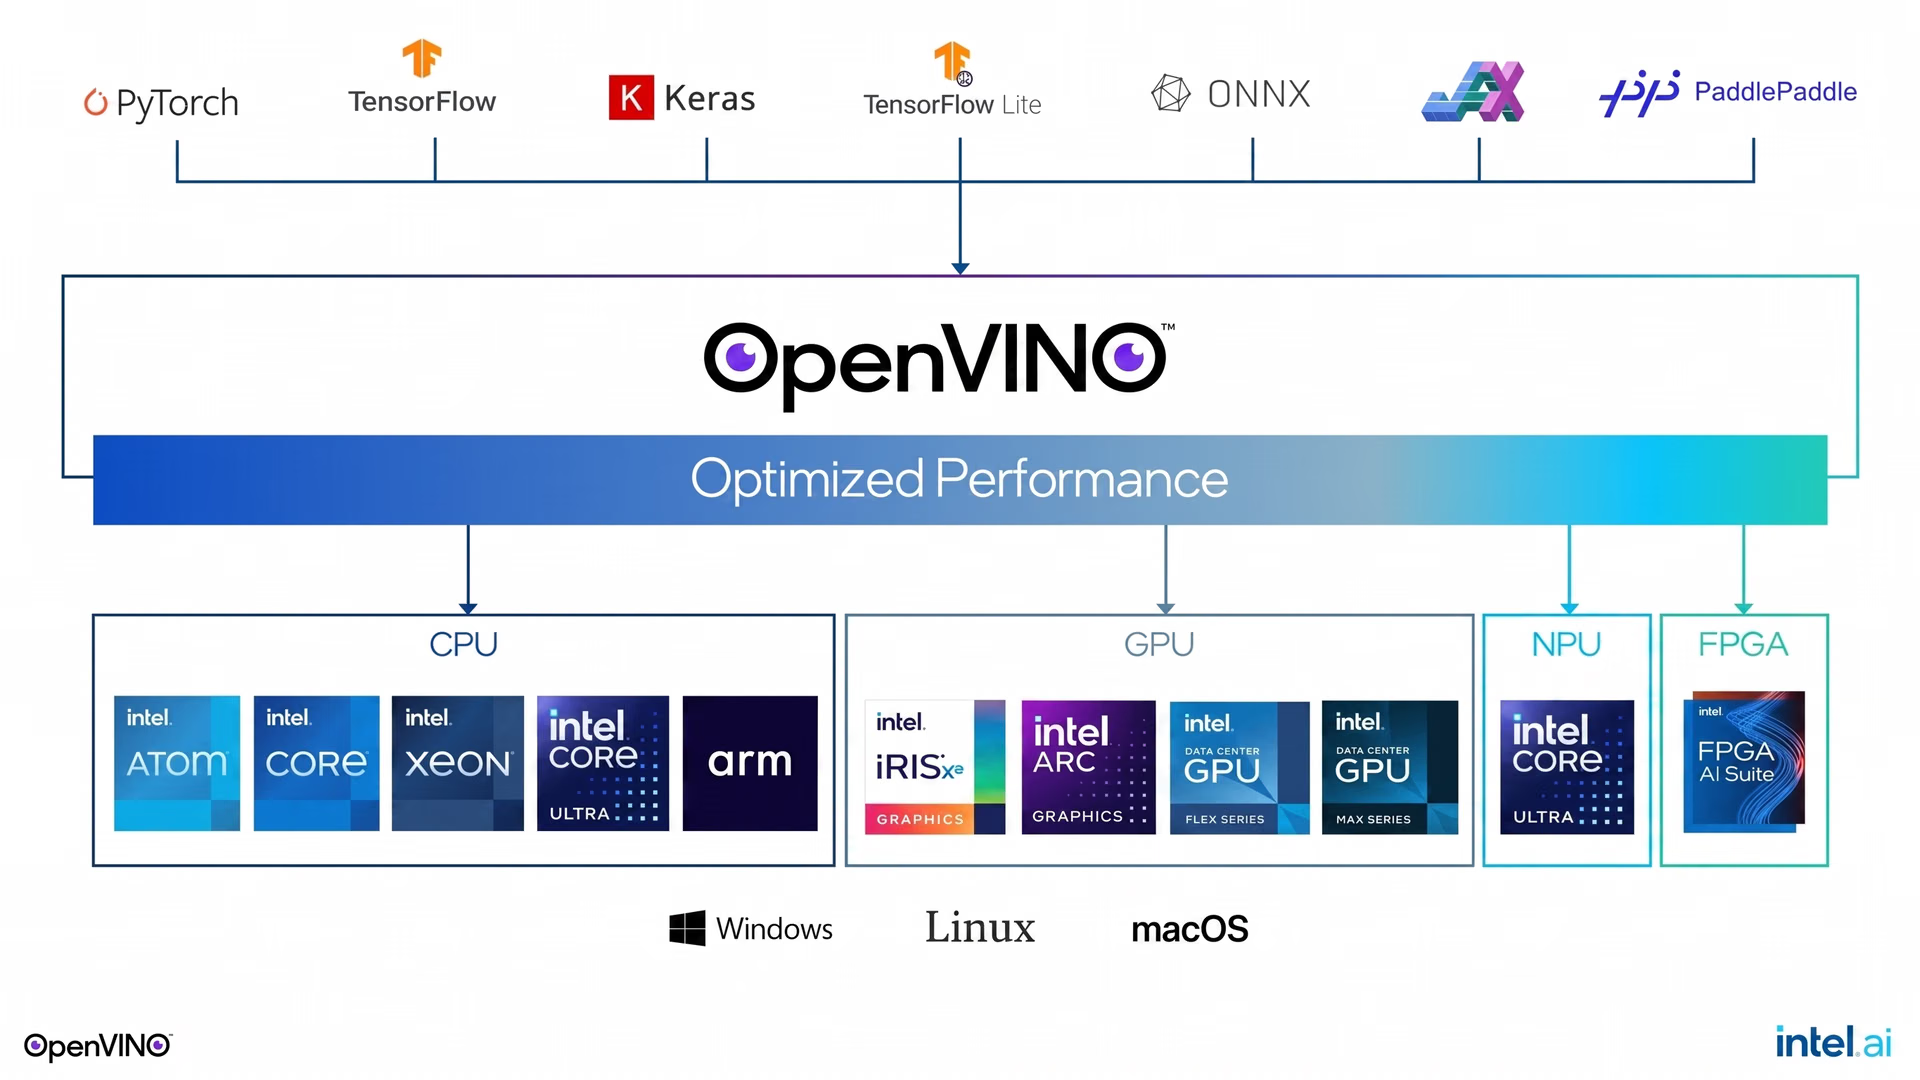
Fig. 1. O OpenVINO facilita a implantação de modelos em vários tipos de hardware. (Fonte)
Nos novos processadores Intel® Core™ Ultra™ Series 3 (codinome Panther Lake), as cargas de trabalho de IA são executadas em várias unidades de computação dentro do mesmo processador. Cada chip combina núcleos de CPU para tarefas de uso geral, uma GPU integrada para processamento paralelo e uma NPU dedicada, projetada especificamente para inferência de IA.
O OpenVINO oferece uma API unificada que permite direcionar qualquer uma dessas unidades de computação — CPU, GPU ou NPU — sem alterar o código. Basta especificar em qual dispositivo executar a inferência durante a execução, o que facilita alternar entre as três opções de acordo com as suas necessidades de desempenho e eficiência.
Benchmarking do Ultralytics YOLO26 na série Intel® Core™ Ultra™#
Ao explorar a integração entre Ultralytics e OpenVINO, talvez você esteja se perguntando: que ganhos de desempenho pode esperar ao exportar YOLO26 para o formato OpenVINO?
A diferença na velocidade de inferência fica evidente ao comparar modelos YOLO26 em diferentes formatos e níveis de precisão. Por exemplo, ao executar a variante nano do YOLO26 (YOLO26n) em um Intel Core Ultra X7 358H, um processador Panther Lake, o tempo de inferência cai de 25,18 ms por imagem com PyTorch em precisão FP32 para 2,64 ms com OpenVINO na mesma precisão e usando a NPU integrada.
Isso é mais rápido do que a referência original do PyTorch em FP32, o que pode fazer uma diferença significativa em aplicações em tempo real e de borda, nas quais a latência é essencial. Esses ganhos ficam ainda mais evidentes ao executar o mesmo modelo na GPU Intel Arc integrada.
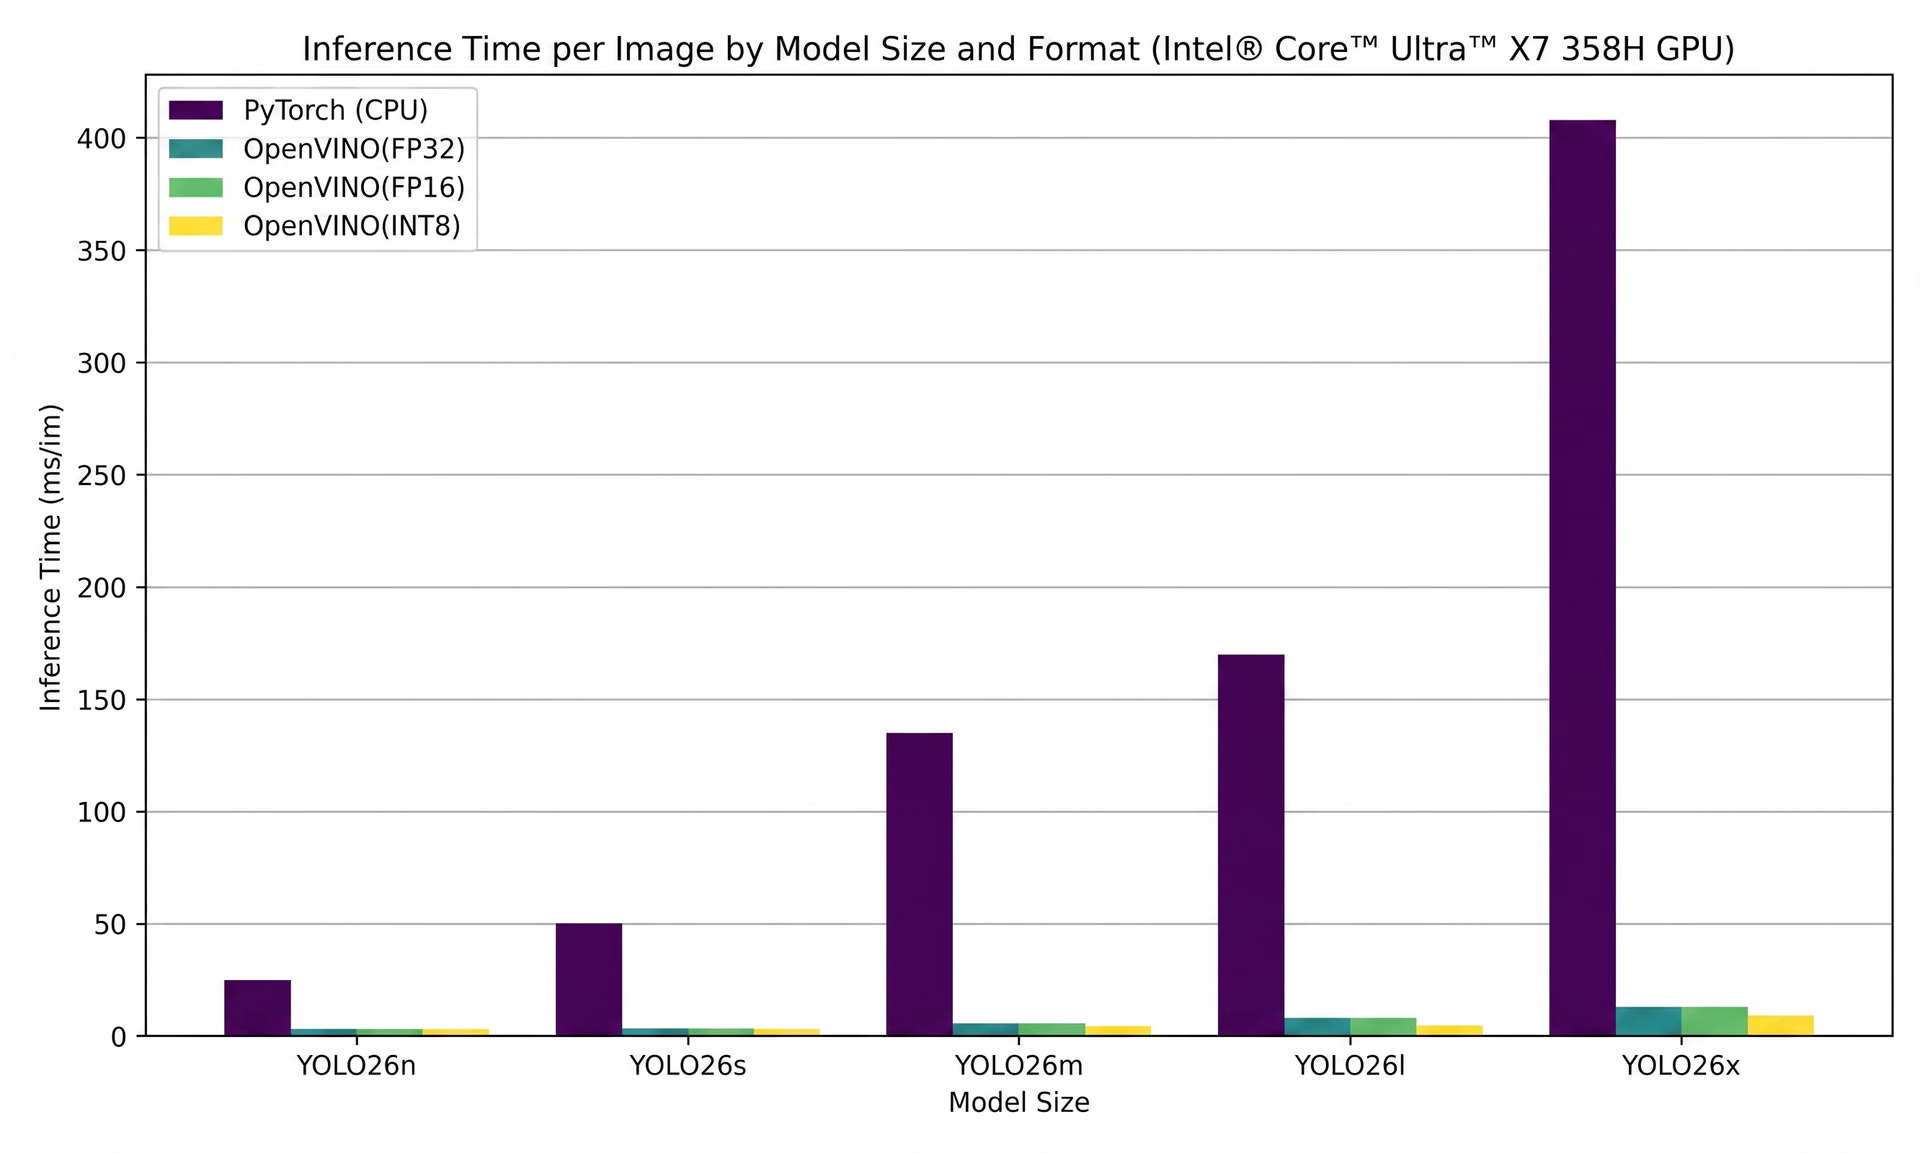
Fig. 2. Benchmarking da inferência do Ultralytics YOLO26 na GPU Intel Panther Lake com OpenVINO (Fonte)
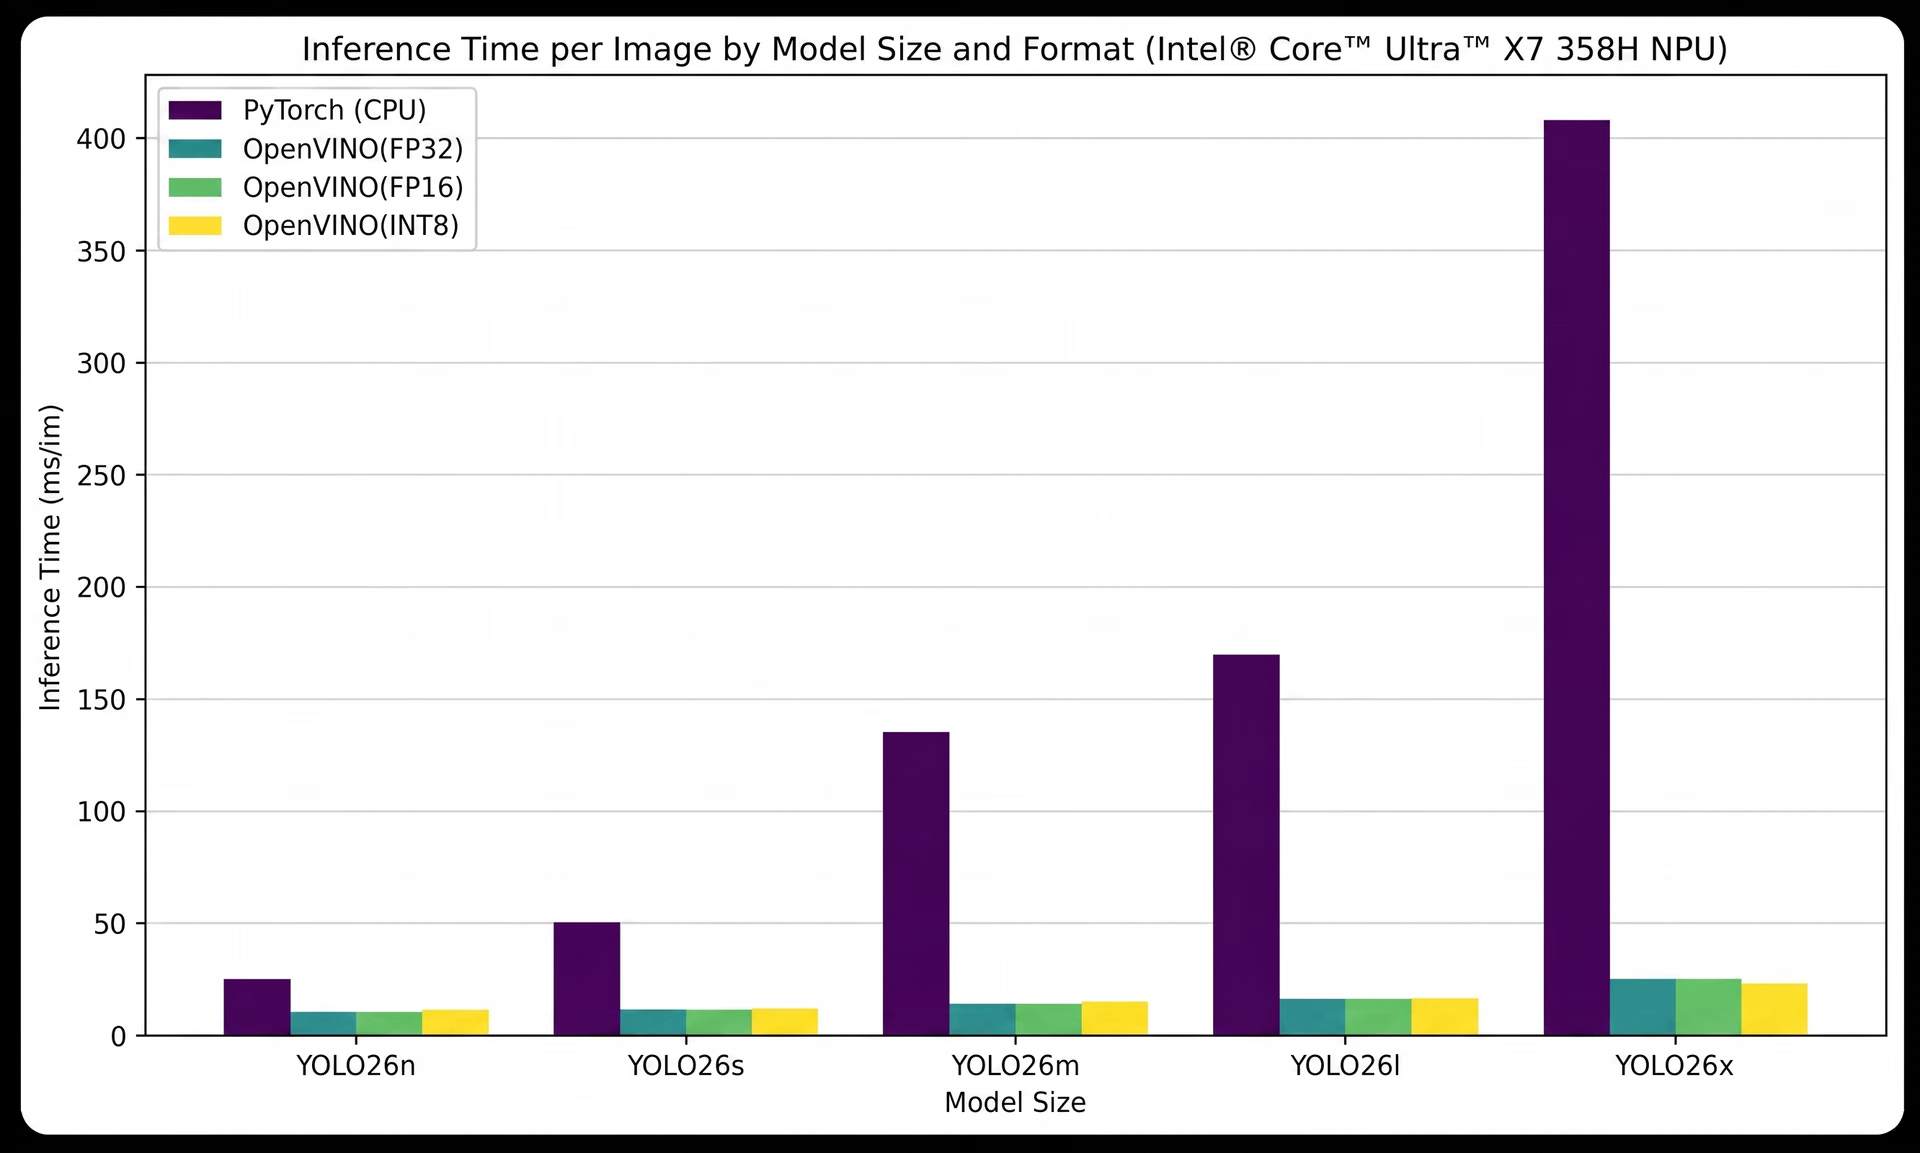
Fig. 3. Benchmarking da inferência do Ultralytics YOLO26 na NPU Intel Panther Lake com OpenVINO (Fonte)
Explorando duas maneiras de exportar o Ultralytics YOLO26 para o formato OpenVINO#
Há duas maneiras principais de exportar modelos YOLO26 para o formato OpenVINO. Você pode usar o pacote Python da Ultralytics ou exportar diretamente pela Ultralytics Platform, um ambiente de ponta a ponta para criar e gerenciar fluxos de trabalho de visão computacional em um só lugar. A seguir, vamos apresentar as duas abordagens.
Usando o pacote Python da Ultralytics para exportar YOLO26#
O pacote Python da Ultralytics oferece uma maneira simples de exportar modelos YOLO26 para o formato OpenVINO em um fluxo de trabalho baseado em código. Como a mesma interface é usada para treinamento e inferência, a exportação de um modelo se encaixa naturalmente nos pipelines existentes, sem exigir ferramentas adicionais.
Para começar, você pode instalar o pacote Ultralytics. Basta executar o comando “pip install ultralytics” em um terminal ou prompt de comando. Se estiver trabalhando em um ambiente interativo, como Jupyter Notebook ou Google Colab, você pode executar o mesmo comando precedido de um ponto de exclamação.
Depois de instalar o pacote, você pode carregar um modelo YOLO26 treinado e exportá-lo diretamente para o formato OpenVINO. Como mostrado abaixo, um modelo YOLO26n pré-treinado (yolo26n.pt) é carregado e, em seguida, convertido para o formato OpenVINO usando o método export.
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

model.export(format="openvino")
Depois de executar o código, o modelo convertido é salvo em um novo diretório, onde pode ser usado para implantação.
Exportando YOLO26 pela Ultralytics Platform#
Se você procura uma abordagem mais simples, sem código, pode exportar modelos YOLO26 diretamente pela Ultralytics Platform. A plataforma reúne todo o fluxo de trabalho de visão computacional em um único ambiente, facilitando a transição do treinamento à implantação sem configurações adicionais.
Quando o modelo estiver pronto, você poderá abri-lo na plataforma e acessar a guia Exportar. A partir daí, poderá selecionar OpenVINO como formato de exportação e, se quiser, ajustar configurações como o tamanho da imagem ou a precisão.
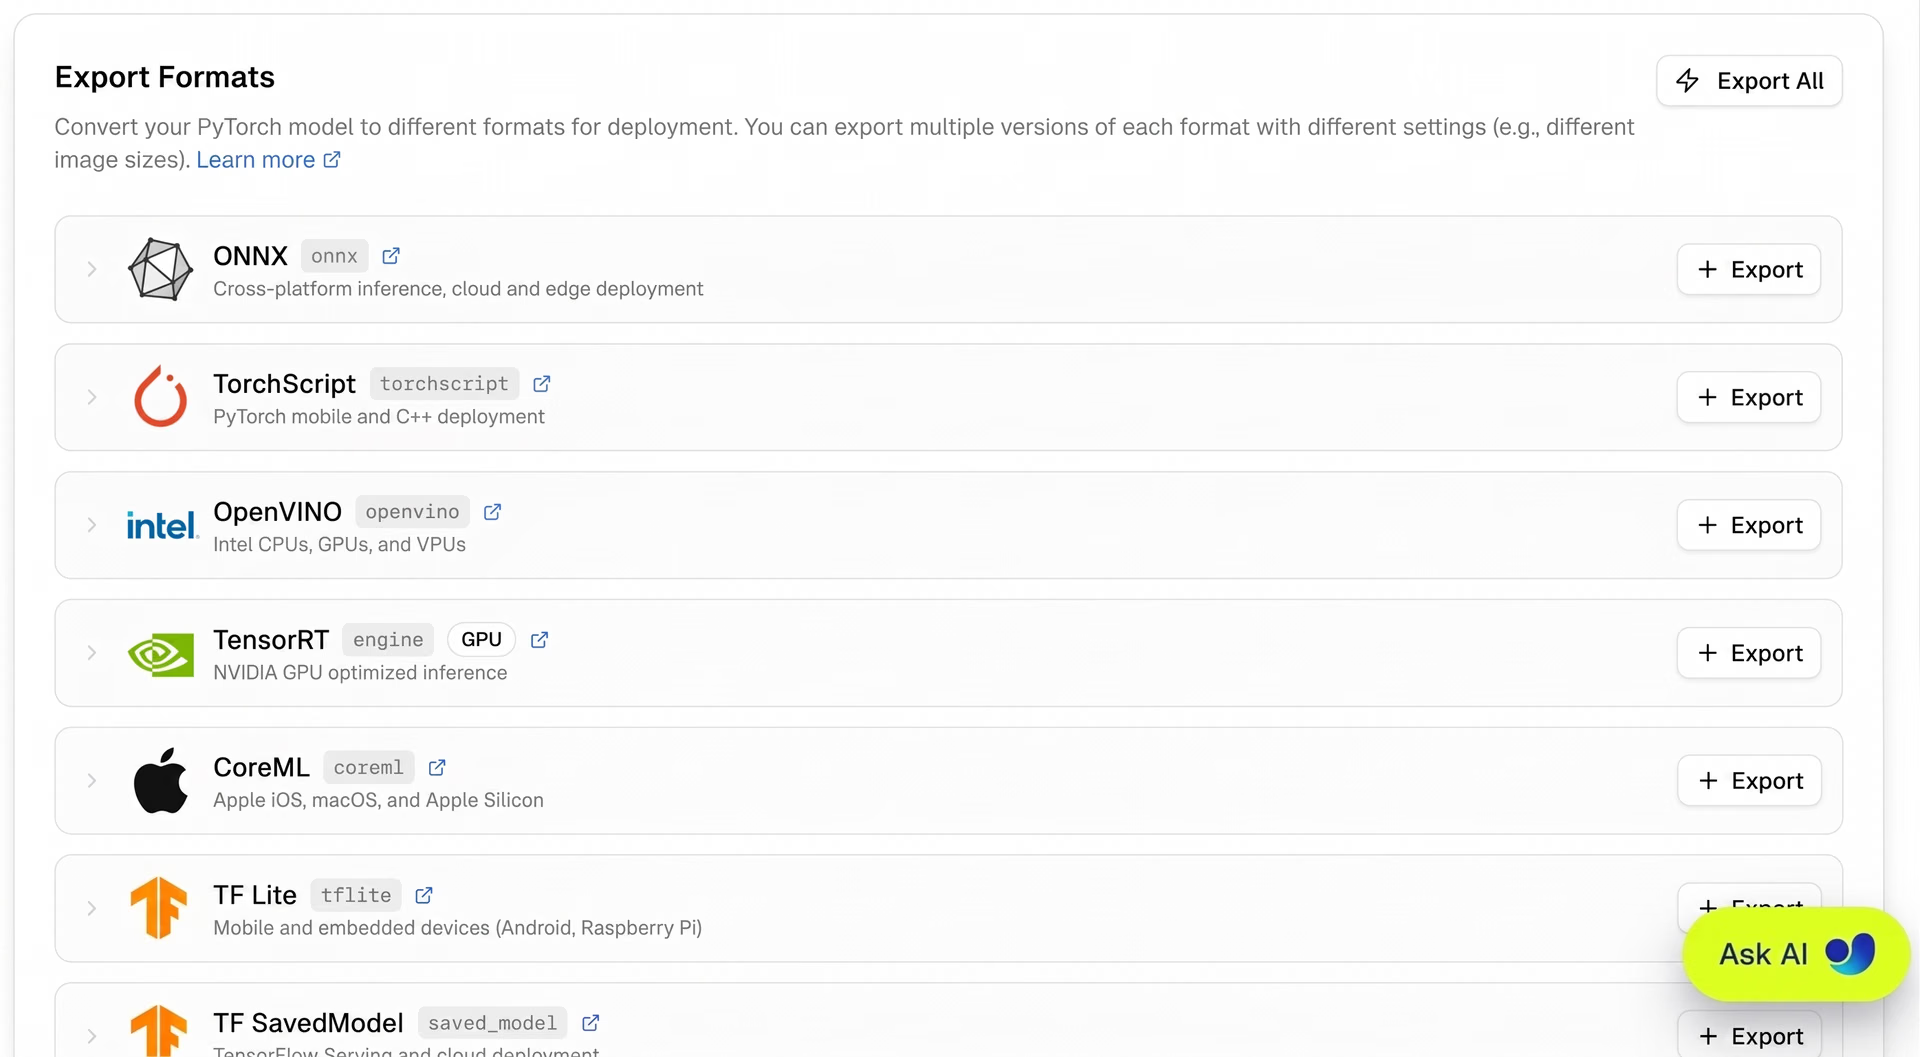
Fig. 4. Uma visão da exportação de YOLO26 na Ultralytics Platform
A plataforma realiza a conversão automaticamente, então você não precisa gerenciar scripts, dependências ou a configuração do ambiente. Após a conclusão da exportação, o modelo otimizado pode ser baixado e usado para implantação em CPUs, GPUs e NPUs Intel.
Opções de implantação disponíveis com a integração entre Ultralytics e OpenVINO#
Depois que um modelo YOLO26 é exportado para o formato OpenVINO, há algumas maneiras de executar inferência, dependendo do seu fluxo de trabalho e do nível de controle necessário. Você pode usar o pacote Python da Ultralytics para uma abordagem mais simples e integrada ou o runtime nativo do OpenVINO para obter mais flexibilidade e controle.
Executando inferência com o pacote Python da Ultralytics#
Depois de exportar o modelo para o formato OpenVINO, você pode executar inferência usando o pacote Python da Ultralytics. Essa abordagem é ideal para testes rápidos e uma implantação simplificada, pois usa a mesma interface do treinamento e da exportação.
Com essa abordagem, você pode carregar o modelo OpenVINO exportado do diretório correspondente e executar inferência em uma entrada, como uma imagem ou um vídeo. Também pode escolher o dispositivo de execução especificando opções como "intel:cpu", "intel:gpu" ou "intel:npu", de acordo com o hardware disponível no seu sistema.
O trecho de código abaixo mostra como carregar o modelo exportado e executar inferência em uma imagem usando a GPU. Após a inferência, a imagem de saída é salva no diretório “runs/detect/predict”.
ov_model = YOLO("yolo26n_openvino_model/")

results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:gpu")
Usando o pacote nativo OpenVINO para inferência#
Se você precisa de mais controle sobre a execução do modelo em produção, pode usar o runtime nativo do OpenVINO para inferência. Esse método é útil ao integrar modelos em aplicações maiores ou quando você quer ajustar a forma como a inferência é executada em um hardware específico.
O OpenVINO oferece uma maneira unificada de executar modelos em CPUs, GPUs e NPUs Intel, além de recursos como execução assíncrona e uso eficiente dos recursos de computação disponíveis. Para configurá-lo, você pode trabalhar diretamente com os arquivos do modelo exportado, incluindo o arquivo .xml, que define a estrutura do modelo, e o arquivo .bin, que contém os pesos treinados.
De acordo com o seu caso de uso, você também pode ajustar configurações como o tamanho da entrada ou as etapas de pré-processamento. Para configurar a inferência, inicialize o runtime do OpenVINO, carregue e compile o modelo para um dispositivo de destino, prepare os dados de entrada e, em seguida, execute a inferência.
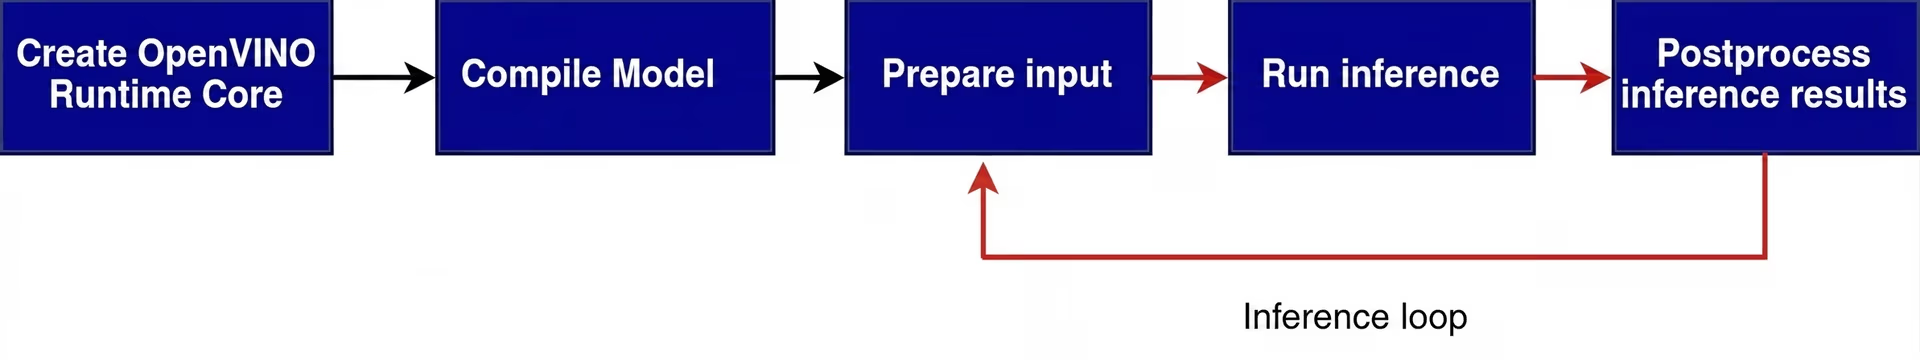
Fig. 5. Exemplo de um pipeline típico de inferência com OpenVINO (Fonte)
Isso permite controlar como o modelo é executado e como se encaixa na implantação como um todo. Para saber mais sobre como configurar e executar inferência com o runtime do OpenVINO, consulte a Ultralytics documentação oficial.
Aplicações reais do Ultralytics YOLO26 em hardware Intel#
O verdadeiro valor da integração entre Ultralytics e OpenVINO aparece em produção, onde uma inferência confiável e de baixa latência pode fazer uma diferença concreta. Veja alguns setores importantes nos quais essa integração gera resultados significativos:
- Manufatura: Ao exportar o Ultralytics YOLO26 para OpenVINO, os sistemas de linhas de produção podem detectar automaticamente defeitos visuais, como componentes ausentes, desalinhamento ou danos superficiais, em hardware Intel, ajudando a melhorar a qualidade dos produtos e a reduzir erros dispendiosos.
- Saúde: Sistemas de diagnóstico por imagem e monitoramento de pacientes podem executar localmente modelos Ultralytics YOLO26 exportados em hardware Intel, atendendo a requisitos rigorosos de privacidade dos dados e mantendo um desempenho de inferência confiável.
- Cidades inteligentes: O monitoramento do trânsito e a análise de multidões podem ser implantados com modelos Ultralytics YOLO26 exportados em câmeras de borda com hardware Intel, permitindo obter informações em tempo real, como contagem de veículos, rastreamento de pedestres e detecção de incidentes.
- Automotivo: A baixa latência e a eficiência energética são essenciais para o monitoramento do motorista e a detecção no interior da cabine, o que faz do hardware Intel combinado com modelos Ultralytics YOLO26 exportados uma ótima opção para sistemas automotivos embarcados.
Para saber mais sobre essa integração, participe da série de workshops OpenVINO DevCon da Intel: “Da anotação à implantação: criando um pipeline de detecção de objetos com Geti, Ultralytics YOLO26 e OpenVINO™”. O nosso gerente de parcerias e ecossistema, Francesco Mattioli, se juntará ao evangelista de software de IA da Intel, Adrian Boguszewski, para uma demonstração ao vivo e um passo a passo de como criar pipelines de visão computacional prontos para produção em cenários industriais do mundo real. O workshop apresentará um fluxo de trabalho completo, de ponta a ponta, para detecção de objetos, desde a criação de conjuntos de dados e o treinamento de modelos até a otimização e a implantação na borda.
Benefícios do uso do formato de exportação OpenVINO#
Estas são algumas das principais vantagens do formato de exportação OpenVINO:
- Acessível e fácil de integrar: Com uma API unificada e mais de 80 notebooks com tutoriais, o OpenVINO facilita a transição da experimentação à implantação sem acrescentar complexidade significativa.
- Execute o mesmo modelo em diferentes hardwares: O OpenVINO permite usar um único modelo exportado em hardware Intel compatível, implantando-o em CPUs, GPUs ou NPUs sem precisar reescrevê-lo ou adaptá-lo a cada dispositivo.
- Otimização integrada durante a exportação: A exportação para OpenVINO converte modelos de frameworks populares, como PyTorch e TensorFlow, para um formato otimizado e pronto para inferência, eliminando a necessidade de etapas de conversão separadas.
- Melhor aproveitamento dos recursos de hardware: O OpenVINO oferece suporte à inferência assíncrona e ao balanceamento de carga em hardware Intel, ajudando a melhorar a eficiência em aplicações do mundo real.
Executando o Ultralytics YOLO26 com ExecuTorch e o backend OpenVINO#
Se você está implantando o Ultralytics YOLO26 em ambientes de produção mais exigentes, há outra opção que combina a eficiência no dispositivo com a compressão avançada de modelos.
O ExecuTorch, framework de inferência no dispositivo do PyTorch, oferece suporte a um backend OpenVINO que permite implantar o Ultralytics YOLO26 em hardware Intel por meio de outro fluxo de exportação e execução.
O ExecuTorch gerencia a exportação do modelo e a execução do runtime, enquanto o OpenVINO atua como camada de aceleração de hardware subjacente, realizando os cálculos em CPU, GPU ou NPU Intel. Os dois trabalham em conjunto para oferecer a portabilidade e a eficiência no dispositivo do ExecuTorch, combinadas com as otimizações específicas de hardware fornecidas pelo OpenVINO.
Para saber mais sobre como isso funciona e como começar a usar o Ultralytics YOLO26 com ExecuTorch e o backend OpenVINO, confira o blog da Intel com as atualizações mais recentes sobre ExecuTorch e OpenVINO.
Principais conclusões#
Exportar modelos YOLO26 pela integração entre Ultralytics e OpenVINO melhora o desempenho em hardware Intel sem acrescentar complexidade ao seu fluxo de trabalho. Você pode passar do treinamento à implantação sem reformular o pipeline. No geral, isso oferece uma maneira simples de executar modelos com eficiência em CPUs, GPUs e NPUs Intel em aplicações do mundo real.
Junte-se à nossa comunidade e explore o nosso repositório no GitHub para saber mais sobre IA de visão. Confira as nossas opções de licenciamento para dar início aos seus projetos de visão computacional. Tem interesse em inovações como IA na manufatura ou visão computacional no setor automotivo? Visite as nossas páginas de soluções para saber mais.









