Ultralytics YOLO26 vs. outros modelos Ultralytics YOLO para estimativa de pose
Descubra como a Ultralytics YOLO26 aprimora a estimativa de pose com melhor suporte a pontos-chave não humanos, convergência mais rápida, tratamento aprimorado de oclusões e implantação eficiente em tempo real.
Quando observas a postura de alguém, é fácil perceber se essa pessoa está curvada, inclinada para a frente ou de pé, com a coluna direita. As pessoas conseguem compreender rapidamente como as diferentes partes do corpo se relacionam.
Isso faz parte da forma natural como interpretamos o movimento e a linguagem corporal no dia a dia. Para as máquinas, porém, esse tipo de compreensão visual não é automático. Ensinar um sistema a reconhecer movimento e estrutura exige técnicas avançadas de aprendizagem profunda e de visão computacional que lhe permitam interpretar imagens de forma significativa.
Em particular, a estimativa de pose é uma técnica de IA para visão que permite a um modelo de visão computacional desenvolver uma compreensão semelhante. Em vez de simplesmente detetar um objeto numa imagem, o modelo prevê pontos-chave que representam referências estruturais importantes.
Esses pontos-chave podem corresponder a articulações do corpo, membros de animais, componentes de máquinas ou até pontos fixos, como os cantos de um campo. Ao identificar e acompanhar esses pontos, o sistema consegue compreender a posição, o alinhamento e o movimento de forma estruturada e mensurável.
À medida que a estimativa de pose é aplicada a mais cenários reais, os modelos precisam de lidar de forma mais eficaz com pontos-chave não humanos, cenas complexas e conjuntos de dados personalizados. Por exemplo, modelos de última geração como o Ultralytics YOLO26 dão suporte a tarefas de visão computacional, como a estimativa de pose, e baseiam-se em modelos YOLO anteriores para pose, com melhorias na arquitetura e no treino concebidas para aumentar a flexibilidade e o desempenho geral.
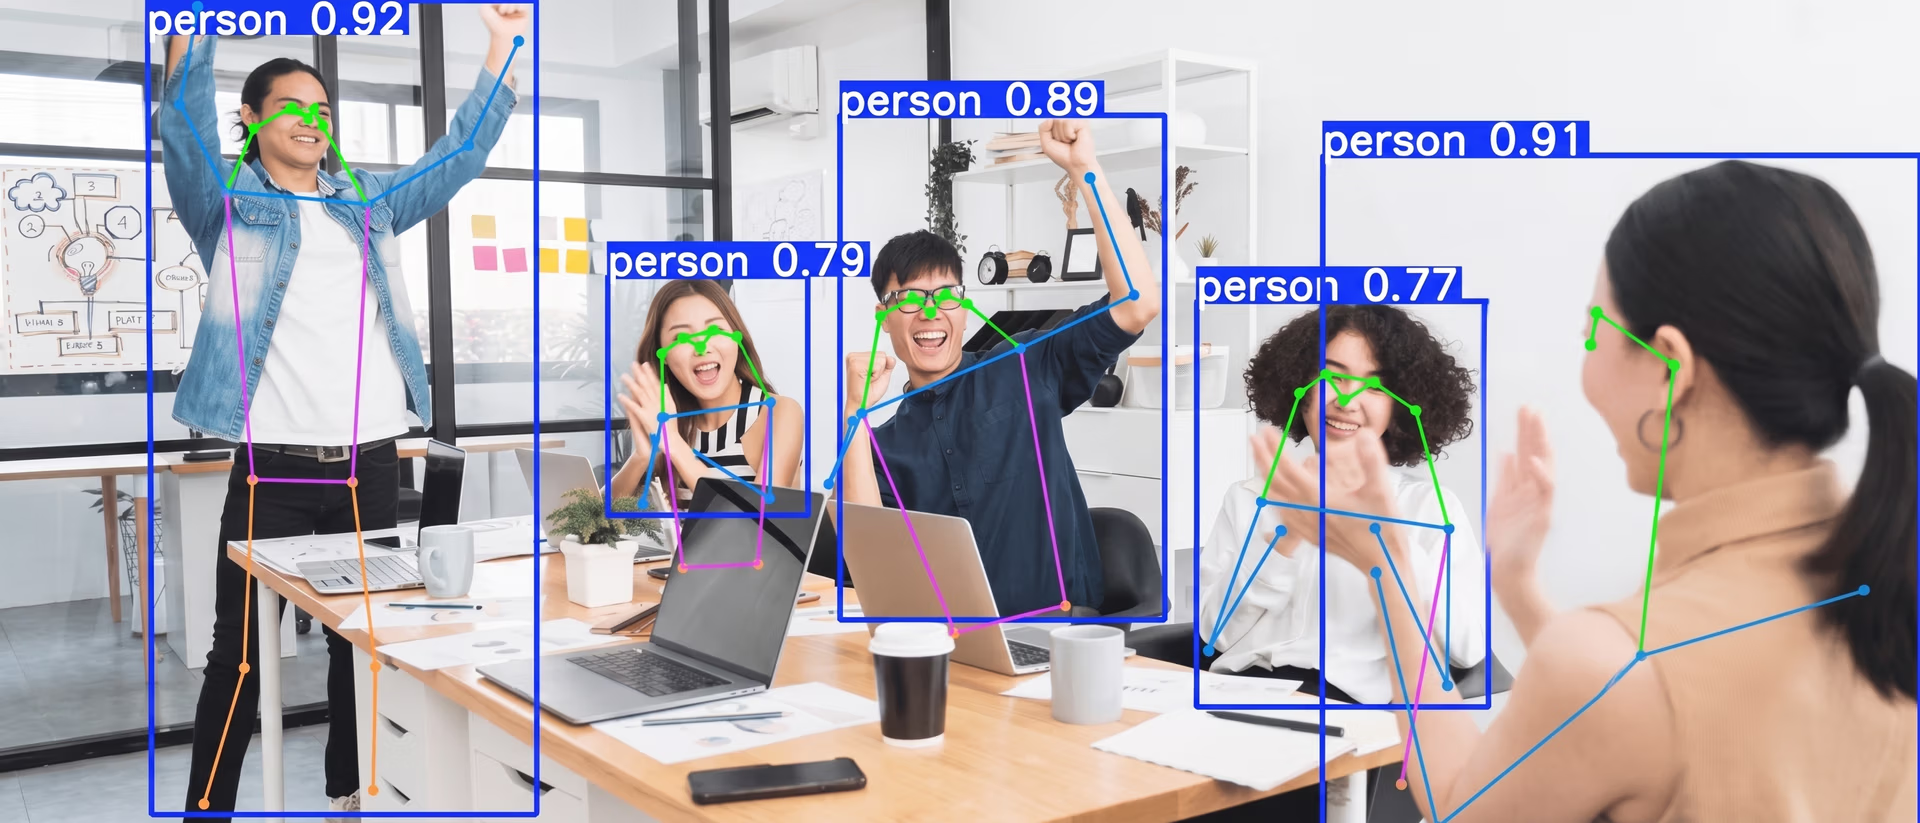
Fig. 1. Exemplo de estimativa de pose possibilitada pelo YOLO (Fonte)
Neste artigo, vamos comparar o YOLO26-pose com os modelos Ultralytics YOLO anteriores para pose e explorar como ele melhora a flexibilidade, a velocidade de convergência e o desempenho em cenas complexas. Vamos começar!
O que é estimativa de pose?#
Antes de nos aprofundarmos na comparação dos modelos Ultralytics YOLO para pose, vamos analisar melhor o que significa realmente estimativa de pose no contexto da visão computacional.
A estimativa de pose é uma técnica usada para detetar e acompanhar pontos-chave específicos numa imagem ou num fotograma de vídeo. Esses pontos-chave podem representar referências estruturais importantes, como articulações do corpo humano, membros de um animal, componentes de uma máquina ou pontos de referência fixos numa cena.
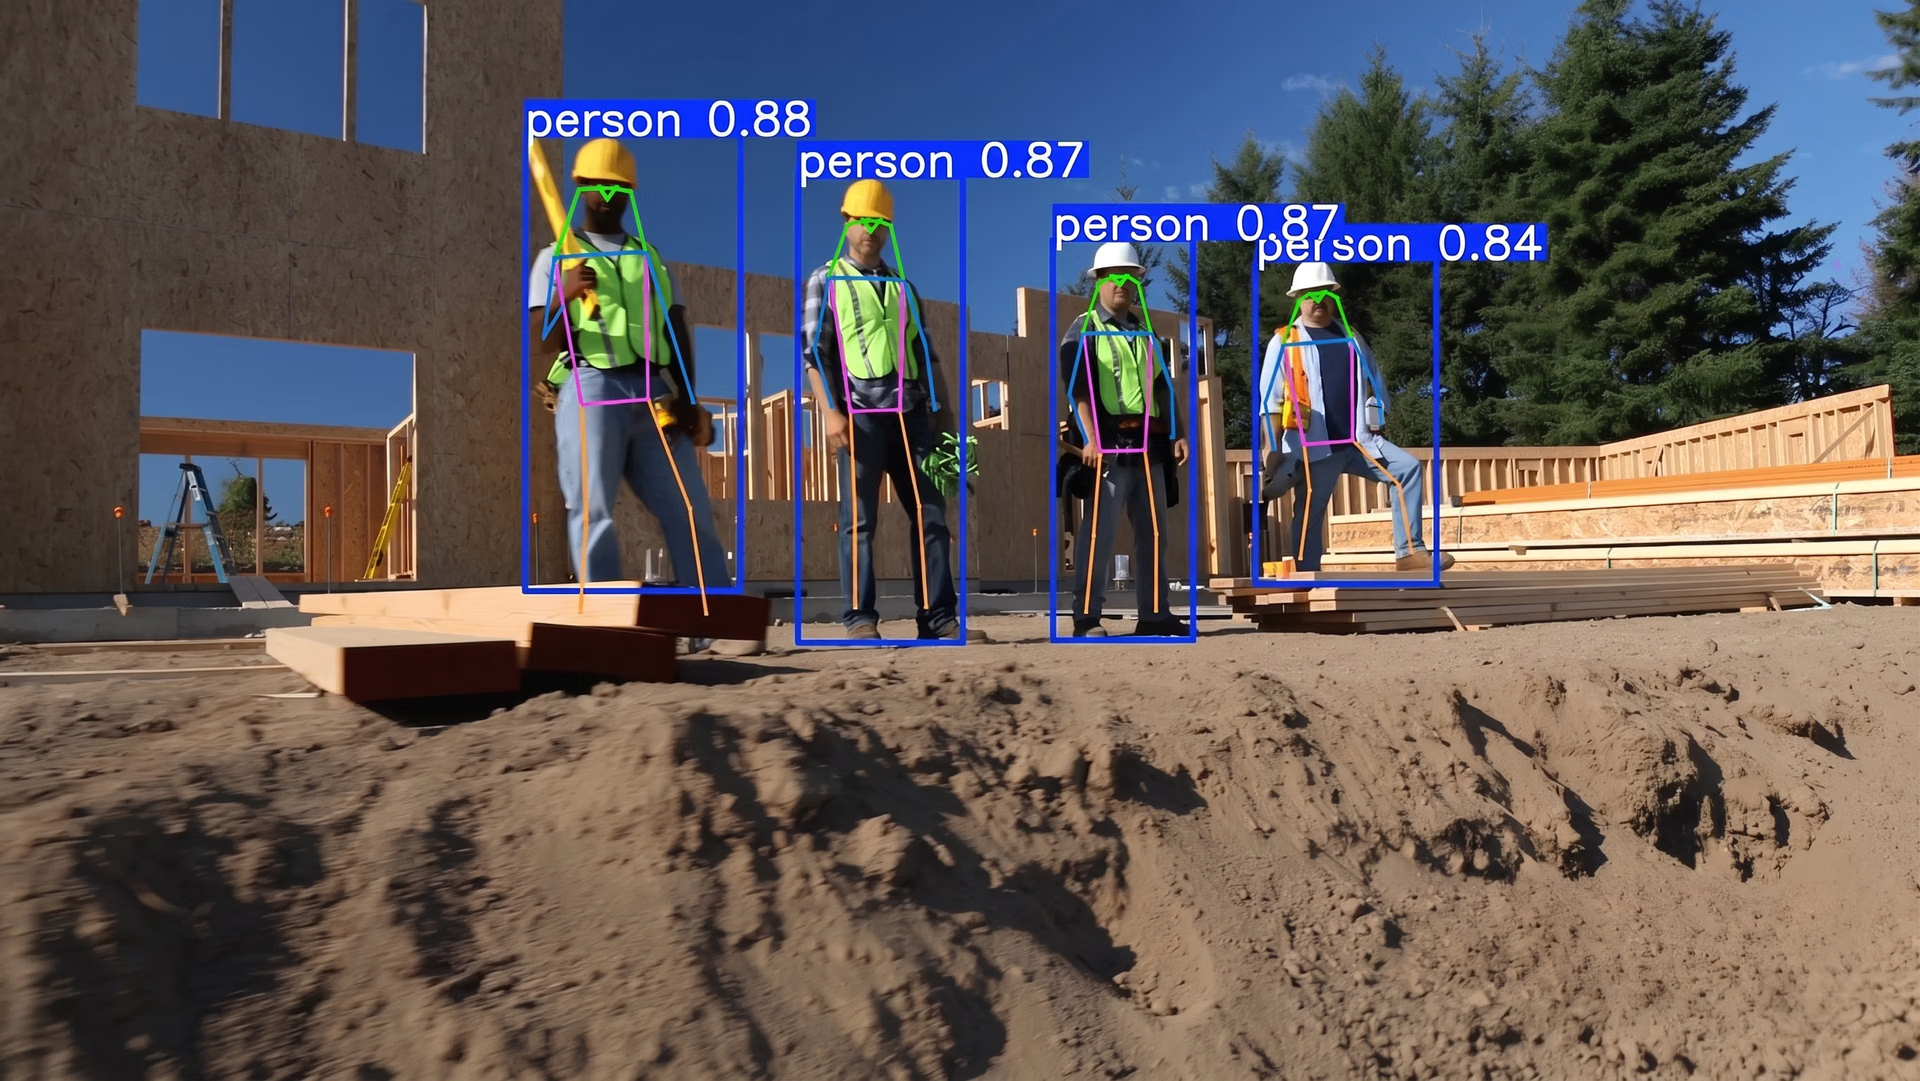
Fig. 2. Estimativa da pose de trabalhadores usando a estimativa da pose humana (Fonte)
Ao identificar as coordenadas desses pontos, um modelo consegue compreender a posição de um objeto e como ele se move ao longo do tempo. Ao contrário da classificação de imagens, que atribui um único rótulo à imagem inteira, ou dos modelos de deteção de objetos, que se concentram em desenhar caixas delimitadoras em torno dos objetos, a estimativa de pose fornece informações espaciais mais detalhadas sobre a estrutura e o movimento.
Visão geral do Ultralytics YOLO26-pose#
O YOLO26-pose está disponível em várias variantes ou tamanhos de modelo, incluindo opções leves como YOLO26n-pose e modelos maiores, como YOLO26m-pose, YOLO26l-pose e YOLO26x-pose. Isso permite que as equipas escolham o equilíbrio certo entre velocidade e precisão, conforme o hardware e os requisitos de desempenho.
A Ultralytics também disponibiliza modelos de pose pré-treinados com conjuntos de dados grandes e gerais, como o conjunto de dados COCO, especificamente as anotações COCO-Pose (pontos-chave COCO) para estimativa da pose humana, para que não tenhas de começar do zero. Na maioria dos casos, as equipas ajustam esses modelos aos seus próprios conjuntos de dados para os adaptar a pontos-chave, disposições ou ambientes específicos.
Normalmente, isso envolve preparar ficheiros de anotação personalizados que definem as coordenadas dos pontos-chave e os rótulos de classe num formato estruturado. Essas anotações associam pontos-chave a coordenadas de píxeis específicas em cada imagem, permitindo que o modelo aprenda relações espaciais precisas durante o treino.
A utilização de modelos pré-treinados acelera o treino, reduz os requisitos de dados e ajuda a levar os projetos à produção com mais eficiência.
Aplicações reais da estimativa da pose humana#
Vê alguns casos de utilização reais em que a estimativa de pose desempenha um papel importante:
- Saúde e reabilitação: Os profissionais de saúde podem usar modelos de pose para avaliar a postura, acompanhar a evolução da recuperação e analisar padrões de movimento durante a fisioterapia.
- Sistemas autónomos: Os drones e as câmaras inteligentes podem usar informações de pose para compreender melhor a orientação e o movimento de objetos em cenas dinâmicas.
- Segurança no local de trabalho: As organizações podem monitorizar o posicionamento corporal e os movimentos repetitivos para ajudar a identificar possíveis riscos de segurança.
- Fitness e treino personalizado: As aplicações de fitness usam a estimativa de pose para acompanhar a execução dos exercícios, contar repetições e fornecer feedback em tempo real sobre a postura e os movimentos mantidos durante os tutoriais de fitness.
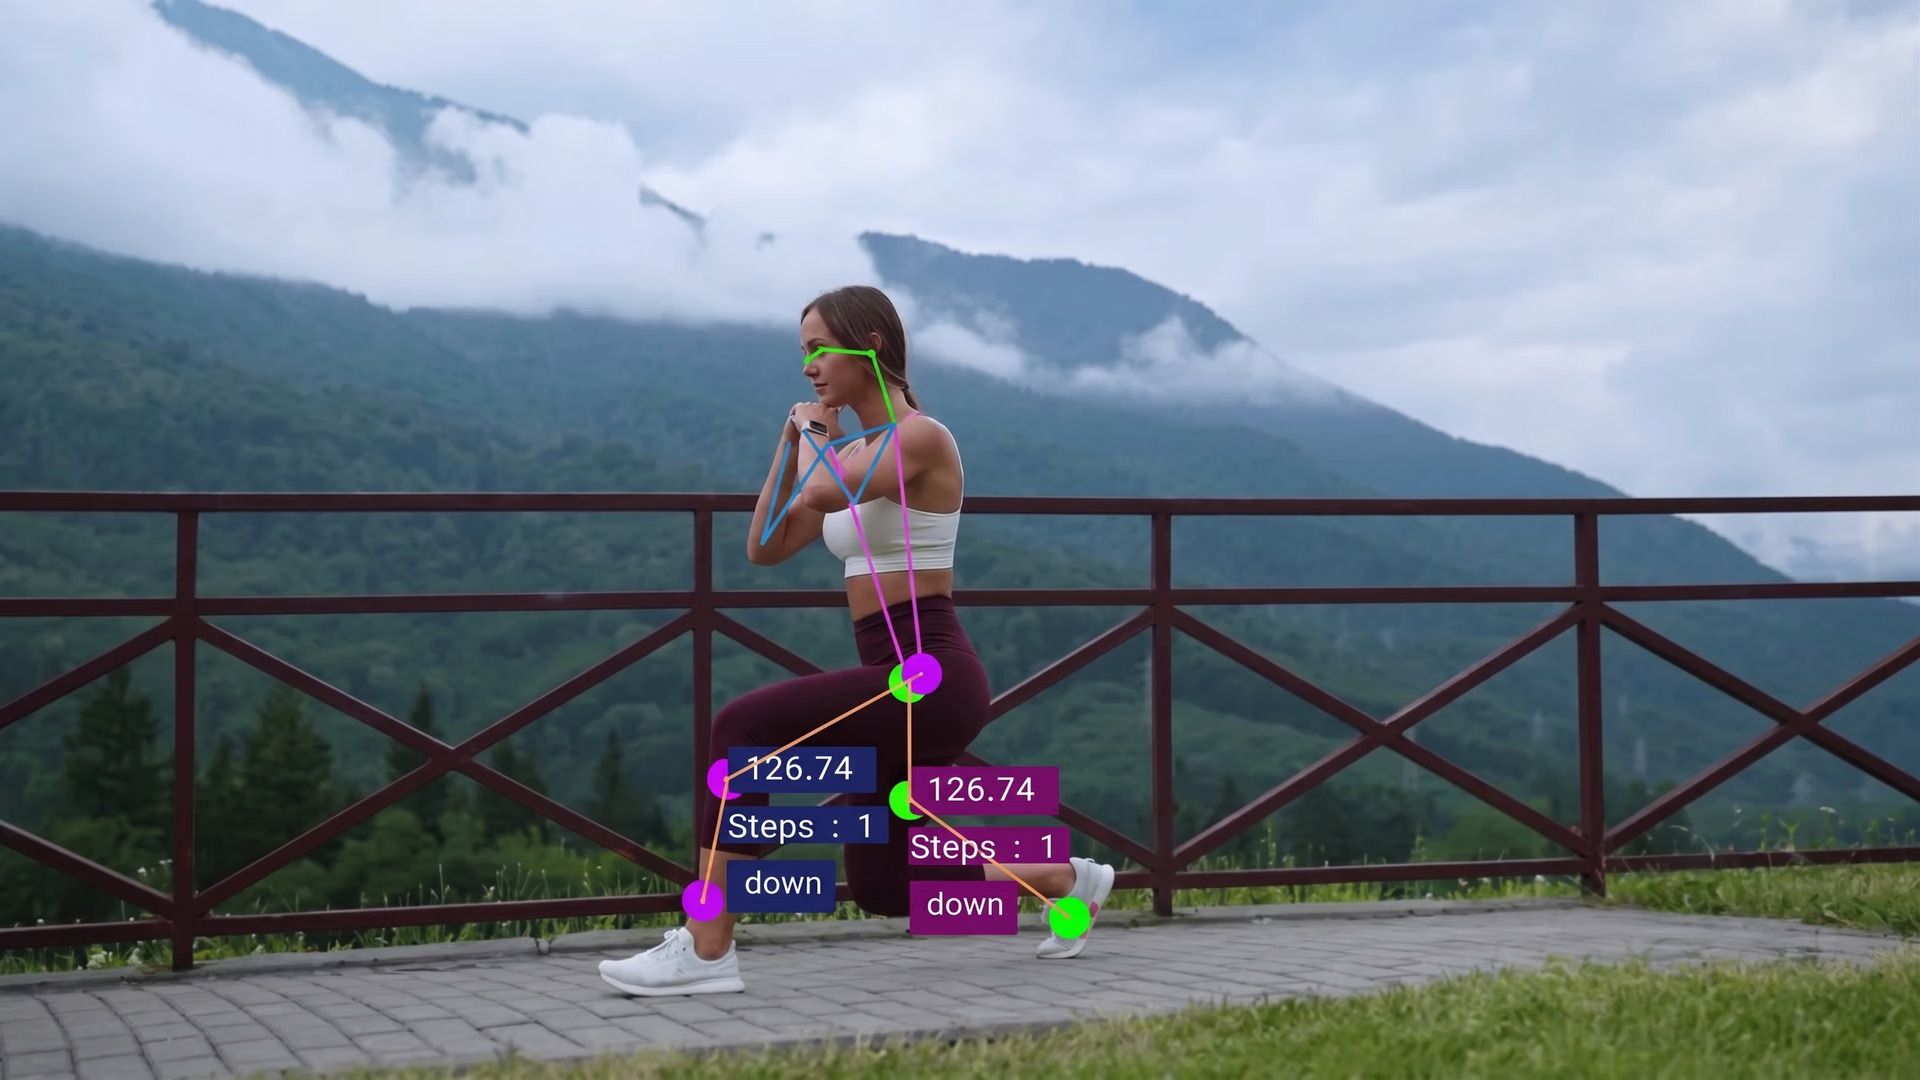
Fig. 3. A estimativa de pose pode ajudar a acompanhar pontos-chave do corpo durante um movimento atlético. (Fonte)
Explorar o suporte do Ultralytics YOLO26 à estimativa de pose#
O Ultralytics YOLO26 baseia-se em modelos Ultralytics YOLO anteriores e inclui atualizações concebidas para tornar o treino e a implementação mais práticos.
Tal como as versões anteriores, dá suporte à estimativa de pose como parte de uma estrutura unificada. A principal diferença é que o Ultralytics YOLO26 foi concebido para oferecer mais flexibilidade e estabilidade numa gama mais ampla de casos de utilização reais.
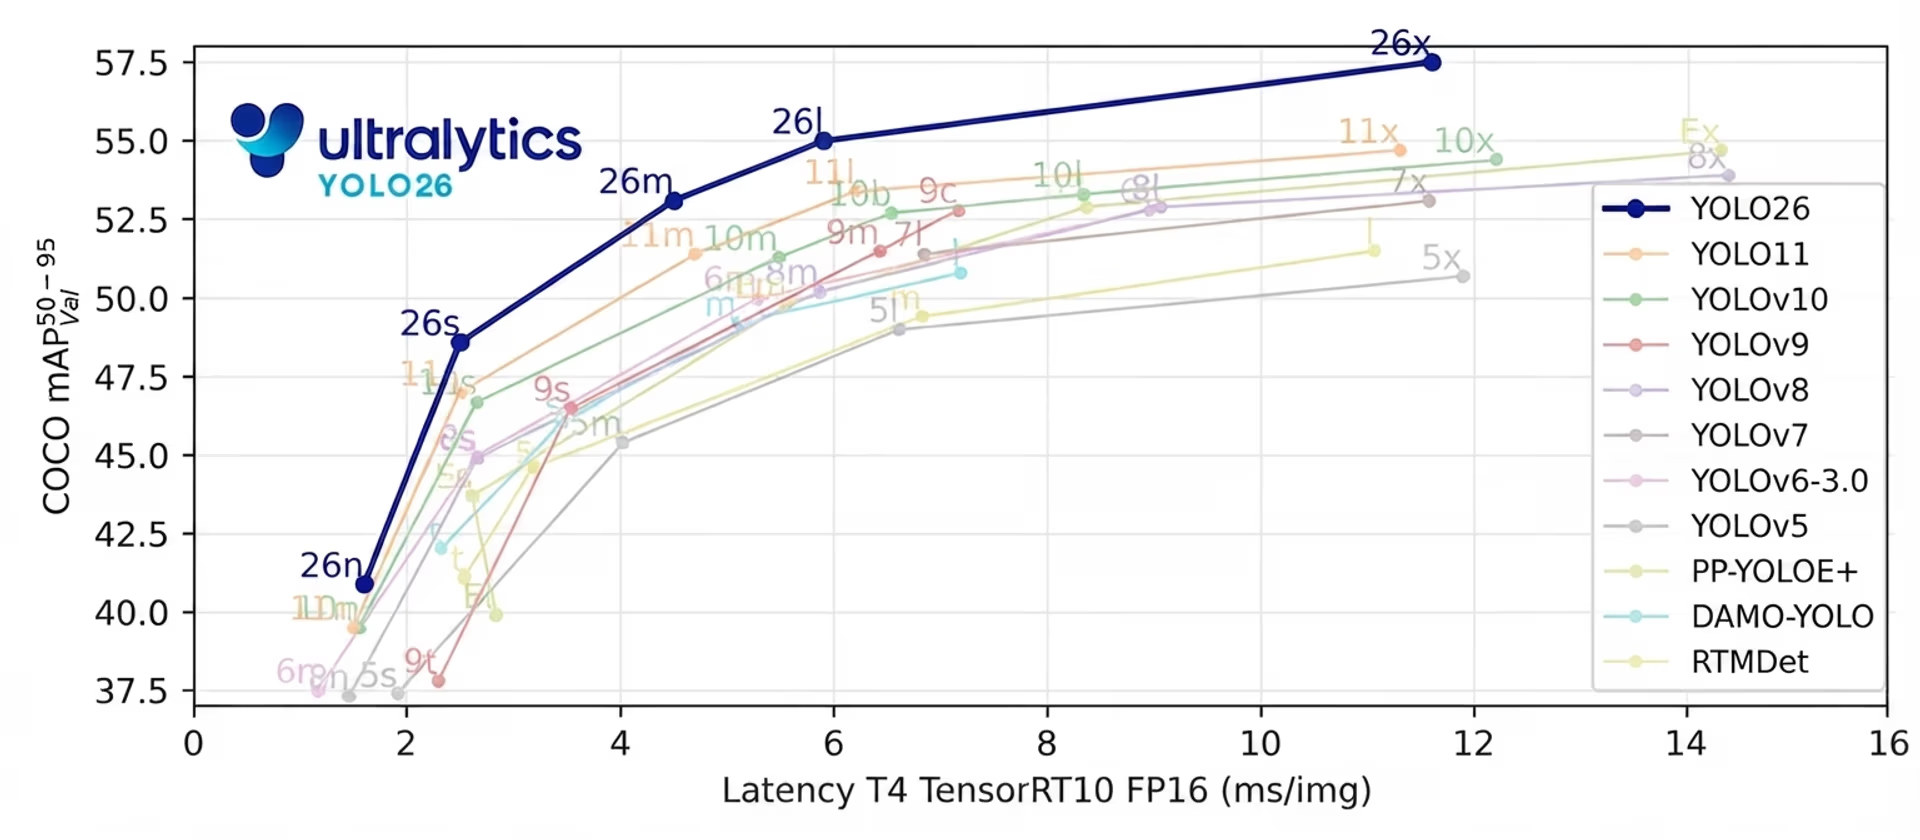
Fig. 4. Avaliação comparativa do YOLO26 (Fonte)
Os modelos Ultralytics YOLO anteriores para pose foram bastante influenciados por conjuntos de dados de pose humana, o que significava que partes dos métodos anteriores eram otimizadas em torno das estruturas das articulações humanas. O YOLO26 elimina essas suposições específicas dos seres humanos.
Por isso, é mais adequado para pontos-chave não humanos, como detetar os cantos de um campo de ténis ou outras referências estruturais personalizadas. Isso é importante porque, logo à saída da caixa, os modelos Ultralytics YOLO26-pose pré-treinados são treinados com conjuntos de dados como o COCO-pose e preveem pontos-chave humanos definidos nas anotações do conjunto de dados.
No entanto, quando as equipas querem detetar outros tipos de referências, como componentes de máquinas, marcadores de campos desportivos ou pontos de infraestrutura, normalmente é necessário ajustar o modelo a um conjunto de dados personalizado no qual esses pontos-chave específicos estejam anotados.
Como o Ultralytics YOLO26 não está vinculado a suposições sobre as estruturas das articulações humanas, consegue adaptar-se de forma mais eficaz durante o ajuste fino. Essa flexibilidade permite que o modelo aprenda disposições personalizadas de pontos-chave com mais fiabilidade, o que melhora as métricas de avaliação quando validado em conjuntos de dados com configurações de pontos-chave específicas.
O Ultralytics YOLO26-pose também foi concebido para melhorar a localização de pontos-chave quando partes de um objeto estão parcialmente ocultas ou aparecem numa escala muito pequena. Em cenas reais com objetos distantes, imagens captadas por drones ou situações com objetos pequenos, isso pode resultar em previsões de pontos-chave mais precisas do que as dos modelos de pose anteriores.
Outra atualização importante é a formulação da função de perda, melhorada e utilizada durante o treino. A função de perda determina como o modelo corrige os seus erros durante a aprendizagem.
No caso do Ultralytics YOLO26-pose, esse processo é mais eficaz, o que ajuda o modelo a aprender mais rápido e alcançar alta precisão em menos épocas, sendo que uma época corresponde a uma passagem completa pelo conjunto de dados de treinamento.
De modo geral, o YOLO26-pose se baseia nos modelos anteriores de pose Ultralytics YOLO, com melhorias mais claras no suporte a pontos-chave não humanos e na convergência do treinamento, mantendo o mesmo fluxo de trabalho familiar.
Comparação entre YOLO26-pose e Ultralytics YOLOv5#
A primeira versão dos modelos Ultralytics YOLO, Ultralytics YOLOv5, foi desenvolvida principalmente para detecção de objetos. Embora o YOLOv5 tenha sido posteriormente ampliado para oferecer suporte à segmentação de instâncias, ele não inclui uma cabeça nativa e especializada para estimativa de pose na estrutura oficial da Ultralytics.
As equipes que precisavam detectar pontos-chave geralmente recorriam a implementações separadas ou modificações personalizadas. O Ultralytics YOLO26 inclui a estimativa de pose como uma tarefa integrada, com uma cabeça arquitetural dedicada, projetada especificamente para prever pontos-chave.
Isso significa que os modelos Ultralytics YOLO26-pose podem ser treinados, validados e implantados no mesmo fluxo de trabalho unificado de detecção e segmentação. Para projetos voltados à detecção estruturada de pontos-chave, o YOLO26 oferece suporte nativo a pose e uma arquitetura específica para essa tarefa, recursos que o YOLOv5 não oferece de forma pronta.
Principais diferenças: YOLO26-pose vs. Ultralytics YOLOv8-pose#
Ultralytics YOLOv8 introduziu a estimativa nativa de pose na estrutura unificada da Ultralytics, facilitando o treinamento e a implantação de modelos de pontos-chave com o mesmo fluxo de trabalho usado para detecção e segmentação. Ele depende de um pipeline tradicional de pós-processamento com supressão não máxima (NMS) e usa formulações de perda anteriores para regressão de caixas delimitadoras e treinamento.
O Ultralytics YOLO26 se baseia nessa fundação com atualizações arquiteturais e de treinamento que afetam diretamente a estimativa de pose. Uma diferença importante é o design de ponta a ponta. O YOLO26 elimina a necessidade de NMS externo durante a inferência, simplificando a implantação e melhorando a consistência da latência, especialmente em CPUs e dispositivos de borda.
Outra melhoria importante está na metodologia de treinamento. O Ultralytics YOLO26 introduz o otimizador MuSGD, além de estratégias de perda atualizadas. Para tarefas de pose, ele integra a Estimativa de Log-Verossimilhança Residual, que aprimora a modelagem da incerteza dos pontos-chave. Em conjunto, essas mudanças podem levar a uma convergência mais rápida e a previsões de pontos-chave mais estáveis, principalmente em cenas complexas ou parcialmente ocluídas.
Em resumo, o Ultralytics YOLOv8-pose estabeleceu uma base sólida e versátil. O YOLO26-pose aprimora essa base com maior eficiência de treinamento, melhor tratamento de oclusões e mais flexibilidade para aplicações de pose não humana no mundo real.
YOLO26-pose vs. Ultralytics YOLO11-pose: o que melhorou?#
Ultralytics YOLO11 se baseia no Ultralytics YOLOv8, refinando a espinha dorsal e as camadas de extração de características. Ele reduziu os FLOPs, melhorou a eficiência dos parâmetros e proporcionou mAP mais alto, mantendo um forte desempenho em tempo real. Para tarefas de pose, isso significou maior precisão dos pontos-chave com uma arquitetura mais leve.
O YOLO26-pose dá continuidade a essa evolução com uma mudança arquitetural mais fundamental. Em poucas palavras, o YOLO11 refinou a eficiência e a precisão do YOLOv8, e o YOLO26 se baseia nessa fundação com atualizações arquiteturais e de treinamento voltadas a uma convergência mais rápida, inferência mais estável e maior precisão de pose em cenários complexos.
Por que começar a usar o modelo Ultralytics YOLO26 para estimativa de pose?#
Ao explorar as diferenças entre os modelos Ultralytics YOLO, você talvez esteja se perguntando se deve migrar para o YOLO26-pose.
A resposta curta é que a atualização é simples. Se você já usa o Ultralytics YOLOv8-pose ou o Ultralytics YOLO11-pose, migrar para o YOLO26-pose geralmente significa apenas mudar a versão do modelo, sem reconstruir seu pipeline.
Você pode aproveitar um suporte melhor a pontos-chave não humanos, convergência mais rápida durante o treinamento e tratamento aprimorado de pontos ocluídos, tudo isso mantendo o mesmo framework da Ultralytics. Para a maioria dos projetos de pose, novos ou existentes, migrar para o YOLO26-pose é uma maneira simples de obter essas melhorias com o mínimo de atrito.
Além disso, o YOLO26-pose tem suporte completo no pacote Python da Ultralytics, desenvolvido sobre PyTorch e que simplifica o treinamento, a validação e a implantação. Os modelos podem ser exportados para formatos como ONNX, TensorRT, OpenVINO, CoreML e TFLite, facilitando a implantação em GPUs, CPUs e dispositivos de borda sem alterar seu fluxo de trabalho geral.
Principais conclusões#
O Ultralytics YOLO26-pose torna a estimativa de pose mais flexível e confiável, especialmente ao trabalhar com pontos-chave não humanos ou cenas complexas. Ele treina mais rápido, lida melhor com oclusões e oferece resultados mais consistentes em diferentes conjuntos de dados. Para as equipes que já usam modelos de pose Ultralytics YOLO, o YOLO26 traz melhorias claras sem alterar os fluxos de trabalho existentes.
Quer saber mais sobre IA? Confira nossa comunidade e nosso repositório no GitHub. Explore nossas páginas de soluções para saber mais sobre IA em robótica e visão computacional na agricultura. Conheça nossas opções de licenciamento e comece hoje mesmo a desenvolver com visão computacional!









