最佳深度估计模型:如何选择
比较 Depth Anything、Depth Pro、Metric3D、UniDepth 和 Ultralytics YOLO26 等单目深度模型,了解它们在度量深度、边缘设备和机器人领域的表现。
选择深度估计模型归结为三点:你需要的是以米为单位的距离还是仅仅相对深度、模型将在何处运行,以及模型许可证是否允许你的使用方式。对于相对深度和研究,Depth Anything 和 Marigold 是值得优先评估的强大模型。对于未知相机的度量深度,可以考虑 Depth Pro 和 UniDepth;如果你知道相机的焦距,Metric3D v2 和 Depth Anything 3 Metric 也是可选方案。对于边缘硬件,可以优先考虑 Depth Anything V2 Small、MiDaS v3.1 Swin2-Tiny 和 LeViT 模型,然后在你的设备上测量延迟。对于 NVIDIA GPU 上的低延迟深度估计,以及其他 Ultralytics YOLO 任务,也可以评估 Ultralytics YOLO26 depth。本指南比较了九种单目深度模型,并提供了选择模型的决策路径。
如果你刚接触这项任务,可以先了解什么是单目深度估计。本页面介绍的是如何选择模型。
相对深度还是度量深度:先做出选择#
- 相对深度表示哪些像素更近或更远,但尺度未知。它足以用于场景理解、背景效果,以及按距离对物体排序。
- 度量深度以米为单位表示距离。你需要它来测量距离、规划机器人运动,或将深度与其他传感器的数据融合。
度量模型实现真实尺度的方式各不相同。有些模型会自行估计相机焦距,有些需要你提供焦距,还有些模型带有固定尺度,需要你针对相机进行标定。在实际应用中,模型获取尺度的方式可能比基准测试准确率相差几个百分点更重要。关于这两种深度的背景信息,请参阅术语表中的深度估计条目。
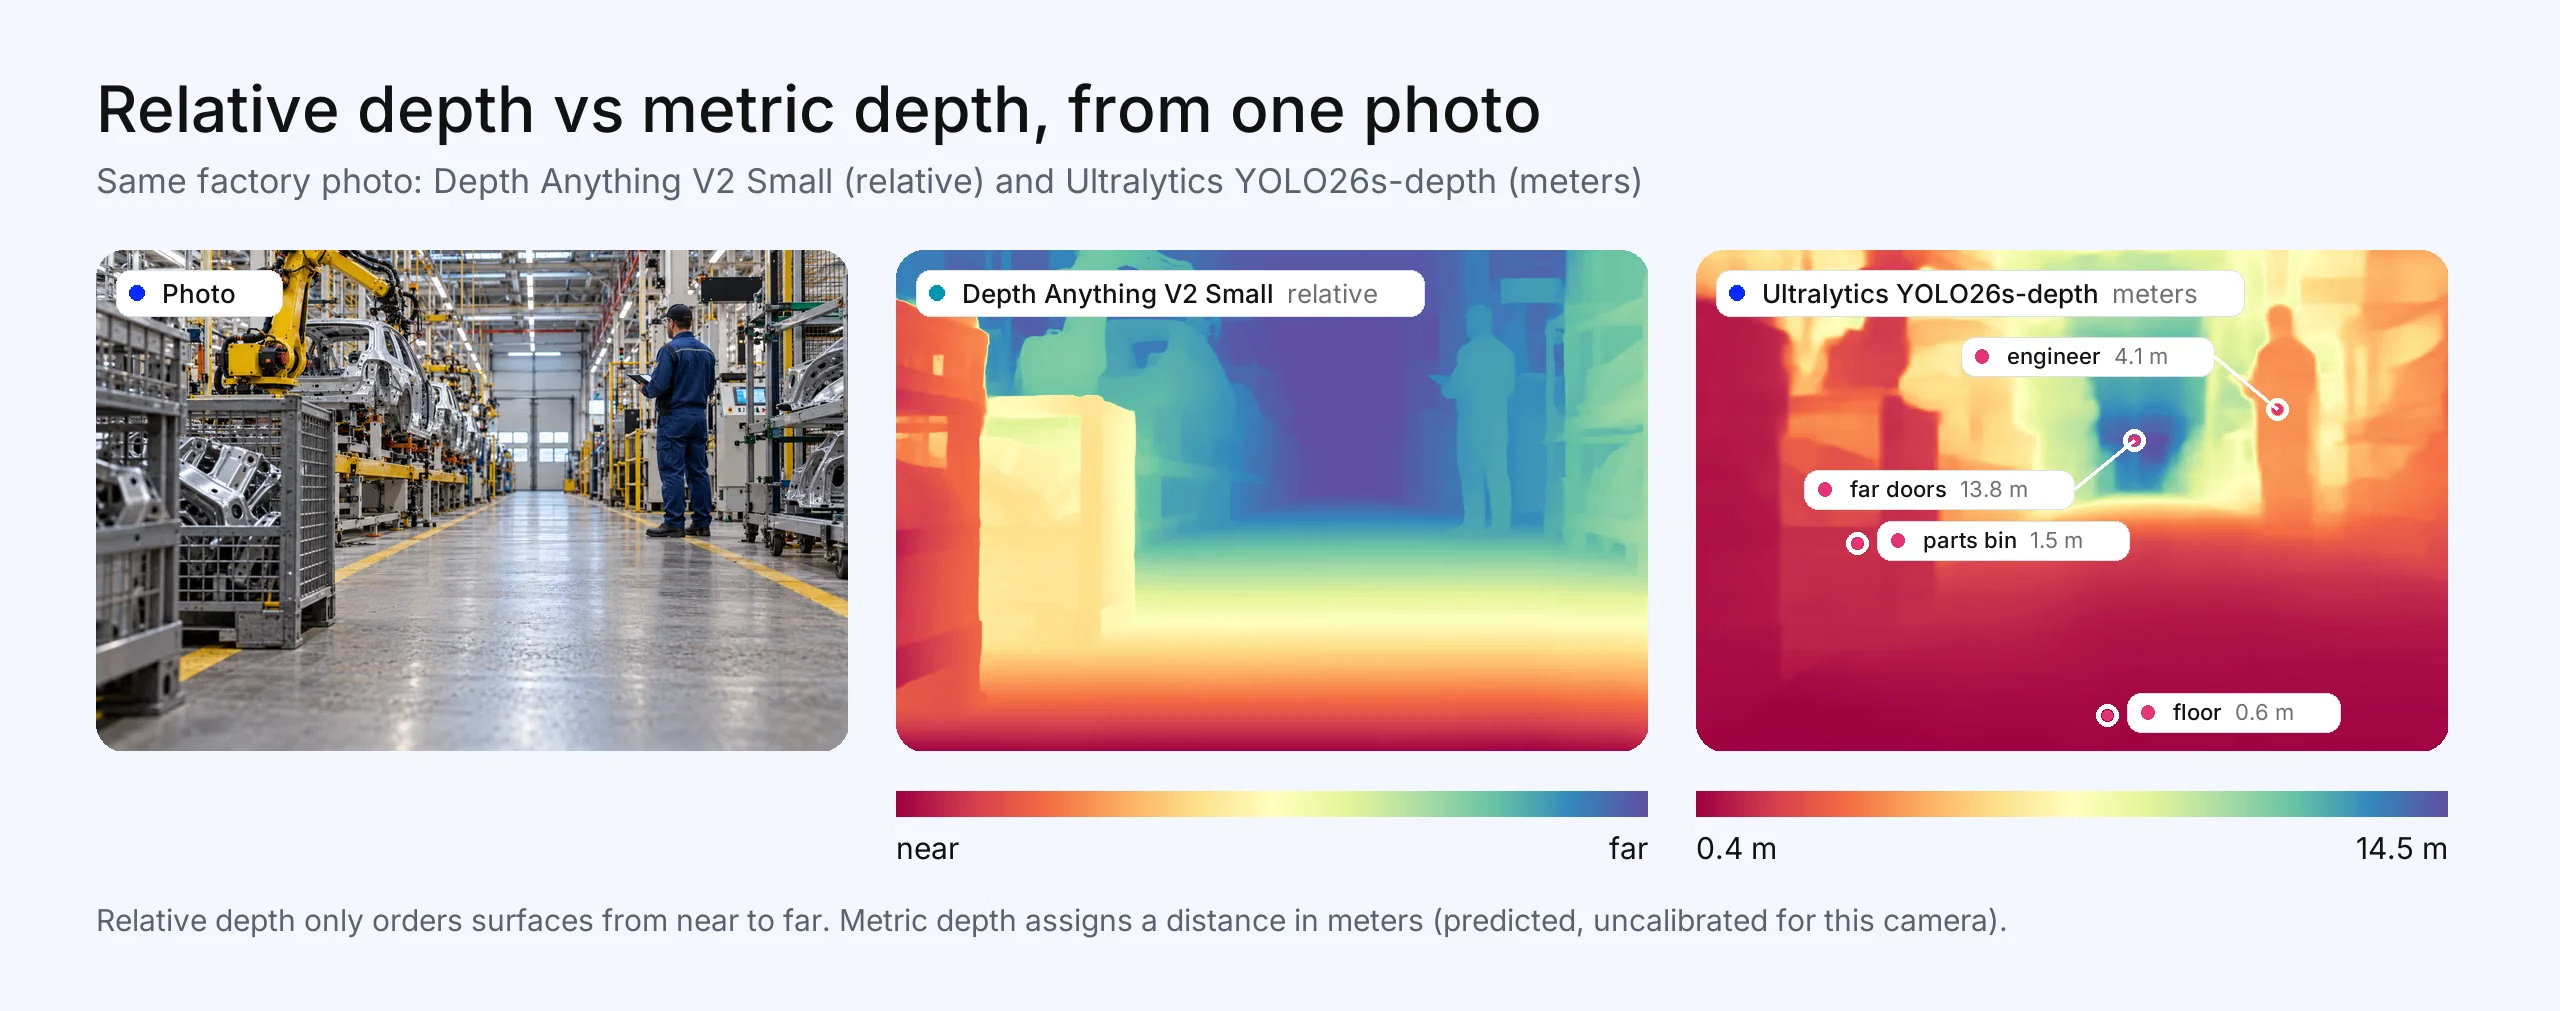
图 1. 同一张工厂照片分别由 Depth Anything V2 Small 和 Ultralytics YOLO26s-depth 处理。前者预测相对深度(表示远近,不带单位),后者预测距离(以米为单位):零件箱约 1.5 m,工程师约 4.1 m,远处的门约 13.8 m。这张照片是为本文生成的;两张深度图均为模型的真实输出。上述距离是已发布检查点的预测结果,未经针对该相机的标定,并非实际测量值。
深度估计模型对比#
模型按字母顺序列出,并非按排名排列。由于各论文采用各自的基准测试方案,结果无法直接比较,因此我们不列出跨模型的准确率数据。许可证信息于 2026 年 10 月核实,适用于各个检查点。
| 模型 | 输出 | 规模 | 许可证 | 最适合 | 主要权衡 |
|---|---|---|---|---|---|
| Depth Anything 3 | 相对深度;已知焦距时可估计度量深度(DA3Metric) | Small 为 0.08B,Giant 为 1.15B,另有一个 1.40B Nested 模型(按项目列出的信息) | Small、Base、Metric-Large 和 Mono-Large:Apache 2.0。Large、Giant 和 Nested:CC BY-NC 4.0 | 除深度外,还支持多视角几何和相机姿态 | 较大的模型不可商用;DA3Metric-Large 需要相机焦距(不可商用的 Nested 模型可直接输出米制距离) |
| Depth Anything V2 | 相对深度;另有独立的室内和室外度量深度检查点 | Small 为 24.8M,Base 为 97.5M,Large 为 335.3M | Small:Apache 2.0。Base 和 Large:CC-BY-NC-4.0 | 稳健的通用相对深度模型 | 只有 Small 获得商用许可;度量深度检查点的距离上限为 20 m(室内)或 80 m(室外) |
| Depth Pro(Apple) | 度量深度,无需相机内参 | 单个模型 | Apple 自行制定的代码和权重许可证 | 从未知相机拍摄的照片中获得清晰的度量深度 | 比边缘设备模型更大、更耗资源;请核查许可证条款是否适用于你的用途 |
| Marigold | 相对深度(仿射不变) | 基于潜在扩散模型构建 | 代码:Apache 2.0。模型:RAIL++-M | 不在意速度时追求精细细节 | 比单次前向模型慢,尤其是使用集成时 |
| Metric3D v2 | 度量深度和表面法线 | ViT-Small、ViT-Large、ViT-giant2 | 代码:BSD-2-Clause;请查看检查点条款 | 度量深度加表面法线,适用于 3D 重建 | 需要准确的焦距才能获得正确的尺度 |
| MiDaS | 相对深度 | v3.1,涵盖从 BEiT-Large 512 到 Swin2-Tiny 256 和 LeViT 224 的模型 | MIT | 知名基线模型,采用宽松许可证并提供嵌入式设备变体 | 早于较新的基础模型;仓库已归档,不再维护 |
| Ultralytics YOLO26 深度估计 | 度量深度(米),可校准的单一全局尺度 | n 6.3M 至 x 57.0M | AGPL-3.0,或 Ultralytics Enterprise 许可证 | 在 NVIDIA GPU 上以低延迟运行深度估计,并同时执行其他 YOLO 任务 | 绝对尺度需要针对你的相机进行校准;未在统一精度评估协议下与其他模型比较 |
| UniDepth V2 | 从单张图像预测度量深度和相机内参 | ViT-S、ViT-B 和 ViT-L 主干网络 | CC BY-NC 4.0 | 相机型号未知时的度量深度 | 非商业许可证 |
| ZoeDepth | 度量深度(室内、室外或混合头),基于相对深度预训练构建 | 基于 ViT | MIT | 适用于已知室内或室外场景的宽松许可度量深度模型 | 针对特定室内和室外场景训练;仓库已归档,不再维护 |
如何选择深度估计模型#
按顺序回答以下问题:
- 你需要以米为单位的深度吗? 如果不需要,可以先试试 Depth Anything V2 或 Depth Anything 3;如果你需要 MIT 许可证,则可以选择 MiDaS。
- 你知道相机内参吗? 如果不知道,选择能估算内参的模型:Depth Pro 或 UniDepth。如果知道,Metric3D v2 和 Depth Anything 3 Metric 可以使用这些内参。
- 模型会在哪里运行? 如果服务器延迟不是限制因素,大型基础模型会是不错的选择。若要在 NVIDIA GPU 上以低延迟运行深度估计,并同时执行其他 YOLO 任务,可以考虑 Ultralytics YOLO26 深度估计,并在你的边缘设备上测量性能,例如 NVIDIA Jetson。其他候选模型包括 Depth Anything V2 Small、MiDaS v3.1 的 Swin2-Tiny 和 LeViT 模型。CPU 延迟取决于处理器、运行时、输入分辨率和模型。请针对你的确切配置进行基准测试;图 3 展示了一个小型 Ultralytics YOLO26 深度估计模型的示例。请参阅下文的边缘设备部分。
- 你能使用该许可证吗? 请查看具体检查点的许可证。多个系列的小型模型采用 Apache 2.0 许可证,而大型模型则采用非商业许可证。
- 你能进行校准或微调吗? 如果你能从自己的相机采集约 50 到 150 张带标签图像,并为每张图像测量几个点,可以在你自己的场景中测试校准或微调后的模型,并与零样本模型进行比较。在 Ultralytics 使用 YOLO26s-depth 进行的测试中(每台相机 150 张图像,每张图像测量 5 个点),通过这种方式校准后,其尺度与完整真值拟合结果的偏差约为 1%;校准前的偏差为 4% 到 46%。这个数值衡量的是尺度恢复效果,而非整体深度精度。
然后,在你的部署分辨率下,使用来自自己相机的图像测试两到三个候选模型。
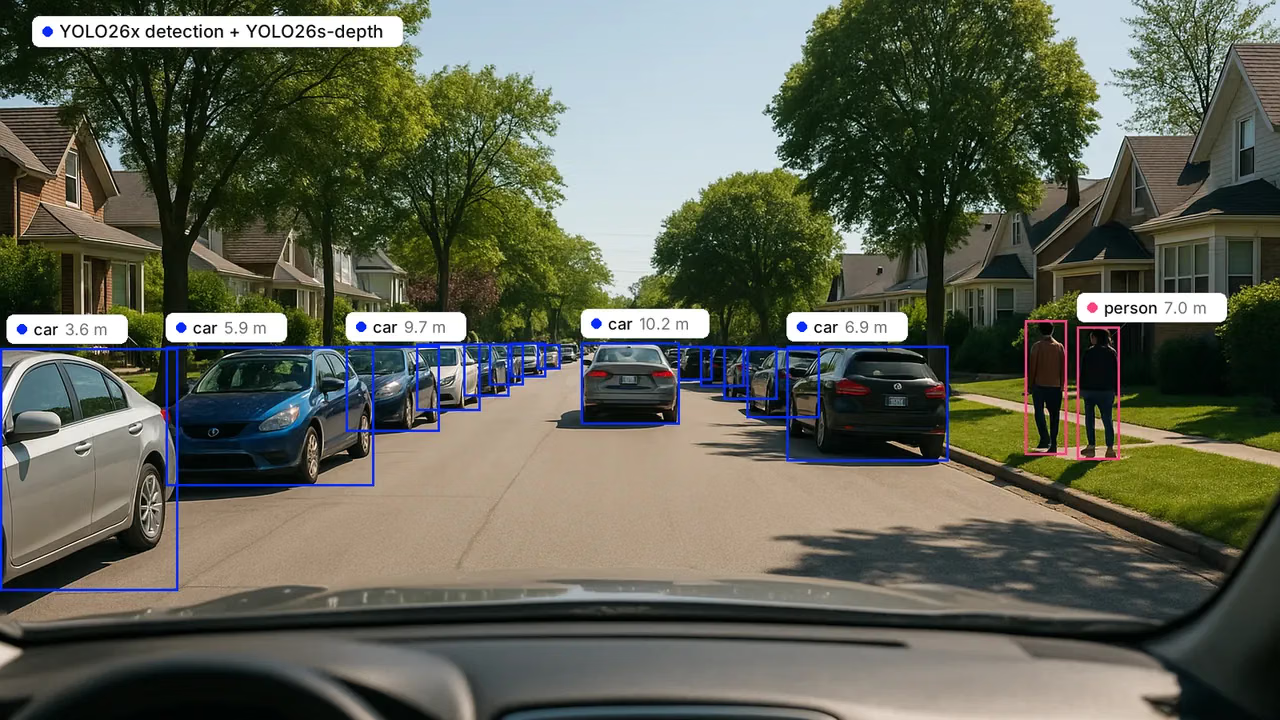
图 2. 将 Ultralytics YOLO26x 检测与 Ultralytics YOLO26s-depth 相结合,预测选定检测到的汽车和行人的距离:距离最近的停放汽车 3.6 m,距离右侧汽车 6.9 m,距离右侧标注的行人 7.0 m。这张照片是为本文生成的;边界框和距离均为真实模型输出,但未经针对这台相机校准。它们是预测值,而非实测距离。
模型详解#
按字母顺序列出。
Depth Anything 3#
ByteDance Seed 推出的 Depth Anything 3 将 Depth Anything 从单张图像扩展到任意数量的视图。其主模型会同时估计深度和相机位姿,专用变体则用于单目相对深度(DA3Mono-Large)和单目度量深度(DA3Metric-Large)。输出:主模型和 Mono 模型输出相对深度;DA3Metric-Large 在提供焦距时输出度量深度,非商业 Nested 模型则可直接输出度量深度。尺寸:0.08B(Small)至 1.15B(Giant),另有 1.40B 的 Nested 模型,具体信息见项目模型卡。许可证:Small、Base、Metric-Large 和 Mono-Large 采用 Apache 2.0;Large、Giant 和 Nested 采用 CC BY-NC 4.0。最适合:多视图场景和 3D 重建。权衡:性能最强的检查点仅限非商业用途。
Depth Anything V2#
Depth Anything V2 是一种广泛可用的相对深度开源模型,在室内、室外和少见场景中都能稳定输出结果。该项目还发布了针对室内场景(深度最高 20 m)和室外场景(深度最高 80 m)微调的度量深度检查点。尺寸:Small 24.8M、Base 97.5M、Large 335.3M。许可证:Small 采用 Apache 2.0;Base 和 Large 采用 CC-BY-NC-4.0。最适合:通用相对深度估计。权衡:如果你需要商业用途,只能使用 Small 模型;度量深度检查点无法预测超出其固定最大深度的范围。
Depth Pro#
Apple 推出的 Depth Pro 无需相机内参,即可从单张图像预测度量深度,并自行估算焦距。Apple 报告称,该模型可在标准 GPU 上于 0.3 秒内生成 2.25 百万像素的深度图,并能清晰呈现精细结构的边界。许可证:Apple 自有许可证涵盖代码和权重。最适合:从相机不受你控制的照片中估算度量深度。权衡:这是服务器级模型,而非边缘设备模型;用于商业用途前,你应先阅读其许可证。
Marigold#
Marigold 将预训练图像扩散模型用于深度估计,并且仅使用合成数据进行训练。它能生成非常精细的相对深度。许可证:代码采用 Apache 2.0,模型采用 RAIL++-M。最适合:离线工作中对细节的要求高于速度的场景,例如内容创作和数据集生成。权衡:它支持单步推理;若通过集成提高精度,成本会成倍增加,因此请测量它是否满足你的延迟要求。
Metric3D v2#
Metric3D v2 可从单张图像预测度量深度和表面法线,提供 ViT-Small、ViT-Large 和 ViT-giant2 检查点,并包含 ONNX 导出版本。许可证:代码采用 BSD-2-Clause;请查看你所用检查点的条款。最适合:同时需要表面法线的 3D 重建和机器人流程。权衡:它会将图像映射到规范相机,因此需要准确的焦距才能获得正确的尺度。
MiDaS#
Intel 的 ISL 推出的 MiDaS 通过在混合数据集上训练,让稳健的相对深度估计变得实用。3.1 版提供从追求质量的 BEiT-Large 模型,到面向嵌入式设备的 Swin2-Tiny 和 LeViT 模型;此外还有旧版 MiDaS v2.1 小型模型的 OpenVINO 格式版本,适用于 Intel CPU,以及适用于 iOS 和 Android 的移动端示例。许可证:MIT。最适合:许可证宽松且文档完善的基线模型。权衡:它早于较新的基础模型,而且 Intel 已归档该仓库,因此不再提供修复。请用你自己的图像将它与较新的模型进行比较。
Ultralytics YOLO26 深度估计#
Ultralytics YOLO26 支持深度估计(于 2026 年 7 月发布,提供五种尺寸,参数量从 6.3M(n)到 57.0M(x),输入分辨率为 768 像素。模型以米为单位预测深度,使用的对数深度头覆盖约 0.02 至 150 米,因此单个模型即可处理室内房间和室外场景。发布的权重使用单一全局尺度;若要针对特定相机获得准确的绝对深度,model.calibrate() 会利用约 50 到 150 张带标签图像拟合尺度,每张图像只需几个测量点,无需重新训练。在 NVIDIA T4 上进行的 batch-1 TensorRT FP16 基准测试中,输入约为 768 像素时,仅推理延迟(不含预处理和后处理)从 2.7 ms(n)到 13.6 ms(x)不等,五种尺寸的延迟都低于 Depth Anything V2 Small。这是延迟比较,并非统一精度评估。模型可导出为 ONNX、TensorRT、CoreML、OpenVINO 等格式,并可使用与检测、分割和姿态相同的 Python API 和 CLI 进行训练。许可证:AGPL-3.0;闭源商业用途可选择 Ultralytics Enterprise 许可证。最适合:在 NVIDIA GPU 上以低延迟运行深度估计,并同时执行其他 YOLO 任务;请在你的边缘设备上测量性能。权衡:绝对尺度取决于针对相机进行的校准;而且此处未在统一协议下将其精度与基础模型进行比较,因此请使用你自己的数据进行测试。
UniDepth V2#
UniDepth 可从单张 RGB 图像预测度量深度和相机内参;如果你已知内参,也可以使用这些内参。许可证:CC BY-NC 4.0。最适合:需要从未知相机获取度量深度的研究和原型项目。权衡:该许可证不允许商业用途。
ZoeDepth#
ZoeDepth 将相对深度预训练与针对室内(NYU)和室外(KITTI)场景的度量深度头相结合。许可证:MIT。最适合:场景与其室内或室外训练领域相似,且需要宽松许可证的度量模型。权衡:该模型针对特定室内和室外领域训练,而 UniDepth 和 Metric3D v2 等较新的度量模型是为多种相机设计的。Intel 已归档该仓库,因此不再提供修复。
在边缘设备上进行深度估计#
在边缘硬件上,关注点会从“精度最高”转向“在我的帧率下精度是否足够”。有三类模型适用:
- 大型模型系列的小型版本。 Depth Anything V2 Small(24.8M 参数,Apache 2.0)是一个选择,并采用宽松许可证。MiDaS v3.1 的 Swin2-Tiny 和 LeViT 模型则专为嵌入式设备设计。
- 实时任务模型。Ultralytics YOLO26 深度估计 在 Tesla T4 上使用 TensorRT FP16、batch 1 时,仅推理耗时为 2.7 ms(n)至 13.6 ms(x),不含预处理和后处理。它可导出为 TensorRT,用于 NVIDIA Jetson;导出为 CoreML,用于 Apple 设备;也可导出为 OpenVINO,用于 Intel CPU;导出支持并不等于边缘设备基准测试。
- 轻量级研究模型。FastDepth(MIT)专为嵌入式系统打造,并已在 NVIDIA Jetson TX2 上进行演示。Lite-Mono(MIT)有 2.2M 到 8.7M 个参数,使用 KITTI 驾驶数据训练。
导出后,请在目标设备上以实际部署分辨率测量推理延迟。要选择硬件,请参阅如何选择合适的边缘设备。如需了解导出选项,请参阅我们的模型部署选项指南。
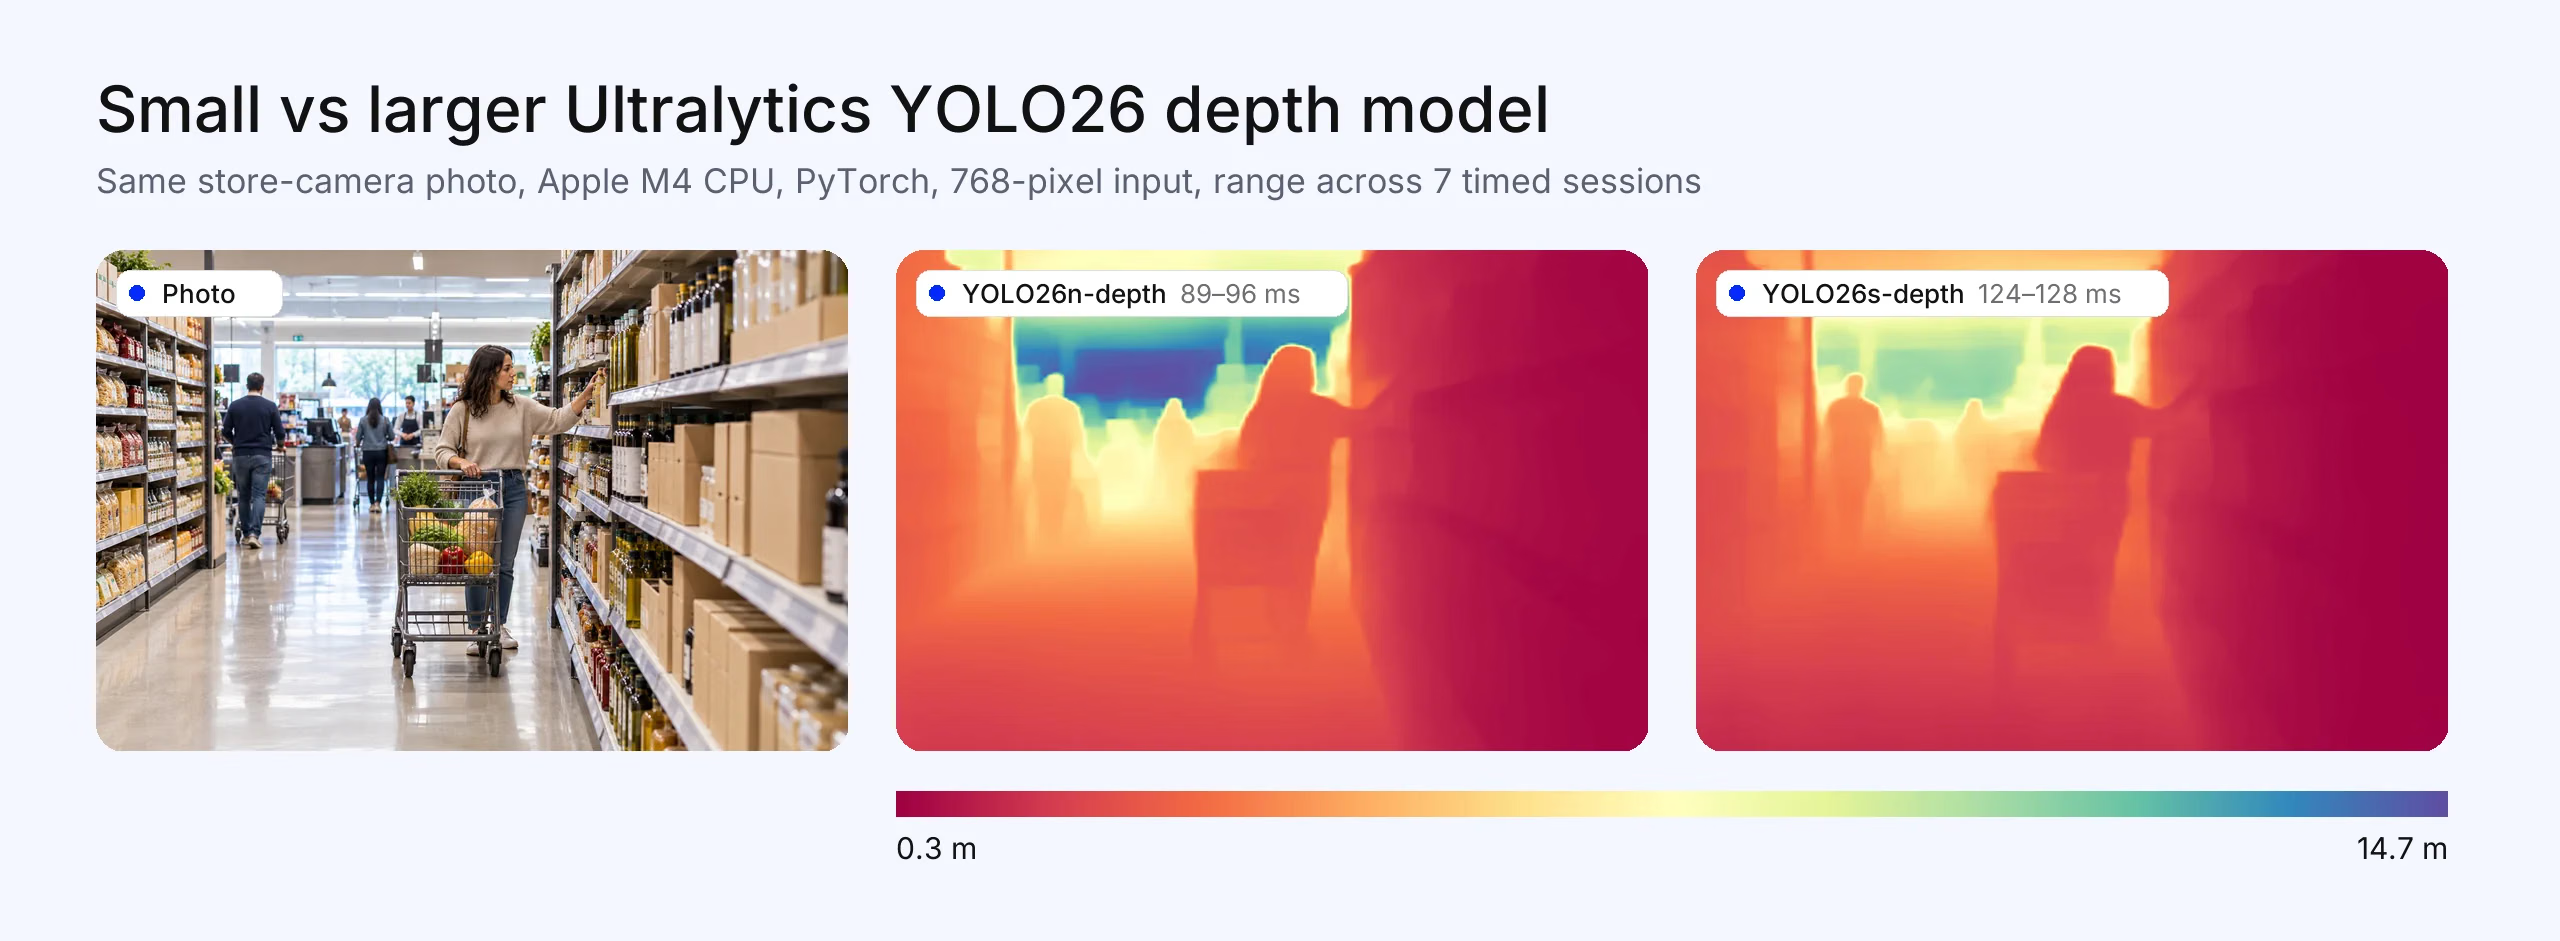
图 3. 在同一张商店照片上运行 Ultralytics YOLO26n-depth(89 到 96 ms)和 YOLO26s-depth(124 到 128 ms),使用 Apple M4 CPU(PyTorch,768 像素输入,从图像到完整深度图)。笔记本电脑的耗时会随后台负载变化,因此请将这些数值视为范围。这张照片是为本文生成的;深度图和耗时均为真实结果。
面向机器人的深度估计#
机器人通常需要以机器人的控制频率运行、帧间稳定的度量深度。以下是三种实用方案:
- 单目度量模型适用于配备单个 RGB 相机的机器人。如果你已知相机内参,可使用 Metric3D v2 或 Depth Anything 3 Metric;如果需要在 NVIDIA GPU 上以低延迟进行机载推理,并同时执行其他 YOLO 任务,可使用经过校准的 Ultralytics YOLO26 深度估计模型;请在机器人计算机上测量性能。
- 双目模型(例如 NVIDIA 的 FoundationStereo)可根据经过校准的相机对计算度量深度。研究版本仅限非商业用途;NVIDIA 列出了可用于商业用途的 TAO 版本。请参阅双目视觉,了解双目视觉与单目深度估计的比较。
- 深度传感器(双目深度相机、结构光或 LiDAR)可直接测量深度。
不适合使用单目模型的情况:对于人员附近的避碰等安全关键决策,应使用深度传感器或双目相机,并将单目深度估计作为补充,例如填补传感器没有返回数据的区域。
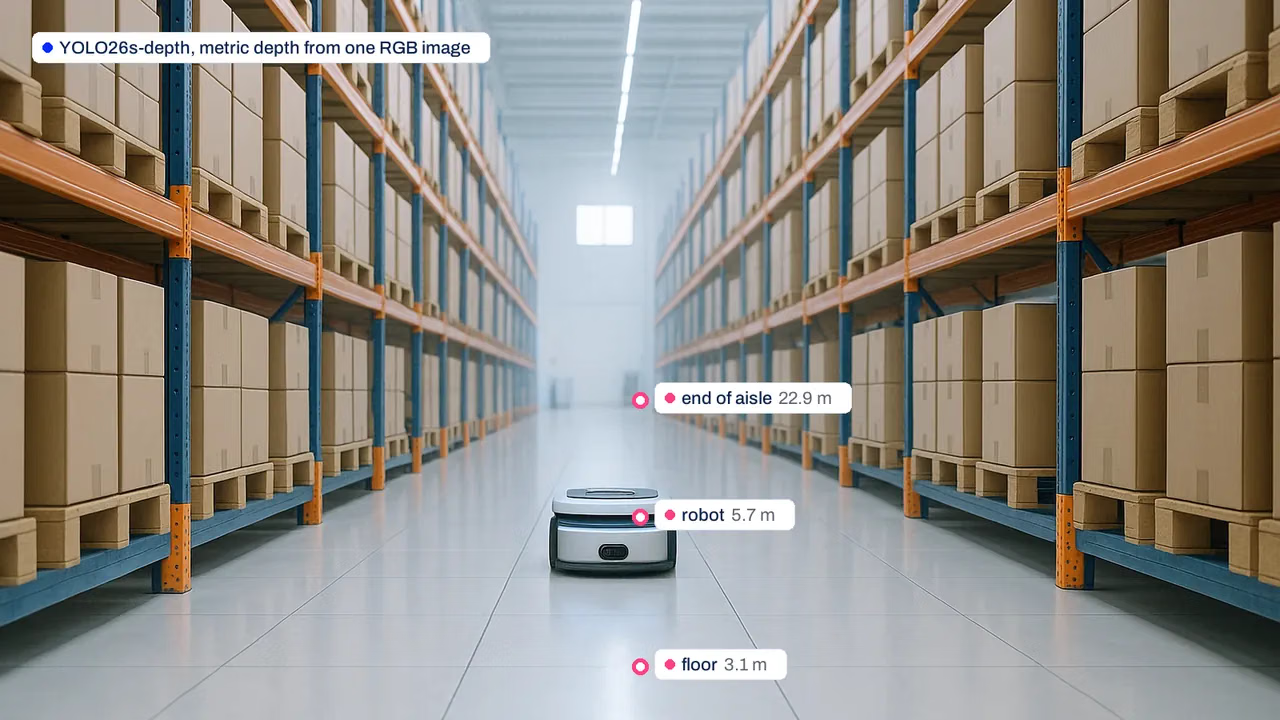
图 4. 从一张 Ultralytics YOLO26s-depth 深度图读取的预测距离:到地面某点 3.1 m,到机器人 5.7 m,到过道尽头约 23 m。这张照片是为本文生成的;读数是模型的真实输出,但未经针对这台相机校准,因此属于预测值,而非测量值。
如何使用自己的相机测试深度模型#
- 使用部署相机采集约 50 到 150 张带标签图像,并保持部署分辨率和镜头设置不变,同时为每张图像测量几个点。公共基准数据集(例如室内场景的 NYU Depth V2 和驾驶场景的 KITTI)可用于初步比较,但最终应以自己相机上的结果为准。
- 测距仪测量的是直线距离,而校准需要沿相机轴向的深度:测量图像中心附近的点;使用相机内参将偏离中心的读数转换为相机轴向深度;或者使用深度传感器采集深度。
- 根据这些测量值比较候选模型的 δ1 和绝对相对误差,并测量每个模型在目标设备上的运行时间。对于度量模型,直接对未经缩放的输出进行评分,不要逐张图像调整尺度以匹配真值;逐图对齐会掩盖你需要发现的尺度误差。
- 对于尺度固定的度量模型,使用部分数据进行校准,再用其余数据测试。Ultralytics YOLO26 深度估计通过
model.calibrate()提供此功能。
常见问题
没有适用于所有情况的最佳模型。对于相对深度,Depth Anything V2 和 Depth Anything 3 是值得优先评估的强力选择。Depth Pro、UniDepth 和 Metric3D v2 可以从单张图像获取度量深度。若要在 NVIDIA GPU 上以低延迟运行深度估计,并同时执行其他 YOLO 任务,可以评估 Ultralytics YOLO26 深度估计,并在你的边缘设备上测量性能。Depth Anything V2 Small、MiDaS v3.1 的 Swin2-Tiny 和 LeViT 模型也是值得测试的较轻量选择。
优先考虑体积小且可导出至你所用运行时的模型:Ultralytics YOLO26 深度估计(6.3M 到 57.0M 参数,可导出为 TensorRT、CoreML 和 OpenVINO)、Depth Anything V2 Small(24.8M 参数),以及 MiDaS v3.1 的 Swin2-Tiny 或 LeViT 模型。然后在你自己的设备上测量延迟;支持导出并不能证明模型在边缘设备上的性能。
机器人通常需要度量深度。Metric3D v2 和 Depth Anything 3 Metric 可以使用已知相机内参,根据单张图像预测以米为单位的深度;UniDepth 可以自行估算内参。根据文档,Ultralytics YOLO26 深度估计在 T4 上使用 TensorRT FP16、输入约为 768 像素、batch 1 时,仅推理延迟为 2.7 到 13.6 ms,不含预处理和后处理;请在机器人自己的计算机上测量性能。对于安全关键导航,应使用双目相机或深度传感器,并将单目深度估计作为补充;FoundationStereo 是值得评估的一种双目模型。
Depth Anything V2 的主模型预测相对深度。该项目还发布了针对室内场景(深度最高 20 米)和室外场景(深度最高 80 米)微调的度量深度检查点。
请检查每个检查点的许可证。MiDaS 和 ZoeDepth 采用 MIT 许可证(两个仓库目前都已归档);Metric3D 的代码采用 BSD-2-Clause(请查看检查点条款);Depth Anything V2 Small 和多个 Depth Anything 3 模型采用 Apache 2.0;Marigold 的模型采用 RAIL++-M。Depth Anything V2 Base 和 Large、较大型的 Depth Anything 3 模型以及 UniDepth 仅限非商业用途。Ultralytics YOLO26 深度估计采用 AGPL-3.0;闭源商业用途可选择 Enterprise 许可证。Depth Pro 使用 Apple 自有许可证,允许使用和再分发,但不授予专利权;发布产品前请先仔细阅读许可证。









