使用 Ultralytics YOLO26 在 Python 中进行 OCR:以任意角度读取文档、照片和 PDF
使用 Ultralytics YOLO26-Text 和 PP-OCRv6,只需几行 Python 代码,就能读取任意旋转角度的图像和 PDF 页面中的文字,并可选择使用 CPU 或 GPU,以及 TensorRT。
 Jing Qiu11 分钟阅读
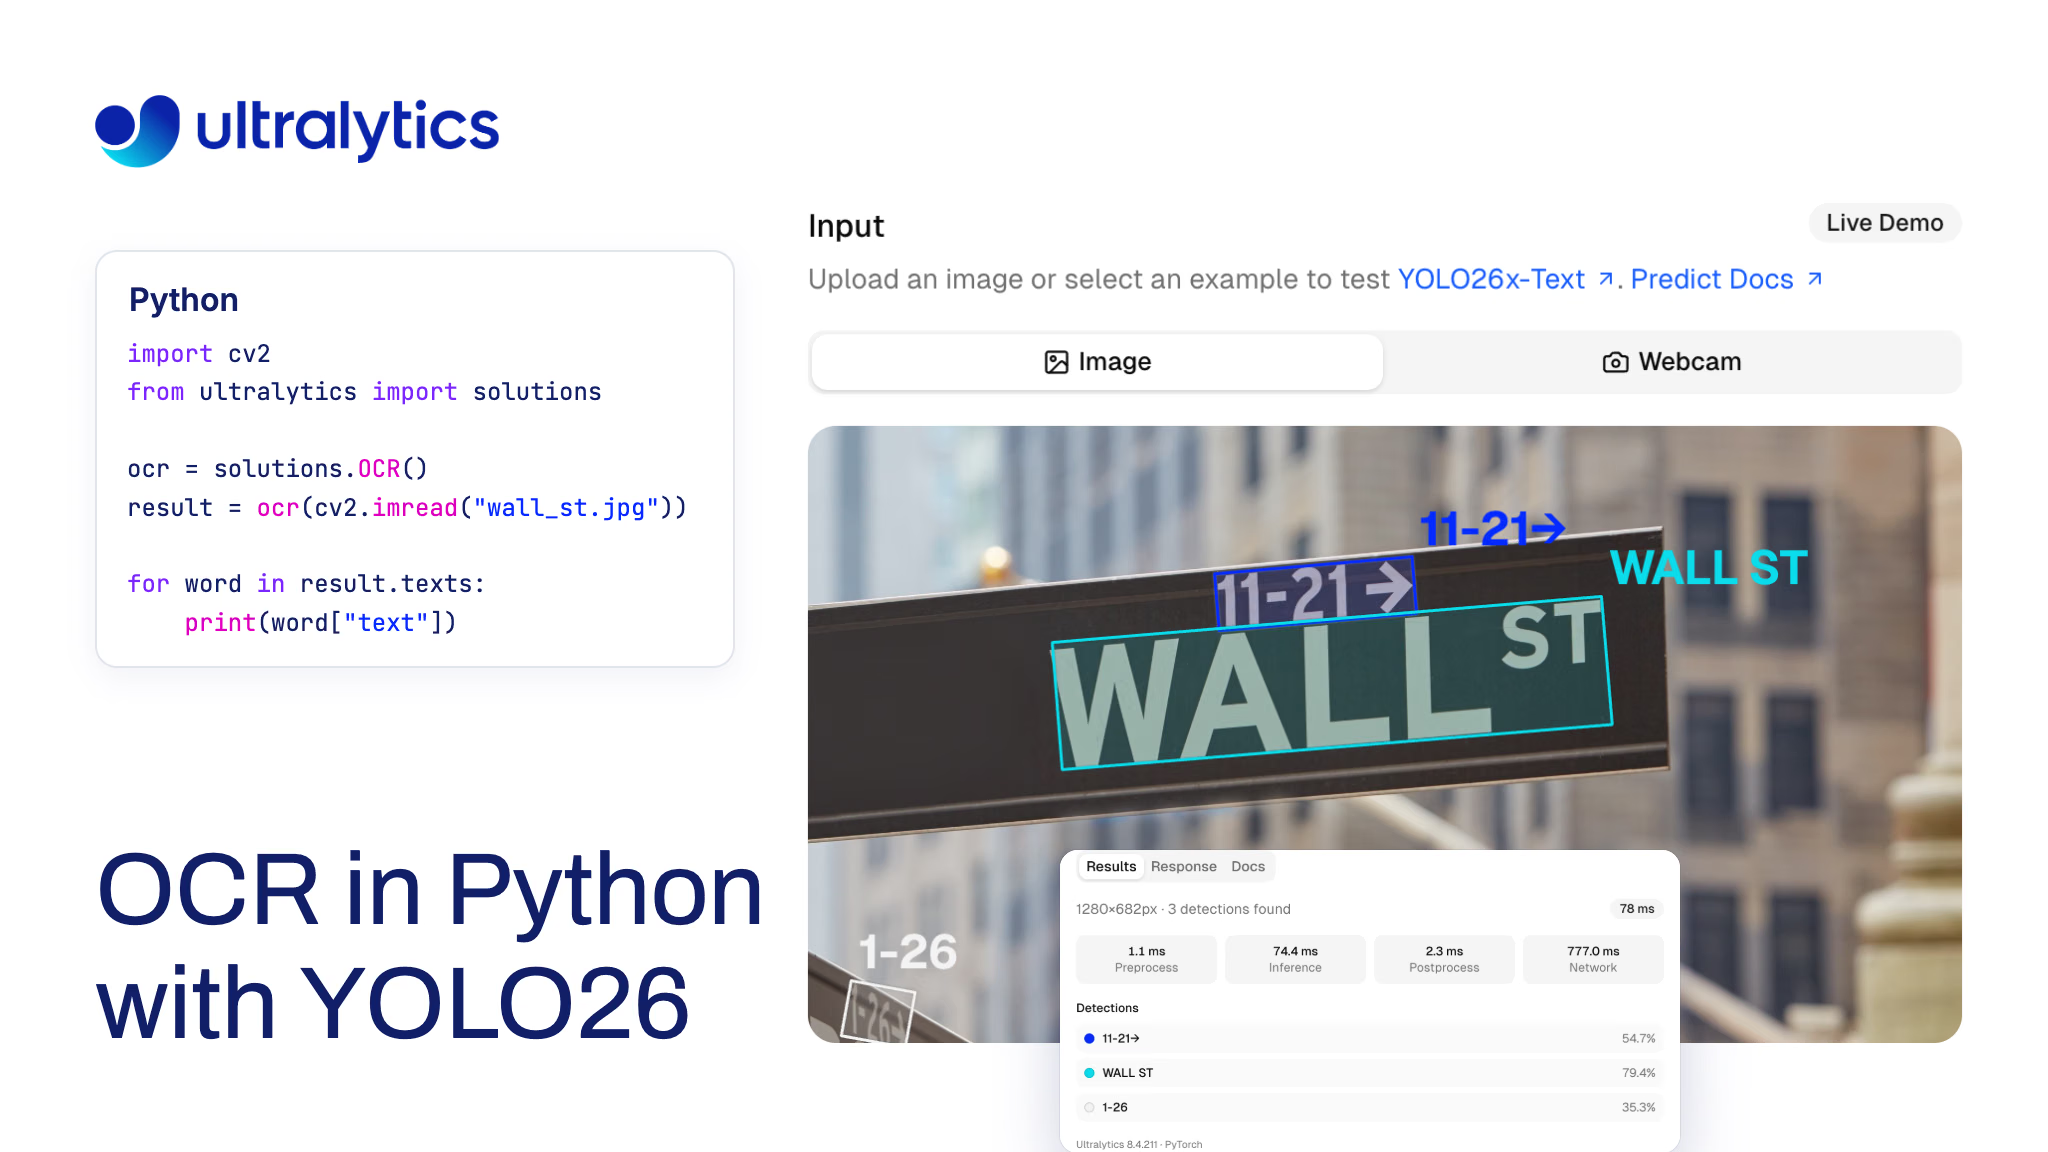
如何在 Python 中对横放的扫描件、手机拍摄的街牌照片或 PDF 页面执行 OCR,并按照人们的阅读顺序还原文字?使用 Ultralytics 软件包,只需一个类:solutions.OCR() 会使用 Ultralytics YOLO26-Text 模型检测文字,使用 PaddleOCR 的 PP-OCRv6 识别器读取每个单词,并逐行返回识别出的文字,支持任意页面旋转角度,也可在 CPU 或 GPU 上运行。
这条处理流程是全新的。Ultralytics 8.4.210 基于 ONNX Runtime 和 PP-OCRv6 重建了 OCR 方案,加入了旋转处理和阅读顺序功能;8.4.211 则新增了可选的 TensorRT 识别器。在我们的基准测试中,图像尺寸为 1280 时,默认配置在 6 个 PDF 页面上的单词级 F1 分数为 0.931,在 80 张 HierText 照片上为 0.722。在 RTX PRO 6000 上,缓存的 FP16 TensorRT 引擎用 82 毫秒读取了单张照片中检测到的 251 个单词;使用 CUDA 上的 ONNX Runtime 则需要 249 毫秒。
本指南介绍这条处理流程的工作原理、如何在图像和 PDF 上运行、运行速度,以及目前支持识别的语言。Ultralytics 提供了下文对比的 OCR 选项之一,因此对比内容仅限各项目文档中说明的功能。
YOLO26 OCR 分两步读取页面,然后按顺序排列文字#
光学字符识别(OCR)需要完成两项工作:找到文字,然后读取文字。Ultralytics OCR 方案将这两项工作清晰地拆分开:
- 检测:YOLO26-Text 模型是一种有向边界框检测器,会在文字周围绘制旋转框。它有 n、s、m、l 和 x 五种尺寸,默认使用 x 模型。
- 识别:PP-OCRv6 medium 会读取每个裁剪区域。它使用 Ultralytics 资源发布版中的 ONNX Runtime 运行,因此无需安装 PaddlePaddle。识别结果为空的裁剪区域会被丢弃。
- 排序:文字会被分组成行,并按从上到下、从左到右的顺序返回,每个单词都标有行号。
每个单词都会作为一条记录返回,其中包含文字、识别置信度、检测器置信度、行号,以及原始图像坐标中的多边形。由于两种置信度分别保留,如果某个单词检测置信度高但识别置信度低,你可以将它交由人工审核,而不是直接相信识别结果。
这两个阶段彼此独立。你可以换用更小的检测器、自定义的检测或分割模型,或其他识别器,旋转处理和阅读顺序功能仍然有效。在安装任何内容之前,你可以先在我们的文档处理页面中通过浏览器尝试同一条代码处理流程。
正确读取旋转和倒置页面中的文字顺序#
该方案会根据检测到的文字推断页面的旋转角度,因此你无需事先校正倾斜或旋转页面:
- 确定文字方向。它会根据检测框的长宽比加权,对检测框长边的角度取平均值。长宽比小于 2:1 的检测框(例如只有一个数字的框)不会参与判断。
- 旋转页面。将页面旋转至文字从左向右排列,然后把每个单词裁剪为正向,并将单词分组成行。
- 判断 0° 或 180°。检测框无法判断文字正反朝向,因此该方案会将最宽的 8 个单词分别按两个方向读取,并保留识别置信度更高的方向。倒置文字会被识别为低置信度噪声,因此正确方向会更明显。
我们将 8 份文档和屏幕截图,以及 12 张照片分别旋转至 90°、180° 和 270°,文档的单词级 F1 分数为 0.925,照片为 0.654。在空白的 IRS Form 8802 上,该方案在 0°、180° 和 90° 下分别读取出 404、401 和 399 个单词,且首行完全相同。旧版本假定每个页面都是正向的。
默认值来自基准测试,而非猜测#
我们通过测量来确定主要默认值。基准测试在 RTX PRO 6000 上使用生产环境 Platform 镜像运行,上传图像为 JPEG,长边最多 1280 像素。测试使用了 Google HierText 数据集中的 80 张验证照片及其清晰可读单词标注、6 个依据文本层评分的 PDF 页面(来自一篇 arXiv 论文的 4 页,以及空白的 IRS Forms 1040 和 8802)、一张合成屏幕截图和一张合成图像。指标为单词级 F1 分数,用于衡量精确率和召回率之间的平衡;统计时只计入至少包含 2 个字母数字字符的小写单词。
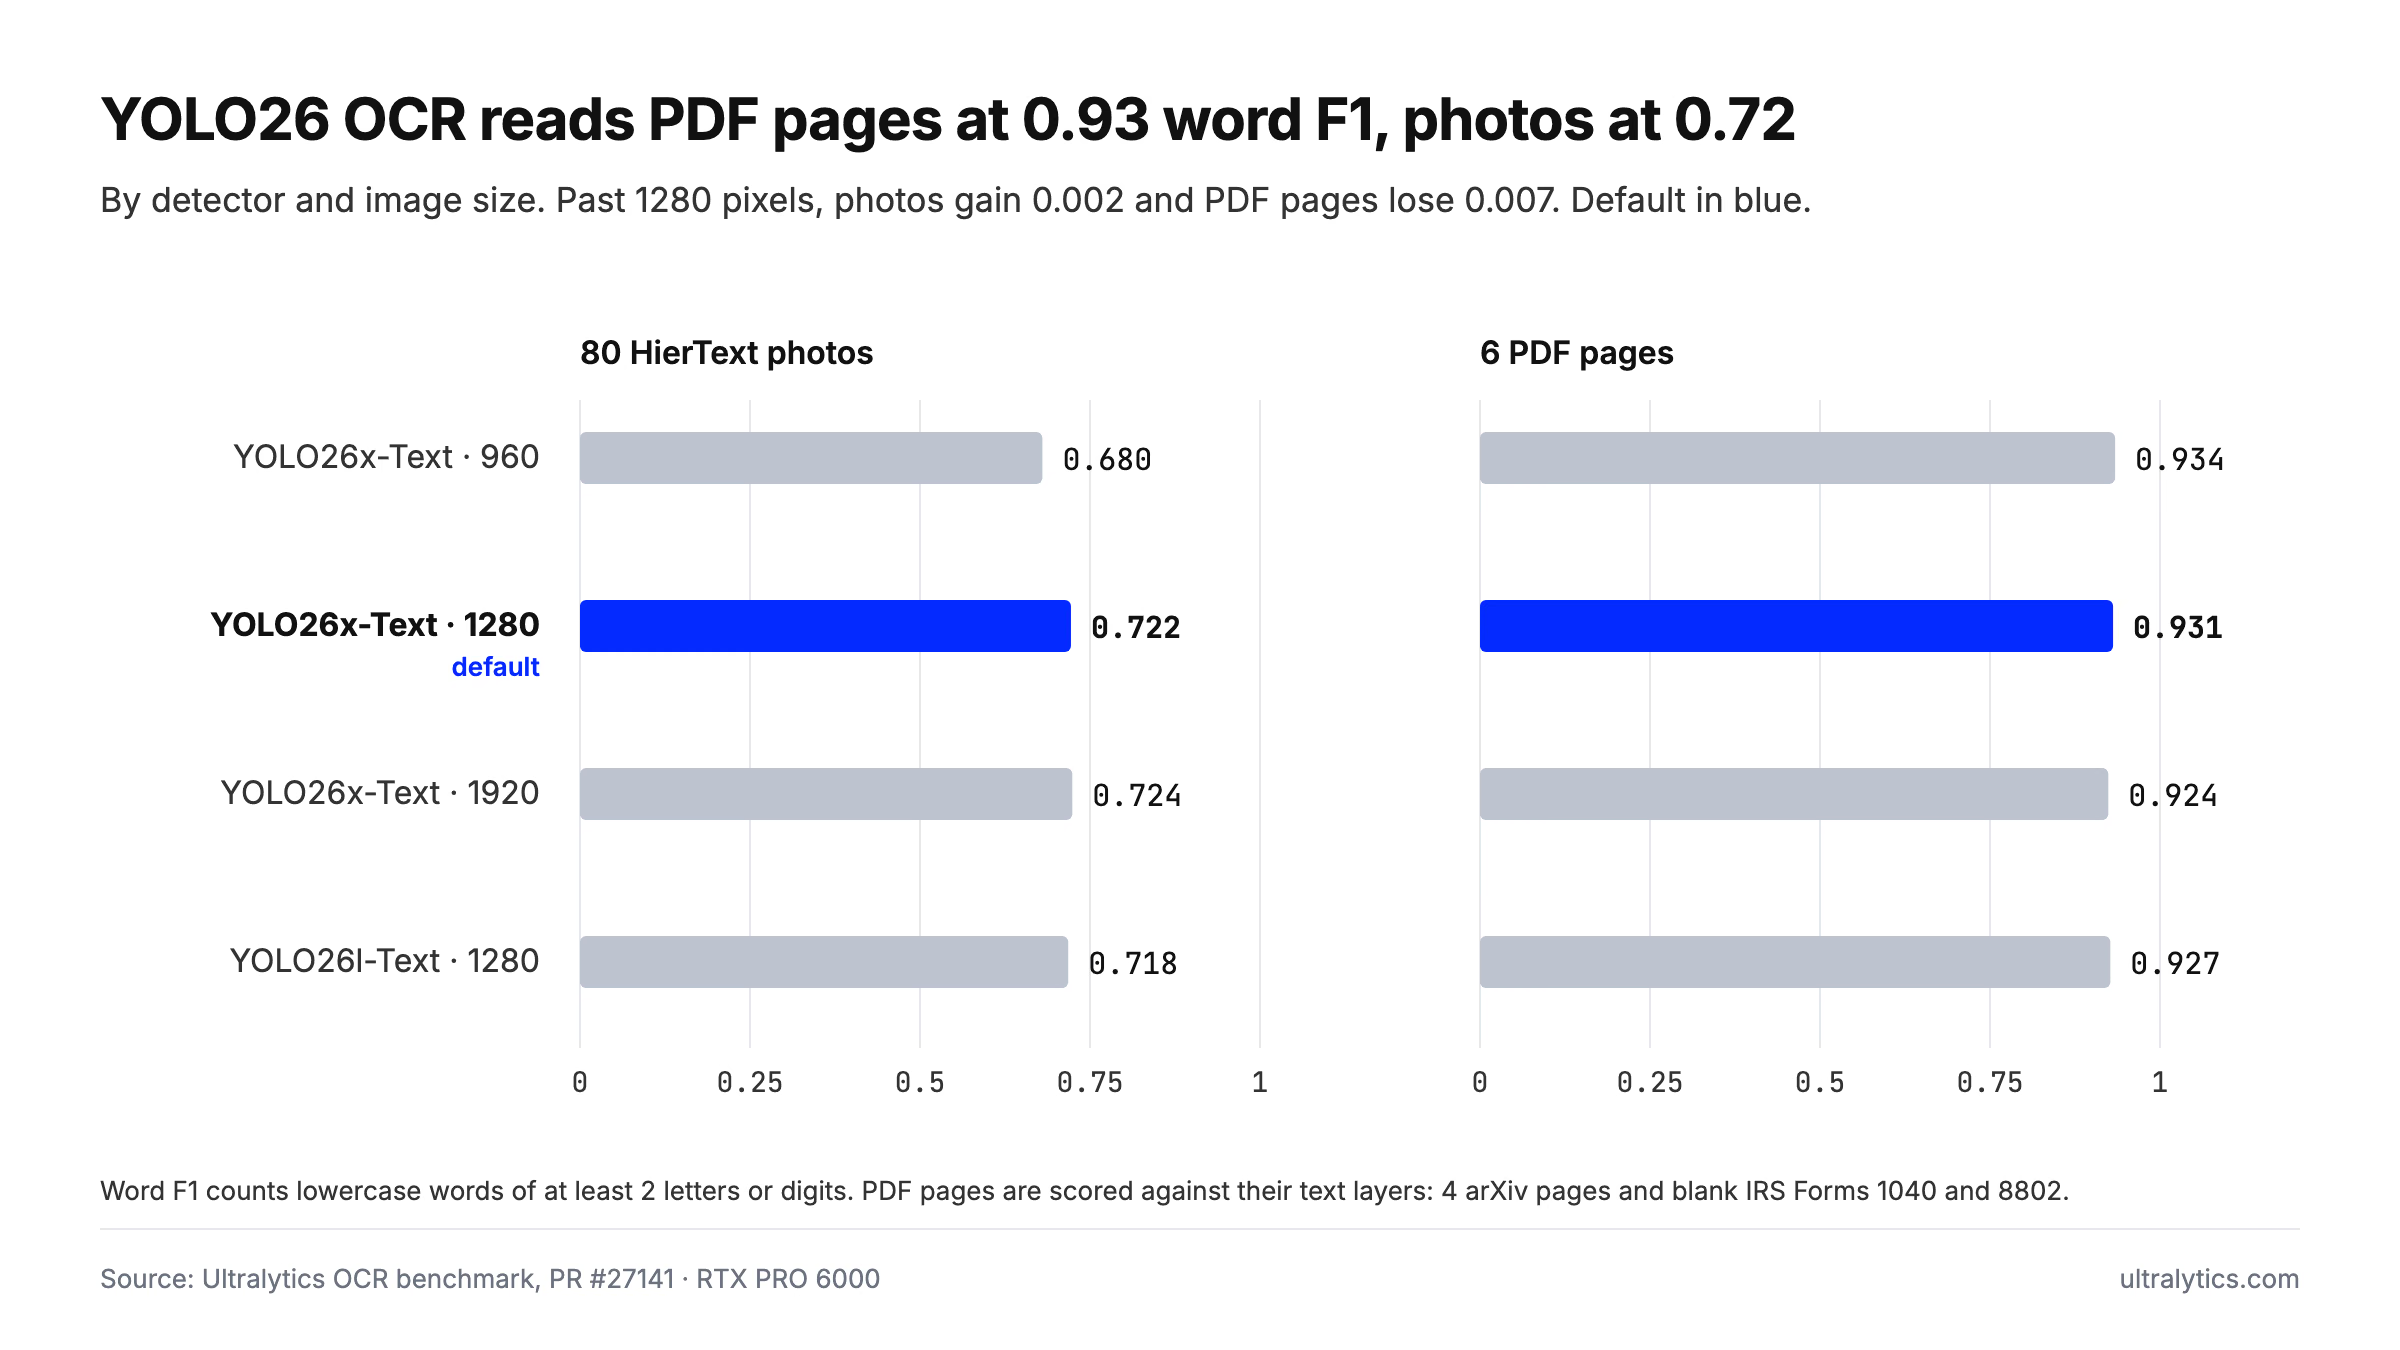
在 RTX PRO 6000 上,YOLO26-Text 搭配 PP-OCRv6,在 80 张 HierText 照片和 6 个 PDF 页面上的单词级 F1 分数,按检测器和图像尺寸划分。
在所有配置下,干净的 PDF 页面都比包含场景文字的照片容易识别得多;从这些数据可以得出三项默认设置:
yolo26x-text使用imgsz=1280。将尺寸降至 960 会使照片的 F1 分数降低 0.042;提升至 1920 会使照片得分提高 0.002,但 PDF 页面得分降低 0.007。较小的图像不会放大到 1280;它们会按原始尺寸运行,并向上取整至模型的 32 像素步幅。- 逐词读取。在照片上,逐个读取单词的效果比读取整行高 4 个 F1 点。
max_det=1000。密集的文档页面所含内容通常超过 300 个检测目标。
如果你需要更轻量的检测器,YOLO26l-Text 在两个数据集上的表现都与 x 模型相差不到半个百分点。
如何使用 YOLO26 在 Python 中运行 OCR#
使用 pip install -U "ultralytics>=8.4.211" 安装或升级。首次调用 OCR 时会下载 YOLO26x-Text 和 PP-OCRv6,并安装 ONNX Runtime;如果 CUDA 可用,则使用 onnxruntime-gpu。默认的 ONNX Runtime 识别器需要 Python 3.11+ 和 ONNX Runtime 1.26+。
读取图像#
import cv2

from ultralytics import solutions

ocr = solutions.OCR()  # YOLO26x-Text,imgsz=1280,搭配 PP-OCRv6
im0 = cv2.imread("receipt.jpg")
assert im0 is not None, "Image not found"
result = ocr(im0)
cv2.imwrite("receipt_ocr.jpg", result.plot_im)  # 标注后的图像

for word in result.texts:
print(word["line"], word["text"], round(word["confidence"], 2))在命令行中,yolo solutions ocr source="path/to/video.mp4" 会对每一帧执行相同操作。每一帧都会独立读取,不进行跟踪。
读取 PDF#
该方案接收图像,因此需要先渲染每个 PDF 页面。PyMuPDF 是一种实现方式:
import cv2
import numpy as np
import pymupdf  # pip install pymupdf

from ultralytics import solutions

ocr = solutions.OCR()
for page in pymupdf.open("document.pdf"):
    pix = page.get_pixmap(dpi=200)
    rgb = np.frombuffer(pix.samples, np.uint8).reshape(pix.height, pix.width, pix.n)
    result = ocr(cv2.cvtColor(rgb, cv2.COLOR_RGB2BGR))

    lines = {}
    for word in result.texts:  # 已按阅读顺序排列
        lines.setdefault(word["line"], []).append(word["text"])
    print("\n".join(" ".join(words) for words in lines.values()))
由于 result.texts 已经排好顺序,重建纯文本只需一个字典和一次拼接。你还可以利用多边形进行更进一步的处理,例如检查金额是否位于“Total”一词旁边。
选择模型、设备和识别器#
- 更小的检测器:
solutions.OCR(model="yolo26s-text.pt")会加载一个更小、速度更快的检测器;请在自己的页面上检查其准确率。五种尺寸都会自动下载。 - CPU 或 GPU:如果选择了 CUDA GPU,且 ONNX Runtime 的 CUDA 执行提供程序可用,识别器就会在 CUDA 上运行;否则会在 CPU 上运行,因此同一脚本既能在笔记本电脑上运行,也能在服务器上运行。
- 自定义识别器:将函数作为
recognizer传入。函数会接收每个 BGR 单词裁剪区域,并返回(text, confidence);该方案仍会围绕它执行检测、旋转处理和排序。
def recognize(crop):
    # 在 BGR 单词裁剪区域上运行任意识别模型
    return "example", 0.95


ocr = solutions.OCR(recognizer=recognize)
在密集照片上,TensorRT 读取单词的速度快 2.5 到 3 倍#
在我们的密集页面 GPU 测试中,识别耗时远高于检测。早期优化测得检测在 250 毫秒的请求中约耗时 11 毫秒;TensorRT 拉取请求的分析发现,剩余的大部分识别耗时来自 33 个小批次,这些批次主要受启动开销影响,而非计算耗时。Ultralytics 8.4.211 为此新增了一个参数:
ocr = solutions.OCR(recognizer="tensorrt") # NVIDIA GPU 上的 FP16 TensorRT 引擎首次运行时会在约 30 秒内构建 FP16 TensorRT 引擎,并将其缓存在 PP-OCRv6 模型旁边;每个 TensorRT 版本和 GPU 架构只需构建一次。之后加载只需 0.05 到 0.2 秒。该版本报告称,在密集页面上的速度约为 ONNX Runtime 的 2.5 倍。
我们对 read_words 计时;这是检测之后负责裁剪、旋转、识别和排序单词的步骤。测试了 4 张包含场景文字的照片。在其中包含 195 到 263 个单词的 3 张照片上,FP16 引擎比 CUDA 上的 ONNX Runtime 快 2.5 到 3 倍;在一张包含 48 个单词的照片上则快 1.4 倍:
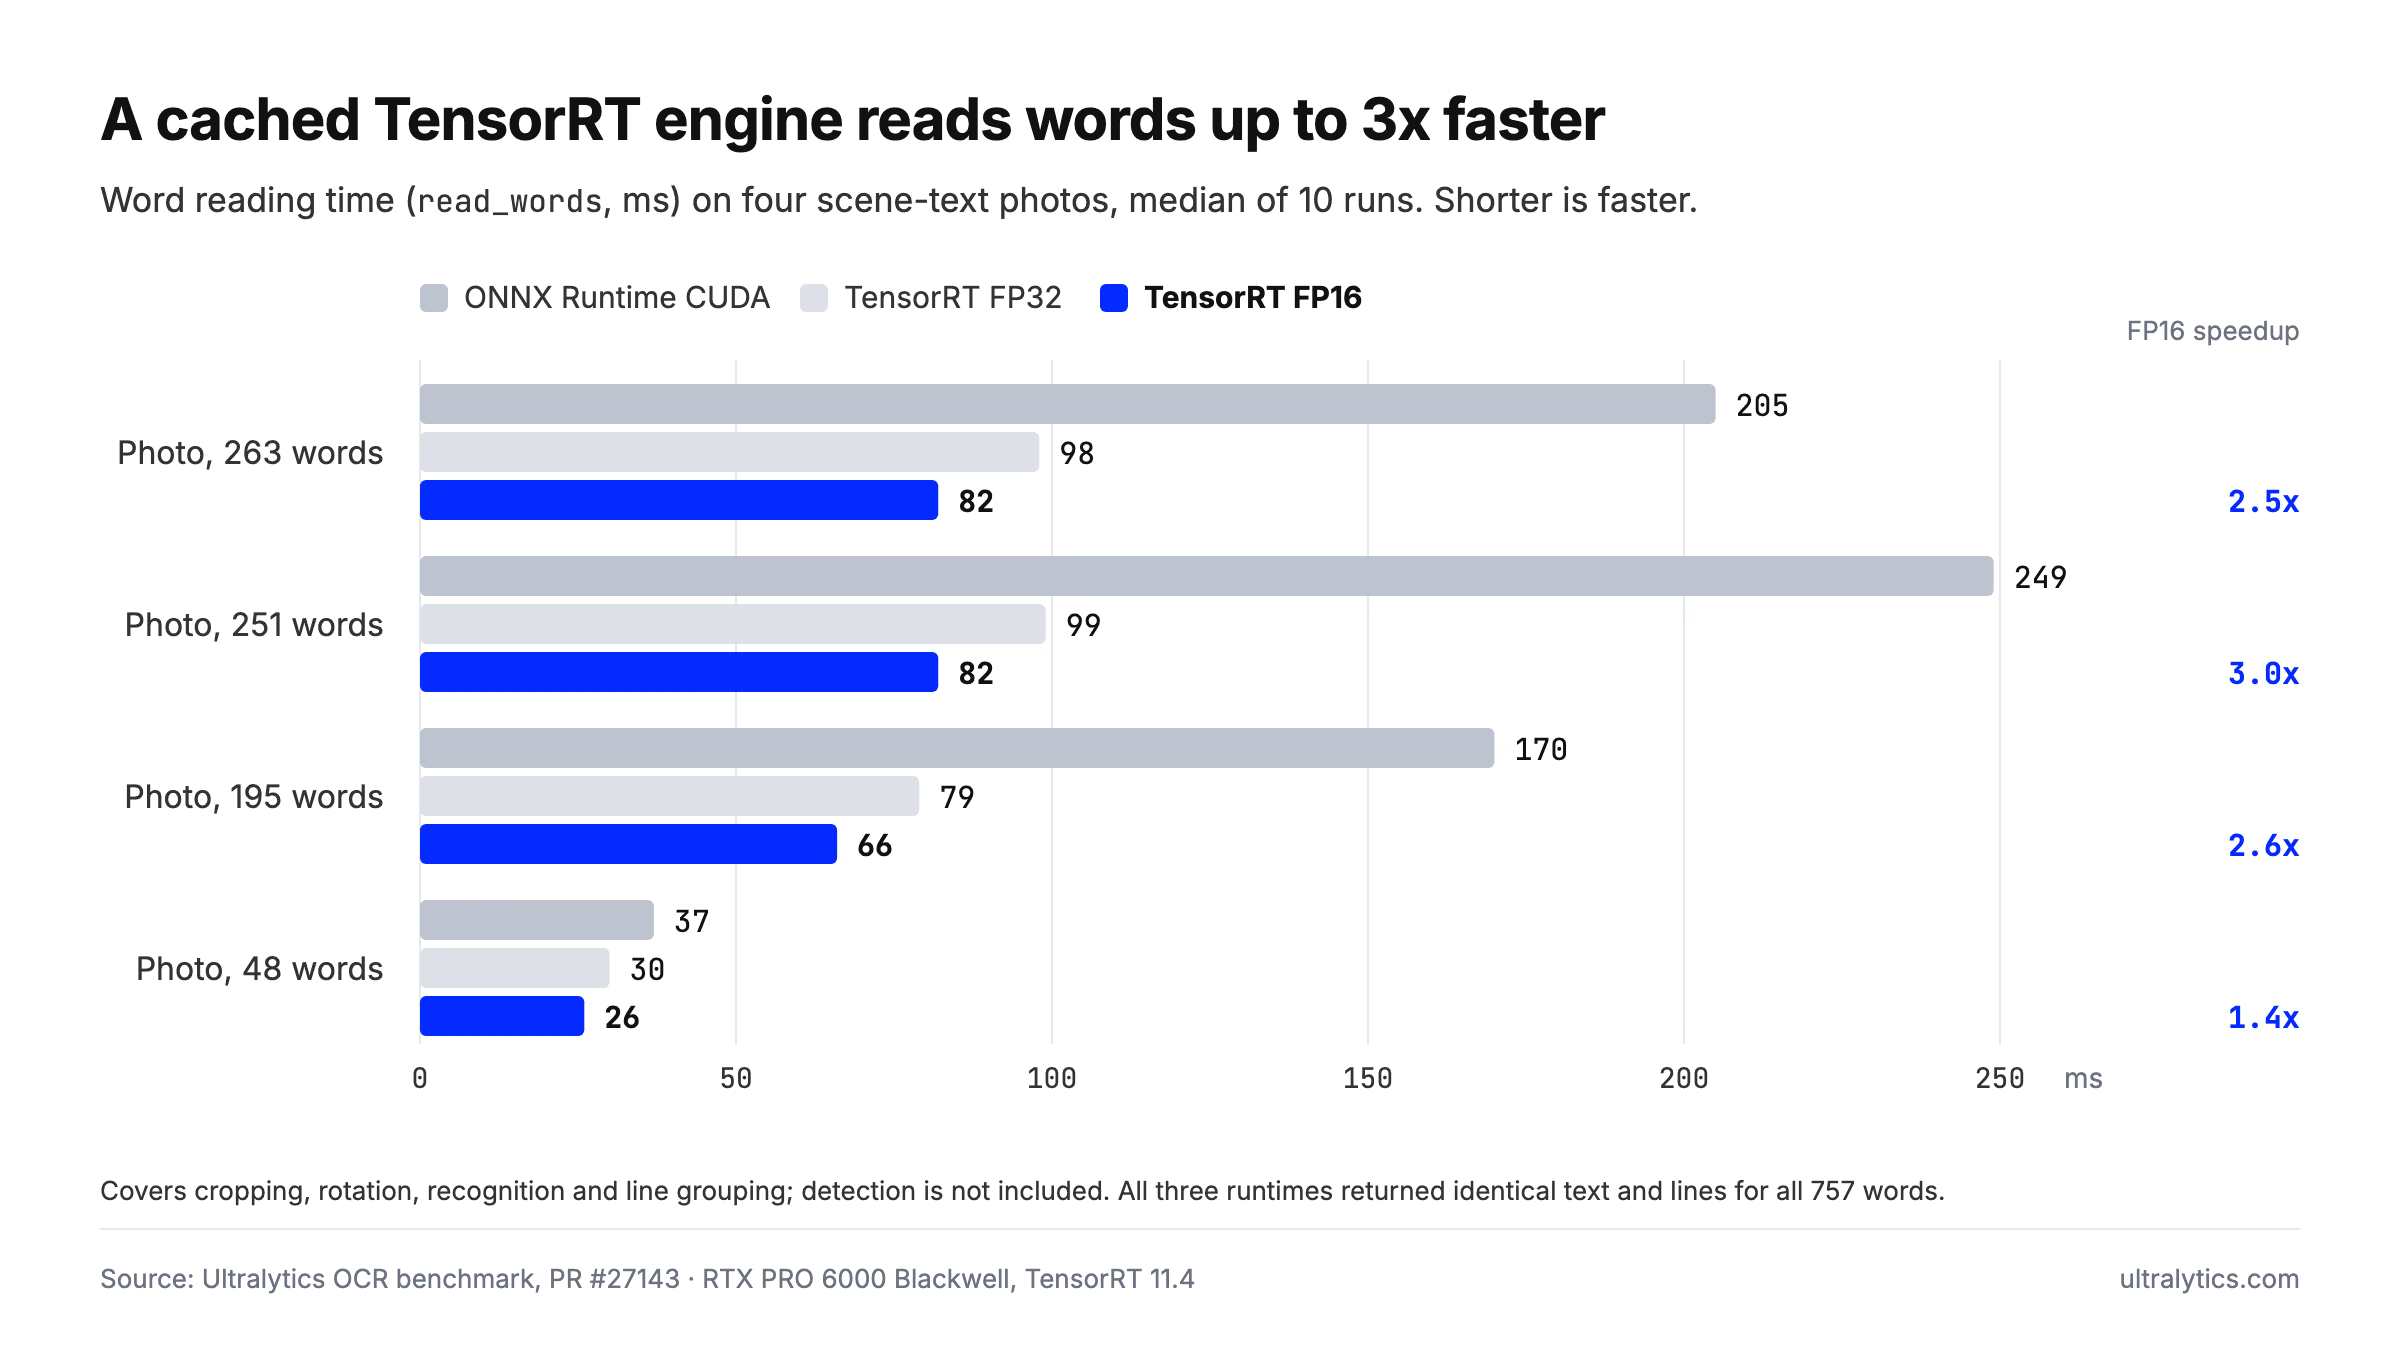
四张场景文字照片的单词读取耗时,对比 CUDA 上的 ONNX Runtime、FP32 和 FP16 TensorRT 引擎;在搭载 TensorRT 11.4 的 RTX PRO 6000 Blackwell 上运行 10 次取中位数。
密集页面上的完整 OCR 调用耗时从 182 毫秒降至 94 毫秒。在这 4 张照片上,速度提升没有改变输出:对于全部 757 个单词,ONNX Runtime 和两个引擎返回的文字和行分组完全相同。
如果你不想等待首次构建,或使用的不是 NVIDIA 硬件,请保留默认的 recognizer="paddleocr"。它无需构建任何内容,约一秒即可启动。我们的 ONNX 与 TensorRT 对比介绍了检测模型中相同的权衡,TensorRT 集成指南则介绍了设置方法。
目前支持中文、日文和拉丁字母文字#
PP-OCRv6 只能输出其内置的 18,708 个字符。YOLO26-Text 检测器不依赖该字符集,仍能找到其他文字体系中的单词,但字符不在字符集内时,输出会变成外形相似的字符。例如,俄语 ТЕКСТ 会被读成“TEKCT”,而且置信度通常很高。
- 支持:简体中文和繁体中文(约 15,600 个 CJK 字符)、日文(平假名、片假名和汉字),以及使用拉丁字母的语言,包括英语、法语、德语、西班牙语、葡萄牙语、意大利语、荷兰语、瑞典语、芬兰语、丹麦语、挪威语、波兰语、捷克语、匈牙利语、罗马尼亚语、土耳其语、克罗地亚语、印度尼西亚语和马来语。除德语大写字母 ẞ 和西班牙语倒感叹号 ¡ 外,所有字母及带重音字母均受支持。
- 部分支持:越南语,缺少大多数带声调的元音;希腊语,仅支持基本字母。
- 暂不支持:西里尔字母、韩文(谚文)、阿拉伯文、希伯来文、天城文和泰文。
对于不支持的文字体系,保留 YOLO26-Text 检测器,并将针对该文字体系训练的识别器作为 recognizer 传入。完整的支持范围表见 OCR 指南中的支持语言部分。
按文档所述功能对比 Python OCR 库#
没有哪一个 OCR 模型适用于所有场景;合适的模型取决于你的页面、语言和代码运行环境。下表依据各项目截至 2026 年 11 月 12 日的公开页面,对比文档中说明的功能,而非实测结果。选项按字母顺序排列。
| 选项 | 运行环境 | 旋转文字 | 文档中说明支持的语言 | 输出 |
|---|---|---|---|---|
| EasyOCR | PyTorch | rotation_info 会对每个文字框尝试 90°、180° 和 270° | 80 多种,包括西里尔文、阿拉伯文、天城文、韩文和泰文 | 检测框、文字和置信度 |
| PaddleOCR | PaddlePaddle | 可选的方向分类 | 100 多种(PP-OCRv6 的单个模型支持 50 种) | 检测框、文字和置信度 |
| Tesseract(pytesseract) | 原生二进制程序,CPU | 方向和文字体系检测(image_to_osd);读取前需旋转图像 | 100+ | 文字,可选提供单词数据 |
| Ultralytics YOLO26 OCR | PyTorch 检测器;识别器运行于 ONNX Runtime,或在 NVIDIA GPU 上运行于 TensorRT | 根据检测到的文字估算页面旋转角度,并自动判断 0° 还是 180° | 中文、日文、拉丁字母文字;其他文字体系可通过自定义识别器支持 | 按阅读顺序排列的单词,包含行号、多边形以及分别记录的检测和识别置信度 |
有关当前可用选项,请查阅 EasyOCR 文档、PaddleOCR 仓库、Tesseract 文档和 pytesseract。如需了解这些引擎的工作原理,请参阅我们的热门开源 OCR 模型概览。
Ultralytics 的适用范围#
Ultralytics YOLO26 OCR 面向 Python 开发者,可从混合输入中提取文字,例如扫描表单、PDF 页面、屏幕截图,以及标签和街牌的照片,并按阅读顺序返回单词及可供检查的坐标。如果页面角度不可预测、你希望在自己的机器上运行 OCR,或已经在运行 Ultralytics YOLO26 模型并希望在同一个软件包中使用 OCR,那么它很适合你。在 NVIDIA GPU 上处理大量数据时,可添加 recognizer="tensorrt"。
检测器是标准的 Ultralytics 模型,因此可以像其他模型一样进行训练、验证和导出。Ultralytics Platform 上的 YOLO26-Text 项目包含从 n 到 x 的全部五种尺寸,你可以比较它们的训练曲线,并克隆项目作为起点。
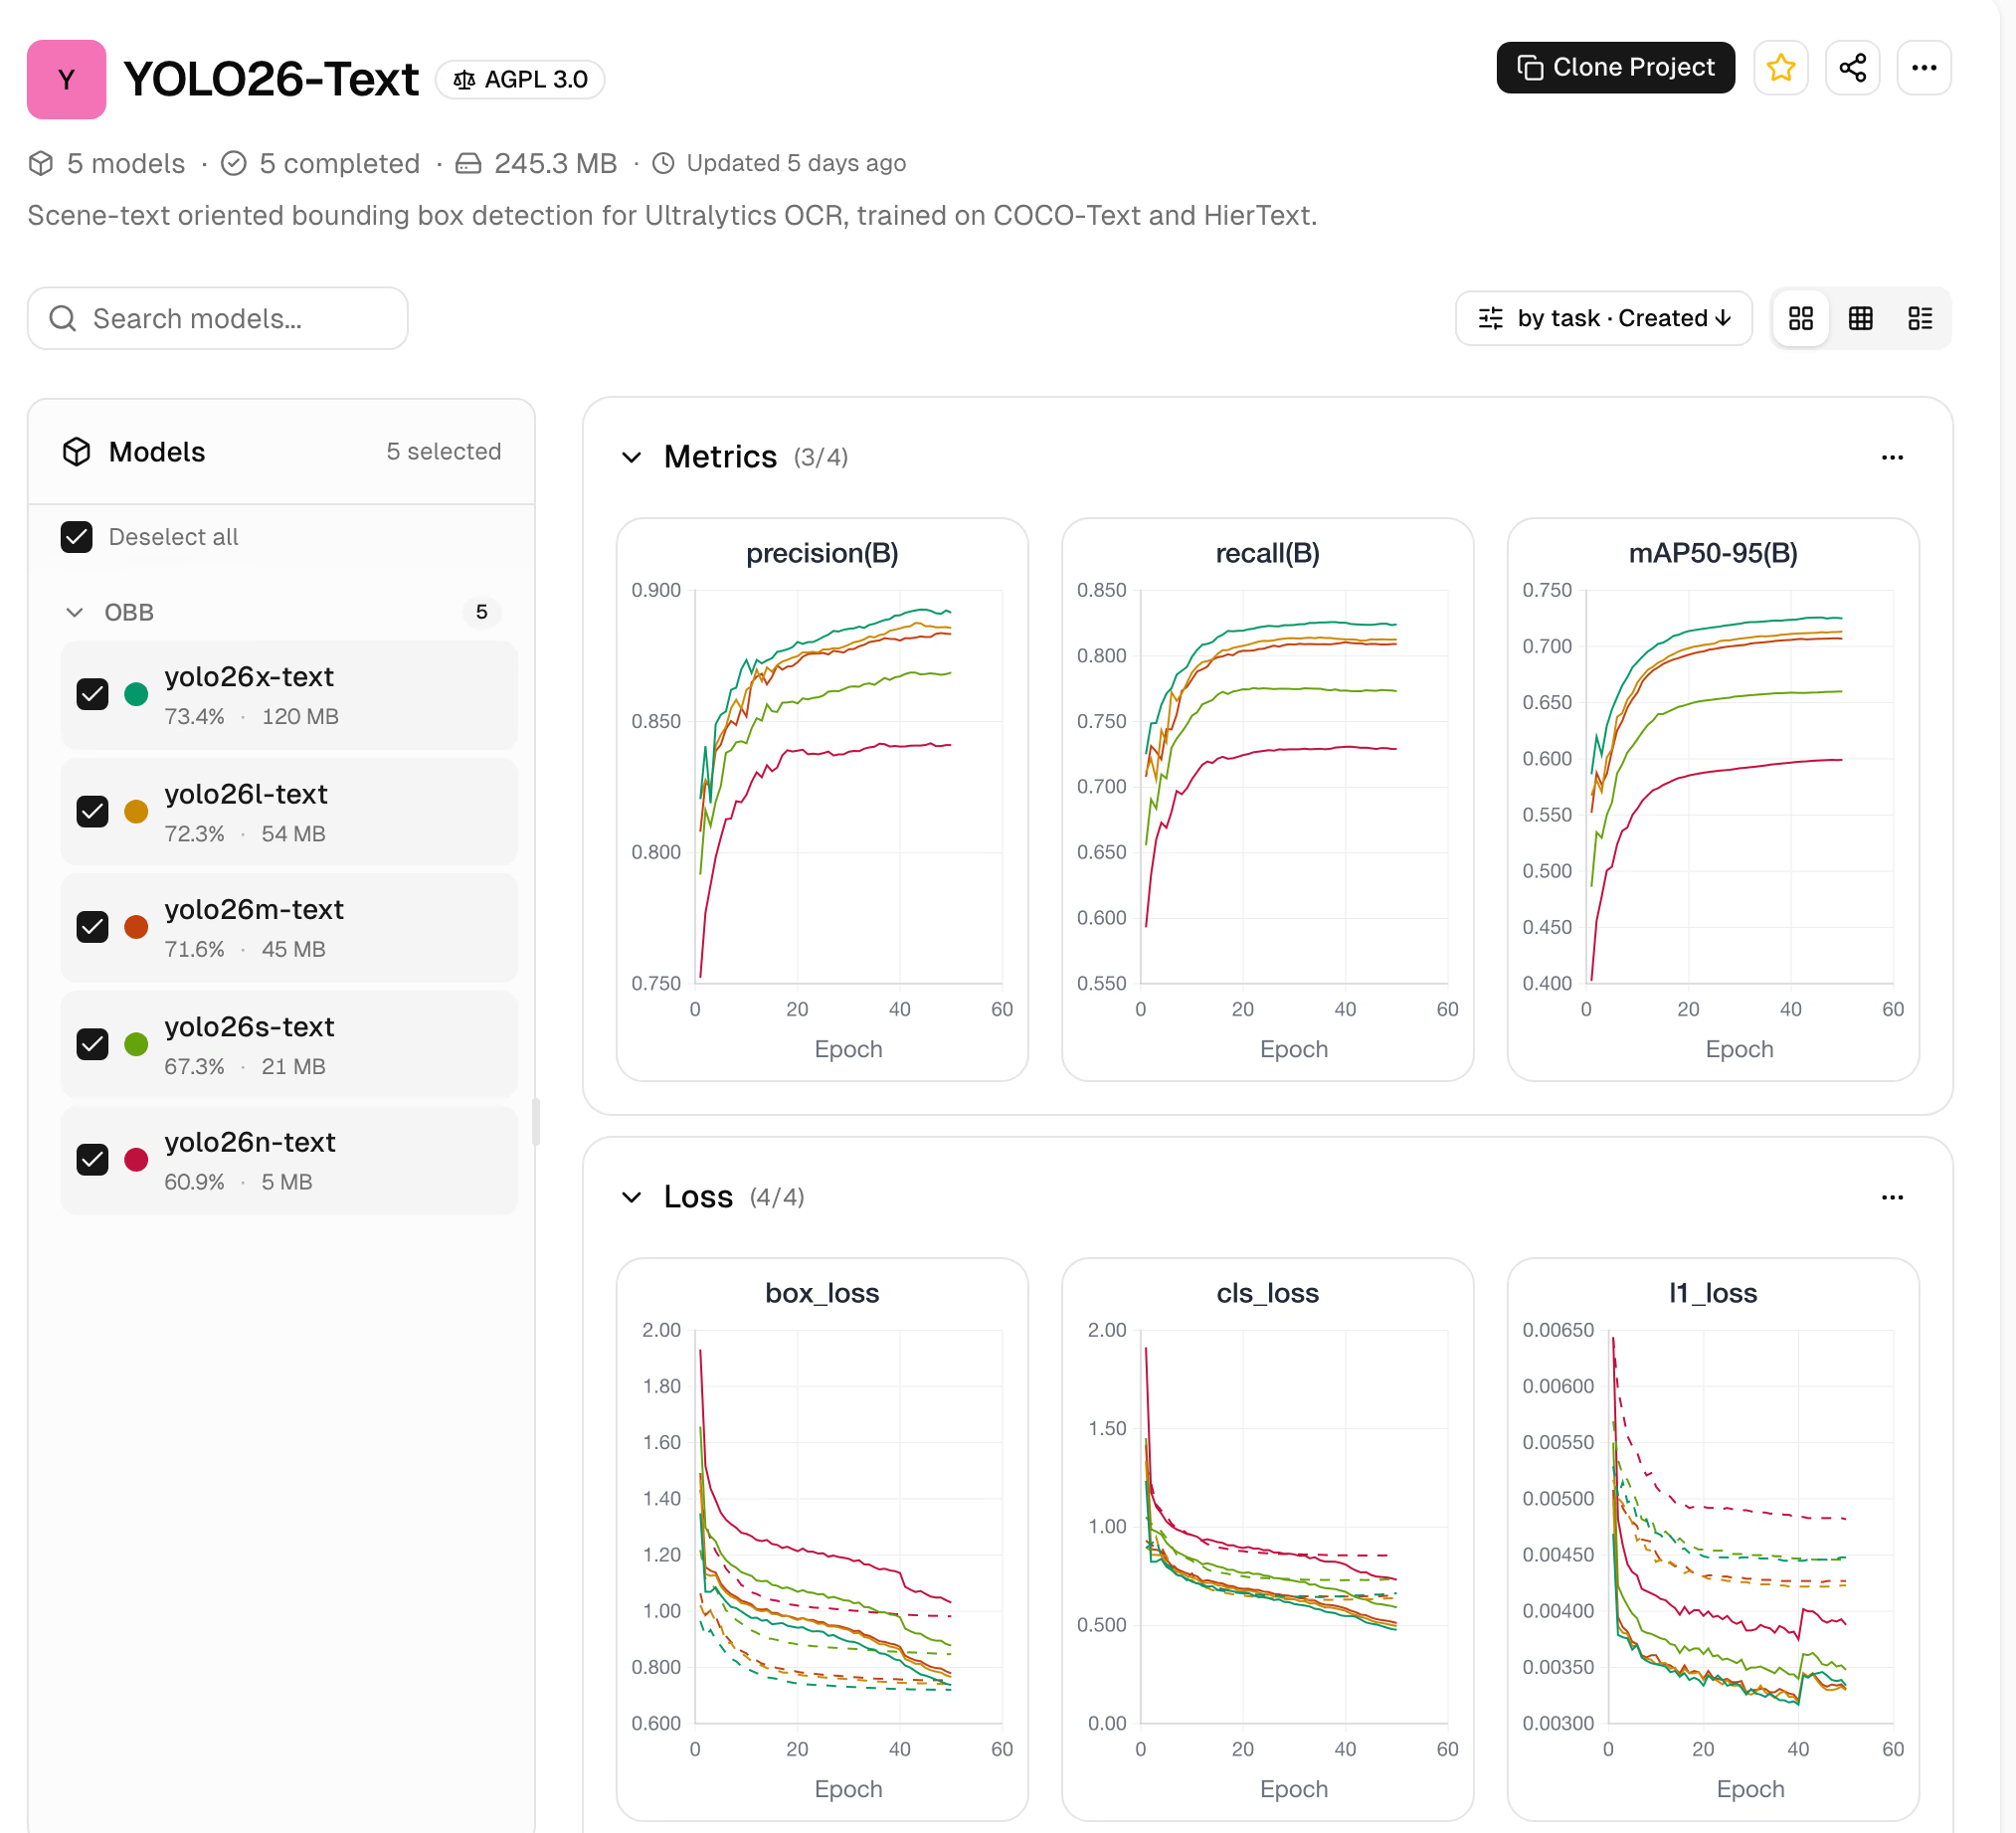
Ultralytics Platform 上的 YOLO26-Text 项目:训练期间五种检测器尺寸的精确率、召回率、mAP50-95 和损失曲线。
要让模型适用于你的文档,可以从 Scene Text OBB 数据集开始;该数据集整合了 COCO-Text 和 HierText,包含 65,325 张图像和约 129 万个单词多边形。
它有以下明确的局限:
- 文字体系。默认识别器目前还不能读取西里尔文、韩文、阿拉伯文、希伯来文、天城文或泰文。你可以将检测器与自定义识别器搭配使用,也可以选择支持这些文字体系的引擎。
- 混合方向。该方案会根据页面上的主要文字方向旋转整个页面,因此同一页面上有多种文字方向时(例如边缘处的竖排注释),识别效果可能较差。
- 导出。识别器不会嵌入导出的检测器文件,因此你需要同时部署检测器和识别运行时,或者继续使用 Python 方案作为衔接层。
- Rust。Ultralytics Inference 使用 Rust 和同一 PP-OCRv6 识别器,通过
ultralytics-inference predict --ocr读取场景文字;不过,它使用方向分类器处理方向,而不是采用 Python 方案的页面旋转步骤。 - 隐私。Python 方案在你自己的硬件上运行,因此页面无需离开你的机器;浏览器演示则会上传页面以进行推理。对于不得读取的字段,请在运行 OCR 前用不透明遮罩覆盖已知区域。
对于表单和合同,可以先使用自定义 YOLO 模型找到字段、表格、签名和印章,这样就只需读取所需区域。Ultralytics Platform 上的签名数据集和我们的智能文档分析指南都是不错的起点;借助 Ultralytics Platform,你还可以在同一个地方标注页面并训练模型。要先在自己的页面上试用 OCR,请将图像或 PDF 拖到实时 OCR 演示中。
常见问题
使用
pip install -U "ultralytics>=8.4.211"安装 Ultralytics 软件包,然后对使用 OpenCV 加载的图像调用solutions.OCR()。它会按照阅读顺序返回识别出的单词及其文字、置信度、行号和多边形。首次运行时会自动下载 YOLO26-Text 检测器和 PP-OCRv6 识别器。这取决于你的文档、语言和硬件;我们的热门开源 OCR 模型概览对比了主要选项。在 RTX PRO 6000 上以 1280 图像尺寸进行的基准测试中,YOLO26x-Text 搭配 PP-OCRv6 在 6 个 PDF 页面上的单词级 F1 分数为 0.931,在 80 张 HierText 照片上为 0.722,并且可以读取任意旋转角度的页面。对于尚未支持的文字体系(例如西里尔文或韩文),请使用针对该文字体系训练的识别器。
YOLO 模型可以检测文字,但不能读取文字。Ultralytics YOLO26-Text 会将文字检测为有向框,而 OCR 方案会把每个裁剪区域传给 PP-OCRv6 识别器,因此两者结合后,一次调用即可完成完整的 OCR。
可以。将 PDF 的每一页渲染为图像,例如使用 PyMuPDF 的
get_pixmap,将图像转换为 BGR 并传递给solutions.OCR()。在浏览器中,演示页面和 Platform Predict 选项卡都支持上传 PDF 并读取其第一页。可以。PP-OCRv6 可通过 ONNX Runtime 在 CPU 或 CUDA GPU 上运行,同一脚本在两者上都能使用。可选的 TensorRT 识别器需要 NVIDIA GPU。
默认识别器目前还不支持。PP-OCRv6 支持中文、日文和使用拉丁字母的语言,但不支持西里尔字母、韩文、阿拉伯文、希伯来文、天城文或泰文。你可以继续使用 YOLO26-Text 检测器,并传入针对相应文字系统训练的识别器。
作者
评论
提出问题、分享你的结果,或帮助其他人。









