الإدارة الذكية لمجموعات البيانات في الرؤية الحاسوبية باستخدام منصة Ultralytics
استكشف كيفية استخدام منصة Ultralytics لتحسين إدارة مجموعات البيانات في مشاريع الرؤية الحاسوبية. تتبّع مجموعات بياناتك وقارن بينها وحسّنها بسهولة.
 Abirami Vina14 دقيقة قراءة
قطع الذكاء الاصطناعي البصري، أو الرؤية الحاسوبية، شوطًا طويلًا منذ بداياته، إذ تطور من أبحاث تجريبية إلى تقنية أساسية تدعم تطبيقات العالم الحقيقي. واليوم، يستطيع المهتمون بالذكاء الاصطناعي بناء نماذج قوية لمهام مثل اكتشاف العناصر والتجزئة حسب الكائن باستخدام أدوات وأطر عمل متاحة.
لكن مع انتقال هذه التطبيقات من مرحلة التجريب إلى الإنتاج، تظل إدارة مجموعات البيانات تحديًا بالغ الأهمية، وغالبًا ما يُغفل عنه. ومع ازدياد حجم مجموعات بيانات الرؤية الحاسوبية وتعقيدها، كثيرًا ما تواجه الفرق صعوبة في الحفاظ على اتساق التعليقات التوضيحية، وتتبع التغييرات بين الإصدارات، وضمان جودة البيانات عمومًا.
قد يكون أداء النماذج المتقدمة أقل من المتوقع في البيئات الواقعية إذا كانت البيانات التي دُرّبت عليها غير مكتملة أو غير متوازنة أو سيئة الإدارة. وتفسر هذه الفجوة المتزايدة بين أداء التطوير والموثوقية في العالم الحقيقي الحاجة إلى نهج أكثر تنظيمًا لإدارة مجموعات البيانات.
ومن القيود الشائعة أيضًا أن جمع البيانات والتعليق عليها والتدريب غالبًا ما تتم باستخدام أدوات منفصلة. ويصعّب سير العمل المجزأ إدارة مجموعات البيانات بكفاءة، ويزيد مخاطر عدم الاتساق، ويبطئ دورات التحسين.
لمعالجة معوقات الذكاء الاصطناعي البصري، مثل إدارة مجموعات البيانات وتجزؤ سير العمل، أطلقنا مؤخرًا منصة Ultralytics. وهي مساحة عمل متكاملة من البداية إلى النهاية تجمع إدارة مجموعات البيانات والتعليق عليها والتدريب والنشر والمراقبة ضمن سير عمل موحّد.
ومن خلال ربط كل مرحلة من دورة حياة الرؤية الحاسوبية، يصبح تتبع تغييرات مجموعات البيانات ومقارنة الأداء بين الإصدارات وتحسين بياناتك باستمرار لتحقيق نتائج أفضل أكثر سهولة.
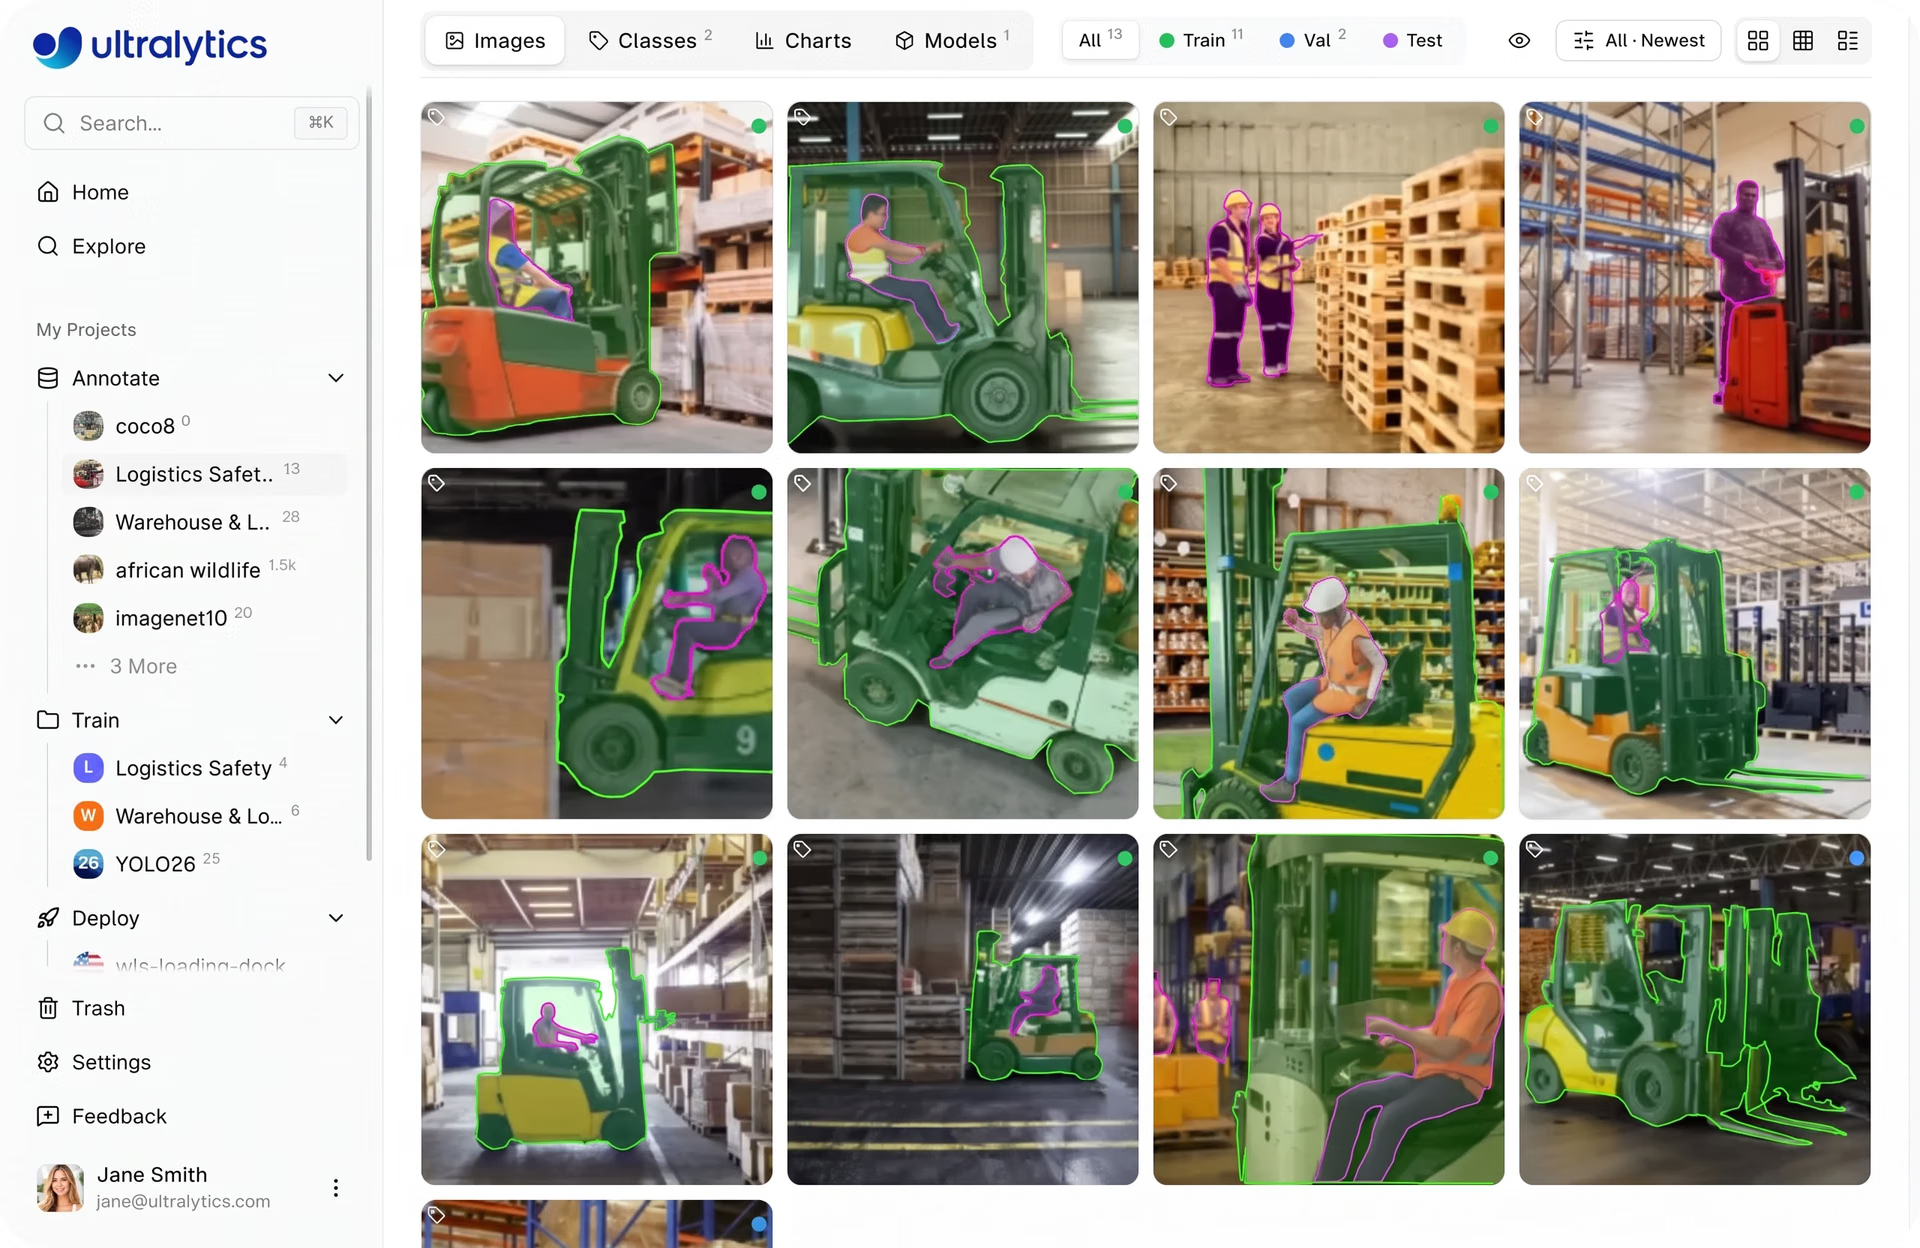
الشكل 1. مثال على عرض صور مجموعة البيانات ضمن منصة Ultralytics (المصدر)
في هذا المقال، سنتعمق في كيفية مساعدة Ultralytics Platform على تتبع مجموعات بياناتك ومقارنتها وتحسينها لبناء نماذج رؤية حاسوبية أكثر موثوقية.
أهمية إدارة مجموعات البيانات في الرؤية الحاسوبية#
يرتبط أداء نموذج الرؤية الحاسوبية ارتباطًا وثيقًا بالبيانات التي دُرّب عليها. وتعتمد دقة النموذج، أي مدى صحة تنبؤاته، ليس على الخوارزمية وحدها، بل أيضًا على مدى تمثيل مجموعة البيانات لظروف العالم الحقيقي.
ببساطة، يتعلم النموذج الأنماط مباشرةً من البيانات، لذا فإن أي نقص أو تحيز أو عدم اتساق في مجموعة البيانات قد يؤثر في طريقة إصدار التنبؤات. وبعبارة أخرى، يمكن للبيانات منخفضة الجودة أو التعليقات التوضيحية غير الصحيحة أو التغطية المحدودة للتباينات في صور العالم الحقيقي، مثل اختلاف ظروف الإضاءة وزوايا العناصر والخلفيات ومستويات الاحتجاب، أن تقلل الدقة بدرجة كبيرة، حتى إن كانت بنية النموذج نفسها قوية.
وينطبق ذلك أيضًا عند الضبط الدقيق للنموذج، حيث يُدرّب نموذج مدرّب مسبقًا من جديد على بيانات جديدة أو محدّثة ليتكيف بصورة أفضل مع حالة استخدام أو بيئة محددة. وبما أن دقة النموذج تعتمد بدرجة كبيرة على البيانات، تصبح إدارتها على نحو سليم أمرًا أساسيًا.
تشمل إدارة مجموعات البيانات تنظيم البيانات وتسميتها وتحديثها باستمرار لضمان دقتها وملاءمتها. ويسهّل ذلك تحسين الأداء بمرور الوقت، ولا سيما عند إعادة تدريب النماذج أو ضبطها دقيقًا باستخدام بيانات جديدة.
تأثير جودة مجموعة البيانات في الموثوقية في العالم الحقيقي#
تُعد حالات استخدام الرؤية الحاسوبية، مثل أنظمة المراقبة الأمنية، مثالًا واضحًا على أهمية الإدارة السليمة للبيانات. إذ يجب أن تعمل هذه الأنظمة بموثوقية في ظل مجموعة من ظروف العالم الحقيقي، بما في ذلك اختلاف بيئات الإضاءة وزوايا الكاميرات ومستويات الازدحام والاحتجاب الجزئي.
إذا لم تغطِّ بيانات التدريب هذه التباينات أو افتقرت إلى التنوع في كيفية ظهور العناصر عبر المشاهد والظروف المختلفة، فقد يواجه النموذج صعوبة في اكتشاف العناصر بدقة. فعلى سبيل المثال، قد يكون أداء نموذج دُرّب في معظمه على مشاهد جيدة الإضاءة وخالية من الفوضى ضعيفًا في البيئات منخفضة الإضاءة أو الأماكن المزدحمة. وفي الأنظمة الأمنية، قد يؤدي ذلك إلى تفويت أحداث أو إطلاق تنبيهات كاذبة.
لتجنب ذلك، من المهم الحفاظ على مجموعات بيانات لا تقتصر على النظافة ودقة التسميات، بل تكون متوازنة جيدًا ومحدّثة باستمرار أيضًا. ويعني ذلك تحديد الثغرات في البيانات، وإضافة أمثلة جديدة مع تغير الظروف، والتأكد من تمثيل الفئات والبيئات المختلفة بالتساوي.
تساعد مجموعة البيانات الأكثر اكتمالًا وتنظيمًا النماذج على التعامل مع التباين في العالم الحقيقي وإنتاج تنبؤات أكثر موثوقية.
الجوانب الرئيسية لإدارة مجموعات البيانات#
إذًا، كيف تبدو إدارة مجموعات البيانات عمليًا؟ إنها تشمل تنظيم البيانات وتسميتها وصيانتها كي تُستخدم بفاعلية طوال عملية تطوير النموذج.
يشمل تنظيم البيانات، على سبيل المثال، هيكلة مجموعة البيانات وتقسيمها إلى مجموعات تدريب وتحقق واختبار. تُستخدم مجموعة التدريب لتعليم النموذج، ومجموعة التحقق لمراقبة الأداء وتوجيه التعديلات أثناء التطوير، ومجموعة الاختبار لتقييم مدى أداء النموذج النهائي على بيانات لم يسبق له رؤيتها.
أما وضع التسميات فيشمل إضافة تعليقات توضيحية إلى الصور، مثل تسميات الفئات ومربعات الإحاطة أو أقنعة التجزئة. وبما أن النموذج يتعلم من هذه التعليقات التوضيحية، فإن الدقة والاتساق ضروريان لمساعدته على تعلم أنماط ذات معنى وإصدار تنبؤات موثوقة.
بالإضافة إلى ذلك، تشمل صيانة مجموعة البيانات مراجعة البيانات وتحديثها بمرور الوقت. وقد يتضمن ذلك تصحيح أخطاء التعليقات التوضيحية، وإزالة البيانات منخفضة الجودة أو المكررة، وإضافة أمثلة جديدة لتغطية الحالات الناقصة أو الظروف المتغيرة.
وعلى نطاق أوسع، تُعد إدارة مجموعات البيانات عملية مستمرة. فمع تقييم النماذج وجمع بيانات جديدة، يجب تحديث مجموعات البيانات لتعكس ظروف العالم الحقيقي والحالات الطرفية. ويساعد تتبع هذه التحديثات ومقارنة الإصدارات المختلفة الفرق على فهم ما يحسّن الأداء وتحديد الجوانب التي تتطلب مزيدًا من التعديلات.
إدارة مجموعات البيانات باستخدام منصة Ultralytics#
توفر منصة Ultralytics سير عمل منظمًا لإدارة مجموعات البيانات ضمن بيئة واحدة، بدءًا من إعداد البيانات ووصولًا إلى تصديرها. وقد صُممت لدعم المطورين الأفراد والفرق على حد سواء، ما يسهّل إدارة مجموعات البيانات باتساق، سواء أكنت تعمل بمفردك أم تتعاون ضمن مشاريع متعددة.
صُممت كل مرحلة لتبسيط تنظيم مجموعات البيانات ومعالجتها واستخدامها طوال دورة حياة تطوير النموذج. ومن خلال جمع هذه الخطوات في مكان واحد، تقلل المنصة تجزؤ سير العمل وتجعل الحفاظ على الاتساق بين مسارات العمل أكثر سهولة.
والآن، لنستعرض الخطوات الرئيسية المعنية وكيف تدعم المنصة كلًا منها.
تحميل مجموعات البيانات إلى منصة Ultralytics#
توفّر المنصة مرونة في بدء العمل بمجموعات البيانات، مع طرق متعددة لاستيراد البيانات أو إعادة استخدامها. يمكنك تحميل بياناتك الخاصة أو البدء بسرعة أكبر باستخدام مجموعات البيانات العامة المتاحة عبر المنصة. كما يمكنك استنساخ مجموعات بيانات موجودة شاركها المجتمع والبناء عليها.
تسهّل ميزات المجتمع في المنصة استكشاف الأعمال الموجودة وإعادة استخدامها. وبفضل إمكانية الوصول إلى مجموعات بيانات أنشأها مستخدمون آخرون، تضم ملايين الصور والتعليقات التوضيحية، يمكنك البدء بسرعة من دون الحاجة إلى جمع كل شيء وتسميته بنفسك. وينشئ استنساخ مجموعة البيانات نسخةً منها في مساحة عملك، ما يتيح لك تعديلها وتوسيعها مع الحفاظ على النسخة الأصلية.
تدعم المنصة رفع الصور ومقاطع الفيديو الفردية وأرشيفات مجموعات البيانات، مثل ملفات ZIP وTAR وGZ. كما تدعم تنسيقات مجموعات البيانات الشائعة مثل YOLO وCOCO، ما يسهّل استيراد مجموعات البيانات والتعليقات التوضيحية الموجودة دون تحويل إضافي. وإضافةً إلى ذلك، يمكنك رفع مجموعة بيانات باستخدام ملف NDJSON مُصدّر من المنصة، ما يسهّل إعادة إنشاء مجموعات البيانات أو إعادة استخدامها عبر المشاريع.
بعد تحميل البيانات، تعالجها المنصة عبر مسار منظم. ويشمل ذلك التحقق من تنسيقات الملفات وأحجامها، وتغيير حجم الصور عند الحاجة، وتحليل التعليقات التوضيحية، وإنشاء إحصاءات مجموعة البيانات.
فعلى سبيل المثال، تُحوّل مقاطع الفيديو إلى إطارات لتصبح جاهزة للاستخدام في التدريب، بينما تُحسّن الصور وتُجهّز لتسهيل تصفحها وتحليلها. وبعد المعالجة، تصبح مجموعات البيانات جاهزة للاستخدام في التعليق التوضيحي والتحليل وتدريب النماذج ضمن المنصة.
التعليق على البيانات في منصة Ultralytics#
بعد الرفع، يمكن مراجعة مجموعات البيانات وإضافة التعليقات التوضيحية إليها مباشرةً داخل المنصة. وتتضمن المنصة أدوات تعليق الصور مدمجة لمجموعة من مهام الرؤية الحاسوبية، مثل اكتشاف الكائنات وتقسيم المثيلات والتقسيم الدلالي وتصنيف الصور وتقدير الوضعية واكتشاف مربعات الإحاطة الموجّهة (OBB).
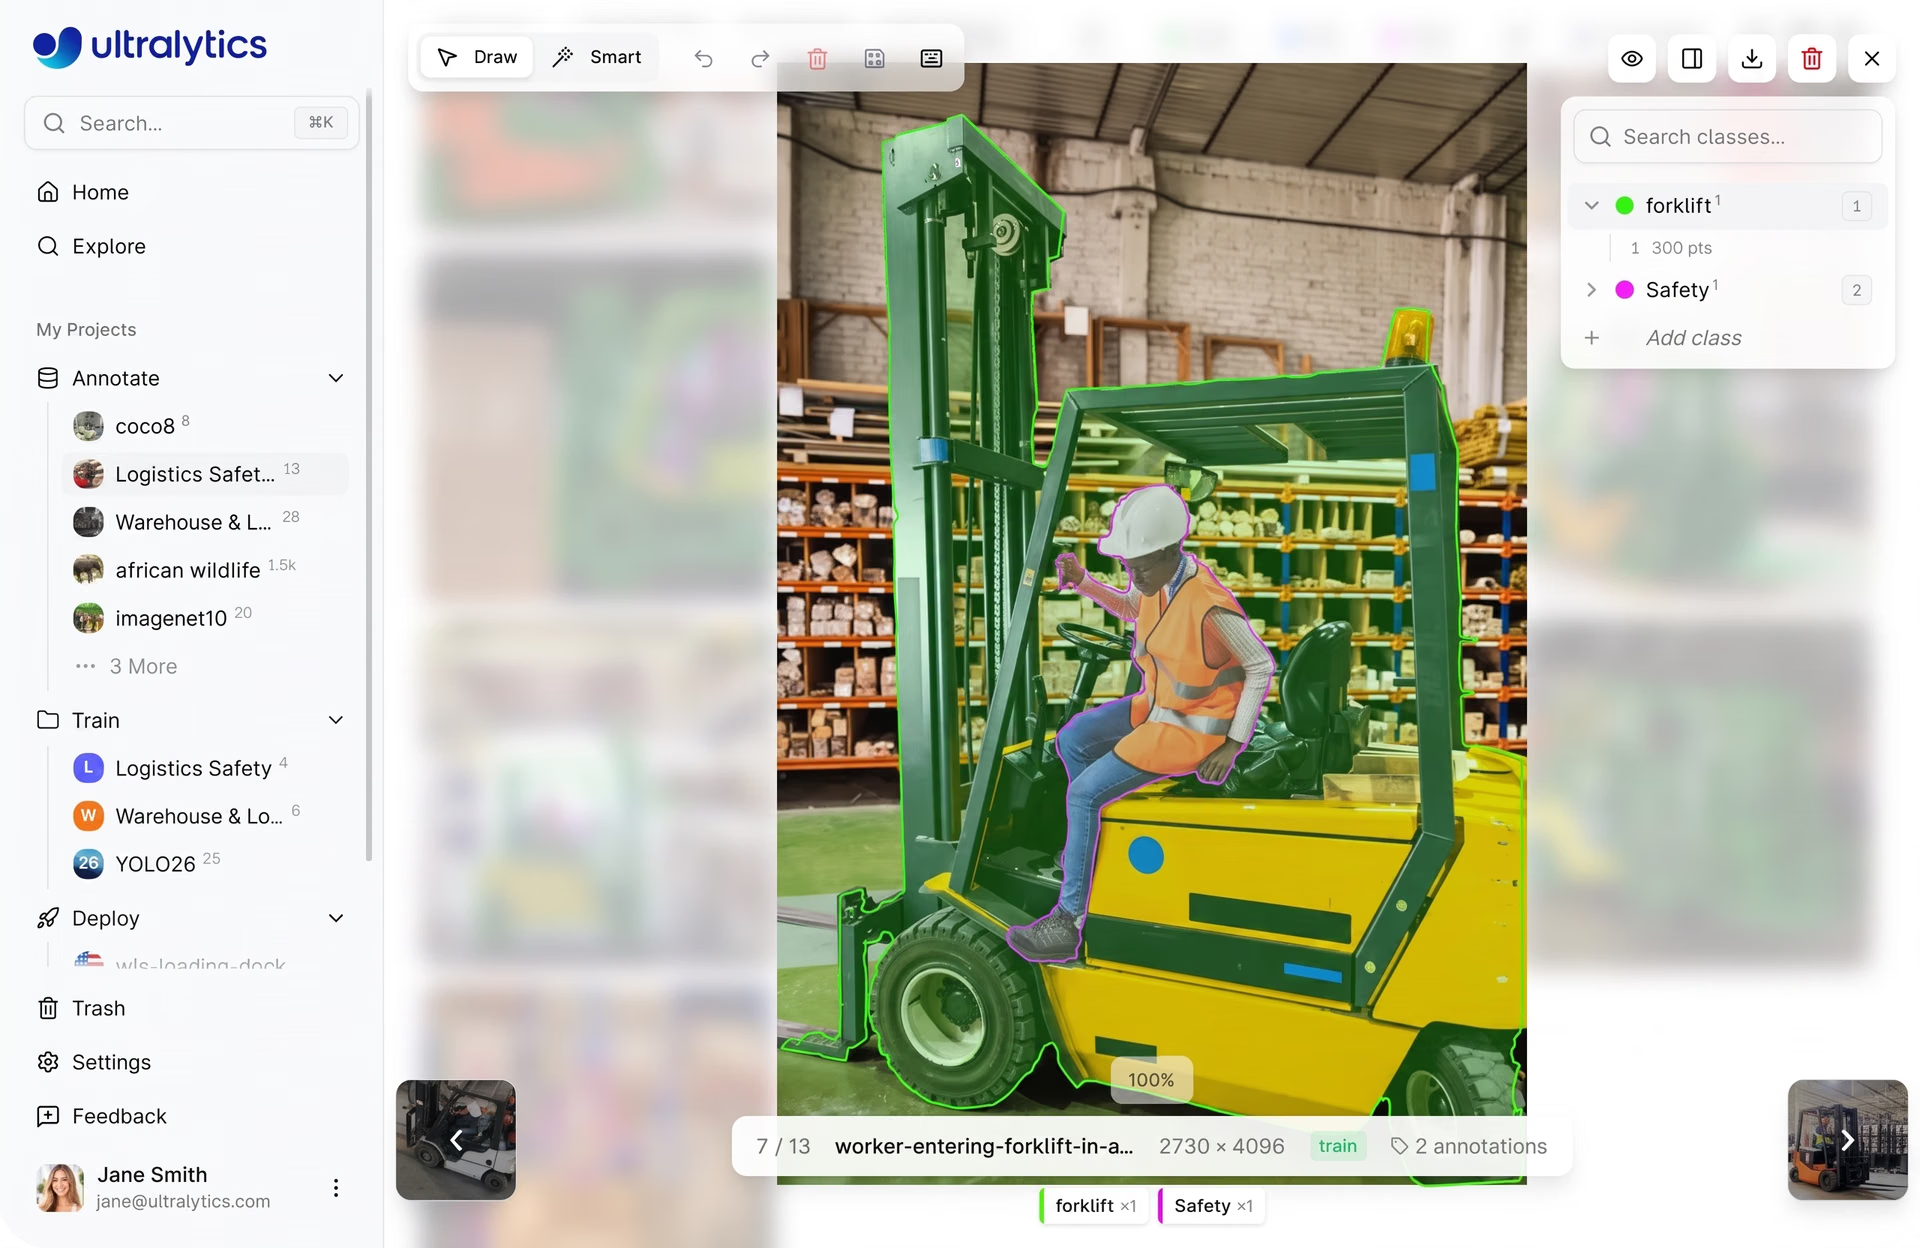
الشكل 2. استخدام منصة Ultralytics لوضع تسميات البيانات (المصدر)
يمكن إنشاء التعليقات التوضيحية يدويًا باستخدام هذه الأدوات أو تسريع العملية بميزات مدعومة بالذكاء الاصطناعي، مثل التعليق الذكي المدعوم بـ SAM. وباستخدام SAM، يمكنك إنشاء أقنعة أو مربعات إحاطة أو مربعات موجّهة عبر التفاعل مع الصورة، ما يساعد على تسريع عملية وضع التسميات مع الحفاظ على الدقة.
تحليل جودة مجموعات البيانات عبر منصة Ultralytics#
إلى جانب إعداد البيانات وإضافة التعليقات التوضيحية، يُعد فهم جودة مجموعة البيانات أمرًا أساسيًا لبناء نماذج رؤية حاسوبية موثوقة. ومن دون رؤية واضحة لعوامل مثل توزيع الفئات وجودة التعليقات التوضيحية وتقسيمات مجموعة البيانات وكيفية تمثيل البيانات في ظل الظروف المختلفة، قد يصعب اكتشاف المشكلات التي تؤثر في أداء النموذج.
تتضمن منصة Ultralytics ميزات مدمجة تساعد على تحليل مجموعات البيانات بفاعلية أكبر. وتتوفر هذه الرؤى مباشرةً ضمن واجهة مجموعة البيانات، عبر علامات تبويب مثل الصور والفئات والمخططات.
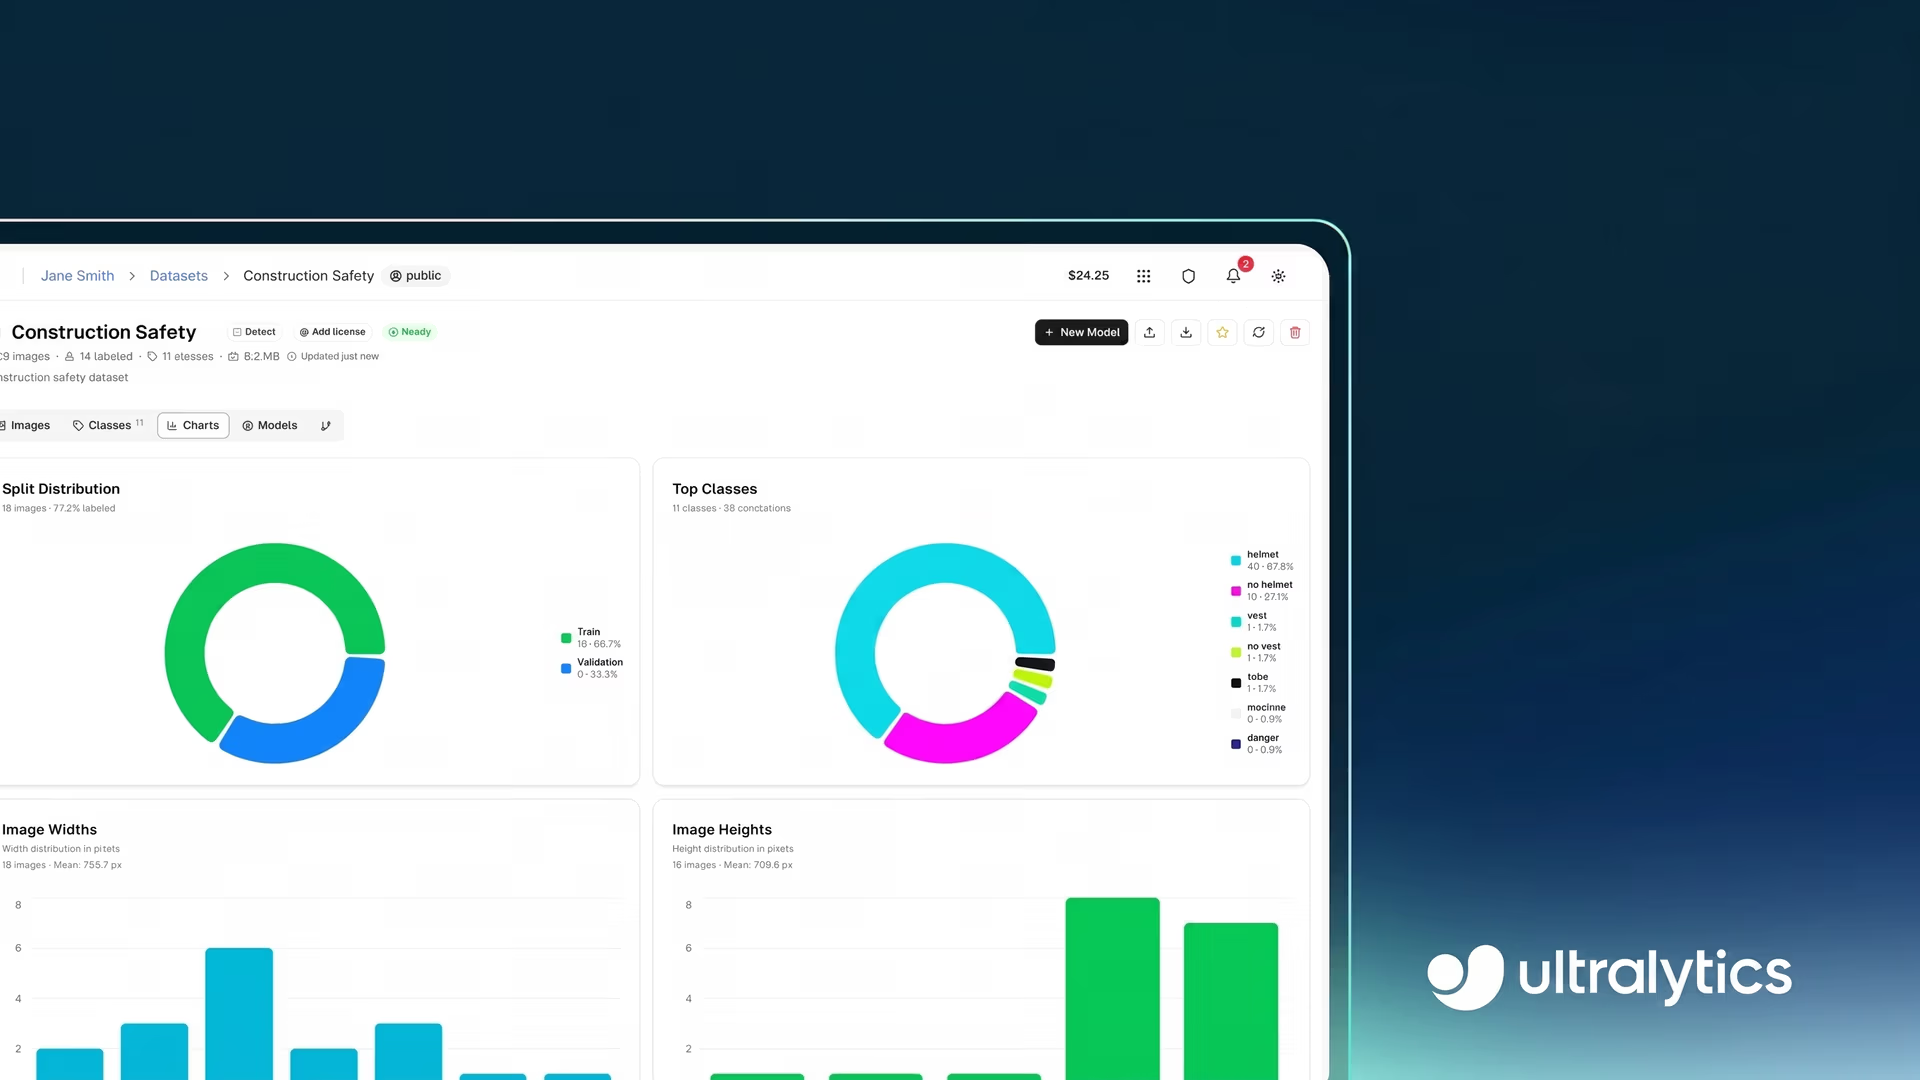
في علامة تبويب المخططات، يمكنك الاطلاع على إحصاءات على مستوى مجموعة البيانات، مثل توزيع التقسيمات (التدريب والتحقق والاختبار) وتكرار الفئات والخرائط الحرارية للتعليقات التوضيحية التي توضح مواضع ظهور العناصر داخل الصور.
تعرض علامة تبويب الفئات تفصيلًا لعدد التعليقات التوضيحية لكل فئة، ما يسهّل اكتشاف عدم توازن الفئات. أما علامة تبويب الصور، فتعرض تفاصيل على مستوى الصورة، مثل الأبعاد وعدد التعليقات التوضيحية وكيفية توزيع التسميات على الصور الفردية.
تسهّل هذه الرؤى تحديد مشكلات مثل عدم توازن الفئات أو السيناريوهات الناقصة أو التوزيع غير المتكافئ للبيانات. فقد تلاحظ، على سبيل المثال، أن بعض الفئات لا تضم سوى أمثلة قليلة، أو أن معظم التعليقات التوضيحية تتركز في مناطق محددة من الصورة.
إلى جانب تحليل البيانات، تدعم المنصة تنقيح مجموعات البيانات وزيادتها، أي تحسينها عبر إصلاح البيانات الإشكالية أو إزالتها وإنشاء تنويعات من البيانات الموجودة لتحسين أداء النموذج. ويمكن إجراء هذه التحسينات مباشرةً ضمن المنصة عن طريق تحديث التعليقات التوضيحية أو إضافة بيانات جديدة أو إعادة تنظيم تقسيمات مجموعة البيانات استنادًا إلى رؤى التحليل.
تصدير مجموعات البيانات من منصة Ultralytics#
بعد إعداد مجموعة البيانات والتحقق منها، يمكن تصديرها لاستخدامها في بيئات مختلفة. ويمنحك ذلك مرونة استخدام بيانات الرؤية الحاسوبية حيثما تفضّل، سواء لتدريب النماذج محليًا أو في السحابة أو باستخدام أدوات ومسارات عمل أخرى.
تُصدّر Ultralytics Platform مجموعات البيانات في ملفات Ultralytics NDJSON، وهو تنسيق يمكن لحزمة Ultralytics Python التدريب عليه مباشرةً وإعادة استيراده إلى المنصة، ما يسهّل دمج مجموعات البيانات في أدوات وسير عمل تدريب مختلفة.
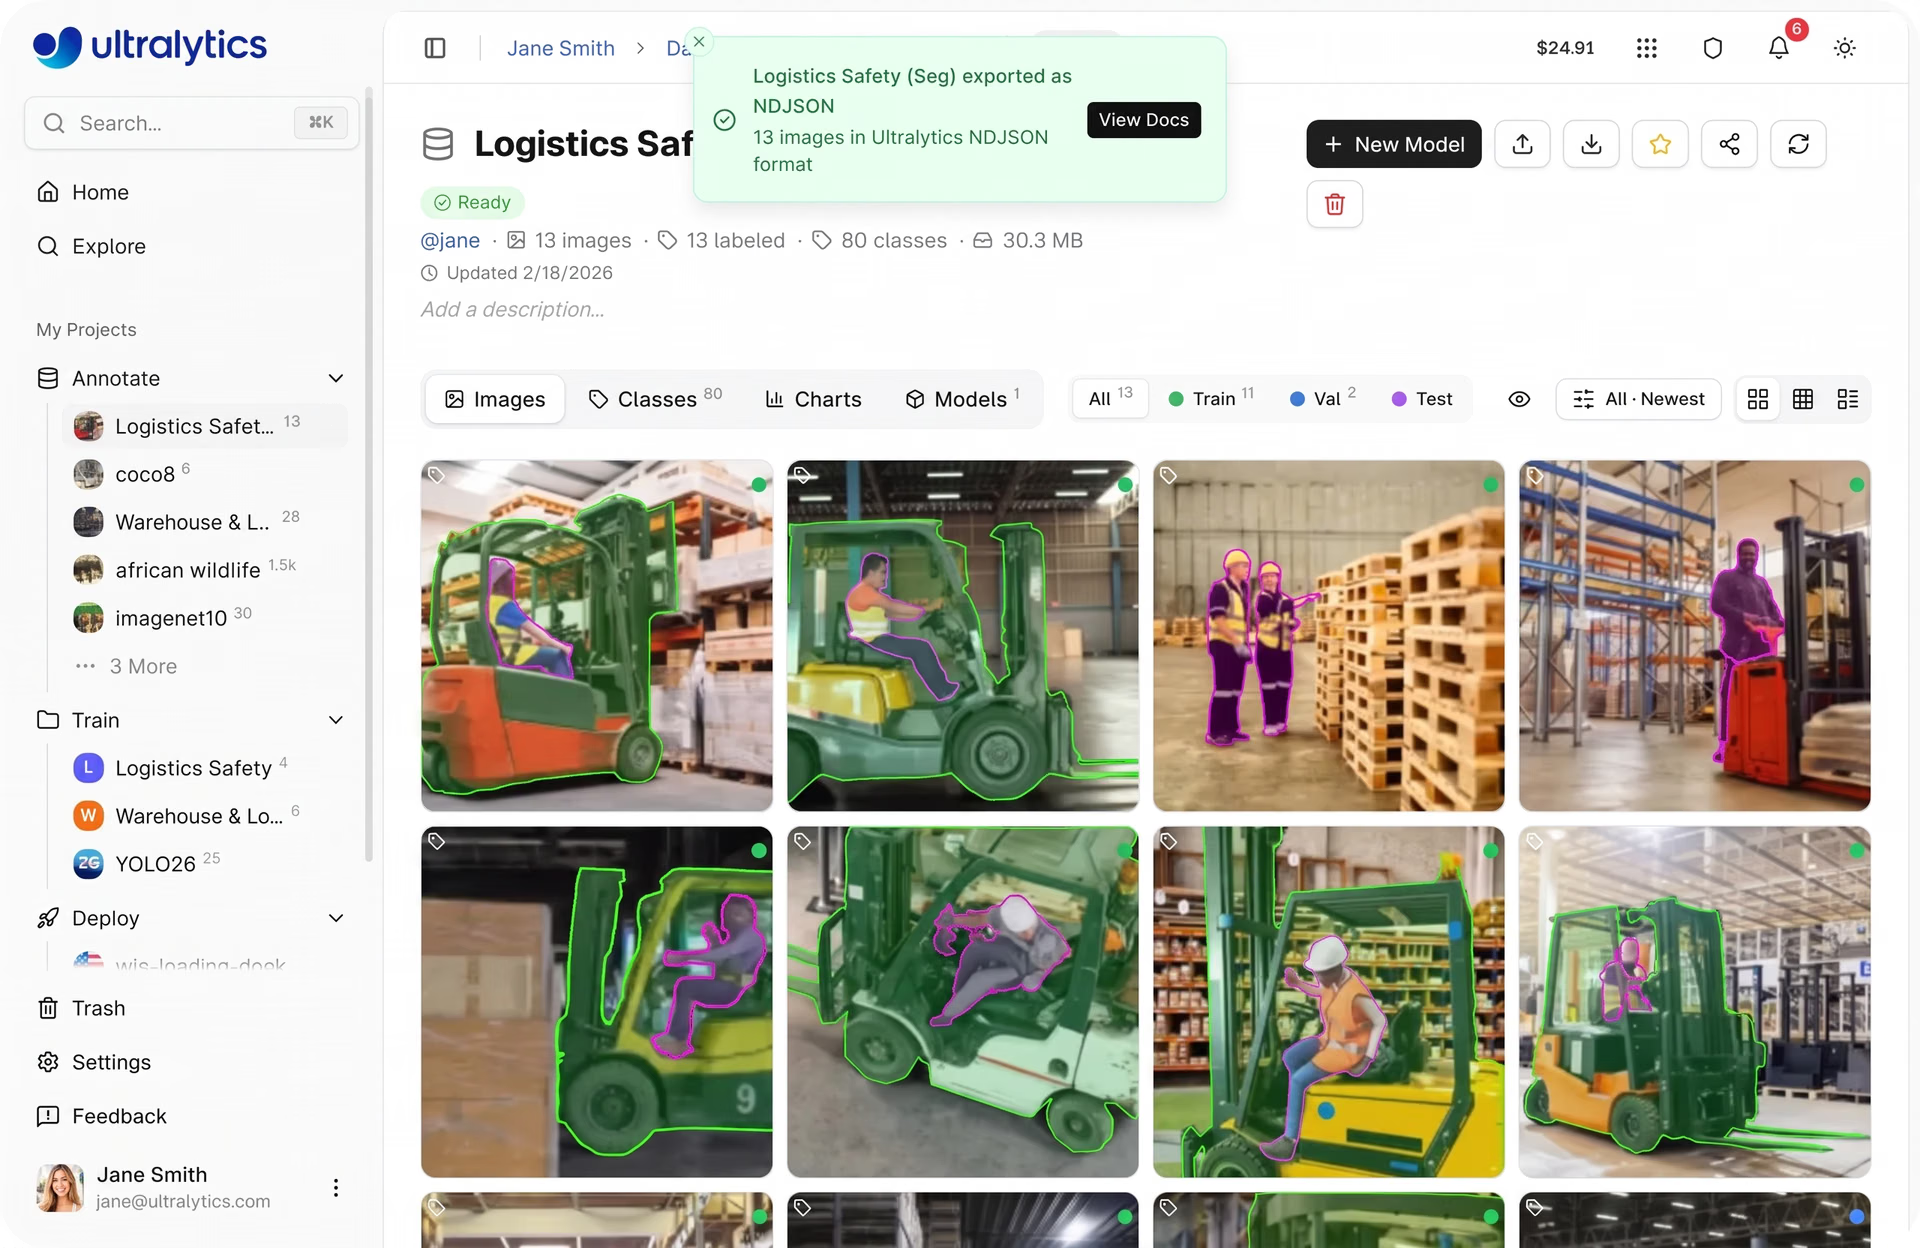
الشكل 3. تصدير مجموعة بيانات من منصة Ultralytics (المصدر)
ينشئ تصدير مجموعة البيانات لقطة ثابتة للبيانات في نقطة زمنية محددة، بما يشمل صورها وتعليقاتها التوضيحية وبنيتها. وهذا مفيد لأن مجموعات البيانات تتغير غالبًا مع إضافة بيانات جديدة أو تحديث التعليقات التوضيحية أو تعديل التقسيمات. ومن خلال تصدير لقطة، يمكنك الاحتفاظ بالإصدار المطابق تمامًا لمجموعة البيانات المستخدم في جولة تدريب معينة.
يسهّل ذلك إعادة إنتاج النتائج لاحقًا، إذ يمكنك تدريب نموذج على إعداد البيانات نفسه مجددًا ومقارنة الأداء بين إصدارات مجموعة البيانات المختلفة. فعلى سبيل المثال، يمكنك تقييم ما إذا كانت إضافة صور جديدة أو تصحيح التعليقات التوضيحية تحسّن دقة النموذج فعلًا، بدلًا من التخمين بشأن التغييرات التي أُجريت.
يمكن تنزيل مجموعات البيانات المُصدّرة واستخدامها في بيئات التدريب المحلية أو السحابية أو غير المتصلة.
تحسين جودة مجموعات البيانات من خلال التكرار على منصة Ultralytics#
في مسارات عمل تعلم الآلة والتعلم العميق، تستمر إدارة مجموعات البيانات حتى بعد النشر، لأن بيانات العالم الحقيقي غالبًا ما تختلف عن البيانات المستخدمة أثناء التدريب.
مع مواجهة النماذج لمدخلات جديدة، تتضح أكثر ثغرات مجموعة البيانات، مثل الظروف الناقصة كالبيئات منخفضة الإضاءة وزوايا الكاميرات المختلفة والاحتجاب والمشاهد المزدحمة، إلى جانب أخطاء التعليقات التوضيحية؛ ما يجعل تنقيح البيانات بمرور الوقت أمرًا ضروريًا.
توجد عدة طرق لتحسين مجموعة البيانات. يمكنك إضافة صور أو مقاطع فيديو جديدة لتغطية الظروف الناقصة، مثل البيئات منخفضة الإضاءة وزوايا الكاميرات المختلفة والاحتجاب والمشاهد المزدحمة، ما يساعد على تقليل النقاط العمياء في البيانات.
وفي الوقت نفسه، يساعد ضمان دقة التعليقات التوضيحية واتساقها، مثل تسمية العناصر على نحو صحيح واستخدام مربعات إحاطة أو أقنعة دقيقة، النموذج على تعلم أنماط أكثر موثوقية.
تتبع هذه العملية عادةً دورة بسيطة: درّب النموذج، وقيّم النتائج، وحدد الأخطاء، وحسّن مجموعة البيانات، ثم أعد التدريب. وتساعد كل خطوة على إبراز مشكلات مثل التعليقات التوضيحية غير الصحيحة أو البيانات الناقصة أو الحالات غير الممثلة بما يكفي.
لنفترض أنك تعمل على نظام لمراقبة رفوف المتاجر في الوقت الفعلي، يُستخدم لاكتشاف المنتجات في المتاجر. قد لا تتضمن الإصدارات الأولى من مجموعة البيانات أنواعًا معينة من المنتجات أو ظروف الإضاءة أو ترتيبات الرفوف المزدحمة. وأثناء التقييم، قد تلاحظ أن النموذج يواجه صعوبة في اكتشاف العناصر في هذه الحالات.
لتحسين الأداء، يمكنك جمع صور جديدة تغطي هذه السيناريوهات الناقصة وتحديث التعليقات التوضيحية عند الحاجة. ويساعد تكرار هذه العملية بمرور الوقت النموذج على أن يصبح أكثر دقة وموثوقية في ظروف العالم الحقيقي.
تدعم منصة Ultralytics سير العمل هذا من خلال ربط تحديثات مجموعات البيانات بالتدريب والتقييم. وبفضل تتبع التجارب المدمج ومقاييس الأداء، تصبح مراقبة التقدم وتحسين مجموعات البيانات باستمرار بمرور الوقت أكثر سهولة.
تتبع تغييرات مجموعات البيانات باستخدام منصة Ultralytics#
تحدثنا بإيجاز عن تطور مجموعات البيانات بمرور الوقت بوصفه جزءًا من عملية تطوير النماذج. ومع إضافة بيانات جديدة وتنقيح التعليقات التوضيحية وتحديث الفئات، يصبح تتبع هذه التغييرات أساسيًا للحفاظ على جودة البيانات وضمان اتساق أداء النموذج.
فيما يلي بعض الميزات الرئيسية في منصة Ultralytics التي تدعم تتبع مجموعات البيانات والتحكم في الإصدارات:
- إصدارات مجموعة البيانات: يمكنك إنشاء إصدارات ثابتة لمجموعة البيانات على هيئة لقطات NDJSON. ويسجل كل إصدار تفاصيل رئيسية، مثل عدد الصور وعدد الفئات وعدد التعليقات التوضيحية وحجم مجموعة البيانات في نقطة زمنية محددة. وتُخزّن هذه الإصدارات ويمكن تنزيلها لاحقًا، ما يسهّل إعادة إنتاج التجارب ومقارنة النتائج بين الحالات المختلفة لمجموعة البيانات.
- علامة تبويب الإصدارات: تُنظّم جميع إصدارات مجموعة البيانات في علامة تبويب الإصدارات، حيث يمكنك الاطلاع على سجل الإصدارات وإضافة أوصاف للتغييرات وتتبع تطور مجموعة البيانات بمرور الوقت.
- الربط بالنماذج: تعرض علامة تبويب النماذج جميع النماذج المدرّبة على مجموعة بيانات، بما في ذلك مقاييس مثل mAP وتفاصيل التدريب. وترتبط إصدارات مجموعة البيانات بجولات التدريب، ما يساعدك على فهم تأثير تغييرات البيانات في أداء النموذج.
- علامة تبويب الأخطاء: تبرز علامة تبويب الأخطاء الملفات التي تعذرت معالجتها، إلى جانب تفاصيل الأخطاء والاقتراحات. ويتيح لك ذلك تحديد المشكلات، مثل الملفات التالفة أو التنسيقات غير المدعومة، وإصلاحها قبل التدريب.
- واجهة مجموعة البيانات (علامتا تبويب الصور والفئات): تتيح لك هاتان الواجهتان استعراض الصور ومراجعة التعليقات التوضيحية وإدارة تسميات الفئات وتحليل توزيع الفئات. وتجعل ميزات مثل التصفية والفرز وتحديد الصور التي لم تُضف إليها تعليقات توضيحية مراقبة جودة مجموعة البيانات بمرور الوقت أسهل.
- الإحصاءات والمخططات: تساعد تصورات البيانات المدمجة، مثل توزيع التقسيمات وتكرار الفئات والخرائط الحرارية للتعليقات التوضيحية، على تتبع التغييرات في توزيع البيانات وتحديد أوجه عدم التوازن مع تطور مجموعة البيانات.
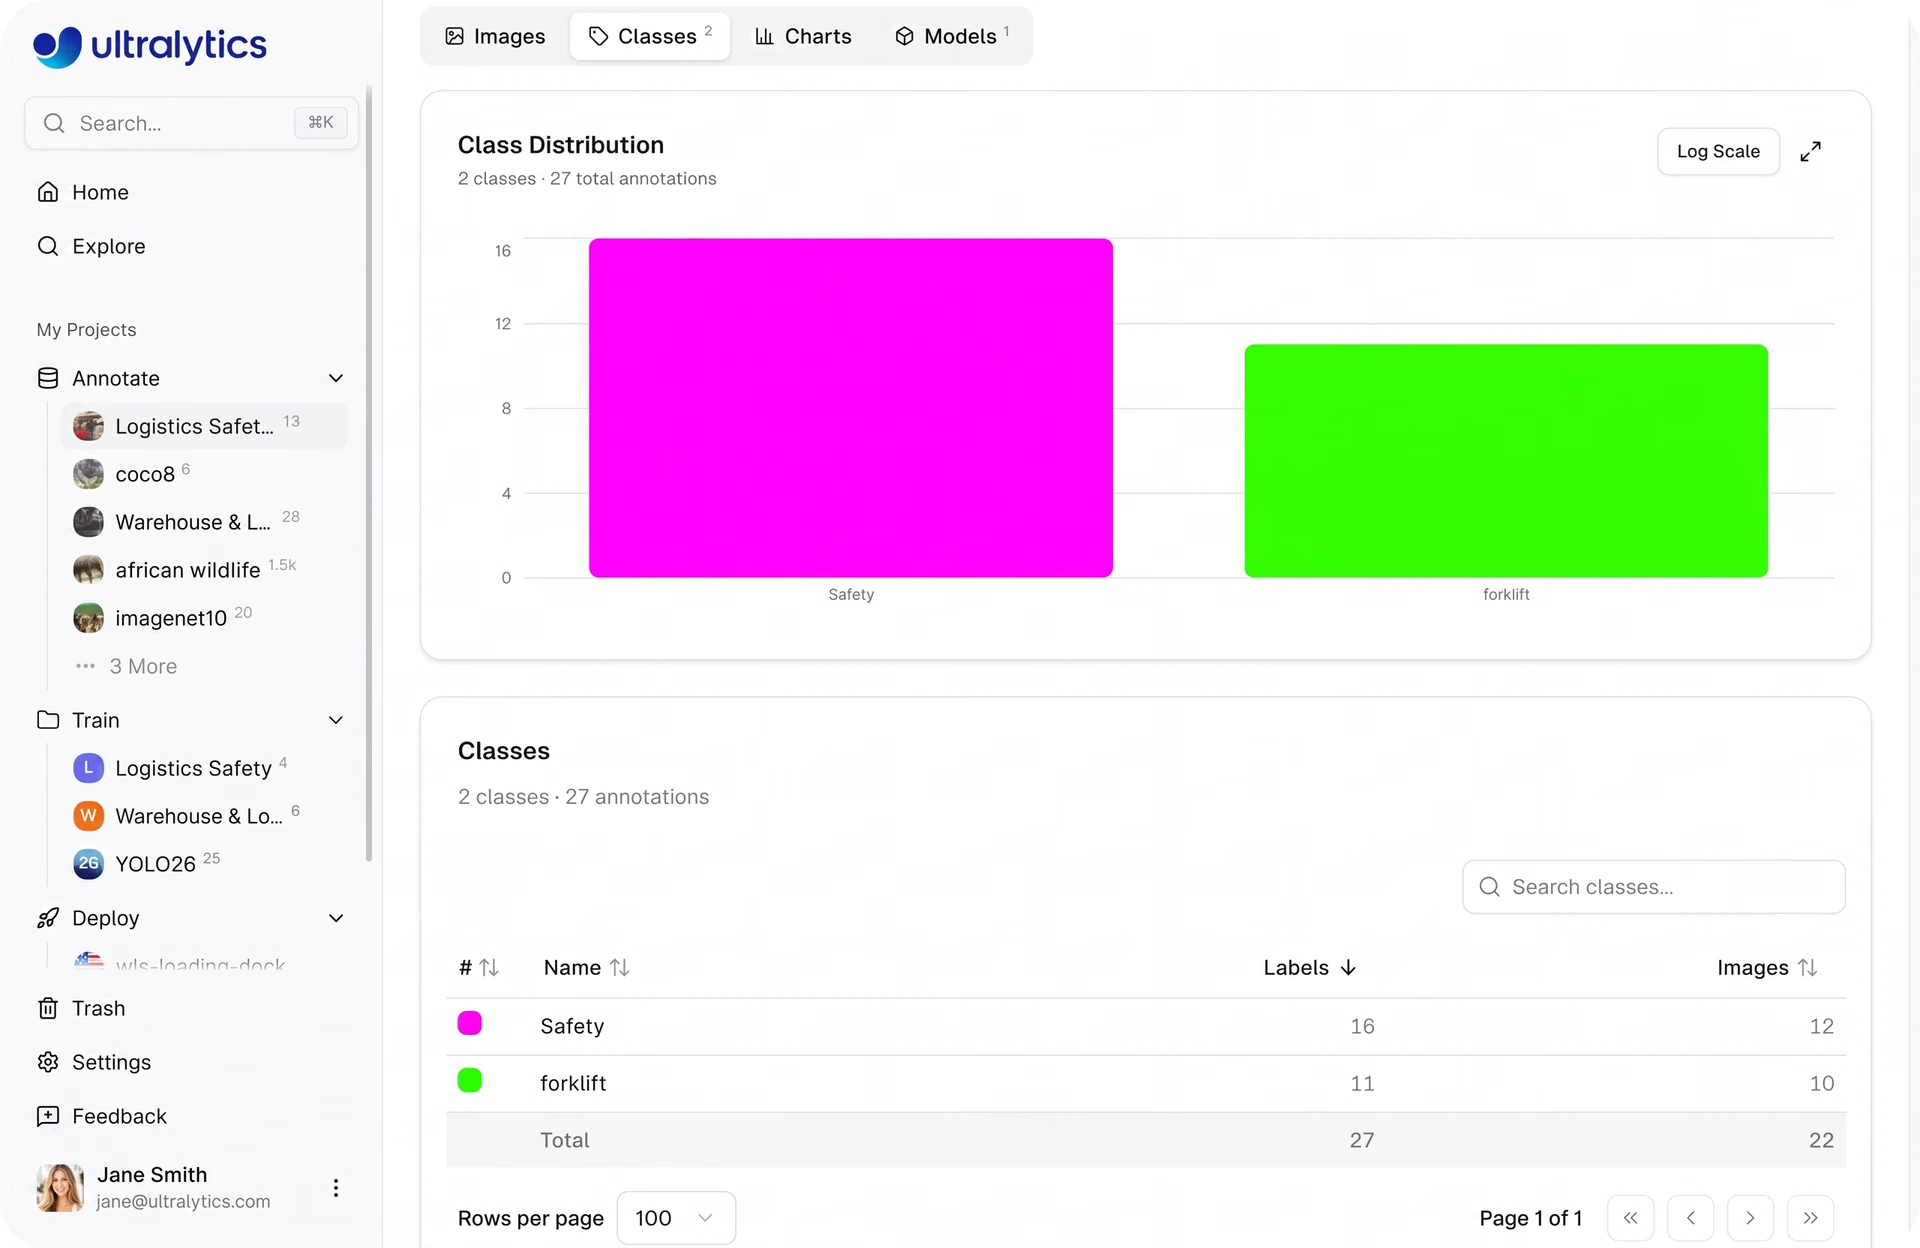
الشكل 4. نظرة على تحليل توزيع فئات مجموعة بيانات على منصة Ultralytics (المصدر)
ربط مجموعات البيانات بالتدريب والنشر ضمن منصة Ultralytics#
تربط منصة Ultralytics مراحل تطوير نماذج الذكاء الاصطناعي المختلفة ضمن مسار واحد. وهذا يبسّط الانتقال من البيانات الخام إلى تطبيقات الذكاء الاصطناعي البصري الجاهزة للإنتاج.
بعد إعداد مجموعات البيانات وإضافة التعليقات التوضيحية إليها، يمكن استخدامها لتدريب نماذج الرؤية الحاسوبية، مثل Ultralytics YOLO26، مباشرةً ضمن المنصة. وأثناء التدريب، يمكنك مراقبة مقاييس الأداء وتتبع التجارب وتقييم مدى تعلم النموذج باستخدام لوحات المعلومات المدمجة.
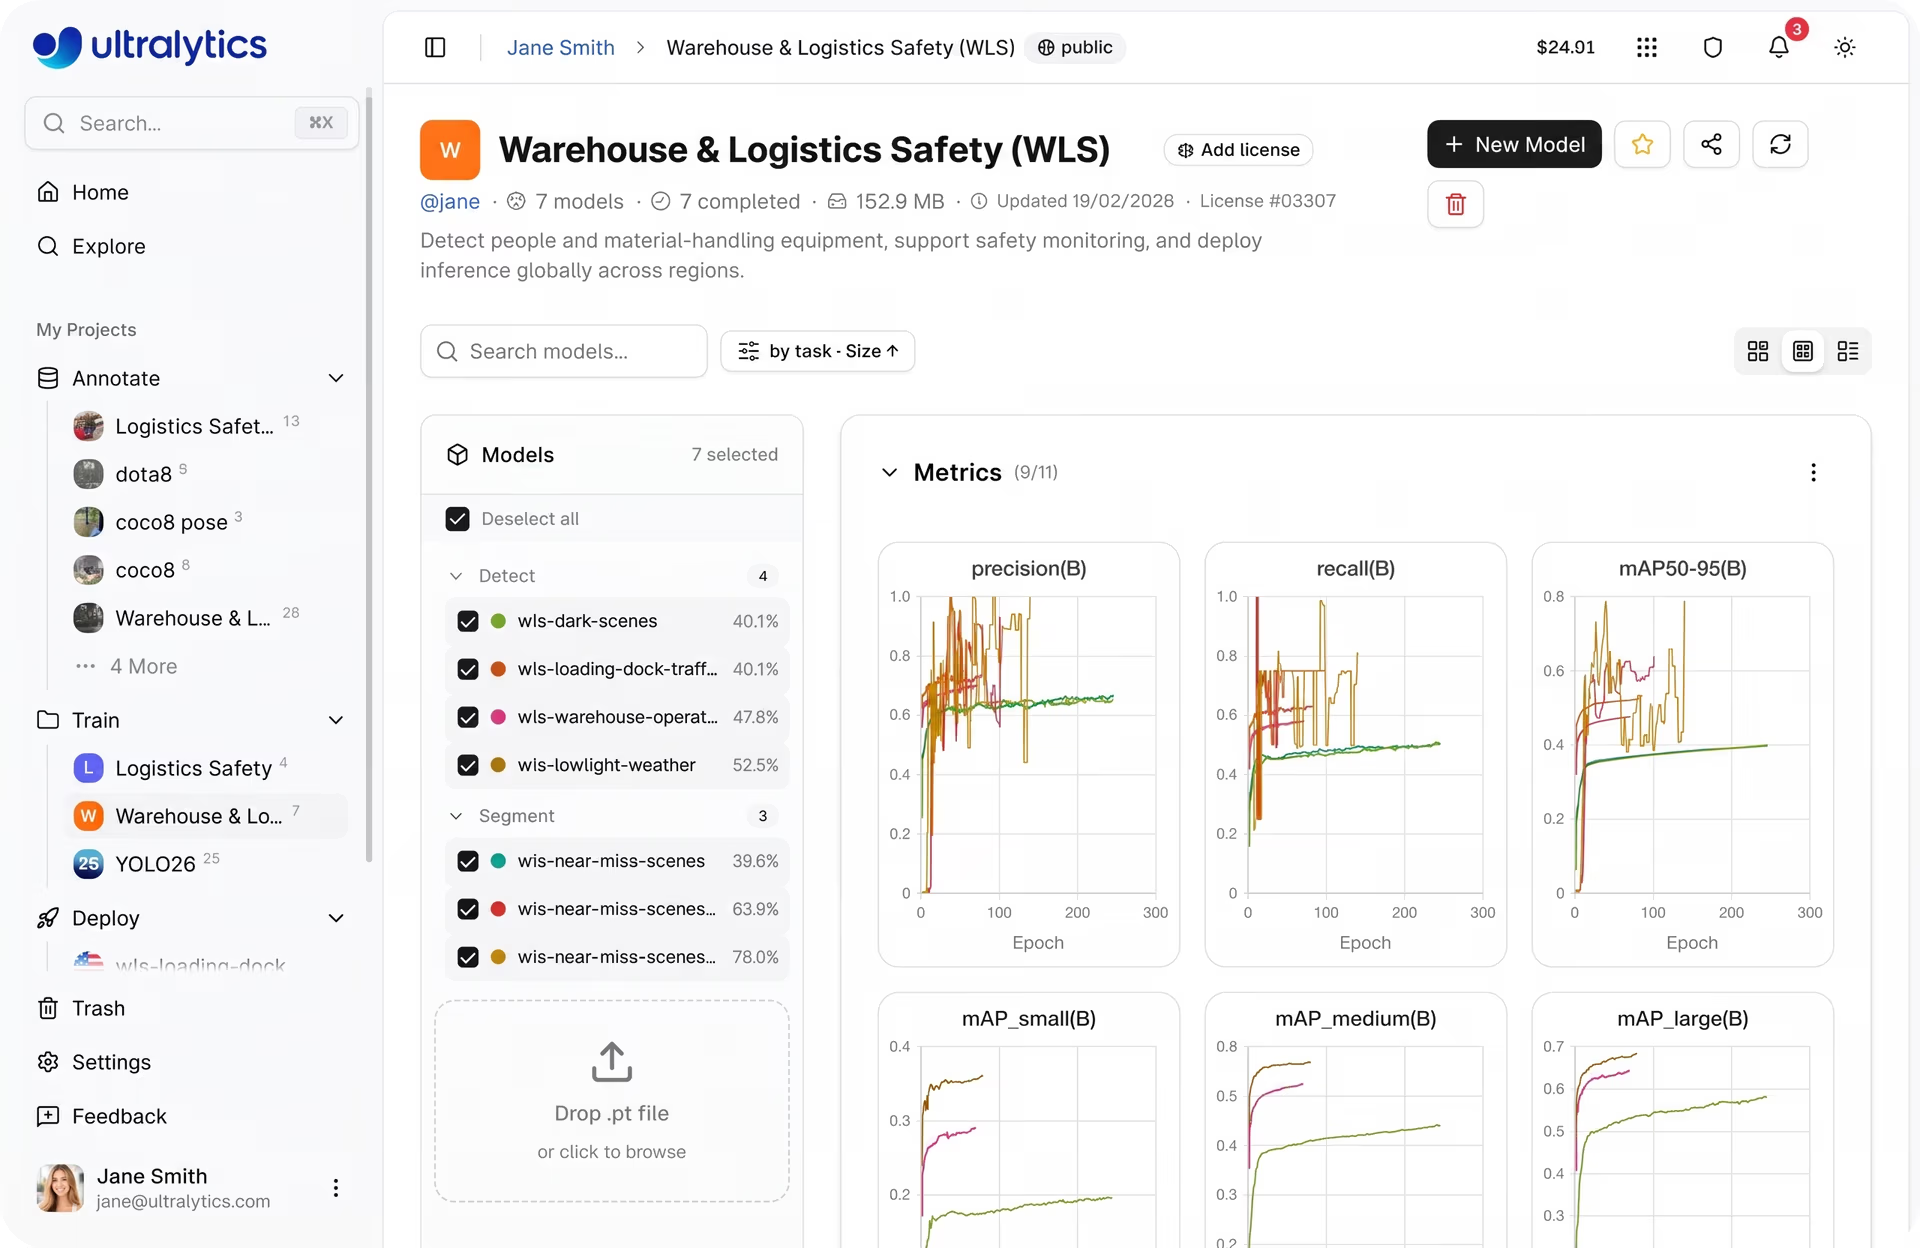
الشكل 5. لمحة عن عرض مقاييس تدريب النماذج على منصة Ultralytics (المصدر)
بعد التدريب، يمكن اختبار النماذج على صور جديدة مباشرةً في المتصفح لتقييم التنبؤات وتحديد مجالات التحسين قبل النشر. وعندما يحقق النموذج أداءً جيدًا، يمكن نشره في بيئة الإنتاج.
تدعم المنصة تصدير النماذج إلى تنسيقات متعددة أو نشرها عبر خدمات الاستدلال ونقاط النهاية المخصصة، ما يتيح تشغيلها في بيئات مختلفة.
بعد النشر، تساعد أدوات المراقبة المدمجة على تتبع أداء النظام بمرور الوقت، بما في ذلك المقاييس المتعلقة بالاستخدام وسلوك النموذج. وهذا يجعل صيانة أنظمة الذكاء الاصطناعي البصري وتحسينها في تطبيقات العالم الحقيقي أكثر سهولة.
أفضل الممارسات لإدارة مجموعات البيانات باستخدام منصة Ultralytics#
فيما يلي بعض العوامل الرئيسية التي ينبغي مراعاتها عند إدارة مجموعات بياناتك باستخدام منصة Ultralytics:
- استخدم عوامل التصفية لاكتشاف الفجوات: حدّد البيانات غير المصنفة أو ناقصة التمثيل باستخدام أدوات التصفية، لتسهيل استكمال التعليقات التوضيحية وتحسين التغطية.
- عالج الأخطاء مبكرًا: استخدم علامة التبويب «الأخطاء» لمراقبة الجودة واكتشاف حالات فشل التحميل أو الملفات التالفة أو التنسيقات غير المدعومة قبل التدريب.
- حدّث مجموعات البيانات باستمرار: أضف بيانات جديدة، وصحّح التعليقات التوضيحية، وأدرج الحالات الحدية عند ظهورها. يساعد ذلك على تحسين التغطية وضمان أداء النماذج بموثوقية في سيناريوهات العالم الحقيقي.
- أدر تقسيمات مجموعة البيانات بعناية: احرص على تحقيق توازن جيد بين مجموعات التدريب والتحقق والاختبار. يمكنك إعادة تنظيم التقسيمات يدويًا أو استخدام إعادة التوزيع التلقائية عند الحاجة.
لمعرفة المزيد عن Ultralytics Platform، راجع الوثائق الرسمية لـ Ultralytics Platform.
أبرز النقاط#
مع توسّع مشاريع الرؤية الحاسوبية، تصبح إدارة مجموعات البيانات بفاعلية بأهمية تطوير النماذج نفسها. ويساعد اتباع نهج منظم لإدارة مجموعات البيانات على تحسين جودة البيانات، وتبسيط سير العمل، ودعم أداء أفضل للنماذج بمرور الوقت.
تُبسّط منصة Ultralytics هذه العملية من خلال جمع إدارة مجموعات البيانات والتدريب والنشر ضمن سير عمل واحد. وباتباع نهج منظم لإدارة مجموعات البيانات، يمكن للفرق تقليل التعقيد، وتحسين الكفاءة، وبناء أنظمة رؤية حاسوبية أكثر قابلية للتوسع والاعتماد.
انضم إلى مجتمعنا المتنامي واستكشف مستودع GitHub للحصول على موارد الذكاء الاصطناعي. للبدء بالبناء باستخدام الذكاء الاصطناعي للرؤية اليوم، اطّلع على خيارات الترخيص. تعرّف على كيفية إحداث الذكاء الاصطناعي في الزراعة تحولًا في الزراعة، وعلى كيفية رسم الذكاء الاصطناعي للرؤية في الرعاية الصحية ملامح المستقبل، بزيارة صفحات حلولنا.
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









