Ultralytics YOLO26 unterstützt jetzt monokulare Tiefenschätzung
Erfahre, wie die neue Tiefenschätzungsaufgabe in Ultralytics YOLO26 die Tiefe für jedes Pixel in metrischem Maßstab aus einem einzelnen RGB-Bild vorhersagt – ganz ohne Stereoanlage oder LiDAR.
Bislang bedeutete mehr Tiefeninformationen in einer YOLO-Pipeline, alles selbst zusammenzustellen. Üblicherweise wurde YOLO zur Erkennung ausgeführt und mit einem separaten Tiefenmodell aus einem anderen Projekt kombiniert, etwa MiDaS oder Depth Anything. Das bedeutete eine zweite Abhängigkeit, ein zweites Framework und zwei Eingabe- und Ausgabeformate, die aufeinander abgestimmt werden mussten.
Die monokulare Tiefenschätzung ist jetzt eine native Aufgabe in Ultralytics YOLO26. Ein einziges RGB-Bild liefert für jedes Pixel einen Abstandswert. Dafür werden dasselbe Paket, derselbe Arbeitsablauf und derselbe Exportpfad wie bei Erkennung, Segmentierung und Pose verwendet.
Was ist Tiefenschätzung?#
Tiefenschätzung sagt eine Tiefenkarte auf Pixelebene anhand eines einzelnen RGB-Bildes voraus, ohne dass eine zweite Kamera oder ein zusätzlicher Sensor erforderlich ist. Jedes Ausgabepixel enthält einen Tiefenwert in Metern, der den geschätzten Abstand von der Kamera zu diesem Oberflächenpunkt angibt.
Die Ausgabe ist eine dichte Fließkommakarte mit der Form (H, W), die am Eingabebild ausgerichtet ist. Jedes Pixel enthält einen absoluten Abstand in Metern: den Abstand zur Kamera und keine relative Reihenfolge danach, was näher oder weiter entfernt ist.
Die Ausgabe auf Pixelebene macht Tiefeninformationen nützlich für die Erkennung von Hindernissen und freien Flächen, die Überprüfung von Abständen, die räumliche Anordnung einer Szene und das Verständnis dafür, was sich vor etwas anderem befindet.
Die Tiefenschätzung ist eine eigenständige Aufgabe mit einem eigenen Prüfpunkt, und ihre einzige Ausgabe ist die Tiefenkarte. Sie liefert keine Begrenzungsrahmen oder Segmentierungsmasken zurück. Um Erkennung mit Tiefeninformationen zu kombinieren, müssen daher zwei Modelle und zwei Vorwärtsdurchläufe ausgeführt werden. Neu ist, dass beide nun in einem einzigen Paket untergebracht sind und sich eine Installation, eine Schnittstelle für Training und Vorhersage, ein Exportpfad und eine Version teilen. So muss nicht länger ein zweites Framework parallel zum ersten gepflegt werden.
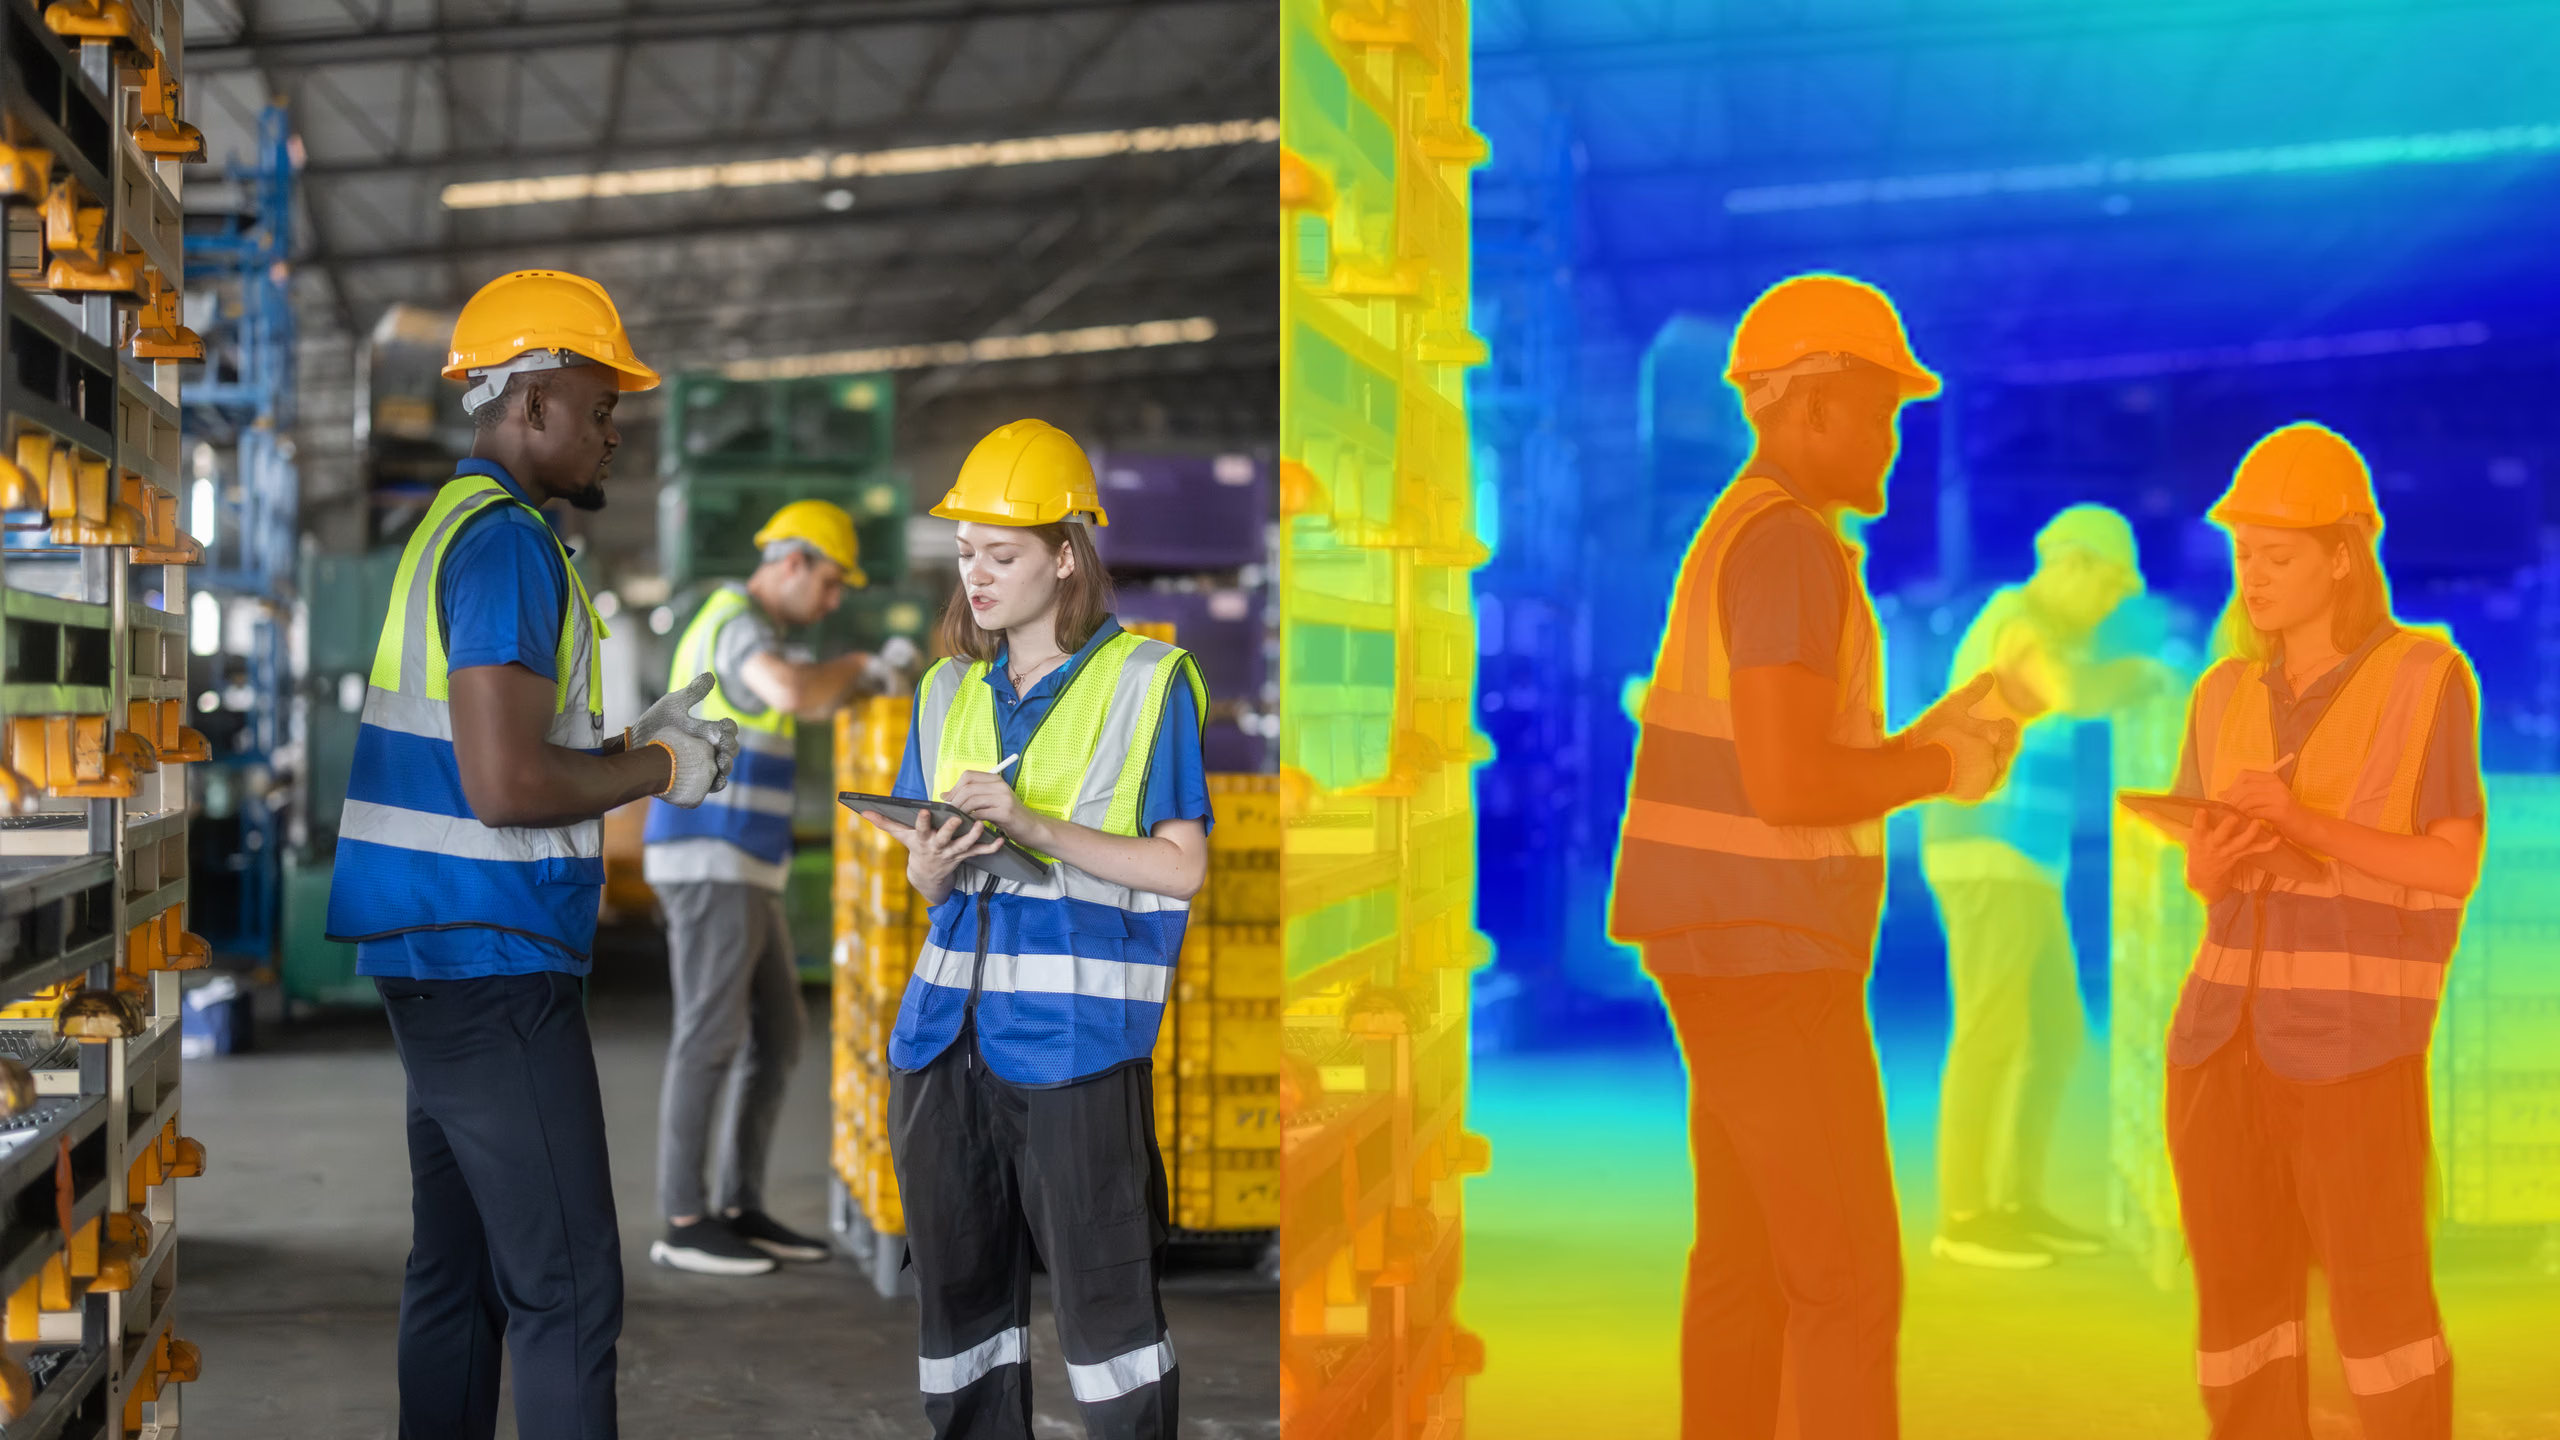 Abb. 1. Ultralytics YOLO26 zur Tiefenschätzung für Sicherheits- und Compliance-Überwachung.
Ultralytics YOLO26 umfasst fünf vortrainierte Tiefenmodelle – von yolo26n-depth bis yolo26x-depth –, die mit einer breiten Mischung aus mehreren Datensätzen mit insgesamt rund 2,19 Millionen Innen- und Außenaufnahmen trainiert wurden. Auf dem Datensatz NYU Depth V2 reicht die Genauigkeit von 0,882 δ1 beim Nano-Modell bis 0,933 beim Extra-Large-Modell. So kannst du den Kompromiss zwischen Geschwindigkeit und Genauigkeit wählen, der zu deinem Einsatzziel passt.
Von Grund auf unbegrenzte Tiefenschätzung#
Die meisten Tiefenmodelle begrenzen ihre Vorhersagen auf einen festen Bereich, zum Beispiel 0–10 Meter. Das funktioniert in Innenräumen gut, versagt aber im Freien. Ultralytics sagt die Tiefe stattdessen auf einer offenen logarithmischen Skala voraus, ohne feste Obergrenze.
Der Unterschied zeigt sich in Tests. Ein begrenztes Modell stagniert fast sofort, wenn es mit gemischten Innen- und Außendaten trainiert wird, und versagt bei Datensätzen mit größerer Reichweite wie KITTI, bei denen Objekte bis zu 80 Meter entfernt sein können. Der Ansatz von Ultralytics YOLO26 hat keine solche Obergrenze, verbessert sich daher mit mehr Daten weiter und funktioniert von wenigen Zentimetern bis zu mehreren hundert Metern zuverlässig. Auf KITTI erreicht δ1 bei einer Reichweite von 80 m den Wert 0,942. Das bedeutet, dass eine Modellfamilie eine Tischszene ebenso gut bewältigt wie eine Autobahnszene.
Ultralytics YOLO26 Depth im Vergleich zu Depth Anything V2#
Wenn du heute Depth Anything parallel zu YOLO ausführst, liegt der Unterschied in der Geschwindigkeit und den damit verbundenen Rechenkosten. Ultralytics YOLO26 Depth läuft bis zu 20,3-mal schneller als Depth Anything V2 Base und 7,7-mal schneller als Depth Anything V2 Small. Dabei ist das Modell deutlich kleiner: Das Nano-Modell hat weniger als 10 Millionen Parameter, während der kleinere Checkpoint von DA V2 rund 24 Millionen Parameter umfasst.
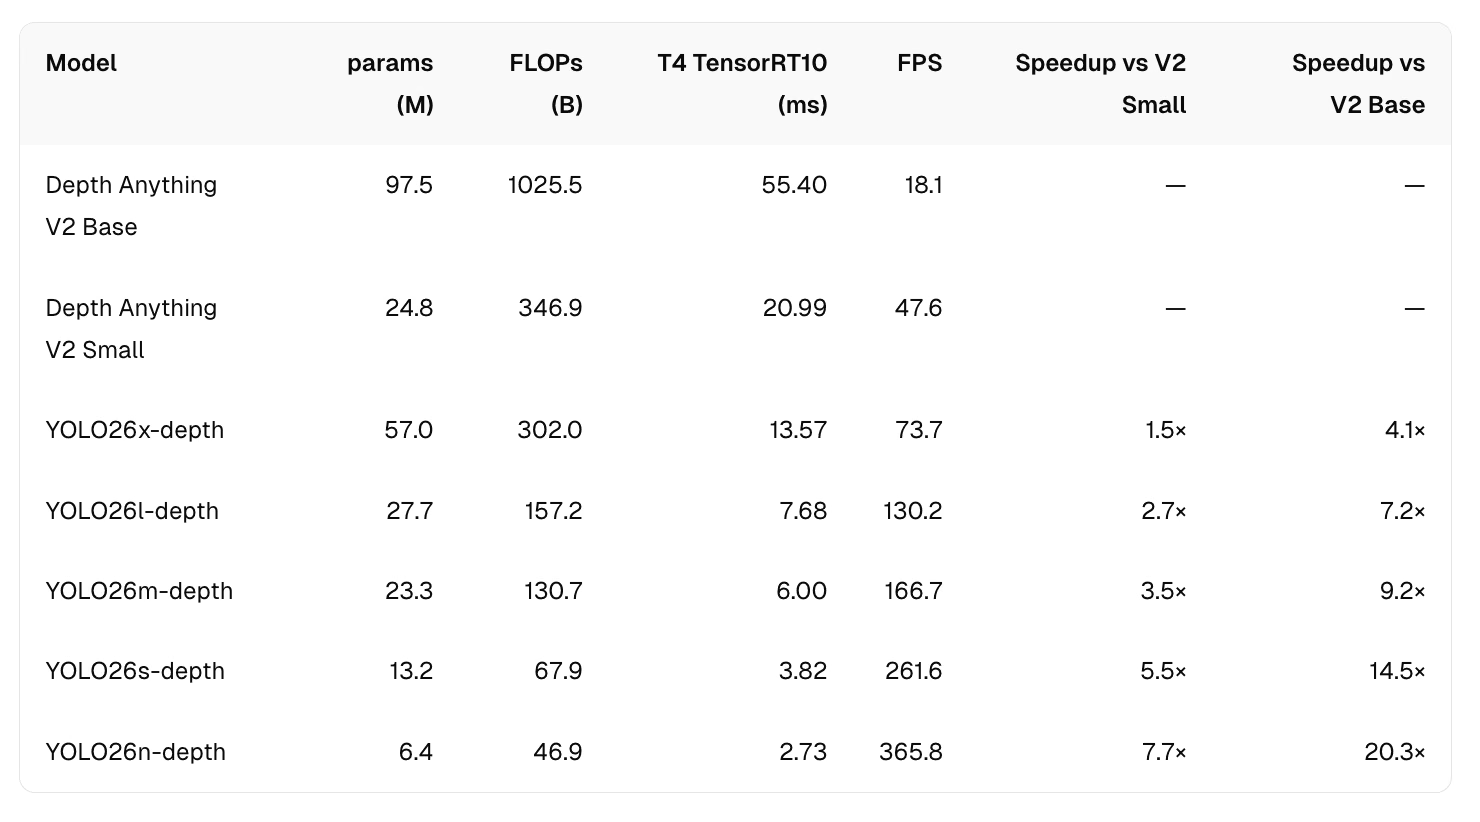 Abb. 2. Geschwindigkeitsbenchmarks für Ultralytics YOLO26 Depth im Vergleich zu Depth Anything V2.
Dieser Abstand ist beabsichtigt. Die Modelle von Depth Anything V2 sind deutlich größer; Ultralytics YOLO26-Depth wurde auf hohe Tiefenschätzungsleistung bei einer Größe und Geschwindigkeit ausgelegt, die pro Bild weniger Rechenleistung benötigt und den Einsatz auf Hardware ermöglicht, für die diese Modelle nicht geeignet sind. Die Genauigkeitswerte der einzelnen Modelle auf NYU Depth V2 und KITTI sind in der Dokumentation veröffentlicht, sodass du sie mit deinen tatsächlichen Anforderungen abgleichen kannst.
Wo es eingesetzt werden kann#
Dieser Größenunterschied entscheidet darüber, wo Tiefenschätzung tatsächlich eingesetzt werden kann. Den meisten Teams, die Tiefenschätzung evaluieren, mangelt es nicht an Ideen, sondern an Rechenleistung. Drohnen mit geringem Stromverbrauch, vierbeinige Roboter, Wearables, Dashcams, Konferenztechnik und Industrie-PCs stoßen alle an eine Leistungs- und Kostengrenze, bevor sie an eine Genauigkeitsgrenze stoßen.
Tiefenschätzung ist mit fünf vortrainierten Modellen verfügbar. So kannst du die Größe wählen, die zum Zielgerät passt, statt die Größe, die in einem Benchmark gewinnt. Da Tiefenschätzung eine native Aufgabe von Ultralytics YOLO26 ist, nutzt sie denselben Exportpfad wie Erkennung, Segmentierung und Pose mit den folgenden Formaten: ONNX, TensorRT, CoreML, NCNN, LiteRT.
Erste Schritte mit Ultralytics YOLO26 Depth#
Das Ultralytics-Python-Paket bietet eine einheitliche Schnittstelle für Training, Validierung und Inferenz bei allen YOLO26-Aufgaben, einschließlich Tiefenschätzung. Ein vortrainiertes Tiefenmodell lässt sich mit einem einzigen Befehl ausführen:
from ultralytics import YOLO
from ultralytics import YOLO

# Modell laden
model = YOLO("yolo26n-depth.pt")  # offizielles Modell laden
model = YOLO("path/to/best.pt")  # benutzerdefiniertes Modell laden

# Vorhersage mit dem Modell ausführen
results = model("https://ultralytics.com/images/bus.jpg")  # Vorhersage für ein Bild ausführen

# Ergebnisse abrufen
for result in results:
    depth_map = result.depth.data.cpu().numpy()  # torch.Tensor → NumPy float32, shape (H, W), Meter
Oder über die CLI:
yolo depth predict model=yolo26n-depth.pt source='https://ultralytics.com/images/bus.jpg'  # predict with official model
yolo depth predict model=path/to/best.pt source='https://ultralytics.com/images/bus.jpg'   # predict with custom model
Die absolute Entfernung hängt von deiner Kamera und deiner Szene ab. Wenn die Form der Tiefenkarte stimmt, aber der Maßstab nicht, passt model.calibrate() in wenigen Sekunden zwei Variablen im Tiefenkopf des Modells an – einen Skalierungsfaktor und einen Versatz. Dafür genügen etwa 100 beschriftete Bilder; Training ist nicht erforderlich und der Rest des Netzwerks bleibt unverändert.
Feinabstimmung mit deinen eigenen Daten#
Um ein vortrainiertes Tiefenmodell an deine eigene Kamera oder Domäne anzupassen, beginne mit den vortrainierten Gewichten, verwende AdamW und setze die Lernrate deutlich niedriger an als den Standardwert für ein Training von Grund auf. So verfeinert die Feinabstimmung das Modell, statt es zu überschreiben:
from ultralytics import YOLO
from ultralytics import YOLO
model = YOLO("yolo26s-depth.pt")  # mit vortrainierten Gewichten beginnen
model.train(
    data="path/to/your_dataset.yaml",
    epochs=20,
    imgsz=640,
    optimizer="AdamW",
    lr0=1e-4,  # etwa 100-mal niedriger als der Standardwert für ein Training von Grund auf
    warmup_bias_lr=1e-4,  # auch das Aufwärmen moderat halten
)
Da der standardmäßige logarithmische Kopf unbegrenzt ist, funktioniert dies ohne weitere Anpassungen sowohl bei Datensätzen mit kurzer als auch mit großer Reichweite; eine Abstimmung mit max_depth ist nicht nötig. Wenn nur der absolute Maßstab für deine spezifische Kamera nicht stimmt, berechnet model.calibrate() in wenigen Sekunden eine einfache Korrektur in geschlossener Form anhand einer kleinen beschrifteten Teilmenge, ohne die Netzwerkgewichte anzutasten.
Zu jedem RGB-Bild gehört eine Tiefendatei im Format .npy in einer dazu passenden Ordnerstruktur. Ultralytics stellt integrierte Konfigurationen für NYU Depth V2, KITTI, Hypersim, SUN RGB-D und ARKitScenes bereit. So können die meisten Teams sofort mit der Validierung anhand eines Standardbenchmarks beginnen.
Wichtige Anwendungsfälle für die Tiefenschätzung#
Da diese neue Funktion mit einer einzelnen gewöhnlichen Kamera auskommt, eröffnet die monokulare Tiefenschätzung zahlreiche Möglichkeiten für Produkte und Branchen, für die sich die Kosten, der Stromverbrauch oder der Kalibrierungsaufwand eines Stereo- oder LiDAR-Systems sonst nicht rechtfertigen ließen. Werfen wir einen Blick auf einige wichtige Branchen und Anwendungsfälle, die von dieser Funktion profitieren können:
- Robotik und autonome Navigation. Mobile Roboter und Drohnen können mit einer einzelnen eingebauten Kamera die Entfernung zu Hindernissen und den freien Raum schätzen. Das unterstützt die Pfadplanung in Echtzeit, ohne spezielle Tiefensensoren.
- Überblick über industrielle Abläufe und Logistik. Prüfung von Abständen, Erkennung freier Flächen sowie Erfassung des Kontexts von Regalen oder Gängen mit einer einzelnen fest installierten Kamera – überall dort, wo ein zusätzlicher Sensor nicht praktikabel ist.
- Sicherheits- und Compliance-Überwachung. Sicherheitszonen für Gabelstapler und Lagerhallen, Erkennung von Vorfällen im Bahnverkehr sowie die Erkennung gestürzter Personen und zurückgelassener Gegenstände über vorhandene CCTV-Anlagen: Die Kameraübertragungen werden um Entfernungsinformationen ergänzt. Die bereits installierten Kameras werden neben den vorhandenen sicherheitszertifizierten Sensoren genutzt, nicht an ihrer Stelle.
- Inspektion von Infrastruktur und Anlagen. Analyse des Abstands zu Freileitungen, drohnengestützte Inspektion von Anlagen und Korrosion sowie Luftbildvermessung – überall dort, wo dieselbe Modellfamilie sowohl Nahaufnahmen als auch Szenen mit großer Reichweite bewältigen muss.
- Fahrerassistenz und Fahrzeugwahrnehmung. Die Tiefenausgabe mit großer Reichweite und ohne feste Obergrenze ermöglicht es derselben Modellfamilie, sowohl Nahaufnahmen in Innenräumen als auch Fahrszenen mit einer Reichweite von über 80 m zu verarbeiten.
- AR und räumliche Inhalte. Virtuelle Objekte glaubwürdig in einer realen Szene zu platzieren oder tiefenabhängige Effekte anzuwenden, setzt voraus, dass bekannt ist, wie weit jedes Pixel tatsächlich von der Kamera entfernt ist.
Tiefenschätzung für jeden Einsatz von Ultralytics YOLO26#
Da Tiefenschätzung jetzt eine native Aufgabe von Ultralytics YOLO26 ist, können Teams den pixelgenauen Abstand jeder RGB-Kamera in verschiedensten Branchen nutzen. Dafür kommt derselbe Workflow für Training, Validierung, Vorhersage und Export zum Einsatz, den sie bereits von Erkennung, Segmentierung und Pose kennen – und eine Drittanbieterabhängigkeit weniger muss gepflegt werden.
Wenn du deinen Einsatz von Ultralytics YOLO26 Depth planst, solltest du einige wichtige Punkte beachten:
- Ultralytics YOLO Depth ist für RGB-Kameras ausgelegt. Jede Standardkamera eignet sich, darunter Webcams, Smartphones, Industriekameras und Drohnen. Andere Modalitäten wie LiDAR-Punktwolken, Radar, Sonar, Wärmebild- und Multispektralbänder sowie Mesh- und IFC-Daten liegen jedoch außerhalb des Eingabeformats des Modells.
- Metrische Entfernungen für Wahrnehmungsentscheidungen. Die Ausgabe ist eine tatsächliche Entfernung in Metern und eignet sich daher gut für Navigation, Abstandskontrolle und Überwachung. Für Anwendungen, die eine zertifizierte Toleranz erfordern, bleibt spezielle Messtechnik jedoch das richtige Instrument.
- Inferenz für jedes Bild einzeln. Die Tiefenschätzung wird für jedes Bild unabhängig ausgeführt, wie bei allen anderen Aufgaben von Ultralytics YOLO26. Sie lässt sich daher ohne Änderungen in eine vorhandene Pipeline zur bildweisen Verarbeitung integrieren. Die Auswertung einer Sequenz erfolgt weiterhin in deiner Anwendungsschicht.
- Ultralytics YOLO26-Depth liefert die besten Ergebnisse bei strukturierten, undurchsichtigen Oberflächen. Glas, Spiegel, stehendes Wasser, poliertes Metall und offener Himmel sind für jedes Verfahren mit nur einer Kamera grundsätzlich mehrdeutig. Deshalb solltest du das Modell mit Szenen testen, die für deine Umgebung repräsentativ sind.
Interessierst du dich für Vision-KI? Entdecke unsere Lizenzoptionen, um Computer Vision in deine Projekte einzubringen. Besuche unser GitHub-Repository, um das gesamte Spektrum der Aufgaben und Integrationen von Ultralytics kennenzulernen, und sieh dir die Ultralytics Platform an, um eigene durchgängige Workflows für Vision-KI zu erstellen.









