Ultralytics YOLO26 im Vergleich zu anderen Ultralytics YOLO-Modellen für die Posenschätzung
Entdecke, wie Ultralytics YOLO26 die Posenschätzung durch bessere Unterstützung für nichtmenschliche Schlüsselpunkte, schnellere Konvergenz, besseren Umgang mit Verdeckungen und eine effiziente Echtzeitbereitstellung verbessert.
Wenn du die Körperhaltung einer Person betrachtest, erkennst du leicht, ob sie sich krümmt, nach vorn lehnt oder aufrecht steht. Menschen verstehen schnell, wie verschiedene Körperteile zueinander in Beziehung stehen.
Das ist ein natürlicher Teil davon, wie wir Bewegungen und Körpersprache im Alltag deuten. Für Maschinen ist diese Art des visuellen Verständnisses jedoch nicht selbstverständlich. Einem System beizubringen, Bewegungen und Strukturen zu erkennen, erfordert fortschrittliche Deep-Learning- und Computer-Vision-Verfahren, mit denen es Bilder sinnvoll interpretieren kann.
Insbesondere die Posenschätzung ist eine Vision-AI-Technik, mit der ein Computer-Vision-Modell ein ähnliches Verständnis entwickeln kann. Anstatt lediglich ein Objekt in einem Bild zu erkennen, sagt das Modell Keypoints voraus, die wichtige strukturelle Orientierungspunkte darstellen.
Diese Keypoints können Gelenken eines Körpers, den Gliedmaßen eines Tiers, Maschinenteilen oder sogar festen Punkten wie den Ecken eines Spielfelds entsprechen. Durch die Erkennung und Verfolgung dieser Punkte kann das System Position, Ausrichtung und Bewegung auf strukturierte und messbare Weise erfassen.
Da die Posenschätzung auf immer mehr reale Anwendungsfälle übertragen wird, müssen Modelle nicht menschliche Keypoints, komplexe Szenen und benutzerdefinierte Datensätze besser verarbeiten. So unterstützen hochmoderne Modelle wie Ultralytics YOLO26 Computer-Vision-Aufgaben wie die Posenschätzung und bauen auf früheren YOLO-Pose-Modellen auf. Architekturelle und trainingsbezogene Verbesserungen sollen dabei die Flexibilität und die Gesamtleistung steigern.
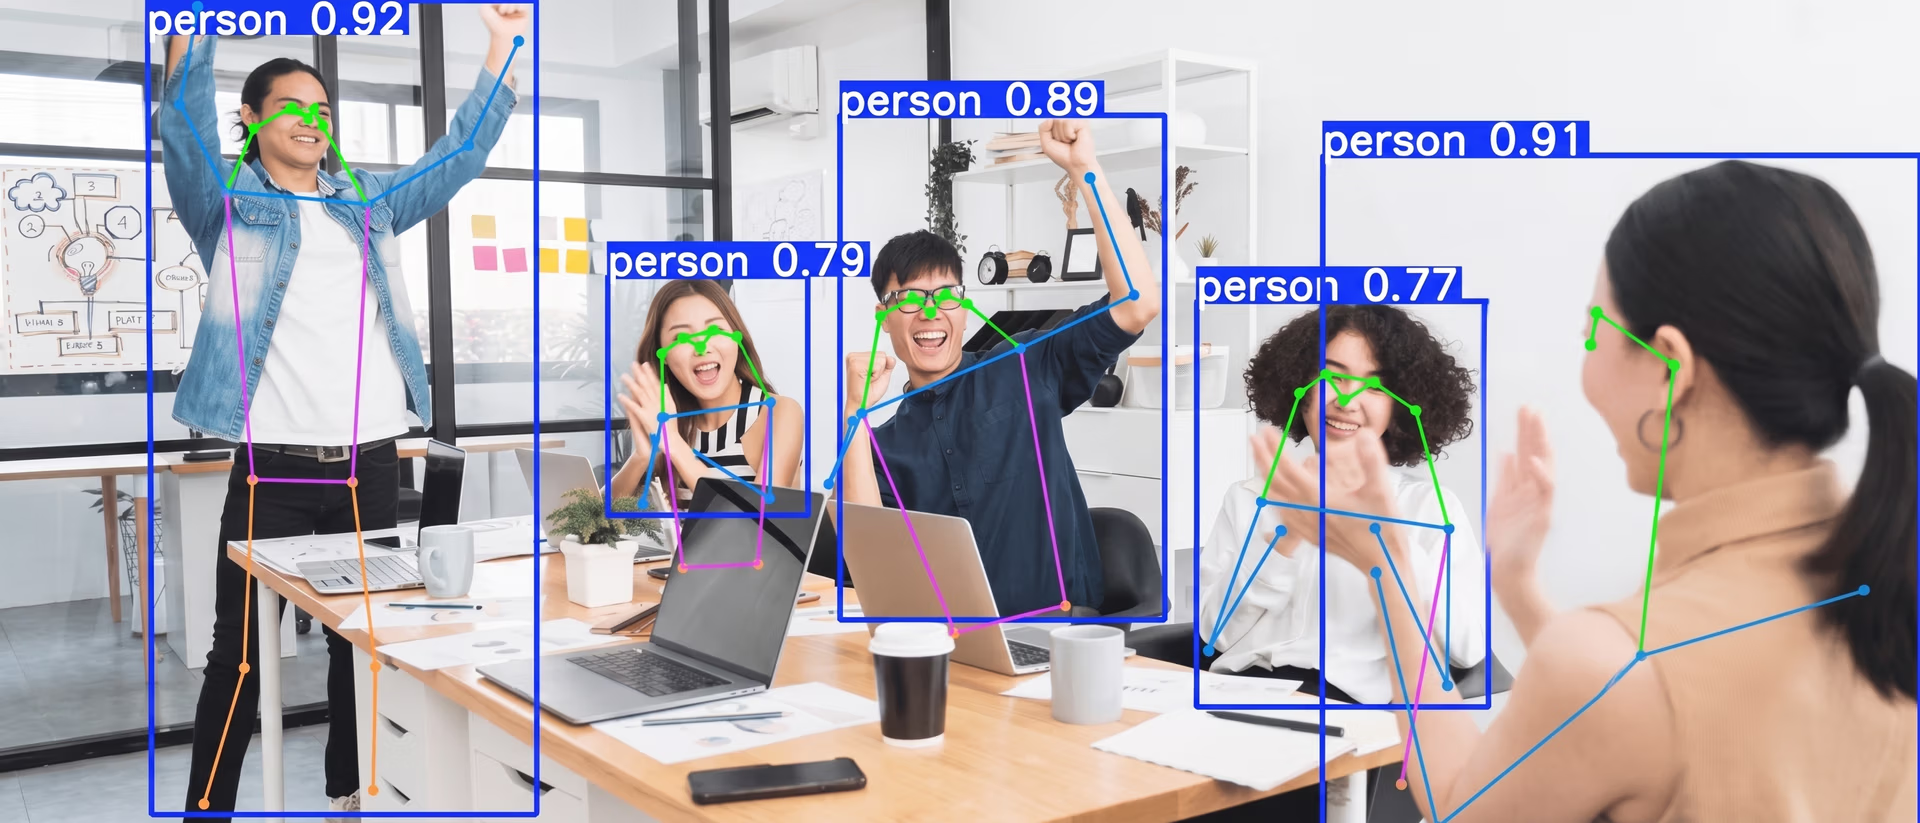
Abb. 1. Ein Beispiel für Posenschätzung mit YOLO (Quelle)
In diesem Artikel vergleichen wir YOLO26-pose mit früheren Ultralytics-YOLO-Pose-Modellen und sehen uns an, wie das Modell die Flexibilität, Konvergenzgeschwindigkeit und Leistung in komplexen Szenen verbessert. Los geht's!
Was ist Posenschätzung?#
Bevor wir uns mit dem Vergleich der Ultralytics-YOLO-Pose-Modelle befassen, sehen wir uns genauer an, was Posenschätzung im Kontext von Computer Vision bedeutet.
Posenschätzung ist ein Verfahren zur Erkennung und Verfolgung bestimmter Keypoints in einem Bild oder Videobild. Diese Keypoints können wichtige strukturelle Orientierungspunkte darstellen, etwa Gelenke eines menschlichen Körpers, Gliedmaßen eines Tiers, Maschinenteile oder feste Bezugspunkte in einer Szene.
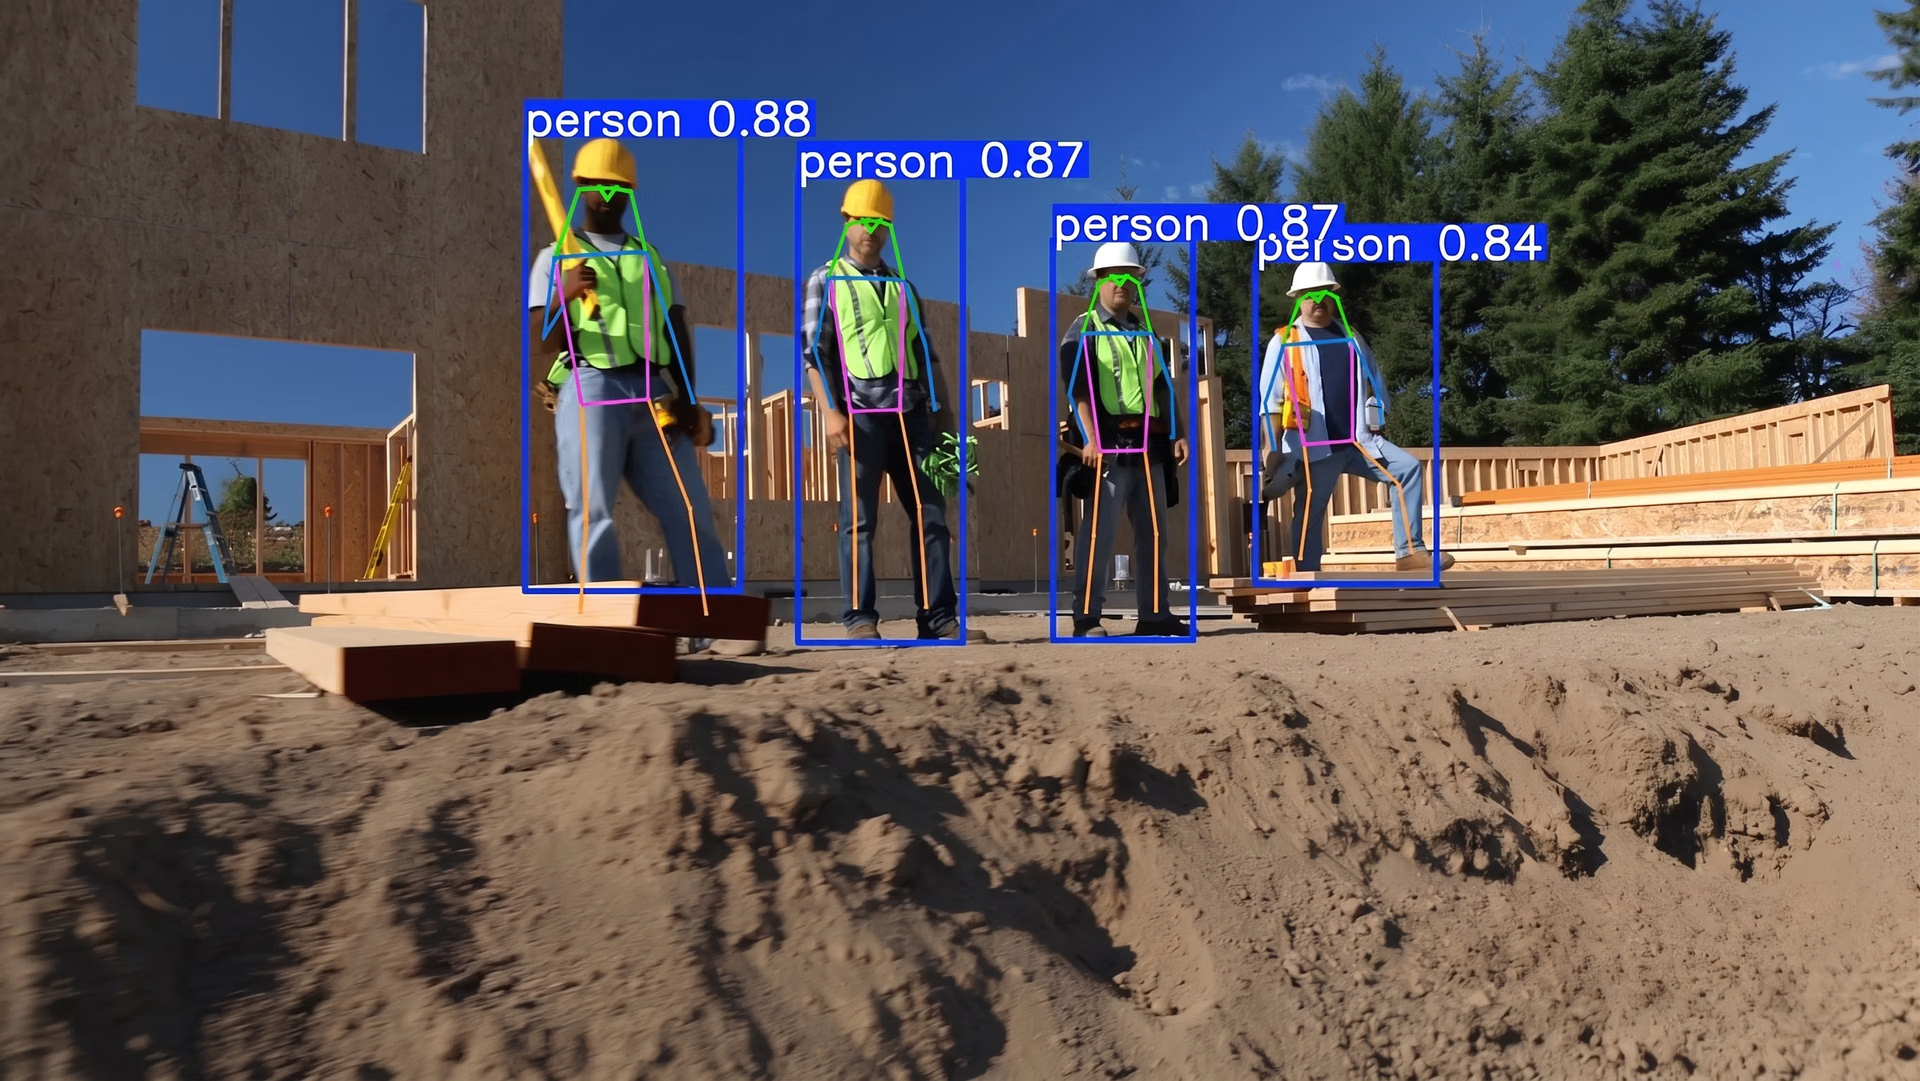
Abb. 2. Posen von Mitarbeitenden mithilfe der menschlichen Posenschätzung ermitteln (Quelle)
Indem ein Modell die Koordinaten dieser Punkte erkennt, kann es nachvollziehen, wie ein Objekt positioniert ist und wie es sich im Laufe der Zeit bewegt. Anders als die Bildklassifizierung, die einem ganzen Bild ein einziges Label zuweist, oder Objekterkennungsmodelle, die sich auf Bounding Boxes um Objekte konzentrieren, liefert die Posenschätzung genauere räumliche Informationen zu Struktur und Bewegung.
Überblick über Ultralytics YOLO26-pose#
YOLO26-pose ist in mehreren Modellvarianten beziehungsweise Modellgrößen erhältlich. Dazu gehören leichte Varianten wie YOLO26n-pose sowie größere Modelle wie YOLO26m-pose, YOLO26l-pose und YOLO26x-pose. So können Teams je nach Hardware und Leistungsanforderungen die passende Balance zwischen Geschwindigkeit und Genauigkeit wählen.
Ultralytics stellt außerdem vortrainierte Pose-Modelle bereit, die mit großen, allgemeinen Datensätzen wie COCO trainiert wurden. Dazu gehören insbesondere die COCO-Pose-Annotationen (COCO-Keypoints) zur Schätzung menschlicher Posen, sodass du nicht von Grund auf beginnen musst. In den meisten Fällen passen Teams diese Modelle mit ihren eigenen Datensätzen an bestimmte Keypoints, Anordnungen oder Umgebungen an.
Dazu müssen in der Regel benutzerdefinierte Annotationsdateien vorbereitet werden, in denen Keypoint-Koordinaten und Klassenlabels in einem strukturierten Format festgelegt sind. Diese Annotationen ordnen Keypoints bestimmten Pixelkoordinaten in jedem Bild zu, sodass das Modell während des Trainings präzise räumliche Beziehungen lernen kann.
Vortrainierte Modelle beschleunigen das Training, verringern den Datenbedarf und helfen dabei, Projekte effizienter in die Produktion zu überführen.
Anwendungen der menschlichen Posenschätzung in der Praxis#
Hier sind einige Beispiele aus der Praxis, bei denen die Posenschätzung eine wichtige Rolle spielt:
- Gesundheitswesen und Rehabilitation: Medizinisches Fachpersonal kann Pose-Modelle einsetzen, um die Körperhaltung zu beurteilen, den Genesungsfortschritt zu überwachen und Bewegungsmuster während der Physiotherapie zu analysieren.
- Autonome Systeme: Drohnen und intelligente Kameras können Pose-Informationen nutzen, um die Ausrichtung und Bewegung von Objekten in dynamischen Szenen besser zu verstehen.
- Arbeitssicherheit: Unternehmen können Körperhaltungen und wiederkehrende Bewegungen überwachen, um mögliche Sicherheitsrisiken zu erkennen.
- Fitness und Personal Training: Fitness-Apps nutzen Posenschätzung, um die Ausführung von Übungen zu verfolgen, Wiederholungen zu zählen und während Fitnessanleitungen in Echtzeit Rückmeldungen zu Körperhaltung und Bewegung zu geben.
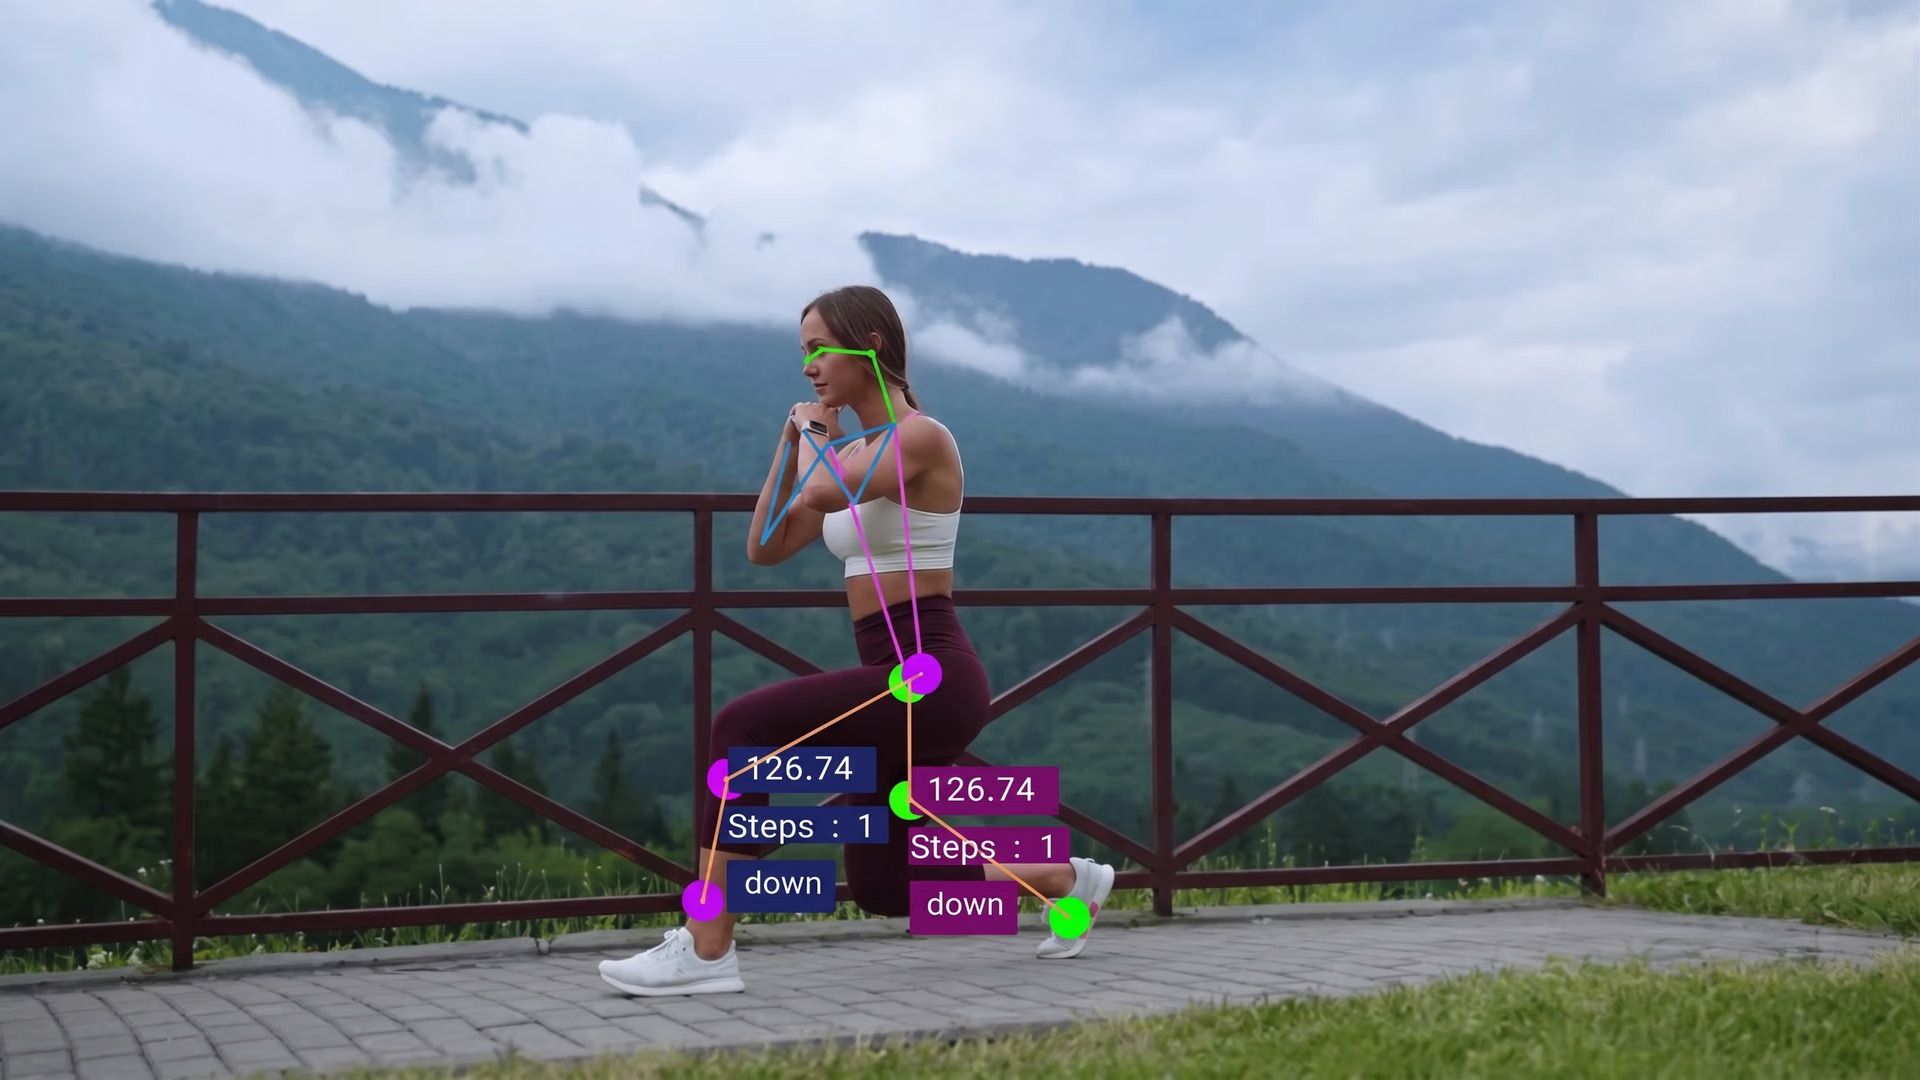
Abb. 3. Posenschätzung kann helfen, wichtige Körperpunkte während einer sportlichen Bewegung zu verfolgen. (Quelle)
Die Unterstützung der Posenschätzung durch Ultralytics YOLO26#
Ultralytics YOLO26 baut auf früheren Ultralytics-YOLO-Modellen auf und bietet Aktualisierungen, die Training und Bereitstellung praxistauglicher machen sollen.
Wie frühere Versionen unterstützt es die Posenschätzung als Teil eines einheitlichen Frameworks. Der wesentliche Unterschied besteht darin, dass Ultralytics YOLO26 flexibler und stabiler für ein breiteres Spektrum realer Anwendungsfälle ausgelegt ist.
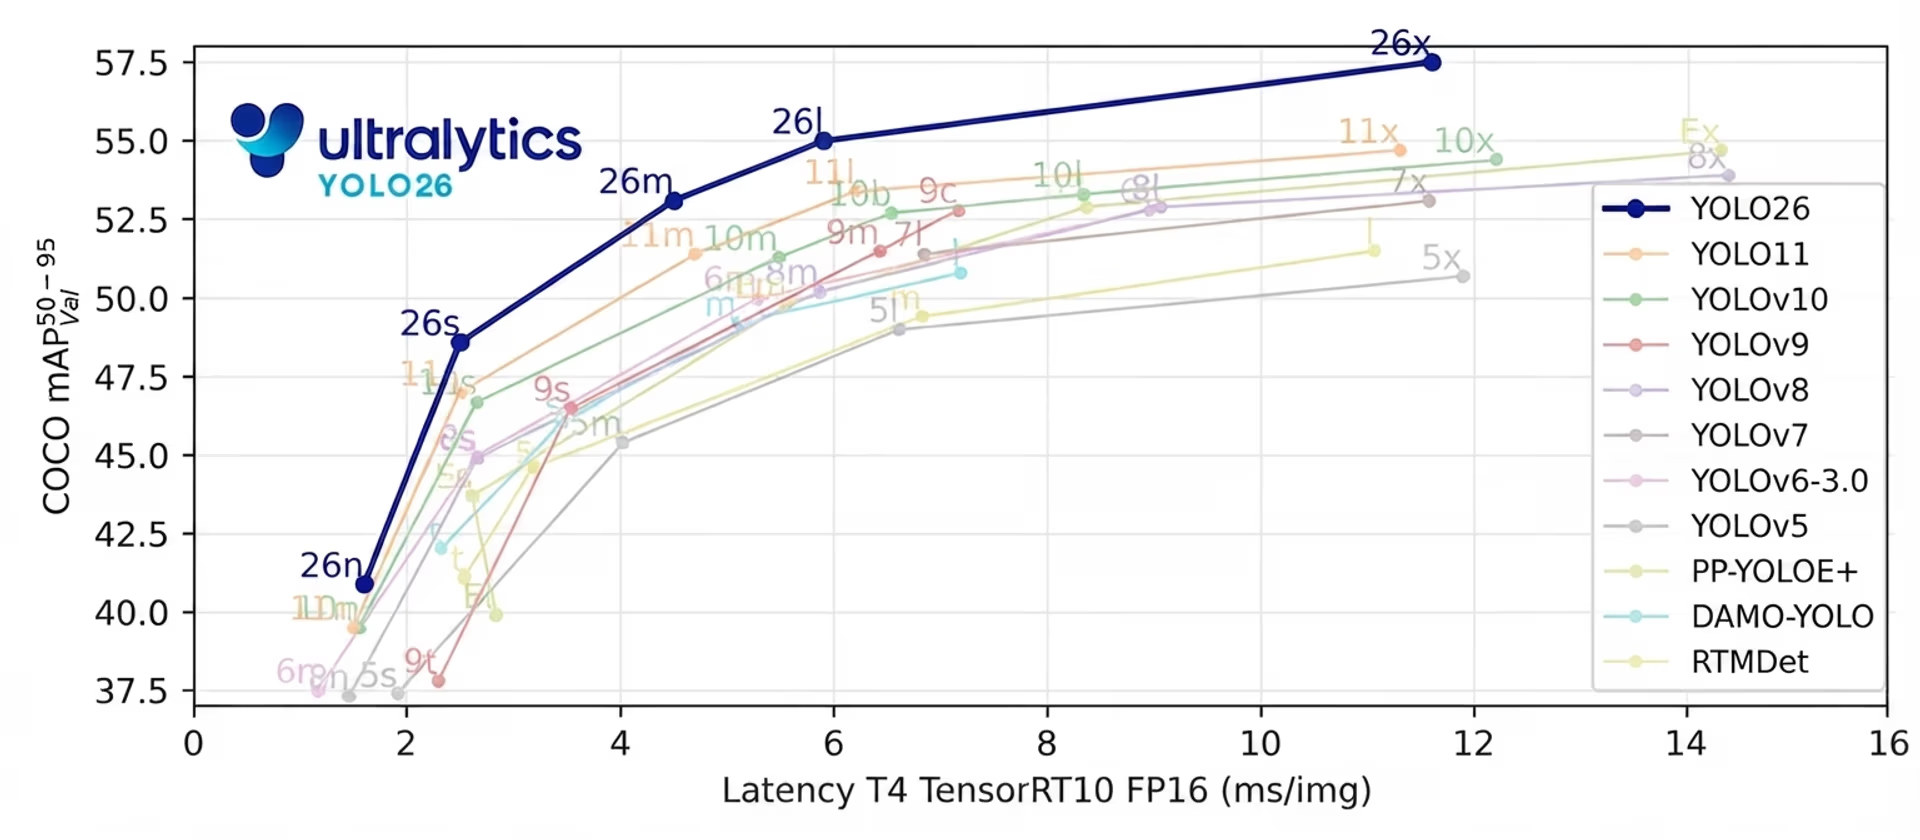
Abb. 4. YOLO26 im Benchmark (Quelle)
Frühere Ultralytics-YOLO-Pose-Modelle wurden stark von menschlichen Posendatensätzen beeinflusst. Dadurch waren Teile der älteren Verfahren auf die Gelenkstrukturen von Menschen optimiert. YOLO26 macht keine solchen menschenbezogenen Annahmen.
Dadurch eignet sich das Modell besser für nicht menschliche Keypoints, etwa zur Erkennung der Ecken eines Tennisplatzes oder anderer benutzerdefinierter struktureller Orientierungspunkte. Das ist bedeutsam, weil vortrainierte Ultralytics-YOLO26-pose-Modelle standardmäßig mit Datensätzen wie COCO-pose trainiert werden und die in den Datensatzannotationen definierten menschlichen Keypoints vorhersagen.
Wenn Teams jedoch andere Arten von Orientierungspunkten erkennen möchten, etwa Maschinenteile, Markierungen auf Sportfeldern oder Punkte an Infrastruktur, muss das Modell in der Regel mit einem benutzerdefinierten Datensatz angepasst werden, in dem diese spezifischen Keypoints annotiert sind.
Da Ultralytics YOLO26 nicht an Annahmen über menschliche Gelenkstrukturen gebunden ist, lässt es sich beim Feinabstimmen effektiver anpassen. Dank dieser Flexibilität kann das Modell benutzerdefinierte Keypoint-Anordnungen zuverlässiger erlernen. Das führt zu besseren Bewertungsmetriken bei der Validierung anhand von Datensätzen mit individuellen Keypoint-Konfigurationen.
Ultralytics YOLO26-pose ist außerdem darauf ausgelegt, die Lokalisierung von Keypoints zu verbessern, wenn Teile eines Objekts teilweise verdeckt sind oder in sehr kleinem Maßstab erscheinen. In realen Szenen mit weit entfernten Motiven, Drohnenaufnahmen oder kleinen Objekten kann dies im Vergleich zu früheren Pose-Modellen zu genaueren Keypoint-Vorhersagen führen.
Eine weitere wichtige Neuerung ist die verbesserte Loss-Formulierung, die während des Trainings verwendet wird. Die Loss-Funktion bestimmt, wie das Modell seine Fehler während des Lernens korrigiert.
Bei Ultralytics YOLO26-pose ist dieser Prozess effektiver. Dadurch kann das Modell schneller lernen und mit weniger Epochen eine hohe Genauigkeit erreichen. Eine Epoche bezeichnet dabei einen vollständigen Durchlauf durch den Trainingsdatensatz.
Insgesamt baut YOLO26-pose auf früheren Ultralytics YOLO-Posemodellen auf und bietet deutlichere Verbesserungen bei der Unterstützung nicht-menschlicher Keypoints und der Konvergenz des Trainings, während der vertraute Arbeitsablauf erhalten bleibt.
YOLO26-pose im Vergleich zu Ultralytics YOLOv5#
Die erste Version der Ultralytics YOLO-Modelle, Ultralytics YOLOv5, wurde hauptsächlich für die Objekterkennung entwickelt. YOLOv5 wurde später zwar um die Instanzsegmentierung erweitert, umfasst aber keinen nativen, spezialisierten Pose-Schätzungskopf im offiziellen Ultralytics-Framework.
Teams, die Keypoint-Erkennung benötigten, griffen üblicherweise auf separate Implementierungen oder individuelle Anpassungen zurück. Ultralytics YOLO26 umfasst Pose-Schätzung als integrierte Aufgabe und verfügt über einen speziellen Architekturkopf, der eigens für die Vorhersage von Keypoints entwickelt wurde.
Das bedeutet, dass Ultralytics YOLO26-pose-Modelle im selben einheitlichen Arbeitsablauf wie Modelle für Erkennung und Segmentierung trainiert, validiert und bereitgestellt werden können. Für Projekte mit Schwerpunkt auf strukturierter Keypoint-Erkennung bietet YOLO26 native Unterstützung für Pose-Schätzung und eine aufgabenspezifische Architektur, die YOLOv5 standardmäßig nicht bietet.
Wichtige Unterschiede: YOLO26-pose im Vergleich zu Ultralytics YOLOv8-pose#
Ultralytics YOLOv8 führte die native Pose-Schätzung im einheitlichen Ultralytics-Framework ein. Dadurch lassen sich Keypoint-Modelle ganz einfach mit demselben Arbeitsablauf wie Modelle für Erkennung und Segmentierung trainieren und bereitstellen. Das Modell nutzt eine herkömmliche Nachverarbeitungspipeline mit Non-Maximum Suppression (NMS) sowie frühere Verlustfunktionen für die BBox-Regression und das Training.
Ultralytics YOLO26 baut auf dieser Grundlage auf und bietet Architektur- und Trainingsaktualisierungen, die sich direkt auf die Pose-Schätzung auswirken. Ein wesentlicher Unterschied ist das durchgängige Design. YOLO26 macht bei der Inferenz eine externe NMS überflüssig, was die Bereitstellung vereinfacht und die Latenz konsistenter macht, insbesondere auf CPUs und Edge-Geräten.
Eine weitere wichtige Verbesserung betrifft die Trainingsmethodik. Ultralytics YOLO26 führt den MuSGD-Optimierer sowie aktualisierte Verluststrategien ein. Bei Pose-Aufgaben integriert das Modell die Residual Log-Likelihood Estimation, wodurch die Unsicherheit von Keypoints besser modelliert wird. Zusammengenommen können diese Änderungen zu schnellerer Konvergenz und stabileren Keypoint-Vorhersagen führen, besonders in komplexen oder teilweise verdeckten Szenen.
Kurz gesagt: Ultralytics YOLOv8-pose etablierte eine leistungsstarke und vielseitige Grundlage. YOLO26-pose verbessert diese Grundlage durch effizienteres Training, einen besseren Umgang mit Verdeckungen und mehr Flexibilität für Pose-Anwendungen mit nicht-menschlichen Motiven in der Praxis.
YOLO26-pose im Vergleich zu Ultralytics YOLO11-pose: Was hat sich verbessert?#
Ultralytics YOLO11 baut auf Ultralytics YOLOv8 auf und verfeinert das Backbone sowie die Merkmalsextraktionsschichten. Das Modell reduzierte die FLOPs, verbesserte die Parametereffizienz und erzielte bei weiterhin starker Echtzeitleistung einen höheren mAP. Bei Pose-Aufgaben bedeutete dies eine präzisere Keypoint-Erkennung mit einer leichteren Architektur.
YOLO26-pose setzt diese Entwicklung mit einem grundlegenderen Architekturwechsel fort. Einfach gesagt: YOLO11 verbesserte die Effizienz und Genauigkeit von YOLOv8, und YOLO26 baut auf dieser Grundlage mit Architektur- und Trainingsaktualisierungen auf, die auf schnellere Konvergenz, stabilere Inferenz und präzisere Pose-Schätzung in komplexen Szenarien abzielen.
Warum solltest du für die Pose-Schätzung mit dem Ultralytics YOLO26-Modell beginnen?#
Wenn du die Unterschiede zwischen den Ultralytics YOLO-Modellen erkundest, fragst du dich vielleicht, ob du zu YOLO26-pose wechseln solltest.
Die kurze Antwort: Das Upgrade ist einfach. Wenn du bereits Ultralytics YOLOv8-pose oder Ultralytics YOLO11-pose verwendest, musst du beim Wechsel zu YOLO26-pose normalerweise nur die Modellversion ändern und nicht deine Pipeline neu aufbauen.
Du profitierst von besserer Unterstützung für nicht-menschliche Keypoints, schnellerer Konvergenz während des Trainings und einem verbesserten Umgang mit verdeckten Punkten – und bleibst dabei im selben Ultralytics-Framework. Für die meisten neuen und bestehenden Pose-Projekte ist der Wechsel zu YOLO26-pose eine einfache Möglichkeit, diese Verbesserungen mit minimalem Aufwand zu nutzen.
Darüber hinaus wird YOLO26-pose vollständig im Ultralytics Python-Paket unterstützt, das auf PyTorch basiert und Training, Validierung und Bereitstellung vereinfacht. Modelle lassen sich in Formate wie ONNX, TensorRT, OpenVINO, CoreML und TFLite exportieren. So kannst du sie einfacher auf GPUs, CPUs und Edge-Geräten bereitstellen, ohne deinen gesamten Arbeitsablauf zu ändern.
Die wichtigsten Erkenntnisse#
Ultralytics YOLO26-pose macht die Pose-Schätzung flexibler und zuverlässiger, insbesondere bei nicht-menschlichen Keypoints oder komplexen Szenen. Das Modell trainiert schneller, kommt besser mit Verdeckungen zurecht und liefert über verschiedene Datensätze hinweg konsistentere Ergebnisse. Für Teams, die bereits Ultralytics YOLO-Posemodelle verwenden, bietet YOLO26 klare Verbesserungen, ohne bestehende Arbeitsabläufe zu ändern.
Möchtest du mehr über KI erfahren? Sieh dir unsere Community und unser GitHub-Repository an. Entdecke unsere Lösungsseiten zu KI in der Robotik und Computer Vision in der Landwirtschaft. Informiere dich über unsere Lizenzmodelle und fang noch heute an, mit Computer Vision zu entwickeln!









