Comparación de Ultralytics YOLO11 con modelos YOLO anteriores
Compara Ultralytics YOLOv8, YOLOv9, YOLOv10 y Ultralytics YOLO11 por sus funciones, resultados en COCO y pruebas de vídeo para ver cómo evolucionó YOLO entre 2023 y 2024.
 Abirami Vina12 min de lectura

Desde automatizar tareas cotidianas hasta ayudar a tomar decisiones fundamentadas en tiempo real, la inteligencia artificial (IA) está transformando el futuro de diversos sectores. Una de las áreas más fascinantes de la IA es la visión artificial, también conocida como IA visual. Su objetivo es permitir que las máquinas analicen e interpreten datos visuales como lo hacen las personas.
En concreto, los modelos de visión artificial impulsan innovaciones que mejoran tanto la seguridad como la eficiencia. Por ejemplo, estos modelos se utilizan en coches autónomos para detectar peatones y en cámaras de seguridad para vigilar instalaciones las 24 horas del día.
Algunos de los modelos de visión artificial más conocidos son los modelos YOLO (Solo se mira una vez), famosos por su capacidad para detectar objetos en tiempo real. Con el tiempo, los modelos YOLO han mejorado y cada nueva versión ofrece un rendimiento superior y más flexibilidad.
Las versiones más recientes, como Ultralytics YOLO11, pueden realizar diversas tareas, como la segmentación de instancias, la clasificación de imágenes, la estimación de pose y el seguimiento de múltiples objetos, con más precisión, velocidad y exactitud que nunca.
En este artículo, compararemos Ultralytics YOLOv8, YOLOv9, YOLOv10 y Ultralytics YOLO11 para entender mejor cómo han evolucionado estos modelos. Analizaremos sus características principales, los resultados de las pruebas de rendimiento y las diferencias de rendimiento.
Introducción a Ultralytics YOLOv8#
Ultralytics lanzó YOLOv8 el 10 de enero de 2023, un importante avance respecto a los modelos YOLO anteriores. Está optimizado para ofrecer una detección precisa en tiempo real y combina enfoques probados con nuevas mejoras para obtener mejores resultados.
Además de la detección de objetos, también admite estas tareas de visión artificial: segmentación de instancias, clasificación de imágenes, estimación de pose y detección con cajas delimitadoras orientadas (OBB). Otra característica importante de Ultralytics YOLOv8 es que está disponible en cinco variantes de modelo: Nano, Small, Medium, Large y X. Así puedes elegir el equilibrio adecuado entre velocidad y precisión según tus necesidades.
Gracias a su versatilidad y a su alto rendimiento, Ultralytics YOLOv8 puede utilizarse en muchas aplicaciones del mundo real, como sistemas de seguridad, ciudades inteligentes, sanidad y automatización industrial.

Fig. 1. Gestión del aparcamiento en ciudades inteligentes con YOLOv8.
Características principales de Ultralytics YOLOv8#
Estas son algunas de las otras características principales de Ultralytics YOLOv8:
- Arquitectura de detección mejorada: Ultralytics YOLOv8 utiliza una red troncal CSPDarknet mejorada. Esta red está optimizada para la extracción de características, es decir, el proceso de identificar y capturar patrones o detalles importantes de las imágenes de entrada que ayudan al modelo a realizar predicciones precisas.
- Cabezal de detección: utiliza un diseño desacoplado y sin anclajes, lo que significa que no depende de formas predefinidas de cajas delimitadoras (anclajes), sino que aprende a predecir directamente la ubicación de los objetos. Gracias a su diseño desacoplado, las tareas de clasificar qué es un objeto y predecir dónde está (regresión) se gestionan por separado, lo que ayuda a mejorar la precisión y acelerar el entrenamiento.
- Equilibrio entre precisión y velocidad: este modelo alcanza una gran precisión y mantiene tiempos de inferencia rápidos, por lo que es adecuado tanto para entornos en la nube como para dispositivos edge.
- Fácil de usar: YOLOv8 está diseñado para que empezar sea sencillo. Puedes empezar a hacer predicciones y ver los resultados en unos minutos con el paquete de Python de Ultralytics.
YOLOv9 se centra en la eficiencia computacional#
YOLOv9 fue lanzado el 21 de febrero de 2024 por Chien-Yao Wang y Hong-Yuan Mark Liao, del Instituto de Ciencias de la Información de la Academia Sinica de Taiwán. Admite tareas como la detección de objetos y la segmentación de instancias.
Este modelo se basa en Ultralytics YOLOv5 e incorpora dos innovaciones importantes: la información de gradiente programable (PGI) y la red de agregación de capas eficiente generalizada (GELAN).
PGI ayuda a YOLOv9 a conservar información importante mientras procesa los datos a través de sus capas, lo que se traduce en resultados más precisos. Por su parte, GELAN mejora el uso que el modelo hace de sus capas, aumentando el rendimiento y la eficiencia computacional. Gracias a estas mejoras, YOLOv9 puede realizar tareas en tiempo real en dispositivos periféricos y aplicaciones móviles, donde los recursos informáticos suelen ser limitados.

Fig. 2. Cómo GELAN mejora la precisión de YOLOv9.
Características principales de YOLOv9#
Estas son algunas de las otras características principales de YOLOv9:
- Alta precisión y eficiencia: YOLOv9 ofrece una gran precisión de detección sin consumir muchos recursos informáticos, por lo que es una opción excelente cuando los recursos son limitados.
- Modelos ligeros: las variantes ligeras de YOLOv9 están optimizadas para su implementación en dispositivos edge y móviles.
- Fácil de usar: el paquete de Python de Ultralytics es compatible con YOLOv9, por lo que resulta sencillo configurarlo y ejecutarlo en distintos entornos, tanto si trabajas con código como con la línea de comandos.
YOLOv10 permite detectar objetos sin NMS#
Investigadores de la Universidad de Tsinghua presentaron YOLOv10 el 23 de mayo de 2024, centrándose en la detección de objetos en tiempo real. El modelo aborda las limitaciones de las versiones anteriores de YOLO al eliminar la necesidad de la supresión no máxima (NMS), un paso de posprocesamiento utilizado para eliminar detecciones duplicadas, y perfeccionar el diseño general del modelo. Esto permite detectar objetos con mayor rapidez y eficiencia sin renunciar a una precisión de vanguardia.
Una parte fundamental de lo que lo hace posible es un método de entrenamiento conocido como asignaciones coherentes de etiquetas duales. Combina dos estrategias: una permite que varias predicciones aprendan del mismo objeto (de muchos a uno) y otra se centra en elegir la mejor predicción única (de uno a uno). Como ambas estrategias siguen las mismas reglas de correspondencia, el modelo aprende a evitar las duplicaciones por sí solo, por lo que no se necesita NMS.

Fig. 3. YOLOv10 utiliza asignaciones coherentes de etiquetas duales para entrenar sin NMS.
La arquitectura de YOLOv10 también utiliza una red troncal CSPNet mejorada para aprender características de forma más eficaz y un cuello PAN (red de agregación de rutas) que combina información de distintas capas, lo que mejora la detección de objetos tanto pequeños como grandes. Estas mejoras permiten utilizar YOLOv10 en aplicaciones del mundo real en los sectores de la fabricación, el comercio minorista y la conducción autónoma.
Características principales de YOLOv10#
Estas son algunas de las otras características más destacadas de YOLOv10:
- Convoluciones con núcleos grandes: el modelo utiliza convoluciones con núcleos grandes para captar más contexto de zonas más amplias de la imagen, lo que le ayuda a comprender mejor la escena en su conjunto.
- Módulos de autoatención parcial: el modelo incorpora módulos de autoatención parcial para centrarse en las partes más importantes de la imagen sin consumir demasiada potencia de cálculo, lo que mejora el rendimiento de forma eficiente.
- Variante de modelo única: además de los tamaños habituales de YOLOv10 —Nano, Small, Medium, Large y X—, también hay una versión especial llamada YOLOv10b (Balanced). Es un modelo más ancho, es decir, procesa más características en cada capa, lo que ayuda a mejorar la precisión y a mantener el equilibrio entre velocidad y tamaño.
- Fácil de usar: YOLOv10 es compatible con el paquete de Python de Ultralytics, por lo que es fácil de utilizar.
Ultralytics YOLO11: mayor velocidad y precisión#
El 30 de septiembre de 2024, Ultralytics presentó oficialmente YOLO11 en su evento híbrido anual, YOLO Vision 2024 (YV24).
Este lanzamiento incorporó mejoras importantes respecto a las versiones anteriores. Ultralytics YOLO11 es más rápido, más preciso y muy eficiente. Admite toda la gama de tareas de visión artificial que conocen los usuarios de YOLOv8, como la detección de objetos, la segmentación de instancias y la clasificación de imágenes. Además, mantiene la compatibilidad con los flujos de trabajo de YOLOv8, lo que facilita a los usuarios la transición a la nueva versión.
Además, Ultralytics YOLO11 está diseñado para adaptarse a una amplia variedad de necesidades informáticas, desde dispositivos periféricos ligeros hasta potentes sistemas en la nube. El modelo está disponible en versiones de código abierto y empresarial, por lo que se adapta a distintos casos de uso.
Es una excelente opción para tareas que requieren precisión, como el diagnóstico por imagen y la detección por satélite, así como para aplicaciones más amplias en vehículos autónomos, agricultura y sanidad.

Fig. 4. Uso de Ultralytics YOLO11 para detectar, contar y seguir el tráfico.
Características principales de Ultralytics YOLO11#
Estas son algunas de las otras características distintivas de Ultralytics YOLO11:
- Detección rápida y eficiente: Ultralytics YOLO11 cuenta con un cabezal de detección diseñado para reducir al mínimo la latencia y priorizar la velocidad en las capas de predicción finales sin comprometer el rendimiento.
- Extracción de características mejorada: una arquitectura optimizada de la red troncal y el cuello mejora la extracción de características y permite obtener predicciones más precisas.
- Implementación en distintas plataformas: Ultralytics YOLO11 está optimizado para ejecutarse de forma eficiente en dispositivos edge, plataformas en la nube y GPU de NVIDIA, lo que garantiza su adaptabilidad a distintos entornos.
Pruebas comparativas de modelos YOLO con el conjunto de datos COCO#
Al analizar distintos modelos, no siempre es fácil compararlos solo por sus características. Para eso sirven las pruebas comparativas. Si ejecutamos todos los modelos con el mismo conjunto de datos, podemos medir y comparar su rendimiento de forma objetiva. Veamos cómo rinde cada modelo con el conjunto de datos COCO.
Al comparar modelos YOLO, cada nueva versión incorpora mejoras notables en precisión, velocidad y flexibilidad. En concreto, YOLO11m supone un gran avance, ya que utiliza un 22 % menos de parámetros que YOLOv8m, lo que significa que es más ligero y rápido de ejecutar. Además, pese a su menor tamaño, alcanza una precisión media promedio (mAP) superior en el conjunto de datos COCO. Esta métrica mide la capacidad del modelo para detectar y localizar objetos, por lo que un mAP más alto indica predicciones más precisas.
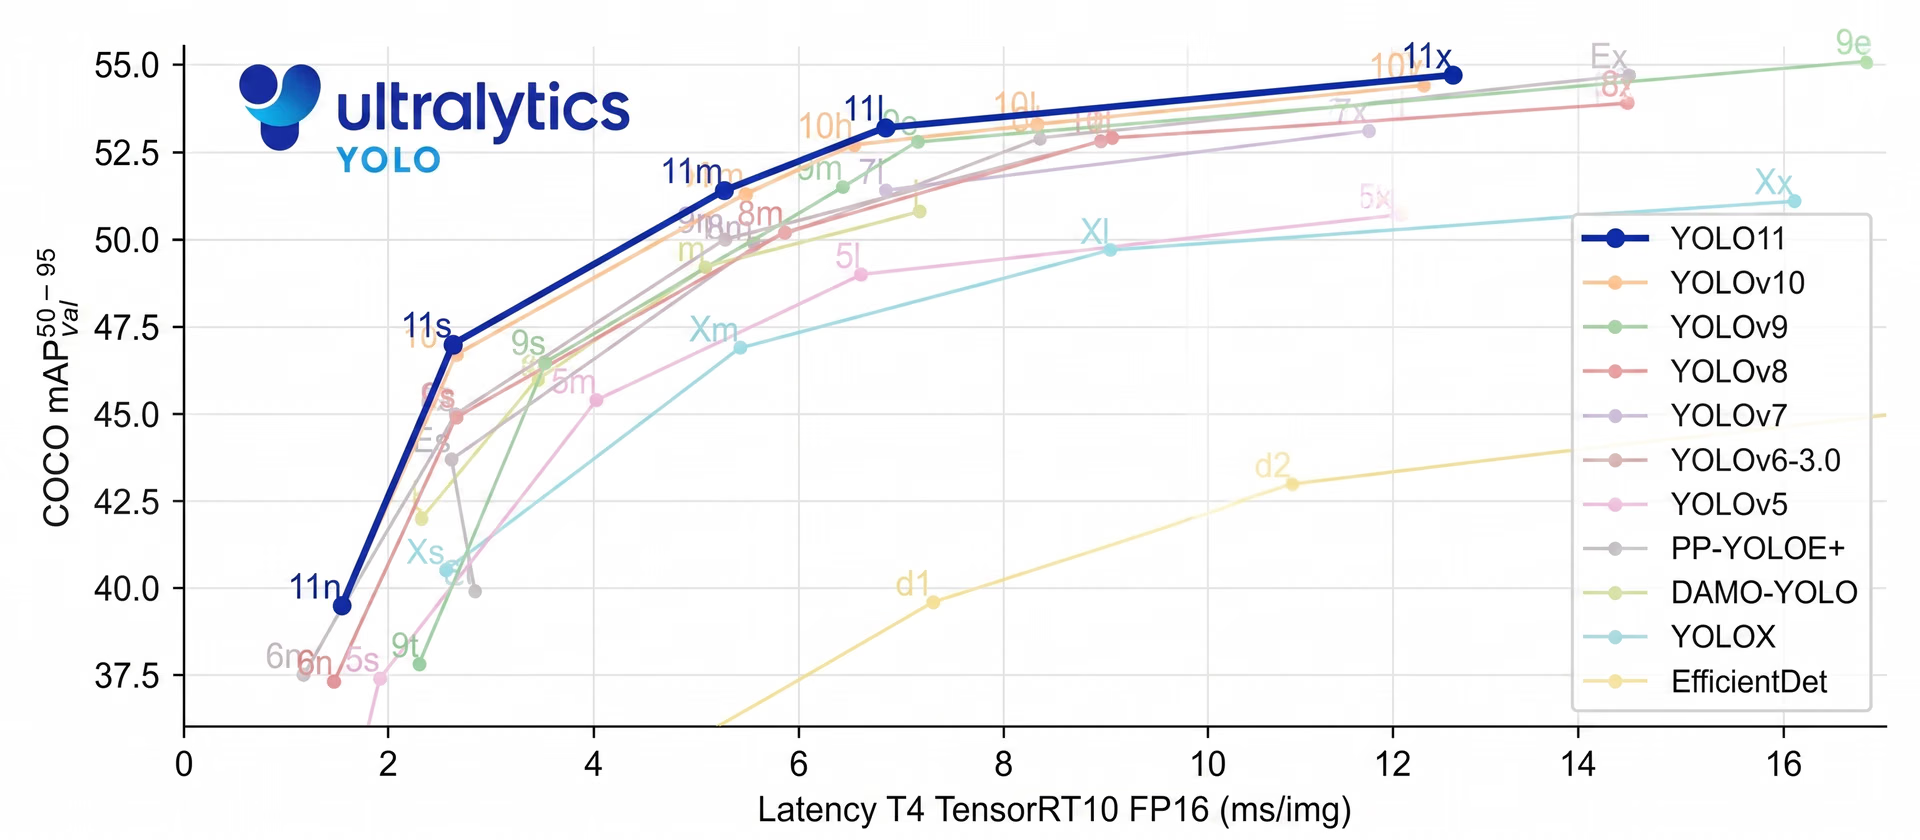
Fig. 5. Pruebas comparativas de YOLO11 y otros modelos YOLO con el conjunto de datos COCO.
Pruebas y comparación de modelos YOLO en un vídeo#
Veamos cómo rinden estos modelos en una situación real.
Para comparar YOLOv8, YOLOv9, YOLOv10 y YOLO11, los cuatro se ejecutaron con el mismo vídeo de tráfico, con una puntuación de confianza de 0,3 (el modelo solo muestra detecciones cuando tiene al menos un 30 % de confianza en haber identificado correctamente un objeto) y un tamaño de imagen de 640, para garantizar una evaluación justa. Los resultados de detección y seguimiento de objetos pusieron de manifiesto diferencias importantes en precisión, velocidad y exactitud de detección.
Desde el primer fotograma, YOLO11 detectó vehículos grandes, como camiones, que YOLOv10 no detectó. YOLOv8 y YOLOv9 ofrecieron un rendimiento aceptable, aunque variaba según las condiciones de iluminación y el tamaño de los objetos. Los vehículos más pequeños y lejanos siguieron siendo un reto para todos los modelos, aunque YOLO11 también mostró mejoras notables en esas detecciones.

Fig. 6. Comparación de YOLOv8, YOLOv9, YOLOv10 y YOLO11.
En cuanto a la velocidad, todos los modelos procesaron cada fotograma en entre 10 y 20 milisegundos, lo bastante rápido para realizar tareas en tiempo real a más de 50 FPS. Por un lado, Ultralytics YOLOv8 y YOLOv9 ofrecieron detecciones estables y fiables durante todo el vídeo. Curiosamente, YOLOv10, diseñado para reducir la latencia, fue más rápido, pero mostró algunas incoherencias al detectar ciertos tipos de objetos.
Por su parte, Ultralytics YOLO11 destacó por su precisión y ofreció un buen equilibrio entre velocidad y exactitud. Aunque ninguno de los modelos rindió a la perfección en todos los fotogramas, la comparación directa demostró claramente que YOLO11 ofreció el mejor rendimiento general.
¿Qué modelo YOLO es el mejor para las tareas de visión artificial?#
La elección de un modelo para un proyecto depende de sus requisitos específicos. Por ejemplo, algunas aplicaciones pueden dar prioridad a la velocidad, mientras que otras pueden necesitar más precisión o tener limitaciones de implementación que influyan en la decisión.
Otro factor importante es el tipo de tareas de visión artificial que necesitas resolver. Si buscas más flexibilidad para realizar distintas tareas, YOLOv8 y YOLO11 son buenas opciones.
La elección entre YOLOv8 y YOLO11 depende realmente de tus necesidades. YOLOv8 es una opción sólida si estás empezando en visión artificial y valoras una comunidad más amplia, más tutoriales y numerosas integraciones de terceros.
Por otro lado, si buscas más precisión y velocidad, Ultralytics YOLO11 es la mejor opción, aunque cuenta con una comunidad más pequeña y menos integraciones por ser una versión más reciente. Desde que se publicó esta comparación, Ultralytics ha lanzado Ultralytics YOLO26, que ahora es el modelo recomendado para proyectos nuevos.
Conclusiones clave#
Desde Ultralytics YOLOv8 hasta Ultralytics YOLO11, la evolución de la serie de modelos YOLO refleja un impulso constante hacia modelos de visión artificial más inteligentes. Cada versión de YOLO incorpora mejoras importantes en velocidad, precisión y exactitud.
A medida que avanza la visión artificial, estos modelos ofrecen soluciones fiables para desafíos del mundo real, desde la detección de objetos hasta los sistemas autónomos. El desarrollo continuo de los modelos YOLO demuestra cuánto ha avanzado este campo y todo lo que aún podemos esperar en el futuro.
Para aprender más sobre IA, visita nuestro repositorio de GitHub y participa en nuestra comunidad. Descubre los avances en distintos sectores, desde la IA visual en la fabricación hasta la visión artificial en la sanidad. Echa un vistazo a nuestras opciones de licencia para empezar hoy mismo tus proyectos de IA visual.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









