Descubre el aprendizaje por conjuntos y su papel en la IA y el ML
Descubre cómo el aprendizaje por conjuntos mejora el rendimiento de los modelos de IA mediante técnicas como bagging, boosting y stacking para ofrecer predicciones más precisas y estables.
Para ver una explicación visual de los conceptos tratados en este artículo, mira el vídeo que aparece a continuación.
Las innovaciones de IA, como los motores de recomendación y los sistemas de detección de fraude, se basan en algoritmos y modelos de aprendizaje automático para hacer predicciones y tomar decisiones a partir de datos. Estos modelos pueden identificar patrones, prever tendencias y ayudar a automatizar tareas complejas.
Sin embargo, puede que un solo modelo no consiga captar todos los detalles de los datos del mundo real. Puede funcionar bien en algunos casos y quedarse corto en otros, por ejemplo, si un modelo de detección de fraude no detecta nuevos tipos de transacciones.
Esta limitación es un problema al que suelen enfrentarse los ingenieros de IA al crear e implementar modelos de aprendizaje automático. Algunos modelos sufren sobreajuste al aprender demasiado fielmente los datos de entrenamiento, mientras que otros sufren subajuste al pasar por alto patrones importantes. El aprendizaje por conjuntos es una técnica de IA que ayuda a abordar estos retos al combinar varios modelos, conocidos como aprendices base, en un único sistema más potente.
Puedes imaginarlo como un equipo de expertos que colabora para resolver un problema. En este artículo veremos qué es el aprendizaje por conjuntos, cómo funciona y dónde se puede utilizar. ¡Empecemos!
¿Qué es el aprendizaje por conjuntos?#
El aprendizaje por conjuntos engloba un conjunto de técnicas que combinan varios modelos para resolver el mismo problema y obtener un único resultado mejorado. Se puede aplicar tanto al aprendizaje supervisado (en el que los modelos aprenden a partir de datos etiquetados) como al aprendizaje no supervisado (en el que los modelos encuentran patrones en datos sin etiquetar).
En lugar de depender de un único modelo para hacer predicciones, un conjunto utiliza varios modelos, cada uno de los cuales analiza los datos a su manera. Al combinar sus resultados, se suele obtener una solución más precisa, estable y capaz de generalizar mejor que la que podría lograr cualquier modelo por sí solo.
Puedes compararlo con un panel de analistas que aborda el mismo problema. Cada analista o modelo individual interpreta los datos de forma distinta.
Uno puede centrarse en los patrones, otro en las anomalías y otro en el contexto. Al combinar sus perspectivas, el grupo puede tomar una decisión más equilibrada y fiable que el juicio de cualquiera de sus integrantes.
Este enfoque también ayuda a abordar dos de los mayores retos del aprendizaje automático: el sesgo y la varianza. Un modelo con un sesgo elevado es demasiado simple y pasa por alto patrones importantes, mientras que uno con una varianza elevada es excesivamente sensible y se ajusta demasiado a los datos de entrenamiento. Al combinar modelos, el aprendizaje por conjuntos equilibra ambos factores y mejora el rendimiento del sistema con datos nuevos que no ha visto antes.
Comprender cómo funciona el aprendizaje por conjuntos#
Cada modelo de un conjunto se conoce como aprendiz base o modelo base. Puede ser un algoritmo del mismo tipo o una combinación de distintos algoritmos, según la técnica de conjunto que se utilice.
Estos son algunos ejemplos habituales de los distintos modelos que se utilizan en el aprendizaje por conjuntos:
- Árboles de decisión: Estos modelos dividen los datos en ramas según los valores de las características para tomar decisiones. Por ejemplo, en problemas de clasificación como predecir si un cliente comprará un producto, tienen en cuenta factores como la edad, los ingresos y el historial de navegación.
- Redes neuronales: Inspiradas en la forma en que el cerebro humano procesa la información, constituyen la arquitectura básica de la mayoría de los modelos modernos de IA y aprendizaje automático.
- Máquinas de vectores de soporte (SVMs): Estos algoritmos clasifican los datos buscando un límite de decisión óptimo, llamado hiperplano, que maximiza el margen entre las distintas clases. En otras palabras, la SVM traza la mejor línea posible para separar los grupos y dejar el mayor espacio posible entre ellos. Por ejemplo, puede utilizarse para determinar si un correo electrónico es spam a partir de patrones como la frecuencia y la estructura de las palabras.
- Modelos de regresión logística: Estiman probabilidades y suelen utilizarse en tareas de clasificación binaria. Un ejemplo habitual es predecir si una transacción es fraudulenta o legítima.
Un conjunto de modelos combinado suele denominarse aprendiz fuerte porque integra los puntos fuertes de los aprendices base (también llamados modelos débiles) y minimiza sus puntos débiles. Para ello, combina las predicciones de cada modelo de forma estructurada: utiliza votación mayoritaria en tareas de clasificación y promedios ponderados en tareas de regresión, con el fin de obtener un resultado final más preciso.
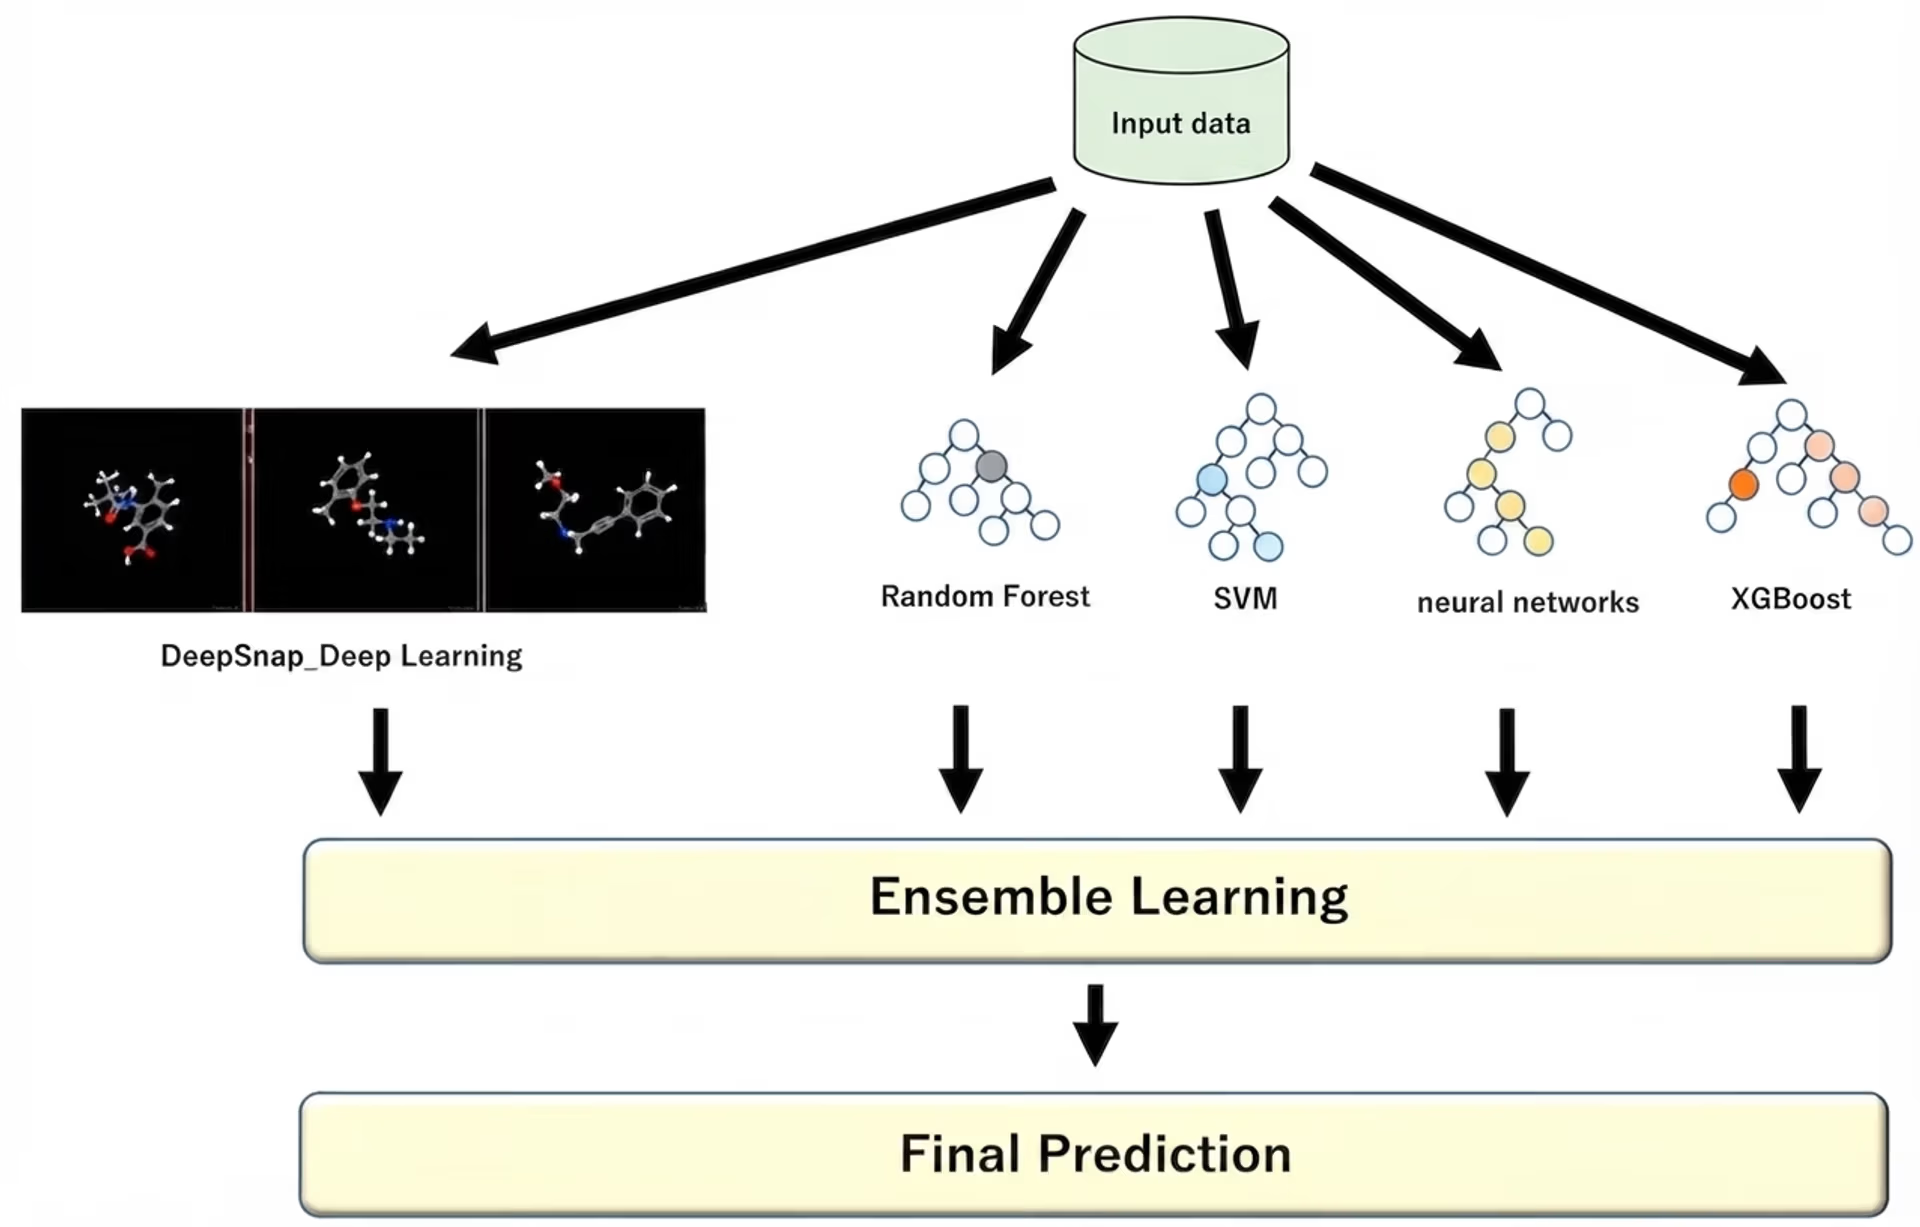
Fig. 1. Un ejemplo de aprendizaje por conjuntos (fuente)
Cuándo utilizar el aprendizaje por conjuntos#
Antes de profundizar en las distintas técnicas de aprendizaje por conjuntos, demos un paso atrás y veamos cuándo conviene utilizar este tipo de enfoque en un proyecto de aprendizaje automático o IA.
El aprendizaje por conjuntos resulta especialmente útil cuando un único modelo tiene dificultades para hacer predicciones precisas o coherentes. También puede utilizarse cuando los datos son complejos, ruidosos o impredecibles.
Estos son algunos casos habituales en los que los métodos de conjunto resultan especialmente eficaces:
- Baja precisión del modelo: Cuando las predicciones de un modelo no son lo bastante fiables, combinar varios modelos puede mejorar considerablemente la precisión y el rendimiento. Por ejemplo, en la evaluación del riesgo crediticio o el diagnóstico médico, incluso pequeñas mejoras en la precisión de las predicciones pueden marcar una gran diferencia.
- Datos ruidosos o incoherentes: Si un conjunto de datos contiene valores atípicos, errores o fluctuaciones aleatorias, el aprendizaje por conjuntos ayuda a suavizar esas irregularidades al promediar los resultados de varios modelos o someterlos a votación.
- Necesidad de robustez: Los modelos de conjunto son menos sensibles a pequeños cambios en los datos, por lo que son más estables y fiables en entornos de producción, donde las entradas del mundo real pueden variar.
- Tareas de predicción complejas: En tareas como el reconocimiento de imágenes, la detección de fraude o la previsión de series temporales, los conjuntos captan una variedad más amplia de patrones y relaciones de la que podría captar un solo modelo.
Además, es más sencillo entrenar un conjunto, resulta más fácil de interpretar y es más rápido de mantener. Antes de utilizar un conjunto, es importante sopesar las ventajas de una mayor precisión frente al tiempo, la potencia de cálculo y la complejidad adicionales que requiere.
Resumen de las técnicas de aprendizaje por conjuntos#
A continuación, veamos las principales formas de aplicar el aprendizaje por conjuntos en proyectos de aprendizaje automático. Existen varias técnicas fundamentales para combinar modelos, cada una de las cuales mejora el rendimiento a su manera. Los métodos de conjunto más habituales son bagging, boosting, stacking y blending.
Bagging#
Bagging, abreviatura de agregación bootstrap, es un método de aprendizaje por conjuntos que ayuda a mejorar la estabilidad y la precisión de los modelos al entrenar varias versiones del mismo modelo con distintas partes de los datos.
Cada subconjunto se crea mediante un proceso llamado muestreo bootstrap, en el que se seleccionan puntos de datos al azar con reemplazo. Esto significa que, después de seleccionar un punto de datos, se devuelve al conjunto antes de elegir el siguiente. Así, el mismo punto puede aparecer varias veces, mientras que otros pueden quedar fuera. El componente aleatorio garantiza que cada modelo se entrene con una versión ligeramente distinta del conjunto de datos.
Durante la inferencia, todos los modelos entrenados se ejecutan en paralelo para hacer predicciones con datos nuevos que no han visto antes. Cada modelo genera su propio resultado en función de lo que ha aprendido y, después, se combinan las predicciones individuales para obtener el resultado final.
En tareas de regresión, como predecir los precios de las viviendas o las ventas, normalmente se promedian los resultados de todos los modelos para obtener una estimación más estable. En tareas de clasificación, como determinar si una transacción es fraudulenta, el conjunto suele recurrir a la votación mayoritaria para decidir la clase final.
El bagging en acción: el algoritmo Random Forest#
Un buen ejemplo de la eficacia del bagging son los árboles de decisión, que pueden sufrir sobreajuste fácilmente si se entrenan con un único conjunto de datos. Al entrenar numerosos árboles con muestras ligeramente distintas y combinar sus resultados, el bagging reduce el sobreajuste y mejora la fiabilidad.
Piensa en el algoritmo Random Forest. Es un conjunto de árboles de decisión en el que cada árbol se entrena con un subconjunto aleatorio del conjunto de datos de entrenamiento y con un subconjunto aleatorio de características.
Esta selección aleatoria de características ayuda a garantizar que los árboles estén menos correlacionados y que el modelo global sea más estable y preciso. El algoritmo Random Forest puede utilizarse para clasificar imágenes, detectar fraudes, predecir el abandono de clientes, prever ventas o estimar los precios de inmuebles.
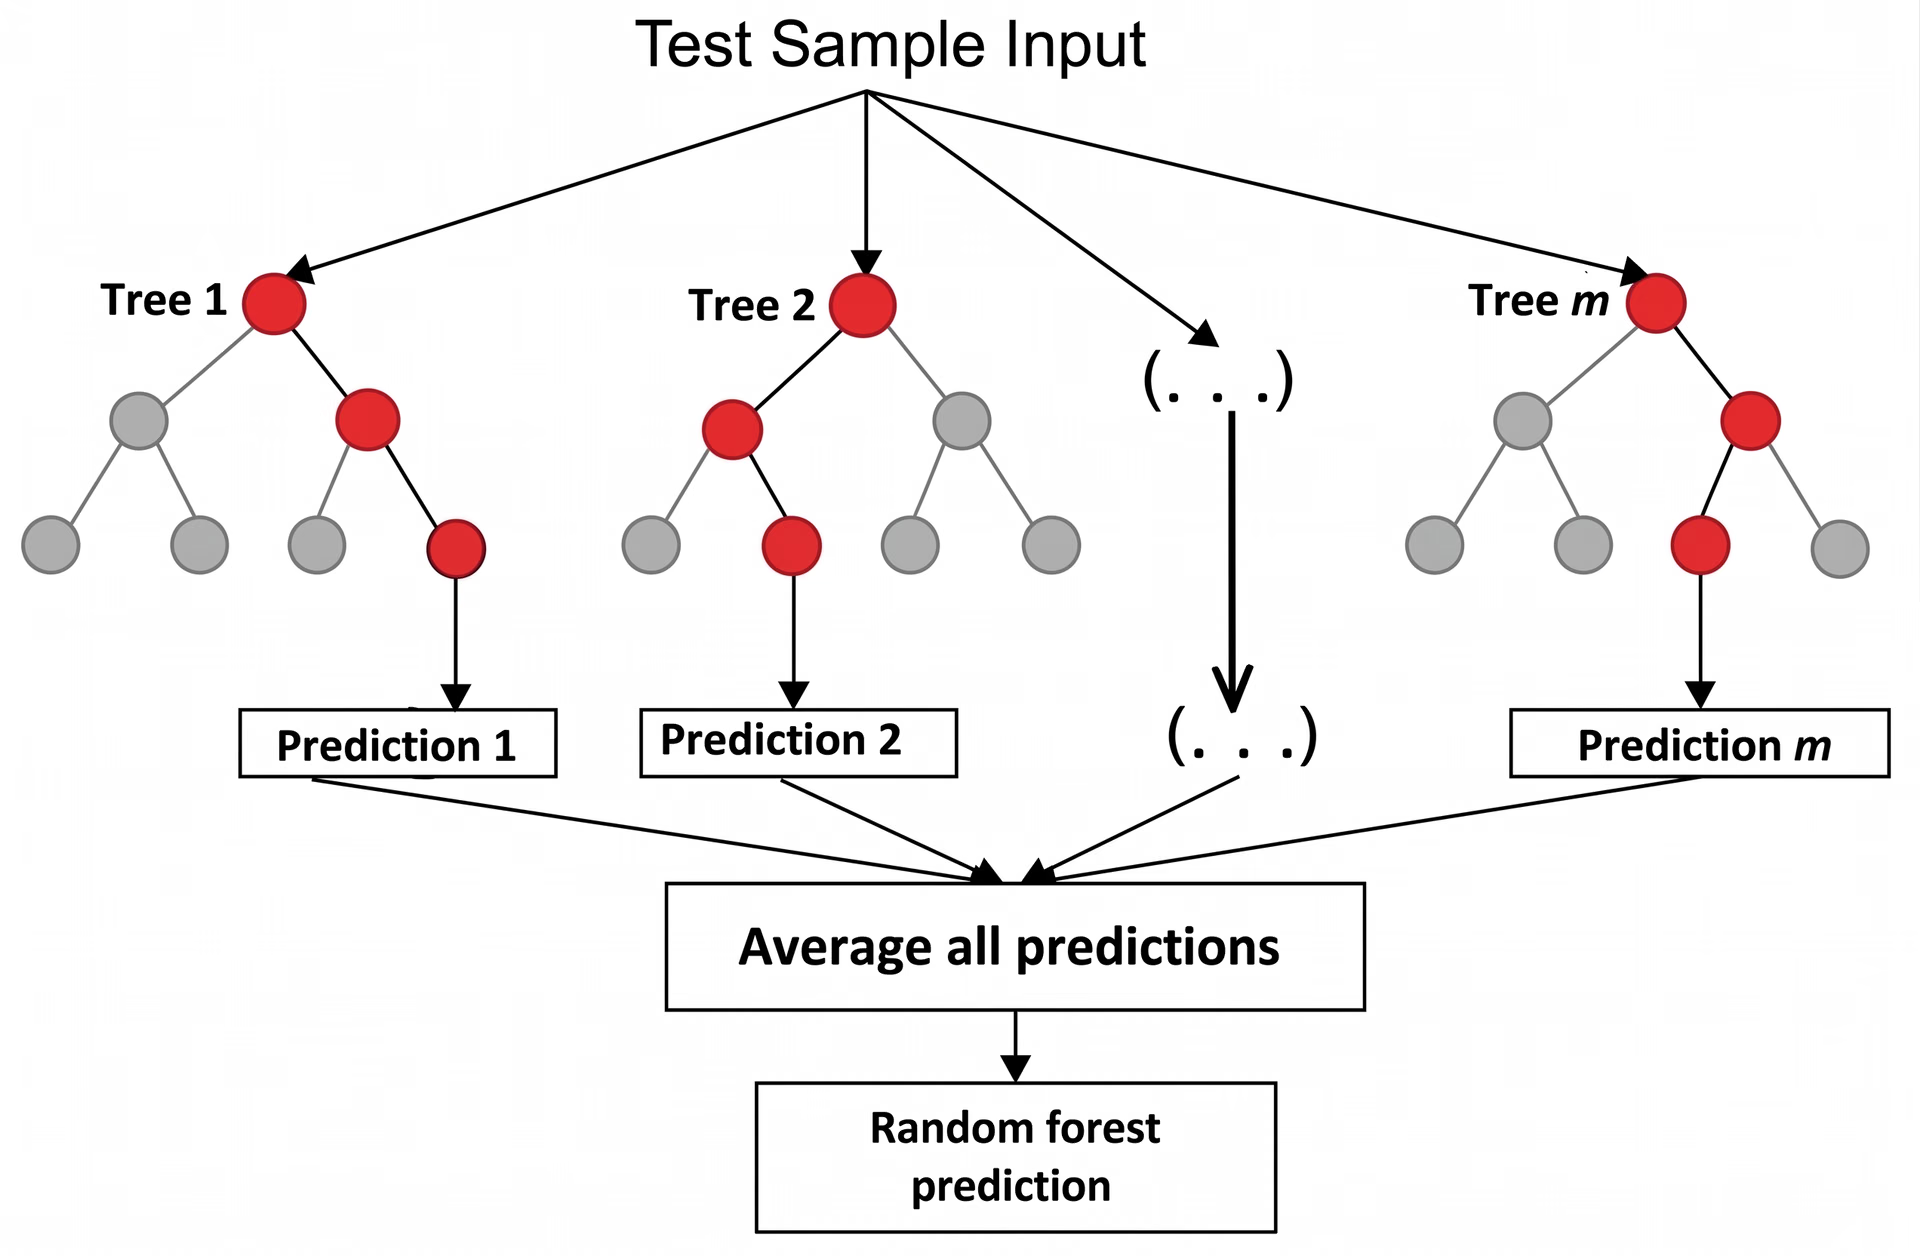
Fig. 2. Un vistazo al algoritmo Random Forest (fuente)
Boosting#
El boosting es otra técnica de aprendizaje por conjuntos que se centra en mejorar los aprendices débiles (modelos) entrenándolos secuencialmente, uno tras otro, en vez de en paralelo. El concepto fundamental del boosting es que cada nuevo modelo aprende de los errores de los anteriores y mejora gradualmente el rendimiento del modelo global.
A diferencia del bagging, que reduce la varianza al promediar modelos independientes, el boosting reduce el sesgo al hacer que cada nuevo modelo preste más atención a los casos difíciles que los modelos anteriores no lograron resolver.
Como los modelos de boosting se entrenan secuencialmente, la forma de combinar sus predicciones al final difiere ligeramente de la de otros métodos de conjunto. Cada modelo contribuye a la predicción final en proporción a su rendimiento durante el entrenamiento; los modelos más precisos reciben un mayor peso.
En las tareas de regresión, el resultado final suele ser una suma ponderada de todas las predicciones de los modelos. En las tareas de clasificación, el algoritmo combina los votos ponderados de los modelos para decidir la clase final. Este enfoque permite al boosting crear un modelo global sólido, al dar más peso a los modelos más precisos sin dejar de aprender de los demás.
Estos son algunos tipos habituales de algoritmos de boosting:
- AdaBoost (impulso adaptativo): Este método comienza entrenando un modelo sencillo, como un árbol de decisión pequeño, y después aumenta el peso de los puntos de datos clasificados incorrectamente. De este modo, el siguiente modelo se centra más en los ejemplos difíciles. A lo largo de varias iteraciones, los modelos se apoyan unos en otros y sus predicciones combinadas ofrecen un resultado más sólido y preciso. Por ejemplo, AdaBoost puede mejorar la detección de spam o la precisión del reconocimiento facial.
- Gradient Boosting: En lugar de volver a ponderar las muestras, Gradient Boosting entrena cada modelo nuevo para corregir los errores residuales de los modelos anteriores, es decir, las diferencias entre los valores reales y los predichos. Este enfoque iterativo resulta eficaz tanto en tareas de regresión como de clasificación, por ejemplo, para prever ventas o evaluar el riesgo crediticio.
- XGBoost (impulso de gradiente extremo): Esta versión avanzada del boosting por gradiente mejora tanto la velocidad como la precisión. Utiliza regularización, que penaliza ligeramente los modelos excesivamente complejos durante el entrenamiento para que se centren en patrones relevantes en lugar de memorizar los datos. Aunque los modelos siguen entrenándose secuencialmente, XGBoost agiliza el proceso mediante la paralelización durante la construcción de los árboles. Puede evaluar simultáneamente muchos puntos de división posibles en distintos núcleos de CPU. Esto acelera considerablemente el entrenamiento, sobre todo con conjuntos de datos grandes, y mantiene un alto rendimiento predictivo.
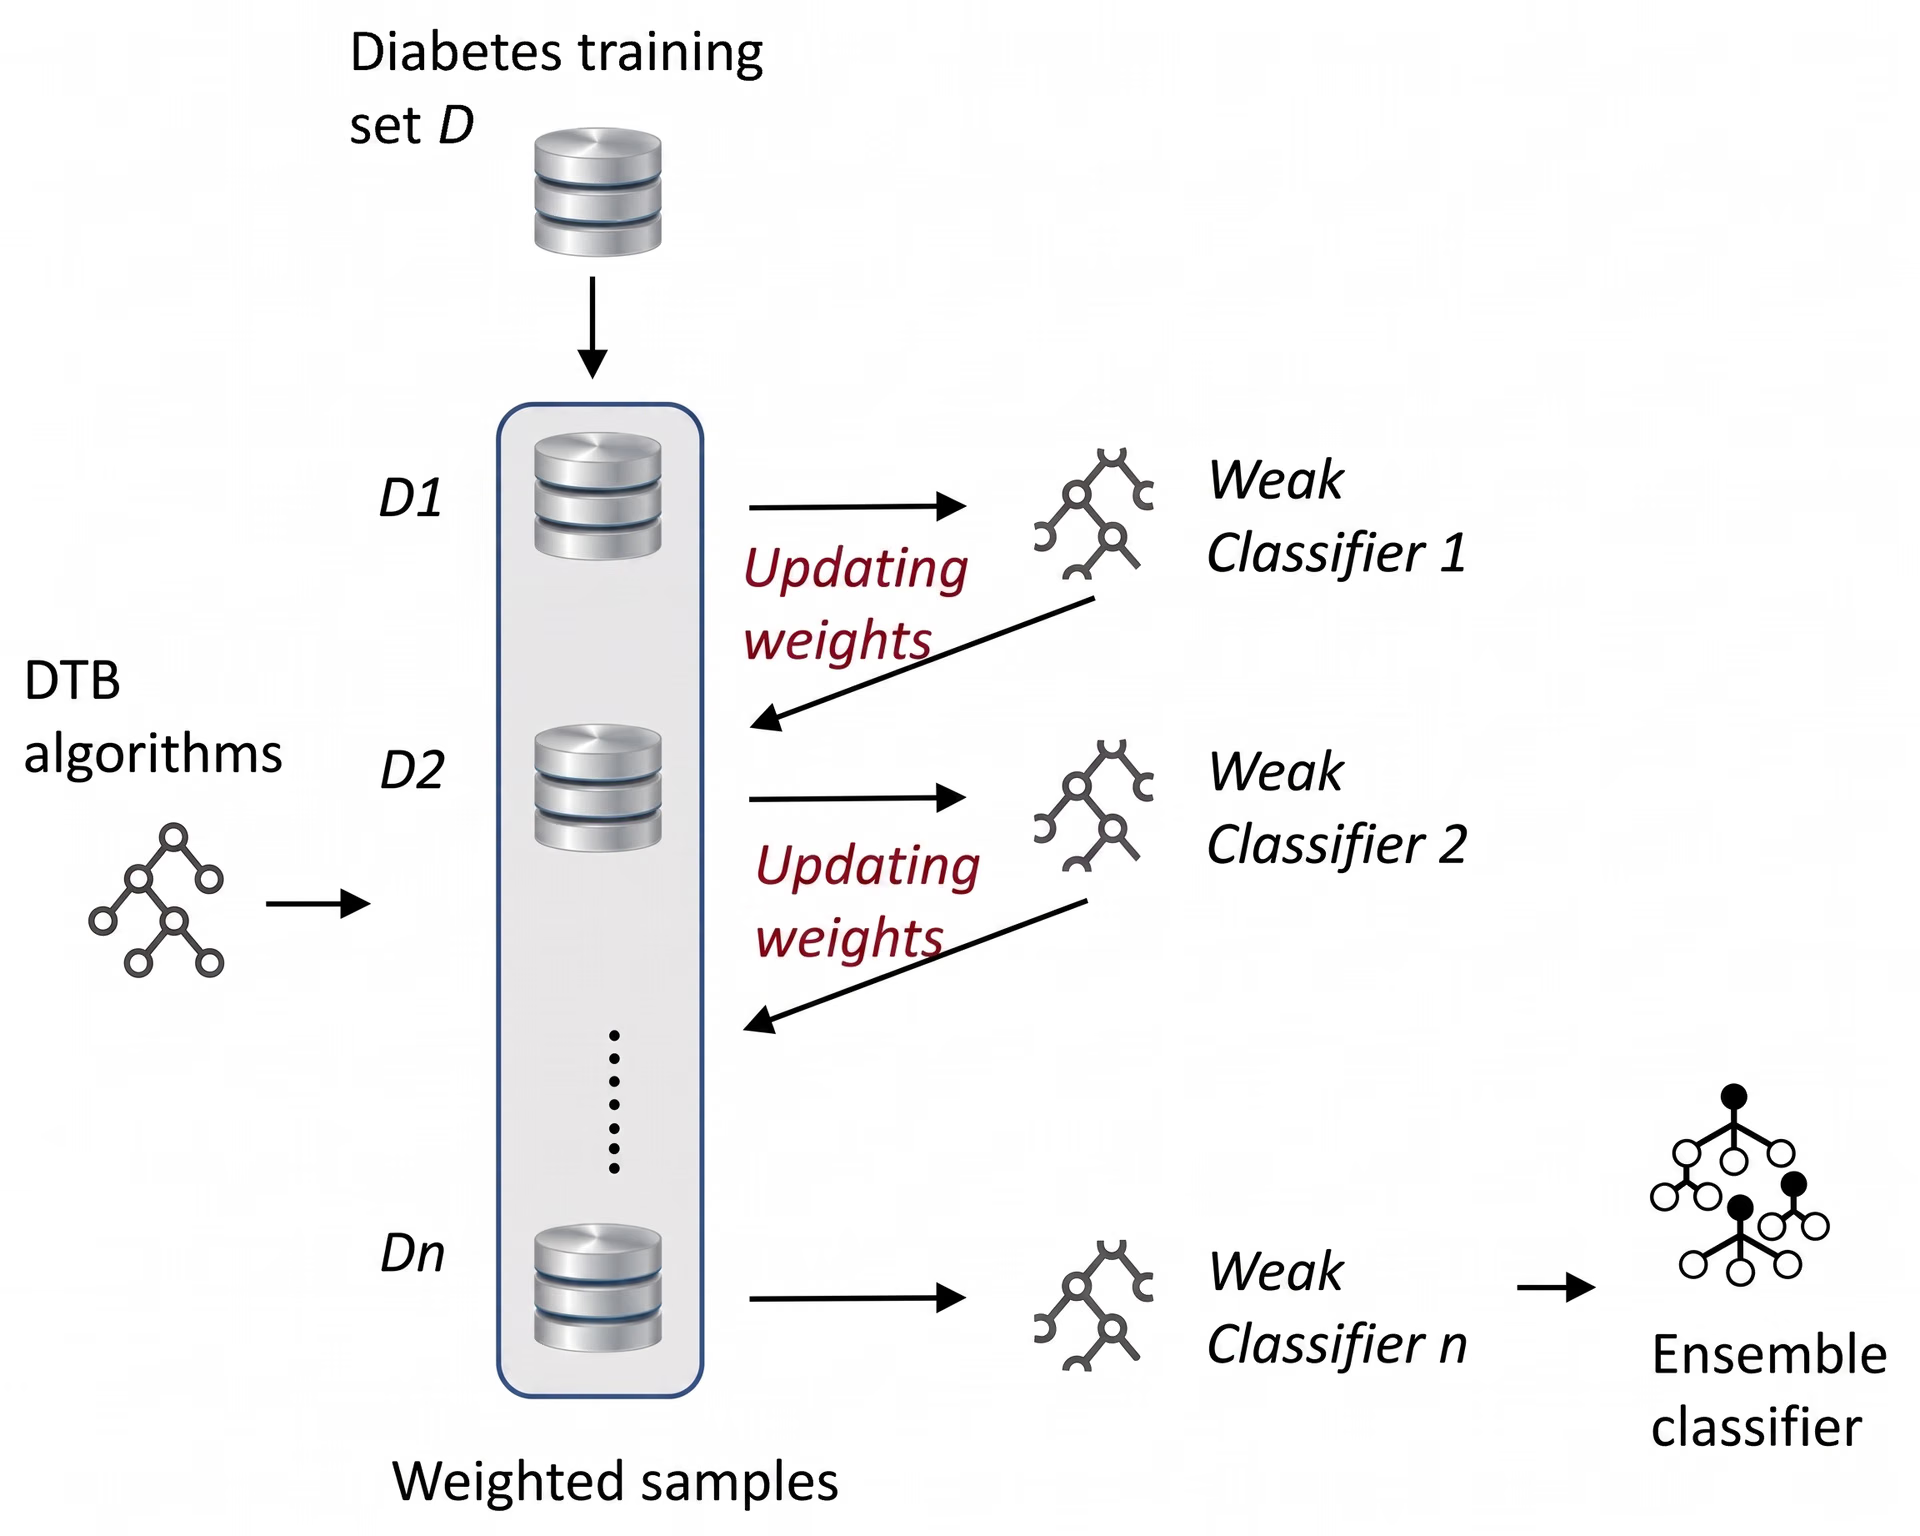
Fig. 3. Ejemplo de clasificador basado en árboles de decisión (DTB) entrenado con un enfoque de boosting para predecir el riesgo de diabetes. (fuente)
Stacking#
El stacking, también llamado generalización apilada, va un paso más allá: utiliza las predicciones de varios modelos como entrada de un modelo final, conocido como metamodelo. Puedes imaginarlo como un grupo de expertos que comparte sus opiniones y un responsable de la decisión final que aprende a ponderarlas para tomar la mejor decisión posible.
Por ejemplo, un modelo puede ser muy bueno detectando fraudes, mientras que otro puede predecir mejor la pérdida de clientes. El metaaprendiz estudia el rendimiento de cada uno y combina sus puntos fuertes para obtener una predicción final más precisa.
Combinación#
La combinación funciona de forma parecida al apilamiento, porque también combina las predicciones de varios modelos para tomar una decisión final, pero sigue un enfoque más sencillo y rápido. En lugar de utilizar validación cruzada (un método que divide los datos en varias partes y las alterna entre el entrenamiento y las pruebas para que el modelo sea más fiable), como hace el apilamiento, la combinación reserva una pequeña parte de los datos, denominada conjunto de reserva.
Los modelos base se entrenan con los datos restantes y después hacen predicciones con el conjunto de reserva, que no han visto antes. Así se obtienen dos datos clave: las respuestas reales, o etiquetas verdaderas, y las predicciones de cada modelo base.
A continuación, estas predicciones se pasan a otro modelo llamado modelo de combinación o metamodelo. Este modelo final estudia la precisión de las predicciones de cada modelo base y aprende a combinarlas de la mejor manera posible.
Como la combinación solo se basa en una división entre entrenamiento y pruebas, en lugar de repetir el proceso varias veces, es más rápida y fácil de configurar. A cambio, dispone de algo menos de información para aprender, lo que puede hacerla un poco menos precisa.
Evaluación de algoritmos de conjunto#
Una parte importante del aprendizaje por conjuntos consiste en evaluar el rendimiento de un modelo con datos que no ha visto antes. Por muy avanzada que sea una técnica, hay que probarla para asegurarse de que puede generalizar; es decir, que realiza predicciones precisas con nuevos ejemplos del mundo real, en lugar de limitarse a memorizar los datos de entrenamiento.
Estas son algunas métricas de rendimiento habituales para evaluar modelos de IA:
- Exactitud: Esta métrica mide la proporción de predicciones correctas respecto al total de predicciones del modelo. Ofrece una visión general rápida del rendimiento.
- Precisión: Indica cuántas de las muestras clasificadas como positivas son realmente positivas. Una precisión alta significa que el modelo comete pocos falsos positivos.
- Exhaustividad: Esta métrica se centra en cuántos de los casos positivos reales ha identificado correctamente el modelo. Es especialmente importante en ámbitos como la sanidad, donde no detectar un caso positivo, como el diagnóstico de una enfermedad, puede tener consecuencias graves.
Aplicaciones del aprendizaje por conjuntos en el mundo real#
Hasta ahora, hemos visto cómo funciona el aprendizaje por conjuntos y las técnicas en las que se basa. Ahora veamos dónde está teniendo repercusión este enfoque.
Estas son algunas áreas clave en las que se aplica habitualmente el aprendizaje por conjuntos:
- Análisis de datos y previsiones: En el ámbito empresarial y analítico, los modelos de conjunto ayudan a las organizaciones a hacer mejores predicciones al combinar la información obtenida de varios modelos. Esto permite elaborar previsiones de ventas más precisas, planificar mejor la demanda y comprender con mayor claridad el comportamiento de los clientes.
- Clasificación binaria: Tareas como la detección de spam, la prevención del fraude y el diagnóstico médico suelen requerir que se distinga entre dos resultados posibles. Los modelos de conjunto ayudan a reducir los falsos positivos y los falsos negativos, algo especialmente importante en ámbitos como la ciberseguridad y la sanidad.
- Problemas de regresión: Al predecir valores continuos, como el precio de una vivienda, los ingresos por ventas o el riesgo crediticio, los métodos de conjunto captan relaciones complejas en los datos. Así se obtienen predicciones más precisas que ayudan a tomar mejores decisiones financieras y operativas.
Más allá de los datos estructurados con el aprendizaje por conjuntos#
Aunque el aprendizaje por conjuntos se utiliza sobre todo con datos estructurados o tabulares, como hojas de cálculo con información numérica o categórica, también puede aplicarse a datos no estructurados, como texto, imágenes, audio y vídeo.
Estos tipos de datos son más complejos y difíciles de interpretar para los modelos, pero los métodos de conjunto ayudan a mejorar la precisión y la fiabilidad. Por ejemplo, en visión artificial, los conjuntos pueden mejorar tareas como la clasificación de imágenes y la detección de objetos.
Al combinar las predicciones de varios modelos de visión, como las redes neuronales convolucionales (CNNs), el sistema puede reconocer objetos con más precisión y gestionar variaciones de iluminación, ángulo o fondo que podrían confundir a un único modelo.
Una mirada al ensamblado de modelos Ultralytics YOLOv5#
Un ejemplo interesante del uso del aprendizaje por conjuntos en visión artificial es cuando un ingeniero combina varios modelos de detección de objetos para mejorar la precisión. Imagina a un ingeniero trabajando en un sistema de vigilancia de seguridad para una obra, donde la iluminación, los ángulos y el tamaño de los objetos cambian constantemente.
Un único modelo podría no detectar a un trabajador entre las sombras o confundir maquinaria en movimiento. Al utilizar un conjunto de modelos con distintos puntos fuertes, el sistema se vuelve más fiable y tiene menos probabilidades de cometer esos errores.
En particular, los modelos como Ultralytics YOLOv5 son muy adecuados para el ensamblado de modelos. Los ingenieros pueden combinar distintas variantes de YOLOv5, como YOLOv5x y YOLOv5l6, para que hagan predicciones conjuntamente. Cada modelo analiza la misma imagen y genera sus propias detecciones, que después se promedian para obtener un resultado final más sólido y preciso.
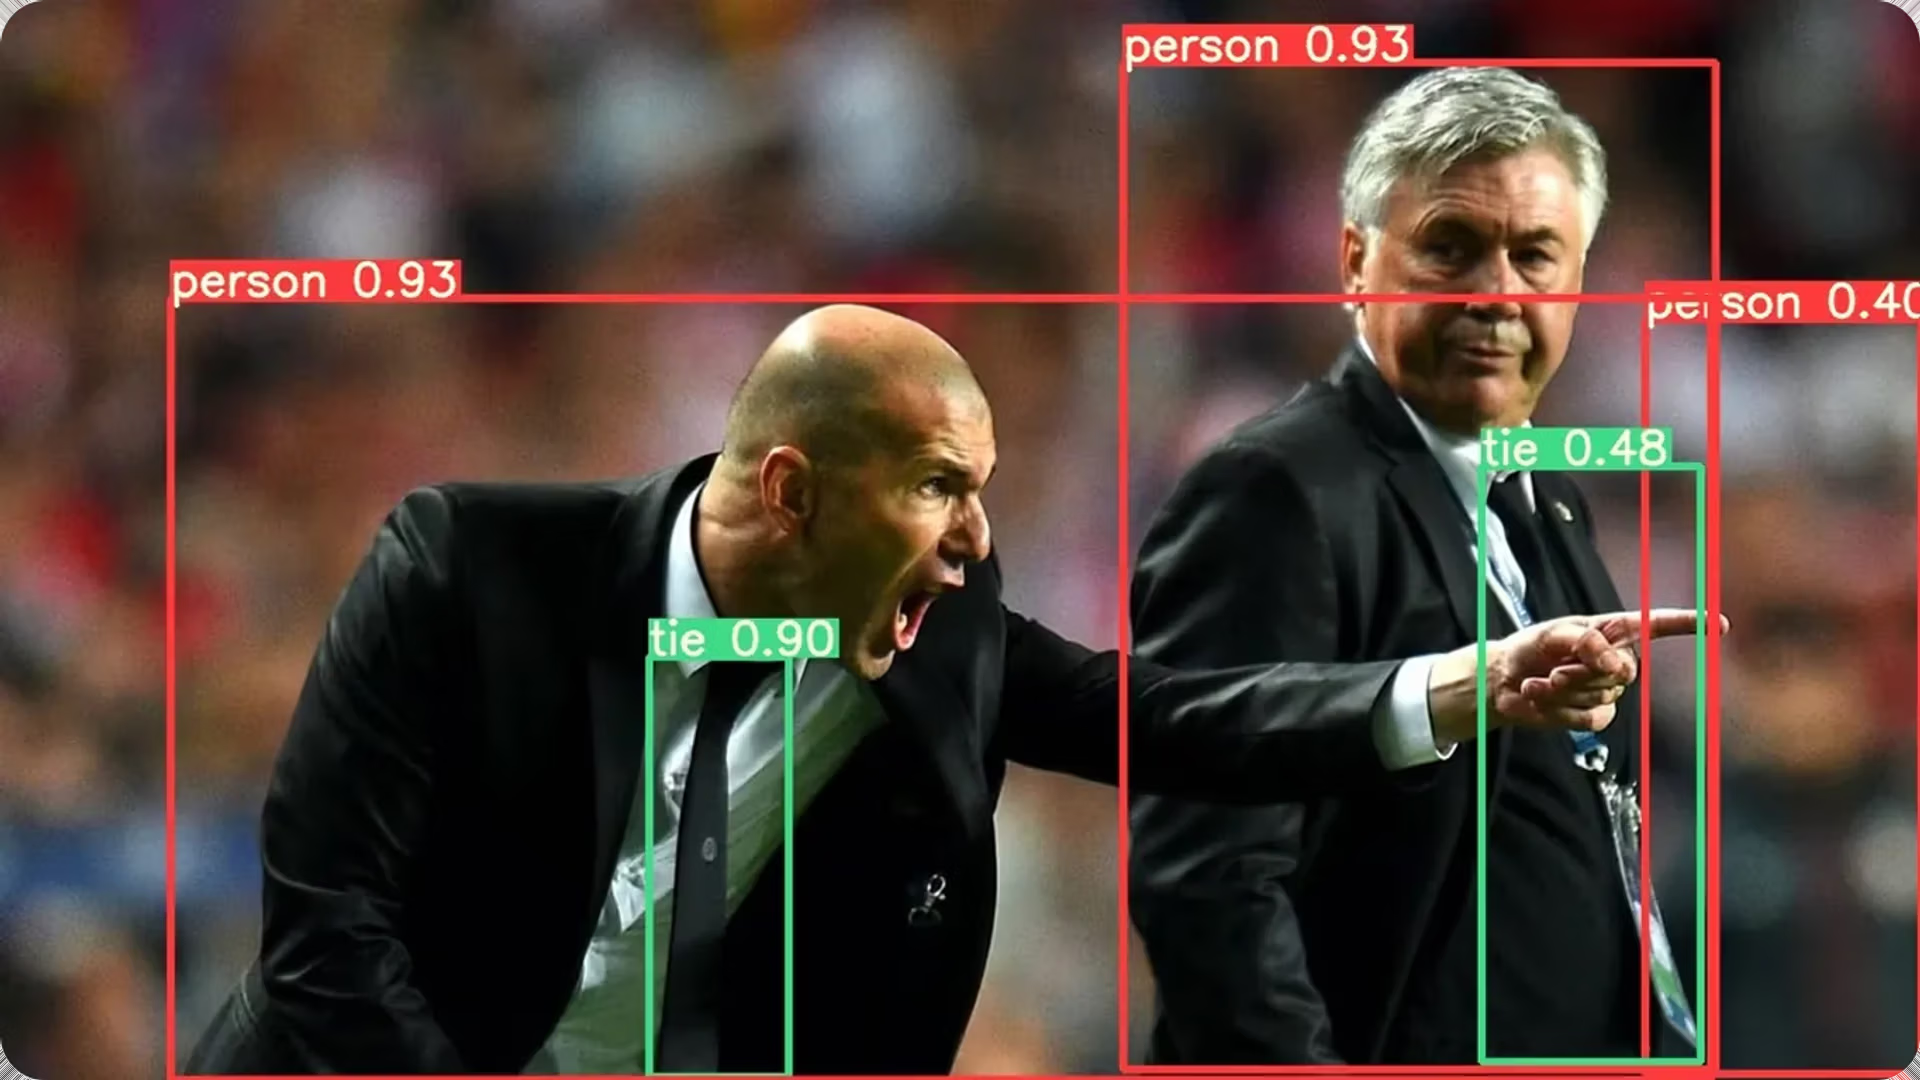
Fig. 4. Detección de objetos en una imagen con YOLOv5. (Fuente)
Ventajas e inconvenientes del aprendizaje por conjuntos#
Estas son algunas de las principales ventajas del aprendizaje por conjuntos:
- Resistencia a los datos ruidosos: Los conjuntos se ven menos afectados por los valores atípicos o el ruido aleatorio del conjunto de datos, ya que se basan en varios modelos.
- Mejor capacidad de generalización: Los conjuntos reducen el sobreajuste y ayudan a los modelos a rendir bien con datos que no han visto, en lugar de limitarse a memorizar ejemplos de entrenamiento.
- Flexibilidad entre algoritmos: Puedes combinar distintos tipos de modelos, como árboles de decisión, redes neuronales y modelos lineales, para aprovechar sus puntos fuertes.
Aunque el aprendizaje por conjuntos ofrece diversas ventajas, también plantea algunos retos que conviene tener en cuenta. Estos son algunos factores a considerar:
- Mayor coste computacional: Entrenar y mantener varios modelos requiere más memoria, capacidad de procesamiento y tiempo que utilizar un único modelo.
- Menor interpretabilidad: Como el resultado final combina varios modelos, puede ser difícil entender por qué se ha tomado una decisión concreta. Sin embargo, depende de los modelos utilizados: si eliges modelos interpretables, como árboles de decisión o máquinas de vectores de soporte, normalmente es más fácil entender los resultados.
- Consideraciones sobre el diseño del conjunto: Para crear un conjunto hay que elegir la combinación adecuada de modelos y asegurarse de que funcionan bien juntos. Sin embargo, en algunos casos el proceso puede ser más sencillo, ya que no hace falta ajustar los hiperparámetros de cada modelo por separado.
Conclusiones clave#
El aprendizaje por conjuntos demuestra cómo combinar varios modelos puede hacer que los sistemas de IA sean más precisos y fiables. Ayuda a reducir errores y a mejorar el rendimiento en distintos tipos de tareas. A medida que avanzan el aprendizaje automático y la IA, técnicas como esta impulsan una adopción más amplia y soluciones de IA más prácticas y eficaces.
Únete a nuestra comunidad en crecimiento y visita nuestro repositorio de GitHub para descubrir más sobre la IA de visión. Explora nuestras páginas de soluciones para conocer las aplicaciones de la visión artificial en la agricultura y la IA en la logística. Consulta nuestras opciones de licencia para empezar hoy mismo a trabajar con tu propio modelo de visión artificial.









