Los 5 mejores consejos para desplegar YOLO26 de forma eficiente en el edge y en la nube
Descubre los 5 consejos prácticos principales para desplegar Ultralytics YOLO26 de forma eficiente en el edge y en la nube, desde elegir el flujo de trabajo y el formato de exportación adecuados hasta la cuantización.
El mes pasado, Ultralytics lanzó oficialmente Ultralytics YOLO26, que establece un nuevo estándar para la IA visual, una rama de la inteligencia artificial que permite a las máquinas interpretar y comprender la información visual de imágenes y vídeos. En lugar de limitarse a capturar imágenes, los modelos de visión artificial, como los modelos Ultralytics YOLO, permiten realizar tareas de visión, como la detección de objetos, la segmentación de instancias, la estimación de poses y la clasificación de imágenes.
Diseñado para los entornos en los que realmente se ejecuta la visión artificial —dispositivos, cámaras, robots y sistemas de producción—, Ultralytics YOLO26 es un modelo de última generación que ofrece una inferencia más rápida en la unidad central de procesamiento (CPU), un despliegue más sencillo y un rendimiento integral eficiente en entornos reales. Los modelos YOLO26 también se han diseñado para facilitar el paso de las soluciones de visión artificial de la fase de experimentación a la de producción.
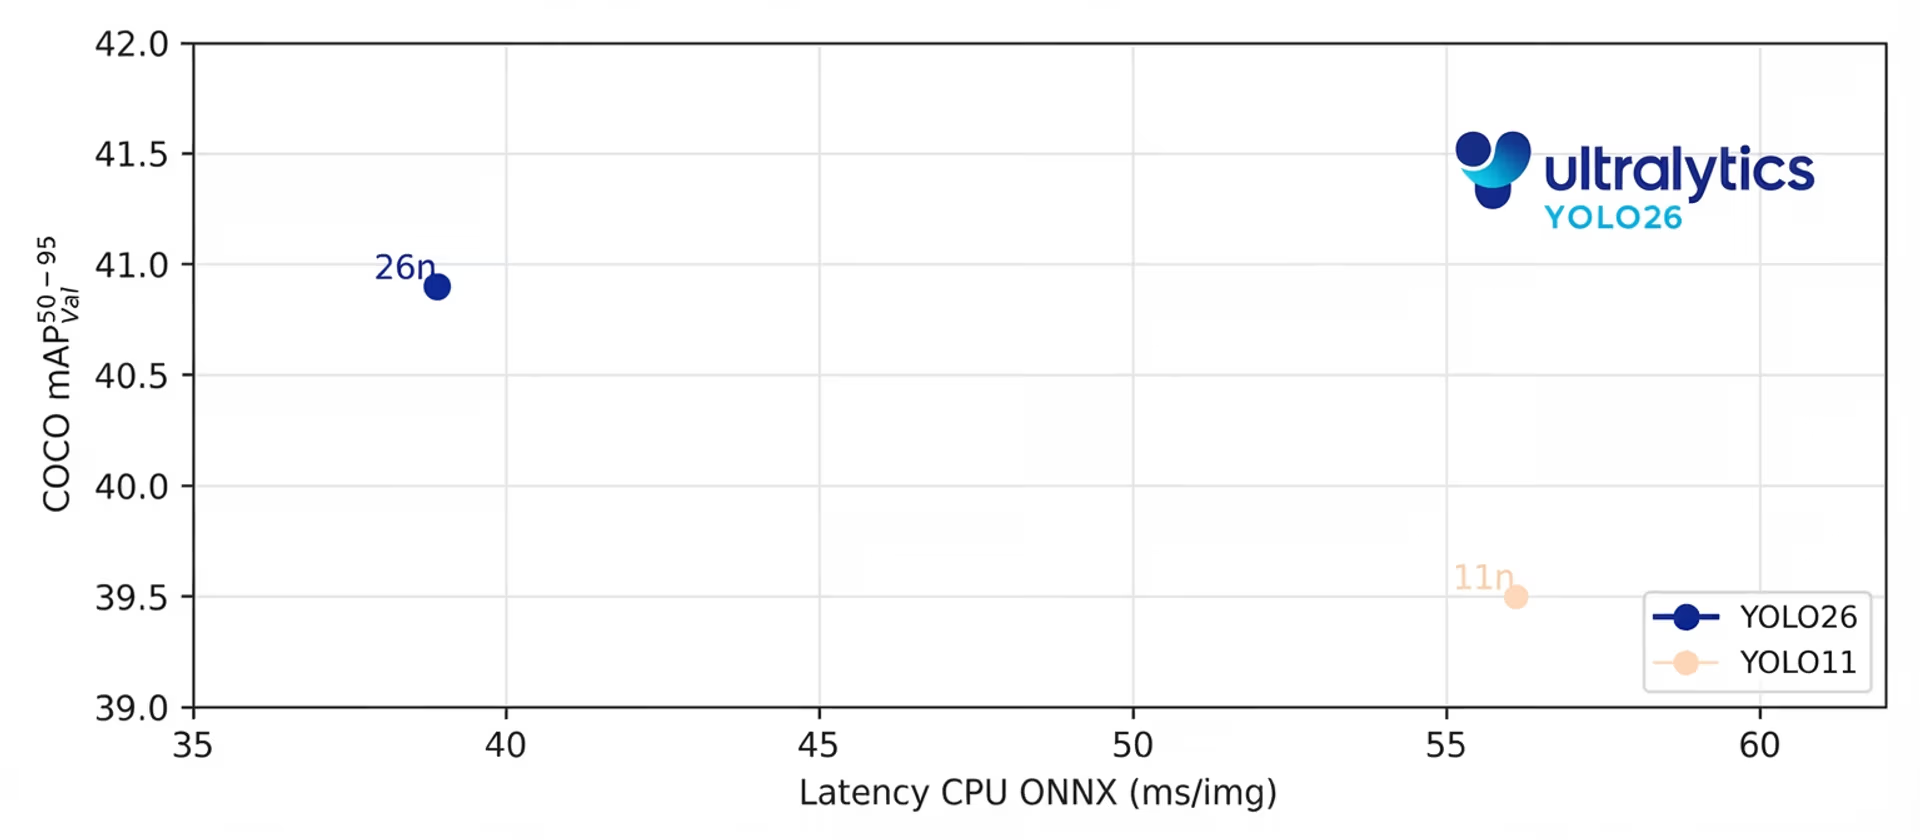
Fig. 1. El modelo nano de YOLO26 ofrece una inferencia en CPU hasta un 43 % más rápida que YOLO11. (Fuente)
El despliegue de modelos suele implicar varios aspectos, como seleccionar el hardware adecuado, elegir un formato de exportación apropiado, optimizar el rendimiento y validar los resultados en condiciones reales. Gracias al paquete de Python de Ultralytics, que simplifica el entrenamiento, la inferencia y la exportación de modelos para distintos destinos de despliegue, es fácil seguir estos pasos al desplegar YOLO26.
Sin embargo, aunque los flujos de trabajo se hayan simplificado, es fundamental tomar las decisiones adecuadas sobre el despliegue. En este artículo repasaremos cinco consejos prácticos para ayudarte a desplegar Ultralytics YOLO26 de forma eficiente en entornos perimetrales y en la nube, y garantizar un rendimiento fiable y escalable de la IA visual en producción. ¡Empecemos!
¿Qué es el despliegue de modelos en visión artificial?#
Antes de profundizar en las estrategias de despliegue de Ultralytics YOLO26, demos un paso atrás para entender qué significa el despliegue de modelos en visión artificial.
El despliegue de modelos es el proceso de trasladar un modelo de aprendizaje profundo entrenado desde un entorno de desarrollo a una aplicación real, donde puede procesar imágenes nuevas o flujos de vídeo y generar predicciones de forma continua. En lugar de ejecutar experimentos con conjuntos de datos estáticos, el modelo pasa a formar parte de un sistema en funcionamiento.
En visión artificial, esto suele implicar integrar el modelo con cámaras, dispositivos de IA perimetral, API o infraestructura en la nube. El modelo debe funcionar dentro de las limitaciones del hardware, cumplir los requisitos de latencia y mantener un rendimiento uniforme en condiciones reales cambiantes.
Entender este paso de la experimentación a la producción es esencial, porque las decisiones de despliegue repercuten directamente en el rendimiento del modelo fuera del laboratorio o de un entorno experimental.
Comprender los flujos de trabajo de despliegue de Ultralytics YOLO26#
A continuación, veamos en qué consiste realmente un flujo de trabajo de despliegue de Ultralytics YOLO26. En pocas palabras, es la secuencia de pasos que convierte una imagen capturada en un análisis y una predicción.
En una configuración típica, una cámara captura una imagen o un fotograma de vídeo. A continuación, se preprocesan los datos, por ejemplo, cambiando su tamaño o aplicando el formato correcto, antes de introducirlos en Ultralytics YOLO26 para realizar la inferencia.
El modelo analiza la entrada y genera resultados como cuadros delimitadores, máscaras de segmentación o puntos clave. Después, estos resultados pueden utilizarse para activar acciones, como enviar alertas, actualizar un panel de control o guiar un sistema robótico.
El lugar donde se ejecuta este flujo de trabajo depende de la estrategia de despliegue. Por ejemplo, en un despliegue perimetral, la inferencia se realiza directamente en el dispositivo o cerca de la cámara, lo que ayuda a reducir la latencia y mejorar la privacidad de los datos.
En cambio, en un despliegue en la nube, las imágenes o los fotogramas de vídeo se envían a servidores remotos para su procesamiento, lo que permite una mayor escalabilidad y una gestión centralizada. Algunos sistemas utilizan un enfoque híbrido: realizan un procesamiento ligero en el perímetro y las cargas de trabajo más exigentes en la nube.
Explorar las variantes de los modelos Ultralytics YOLO26#
Para tomar decisiones fundamentadas sobre el despliegue, también es importante saber que puedes elegir entre distintas variantes de los modelos Ultralytics YOLO26.
De serie, los modelos Ultralytics YOLO están disponibles en varios tamaños, por lo que es fácil elegir una versión que se ajuste a las necesidades de hardware y rendimiento. YOLO26 cuenta con cinco variantes: Nano (n), Small (s), Medium (m), Large (l) y Extra Large (x).
Los modelos más pequeños, como YOLO26n, están optimizados para la eficiencia y son ideales para dispositivos perimetrales, dispositivos del Internet de las cosas (IoT), sistemas integrados y sistemas basados en CPU, en los que son importantes la baja latencia y un menor consumo energético. Ofrecen un gran rendimiento y mantienen un uso mínimo de los recursos.
Los modelos más grandes, como YOLO26l y YOLO26x, están diseñados para ofrecer mayor precisión y gestionar escenas más complejas. Estas variantes suelen rendir mejor en sistemas equipados con unidades de procesamiento gráfico (GPU) o en entornos en la nube con más recursos de computación.
La elección del tamaño de modelo adecuado depende de tus objetivos de despliegue. Si tus prioridades principales son la velocidad y la eficiencia en hardware con recursos limitados, una variante más pequeña puede ser ideal. Si tu aplicación exige la máxima precisión y tienes acceso a hardware más potente, quizá te convenga más un modelo grande.
Consejos para desplegar Ultralytics YOLO26 de forma eficiente#
Ahora que conocemos mejor las variantes de los modelos Ultralytics YOLO26 y los flujos de trabajo de despliegue, veamos algunos consejos prácticos para desplegar YOLO26 de forma eficiente en entornos perimetrales y en la nube.
Consejo 1: Valora las opciones de despliegue de tu modelo#
Una de las primeras decisiones que tendrás que tomar al desplegar Ultralytics YOLO26 es dónde se ejecutará el modelo. El entorno de despliegue afecta directamente al rendimiento, la latencia, la privacidad y la escalabilidad.
Empieza por evaluar tu flujo de trabajo. ¿Tu aplicación necesita una latencia baja, es decir, generar predicciones casi al instante después de capturar una imagen?
Por ejemplo, en robótica o en sistemas de seguridad, incluso los retrasos pequeños pueden afectar al rendimiento. En estos casos, un despliegue perimetral suele ser la mejor opción. Ejecutar la inferencia directamente en un dispositivo o cerca de la cámara reduce el tiempo de procesamiento de los datos y evita enviar imágenes por Internet, lo que también puede mejorar la privacidad.
Por otro lado, el despliegue en la nube ofrece mayor escalabilidad y capacidad de cálculo. Los servidores en la nube pueden procesar grandes volúmenes de imágenes, gestionar varios flujos de vídeo y admitir un mayor rendimiento.
Por ejemplo, en agricultura, un agricultor podría recopilar miles de imágenes de hojas y analizarlas por lotes para determinar si los cultivos presentan signos de enfermedad. En este tipo de situación, quizá no sea necesario obtener resultados inmediatos en tiempo real, por lo que el procesamiento en la nube es una opción práctica y escalable.
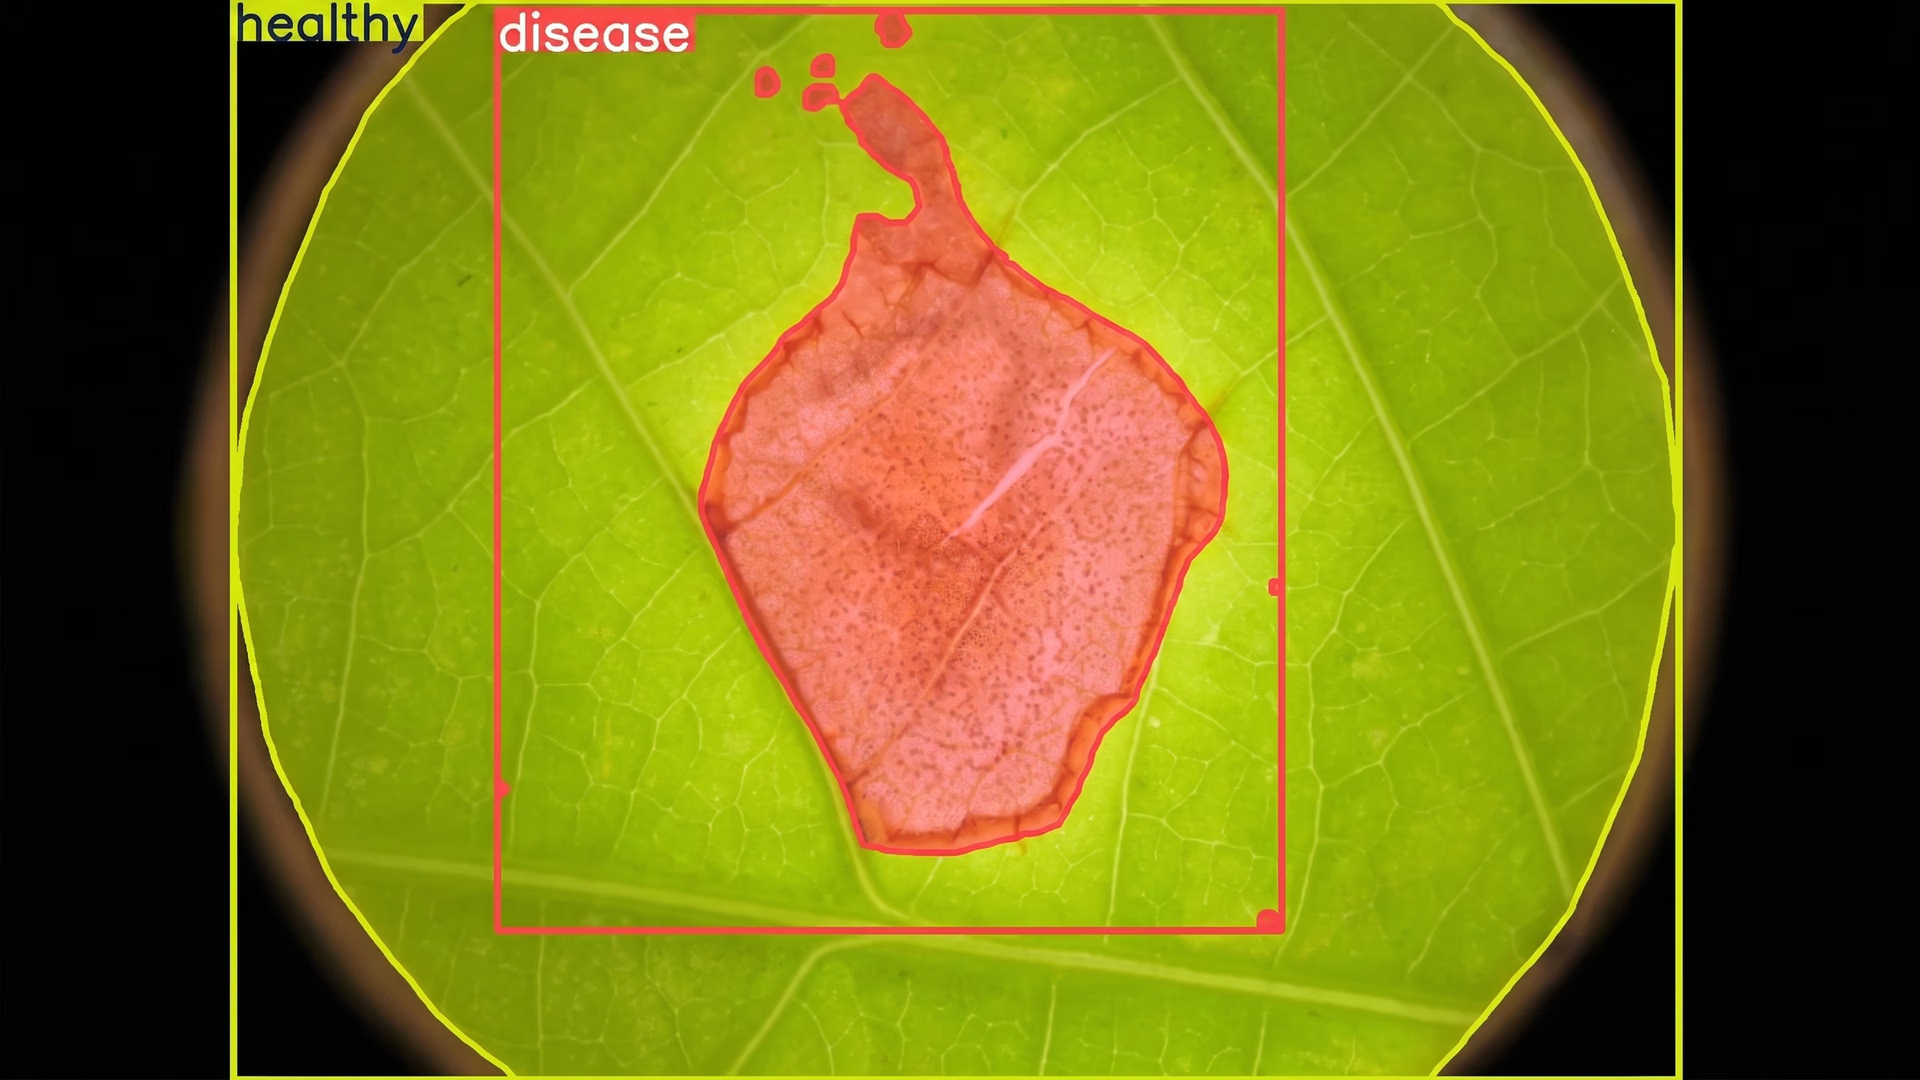
Fig. 2. Ejemplo del uso de Ultralytics YOLO26 para analizar imágenes de hojas
Sin embargo, enviar datos a servidores remotos introduce latencia de red, es decir, el retraso que se produce al transmitir imágenes por Internet y recibir las predicciones. Para las aplicaciones que no requieren una respuesta inmediata, esta contrapartida puede ser aceptable.
También hay opciones intermedias entre el perímetro puro y la nube pura. Algunas empresas utilizan infraestructura local situada cerca del lugar donde se generan los datos. Otras crean procesos híbridos: realizan un filtrado ligero en el perímetro y envían los datos seleccionados a la nube para un análisis más profundo.
La elección de la opción de despliegue adecuada depende de los requisitos de tu aplicación. Si defines claramente tus necesidades de velocidad, privacidad y escalabilidad, podrás elegir una estrategia que garantice un rendimiento fiable de Ultralytics YOLO26 en condiciones reales.
Consejo 2: Elige el formato de exportación que se ajuste a tu hardware#
Una vez que hayas decidido dónde se ejecutará el modelo, el siguiente paso es elegir el formato de exportación adecuado. Exportar un modelo significa convertirlo del formato utilizado durante el entrenamiento a otro optimizado para el despliegue.
Los modelos Ultralytics YOLO26 se crean y entrenan de forma nativa en PyTorch, pero los entornos de producción suelen utilizar motores de ejecución especializados y más adecuados para un hardware concreto. Estos motores están diseñados para mejorar la velocidad de inferencia, reducir el uso de memoria y garantizar la compatibilidad con el dispositivo de destino.
Convertir YOLO26 al formato adecuado permite ejecutarlo de forma eficiente fuera del entorno de entrenamiento. El paquete de Python de Ultralytics simplifica este proceso. Admite una amplia gama de integraciones para crear y desplegar proyectos de visión artificial.
Si quieres explorar estas integraciones con más detalle, consulta la documentación oficial de Ultralytics. Incluye tutoriales paso a paso, orientación específica para cada tipo de hardware y ejemplos prácticos que te ayudarán a pasar del desarrollo a la producción con confianza.
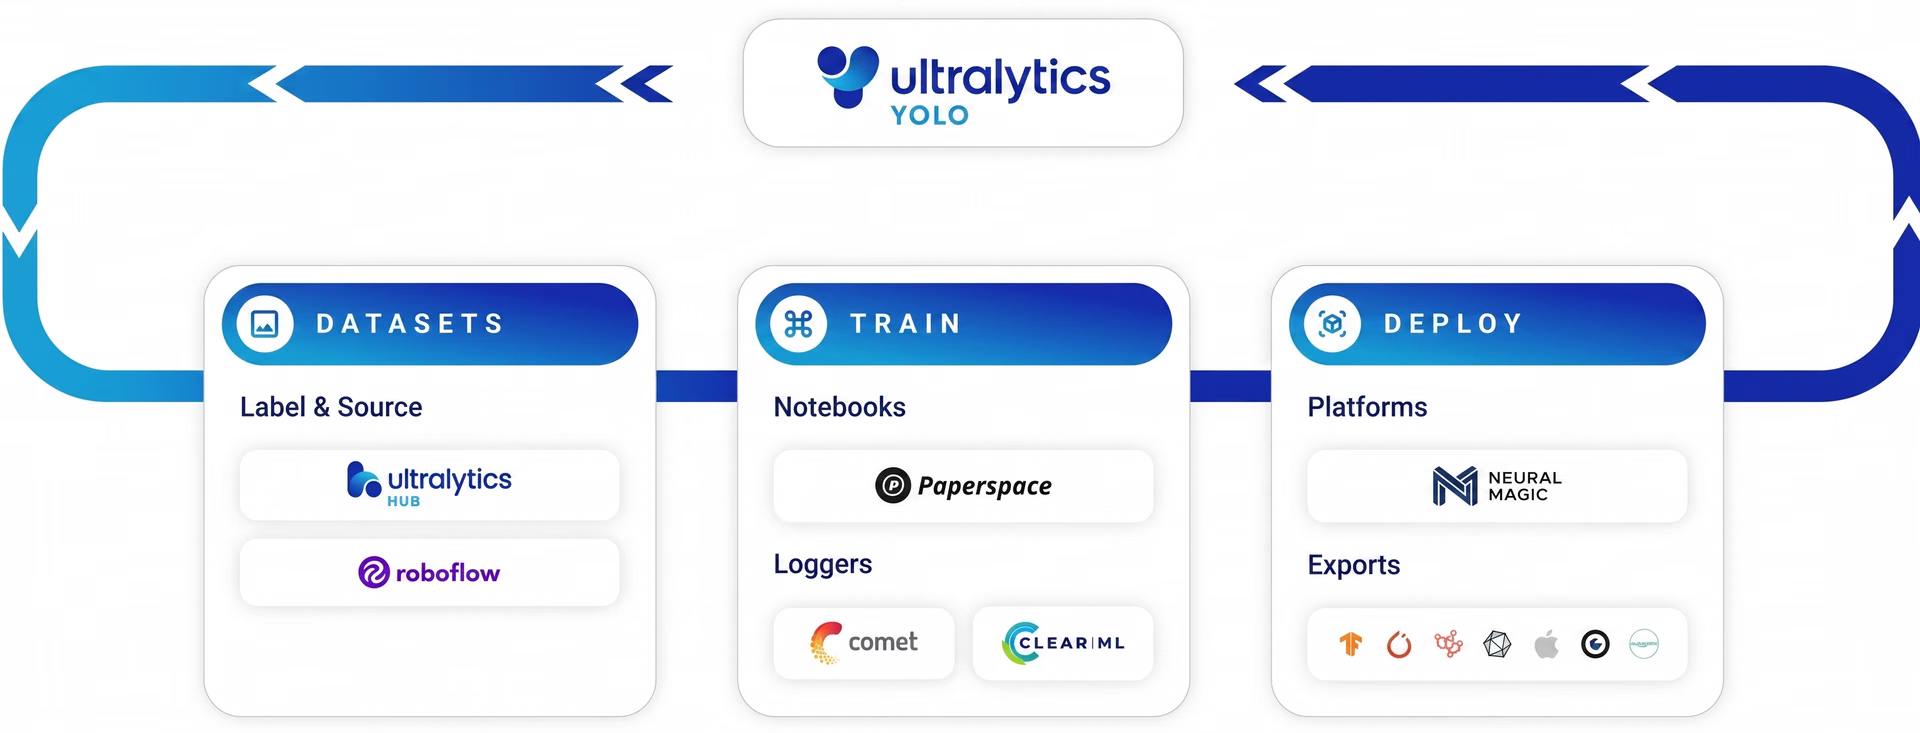
Fig. 3. Ultralytics admite distintas integraciones (Fuente)
En concreto, el paquete de Python de Ultralytics permite exportar Ultralytics YOLO26 a varios formatos adaptados a distintas plataformas de hardware. Por ejemplo, el formato de exportación ONNX ofrece compatibilidad multiplataforma, el formato TensorRT está optimizado para GPU NVIDIA y dispositivos perimetrales NVIDIA Jetson, y el formato OpenVINO está diseñado para hardware Intel.
Algunos dispositivos admiten más de un formato de exportación, pero el rendimiento puede variar según el que elijas. En lugar de seleccionar un formato por defecto, pregúntate: ¿qué opción es más eficiente para tu dispositivo?
Un formato puede ofrecer una inferencia más rápida, mientras que otro puede utilizar la memoria de forma más eficiente o integrarse más fácilmente en tu proceso actual. Por eso es importante adaptar el formato de exportación a tu hardware y entorno de despliegue concretos.
Dedicar tiempo a probar distintas opciones de exportación en el dispositivo de destino puede marcar una diferencia notable en el rendimiento en condiciones reales. Un formato de exportación bien adaptado ayuda a garantizar que Ultralytics YOLO26 se ejecute de forma eficiente y fiable, a la velocidad que requiere tu aplicación.
Consejo 3: comprueba si tu modelo necesita cuantización#
Tras seleccionar un formato de exportación, también conviene determinar si debes cuantizar el modelo.
La cuantización de modelos reduce la precisión numérica de los pesos y los cálculos de un modelo, normalmente convirtiéndolos de coma flotante de 32 bits a formatos de menor precisión, como 16 u 8 bits. Esto ayuda a reducir el tamaño del modelo y el uso de memoria, y a mejorar la velocidad de inferencia, especialmente en dispositivos periféricos o sistemas con CPU.
Según el hardware, el formato de exportación y las dependencias del entorno de ejecución, la cuantización puede mejorar notablemente el rendimiento. Algunos entornos de ejecución están optimizados para modelos de menor precisión, lo que les permite funcionar más rápido y de forma más eficiente.
Sin embargo, la cuantización puede afectar ligeramente a la precisión si no se aplica con cuidado. Al realizar una cuantización posterior al entrenamiento, asegúrate de pasar las imágenes de validación. Estas imágenes se utilizan durante la calibración para ayudar al modelo a adaptarse a una menor precisión y mantener predicciones estables.
Consejo 4: ten en cuenta la deriva de datos#
Incluso el modelo mejor entrenado puede perder rendimiento con el tiempo debido a la deriva de datos. La deriva de datos se produce cuando los datos que ve tu modelo en producción son distintos de aquellos con los que se entrenó.
En otras palabras, el mundo real cambia, pero tu modelo no. Como resultado, la precisión puede disminuir poco a poco.
Por ejemplo, puedes entrenar tu modelo Ultralytics YOLO26 con imágenes capturadas durante el día. Si más adelante se utiliza ese mismo modelo de noche, con condiciones de iluminación distintas, el rendimiento puede disminuir. El mismo problema puede surgir por cambios en los ángulos de cámara, las condiciones meteorológicas, los fondos o el aspecto de los objetos.
La deriva de datos es habitual en los sistemas de IA de visión del mundo real. Los entornos rara vez permanecen estáticos y los pequeños cambios pueden afectar a la precisión de la detección. Para reducir el impacto de la deriva, puedes asegurarte de que tu conjunto de datos de entrenamiento refleje las condiciones del mundo real lo más fielmente posible.
Incluye imágenes capturadas a distintas horas del día, con diferentes condiciones de iluminación y en diversos entornos. Tras el despliegue, puedes seguir supervisando el rendimiento y actualizar o ajustar el modelo cuando sea necesario.
Consejo 5: realiza pruebas de rendimiento en condiciones reales#
Antes de desplegar por completo tu modelo, puedes medir su rendimiento en condiciones reales.
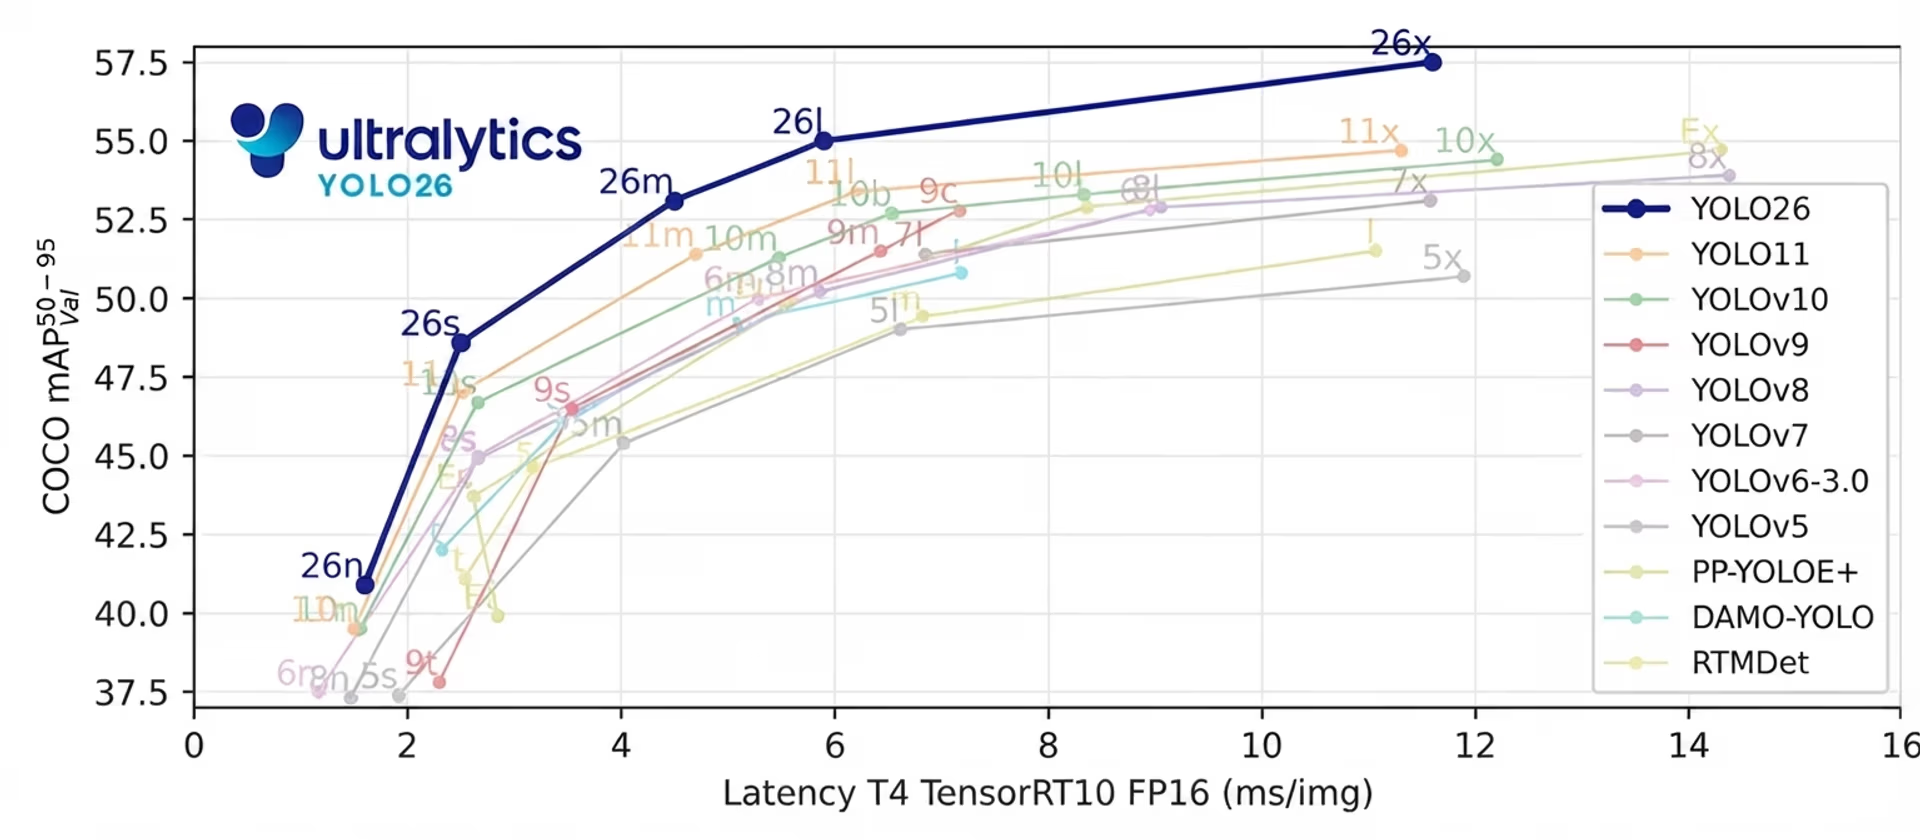
Fig. 4. Comparativa de rendimiento de YOLO26 con otros modelos (Fuente)
Es habitual probar el rendimiento en entornos controlados con imágenes de muestra o conjuntos de datos pequeños. Sin embargo, los sistemas del mundo real suelen comportarse de otra manera. Las limitaciones del hardware, los retrasos de red, los múltiples flujos de vídeo y la entrada continua pueden afectar al rendimiento.
La evaluación comparativa consiste en medir cómo funciona tu modelo en el dispositivo y la configuración reales donde se ejecutará. Esto incluye comprobar la velocidad de inferencia, la latencia general, el uso de memoria y la estabilidad del sistema. Es importante probar no solo el modelo, sino también toda la cadena de procesamiento, incluidos el preprocesamiento y cualquier paso de posprocesamiento.
Un modelo puede funcionar bien en una prueba con una sola imagen, pero tener dificultades al procesar vídeo en directo de forma continua. Del mismo modo, el rendimiento en una máquina de desarrollo potente puede no reflejar cómo se comportará el modelo en un dispositivo periférico de bajo consumo.
Al evaluar el rendimiento en condiciones realistas, puedes identificar los cuellos de botella pronto y hacer ajustes antes de poner el sistema en marcha. Probarlo en el mismo entorno en el que funcionará Ultralytics YOLO26 ayuda a garantizar un rendimiento fiable, estable y uniforme en producción.
Otros aspectos clave que debes tener en cuenta al desplegar modelos#
Estos son algunos factores adicionales que debes tener en cuenta al desplegar Ultralytics YOLO26:
- Supervisión y registro: configura herramientas de supervisión para realizar un seguimiento de métricas como la latencia, la precisión y el estado del sistema tras el despliegue.
- Seguridad y privacidad: implementa medidas de protección para proteger los datos visuales confidenciales, especialmente si utilizas infraestructura en la nube o remota.
- Optimización de los cuellos de botella de la cadena de procesamiento: evalúa toda la cadena, incluidos módulos como el preprocesamiento, la inferencia, el posprocesamiento y la transferencia de datos, ya que pueden producirse retrasos fuera del propio modelo.
- Planificación de la escalabilidad: planifica el crecimiento con antelación y asegúrate de que tu sistema pueda gestionar un aumento del tráfico, cámaras adicionales o cargas de trabajo ampliadas.
Conclusiones clave#
Desplegar YOLO26 de forma eficiente empieza por entender dónde se ejecutará tu modelo y qué necesita realmente tu aplicación. Si eliges el enfoque de despliegue adecuado, adaptas el formato de exportación al hardware y pruebas el rendimiento en condiciones reales, podrás crear sistemas de IA de visión fiables y ágiles. Con la configuración adecuada, Ultralytics YOLO26 facilita llevar la visión artificial rápida y lista para producción al perímetro y a la nube.
Únete a nuestra comunidad y explora nuestro repositorio de GitHub. Echa un vistazo a nuestras páginas de soluciones para descubrir distintas aplicaciones, como la IA en la agricultura y la visión artificial en la atención sanitaria. Descubre nuestras opciones de licencia y empieza hoy mismo con la IA de visión.








