¿Qué es Mask R-CNN y cómo funciona?
Descubre cómo funciona Mask R-CNN, desde su red troncal y la red de propuestas de regiones hasta ROI Align y la predicción de máscaras, además de sus usos, límites y sucesores de YOLO.
 Abirami Vina10 min de lectura
Innovaciones como los robots en almacenes, los coches autónomos que circulan con seguridad por calles concurridas, los drones que supervisan cultivos y los sistemas de IA que inspeccionan productos en fábricas son cada vez más habituales a medida que aumenta la adopción de la IA. Una tecnología clave que impulsa estas innovaciones es la visión artificial, una rama de la IA que permite a las máquinas comprender e interpretar datos visuales.
Por ejemplo, la detección de objetos es una tarea de visión artificial que ayuda a identificar y localizar objetos en imágenes mediante cuadros delimitadores. Aunque los cuadros delimitadores proporcionan información útil, solo ofrecen una estimación aproximada de la posición de un objeto y no pueden captar su forma ni sus límites exactos. Por eso son menos eficaces en aplicaciones que requieren una identificación precisa.
Para resolver este problema, los investigadores desarrollaron modelos de segmentación que captan los contornos exactos de los objetos y proporcionan detalles a nivel de píxel para lograr una detección y un análisis más precisos.
Mask R-CNN es uno de estos modelos. Facebook Investigación en IA (FAIR) lo presentó en 2017, y se basa en modelos anteriores como R-CNN, Fast R-CNN y Faster R-CNN. Como hito importante en la historia de la visión artificial, Mask R-CNN allanó el camino para modelos más avanzados, como Ultralytics YOLO11.
En este artículo veremos qué es Mask R-CNN, cómo funciona, cuáles son sus aplicaciones y qué mejoras surgieron después, hasta llegar a Ultralytics YOLO11.
Introducción a Mask R-CNN#
Mask R-CNN, siglas de red neuronal convolucional basada en regiones con máscaras, es un modelo de aprendizaje profundo diseñado para tareas de visión artificial como la detección de objetos y la segmentación de instancias.
La segmentación de instancias va más allá de la detección de objetos tradicional: no solo identifica objetos en una imagen, sino que también delimita con precisión cada uno de ellos. Asigna una etiqueta única a cada objeto detectado y capta su forma exacta a nivel de píxel. Este enfoque detallado permite distinguir claramente los objetos que se solapan y tratar con precisión las formas complejas.
Mask R-CNN se basa en Faster R-CNN, que detecta y etiqueta objetos, pero no define sus formas exactas. Mask R-CNN mejora este enfoque al identificar los píxeles exactos que componen cada objeto, lo que permite analizar imágenes con mucho más detalle y precisión.
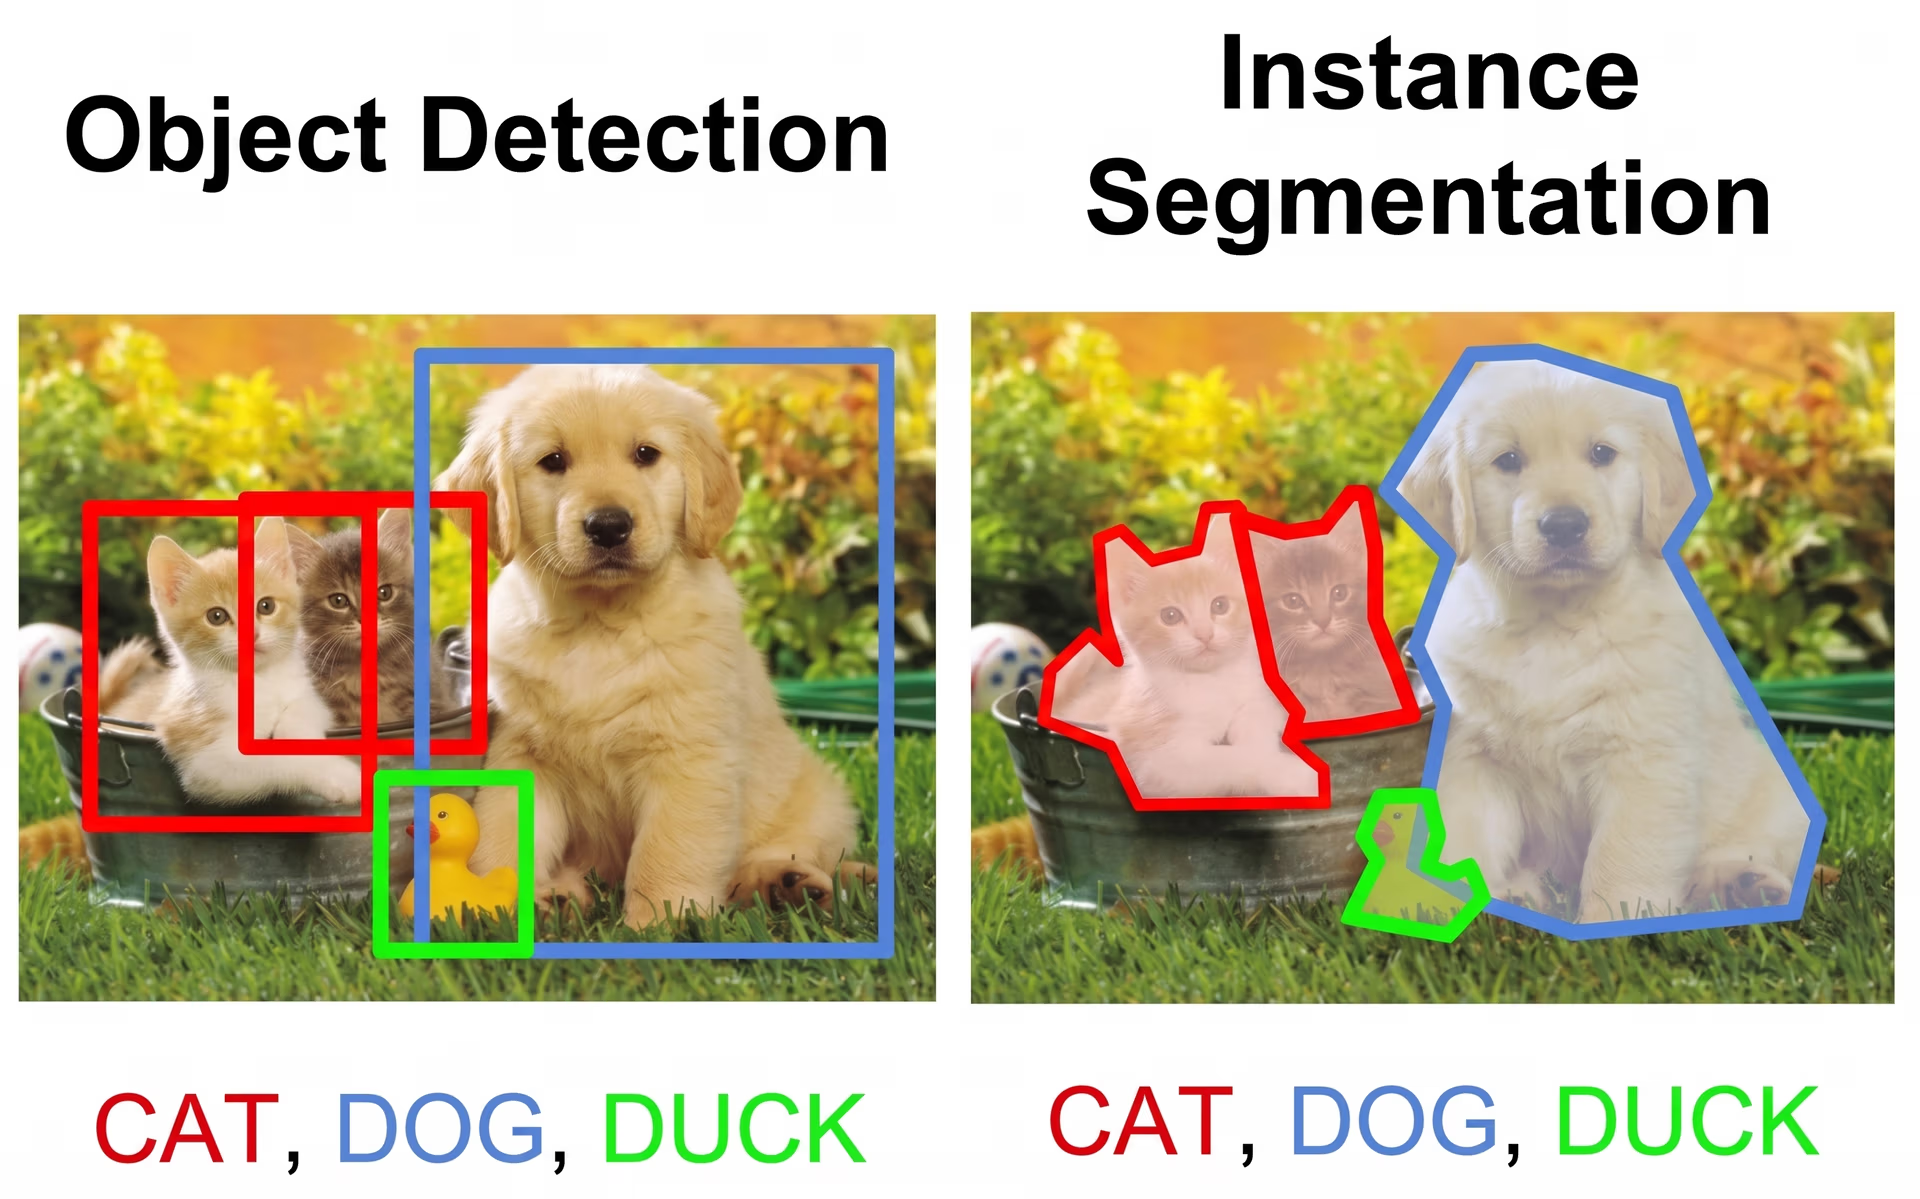
Fig. 1. Comparación entre la detección de objetos y la segmentación de instancias.
Arquitectura de Mask R-CNN y funcionamiento#
Mask R-CNN sigue un proceso paso a paso para detectar y segmentar objetos con precisión. Primero extrae características clave mediante una red neuronal profunda (un modelo de varias capas que aprende de los datos); después identifica posibles zonas con objetos mediante una red de propuestas de regiones (un componente que propone zonas donde probablemente haya objetos); por último, perfecciona estas zonas creando máscaras de segmentación detalladas (contornos precisos de los objetos) que captan la forma exacta de cada objeto.
A continuación, repasaremos cada paso para comprender mejor cómo funciona Mask R-CNN.
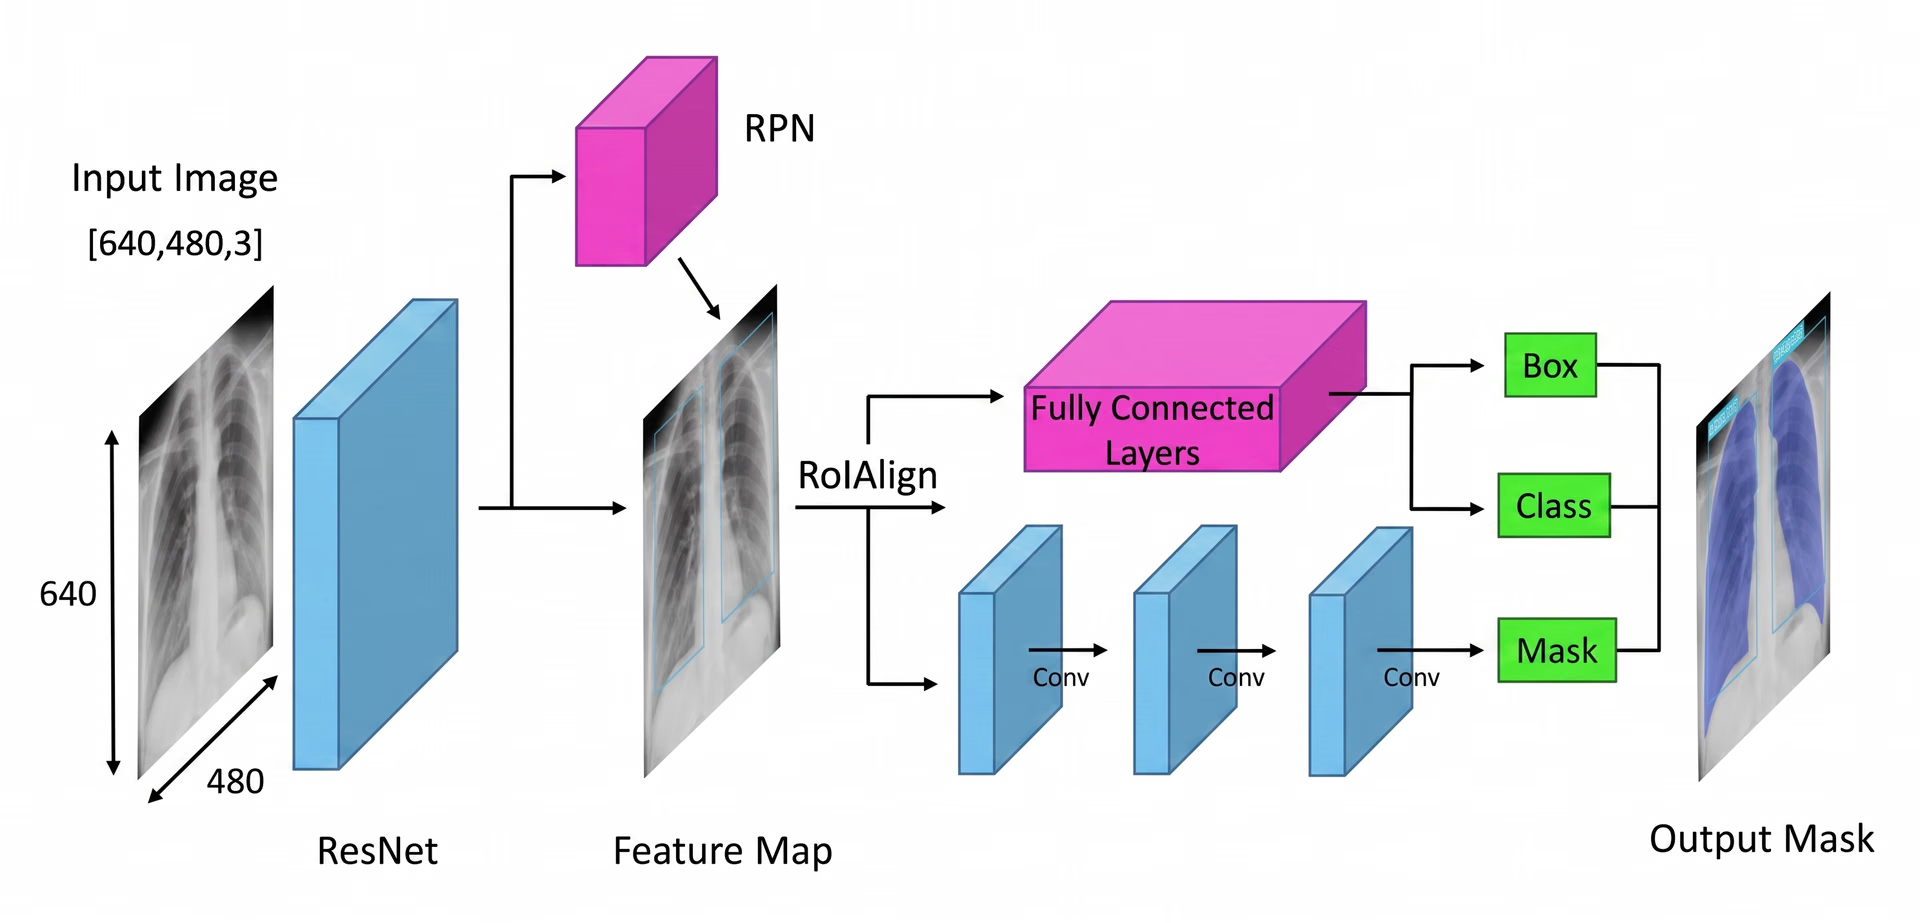
Fig. 2. Descripción general de la arquitectura de Mask R-CNN (fuente: researchgate.net).
Extracción de características#
El primer paso de la arquitectura de Mask R-CNN consiste en descomponer la imagen en sus partes principales para que el modelo entienda qué contiene. Es como cuando miras una foto y te fijas de forma natural en detalles como las formas, los colores y los bordes. El modelo hace algo parecido mediante una red neuronal profunda llamada «backbone» (a menudo ResNet-50 o ResNet-101), que actúa como sus ojos para explorar la imagen y captar los detalles clave.
Como los objetos de las imágenes pueden ser muy pequeños o muy grandes, Mask R-CNN utiliza una red piramidal de características. Es como disponer de lupas de distintos aumentos para que el modelo pueda ver tanto los detalles más precisos como el conjunto, y detectar objetos de cualquier tamaño.
Una vez extraídas estas características importantes, el modelo pasa a localizar los posibles objetos de la imagen, lo que prepara el terreno para análisis posteriores.
Propuesta de posibles zonas de la imagen con objetos#
Una vez procesada la imagen para extraer sus características clave, entra en acción la red de propuestas de regiones. Esta parte del modelo examina la imagen y propone zonas que probablemente contengan objetos.
Lo hace generando varias posibles ubicaciones de objetos denominadas anclas. A continuación, la red evalúa estas anclas y selecciona las más prometedoras para analizarlas con más detalle. Así, el modelo se centra solo en las zonas que probablemente resulten interesantes, en lugar de examinar cada punto de la imagen.
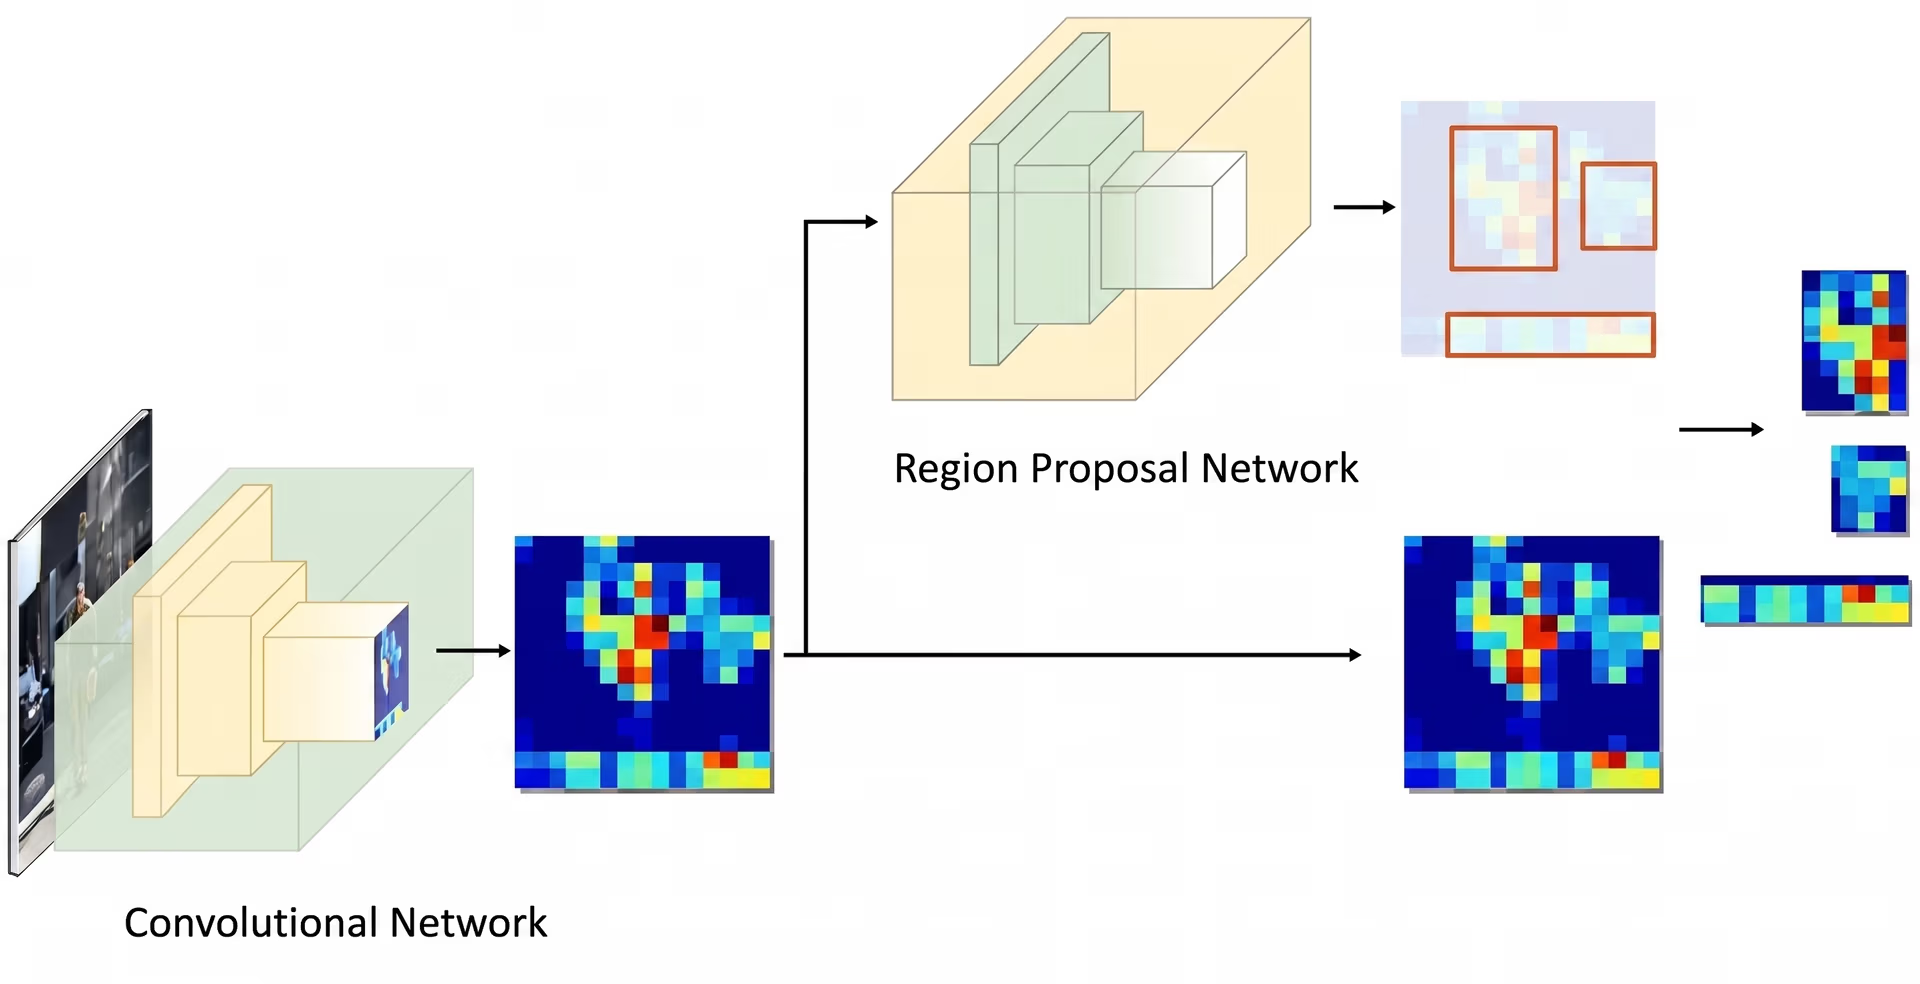
Fig. 3. Ejemplo de una red de propuestas de regiones.
Mejora de las características extraídas#
Una vez identificadas las zonas clave, el siguiente paso es perfeccionar los detalles extraídos de esas regiones. Los modelos anteriores utilizaban un método llamado agrupación de regiones de interés (ROI Pooling) para obtener características de cada zona, pero esta técnica a veces provocaba pequeños desajustes al cambiar el tamaño de las regiones, por lo que resultaba menos eficaz, sobre todo con objetos pequeños o solapados.
Mask R-CNN mejora este enfoque con una técnica llamada ROI Align (alineación de regiones de interés). En lugar de redondear las coordenadas, como hace ROI Pooling, ROI Align utiliza interpolación bilineal para estimar los valores de los píxeles con mayor precisión. La interpolación bilineal es un método que calcula el valor de un píxel nuevo mediante una media ponderada de los valores de sus cuatro vecinos más cercanos, lo que genera transiciones más suaves. Así, las características se mantienen correctamente alineadas con la imagen original, lo que permite detectar y segmentar objetos con mayor precisión.
Por ejemplo, en un partido de fútbol, dos jugadores que estén muy juntos podrían confundirse porque sus cuadros delimitadores se solapan. ROI Align ayuda a separarlos al mantener diferenciadas sus formas.
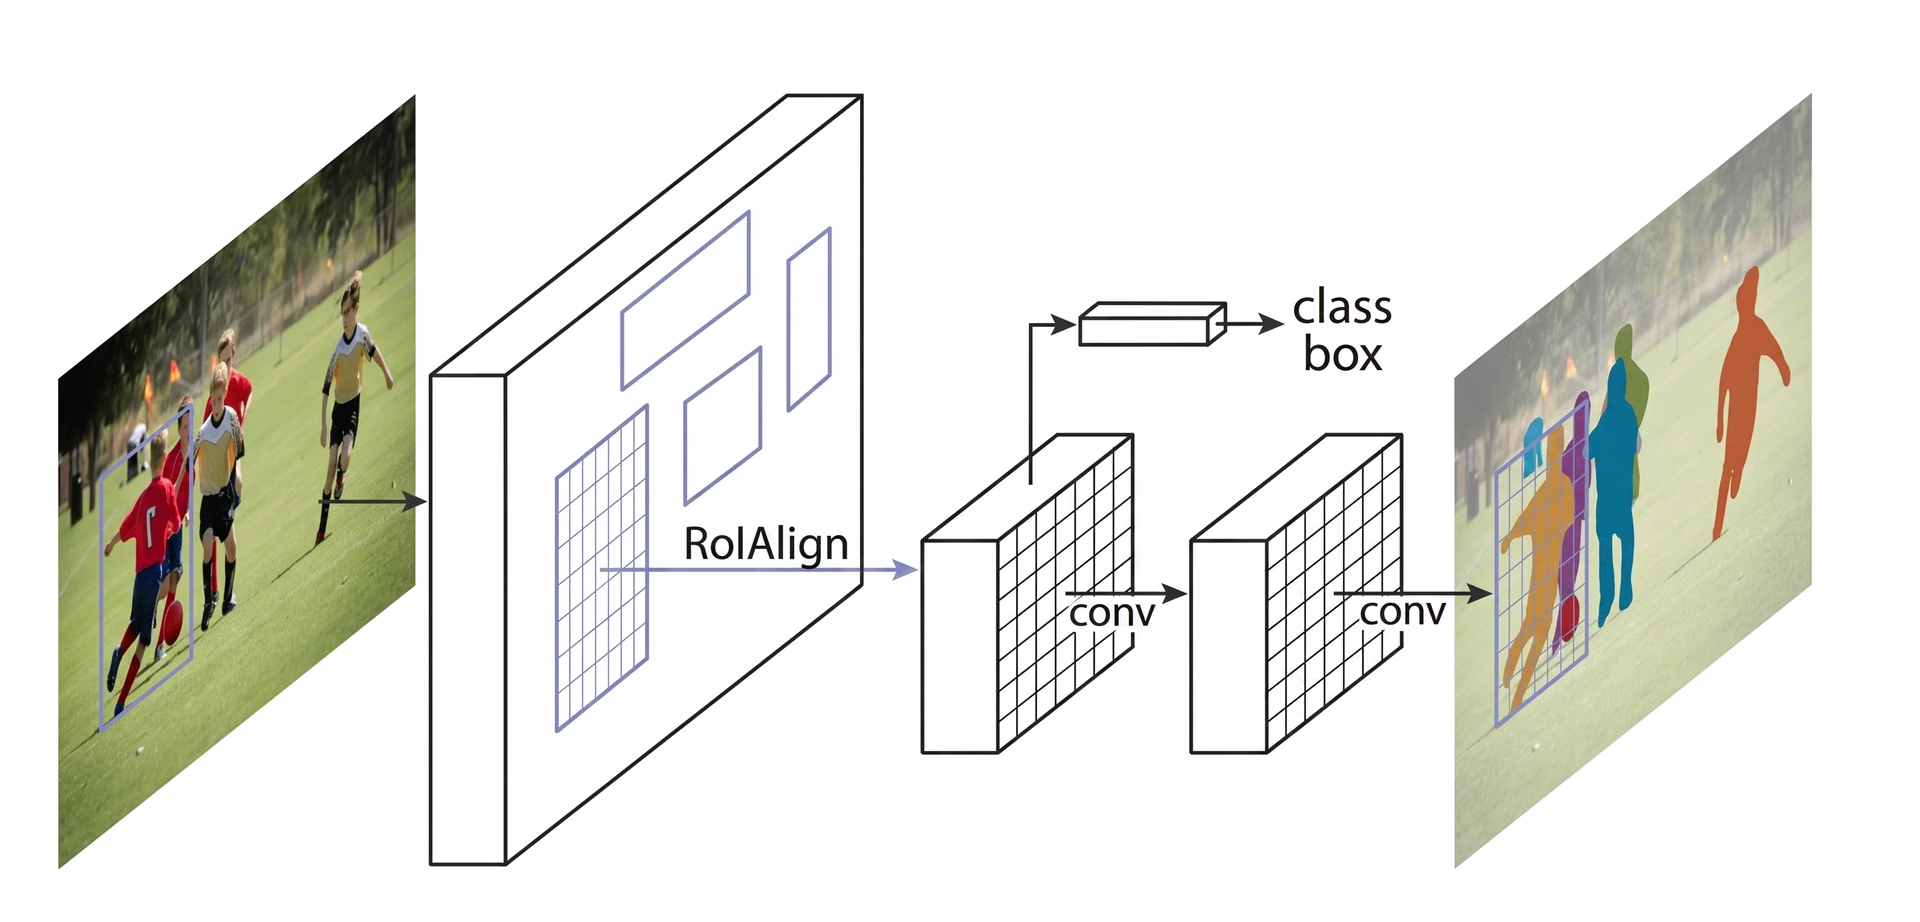
Fig. 4. Mask R-CNN utiliza ROI Align.
Clasificación de objetos y predicción de sus máscaras#
Una vez que ROI Align procesa la imagen, el siguiente paso consiste en clasificar los objetos y ajustar sus ubicaciones. El modelo analiza cada región extraída y decide qué objeto contiene. Asigna una puntuación de probabilidad a distintas categorías y elige la que mejor encaja.
Al mismo tiempo, ajusta los cuadros delimitadores para que se adapten mejor a los objetos. Es posible que los cuadros iniciales no estén colocados de forma óptima, por lo que este ajuste ayuda a mejorar la precisión al garantizar que cada cuadro rodee estrechamente el objeto detectado.
Por último, Mask R-CNN da un paso más: genera en paralelo una máscara de segmentación detallada para cada objeto.
Mask R-CNN y sus aplicaciones en el mundo real#
Cuando apareció este modelo, la comunidad de IA lo recibió con gran entusiasmo y pronto empezó a utilizarse en diversas aplicaciones. Su capacidad para detectar y segmentar objetos con precisión a nivel de píxel lo hizo popular en distintos sectores.
Por ejemplo, seguir a animales en peligro de extinción en estado salvaje es una tarea difícil. Muchas especies se desplazan por bosques densos, lo que complica su seguimiento por parte de los conservacionistas. Los métodos tradicionales utilizan cámaras trampa, drones e imágenes de satélite, pero revisar todos estos datos manualmente lleva mucho tiempo. Las identificaciones erróneas y los avistamientos que pasan desapercibidos pueden ralentizar los esfuerzos de conservación.
Al reconocer rasgos únicos, como las rayas de los tigres, las manchas de las jirafas o la forma de las orejas de los elefantes, Mask R-CNN puede detectar y segmentar animales en imágenes y vídeos con mayor precisión. Incluso cuando los animales están parcialmente ocultos por los árboles o muy juntos, el modelo puede separarlos e identificar cada uno individualmente, lo que agiliza y hace más fiable el seguimiento de la fauna.
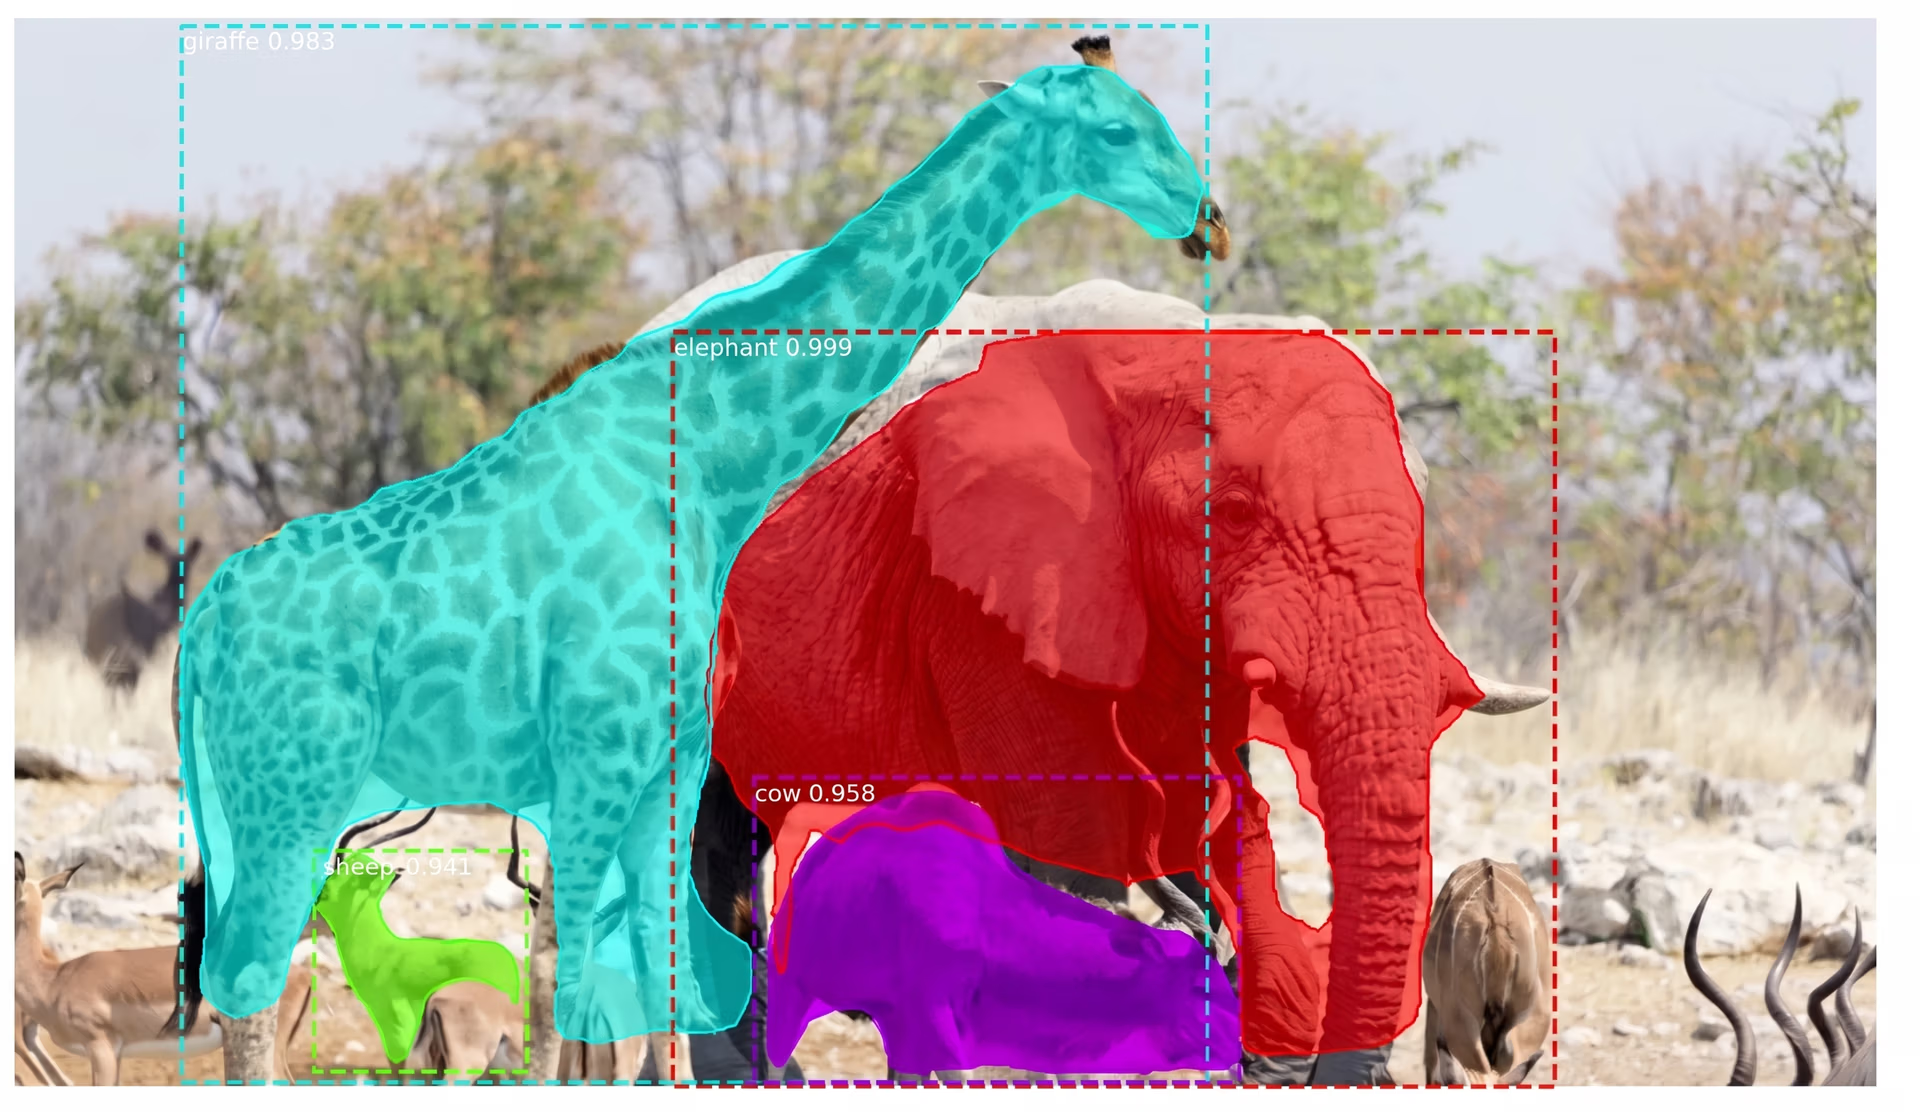
Fig. 5. Detección y segmentación de animales con Mask R-CNN.
Limitaciones de Mask R-CNN#
A pesar de su importancia histórica en la detección y segmentación de objetos, Mask R-CNN también presenta algunos inconvenientes importantes. Estos son algunos de los desafíos relacionados con Mask R-CNN:
- Alta demanda computacional: Depende de GPU potentes, lo que puede encarecer su ejecución y ralentizarla al procesar grandes volúmenes de datos.
- Menor velocidad de procesamiento: su proceso en varias etapas lo hace más lento que los modelos más rápidos para tiempo real, como YOLO, por lo que puede no ser ideal para tareas en las que el tiempo es fundamental.
- Dependencia de datos de alta calidad: el modelo ofrece mejores resultados con imágenes nítidas y bien etiquetadas. Las imágenes borrosas o mal iluminadas pueden reducir considerablemente su precisión.
- Implementación compleja: su arquitectura de varias etapas puede ser difícil de configurar y optimizar, sobre todo al trabajar con grandes conjuntos de datos o recursos limitados.
De Mask R-CNN a Ultralytics YOLO11#
Mask R-CNN era excelente para tareas de segmentación, pero muchos sectores buscaban adoptar la visión artificial priorizando la velocidad y el rendimiento en tiempo real. Esta necesidad llevó a los investigadores a desarrollar modelos de una sola etapa que detectan objetos en una única pasada, lo que mejora considerablemente la eficiencia.
A diferencia del proceso de varias etapas de Mask R-CNN, los modelos de visión artificial de una sola etapa, como YOLO (You Only Look Once, «solo tienes que mirar una vez»), se centran en tareas de visión artificial en tiempo real. En lugar de realizar la detección y la segmentación por separado, los modelos YOLO pueden detectar y segmentar objetos en una sola pasada. Esto los hace ideales para aplicaciones como la conducción autónoma, la sanidad, la fabricación y la robótica, donde es fundamental tomar decisiones rápidamente.
En concreto, Ultralytics YOLO11 —al que sucedió Ultralytics YOLO26— va un paso más allá, al combinar velocidad y precisión. Utiliza un 22 % menos de parámetros que YOLOv8m y, aun así, alcanza una precisión media promedio (mAP) superior en el conjunto de datos COCO, es decir, detecta los objetos con mayor precisión. Su mayor velocidad de procesamiento lo convierte en una buena opción para aplicaciones en tiempo real en las que cada milisegundo cuenta.
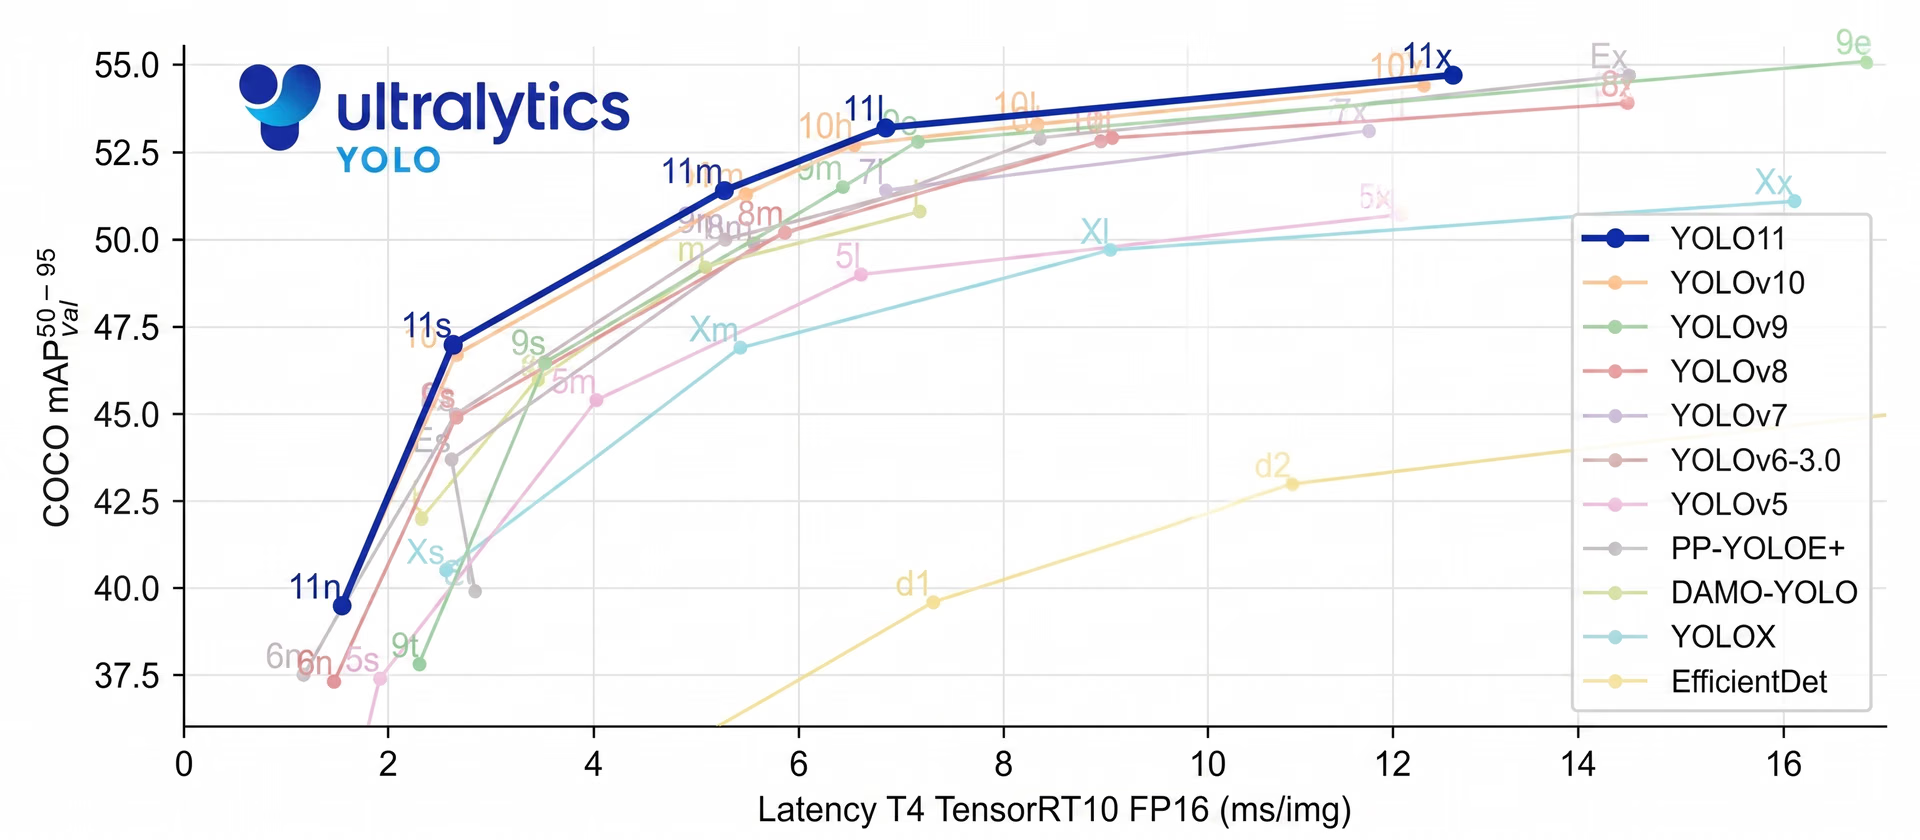
Fig. 6. Rendimiento de YOLO11 en comparación con otros modelos.
Conclusiones clave#
Al repasar la historia de la visión artificial, Mask R-CNN destaca como un gran avance en la detección y segmentación de objetos. Gracias a su detallado proceso de varias etapas, ofrece resultados muy precisos incluso en situaciones complejas.
Sin embargo, este mismo proceso hace que sea más lento que los modelos en tiempo real como YOLO. A medida que aumenta la necesidad de velocidad y eficiencia, muchas aplicaciones utilizan ahora modelos de una sola etapa como Ultralytics YOLO11, que ofrecen una detección de objetos rápida y precisa. Aunque Mask R-CNN sigue siendo importante para comprender la evolución de la visión artificial, el cambio hacia modelos en tiempo real refleja la creciente demanda de soluciones más rápidas y eficientes.
¡Únete a nuestra creciente comunidad! Explora nuestro repositorio de GitHub para aprender más sobre IA. ¿Preparado para iniciar tus propios proyectos de visión artificial? Echa un vistazo a nuestras opciones de licencia. Descubre la IA en la agricultura y la IA visual en la sanidad en nuestras páginas de soluciones.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









