Découvre la fiche du modèle Claude 3 et ce qu’elle implique pour l’IA visuelle
Découvre la fiche de modèle Claude 3 d’Anthropic : les performances d’Opus, Sonnet et Haiku dans les benchmarks de vision, et leurs limites pour les tâches de vision par ordinateur.
 Mostafa Ibrahim9 min de lecture
Ces dernières années, l’IA visuelle a fait d’importants progrès et transformé des secteurs allant de la santé au commerce de détail. Comprendre les modèles sous-jacents et leur documentation est essentiel pour tirer pleinement parti de ces avancées. La fiche de modèle, qui présente de manière complète les caractéristiques et les performances d’un modèle d’IA, est un outil indispensable pour les développeurs en IA.
Dans cet article, nous allons examiner la fiche descriptive du modèle Claude 3, développé par Anthropic, ainsi que ses implications pour le développement de l’IA pour la vision. Claude 3 est une nouvelle famille de grands modèles multimodaux composée de trois variantes : Claude 3 Opus, le modèle le plus performant ; Claude 3 Sonnet, qui équilibre performances et rapidité ; et Claude 3 Haiku, l’option la plus rapide et la plus économique. Chaque modèle est désormais doté de capacités de vision qui lui permettent de traiter et d’analyser des données d’image.
Présentation de la fiche descriptive du modèle Claude 3#
Qu’est-ce qu’une fiche de modèle, exactement ? Une fiche de modèle est un document détaillé qui donne des informations sur le développement, l’entraînement et l’évaluation d’un modèle de machine learning. Elle vise à promouvoir la transparence, la responsabilité et l’utilisation éthique de l’IA en présentant clairement les fonctionnalités du modèle, ses cas d’usage prévus et ses limites potentielles. Pour ce faire, elle fournit des données détaillées sur le modèle, notamment ses résultats d’évaluation et sa comparaison avec les modèles précédents et ceux de la concurrence.
Métriques d’évaluation#
Les métriques d’évaluation sont essentielles pour mesurer les performances d’un modèle. La fiche de modèle de Claude 3 présente des scores obtenus sur des benchmarks standard du secteur, offrant un aperçu clair de ses points forts et des aspects à améliorer. Ces scores sont comparés à ceux d’autres modèles de premier plan, mettant en évidence les performances concurrentielles de Claude 3.
En outre, Claude 3 s’appuie sur les points forts de ses prédécesseurs et intègre des avancées en matière d’architecture et de techniques d’entraînement. La fiche descriptive compare Claude 3 aux versions précédentes et met en évidence les améliorations en matière d’exactitude, d’efficacité et d’adaptabilité à de nouveaux cas d’usage.
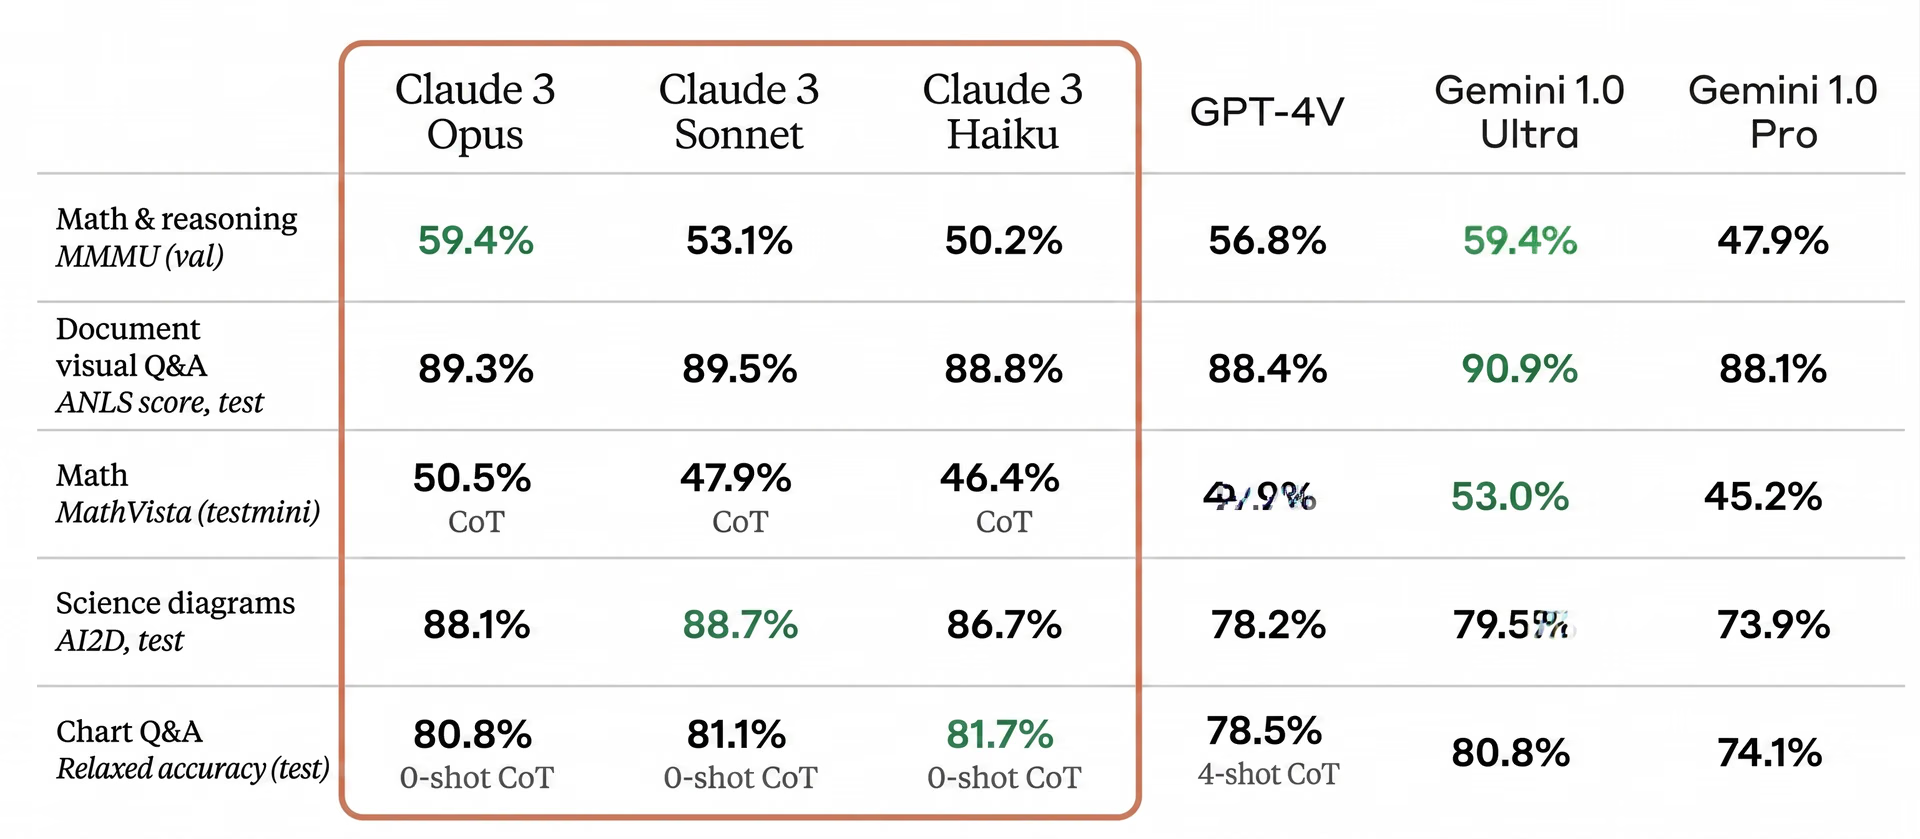
Fig. 1. Tableau comparant les modèles Claude 3 à d’autres modèles sur diverses tâches.
Quel est l’effet de Claude 3 sur le développement de l’IA pour la vision ?#
L’architecture et le processus d’entraînement de Claude 3 lui permettent d’obtenir des performances fiables dans diverses tâches de traitement automatique du langage naturel (NLP) et tâches visuelles. Il obtient régulièrement de très bons résultats dans les évaluations comparatives, démontrant ainsi sa capacité à réaliser efficacement des analyses linguistiques complexes.
L’entraînement de Claude 3 sur des jeux de données variés garantit sa robustesse et sa capacité à généraliser à différents scénarios. Le modèle est ainsi polyvalent et efficace dans de nombreuses applications.
Bien que ses résultats soient remarquables, Claude 3 est fondamentalement un grand modèle de langage (LLM). Même si les LLM comme Claude 3 peuvent effectuer diverses tâches de vision par ordinateur, ils n’ont pas été spécialement conçus pour des tâches comme la détection d’objets, la création de boîtes englobantes et la segmentation d’images. Par conséquent, leur précision dans ces domaines peut être inférieure à celle de modèles spécialement conçus pour la vision par ordinateur, comme Ultralytics YOLOv8. Les LLM excellent néanmoins dans d’autres domaines, en particulier le traitement automatique du langage naturel (NLP), où Claude 3 se distingue par sa capacité à combiner des tâches visuelles simples avec le raisonnement humain.
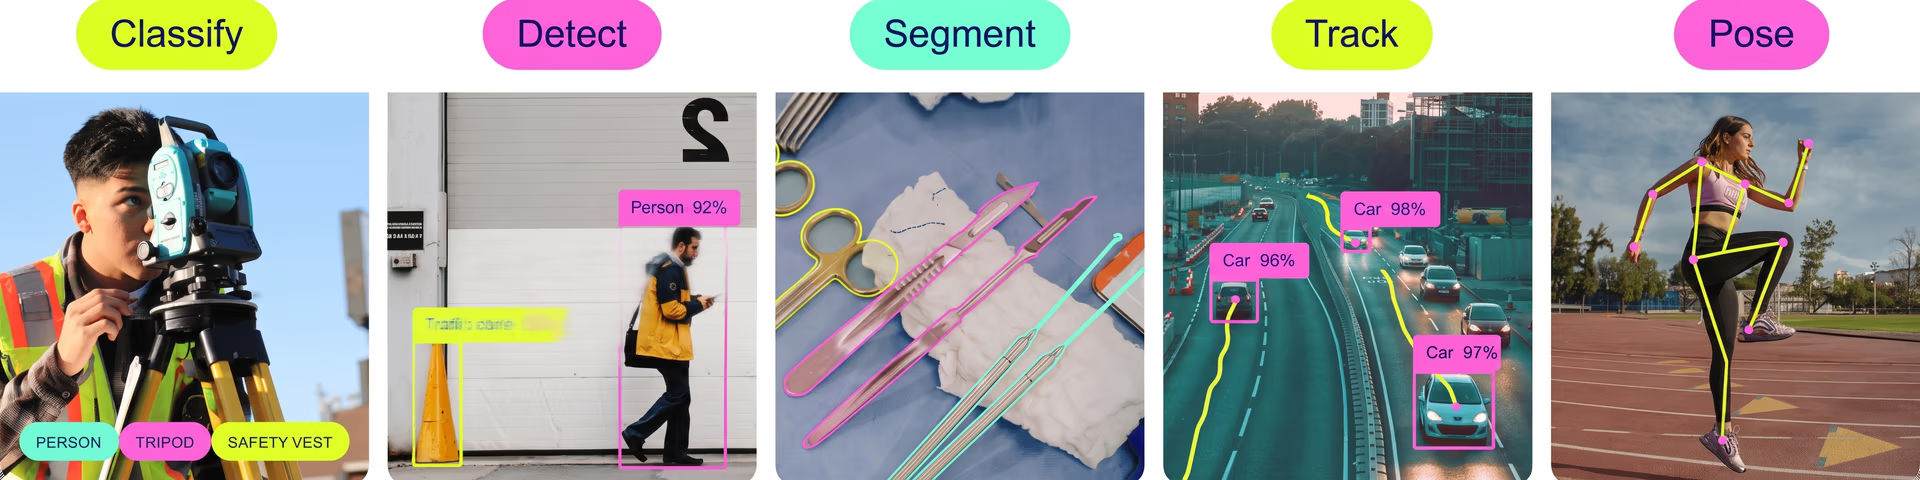
Fig. 2. Présentation de la classification d’objets, de la détection, de la segmentation, du suivi et de l’estimation de pose avec Ultralytics YOLOv8.
Les capacités de NLP désignent l’aptitude d’un modèle d’IA à comprendre le langage humain et à y répondre. Claude 3 exploite largement cette capacité dans ses applications au domaine visuel, ce qui lui permet de fournir des descriptions riches en contexte, d’interpréter des données visuelles complexes et d’améliorer ses performances globales dans les tâches d’IA pour la vision.
Conversion d’image en texte#
L’une des capacités impressionnantes de Claude 3, en particulier pour les tâches d’IA pour la vision, est son aptitude à traiter et à convertir en texte des images de mauvaise qualité contenant une écriture manuscrite difficile à lire. Cette fonctionnalité illustre la puissance avancée de traitement du modèle et ses capacités de raisonnement multimodal. Dans cette section, nous verrons comment Claude 3 accomplit cette tâche, en mettant en évidence les mécanismes sous-jacents et les implications pour le développement de l’IA pour la vision.
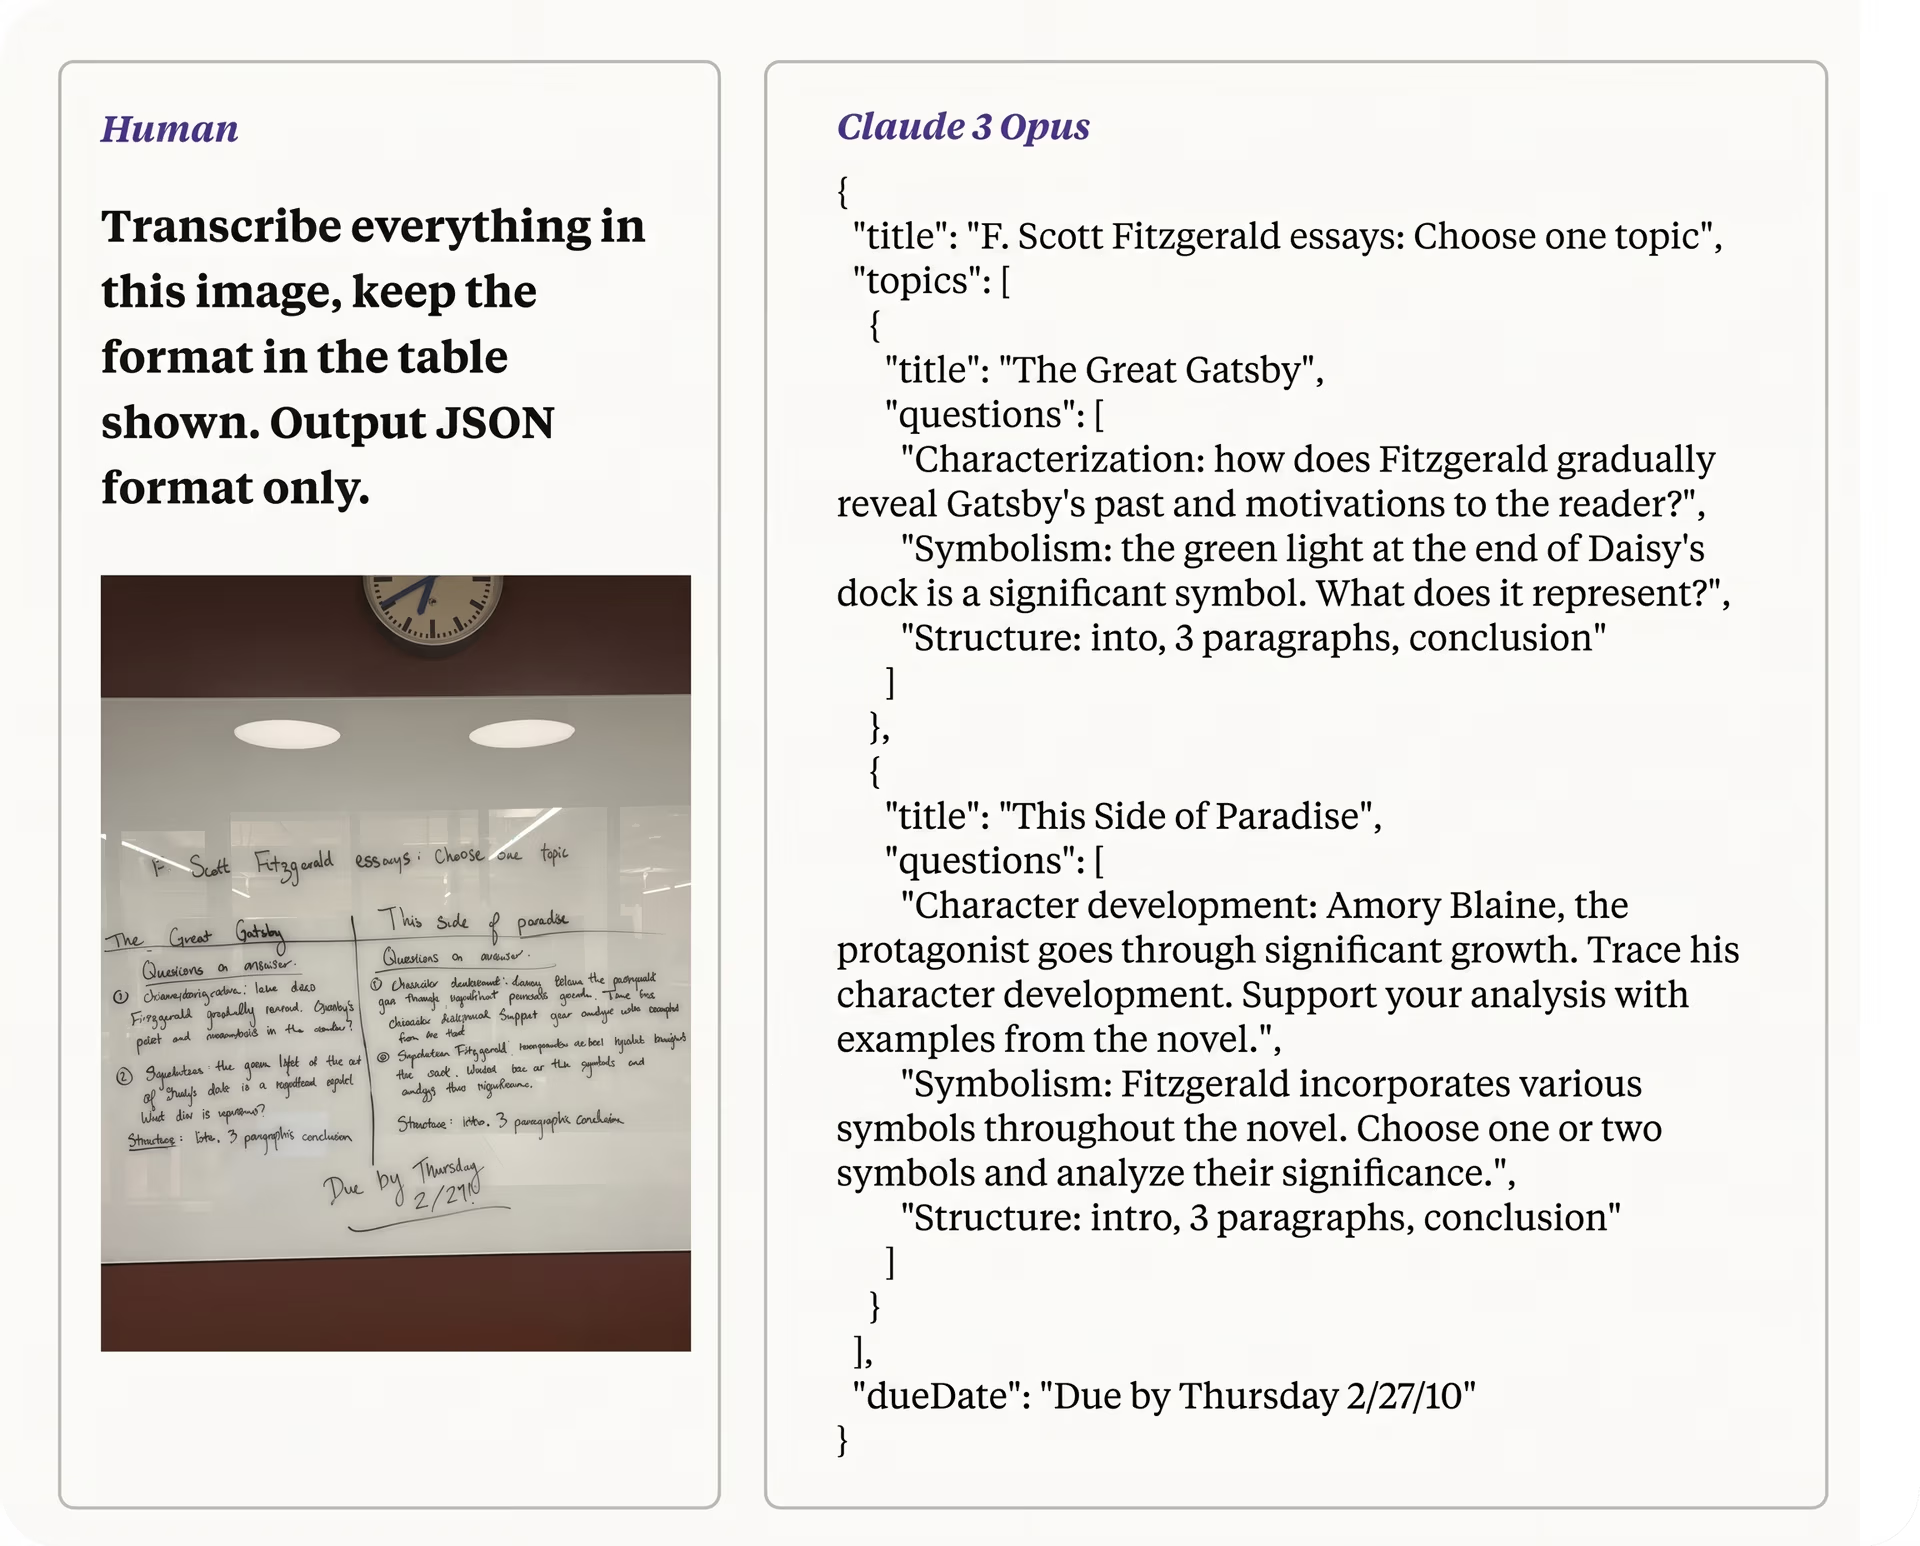
Fig. 3. Claude 3 Opus convertissant en texte une photo de mauvaise qualité contenant une écriture manuscrite difficile à lire.
Comprendre les défis#
La conversion en texte d’une photo de mauvaise qualité contenant une écriture manuscrite difficile à lire est une tâche complexe qui présente plusieurs défis :
- Qualité de l’image : une faible résolution, le bruit et un mauvais éclairage peuvent masquer les détails de l’image.
- Variabilité de l’écriture manuscrite : les styles d’écriture varient considérablement d’une personne à l’autre, ce qui complique la reconnaissance et l’interprétation du texte par les modèles.
- Compréhension du contexte : convertir fidèlement une écriture manuscrite en texte nécessite de comprendre le contexte afin de lever les ambiguïtés.
Comme indiqué précédemment, les modèles Claude 3 relèvent ces défis en combinant des techniques avancées de vision par ordinateur et de traitement automatique du langage naturel (NLP).
Raisonnement à partir d’éléments visuels (multimodal)#
L’architecture de Claude 3 lui permet d’effectuer des tâches de raisonnement complexe à partir d’entrées visuelles. Par exemple, comme le montre la fig. 4, le modèle peut interpréter des graphiques et des diagrammes, par exemple identifier les pays du G7 dans un graphique sur l’utilisation d’Internet, extraire des données pertinentes et effectuer des calculs pour analyser les tendances. Ce raisonnement en plusieurs étapes, comme le calcul des différences statistiques d’utilisation d’Internet entre les groupes d’âge, améliore la précision du modèle et son utilité dans des applications concrètes.
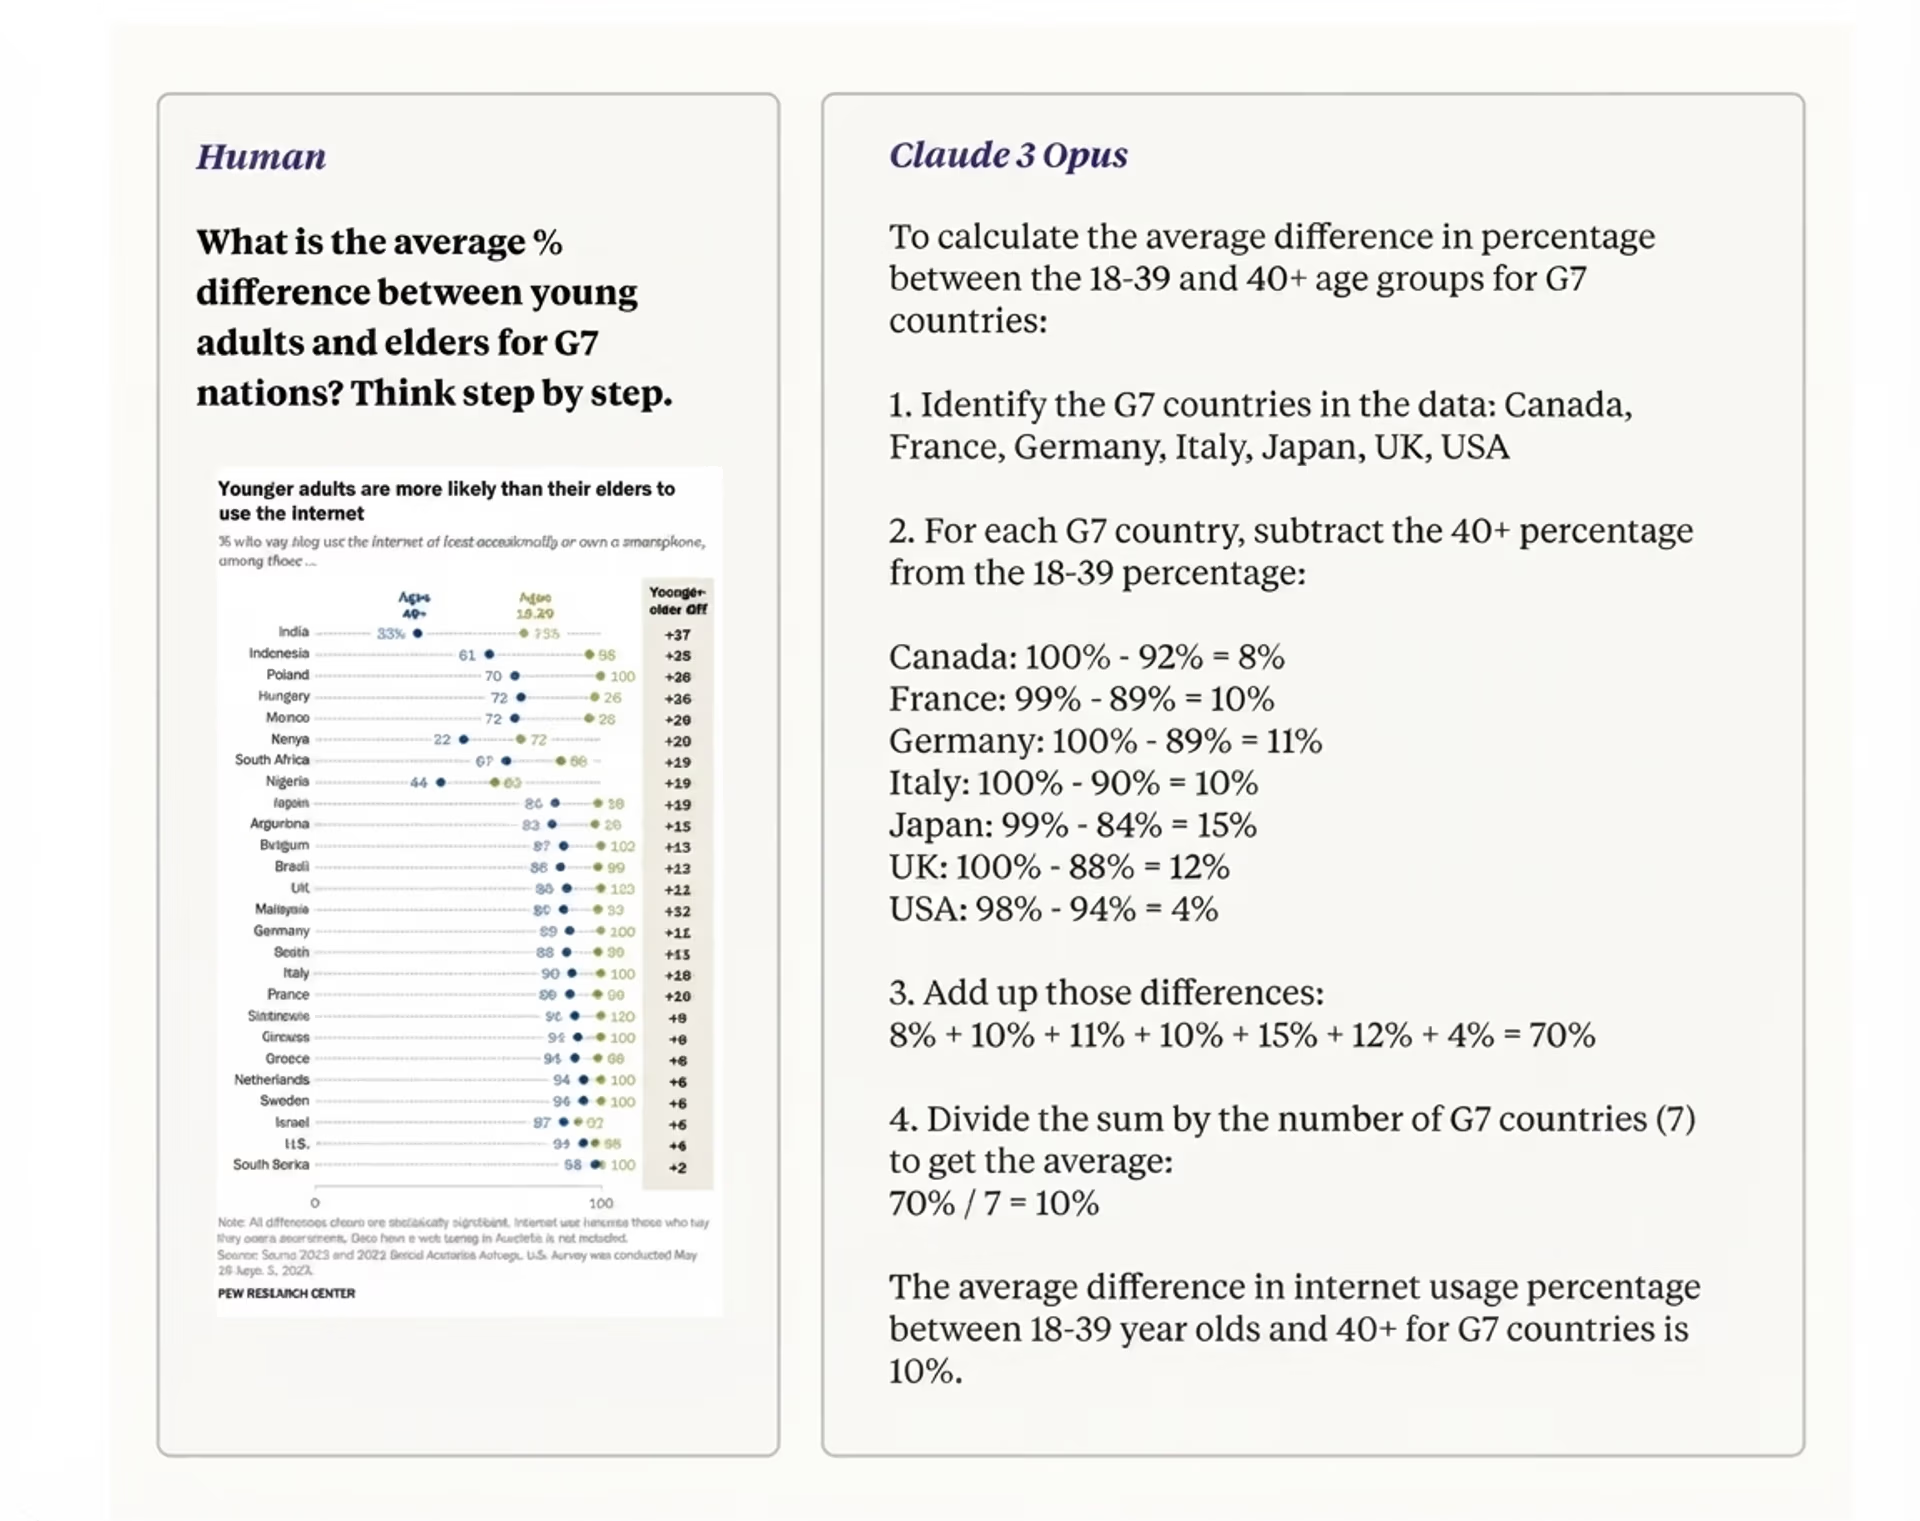
Fig. 4. Claude 3 Opus effectuant plusieurs tâches de raisonnement à partir d’un graphique visuel.
Décrire des images#
Claude 3 excelle à transformer des images en descriptions détaillées, ce qui témoigne de ses puissantes capacités en vision par ordinateur et en traitement du langage naturel. Il peut générer des descriptions précises et riches en contexte, en identifiant les objets, mais aussi en comprenant leurs interactions et leur importance dans la scène.
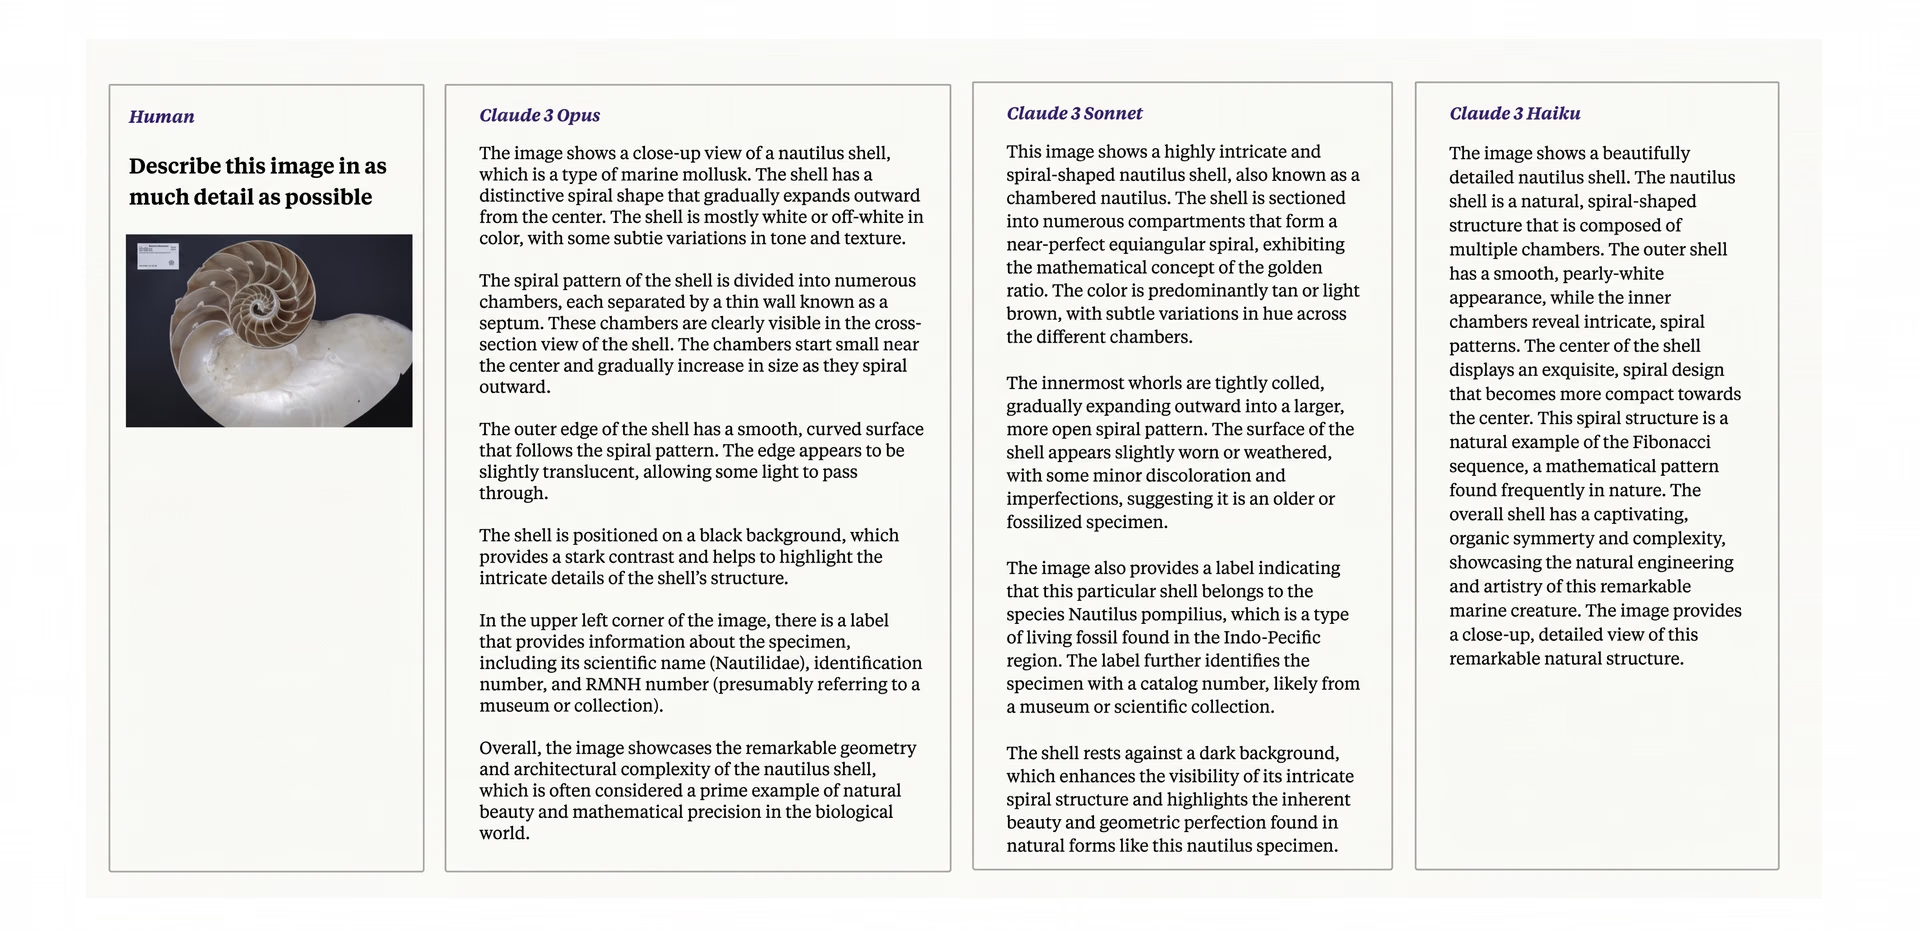
Fig. 5. Claude 3 comprend les objets visuels d’une image et les décrit dans un langage compréhensible par les humains.
Défis et revers des modèles Claude 3 en vision par ordinateur#
Pas orienté vision par ordinateur#
Les grands modèles de langage (LLM) comme Claude 3 excellent dans le traitement automatique du langage naturel, et non en vision par ordinateur. Ils peuvent décrire des images, mais les tâches comme la détection d’objets et la segmentation d’images sont mieux prises en charge par des modèles orientés vision comme Ultralytics YOLOv8. Ces modèles spécialisés sont optimisés pour les tâches visuelles et offrent de meilleures performances pour l’analyse d’images. De plus, Claude 3 ne peut pas effectuer de tâches telles que la création de boîtes englobantes.
Complexité de l’intégration#
Combiner Claude 3 avec des systèmes de vision par ordinateur peut être complexe et nécessiter des étapes de traitement supplémentaires pour combler l’écart entre les données textuelles et visuelles.
Limites des données d’entraînement#
Claude 3 est principalement entraîné sur de grandes quantités de données textuelles, ce qui signifie qu’il ne dispose pas des vastes jeux de données visuelles nécessaires pour obtenir de hautes performances dans les tâches de vision par ordinateur. Ainsi, même si Claude 3 excelle dans la compréhension et la génération de texte, il ne peut pas traiter ni analyser les images avec le même niveau de compétence que les modèles spécialement conçus pour les données visuelles. Cette limite le rend moins efficace pour les applications qui nécessitent d’interpréter ou de générer du contenu visuel.
Le potentiel futur de Claude 3 en IA visuelle#
Comme les autres grands modèles de langage, Claude 3 devrait continuer à s’améliorer. Les futures améliorations porteront probablement sur de meilleures performances pour les tâches visuelles, comme la détection d’images et la reconnaissance d’objets, ainsi que sur les progrès du traitement du langage naturel. Ces améliorations permettront de décrire les objets et les scènes avec plus de précision et de détail, entre autres tâches similaires. Les modèles Claude plus récents, comme Claude Opus 5.5 et Claude Haiku 5.5, peuvent détecter des objets avec des boîtes englobantes, et les résultats du benchmark VLM montrent comment ils se comparent à d’autres modèles de vision-langage.
Enfin, les recherches en cours sur Claude 3 donneront la priorité à l’amélioration de l’interprétabilité, à la réduction des biais et à une meilleure généralisation à partir de jeux de données diversifiés. Ces efforts garantiront la robustesse des performances du modèle dans différentes applications et renforceront la confiance dans ses résultats.
Pour conclure#
La fiche de modèle de Claude 3 est une ressource précieuse pour les développeurs et les parties prenantes de l’IA visuelle. Elle fournit des informations détaillées sur l’architecture du modèle, ses performances et ses considérations éthiques. En favorisant la transparence et la responsabilité, elle contribue à garantir une utilisation responsable et efficace des technologies d’IA. À mesure que l’IA visuelle évolue, les fiches de modèle comme celle de Claude 3 joueront un rôle essentiel pour guider le développement et renforcer la confiance dans les systèmes d’IA.
Chez Ultralytics, nous sommes passionnés par les progrès de l’IA. Pour découvrir nos solutions d’IA et rester au courant de nos dernières innovations, consulte notre dépôt GitHub. Rejoins notre communauté sur Discord et découvre comment nous transformons des secteurs comme les voitures autonomes et l’industrie manufacturière !
Écrit par
Ingénieur logiciel et rédacteur technique · Indépendant
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









