Exporter et optimiser Ultralytics YOLOv8 pour l’inférence avec Intel OpenVINO
Exporte et optimise un modèle Ultralytics YOLOv8 avec OpenVINO pour obtenir une inférence jusqu’à 3 fois plus rapide sur les CPU et GPU Intel, puis compare ses performances à celles de PyTorch.
 Nuvola Ladi4 min de lecture
Dans cet article de blog, nous allons voir comment exporter et optimiser ton modèle Ultralytics YOLOv8, préentraîné ou entraîné sur mesure, pour effectuer l’inférence avec OpenVINO. Si tu utilises un système basé sur Intel, qu’il soit équipé d’un CPU ou d’un GPU, ce guide te montrera comment accélérer considérablement ton modèle avec un minimum d’effort.
Pourquoi optimiser Ultralytics YOLOv8 avec OpenVINO ?#
L’optimisation de ton modèle Ultralytics YOLOv8 avec OpenVINO peut accélérer jusqu’à trois fois l’inférence, en particulier si tu utilises un CPU Intel. Ce gain de performance peut faire une grande différence dans les applications en temps réel, de la détection d’objets à la segmentation en passant par les systèmes de sécurité.
Étapes pour exporter et optimiser ton modèle Ultralytics YOLOv8#
Comprendre le processus#
Commençons par détailler le processus. Nous allons convertir un modèle PyTorch au format OpenVINO et l’optimiser. Au moment de la vidéo, cette conversion passait par ONNX comme étape intermédiaire ; les versions actuelles d’Ultralytics convertissent directement depuis PyTorch. Le processus comporte quelques étapes simples et peut s’appliquer à différents modèles et formats, notamment TensorFlow, PyTorch et ONNX.
Exporter le modèle#
En parcourant la documentation Ultralytics, on découvre que l’exportation d’un modèle YOLOv8 consiste à utiliser la méthode export du framework Ultralytics. Cette méthode convertit notre modèle PyTorch et l’optimise pour OpenVINO. Le résultat est un modèle qui s’exécute nettement plus rapidement sur le matériel Intel.
Installer les dépendances#
Avant d’exécuter le script d’exportation, tu dois t’assurer que toutes les dépendances nécessaires sont installées. Il s’agit notamment de la bibliothèque Ultralytics et d’OpenVINO. L’installation de ces paquets est simple et peut se faire avec pip, le gestionnaire de paquets Python.
Exécuter le script d’exportation#
Une fois ton environnement configuré, tu peux exécuter ton script d’exportation. Ce script convertira ton modèle PyTorch en modèle OpenVINO. Le processus est simple et consiste à appeler une seule fonction pour effectuer l’exportation. Le framework Ultralytics facilite la conversion et l’optimisation de tes modèles, afin d’obtenir les meilleures performances sans difficulté.
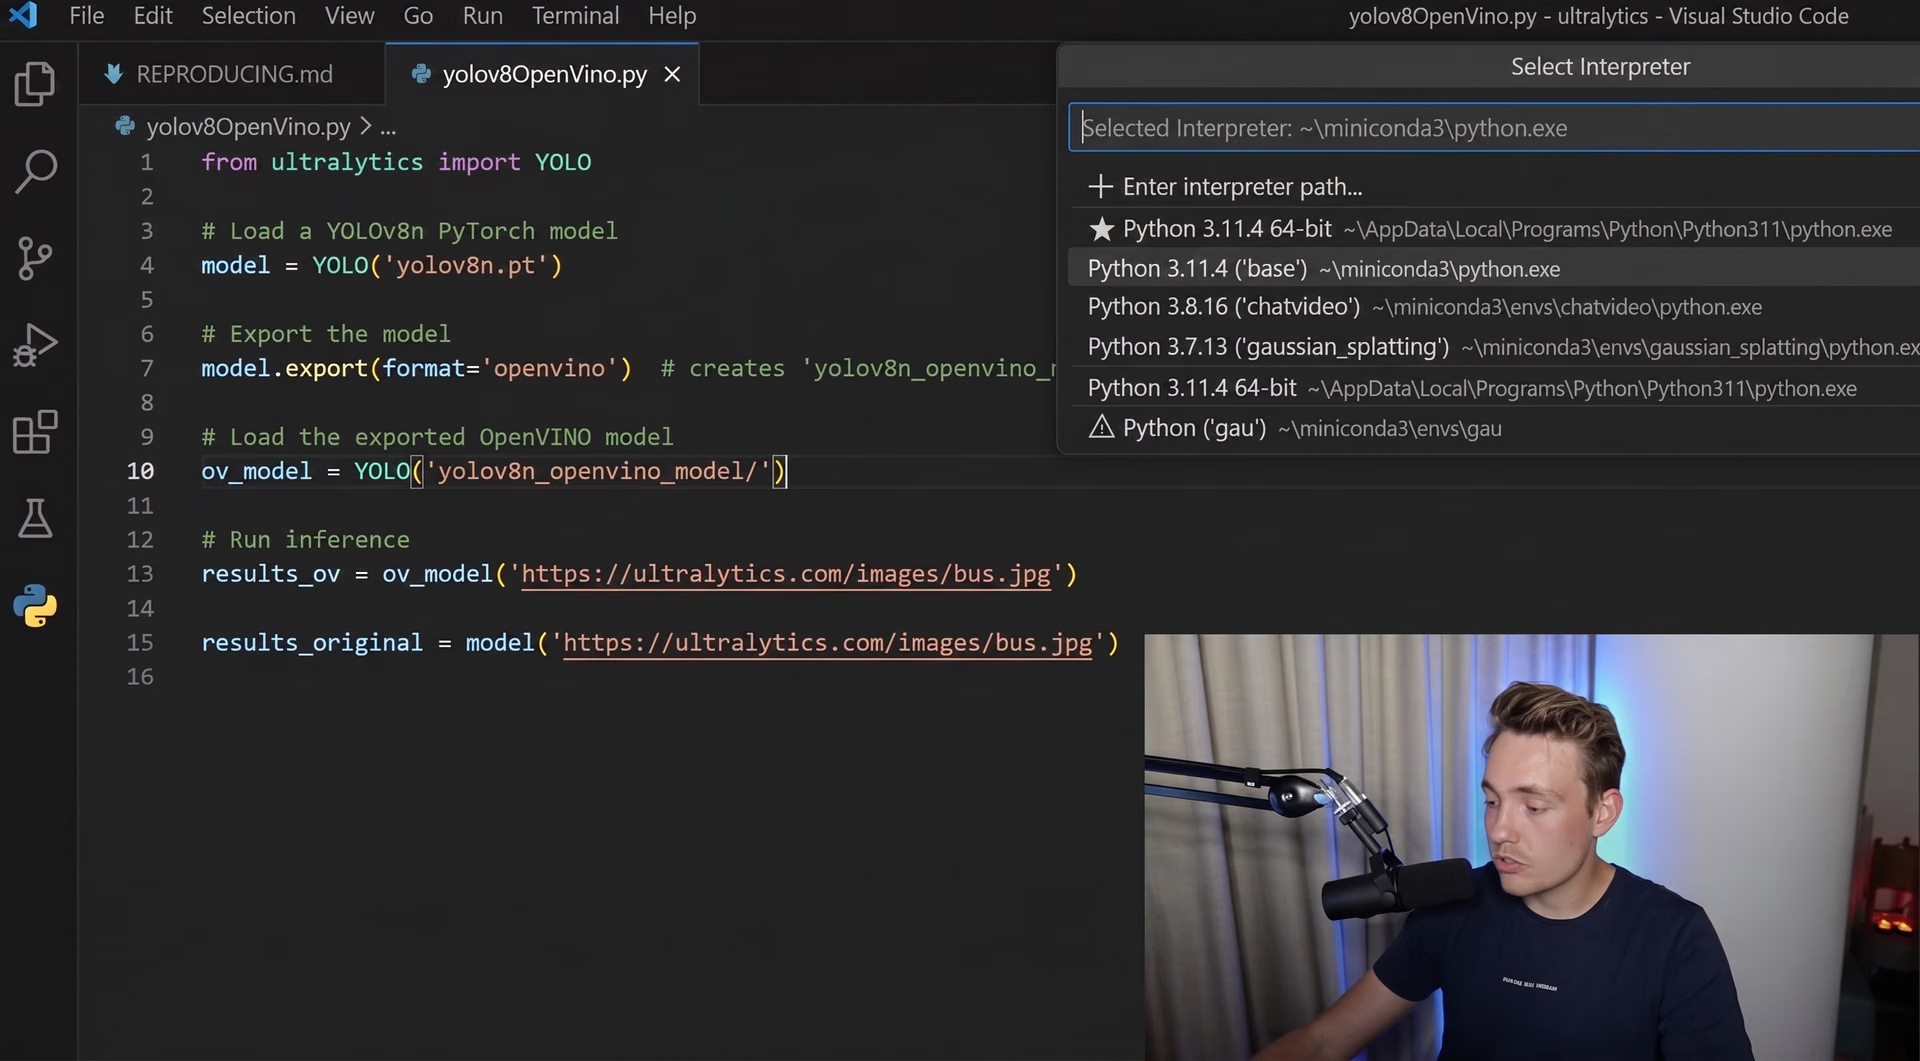
Fig. 1. Nicolai Nielsen expliquant comment exécuter le script d’exportation.
Comparer les performances#
Après l’exportation, il est essentiel de comparer les performances des modèles d’origine et optimisé. En mesurant le temps d’inférence des deux modèles, tu peux constater clairement les gains de performances. En général, le modèle OpenVINO affiche un temps d’inférence nettement inférieur à celui du modèle PyTorch d’origine. C’est particulièrement vrai pour les modèles de grande taille, pour lesquels le gain de performances est le plus visible.
Applications et avantages dans le monde réel#
L’optimisation des modèles Ultralytics YOLOv8 avec OpenVINO est particulièrement avantageuse pour les applications qui nécessitent un traitement en temps réel. En voici quelques exemples :
- Systèmes de sécurité : la détection d’objets en temps réel peut alerter immédiatement le personnel de sécurité, améliorant ainsi la sûreté et la réactivité.
- Véhicules automatisés : des vitesses d’inférence plus élevées améliorent la réactivité des systèmes de conduite autonome, ce qui les rend plus sûrs et plus fiables.
- Santé : le traitement rapide des images pour les outils de diagnostic peut sauver des vies en fournissant des résultats plus rapidement et en permettant des interventions en temps opportun.
En mettant en œuvre ces optimisations, tu améliores non seulement les performances, mais aussi la fiabilité et l’efficacité de tes applications. Cela peut améliorer l’expérience utilisateur, accroître la productivité et favoriser des solutions plus innovantes.
Pour conclure#
Exporter et optimiser un modèle Ultralytics YOLOv8 pour OpenVINO est un moyen efficace d’utiliser le matériel Intel afin d’accélérer et d’améliorer l’efficacité des applications d’IA. En quelques étapes simples, tu peux améliorer considérablement les performances de ton modèle et l’appliquer efficacement à des situations concrètes.
N’hésite pas à consulter d’autres tutoriels et guides Ultralytics, comme le cours OpenVINO sur CPU de l’Ultralytics Academy, pour continuer à améliorer tes projets d’IA. Visite notre dépôt GitHub et rejoins la communauté Ultralytics pour découvrir d’autres informations et actualités.
N’oublie pas que l’optimisation de tes modèles ne vise pas seulement à les rendre plus rapides : elle permet d’explorer de nouvelles possibilités et de garantir que tes solutions d’IA sont robustes, efficaces et prêtes pour l’avenir.
Écrit par
Responsable du contenu numérique · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









