Pourquoi Ultralytics YOLO26 supprime le NMS et comment cela change le déploiement
Découvre comment Ultralytics YOLO26 permet une inférence véritablement de bout en bout, sans NMS, et pourquoi la suppression du post-traitement simplifie l’export et le déploiement en périphérie.
 Abirami Vina12 min de lecture
Le 14 janvier 2026, nous avons lancé Ultralytics YOLO26, la dernière génération de nos modèles de vision par ordinateur. Avec YOLO26, notre objectif n’était pas seulement d’améliorer la précision ou la vitesse, mais de repenser la façon dont les modèles de détection d’objets sont conçus et déployés dans des systèmes du monde réel.
À mesure que la vision par ordinateur passe de la recherche à la production, les modèles doivent de plus en plus fonctionner sur des CPU, des appareils périphériques, des caméras, des robots et du matériel embarqué. Dans ces environnements, la fiabilité, la faible latence et la facilité de déploiement comptent autant que les performances.
Ultralytics YOLO26 a été conçu pour répondre à cette réalité, grâce à une architecture de bout en bout rationalisée qui élimine toute complexité inutile du pipeline d’inférence. L’une des principales innovations de YOLO26 est la possibilité de supprimer la suppression non maximale, communément appelée NMS.
Depuis des années, la NMS est une étape standard des systèmes de détection d’objets, utilisée comme traitement postérieur pour éliminer les détections en double. Bien qu’efficace, elle ajoute aussi des calculs et des difficultés de déploiement, en particulier sur le matériel périphérique.
Avec YOLO26, nous avons adopté une approche différente. En repensant la génération et l’entraînement des prédictions, nous permettons une inférence véritablement de bout en bout, sans NMS. Le modèle produit directement les détections finales, sans dépendre d’étapes de nettoyage externes ni de règles conçues manuellement. Cela accélère YOLO26, facilite son exportation et améliore la fiabilité de son déploiement sur un large éventail de plateformes matérielles.
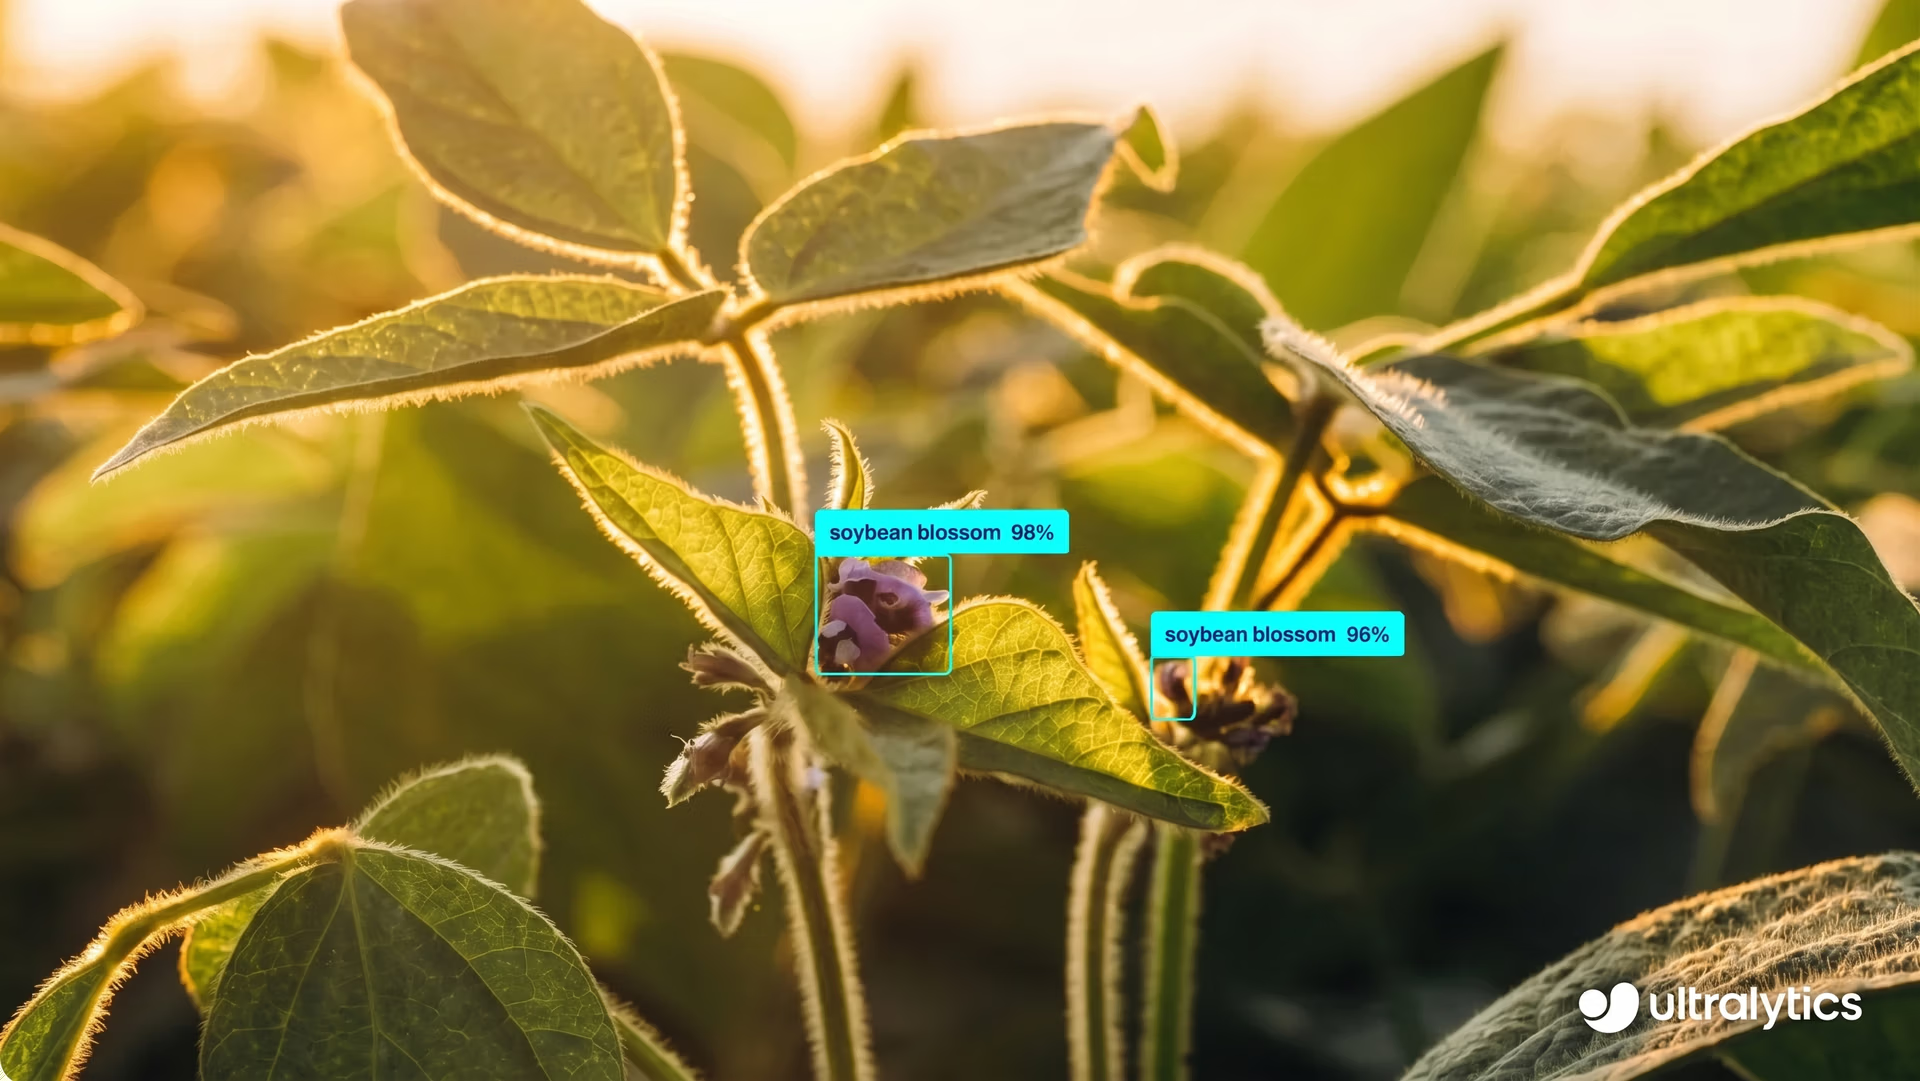
Fig. 1. Détection d’objets dans une image avec Ultralytics YOLO26.
Dans cet article, nous allons examiner de plus près pourquoi la détection d’objets traditionnelle s’appuyait sur la NMS, comment celle-ci est devenue un goulot d’étranglement au déploiement et comment Ultralytics YOLO26 élimine le besoin de solutions de contournement.
La détection d’objets traditionnelle produit des détections en double#
Avant d’examiner ce qu’est la NMS et pourquoi nous l’avons supprimée dans Ultralytics YOLO26, prenons un peu de recul pour voir comment les modèles traditionnels de détection d’objets génèrent leurs prédictions.
Les modèles traditionnels de détection d’objets produisent souvent plusieurs boîtes englobantes qui se chevauchent pour un même objet. Chacune de ces boîtes est associée à son propre score de confiance, même si elles désignent toutes le même objet dans l’image.
Cela s’explique par plusieurs raisons. Premièrement, le modèle effectue simultanément des prédictions à de nombreux emplacements spatiaux et à différentes échelles. Cela l’aide à détecter des objets de tailles différentes, mais signifie également que des emplacements proches peuvent identifier indépendamment le même objet.
Deuxièmement, de nombreux systèmes de détection d’objets utilisent des approches basées sur des ancres, qui génèrent un grand nombre de boîtes candidates autour de chaque emplacement. Cela augmente les chances de détecter les objets avec précision, mais aussi le nombre de prédictions qui se chevauchent.
Enfin, la détection basée sur une grille entraîne naturellement des redondances. Lorsqu’un objet se trouve près de la limite de plusieurs cellules de la grille, plusieurs cellules peuvent prédire une boîte pour cet objet, ce qui produit plusieurs détections qui se chevauchent.
Par conséquent, la sortie brute du modèle contient souvent plusieurs boîtes pour un même objet. Pour rendre les résultats exploitables, il faut filtrer ces prédictions redondantes afin de ne conserver qu’une seule détection finale.
Comprendre la suppression non maximale#
Lorsqu’un modèle de détection d’objets produit plusieurs boîtes englobantes qui se chevauchent pour un même objet, il faut nettoyer ces résultats avant de pouvoir les utiliser. C’est là qu’intervient la suppression non maximale.
La suppression non maximale est une étape de traitement postérieur qui intervient une fois que le modèle a terminé ses prédictions. Elle vise à réduire les détections en double afin que chaque objet soit représenté par une seule boîte englobante finale.
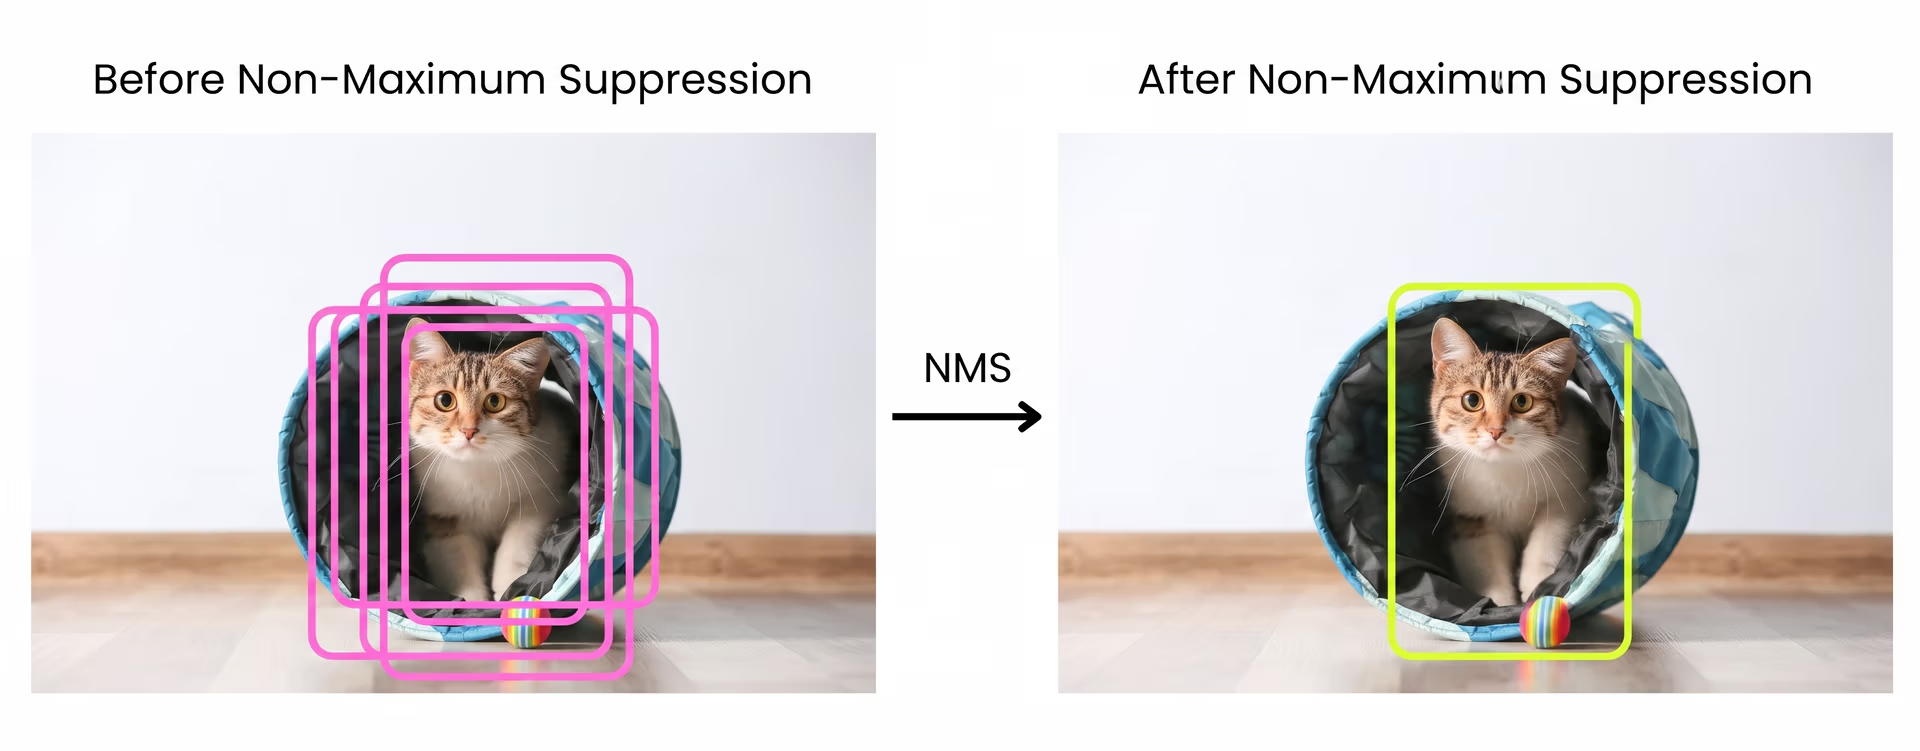
Fig. 2. Vue d’ensemble de la NMS. Image de l’auteur.
Le processus compare les boîtes englobantes en fonction de leurs scores de confiance et de leur degré de chevauchement. Les prédictions dont le niveau de confiance est très faible sont d’abord supprimées.
Les boîtes restantes sont ensuite triées selon leur niveau de confiance, puis celle qui obtient le score le plus élevé est sélectionnée comme meilleure détection. La boîte sélectionnée est comparée aux autres.
Si une autre boîte la chevauche trop, cette boîte est écartée et supprimée. Le chevauchement est généralement mesuré à l’aide de l’intersection sur l’union, une métrique qui calcule le rapport entre la surface commune à deux boîtes et la surface totale couverte par les deux. Le processus se répète jusqu’à ce qu’il ne reste que les détections les plus fiables et sans chevauchement.
Pourquoi la NMS complique le déploiement#
Bien que la suppression non maximale aide à filtrer les détections en double, elle pose aussi des difficultés qui deviennent plus visibles lorsque les modèles quittent le cadre de la recherche pour être déployés dans le monde réel.
Les performances constituent l’un des principaux problèmes. La NMS intervient après l’inférence et nécessite de comparer les boîtes englobantes entre elles afin de déterminer lesquelles conserver.
Ce processus est coûteux en calcul et difficile à paralléliser efficacement. Sur les appareils périphériques et les systèmes basés sur un CPU, ce travail supplémentaire peut ajouter une latence notable et compliquer le respect des exigences du temps réel.
La NMS accroît également la complexité du déploiement. Comme elle ne fait pas partie du modèle lui-même, elle doit être implémentée séparément sous forme de code de traitement postérieur.
Les différents environnements d’exécution et plateformes gèrent la NMS de différentes manières, ce qui oblige souvent à maintenir des implémentations personnalisées pour chaque environnement cible. Une configuration qui fonctionne dans un environnement peut se comporter légèrement différemment dans un autre, rendant le déploiement plus fragile et plus difficile à mettre à l’échelle.
L’optimisation matérielle constitue un autre défi. La NMS ne s’adapte pas facilement aux accélérateurs d’IA spécialisés, conçus pour exécuter efficacement les opérations des réseaux neuronaux. Par conséquent, même lorsque le modèle fonctionne rapidement sur du matériel optimisé, la NMS peut devenir un goulot d’étranglement qui limite les performances globales.
En plus de ces facteurs, la NMS repose sur des paramètres définis manuellement, comme les seuils de confiance et de chevauchement. Ces réglages peuvent avoir un impact important sur les résultats et doivent souvent être ajustés selon les jeux de données, les applications ou le matériel. Le comportement des systèmes de production devient alors moins prévisible et leur configuration demande davantage de travail.
Explication de l’inférence de détection d’objets de bout en bout#
Les limites de la suppression non maximale nous ont amenés à repenser le comportement des modèles de détection d’objets au moment de l’inférence. Au lieu de générer de nombreuses prédictions qui se chevauchent, puis de les nettoyer, nous nous sommes posé une question plus fondamentale.
Et si le modèle pouvait produire directement les détections finales ? Cette question est au cœur de l’inférence de détection d’objets de bout en bout. Dans un système de bout en bout, le modèle est entraîné pour gérer l’ensemble du processus de détection, du début à la fin, sans dépendre d’étapes de nettoyage externes.
Au lieu de produire de nombreuses boîtes candidates et de les filtrer après l’inférence, le modèle apprend à générer de lui-même un petit ensemble de prédictions fiables et sans chevauchement. Les détections en double sont résolues au sein du réseau plutôt que supprimées lors du traitement postérieur.
De nouvelles architectures de modèles ont montré que cette approche était à la fois possible et pratique. Avec une stratégie d’entraînement adaptée, les modèles pouvaient apprendre à associer chaque objet à une seule prédiction plutôt qu’à de nombreuses prédictions concurrentes, réduisant ainsi les redondances à la source.
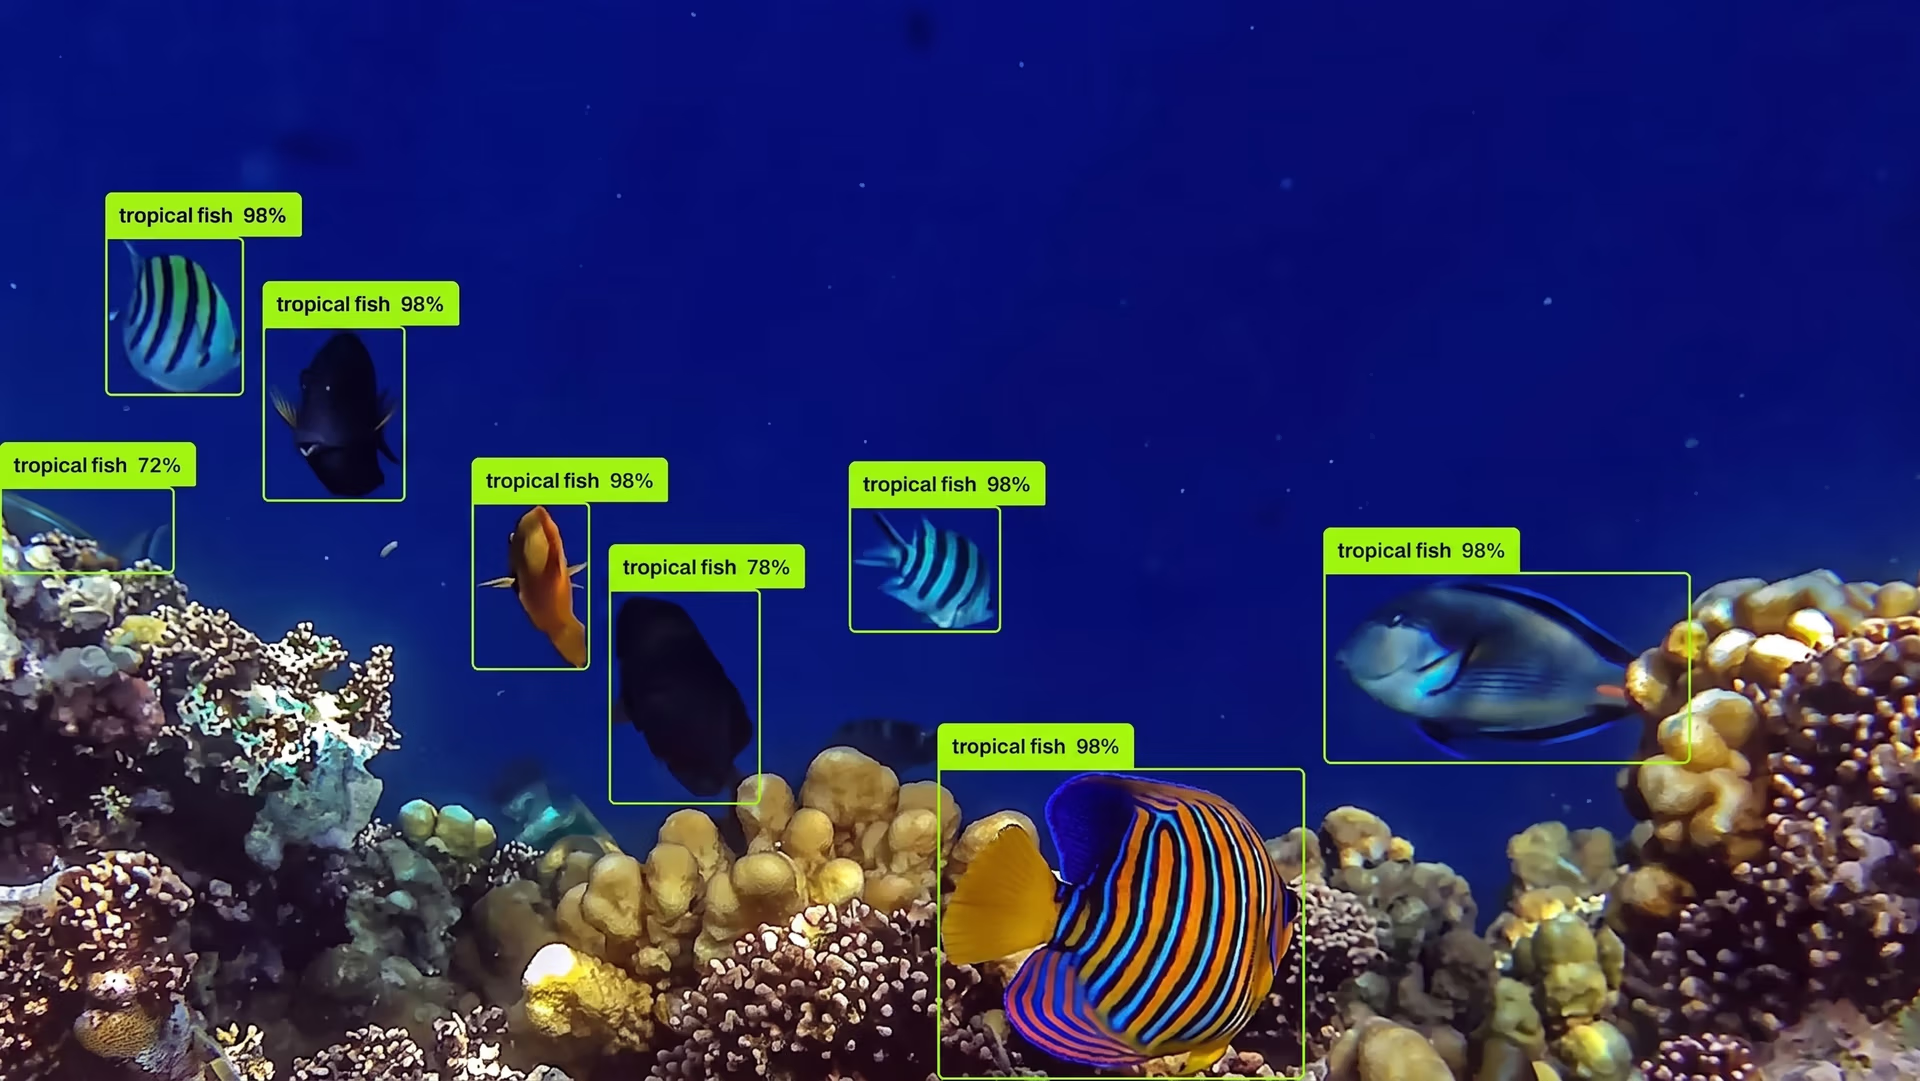
Fig. 3. Exemple de détection d’objets avec Ultralytics YOLO26.
Pour que cela fonctionne, l’entraînement doit lui aussi évoluer. Au lieu de laisser de nombreuses prédictions se disputer un même objet, le modèle apprend à prendre une décision claire, ce qui produit moins de détections, mais plus fiables.
Le résultat global est un pipeline d’inférence plus simple. Les doublons étant déjà résolus en interne, la suppression non maximale n’est plus nécessaire au moment de l’inférence. La sortie du modèle correspond déjà à l’ensemble des détections finales.
Cette conception de bout en bout facilite également le déploiement. Sans étapes de traitement postérieur ni implémentations de NMS propres à chaque plateforme, le modèle exporté est entièrement autonome et se comporte de manière cohérente avec différents frameworks d’inférence et matériels cibles.
Comme l’explique notre ingénieur principal des partenariats, Francesco Mattioli : « Le véritable apprentissage de bout en bout signifie que le modèle doit tout gérer, des pixels aux prédictions, sans étapes de traitement postérieur conçues manuellement qui nuisent à la différentiabilité et compliquent le déploiement. »
Comment Ultralytics YOLO26 supprime la NMS#
Ultralytics YOLO26 supprime la suppression non maximale en modifiant la façon dont les détections sont apprises et produites, plutôt qu’en s’appuyant sur un traitement postérieur pour les nettoyer. Au lieu de laisser de nombreuses prédictions se disputer un même objet, YOLO26 est entraîné pour apprendre une relation claire de correspondance univoque entre les objets et les sorties.
Cela est rendu possible en partie par une tête de détection dédiée un-à-un, entraînée parallèlement à une tête conventionnelle un-à-plusieurs. Elle aide le modèle à produire une seule prédiction fiable par objet plutôt qu’une multitude de candidats qui se chevauchent. Chaque objet est associé à une prédiction, ce qui réduit naturellement les détections en double.
Des stratégies d’appariement cohérentes pendant l’entraînement renforcent ce comportement et incitent le modèle à prendre une décision fiable par objet plutôt qu’à générer des prédictions qui se chevauchent. Au final, le modèle produit moins de prédictions, mais chacune correspond à une détection finale.
Pourquoi la suppression de DFL a rendu possible la détection sans NMS#
La suppression de la perte focale de distribution, ou DFL, constitue une autre innovation importante qui permet l’inférence sans NMS dans Ultralytics YOLO26. Dans les anciens modèles YOLO, la DFL servait à améliorer la régression des boîtes englobantes en prédisant une distribution de positions possibles des boîtes plutôt qu’une seule valeur.
Cette approche améliorait la précision de localisation, mais ajoutait aussi de la complexité au pipeline de détection. Cette complexité est devenue un obstacle au passage à une véritable inférence de bout en bout.
La DFL ajoutait des calculs supplémentaires et des plages de régression fixes, ce qui rendait plus difficile l’apprentissage d’affectations d’objets simples et univoques par le modèle et renforçait la dépendance aux étapes de traitement postérieur comme la suppression non maximale. Avec Ultralytics YOLO26, nous avons supprimé la DFL et repensé la régression des boîtes englobantes pour la rendre plus simple et plus directe.
Au lieu de s’appuyer sur des sorties basées sur des distributions, le modèle apprend à prédire des coordonnées de boîtes précises d’une manière qui permet d’obtenir moins de détections, mais plus fiables. Ce changement contribue à réduire à la source les prédictions qui se chevauchent et aligne la régression des boîtes englobantes sur la conception de bout en bout sans NMS d’Ultralytics YOLO26.
Ultralytics YOLO26 fonctionne sans NMS et se déploie facilement#
Une conception sans NMS fait d’Ultralytics YOLO26 un véritable modèle de bout en bout. Cela a un impact important sur l’exportation des modèles.
L’exportation consiste à convertir un modèle entraîné dans un format qui peut être exécuté en dehors de l’environnement d’entraînement, comme ONNX, TensorRT, CoreML ou OpenVINO. Dans les pipelines traditionnels, ce processus échoue souvent parce que la suppression non maximale ne fait pas partie du modèle lui-même.
En supprimant la NMS, Ultralytics YOLO26 évite complètement ce problème. Le modèle exporté comprend déjà tout le nécessaire pour produire les détections finales. Dans les versions actuelles d’Ultralytics, tu sélectionnes cette tête un-à-un sans NMS avec nms=False lors de la prédiction, de la validation ou de l’exportation, tandis que la tête un-à-plusieurs par défaut avec NMS reste disponible pour obtenir une précision légèrement supérieure ; le guide de détection de bout en bout présente les deux options.
Le modèle exporté est ainsi entièrement autonome et plus facilement transférable entre différents frameworks d’inférence et matériels cibles. Le même modèle se comporte de manière cohérente, qu’il soit déployé sur des serveurs, des systèmes fonctionnant uniquement sur CPU, des appareils embarqués ou des accélérateurs périphériques. Le déploiement devient plus simple, car ce que tu exportes est exactement ce que tu exécutes.
Cette simplicité est particulièrement importante pour les applications périphériques. Par exemple, YOLO26 peut être facilement déployé sur des appareils comme des drones pour surveiller les cultures, inspecter les champs et analyser la santé des plantes, des cas d’usage où les budgets limités en calcul et en énergie rendent les pipelines de traitement postérieur complexes peu pratiques. Comme le modèle produit directement les détections finales, il fonctionne de manière fiable sur du matériel léger, sans étapes de traitement supplémentaires.
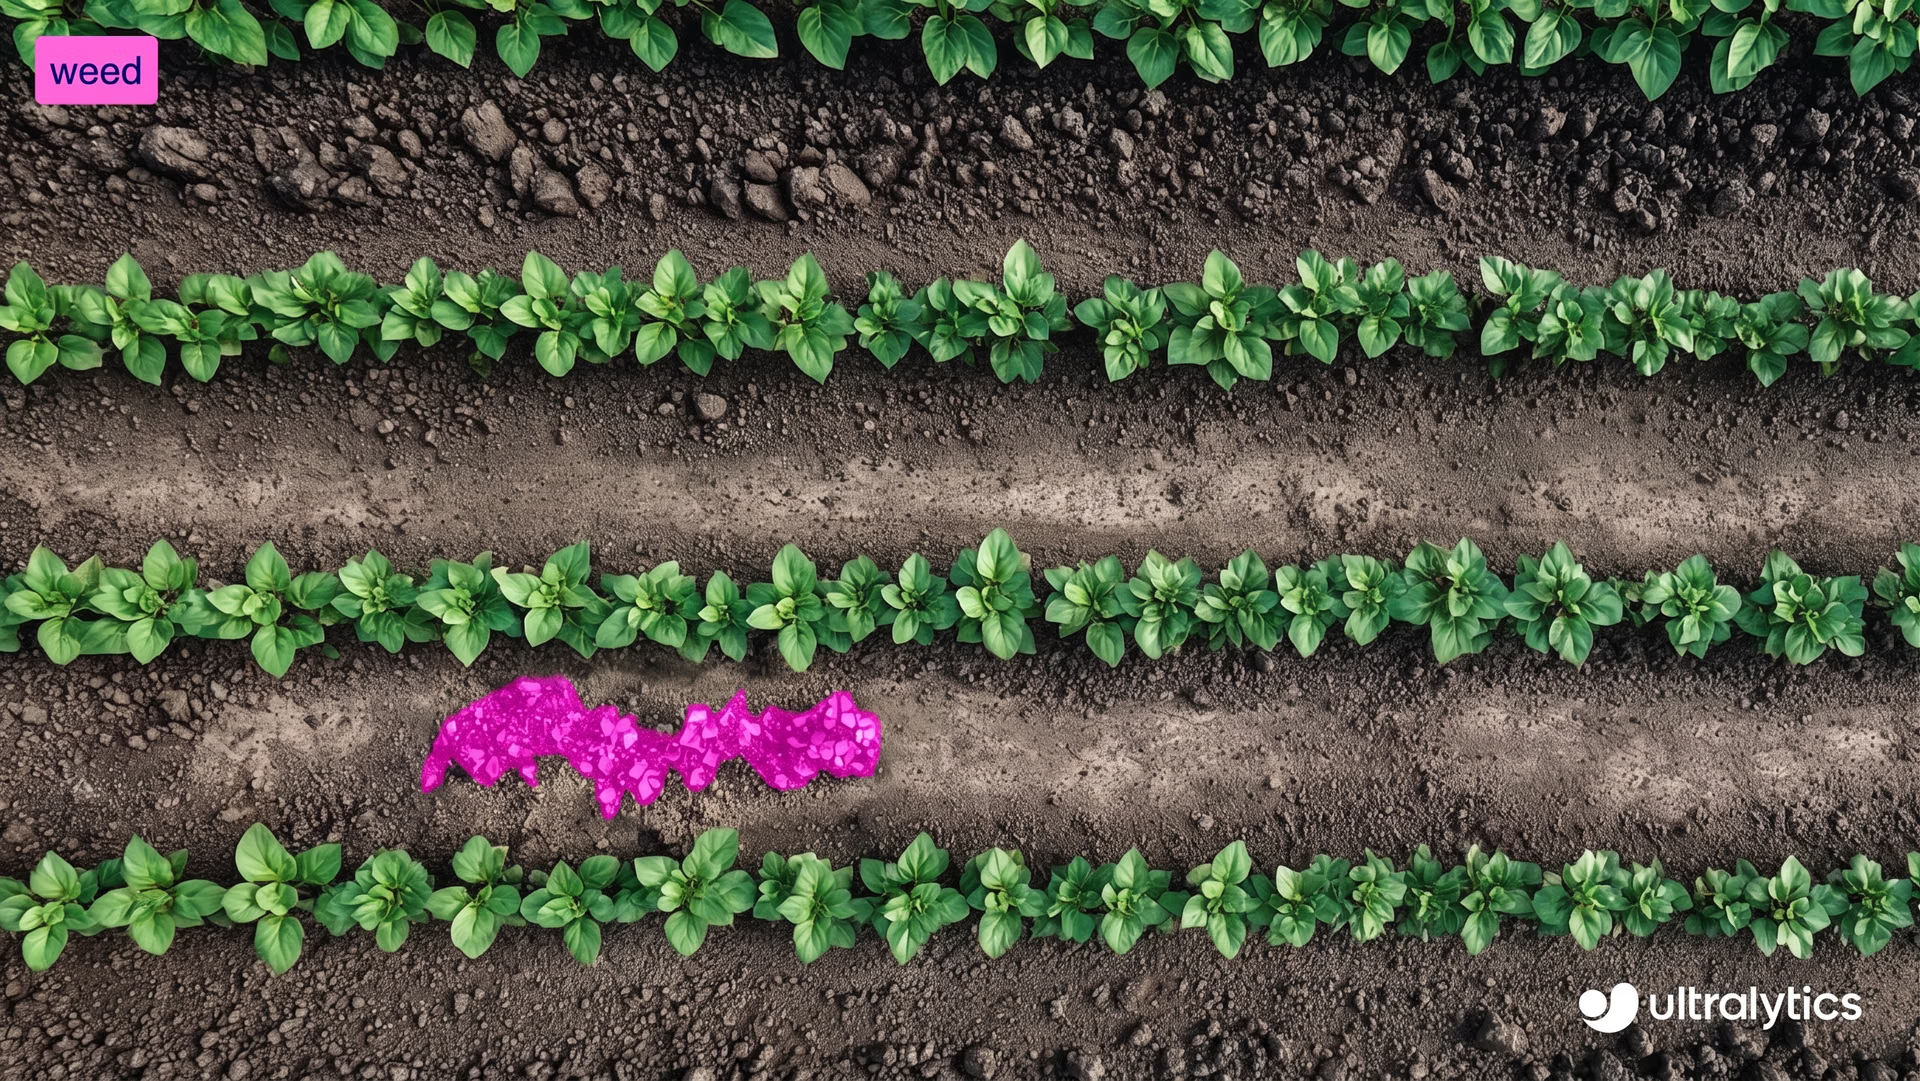
Fig. 4. Ultralytics YOLO26 se déploie facilement sur des appareils périphériques comme les drones.
En bref, l’inférence sans NMS simplifie l’exportation et le déploiement et permet de créer des systèmes de vision plus propres et plus fiables. La NMS était une solution de contournement. Ultralytics YOLO26 n’a plus besoin de solutions de contournement.
Points clés à retenir#
Ultralytics YOLO26 peut se passer de la suppression non maximale en résolvant le problème sous-jacent des détections en double, plutôt qu’en les corrigeant après coup. Sa conception de bout en bout permet au modèle de produire directement les détections finales, ce qui simplifie l’exportation et le déploiement et les rend plus cohérents sur différents matériels. La NMS était une solution de contournement utile pour les anciens systèmes, mais YOLO26 n’en a plus besoin.
Rejoins notre communauté et consulte notre dépôt GitHub pour en savoir plus sur l’IA. Explore nos pages de solutions consacrées à l’IA dans l’agriculture et à la vision par ordinateur dans le commerce de détail. Découvre nos options de licence et lance-toi dès aujourd’hui dans l’IA pour la vision !
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









