5 motivi per cui i modelli di computer vision falliscono in produzione
Scopri perché i modelli di computer vision falliscono in produzione, dai dati non corrispondenti alla latenza, e come i team possono migliorare le prestazioni dei modelli nei sistemi di IA per la visione nel mondo reale.
 Abirami Vina10 min di lettura
La computer vision è ormai una tecnologia chiave dell'intelligenza artificiale, adottata nella maggior parte dei settori. Consente alle macchine di interpretare e analizzare i dati visivi per svolgere una vasta gamma di attività. Questi sistemi supportano numerose applicazioni reali, dall'imaging medico e dalla robotica all'automazione della produzione e del commercio al dettaglio.
Tuttavia, realizzare un sistema di computer vision non è sempre semplice. Di solito comporta lo sviluppo di un modello di AI visiva, addestrato a individuare schemi in immagini e video per supportare attività come il rilevamento e il tracciamento degli oggetti.
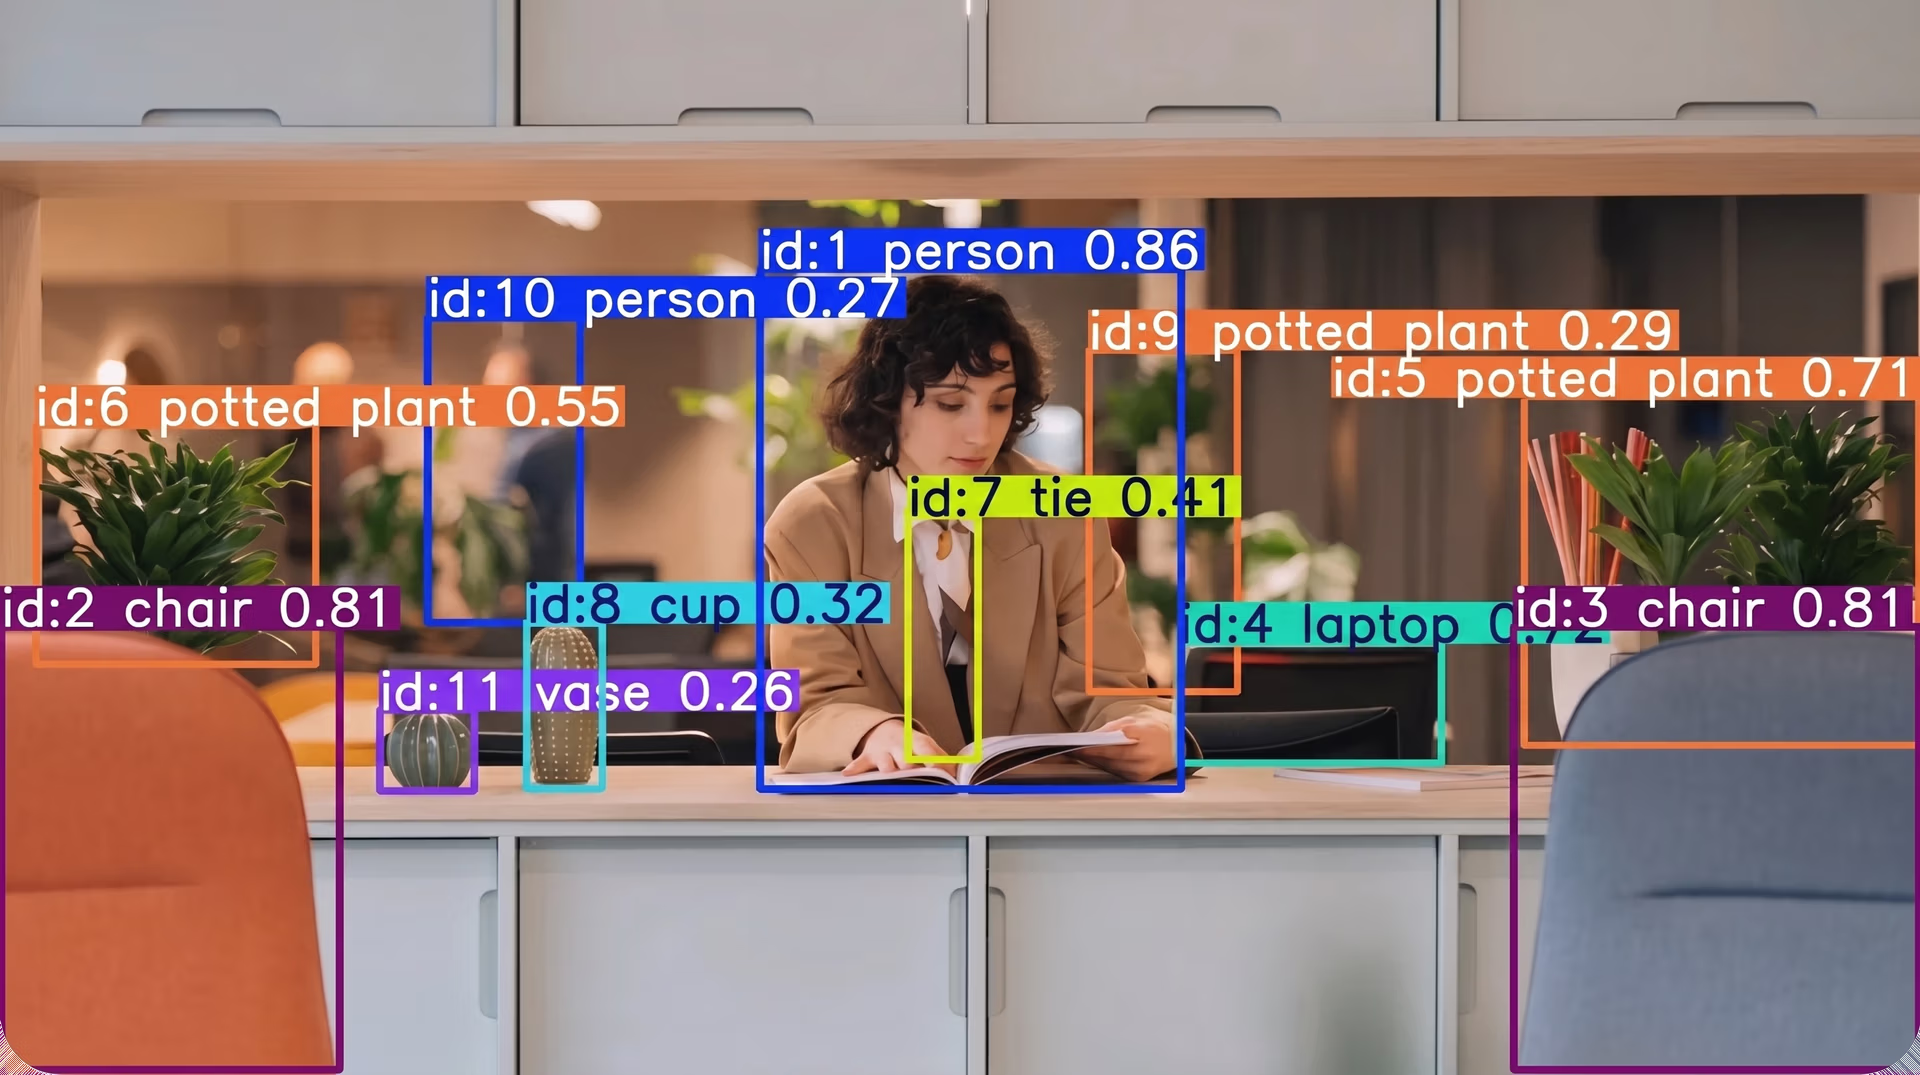
Fig. 1. Un esempio di rilevamento e tracciamento degli oggetti (Fonte)
Nonostante i progressi compiuti negli anni, i modelli di computer vision possono ancora comportarsi diversamente durante lo sviluppo rispetto a dopo la distribuzione in ambienti reali. Questo accade perché distribuire i modelli al di fuori di ambienti di sviluppo controllati comporta sfide nuove e spesso impreviste.
Fattori come la scarsa diversità dei dataset, il monitoraggio insufficiente dei modelli e i limiti dell'infrastruttura possono far sì che lo stesso modello si comporti in modo diverso nel mondo reale dopo la distribuzione.
In questo articolo esamineremo cinque motivi comuni per cui i modelli di visione artificiale potrebbero non funzionare bene in produzione.
Il divario tra addestramento del modello e produzione#
L'addestramento del modello avviene in genere in un ambiente controllato. In questa fase, gli sviluppatori di AI lavorano con dataset di addestramento preparati con cura.
Queste vaste raccolte di dati visivi includono annotazioni ben strutturate, o etichette, che descrivono il contenuto di ogni immagine. Anche l'addestramento avviene in condizioni costanti, consentendo ai modelli di AI visiva di apprendere efficacemente gli schemi visivi.
Per assicurarsi che questi schemi vengano appresi correttamente, durante lo sviluppo i modelli possono essere valutati sistematicamente usando metriche di valutazione standard e dataset di benchmark. Come i dataset di addestramento, anche questi dataset di benchmark sono preparati con cura.
Tuttavia, i dati incontrati dai sistemi di computer vision nel mondo reale possono essere molto diversi da quelli usati durante l'addestramento e la valutazione. Una volta distribuiti, questi modelli raramente operano in condizioni controllate.
I modelli possono trovarsi a elaborare immagini e video provenienti da ambienti imprevedibili, in cui l'illuminazione cambia continuamente, le angolazioni della telecamera variano e gli sfondi cambiano nel tempo. Per esempio, un modello di AI visiva addestrato per il rilevamento del traffico potrebbe avere difficoltà a rilevare i veicoli di notte se è stato addestrato e valutato principalmente su immagini diurne.
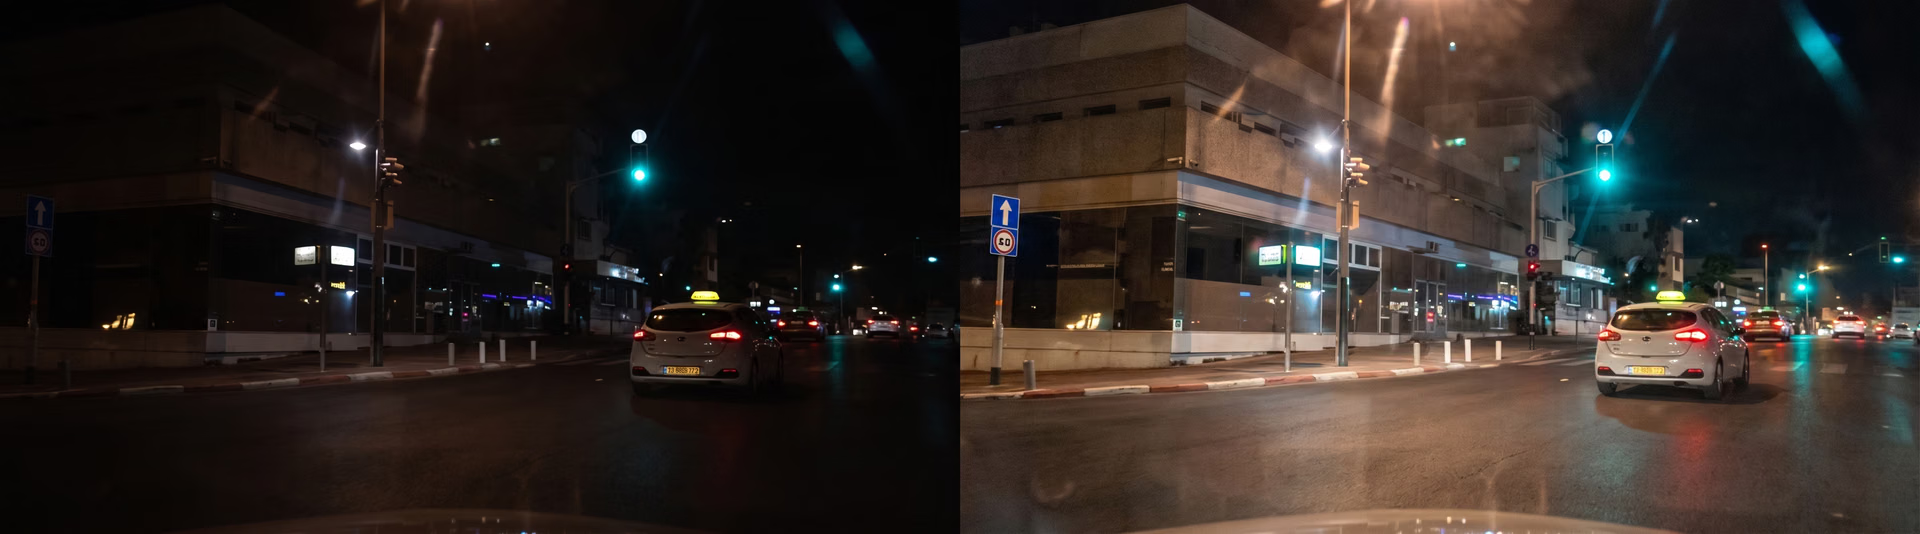
Fig. 2. Anche dopo il miglioramento, le immagini notturne sono difficili da interpretare per i modelli addestrati su immagini diurne. (Fonte)
Questa differenza tra lo sviluppo e la distribuzione nel mondo reale è il divario tra training e produzione. Per questo motivo, molti problemi dei modelli emergono solo dopo la distribuzione: è quindi essenziale comprendere fin dalle prime fasi il percorso dal laboratorio alla produzione per creare sistemi di visione artificiale più affidabili e robusti.
5 motivi comuni per cui i modelli di computer vision falliscono in produzione#
Ora esaminiamo più da vicino cinque motivi comuni per cui i modelli di computer vision falliscono in produzione.
1. Dataset di addestramento di bassa qualità#
I dataset hanno un ruolo centrale nell'addestramento dei modelli di computer vision, perché determinano ciò che il modello apprende durante l'addestramento e il modo in cui risponde agli input del mondo reale dopo la distribuzione. Questo aspetto è particolarmente importante nell'apprendimento supervisionato, in cui i modelli apprendono da esempi etichettati che indicano cosa rappresenta ogni immagine.
Molti modelli di deep learning, comprese le reti neurali convoluzionali (CNNs), si affidano a questi esempi etichettati per riconoscere gli schemi nei dati visivi. Tuttavia, quando il dataset di addestramento non rispecchia le condizioni del mondo reale, il modello può apprendere schemi che non rappresentano appieno l'aspetto degli oggetti al di fuori dei dati di addestramento.
Per esempio, un modello addestrato su un dataset di difetti costituiti da grandi crepe potrebbe non rilevare nel flusso di lavoro produttivo reale un raro tipo di crepa di lieve entità. Anche la qualità delle annotazioni può influire sul comportamento del modello. Etichette incoerenti o dettagli mancanti nei dati etichettati possono portare il modello ad apprendere informazioni errate durante l'addestramento.
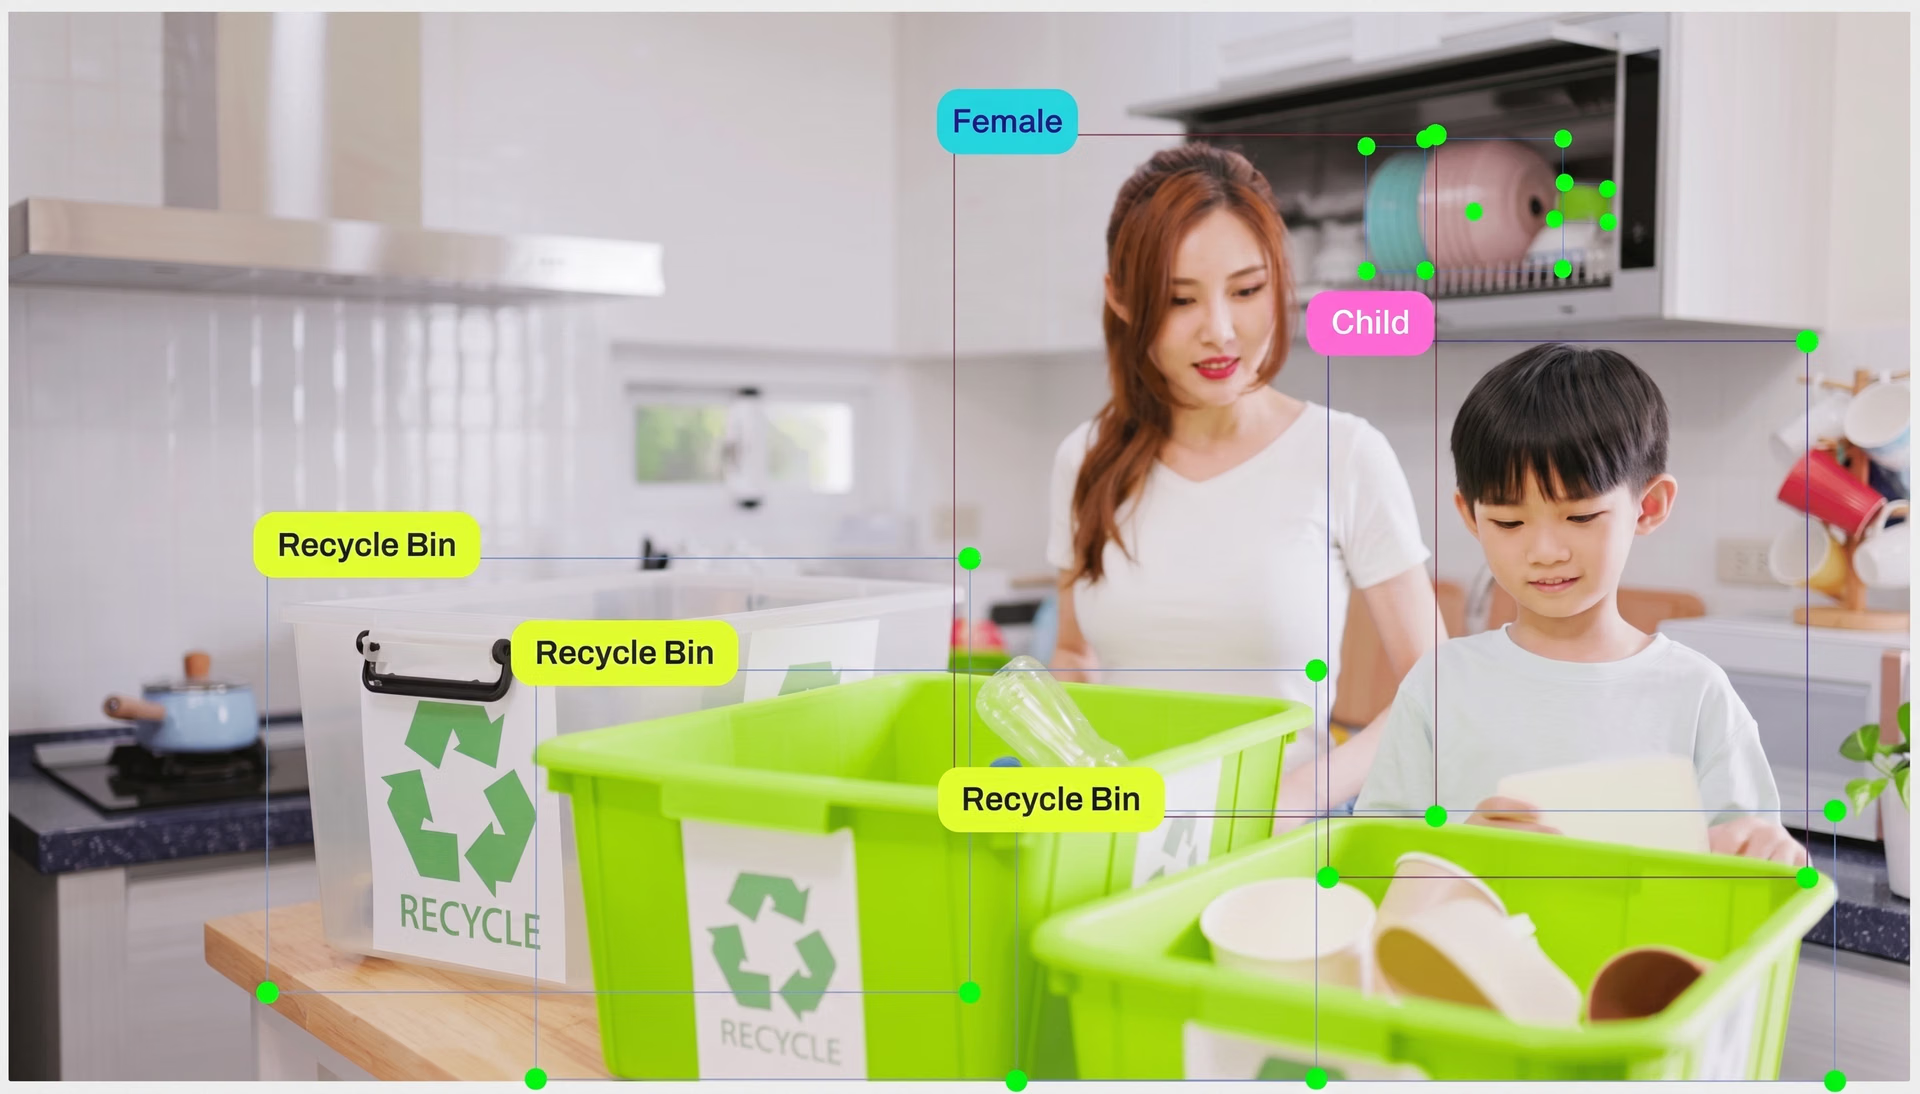
Fig. 3. Uno sguardo alle annotazioni delle immagini (Fonte)
Nel complesso, la qualità e la diversità dei dati di addestramento sono fondamentali e possono determinare il rendimento del modello nelle applicazioni reali. Quando i dataset sono rappresentativi e le etichette sono accurate, in genere un modello funziona in modo più affidabile una volta distribuito.
2. Overfitting e generalizzazione#
I modelli di machine learning, come quelli di computer vision, apprendono schemi dai dataset di addestramento. A volte, però, un modello può fare eccessivo affidamento su pochi schemi.
Invece di apprendere relazioni visive più ampie, può finire per memorizzare gli schemi limitati dei dati di addestramento. Questo comportamento è noto come overfitting.
L'overfitting si verifica di solito quando i dataset di addestramento sono piccoli o non abbastanza diversificati. In questi casi, il modello diventa bravo a riconoscere le immagini che ha già visto, ma ha difficoltà a interpretare nuovi dati o input non familiari.
Di conseguenza, un modello può funzionare bene sui dati di test, poiché sono simili a quelli di training, ma comportarsi diversamente dopo la distribuzione in nuove condizioni. Ecco perché il concetto di generalizzazione è fondamentale. In parole semplici, indica quanto bene i modelli riescano ad applicare ciò che hanno appreso durante il training a nuovi scenari.
Per ridurre l'overfitting, i professionisti spesso addestrano i modelli su dataset più vari e applicano l'aumento dei dati, un metodo che modifica leggermente le immagini di training per introdurre maggiore varietà nei dati. Senza queste precauzioni, le prestazioni del modello possono peggiorare rapidamente quando il sistema inizia a operare in ambienti reali.
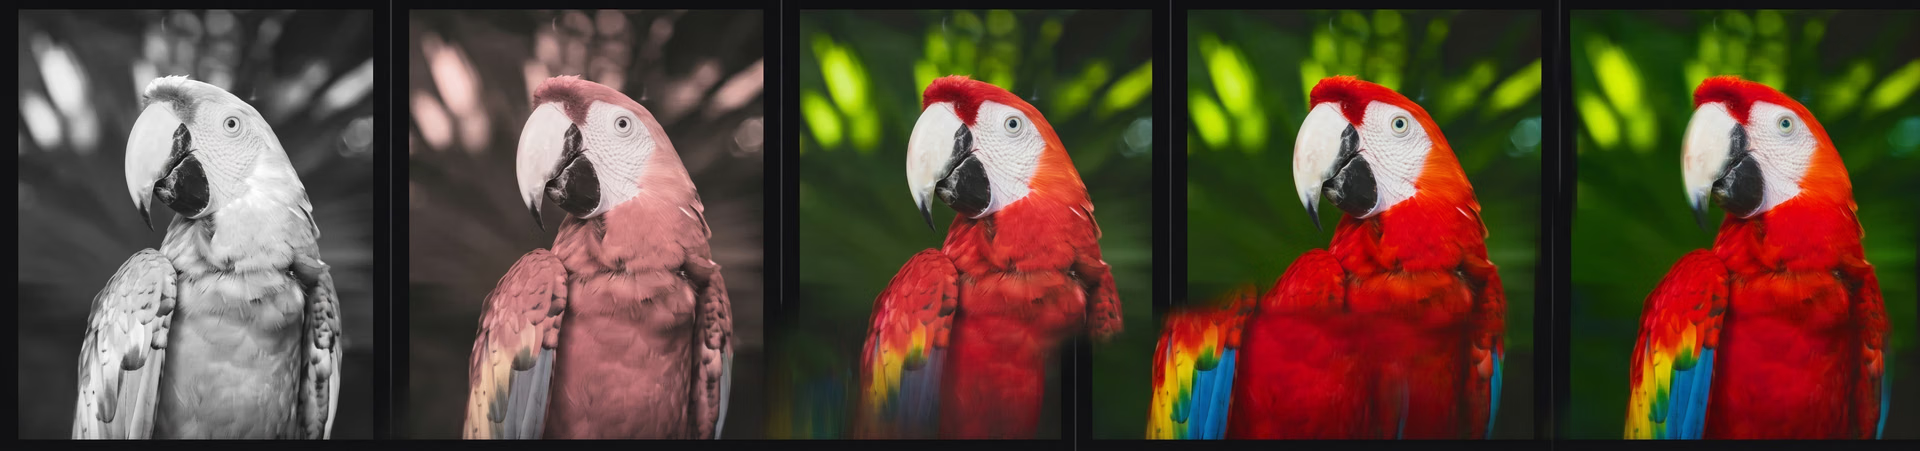
Fig. 4. L'aumento dei dati può aiutare a creare variazioni della stessa immagine all'interno di un dataset. (Fonte)
3. Casi limite nascosti negli ambienti reali#
Anche quando i modelli di computer vision generalizzano bene a nuovi dati, gli ambienti reali possono comunque presentare casi limite imprevisti. Si tratta di situazioni insolite, diverse dagli schemi tipici appresi dal modello durante l'addestramento.
Molti di questi scenari sono difficili da acquisire durante lo sviluppo perché si verificano raramente, sono difficili da ricreare o possono essere costosi da raccogliere come dati di addestramento. Per esempio, gli oggetti possono avere forme insolite, muoversi in modo imprevedibile o essere parzialmente nascosti da altri oggetti.
Anche le variazioni dell'illuminazione, delle angolazioni della telecamera o delle condizioni dello sfondo possono creare situazioni che rendono più difficile il riconoscimento. Questi casi limite spesso diventano evidenti solo dopo che il sistema è stato distribuito in applicazioni reali.
Per esempio, nella robotica e nell'automazione della produzione, gli articoli potrebbero essere collocati o posizionati in modo diverso da quello previsto, creando situazioni per cui il modello non è stato progettato. In definitiva, previsioni che sembravano affidabili durante i test possono diventare meno coerenti quando il sistema opera in ambienti reali.
4. Mancanza di monitoraggio e debug dopo la distribuzione#
Oltre a sviluppare un modello di AI visiva, è fondamentale monitorarne e migliorarne le prestazioni. Tuttavia, una volta che il sistema è operativo, spesso l'attenzione si sposta sul mantenerlo in funzione, anziché monitorarne attentamente le prestazioni nel tempo. Di conseguenza, i cambiamenti nel comportamento del modello possono passare inosservati.
Allo stesso tempo, fattori come i cambiamenti nei dati in ingresso, la configurazione delle telecamere o gli ambienti operativi possono influire gradualmente sull'accuratezza con cui il modello rileva o classifica gli oggetti. Questi cambiamenti non sono sempre evidenti e possono passare inosservati durante il funzionamento quotidiano.
Monitorare gli output del modello e il comportamento complessivo del sistema può aiutare i team a individuare prima questi problemi. Controlli regolari, procedure di validazione e flussi di lavoro per il debug consentono ai team di esaminare risultati insoliti e capire quali potrebbero esserne le cause.
In settori come la produzione, per esempio, un modello potrebbe iniziare improvvisamente a identificare in modo errato gli oggetti su una catena di montaggio dopo una modifica alla configurazione della telecamera. Tenere traccia del comportamento di un sistema di AI visiva distribuito facilita la risposta a questi cambiamenti e permette di mantenere prestazioni stabili in ambienti reali.
5. Limiti dell'infrastruttura e latenza#
Molti sistemi di computer vision devono funzionare in tempo reale, il che può mettere sotto notevole pressione l'hardware, le reti e le pipeline di elaborazione. Quando le risorse sono limitate, possono verificarsi ritardi di calcolo o latenza di rete, che fanno arrivare le previsioni troppo tardi e compromettono le prestazioni complessive del sistema.
In alcuni casi, anche i modelli avanzati di deep learning possono creare problemi infrastrutturali. Per esempio, le architetture basate su Transformer sono progettate per elaborare grandi quantità di dati visivi e apprendere relazioni complesse all'interno delle immagini, ma spesso richiedono notevoli risorse di calcolo. Per eseguire questi modelli potrebbe essere necessario un hardware più potente o costoso.
Senza un'ottimizzazione adeguata, anche i modelli che durante i test funzionano rapidamente possono rallentare o comportarsi in modo incoerente dopo la distribuzione. Per affrontare questo problema, i team spesso ottimizzano le pipeline, riducono la complessità del modello ove possibile e bilanciano precisione e velocità.
Questo può comportare la compressione di modelli di grandi dimensioni in versioni più leggere, l'uso di architetture più efficienti o l'elaborazione delle immagini a risoluzioni inferiori, così che il sistema funzioni senza problemi sull'hardware disponibile. In molti casi, i team scelgono anche modelli leggeri e più veloci come Ultralytics YOLO26 per rispettare i vincoli di distribuzione.
Buone pratiche per prevenire i malfunzionamenti dei modelli di computer vision#
Ecco alcune buone pratiche che possono aiutare a ridurre i malfunzionamenti quando si distribuiscono modelli di computer vision in produzione:
- Usa strategie di distribuzione graduale: introduci gradualmente i modelli in produzione, così i team possono osservarne il comportamento e apportare modifiche quando necessario.
- Integra cicli di feedback: raccogli nuove immagini ed esamina le previsioni errate per riaddestrare i modelli con dataset aggiornati e migliorarne le prestazioni nel tempo.
- Documenta i limiti del modello: registra chiaramente le situazioni in cui il modello potrebbe avere difficoltà, così i team potranno anticipare i potenziali problemi durante la distribuzione.
- Progetta tenendo conto della variabilità del mondo reale: pianificare in anticipo le variazioni di illuminazione, angolazione della telecamera, posizione degli oggetti o condizioni dello sfondo può aiutare i modelli a mantenersi stabili in diversi scenari operativi.
Punti chiave#
I modelli di computer vision raramente falliscono perché gli algoritmi in sé sono deboli. Nella maggior parte dei casi, la vera sfida deriva dagli ambienti in cui operano questi sistemi. I modelli che funzionano bene durante l'addestramento spesso si trovano ad affrontare condizioni imprevedibili nel mondo reale, che possono influire sul loro comportamento.
Ecco perché realizzare sistemi di AI visiva affidabili richiede più del semplice addestramento di un modello. Significa anche preparare attentamente i dataset, monitorare le prestazioni del modello dopo la distribuzione e adattare continuamente i sistemi alle condizioni del mondo reale.
Vuoi approfondire l'AI visiva? Unisciti alla nostra community e leggi le applicazioni dell'AI nel settore automobilistico e della computer vision nella logistica. Dai un'occhiata alle nostre opzioni di licenza per iniziare a lavorare a progetti di computer vision. Visita il nostro repository GitHub per saperne di più.
Scritto da
Creatore di contenuti · Ultralytics
Commenti
Fai una domanda, condividi i tuoi risultati o aiuta qualcun altro.









