ビジョンAIとその仕組みの概要
最新のモデル、厳選されたデータセット、エンドツーエンドのワークフローを活用し、さまざまな業界で画像や動画からリアルタイムの知見を引き出すビジョンAIの仕組みをご紹介します。
 Abirami Vina11 分で読めます
工場、病院、都市、車両、消費者向けデバイスのカメラは、毎日、膨大な量の画像や動画を撮影しています。この絶え間ない視覚データの流れは新たな可能性を生み出す一方で、何が起きているのかを把握して迅速に対応することを難しくしています。
たとえば、交通量の多い交差点や混雑した公共スペースの状況は、刻々と変化します。こうした環境を人手で監視するには時間がかかり、特に迅速かつ確実な判断が必要な場合には、精度が十分でないこともよくあります。
このような状況に対応するには、視覚情報をその場で理解し、リアルタイムに応答できるシステムが必要です。コンピュータービジョンを使うと、機械が画像や動画を分析し、パターンを認識して有用な情報を抽出できるため、これが実現します。
従来のコンピュータービジョンシステムは固定ルールに依存していました。こうしたルールは管理された環境では機能しましたが、照明やカメラの角度などの条件が変わると、しばしば対応できませんでした。最新のビジョンAIは、人工知能と機械学習を活用して、このアプローチを改善しています。
こうしたシステムは、視覚情報を撮影または保存するだけでなく、視覚データをリアルタイムに分析し、事例から学習して、変化する環境に適応します。そのため、ビジョンAIは実環境でより効果を発揮し、より多くの用途で使われるほど継続的に改善できます。
この記事では、ビジョンAIとは何か、エンドツーエンドのインテリジェントなワークフローの構築にどのように活用できるかを詳しく見ていきます。
ビジョンAIとは何ですか?#
ビジョンAIは、機械が画像や動画を理解し、解釈できるようにする人工知能の一分野です。つまり、ビジョンAIシステムは目にしたものを分析し、その情報を使って、より大きなワークフローの一部としてアクションを支援したり、予測を最適化したり、意思決定を行ったりします。新しいコンテンツを生成する生成AIとは異なり、ビジョンAIは既存の視覚データを理解し、そこから情報を抽出することに重点を置いています。
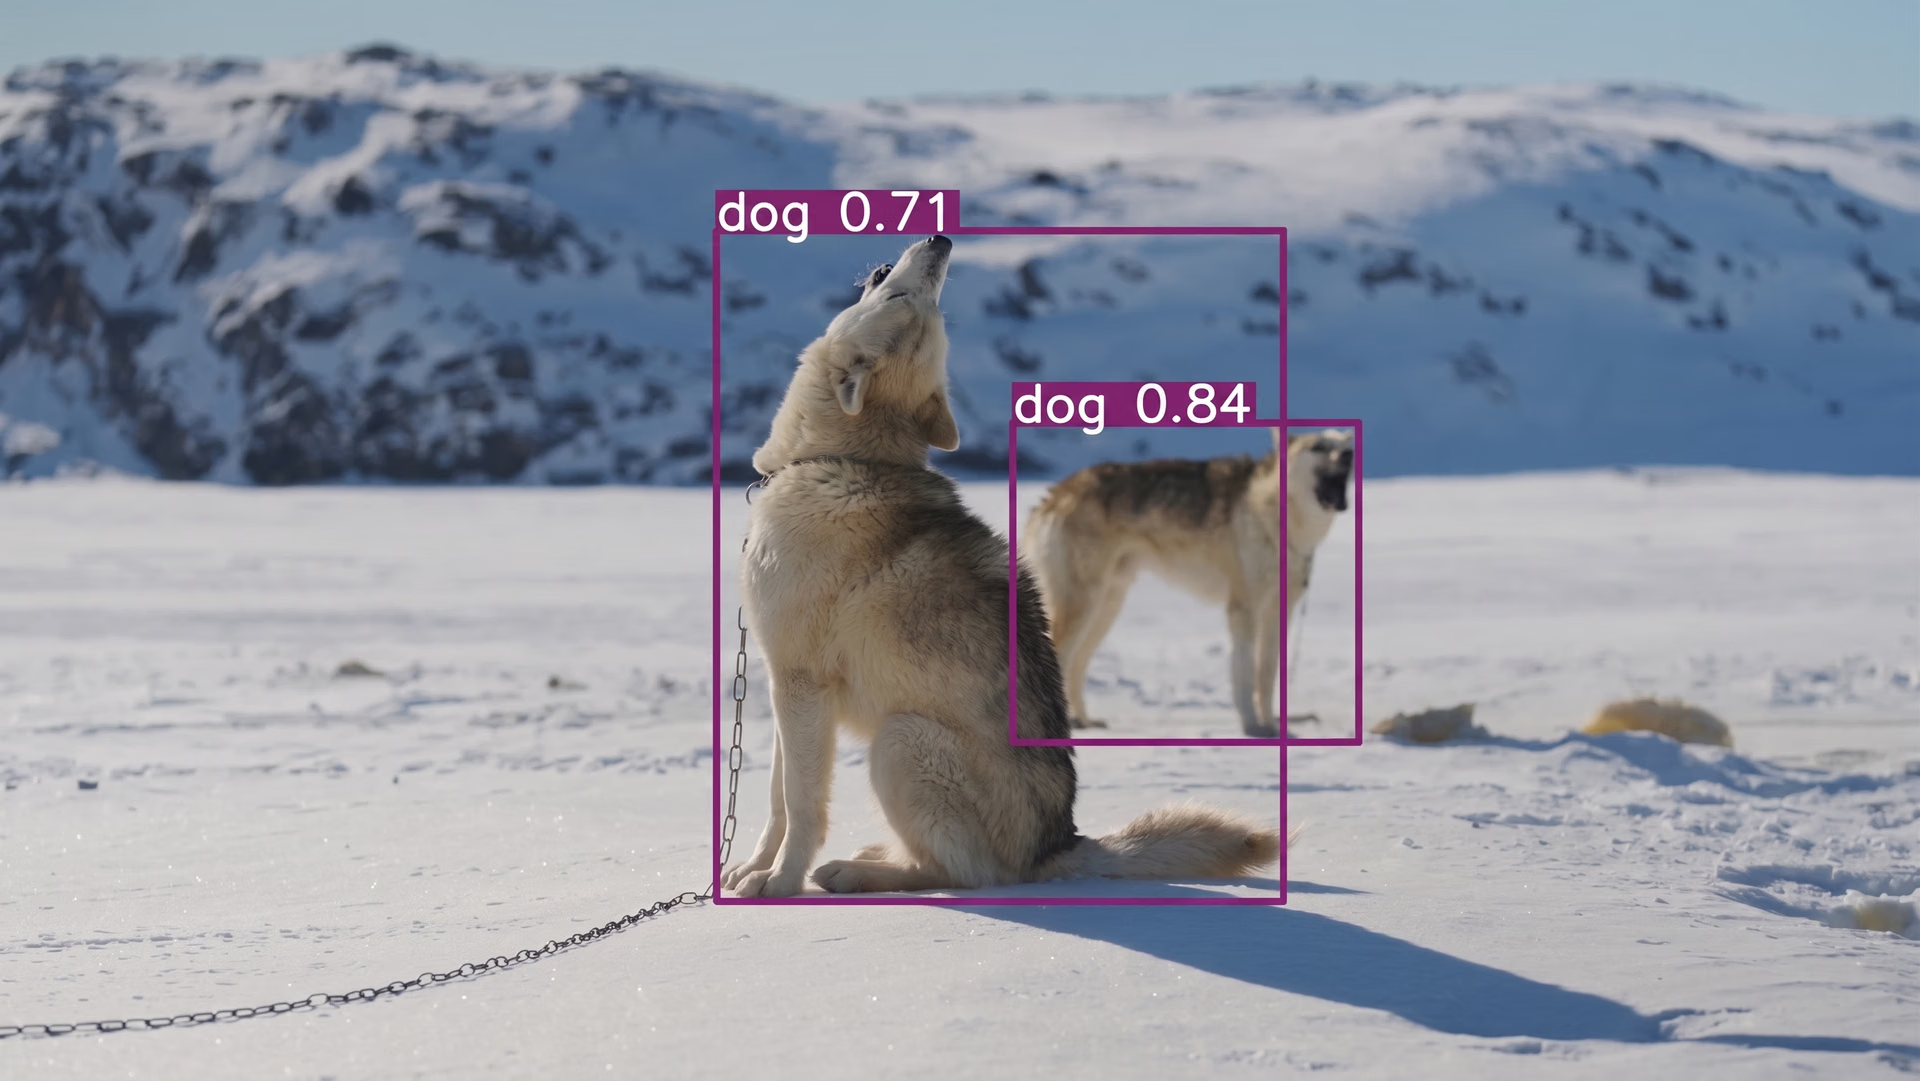
たとえば、工場の作業現場や公共スペースの活動を長時間にわたって監視するには、速度と一貫性が求められますが、人手で維持するのは困難です。ビジョンAIシステムは、機械学習やディープラーニングの技術を適用し、パターンを認識して関連する詳細を特定し、新たな視覚情報が現れるたびに応答することで、この課題に対応できます。
図1. ビジョンAIを使用して画像内の物体を検出する例(出典)
画像や動画は大量かつ高速に生成されることが多いため、ビジョンAIシステムは視覚データを継続的に処理し、すべてのフレームに同じモデルを適用できます。その結果、一貫性が高まり、条件が変化してもチームは精度を保ちながら業務を改善できます。
実環境でビジョンAIは通常、エンドツーエンドのAIシステムの一部として機能します。ビジョンAIモデルを、結果に基づいて動作する意思決定ロジックやその他のツールと連携させます。視覚入力を有用な知見に変換することで、ビジョンAIは定型タスクを自動化し、多様なコンピュータービジョンの用途で、より迅速で確かな意思決定を支援できます。
ビジョンAIの仕組み:視覚データから実用的な知見へ#
では、システムや機械は画像や動画を見て、何が起きているかを理解し、次に何をすべきかを判断するまで、どのような処理を行うのでしょうか。
このプロセスは、写真、動画クリップ、ライブカメラ映像、センサーストリームなど、現実世界からの視覚入力から始まります。データの品質、照明、カメラの角度には大きなばらつきがあるため、通常は分析の前に前処理が必要です。
この前処理には、画像のリサイズ、照明の調整、動画フレームの形式の統一などが含まれる場合があります。より正確な分析を支援するため、タイムスタンプやカメラの位置などの追加情報を含めることもよくあります。
準備されたデータは、システムが視覚パターンを認識できるようにする学習フレームワークで使用されます。ラベル付きの画像や動画で学習することで、ビジョンAIモデルは、さまざまな条件下で物体、パターン、イベントがどのように見えるかを学習します。
こうして学習した理解は、物体検出(画像内の物体を識別して位置を特定する)やインスタンスセグメンテーション(個々の物体をピクセル単位で分離してラベル付けする)など、一般的な多くのコンピュータービジョンタスクの基盤となります。Ultralytics YOLO26などの最先端のビジョンAIモデルは、実環境で高速かつ高精度を維持しながら、これらのタスクに対応できるよう設計されています。
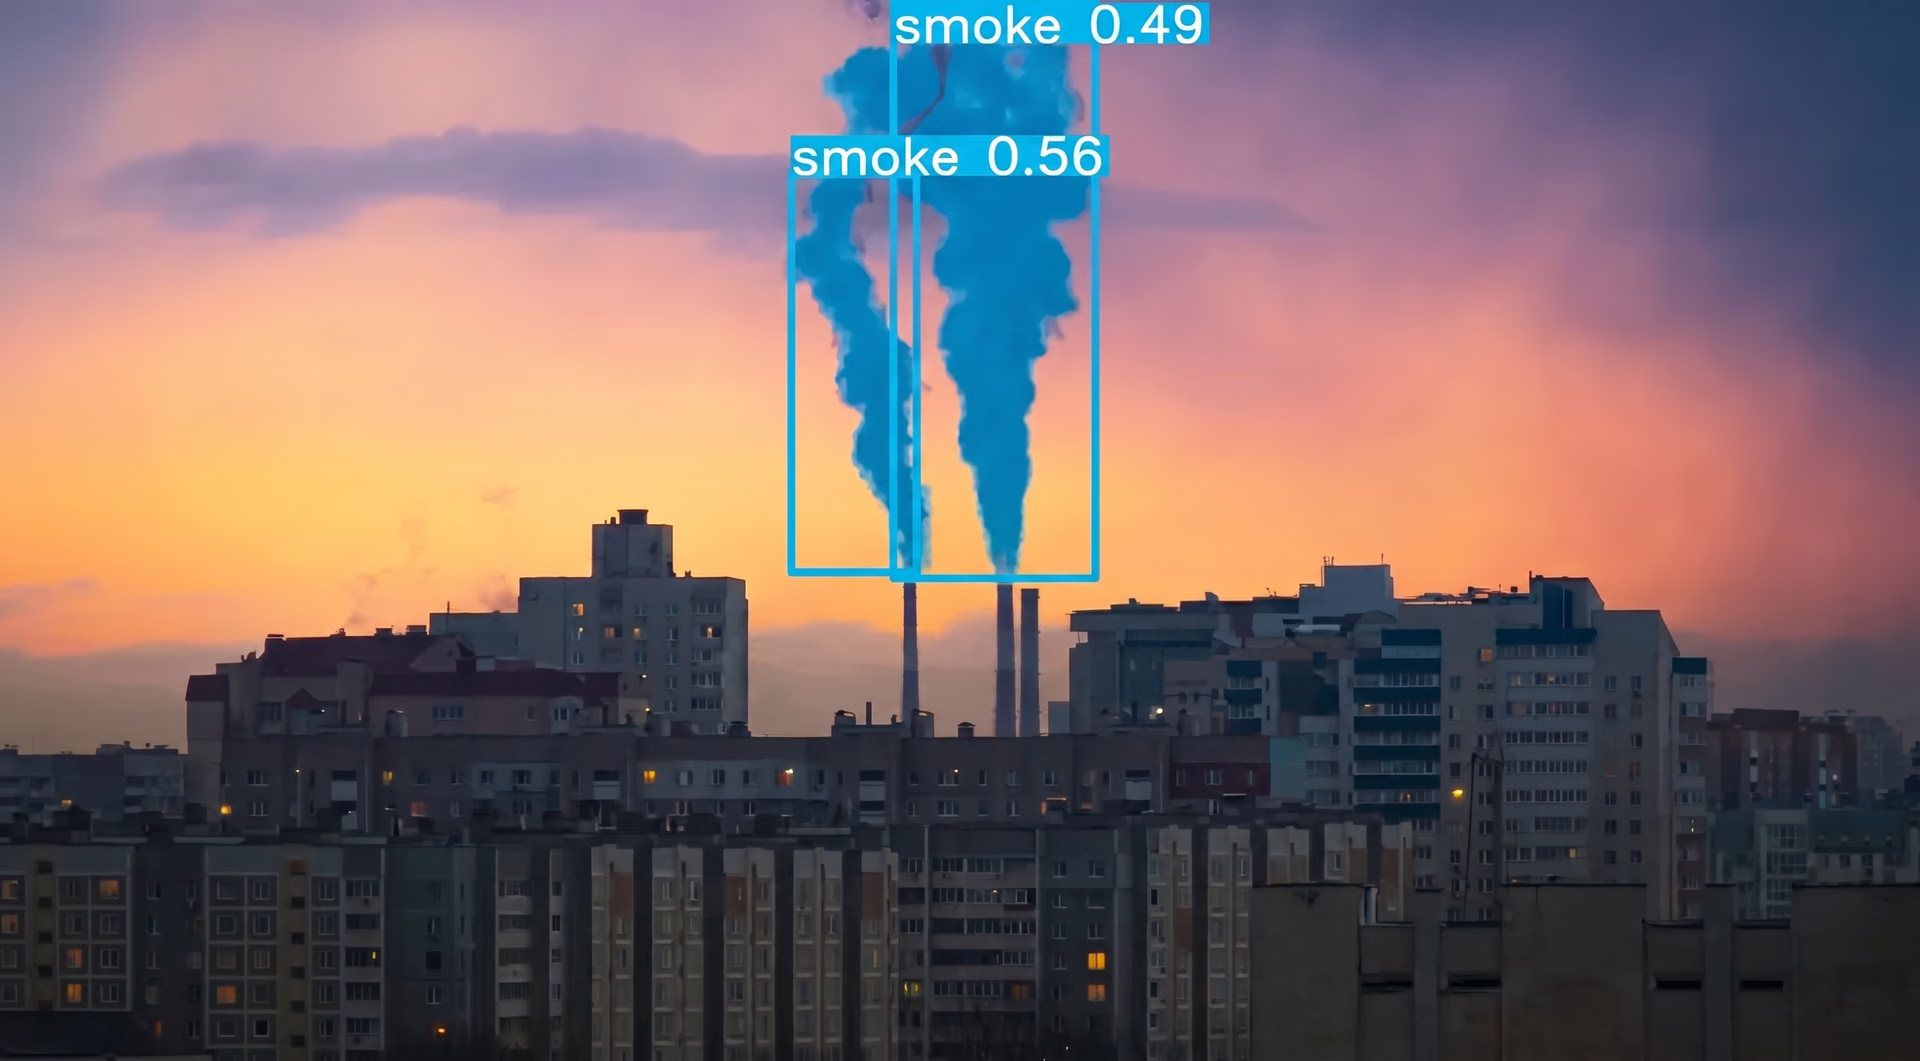
図2. インスタンスセグメンテーションにYOLOを使用する例(出典)
システムの導入後は、エンドツーエンドのワークフローの一環として視覚入力が継続的に処理されます。モデルが画像や動画を分析し、その出力をダッシュボード、自動化ツール、その他のAIシステムに送信します。場合によっては、ビジョンAIエージェントが結果を使ってアクションを実行したり、意思決定を支援したりすることで、視覚的な理解を実用的かつ実行可能な知見に変えます。
ビジョンモデルとアーキテクチャの進化#
ビジョンAIについて理解を深めるなかで、モデルとアーキテクチャがなぜ重要なのか、システムのパフォーマンスにどう影響するのか疑問に思うかもしれません。ビジョンAIモデルは、今日のコンピュータービジョンの革新に欠かせない要素です。
ほとんどのビジョンAIシステムは、画像や動画の分析方法を決めるモデルを中心に構築されています。モデルによって、システムがシーン内で何を認識できるか、またさまざまな条件下でどの程度適切に動作するかが決まります。
ビジョンAIの用途が多様化し複雑になるにつれて、ビジョンAIモデルとその基盤となるアーキテクチャも進化を続け、ニーズに対応しながら使いやすくなっています。初期のコンピュータービジョンシステムでは、特定のエッジ、色、形状など、何を探すべきかをエンジニアが手動で定義する必要がありました。
こうしたルールベースのアプローチは管理された環境ではうまく機能しましたが、照明が変わったり、カメラの品質が異なったり、シーンが複雑になったりすると、しばしば対応できませんでした。最新のビジョンAIモデルは異なるアプローチを採用しています。
多くのオープンソースモデルは、データから視覚パターンを直接学習するため、柔軟性が高く、条件が予測しにくい実環境に適しています。モデルアーキテクチャの進歩により、画像や動画の処理方法も簡素化され、こうしたシステムをビジョンAIプラットフォームにデプロイして統合しやすくなりました。
Ultralytics YOLOモデルは、この変化をよく示す例です。YOLO26などのモデルは、速度と一貫性が求められる物体検出タスク、特にライブ動画の用途で広く使われています。
ビジョンAIの主要タスクを詳しく見る#
AIを活用したビジョンシステムが視覚情報を理解し、実環境の業務を効率化するために用いる、主要なコンピュータービジョンタスクをいくつか紹介します。
- 物体検出: このタスクでは、画像や動画に含まれる物体の種類と位置をシステムが特定します。通常は各物体の周囲にバウンディングボックスを描画します。
- インスタンスセグメンテーション: より高い精度が求められるタスクでは、画像をピクセル単位で分解し、シーン内の物体や領域を分離します。
- 画像分類: 画像全体を分析し、全体的な内容に基づいて1つ以上のラベルを割り当てるアプローチです。視覚情報の整理や意思決定に役立ちます。
- 姿勢推定: 関節や基準点など、人や物体のキーポイントを特定し、動的な環境での位置、姿勢、動きを判断します。
- 物体追跡: 動画を使う用途では、物体の識別情報と時間経過に伴う動きを維持しながら、フレーム間で物体を追跡できます。
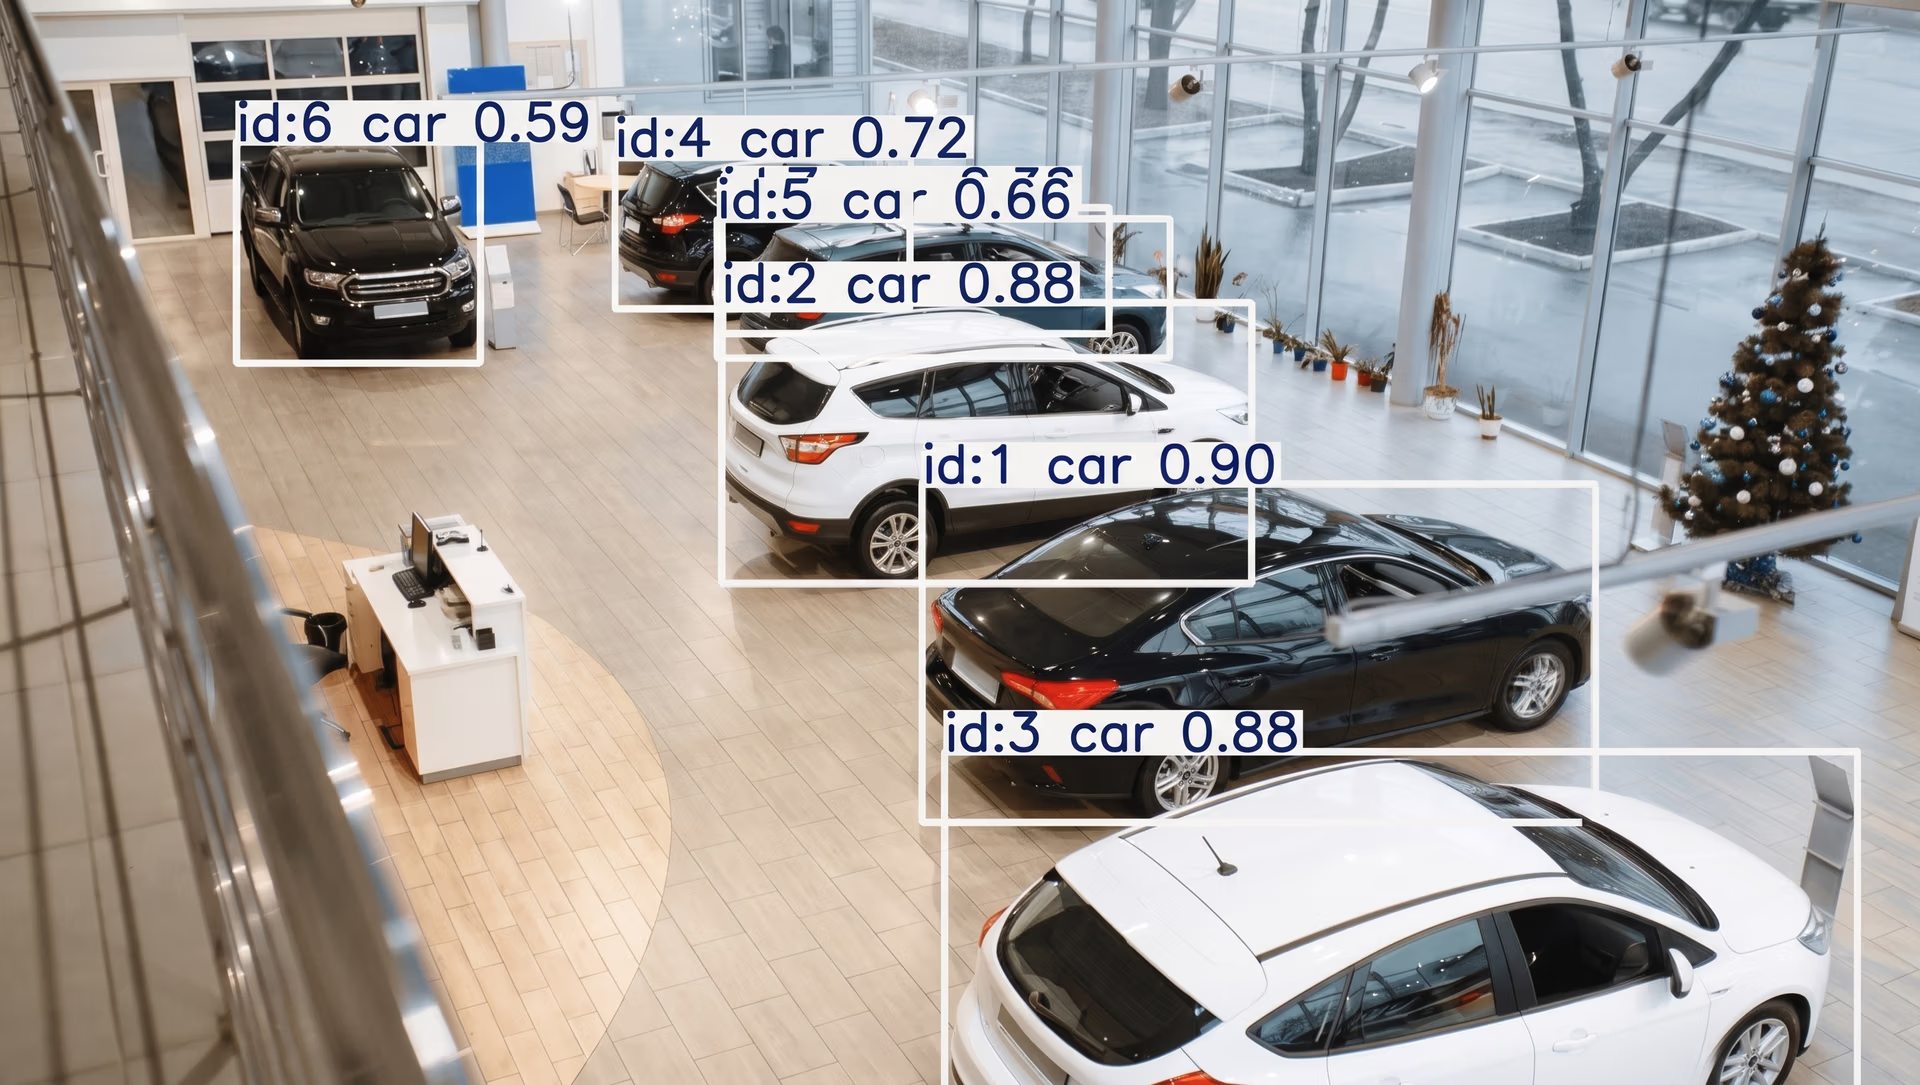
図3. YOLOを使用した車両の検出と追跡(出典)
ビジョンAIにおけるデータセットの役割#
効果的なビジョンAIシステムの背後には、適切にキュレーションされたデータセットがあります。ビジョンAIデータセットは、ビジョンAIモデルが学習に使う画像や動画を提供し、実環境で物体、パターン、シーンを認識できるよう支援します。
データの品質は、システムの精度と信頼性に直接影響します。視覚データを活用できるようにするには、データセットにアノテーションを付けます。これは、物体のラベル付け、特定領域の強調表示、カテゴリの割り当てなど、各画像や動画に重要な情報を追加することです。
ラベルに加えて、データの整理と理解の向上に役立つ時間、場所、シーンの種類などのメタデータを含めることもできます。また、見たことのない画像でシステムを評価できるよう、データセットは一般に学習用、検証用、テスト用に分割されます。
ImageNet、COCO、Open Imagesなどの代表的なデータセットは、大規模で多様なラベル付き画像のコレクションを提供し、ビジョンAIの発展に大きく貢献してきました。それでも、実環境のデータ収集は依然として困難です。
バイアス、網羅性の不足、絶えず変化する環境が、実際の条件を真に反映するデータセットの作成を難しくしています。信頼性の高いビジョンAIシステムを構築するには、大規模なデータを適切なバランスで確保することが重要です。
ビジョンAIのさまざまな活用例#
ビジョンAIの仕組みを理解したところで、実環境の用途でどのように活用されているかを見ていきましょう。多くの業界でビジョンAIは、大規模な視覚タスクへの対応を支援し、迅速な対応と効率的な業務につなげています。
さまざまな分野におけるビジョンAIの一般的な活用例をいくつか紹介します。
- 製造: 工場では、ビジョンAIを使って製造工程の各段階を進む製品を監視できます。早い段階で欠陥、部品の不足、不整合を検出し、手直しの削減、品質の維持、予期しない稼働停止の回避を支援します。
- 小売業: 小売店舗では、ビジョンAIソリューションを使って在庫を追跡し、棚の状態を確認し、損失を削減できます。店内の視覚情報を分析することで、スタッフが現場の状況を把握しやすくなり、業務を円滑に進めるための調整を迅速に行えます。
- 医療: ビジョンAIは、スキャン画像や検査結果などの医療画像の確認を支援し、医療従事者をサポートできます。さらに詳しい確認が必要な可能性がある領域にフラグを付けることで、最終的な判断は人間が担いながら、臨床医がより効率的に業務を行えるようにします。
- 輸送とスマートシティ: 道路や公共スペースでは、ビジョンAIが交通の流れの監視、事象の検出、安全性の向上を支援します。カメラ映像をリアルタイムで分析することで、状況の変化に迅速に対応でき、都市インフラのより良い管理にもつながります。
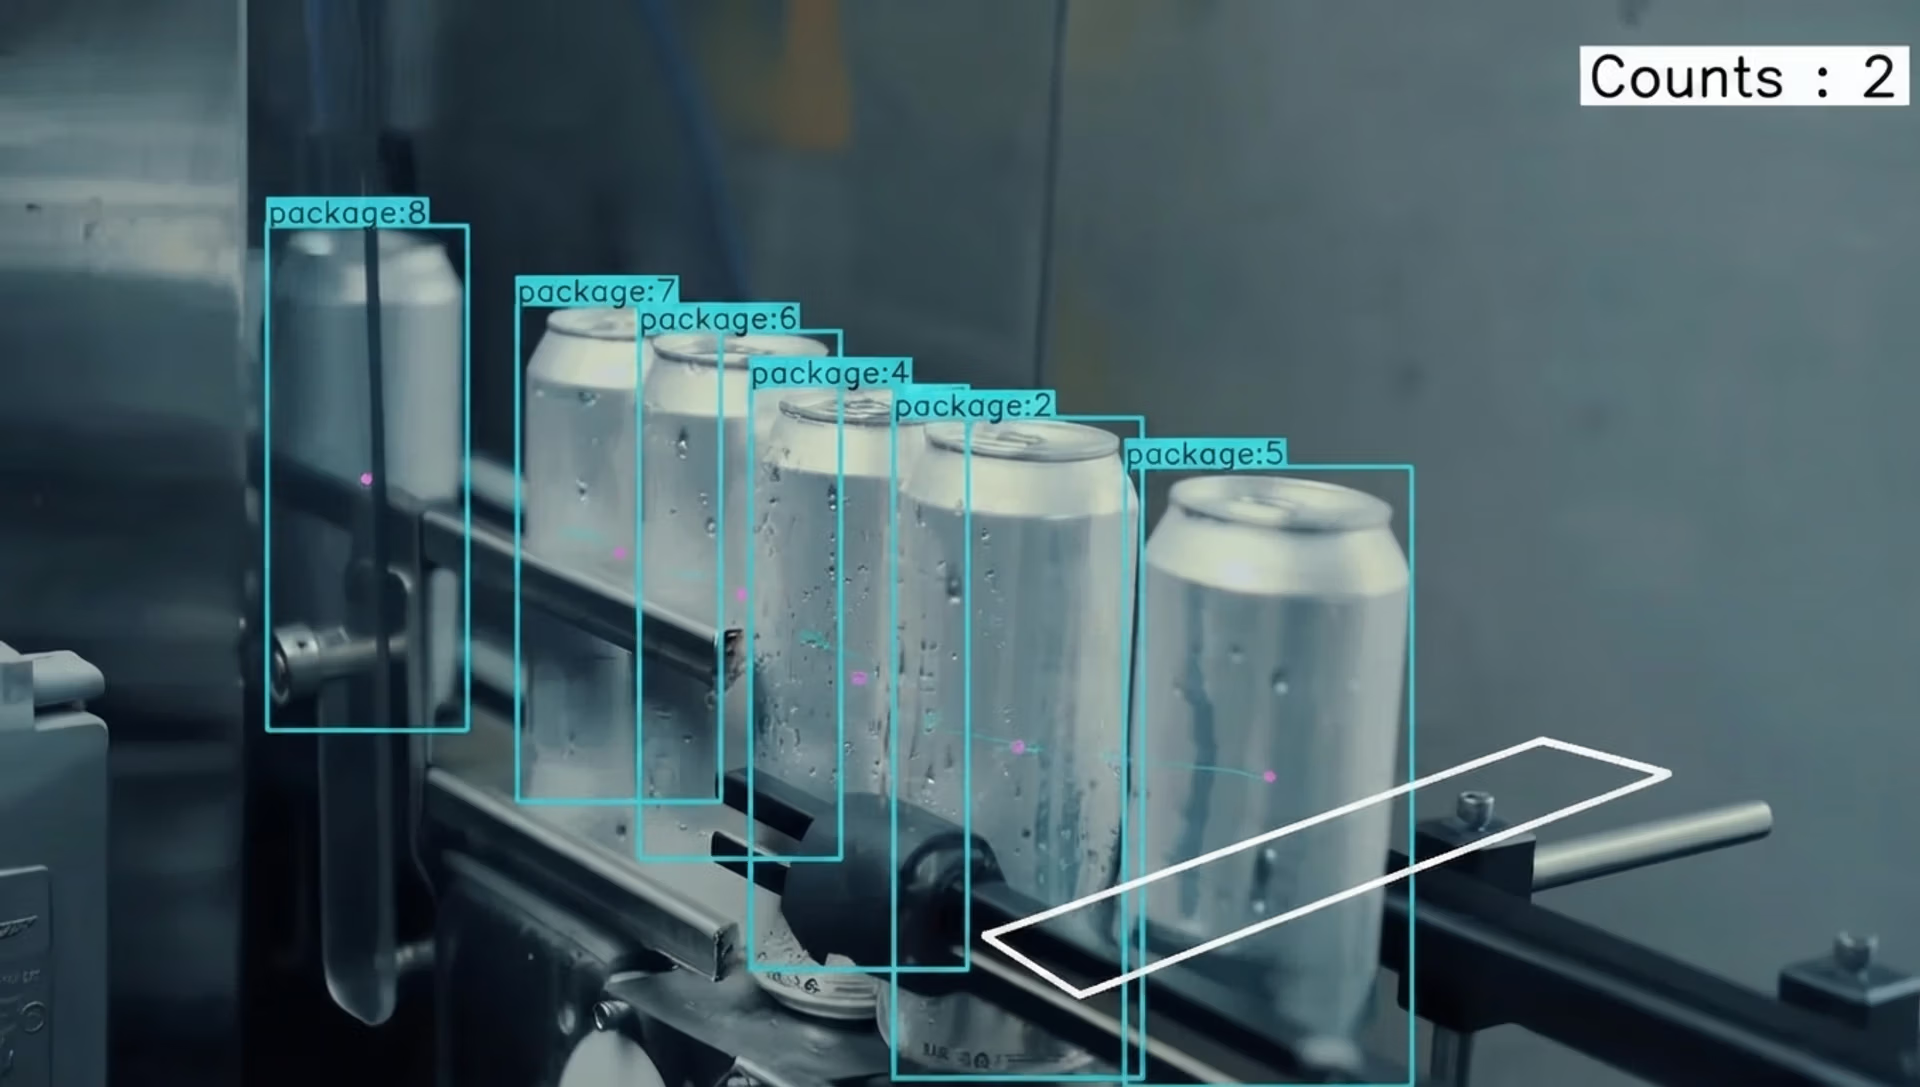
図4. 製造業におけるビジョンAIを使った製品監視の自動化(出典)
ビジョンAIツールの長所と短所#
実環境の用途でビジョンAIを使用する主な利点をいくつか紹介します。
- さまざまなユースケースに対応: 学習後のビジョンAIシステムは、わずかな変更で複数の場所やアプリケーションに導入できます。
- AIによる迅速な支援: 画像や動画を撮影時に分析することで、ビジョンAIを活用したシステムはリアルタイムのインサイトを提供し、迅速な対応とより良い意思決定を支援できます。
- 既存のワークフローに簡単に統合: ビジョンAIの出力は、後続システム、ダッシュボード、自動化パイプラインに接続できます。
こうした利点がある一方で、ビジョンAIシステムの性能に影響を与える制約もあります。留意すべき要素を以下に示します。
- データの品質と可用性への依存: ビジョンAIシステムは、大規模で適切に準備されたデータセットに大きく依存します。高品質な視覚データの収集と維持には、時間とコストがかかる場合があります。
- 環境変化への敏感さ: 再学習や調整を行わずに、カメラの位置や照明が変わったり、シーンが大きく変化したりすると、性能が低下する可能性があります。
- コンピューティングとインフラストラクチャの要件: ビジョンAIモデルの実行、特にリアルタイムや大規模な実行には、相当なコンピューティングリソースや専用ハードウェアが必要になる場合があります。
重要なポイント#
ビジョンAIは画像や動画を、システムが理解して活用できる有用な情報に変換します。これにより、視覚タスクを自動化し、より迅速で信頼性の高い意思決定を支援できます。その効果は、高性能なモデル、高品質なデータセット、適切に設計されたワークフローが連携するかどうかに左右されます。
ビジョンAIに関心がありますか?コミュニティに参加して、農業におけるコンピュータービジョンや自動車業界におけるビジョンAIについて学びましょう。コンピュータービジョンを始めるには、ライセンスオプションをご確認ください。GitHubリポジトリにアクセスして、AIについてさらに探求しましょう。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









