Ultralytics YOLO11による小物体検出を探る
Ultralytics YOLO11が、監視やロボティクスなどの実環境のアプリケーションで、小さな物体を高速かつ正確に検出する仕組みをご紹介します。
 Abirami Vina13 分で読めます
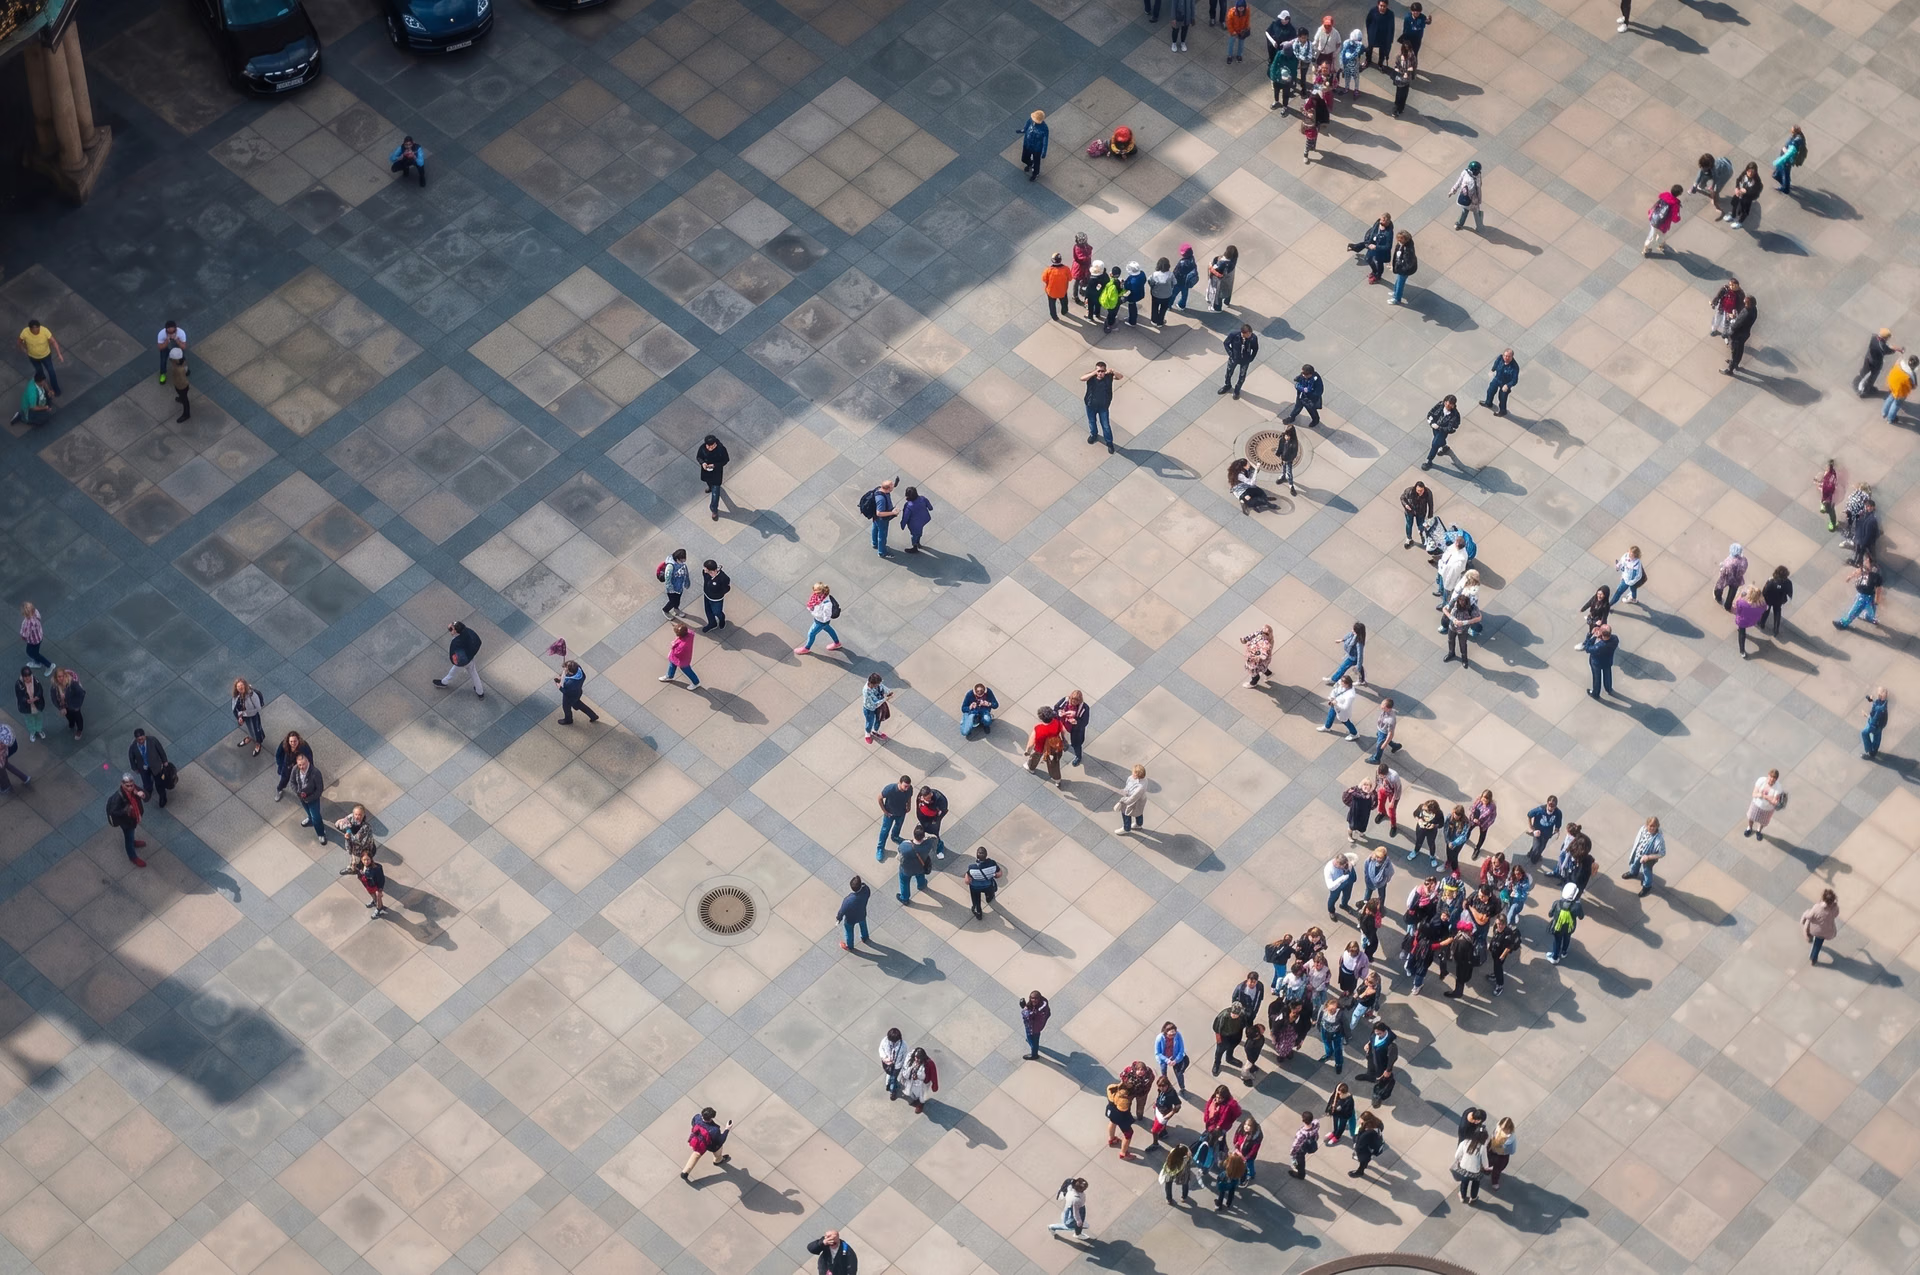
ビジョンAIを組み込んだドローンは、地上から数百メートルの高さを飛行しながら、映像上ではわずか数ピクセルにしか見えない人物を検出する必要があります。これは実際によくある課題であり、ロボティクス、監視、リモートセンシングなどのアプリケーションでは、画像内の非常に小さな物体をシステムが特定しなければなりません。
しかし、従来の物体検出モデルでは、これが難しい場合があります。画像や動画内の小さな物体から得られる視覚情報は非常に限られています。つまり、モデルがそれらを見ても、学習や認識に使える詳細情報がほとんどありません。
これらのモデルは通常、畳み込みニューラルネットワーク(CNN)ベースのアーキテクチャを採用しています。画像はネットワークの各層を通過し、生のピクセルではなく、関連するパターンを強調した特徴マップまたは簡略化された表現に変換されます。
画像がネットワークの深い層へ進むにつれて、特徴マップは小さくなります。これにより計算は高速になりますが、細部が失われる可能性もあります。
小さな物体では、こうした細部が非常に重要です。細部が失われると、コンピュータビジョンモデルによる物体検出が難しくなり、バウンディングボックスの精度が低下したり、一貫性が損なわれたりする可能性があります。
リアルタイムのエンドツーエンドコンピュータビジョンシステムでは、課題がさらに複雑になります。高解像度画像は細部を保ちやすい一方、推論が遅くなり、より多くのGPU性能が必要です。低解像度では処理は速くなりますが、小さな物体の検出はさらに難しくなります。
速度、精度、ハードウェアの制限を常に両立させる必要があります。近年の技術進歩により、Ultralytics YOLO11や、その後リリースされたUltralytics YOLO26などのコンピュータービジョンモデルは、このトレードオフをより効果的に管理できるよう設計されています。
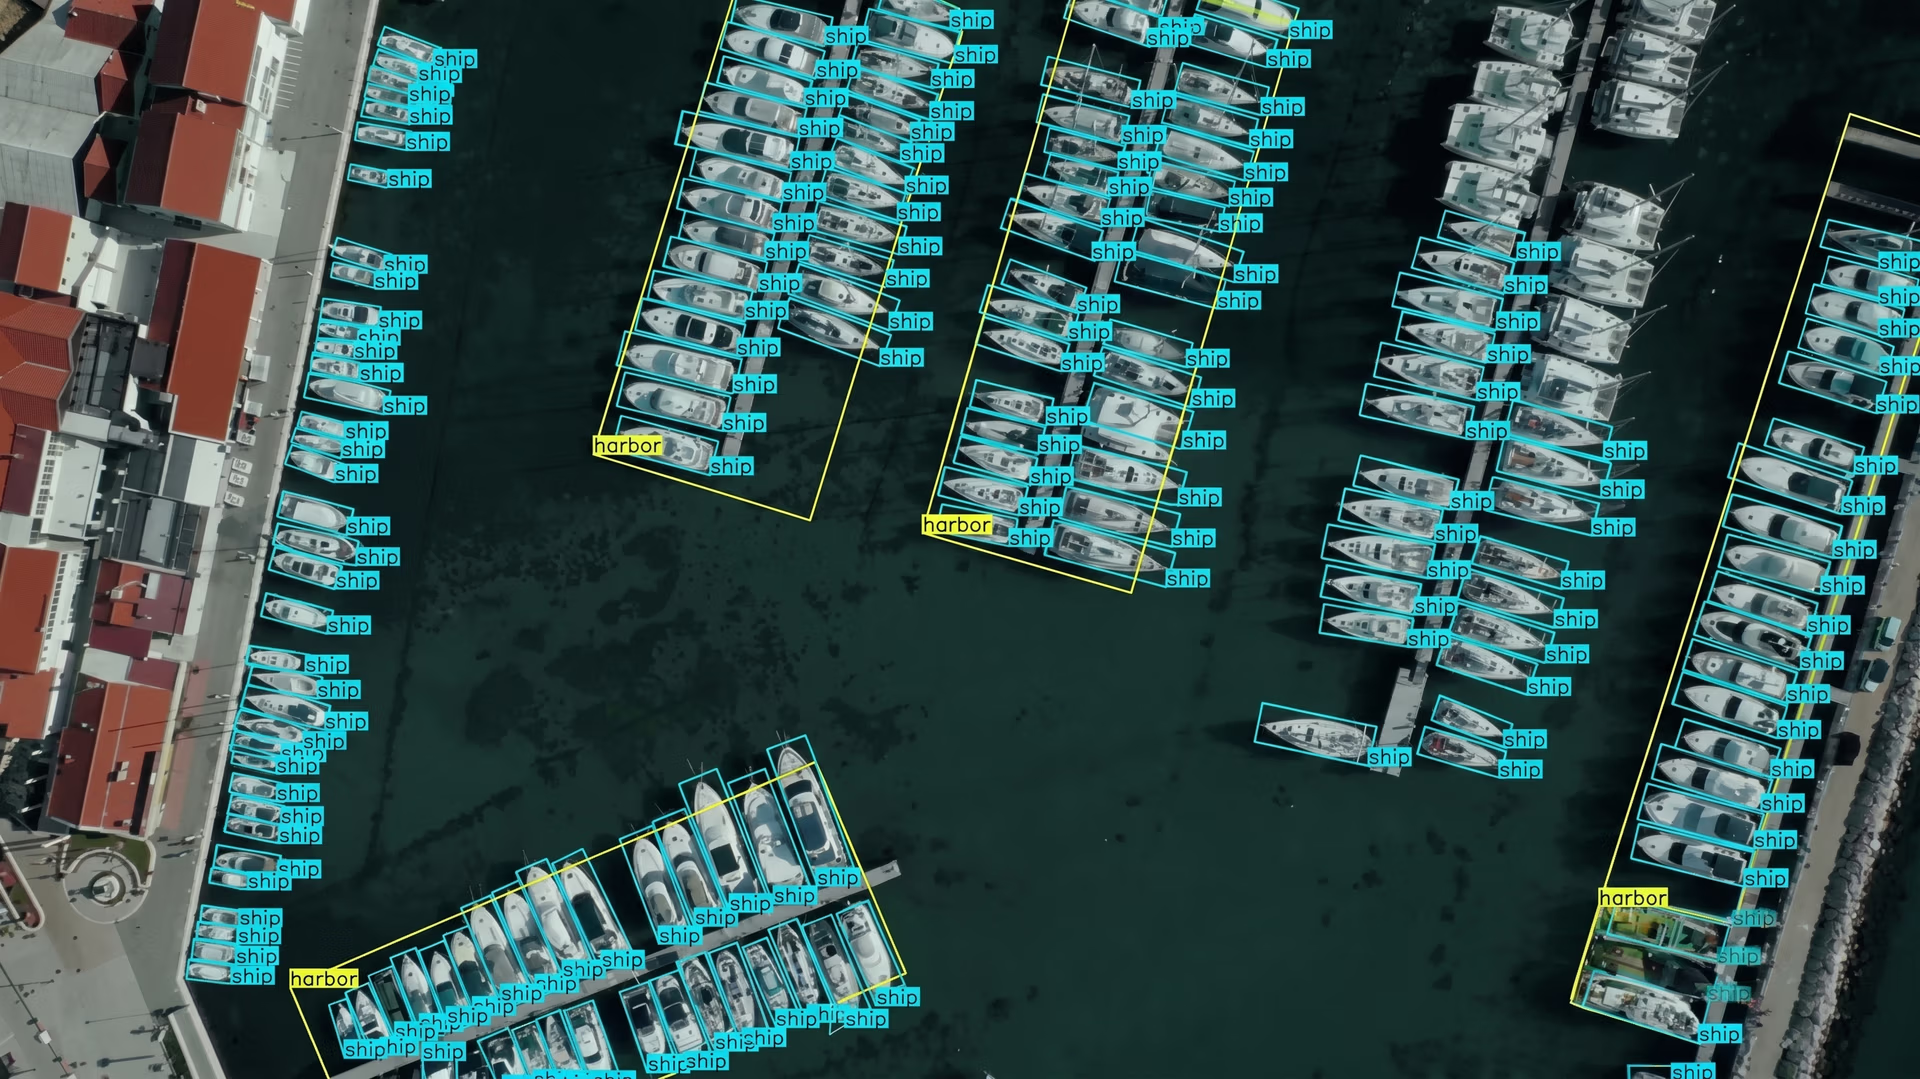
図1. YOLO11を使用した航空画像内の小さな物体の検出(出典)
この記事では、小物体検出が難しい理由と、Ultralytics YOLO11によってどのように容易になるかを紹介します。
小さな物体の検出とは何か、なぜ重要なのか#
小さな物体の検出は、AIの一分野であるコンピュータビジョンのタスクで、画像内のごく小さな領域を占める物体の識別と位置特定に焦点を当てています。こうした物体は、デジタル画像を構成する最小単位であるピクセルが限られた数しか割り当てられないことが多く、そのため、より大きく鮮明な対象(多くの場合、より多くのピクセルを含みます)よりも検出が難しくなります。
たとえば、航空画像に写る車両、工場の床にある工具、広角監視カメラで撮影された人などは、画像内で小さな物体として映る場合があります。こうした物体には重要な情報が含まれていることが多く、監視などの多くの実環境での用途は、正しく機能するためにこれらの検出に依存しているため、検出が重要です。
小さな物体を見逃すと、システムの性能や意思決定に影響が及ぶ可能性があります。無人航空機(UAV)による監視はその一例で、地上を動く小さな物体を見逃すと、航行や追跡の精度に影響することがあります。
小さな物体の検出に関する課題#
初期のシステムでは、手作業で設計した特徴量や従来のコンピュータビジョン手法が使われていましたが、複雑なシーンや多様なシーンではうまく機能しませんでした。現在ではディープラーニングモデルの性能が大幅に向上していますが、画像内で占める割合がごくわずかな小さな対象の検出は、依然として困難です。
次に、実環境のさまざまな状況で小さな物体を検出する際に生じる、よくある課題を見ていきましょう。
サイズ、ピクセル、情報の損失#
小さな物体はピクセル数が非常に少ないため、特徴抽出などの段階でモデルが学習できる視覚的な詳細情報が限られます。その結果、エッジ、形状、テクスチャなどのパターンを検出しにくくなり、小さな物体が背景に溶け込む可能性が高まります。
画像がニューラルネットワークの畳み込み層を通過すると、ピクセル内の視覚情報は特徴マップへと徐々に圧縮されます。これによりモデルの効率性は保たれますが、細部も失われていきます。
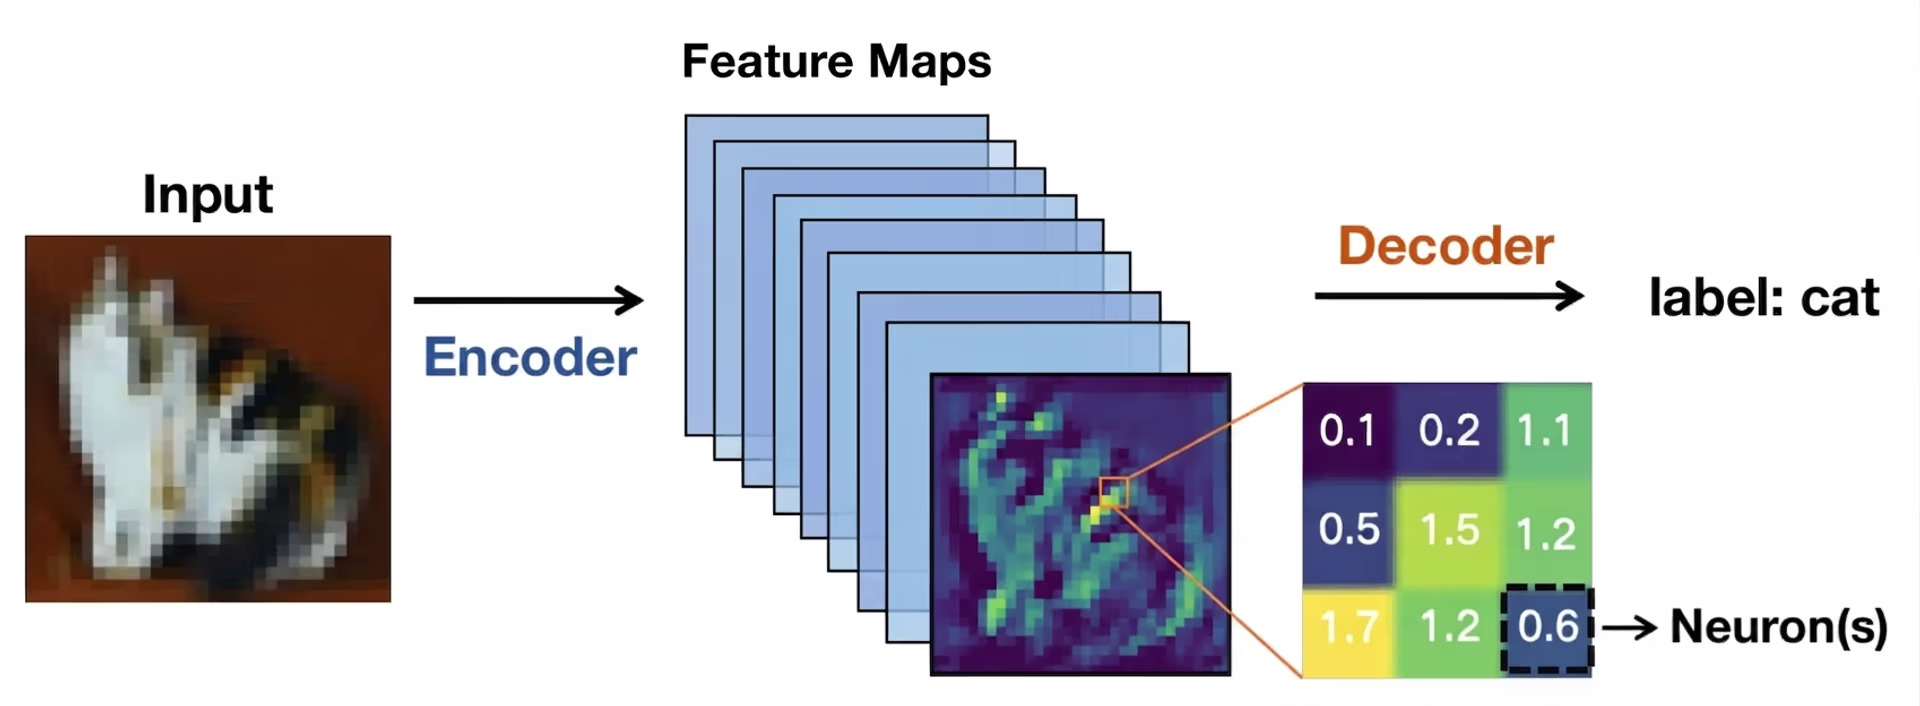
図2. 特徴マップは画像内の視覚パターンを表します(出典)
小さな対象では、検出ネットワークが処理を開始する前に重要な手がかりが失われることがあります。そうなると位置特定の信頼性が低下し、バウンディングボックスがずれたり、重なったり、対象を完全に見逃したりする可能性があります。
オクルージョン、スケールのばらつき、コンテキスト#
サイズに関する課題は、オクルージョンによって生じることもよくあります。オクルージョンとは、特に小さな物体の一部が、シーン内の別の物体によって隠されることです。
これにより対象の可視領域が狭まり、物体検出器が利用できる情報が限られます。わずかなオクルージョンでも検出ネットワークが混乱する場合があり、低解像度の入力と組み合わさると特に顕著です。たとえば、VisDroneなどのUAVデータセットでは、歩行者、自転車、車両が建物、木、その他の移動物体によって部分的に隠れていることがあります。
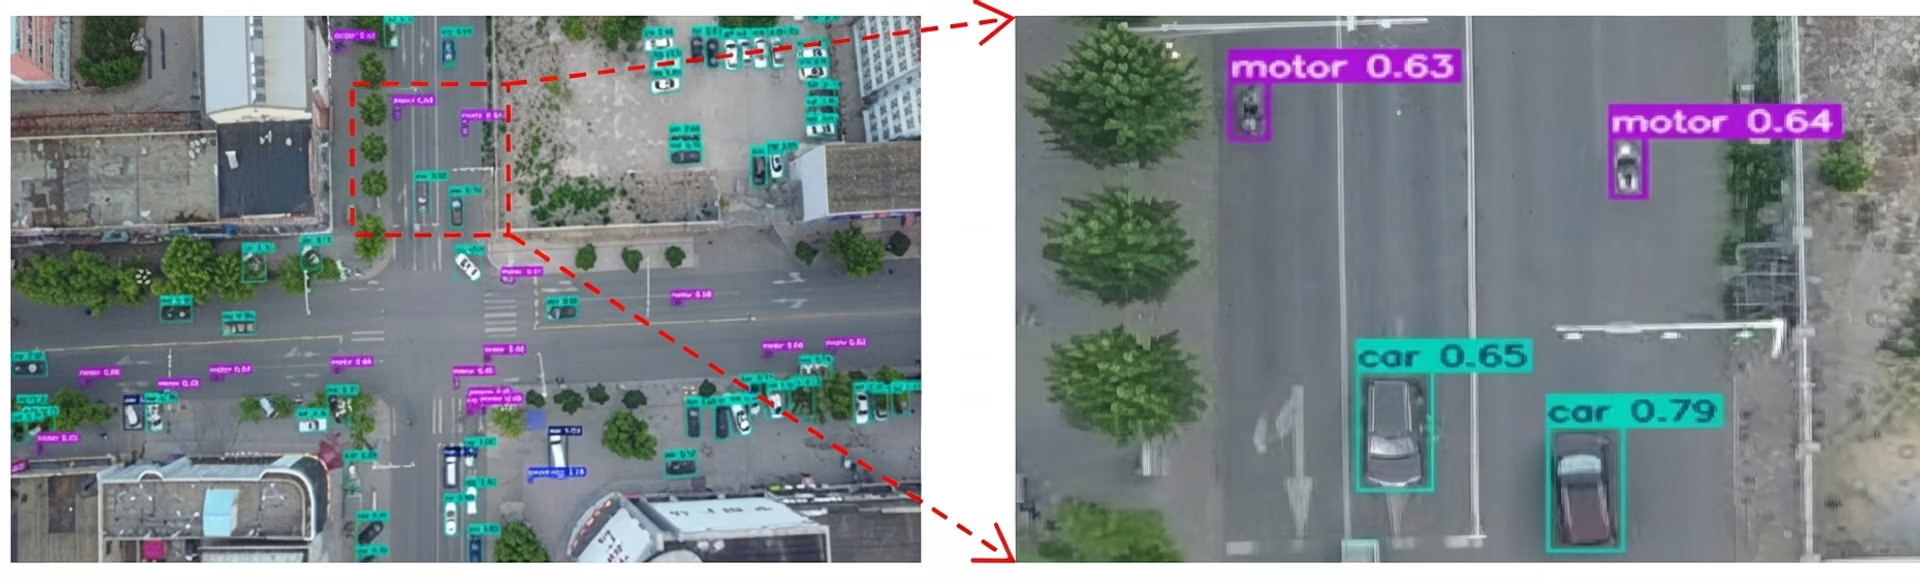
図3. 小さな物体を示すVisDroneデータセットの例(出典)
同様に、距離やカメラの位置によって同じ物体が非常に小さく見えたり、比較的大きく見えたりするスケールのばらつきも、難しさを増す要因です。こうした課題があっても、検出アルゴリズムには精度を損なわずに、さまざまなスケールの小さな物体を認識することが求められます。
コンテキストも検出において重要な役割を果たします。たとえば、大きな物体は通常、役立つ視覚的な手がかりを含む明瞭な周辺環境とともに映ります。一方、小さな対象にはこうしたコンテキスト情報が不足していることが多く、パターン認識が難しくなります。
小さな物体の検出における見えにくい指標の問題#
Intersection over Union(IoU)などの一般的な評価指標は、予測されたバウンディングボックスが正解ボックスとどの程度重なっているかを測定します。IoUは大きな物体では有効ですが、小さな物体では挙動が大きく異なります。
小さな物体は数ピクセルしか占めないため、予測ボックスがわずかにずれるだけでも、割合として大きな誤差となり、IoUスコアが大幅に低下する可能性があります。そのため、画像内に物体が見えていても、正しい予測として数えるための標準的なIoU閾値を満たせないことがよくあります。
その結果、位置特定の誤差が偽陽性または偽陰性に分類されやすくなります。こうした制約を受けて、研究者は物体検出システムで小さく検出しにくい対象を評価し、処理する方法を見直すようになりました。
マルチスケール特徴:リアルタイムの小物体検出の鍵#
研究者たちが小さな物体の検出性能の向上に取り組む中で、複数のスケールにわたって視覚情報を保持し、表現することが不可欠だと明らかになりました。この知見は、近年のarXivの研究や、IEEE International ConferencesやEuropean Conference on Computer Vision (ECCV)などで発表された論文にも反映されています。
画像がニューラルネットワークの深い層へ進むにつれて、小さな物体は細部を失ったり、完全に消えたりする可能性があります。そのため、Ultralytics YOLO11などの最新のコンピュータビジョンモデルは、特徴抽出の改善を重視しています。次に、特徴マップと特徴ピラミッドネットワークの基本概念を見て、理解を深めましょう。
特徴マップとスケール表現#
リモートセンシング画像などの入力画像がニューラルネットワークに入ると、徐々に特徴マップへと変換されます。特徴マップは画像を簡略化した表現で、エッジ、形状、テクスチャなどの視覚パターンを強調します。
ネットワークの層が深くなるにつれて、特徴マップの空間サイズは小さくなります。この縮小によりモデルは効率的に動作し、高レベルの情報に集中できます。ただし、特徴マップの縮小と深層化によって空間的な詳細も失われます。
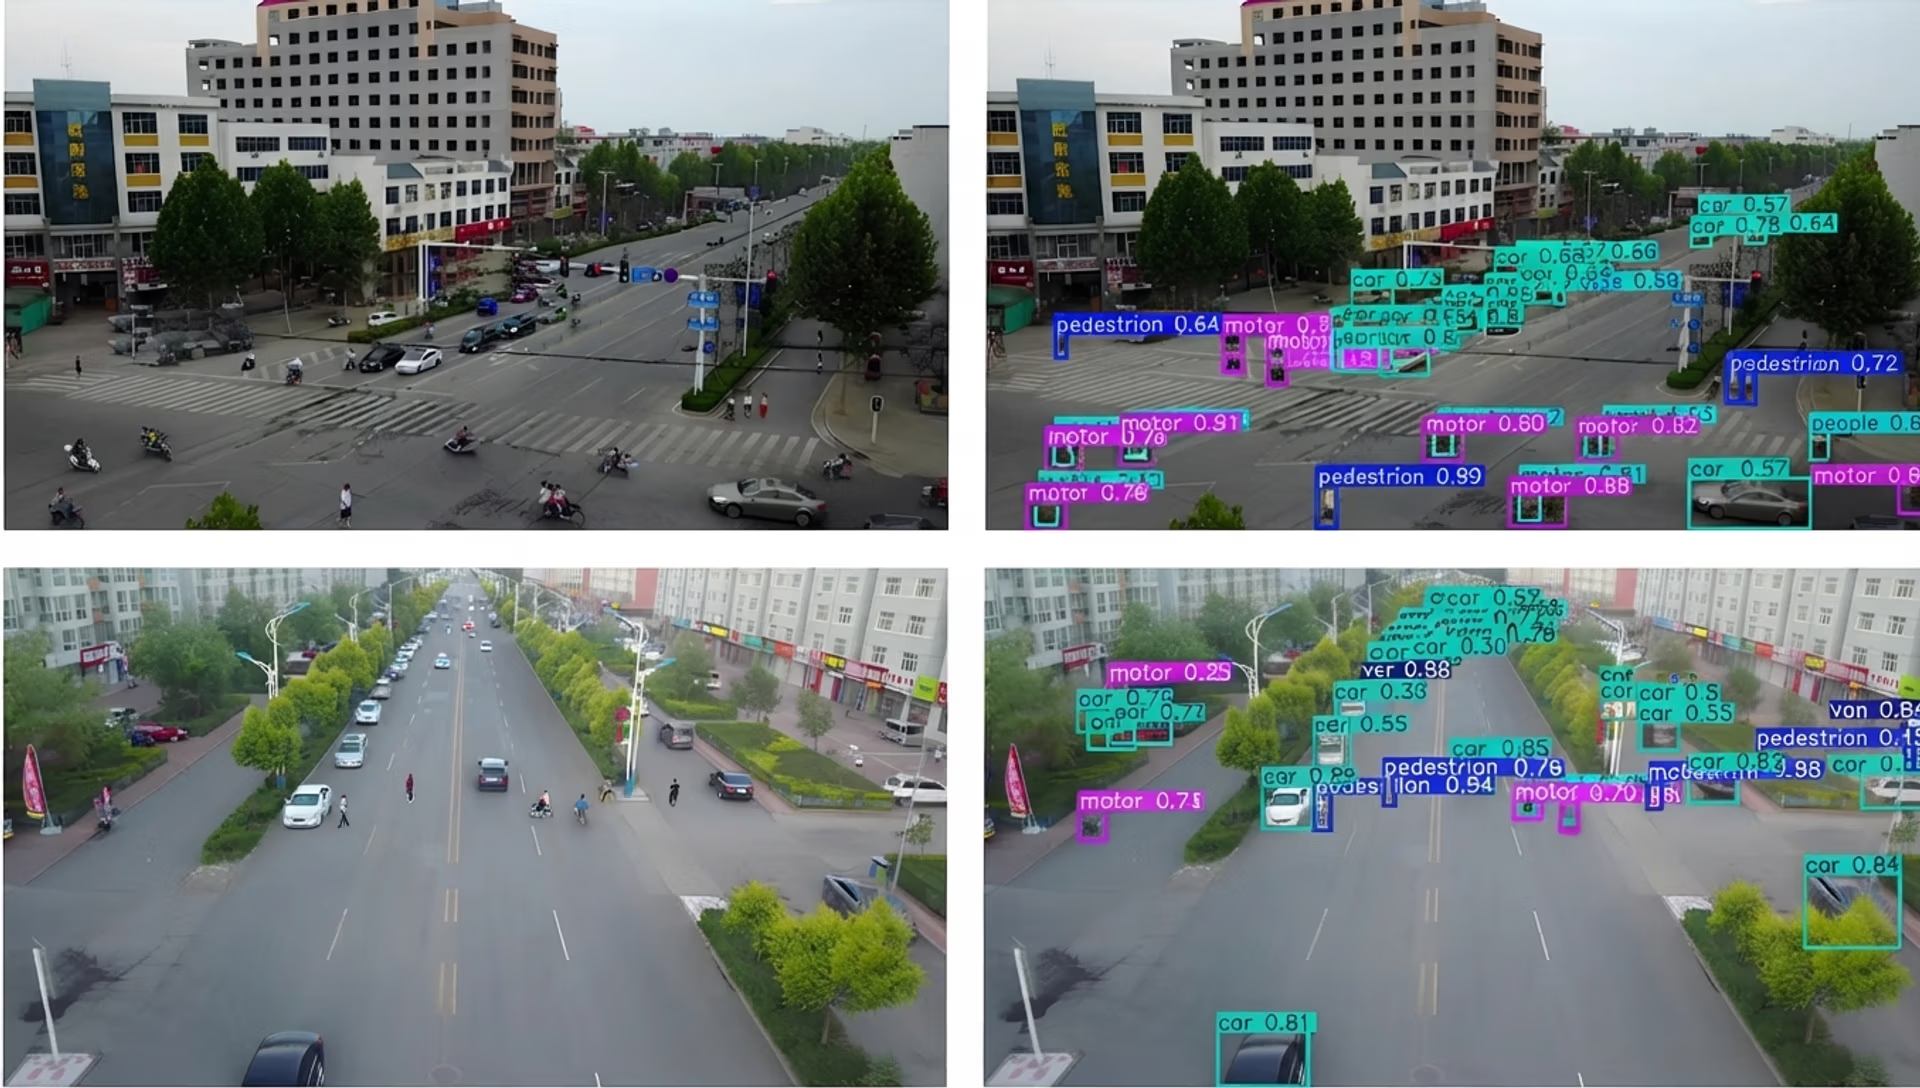
図4. 小さな物体の検出には特徴抽出が重要です。(出典)
大きな物体は正確な検出に十分な視覚情報を保持できますが、小さな対象はネットワークのわずか数層を通過するだけで重要な詳細を失うことがあります。そうなると、モデルは小さな物体の存在自体を認識しにくくなります。これが、深層物体検出モデルで小さな物体を見逃す主な理由の一つです。
特徴ピラミッドネットワークとマルチスケール学習#
特徴ピラミッドネットワークは、空間的な詳細の損失に対処するために導入され、一般にFPNと呼ばれます。複数の層からの情報を組み合わせる補助モジュールとして機能し、モデルによる小さな物体の検出をより効果的にします。この処理は、特徴集約や特徴融合とも呼ばれます。
浅い層は細かな空間情報を提供し、深い層は意味的なコンテキストを加えるため、効果的なマルチスケール特徴学習が可能になります。特徴マップを単純に拡大するだけの素朴なアップサンプリングとは異なり、FPNは意味のある情報を保持し、小さな物体の検出を改善します。
最新の手法では、この考え方を発展させ、適応的な特徴融合やコンテキストを考慮した設計によって、小さな対象の検出をさらに強化しています。つまり、FPNによってモデルは全体像と細かな部分を同時に捉えられます。この最適化は、物体が小さい場合に不可欠です。
小さな物体に対応するための物体検出モデルの進化#
非常に小さな物体を含め、さまざまなサイズの物体をより適切に検出するため、物体検出モデルがどのように進化し、発展してきたかを簡単に紹介します。
- 初期の検出手法: 初期の物体検出手法は、手作業で設計した特徴量と、古典的な画像処理に基づくルールベースのアルゴリズムに依存していました。特徴量が固定されていたため、異なる画像では性能が低下しました。
- 機械学習とディープラーニングの導入: 機械学習とディープラーニングの採用は、物体検出研究に大きな変化をもたらしました。事前に定義したルールに頼るのではなく、ニューラルネットワークがトレーニングデータから視覚表現を直接学習することで、さまざまな物体サイズやシーンへの適応性が向上しました。
- 畳み込みネットワーク: これらのニューラルネットワークは、画像内のパターンを認識する方法を学習します。各層が異なる詳細を捉え、単純なエッジや色から始まり、形状、そして最終的には物体全体へと学習を進めるため、現代のコンピュータビジョンに欠かせません。
- 2段階物体検出器: Renらが提案したFaster R-CNNなどの2段階検出器は、まず候補領域を生成し、その後に分類を行います。このアプローチにより小さな物体の精度は向上しましたが、計算コストが増加し、リアルタイム性能が低下しました。
- 1段階物体検出器: SSD(Single-Shot Detector)やYOLO(You Only Look Once)ファミリー(YOLOv3、Ultralytics YOLOv5、後継のUltralytics YOLOv8など)の1段階検出器は、1回の処理で検出を行います。この設計は、競争力のある精度を保ちながら推論速度を大幅に向上させます。
- 最新の最先端モデル: 新しい物体検出モデルでは、リアルタイム性能とエッジデバイスへのデプロイがより重視されています。Ultralytics YOLO11やUltralytics YOLO26など、近年リリースされたUltralytics YOLOモデルは、高い精度と低レイテンシの推論を両立するよう設計されています。そのため、小さな対象物を含むあらゆるサイズの物体を、計算能力が限られたデバイス上で検出するのに適しています。
小さな物体の検出用途にUltralytics YOLO11を活用する#
小さな物体の検出の仕組みをよりよく理解できたところで、Ultralytics YOLO11を活用できる実環境での用途をいくつか見ていきましょう。
UAVと航空画像#
にぎやかな市街地の上空を飛ぶドローンを想像してみてください。その高さから見ると、車、自転車、さらには人も、画面上ではわずか数ピクセルに縮んでしまいます。
UAVや航空画像のモジュールでは、このようなシーンがよく撮影されます。関心のある物体は非常に小さく、雑然とした背景に囲まれているため、コンピュータビジョンモデルによる検出が困難です。
こうしたシナリオでは、Ultralytics YOLO11が理想的なモデルの選択肢となる場合があります。たとえば、VisDroneなどの航空画像データセットでファインチューニングしたYOLO11モデルを搭載したドローンは、シーン内を移動する車両、自転車利用者、歩行者を、各物体が画像のごく一部しか占めない場合でもリアルタイムで検出し、交通状況を監視できます。これにより、交通管理、公共の安全、都市計画などのアプリケーションで、より迅速な意思決定と正確な知見が可能になります。
ロボティクスと自動化#
ロボットは、精度とタイミングが重要な環境でよく使用されます。倉庫、工場、農場などでは、ロボットが生産ラインの部品、荷物のラベル、畑の小さな植物の芽などを認識し、迅速に反応する必要がある場合があります。
カメラ映像内で数ピクセルしかない物体や、別の物体に一部が隠れている物体は、特に検出が困難です。こうした小さな詳細を見逃すと、自動化の速度が低下したり、ロボットがタスクを完了する能力に影響したりする可能性があります。
このような状況では、Ultralytics YOLO11が役立ちます。特徴抽出の改善と高速な推論により、ロボットはリアルタイムで小さな物体を検出し、すぐに対応できます。
Ultralytics YOLO11はインスタンスセグメンテーションにも対応しているため、一般的なバウンディングボックスで位置を特定するだけでなく、物体の境界や把持点をより正確に把握できます。たとえば、YOLO11を統合したロボットアームは、コンベヤーベルト上の小さな部品を見つけ、正確な形状をセグメント化し、届かなくなる前に拾い上げることで、システムの効率性と信頼性を維持できます。
Ultralytics YOLO11が小さな物体の検出に効果的な理由#
現在は数多くのコンピュータビジョンモデルが利用できますが、Ultralytics YOLO11の際立った特徴が何か、疑問に思うかもしれません。
小さな物体を検出する必要がある用途で、Ultralytics YOLO11が優れた選択肢となる理由をいくつか紹介します。
- 特徴抽出の改善: YOLO11は、改良されたバックボーンとネックのアーキテクチャを採用し、特徴抽出を強化することで、より正確な物体検出を実現します。
- エコシステムと使いやすさ: Ultralytics Pythonパッケージは、YOLO11などのモデルの読み込み、トレーニング、検証、デプロイに使える組み込み関数を提供するライブラリです。これらのワークフローは数行のコードで実行できるため、チームは小さな物体の検出向けにモデルをすばやく試し、ファインチューニングできます。
- エッジデバイスへのデプロイに最適化: Ultralytics YOLO11は、NVIDIA Jetson、Raspberry Pi、産業用カメラシステムなどのエッジデバイス上で効率的に動作します。つまり、ビジョンAIタスクをデバイス上で直接リアルタイムに実行できます。
Ultralytics YOLO11で小さな物体を検出する際に役立つ実践的な方法#
Ultralytics YOLO11のようなモデルを使うことに加えて、アノテーションの準備方法、データセット全体、モデルの学習手順も、検出性能に大きな影響を与える可能性があります。Ultralyticsのtile引数も、大きな画像内の非常に小さな対象物の検出に役立ちます。高解像度タイリングでは、ネイティブ解像度のまま重複するウィンドウを使って学習、検証、推論を実行します。
注目すべきポイントを簡単に紹介します。
- 適切なデータ拡張: スケーリングやクロッピングなどの軽度なデータ拡張は、モデルが新しい画像に汎化するのに役立ちます。ただし、大規模なデータ拡張を過度に行うと、小さな物体が変形したり消えたりして、モデルが学習しにくくなる可能性があります。
- 失敗例の確認: モデルが物体を見逃したり、誤認識したりするケースを分析すると、基準を作成し、問題がデータセット、特徴抽出中の情報損失、トレーニング設定の調整の必要性のいずれに起因するのかを明らかにできます。
- データセットの構成: モデルが意味のあるパターンを学習できるよう、データセットには小さな物体の例を十分に含める必要があります。また、トレーニング中に大きな物体が小さな物体を覆い隠さないよう、バランスを保つ必要があります。
重要なポイント#
コンピュータビジョンモデルを通過するにつれて小さな対象の詳細が失われるため、小さな物体の検出は困難です。Ultralytics YOLO11は、こうした詳細の保持を改善し、リアルタイム性能を損なうことなく、小さな物体をより確実に検出できるようにします。このバランスにより、YOLO11は実環境の用途において、正確かつ効率的な検出を支援できます。
成長を続けるコミュニティに参加しましょう!GitHubリポジトリを確認して、AIについてさらに詳しく学べます。ソリューションページでは、小売分野のコンピュータービジョンや自動車業界のAIなどのイノベーションをご覧ください。コンピュータービジョンを使った開発を今すぐ始めるには、ライセンスオプションをご確認ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









