LiteRTでのUltralytics YOLOのエクスポート
新しいLiteRTエクスポート統合により、Ultralytics YOLOの推論をモバイル、組み込み、エッジ、ブラウザー環境に単一の統合フォーマットで展開する方法を解説します。
Ultralyticsでは、クラウドへの接続に頼るのではなく、必要なデバイス上でコンピュータービジョンモデルを直接実行する動きが広がっています。モバイルアプリ、組み込みシステム、IoTセンサー、ブラウザーベースのツールでは、電力や演算能力に厳しい制約があるハードウェア上であっても、ローカルで推論を実行する必要性が高まっています。そこで、Ultralytics YOLOモデルをLiteRTに直接エクスポートできるようになったことをお知らせします。
こうしたニーズに応えるには、開発者が環境ごとに個別のエクスポートパイプラインを維持する必要がなく、これらすべての環境で利用できるモデル形式が必要です。
この機能は以前から非公式のサードパーティ製パッケージを通じて利用できましたが、今回の統合はGoogleとの公式な協業によって実現しました。LiteRTチームと緊密に連携し、LiteRT経由でUltralytics YOLOモデルをTFLiteにエクスポートするエンドツーエンドのパイプラインを構築しました。この統合により、エクスポートした1つのUltralytics YOLOモデルをモバイル、組み込み、エッジ、ブラウザーの各環境にデプロイできます。従来は別々に扱われていたTFLiteとTF.jsのエクスポート形式を、効率化された1つの形式に統合します。
LiteRTとは何ですか?#
LiteRT(Lite Runtimeの略)は、Googleが提供するオンデバイスAI向けの高性能ランタイムです。TensorFlow Lite(TFLite)の次世代版であり、新しい名称です。開発者に広く知られている従来と同じ.tfliteモデル形式を実行できます。
LiteRTは、オンデバイス推論、別名エッジコンピューティングに特化して設計されたオープンソースのフレームワークです。開発者はこのフレームワークを使って、モバイル、組み込み、IoTデバイス、従来型のコンピューターに加え、LiteRT.jsを通じてWebブラウザーやNode.js上でも直接、学習済みモデルを実行できます。LiteRTのエクスポート形式は、物体検出、セグメンテーション、姿勢推定、分類などのタスク向けにモデルを最適化し、幅広いデバイスで高速かつオフラインで実行できるようにします。
Ultralytics YOLOモデルをLiteRTにエクスポートする理由#
1つのモデル形式で、あらゆるデプロイ先に対応できるようになりました。
• モバイルと組み込み。 Android、iOS、デスクトップ、組み込みLinux、マイクロコントローラー(MCU)に対応します。
• エッジアクセラレーター。 Coral Edge TPUに対応し、さらなる高速化を実現します。
• ブラウザーとNode.js。 LiteRT.jsは、WebGPU/WASMアクセラレーションを利用して、同じ.tfliteモデルをWeb上で実行できるため、個別のTensorFlow.jsエクスポートが不要になります。
• デスクトップ
この統合は、本番環境へのデプロイにおける現実的な摩擦要因を取り除くという点で重要です。モバイル用、ブラウザー用、エッジアクセラレーター用にそれぞれ別のエクスポートパイプラインを維持する代わりに、一度エクスポートするだけで、LiteRTが動作するあらゆる環境にデプロイできるようになりました。
LiteRTモデルの主な機能#
• オンデバイス最適化。 データをローカルで処理してレイテンシを削減し、個人データを送信しないことでプライバシーを強化します。また、モデルサイズを最小限に抑えて、必要なストレージ容量を削減します。
• 複数のプラットフォームをサポート。 Android、iOS、組み込みLinux、マイクロコントローラー、最新のWebブラウザーで動作します。
• ハードウェアアクセラレーション。 CPUではXNNPACKを活用し、OpenCL、Metal、WebGPU経由でGPUアクセラレーションを利用できます。GPUアクセラレーションは、さらなる高速化のためデフォルトでFP16を使用します。
• 量子化。 FP32、静的INT8、静的INT16アクティベーション、動的INT8に対応し、精度の低下を最小限に抑えながらモデルを圧縮して推論を高速化します。
• 幅広い言語をサポート。 Java/Kotlin、Swift、Objective-C、C++、Python、JavaScriptに対応します。
LiteRTエクスポートを始める#
Ultralytics PythonパッケージとUltralytics Platformは、コンピュータービジョンの5つすべてのタスクにおいて、YOLOモデルの学習、評価、デプロイに対応する統合環境を提供します。LiteRTのエクスポート形式は、エクスポート、予測、検証の各モードをサポートしているため、モデルをエクスポートした後、すぐにローカルで推論や精度検証に利用できます。
モデルのエクスポートは、次の1つのコマンドで実行できます。
from ultralytics import YOLO

# YOLO26モデルを読み込む
model = YOLO("yolo26n.pt")

# モデルをLiteRT形式にエクスポートします
model.export(format="litert") # 'yolo26n.tflite'を作成します
リソースに制約のあるハードウェアにデプロイするチーム向けに、LiteRTは量子化エクスポートにも対応しています。精度の低下を最小限に抑えながらモデルを圧縮し、推論を高速化できます。
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 動的INT8: int8の重み、FP32のアクティベーション — キャリブレーションデータは不要です
model.export(format="litert", quantize="w8a32")

# 静的INT8: int8の重みとint8のアクティベーション — キャリブレーションデータが必要です
model.export(format="litert", quantize=8, data="coco8.yaml")
エクスポート後は、モデルを読み込んで直接推論を実行できます。
from ultralytics import YOLO

# エクスポートしたLiteRTモデルを読み込みます
model = YOLO("yolo26n.tflite")

# 推論を実行します
results = model("https://ultralytics.com/images/bus.jpg")
LiteRTへのエクスポートは、現在Linux x86_64とmacOSでサポートされています。エクスポートされた.tfliteモデル自体は、モバイル、組み込み、エッジ、ブラウザーなど、LiteRTがサポートするすべてのプラットフォームで動作します。
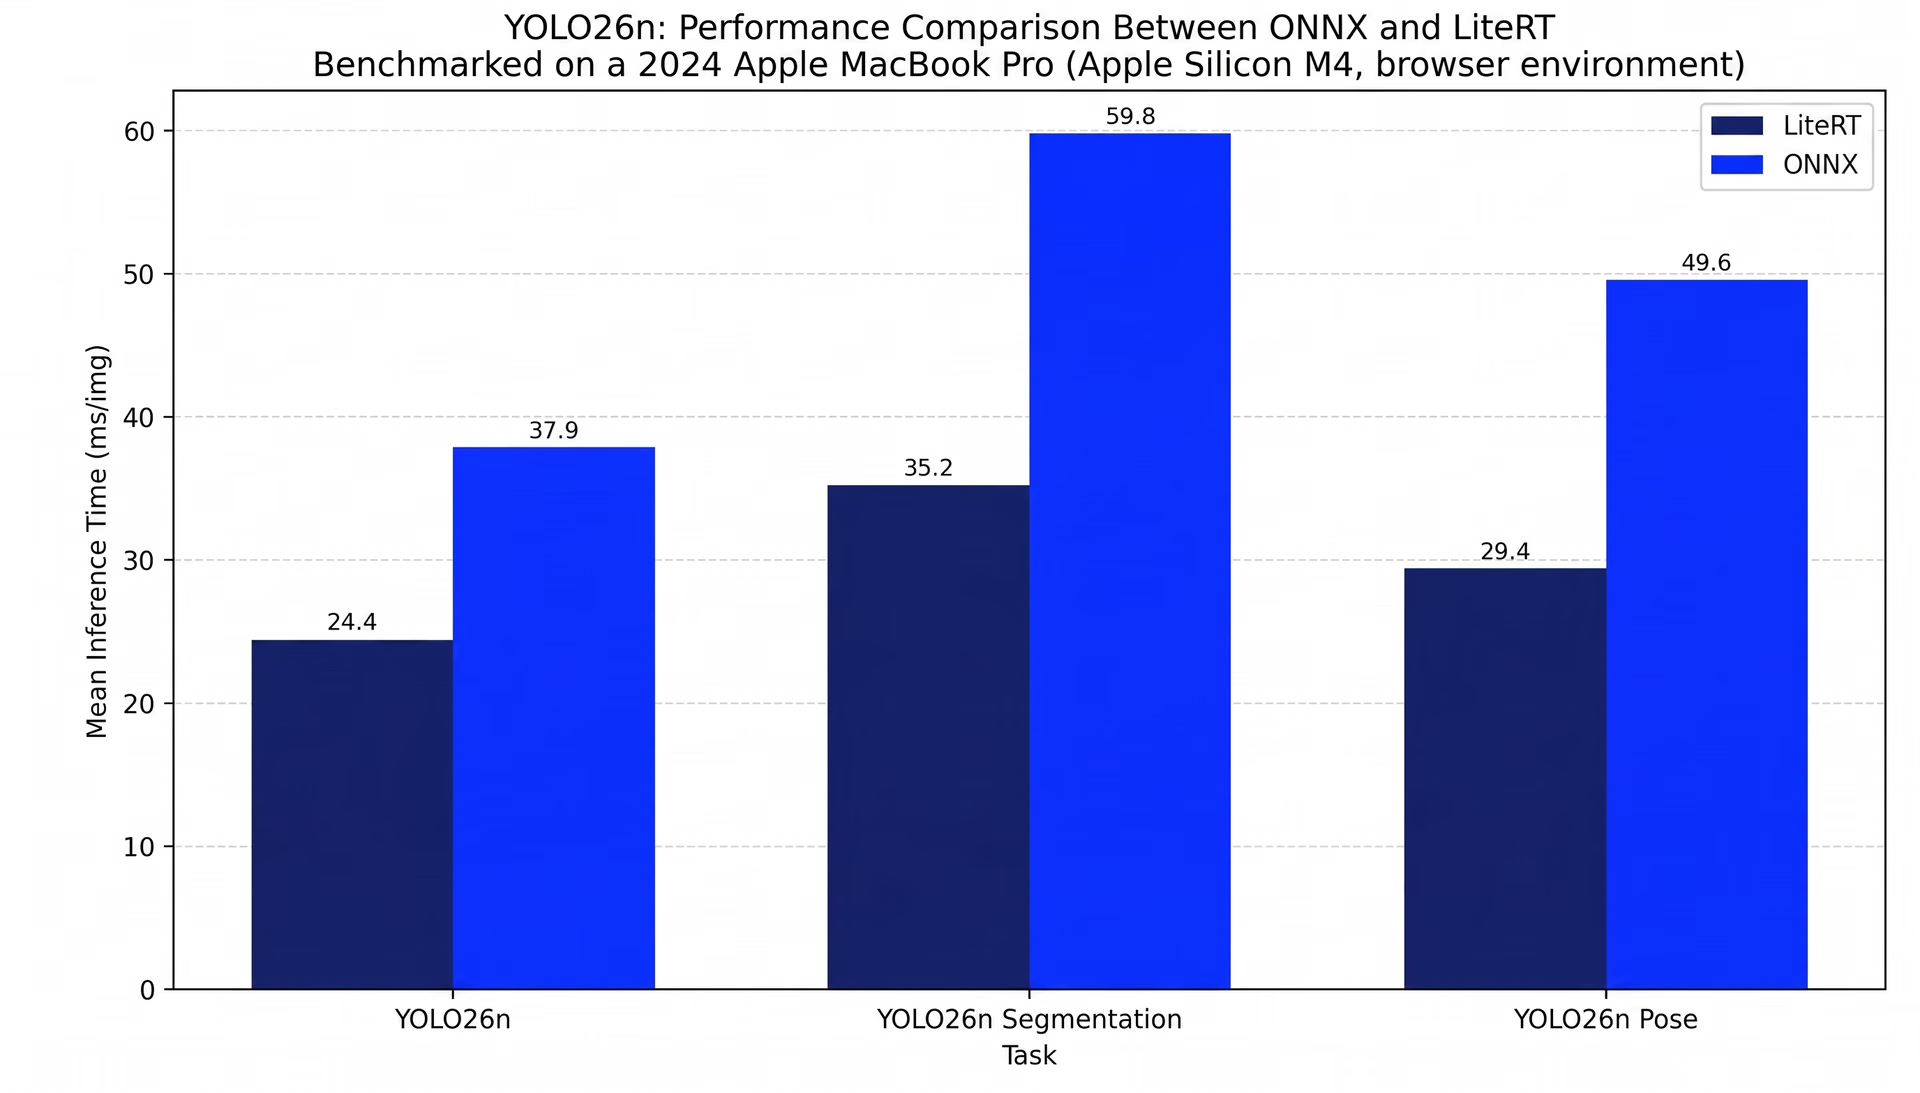 図1. ONNXとLiteRTのパフォーマンス比較。
上の画像は、YOLO26nを @ultralytics/yolo(ONNX Runtime Web経由でWebGPU/WASMを使用し、クライアント側推論を行うUltralyticsのnpmパッケージ)でブラウザー上で実行した際の、物体検出、セグメンテーション、姿勢推定における平均推論時間を比較したものです。2024年モデルのApple MacBook Pro(Apple Silicon M4)を使用し、制御されたブラウザー環境でベンチマークを実施しました。
Ultralytics YOLOをエッジへ#
LiteRTを使えば、Ultralytics YOLOモデルをモバイル、組み込み、エッジ、ブラウザーの各環境にデプロイする際に、対象ごとに個別のエクスポートパイプラインを用意する必要がありません。エクスポートは1回、モデル形式は1つ。推論が必要な場所を問わず、学習から本番環境まで一貫したプロセスを実現します。
ビジョンAIにご関心がありますか?ライセンスオプションをご覧いただき、プロジェクトにコンピュータービジョンを導入してください。GitHubリポジトリでは、Ultralyticsの幅広いエクスポート統合をご確認いただけます。また、Ultralytics Platformで、エンドツーエンドのビジョンAIワークフローの構築を始めましょう。









