Ultralytics YOLO DocsのReferenceセクションの使い方
Ultralytics YOLO DocsのReferenceセクションを活用して、Ultralytics Pythonパッケージの内部の仕組みを理解する方法をご紹介します。
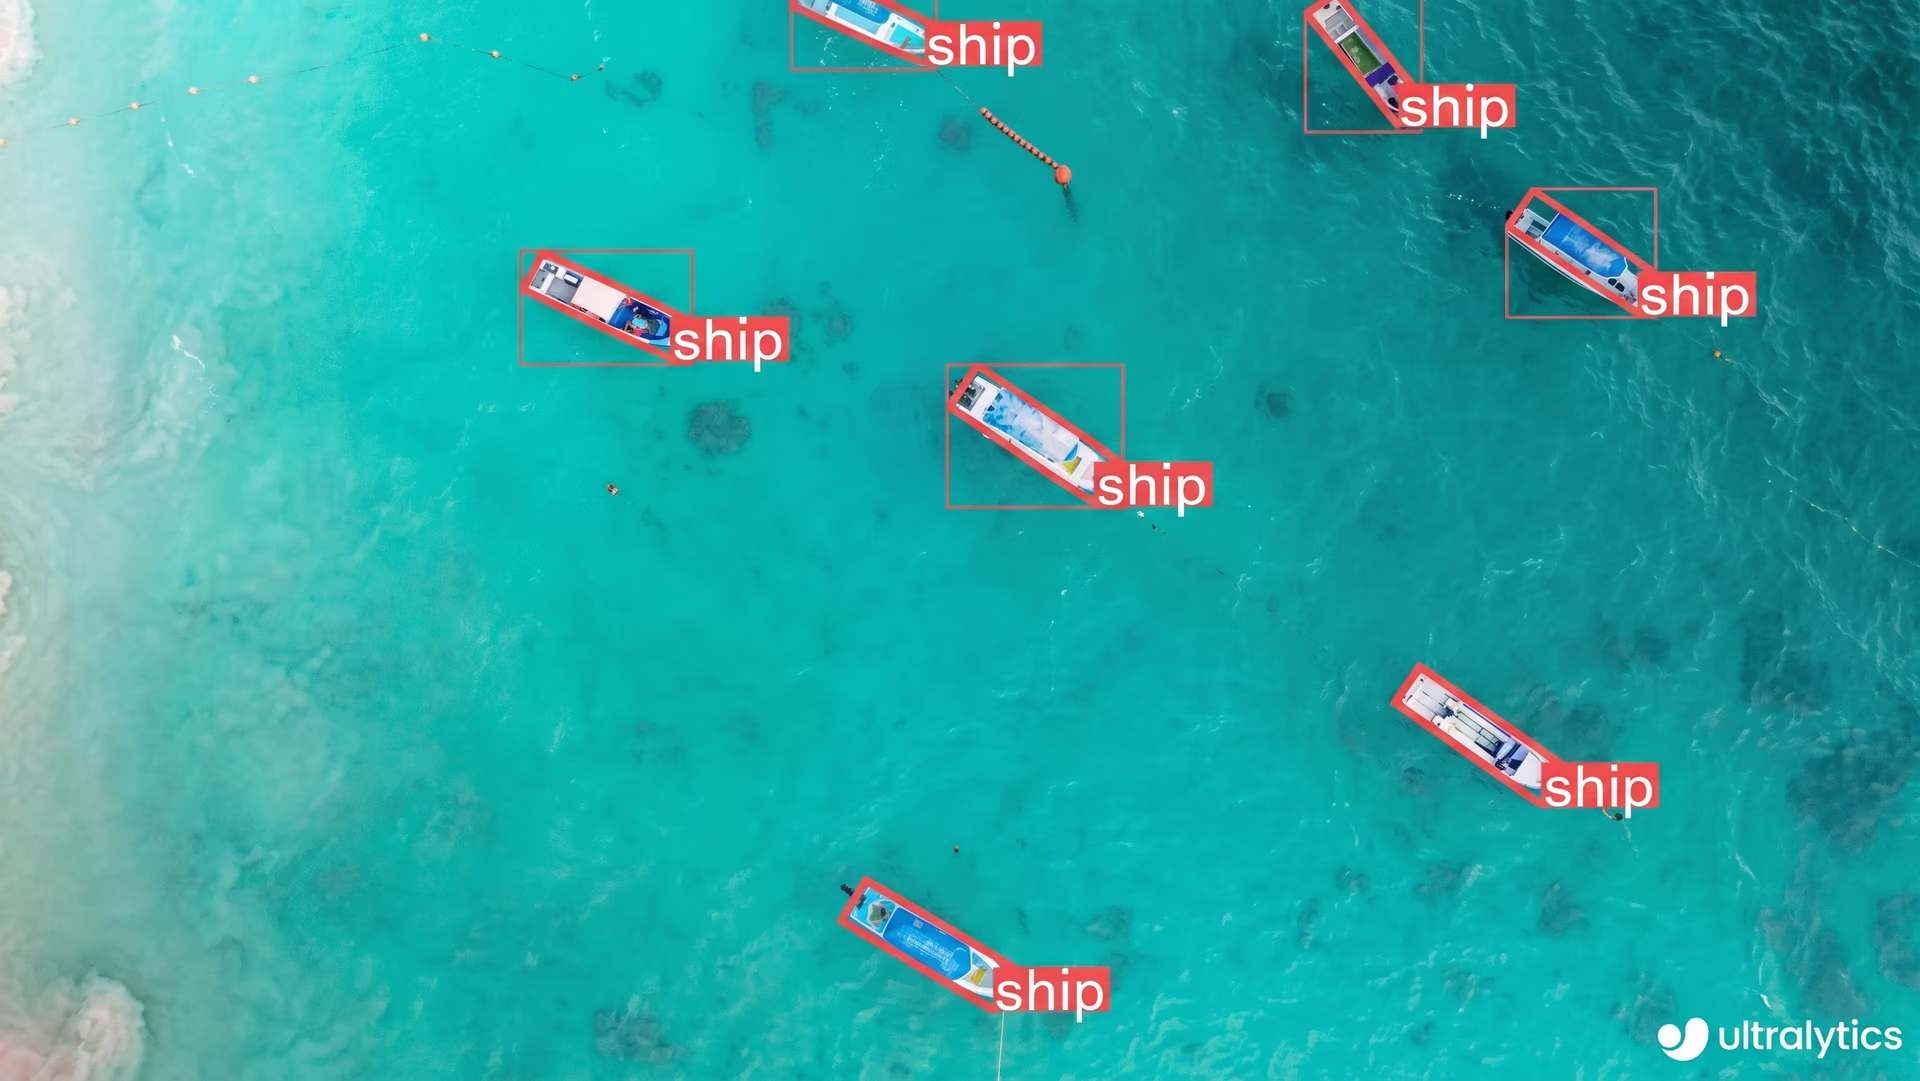
現在、人工知能 (AI) はかつてないほど身近になり、誰もが気軽に利用を始め、さまざまな最先端タスクにさまざまなAIモデルをすぐに活用できます。
たとえば、コンピュータービジョンはAIの一分野であり、コンピューターが画像や動画の視覚情報を解釈して理解できるようにします。また、Ultralytics YOLO11のようなコンピュータービジョンモデルは、すぐに使い始めることができます。
Ultralytics YOLO11は、物体検出、インスタンスセグメンテーション、画像分類などのタスクに対応しており、自動運転、セキュリティ監視、小売分析などの用途に活用できます。
図1. Ultralytics YOLO11は、さまざまな物体の検出に使用できます。
具体的には、Ultralytics Pythonパッケージは、これらのAIモデルをすばやくトレーニング、カスタマイズ、デプロイするための使いやすいツールを提供しており、あらゆるスキルレベルのユーザーが高度なコンピュータービジョンアプリケーションを簡単に構築できます。
すべての仕組みをさらに詳しく調べたり、独自のカスタマイズを作成したりする場合は、Ultralyticsドキュメントのリファレンスセクションが役立ちます。データの処理方法、モデルのトレーニングプロセス、予測結果の可視化方法など、Ultralytics Pythonパッケージの内部動作を解説しています。
この記事では、Ultralyticsドキュメントのリファレンスセクションを詳しく見ていき、コンピュータービジョンプロジェクトでの活用方法を紹介します。それでは始めましょう。
Ultralytics YOLOモデルの活用を詳しく見る#
Ultralytics Pythonパッケージは、簡単かつ直感的に使用できます。わずか数行のコードでYOLOモデルをトレーニングしたり、画像内の物体を検出したりできます。
コンピュータービジョンモデルの操作に慣れてきたら、Ultralyticsドキュメントのリファレンスセクションを活用して、コードの動作やパッケージがサポートする関数を詳しく確認できます。また、わかりやすい解説や設定可能なオプション、Ultralytics GitHubリポジトリ内の関連コードへのリンクも掲載されています。
このセクションでは、Ultralytics Pythonパッケージの構成を説明し、モデルのセットアップ、データの読み込み、トレーニングプロセス、予測の実行と返却などの主要な要素を取り上げています。
すべてがわかりやすいカテゴリに整理されているため、必要な情報を簡単に見つけられます。たとえば、独自のデータセットでモデルをトレーニングする場合は、リファレンスセクションのデータに関する部分を参照すると、モデルのトレーニングでデータがどのように使用されるかをより深く理解できます。
リファレンスセクションの使い始め方#
Ultralytics YOLOドキュメントのリファレンスセクションを開くと、ページ左側にさまざまなリファレンスカテゴリのメニューがあります。各カテゴリは、モデル、データ処理、トレーニング関数など、Ultralyticsコードベースの特定の部分を表しています。
カテゴリをクリックすると、詳細を説明するページが開きます。
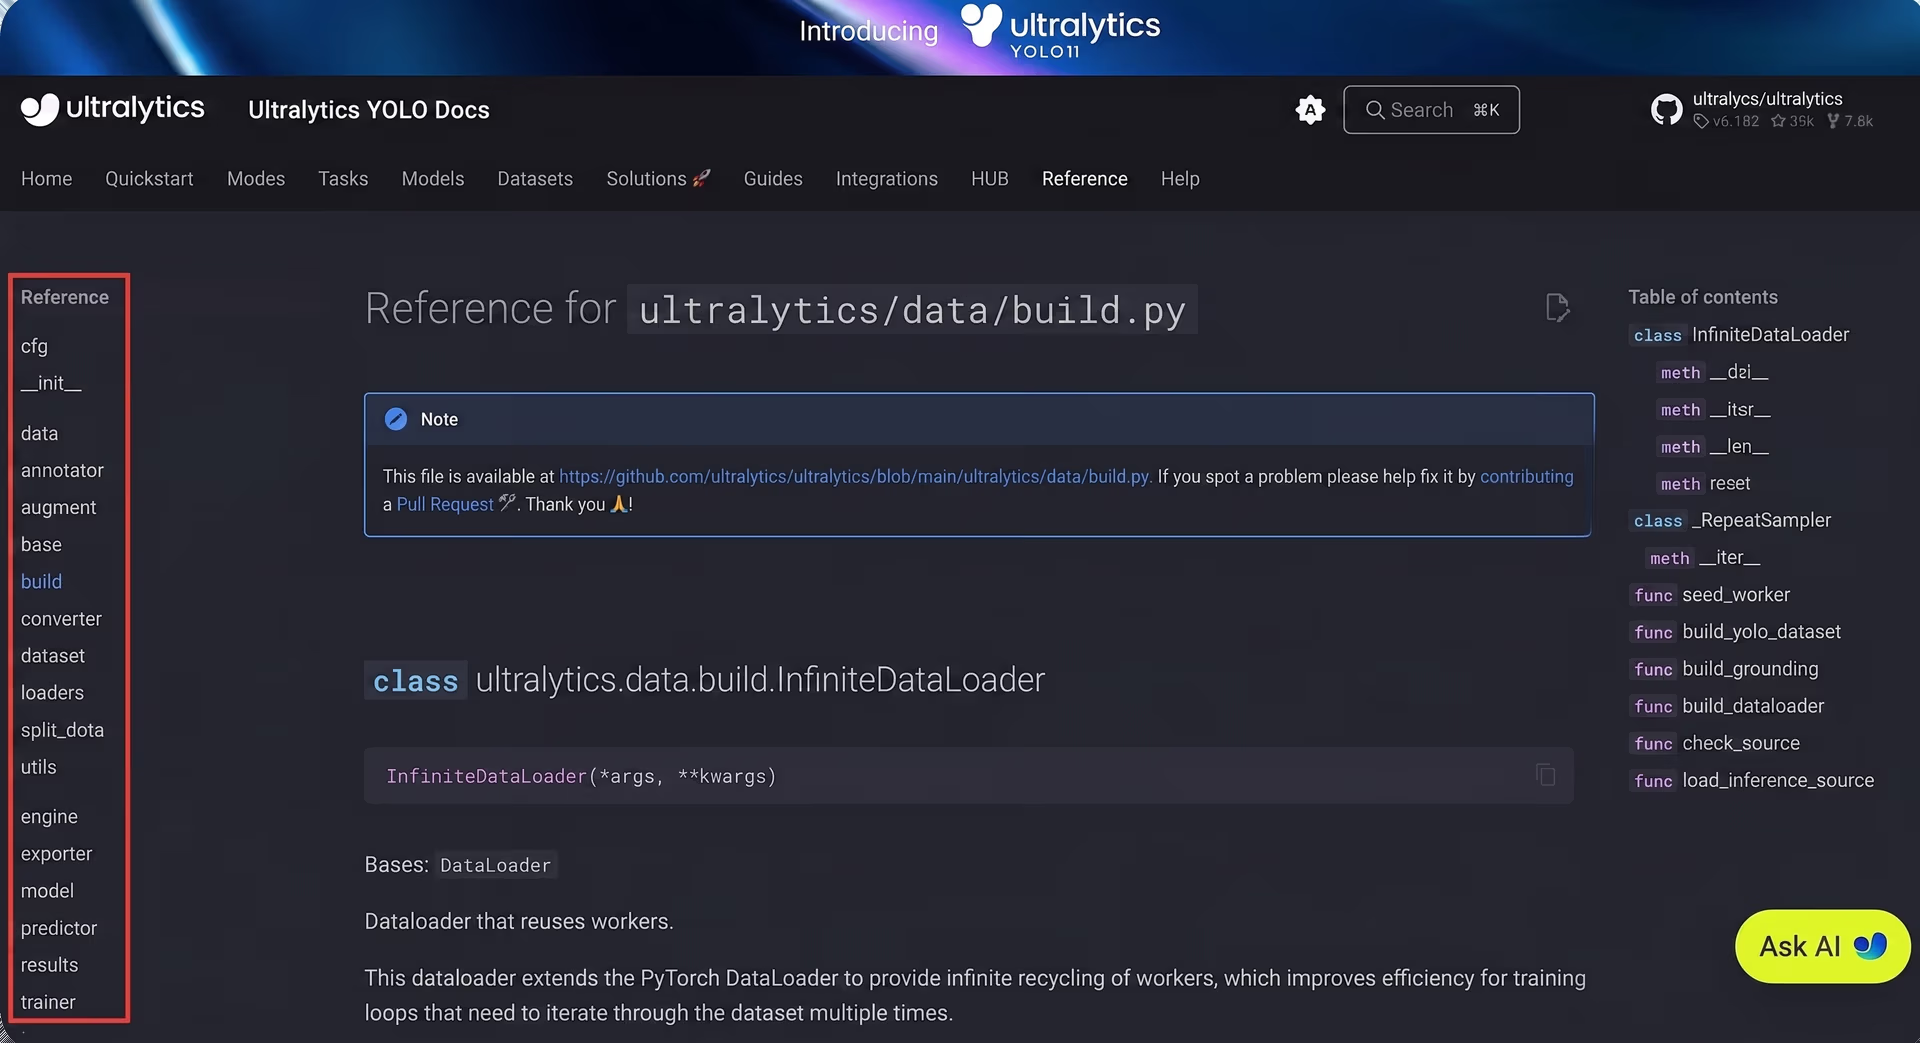
図2. 左側には、さまざまなリファレンスカテゴリのメニューがあります。
同様に、ページ右側には目次があり、各リファレンスページを、関数(再利用可能なコードブロック)、クラス(オブジェクトを作成するための設計図)、メソッド(クラス内で定義された関数)などの主要な要素に分けて示しています。そのため、必要な情報にすぐ移動できます。
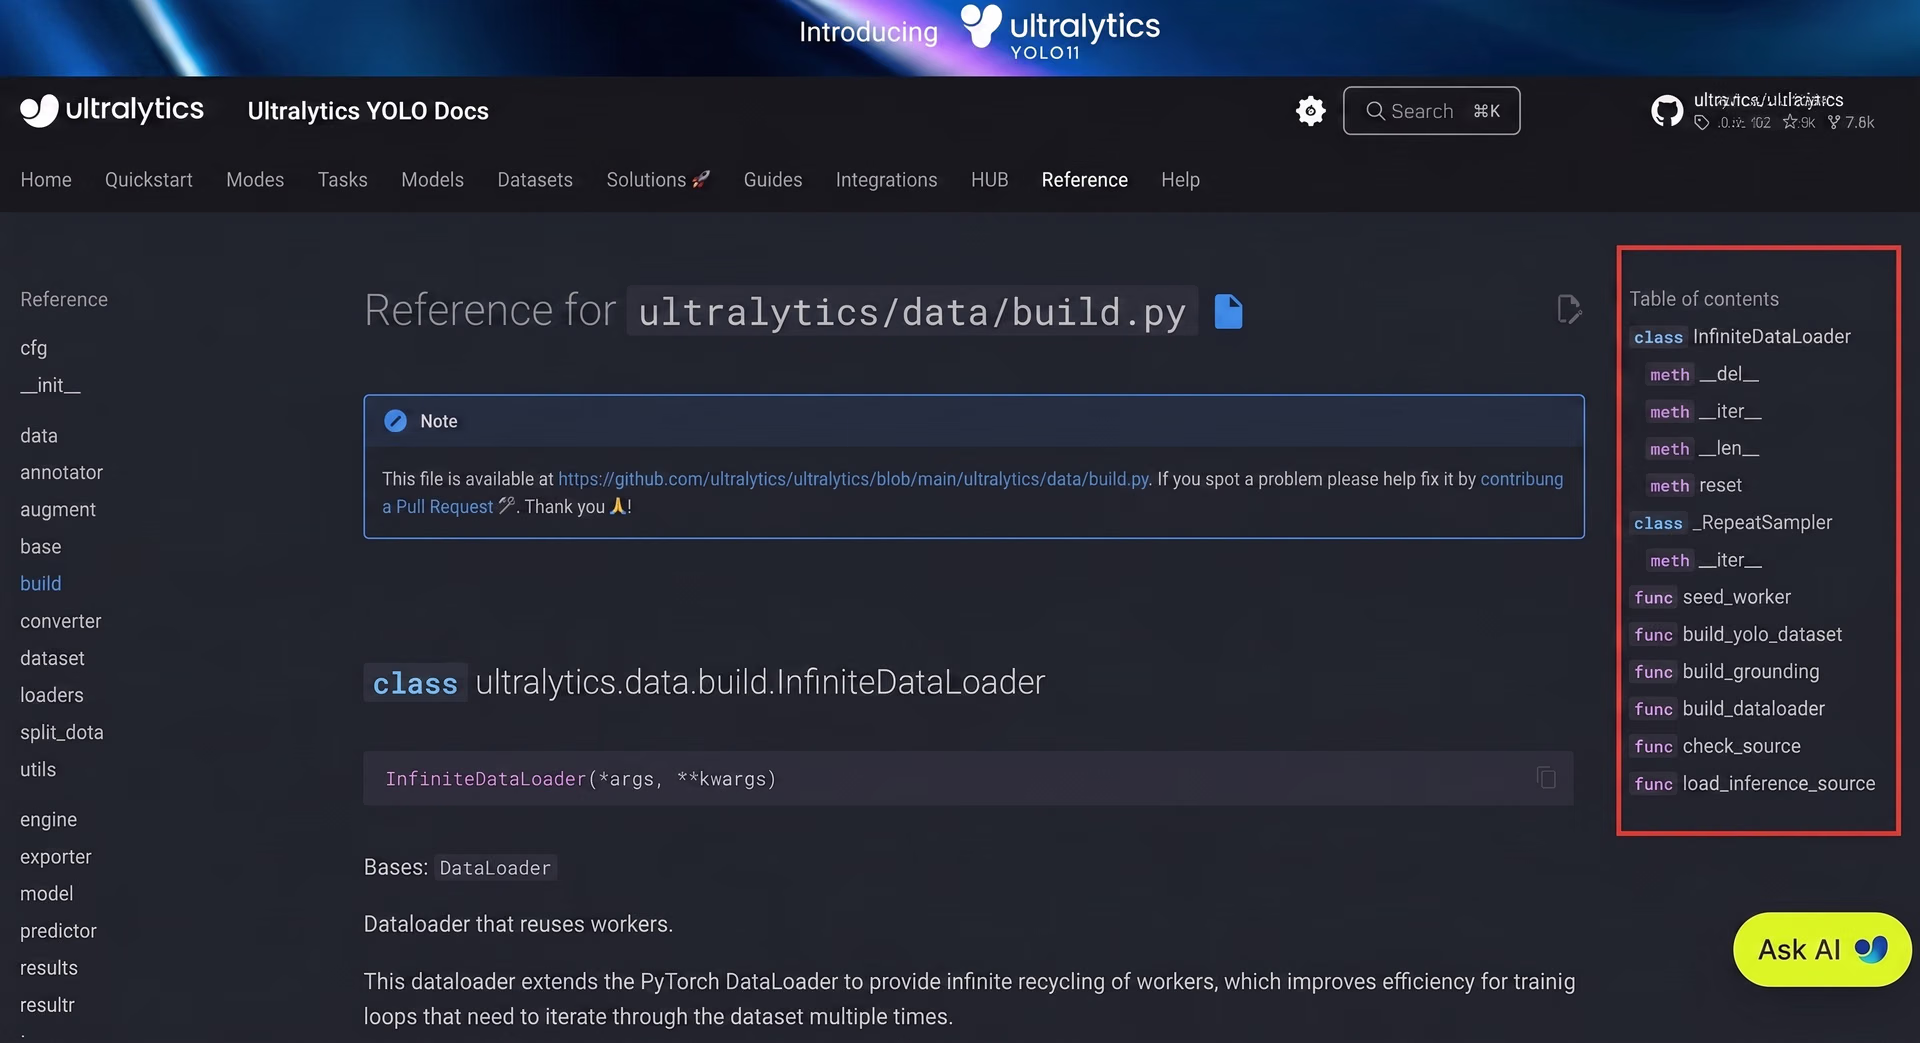
図3。右側には、表示中のリファレンスページの目次があります。
Ultralytics GitHubリポジトリの構成#
Ultralytics GitHubリポジトリは、モデル、トレーニング、データなど、Ultralyticsパッケージの各部分に応じたサブディレクトリまたはサブパッケージに整理されています。ドキュメントのリファレンスセクションも同じ構成に沿っているため、全体のつながりを把握しやすくなっています。
Ultralytics GitHubリポジトリとUltralyticsドキュメントのリファレンスセクションの両方にある、主なサブディレクトリまたはカテゴリをいくつか紹介します。
- Models: このセクションでは、予測、性能検証、トレーニング済みモデルのエクスポートなど、さまざまなモデルとそのモードを取り上げています。
- Engine: モデルのトレーニング、検証、予測、エクスポート、評価を行うための中核ロジックが含まれています。
- Data: データセットの読み込み、処理、拡張を管理します。これには、データをバッチ単位でモデルに供給するツールであるデータローダーの作成、モデルの学習を促進するために画像のサイズ変更や反転などを行う変換の適用、トレーニングに向けたデータ(画像とラベル)の整理やフォーマット設定を行う関数が含まれます。
- Utils: 可視化ツール、ファイル処理、指標の計算など、コードベース全体で使用される幅広いヘルパー関数を提供します。
- HUB: ノーコードのコンピュータービジョンプラットフォームであるUltralytics HUBに接続し、APIを通じてログイン、モデルのアップロード、データセットの管理などのクラウド機能を利用できるようにします。
- Trackers: 動画やフレーム単位の画像シーケンスを扱うアプリケーション向けに、物体追跡ロジックを実装しています。
GitHubリポジトリの各サブディレクトリには、ドキュメント内に対応するセクションがあります。この構成は意図的に同じ形にそろえられており、ドキュメントの閲覧とソースコードの確認を簡単に切り替えられます。
実際、多くのリファレンスページにはソースコードも掲載されているため、ドキュメントを離れることなく、関数やクラスの実装を正確に確認できます。
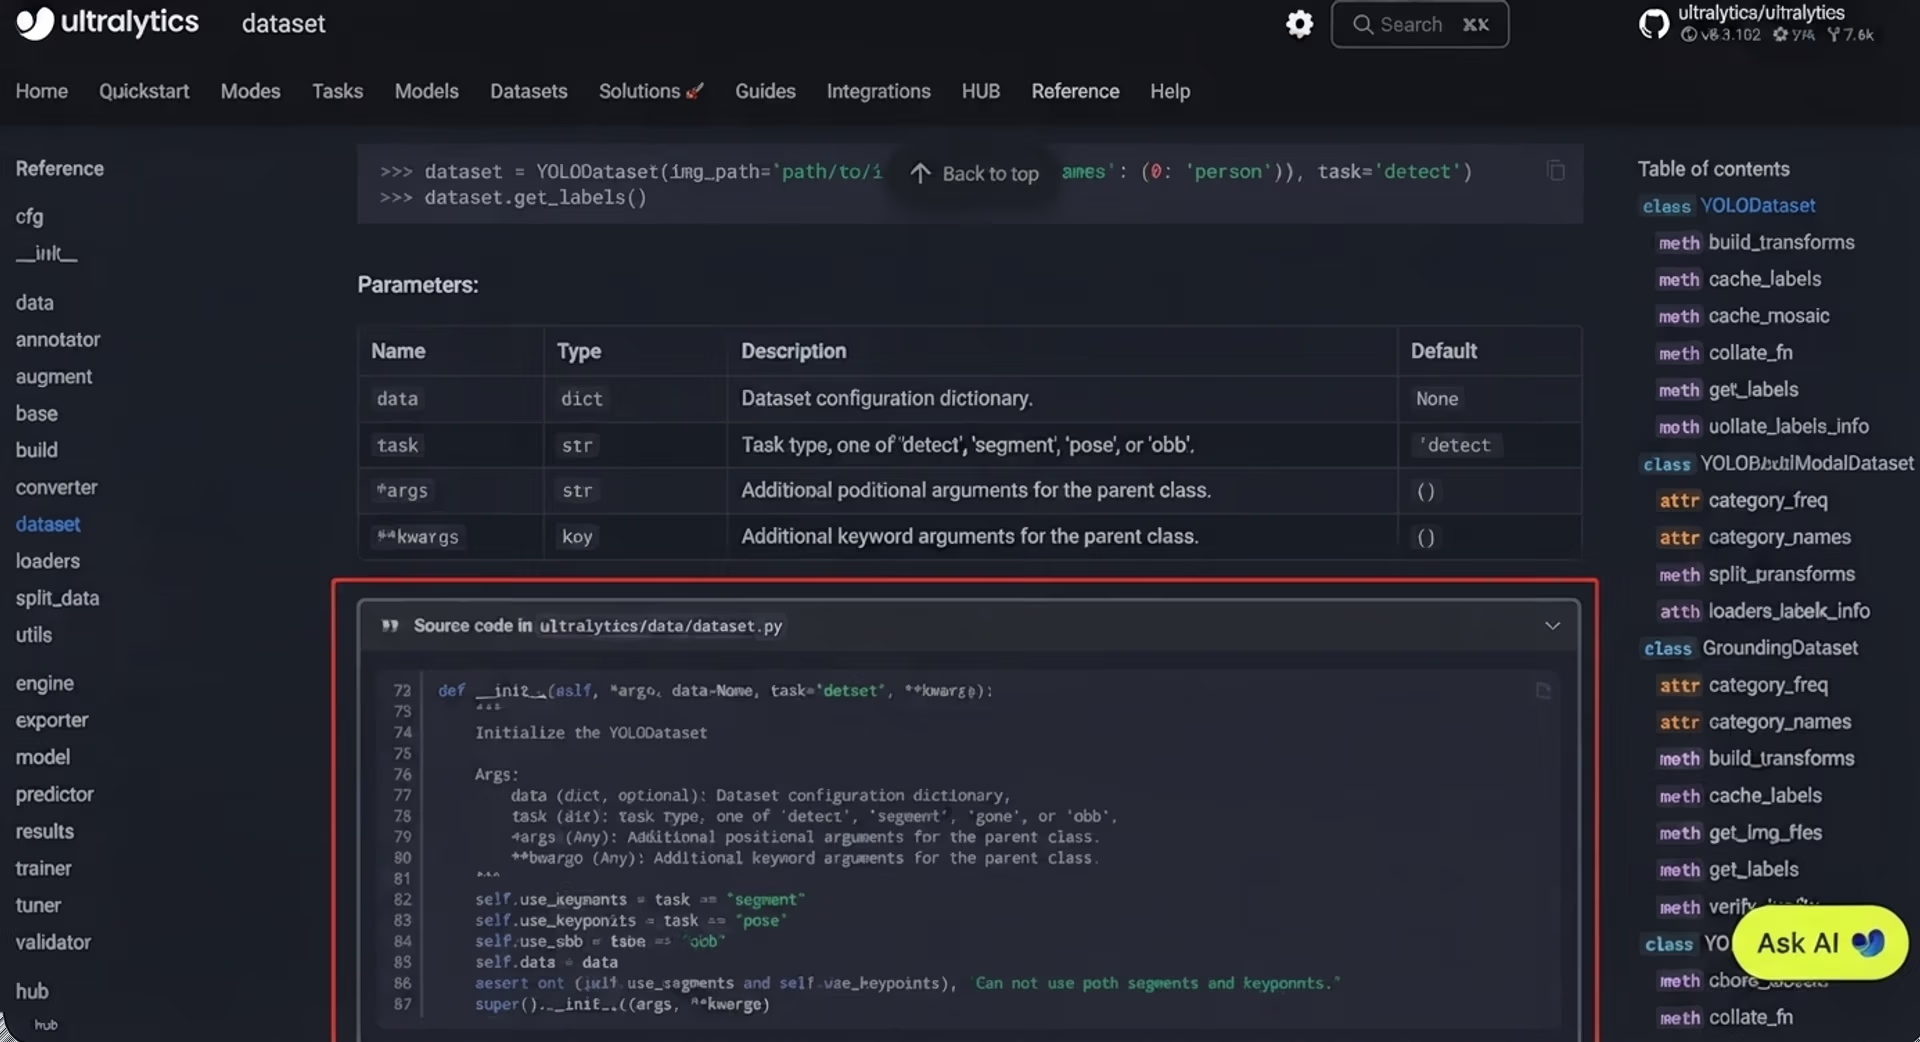
図4. リファレンスページにはソースコードも掲載されています。
モデル、エンジン、データコンポーネントを理解する#
リファレンスセクションの構成を確認したところで、Ultralyticsパッケージの主要な3つの部分であるモデル、エンジン、データを詳しく見ていきましょう。
modelsサブディレクトリには、各種モデルの動作を定義するコードが含まれています。YOLO、FastSAM、RT-DETRなどのモデルタイプと、検出、セグメンテーション、分類などのタスクの両方に基づいて整理されています。それぞれの中には、予測の実行方法、トレーニング方法、性能の評価方法など、特定の処理を担当するファイルやモジュールがあります。
一方、engineサブディレクトリは、プロセス全体を管理するためにバックグラウンドで動作します。modelsサブディレクトリが各モデルの目的に焦点を当てるのに対し、engineサブディレクトリは、それらのタスクを一貫性と効率性を保ちながら実行する方法に焦点を当てています。
また、dataサブディレクトリはデータセットの読み込みと準備を担当します。このコードベースの部分によって、トレーニングデータがクリーンで構造化され、多様性を備えるようになり、モデルの学習と汎化性能の向上につながります。
このように明確に分離することで、コードの保守が容易になり、ユーザーは柔軟にカスタマイズできます。
リファレンスセクションの活用例#
Ultralyticsコードベースの各部分を理解することがなぜ重要なのか、疑問に思うかもしれません。どのコードがどの処理を担当するかを把握すれば、必要な情報を見つけたり、変更を加えたり、問題をトラブルシューティングしたりするのが格段に簡単になります。
ドキュメントのリファレンスセクションの活用例をいくつか紹介します。
- 「モデルはどのように予測を行うのか」と知りたい場合は、リファレンスセクションのModelsカテゴリに移動し、YOLOなどのモデルタイプを選択して、detectなどのタスクを選び、Predictページを開くと詳細を確認できます。
- データ拡張の適用方法を知りたい場合は、DataカテゴリのAugmentページを確認できます。このページには、モデルの性能とトレーニングデータの多様性を高めるために使用される、組み込みの拡張手法が一覧表示されています。
リファレンスセクションで結果を確認する#
リファレンスセクションは、モデルが返す出力を理解する際にも役立ちます。Ultralytics YOLO11などのモデルで画像の推論を実行すると、検出内容を説明する一連の結果が返されます。
たとえば、カメラ映像から人物を検出し、バウンディングボックスで位置を強調表示するとともに、信頼度スコアを返す場合があります。信頼度スコアは0から1までの値で、検出結果に対するモデルの確信度を示します。
プロジェクトで出力を活用する方法を知りたい場合は、リファレンスセクションが役立ちます。Resultsモジュールのページでは、出力に含まれる内容とコードでのアクセス方法を詳しく解説しています。検出ボックスの表示、信頼度スコアの確認、結果の表示や保存方法についても説明しています。
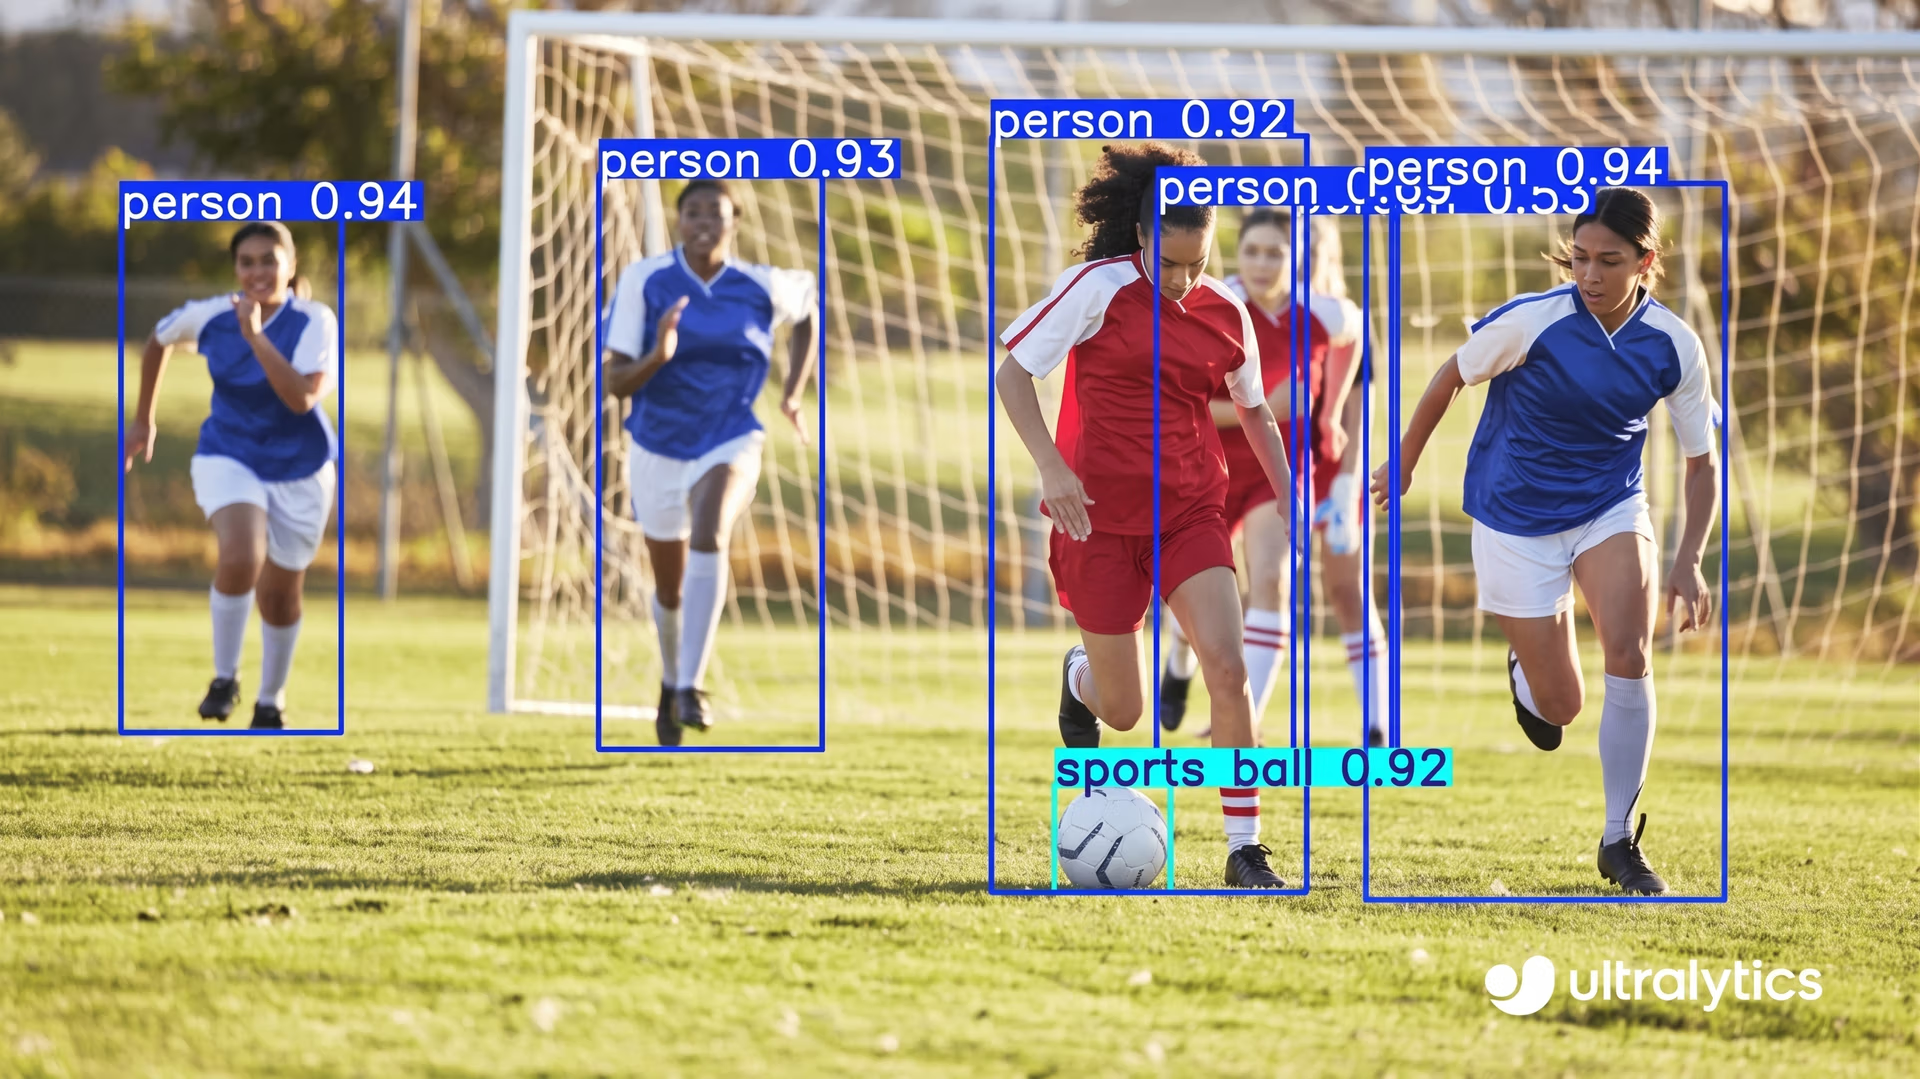
図5. YOLO11が返す結果の可視化例です。
重要なポイント#
Ultralyticsドキュメントは、YOLOモデルを効果的に活用する方法の理解に役立ちます。モデルのトレーニング、データの準備、結果の処理などの主要なプロセスを説明しています。各ページには、すぐに使い始められるよう、明確な説明とコードスニペットの例が掲載されています。
内部の仕組みに関心がある場合は、ドキュメントのリファレンスセクションで手順を追って確認できます。コードの構成、各部分の役割、全体がどのように連携するかが説明されています。そのため、コンピュータービジョンプロジェクトの学習やカスタマイズを進め、自信を持って独自のプロジェクトを構築できます。
活発なコミュニティに参加し、GitHubリポジトリを確認して、AIを活用した開発について詳しく学びましょう。独自のコンピュータービジョンのアイデアを実現する準備はできていますか。ライセンスオプションをご覧いただき、始めましょう。自動車分野のVision AIや医療分野のAIがどのような効果をもたらしているか、ソリューションページでご確認ください。









