データ拡張でAIモデルの堅牢性を向上させる
データ拡張によってトレーニングデータに現実的なバリエーションを加え、AIモデルの堅牢性と実環境での性能を向上させる方法をご紹介します。
 Abirami Vina9 分で読めます
テストは、あらゆる技術ソリューションの構築に欠かせない工程です。テストによって、チームはシステムの本番稼働前に実際の動作を把握し、問題を早期に修正できます。これはAIを含む多くの分野に当てはまります。AIでは、デプロイ後にモデルが予測不能な現実世界の状況に対応することが求められます。
たとえば、コンピュータービジョンは、画像や動画を理解するよう機械に学習させるAIの一分野です。Ultralytics YOLO26などのコンピュータービジョンモデルは、物体検出、インスタンスセグメンテーション、画像分類などのタスクに対応します。
モデルは、患者モニタリング、交通分析、自動チェックアウト、製造における品質検査など、多くの業界の幅広い用途で使用できます。しかし、高度なモデルや高品質な学習データを用いても、ビジョンAIソリューションは、照明の変化、動き、物体の一部が隠れるといった現実世界の変化に直面すると、依然として性能が低下する可能性があります。
これは、モデルが学習時に与えられた例から学習するためです。まぶしさ、モーションブラー、視認性の低下といった状況を事前に経験していないモデルは、そうした状況で物体を正しく認識できる可能性が低くなります。
モデルのロバスト性を高める方法の一つが、データ拡張です。大量の新しいデータを収集する代わりに、エンジニアは照明の調整、クロップ、画像の合成など、既存の画像に小規模で効果的な変更を加えられます。これにより、モデルはより幅広い状況で同じ物体を認識できるようになります。
この記事では、管理された環境の外にデプロイされたとき、データ拡張がモデルのロバスト性とビジョンAIシステムの信頼性をどのように高めるのかを解説します。それでは始めましょう。
モデルのロバスト性を確認する方法#
データ拡張の説明に入る前に、コンピュータービジョンモデルが実際の使用に本当に適しているかどうかを判断する方法を見ていきましょう。
ロバストなモデルは、きれいに撮影され、完璧にラベル付けされた画像だけでなく、条件が変化しても高い性能を維持します。AIモデルのロバスト性を評価する際に考慮すべき実践的な要素をいくつかご紹介します。
- 照明の変化: 強い光、暗い環境、まぶしさ、影にさらされるとモデルの動作が変わり、物体をどの程度の確信度で検出できるかに影響することがあります。
- 部分的な遮蔽: 日常のシーンでは、物体がほかの物に遮られたり、一部しか見えなかったりすることがよくあります。ロバスト性の高いモデルは、視覚情報の一部が欠けていても物体を認識できます。
- 物体が密集したシーン: 多くの物体が重なり合う環境では、検出がより困難になります。こうした状況でも高い性能を発揮するモデルは、複雑な環境でも一般に高い信頼性を示します。
きれいに撮影された完璧な画像で良好な結果が得られても、必ずしも現実世界で高い性能を発揮するとは限りません。さまざまな条件下で定期的にテストすることで、デプロイ後にモデルがどれだけ性能を維持できるかを確認できます。
データ拡張とは何ですか?#
写真に写る物体の見え方は、照明、角度、距離、背景によって変わります。コンピュータービジョンモデルを学習させる際は、予測しにくい環境でも高い性能を発揮できるよう、学習に使うデータセットにこうした変化を含める必要があります。
データ拡張は、すでにある画像に追加の例を作成することで、学習データセットを拡張します。画像の回転や反転、明るさの調整、一部のクロップなど、意図的な変更を加えて実現します。
たとえば、猫の写真が1枚しかないとします。画像を回転させたり、明るさを変えたりすれば、その1枚から複数の新しいバージョンを作成できます。それぞれの画像は少しずつ異なりますが、同じ猫の写真であることに変わりはありません。こうしたバリエーションによって、見え方が変わっても同じ物体であるとモデルに学習させることができます。
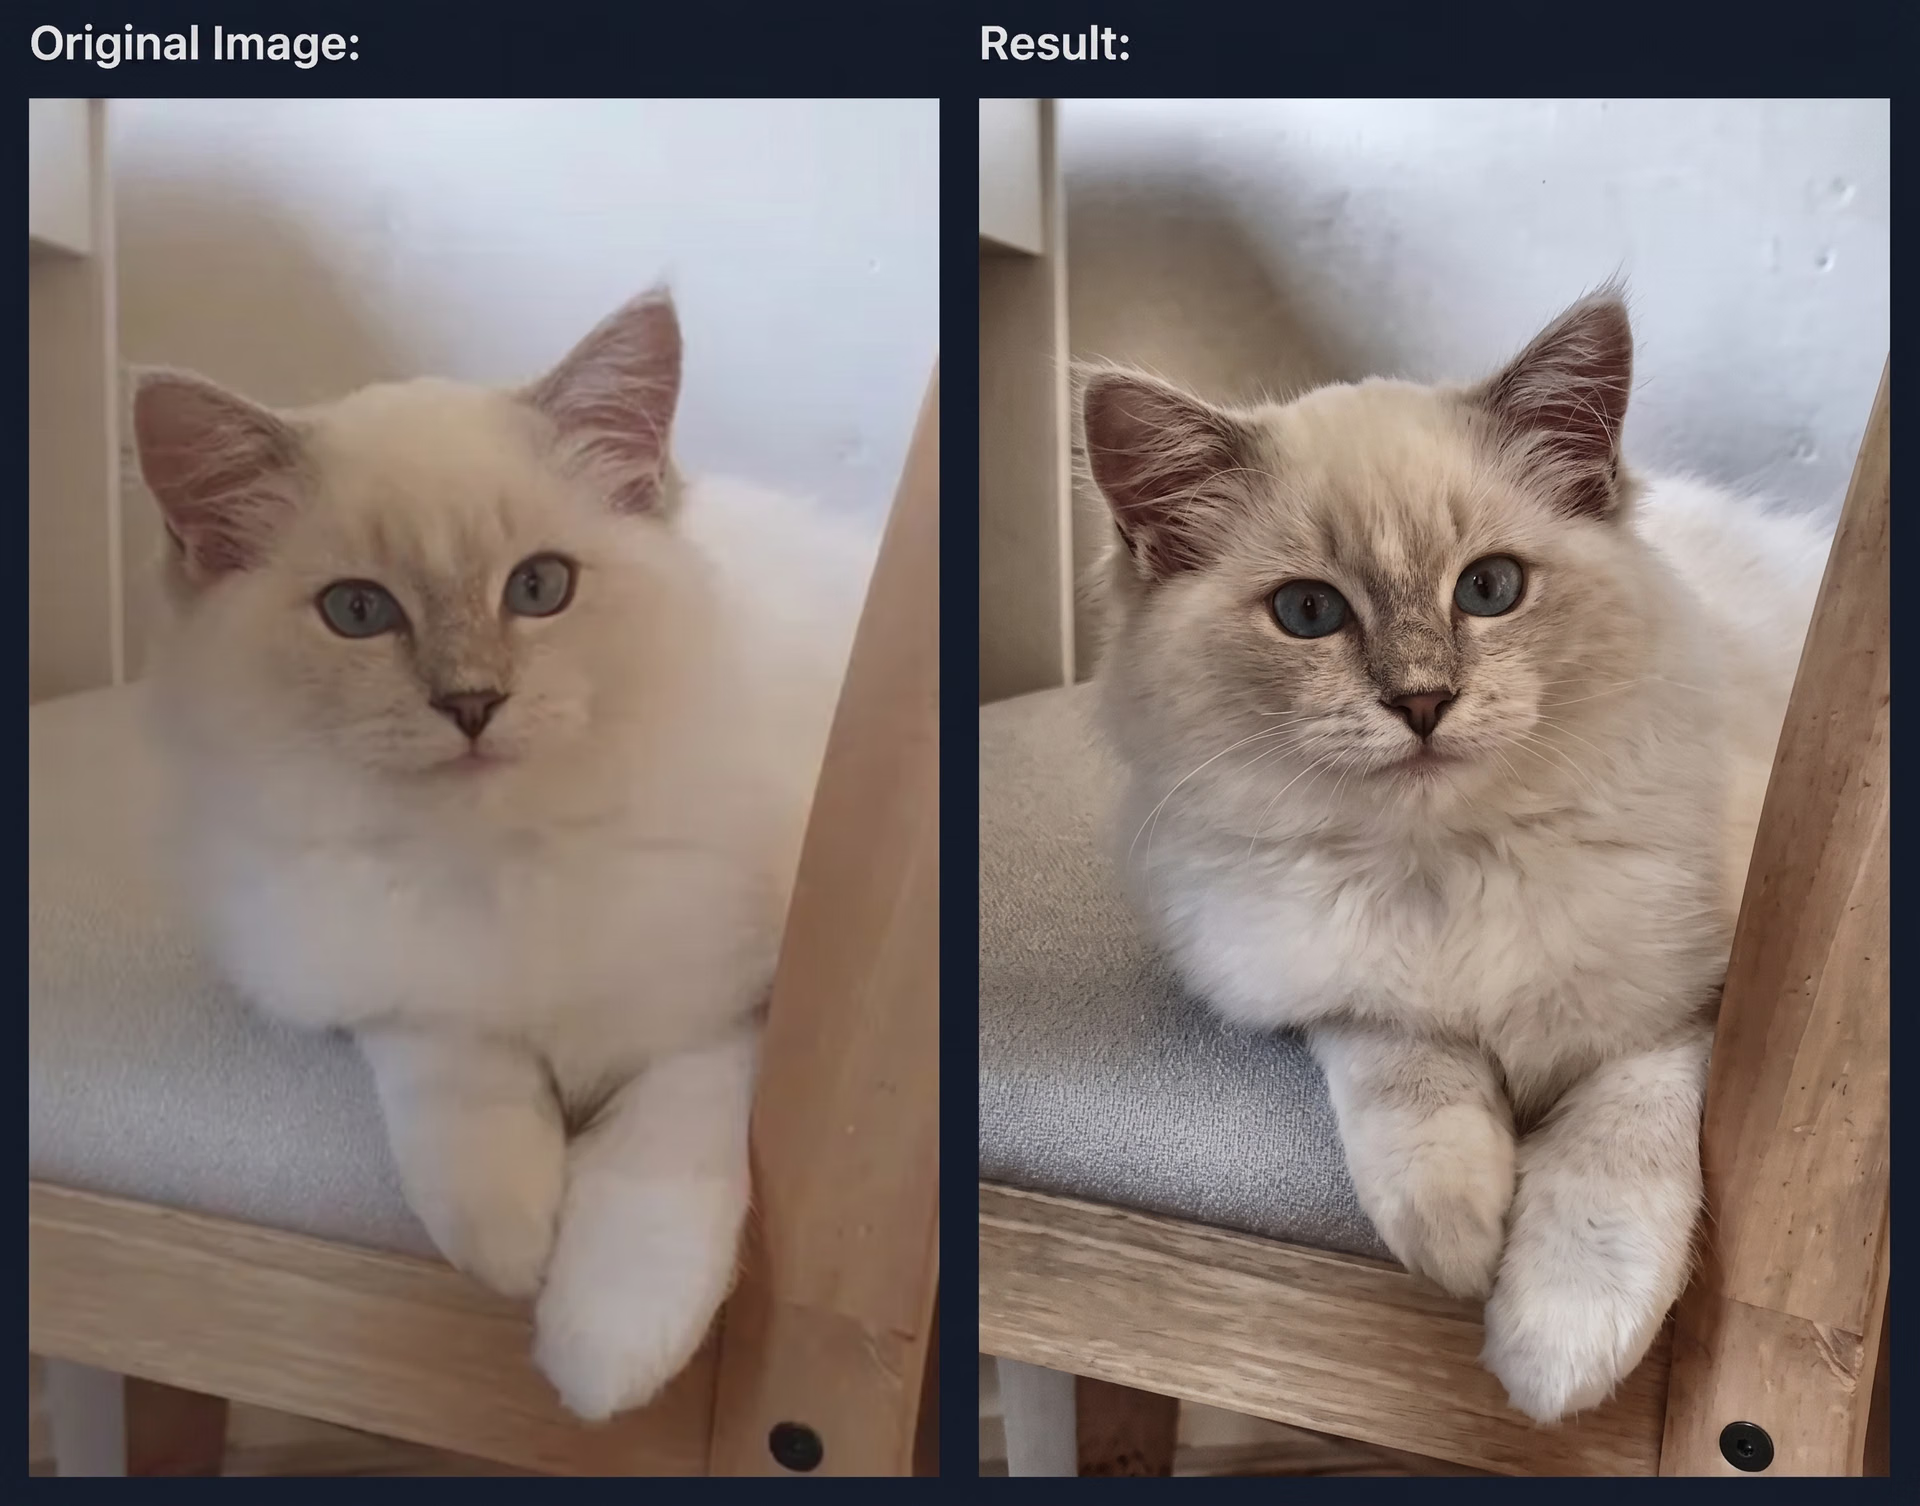
図1. 猫の画像を拡張する例(出典)
データ拡張がモデルの性能を向上させる仕組み#
モデルのトレーニング中に、データ拡張をトレーニングパイプラインに直接組み込めます。画像の新しいコピーを手動で作成して保存する代わりに、各画像の読み込み時にランダムな変換を適用できます。
これにより、画像が明るくなる、反転する、一部が隠れるなど、モデルは読み込むたびに少し異なるバージョンの画像を見ます。ランダム消去などの手法では、画像の小さな領域を削除して、物体が遮られたり一部しか見えなかったりする現実世界の状況を再現することもできます。
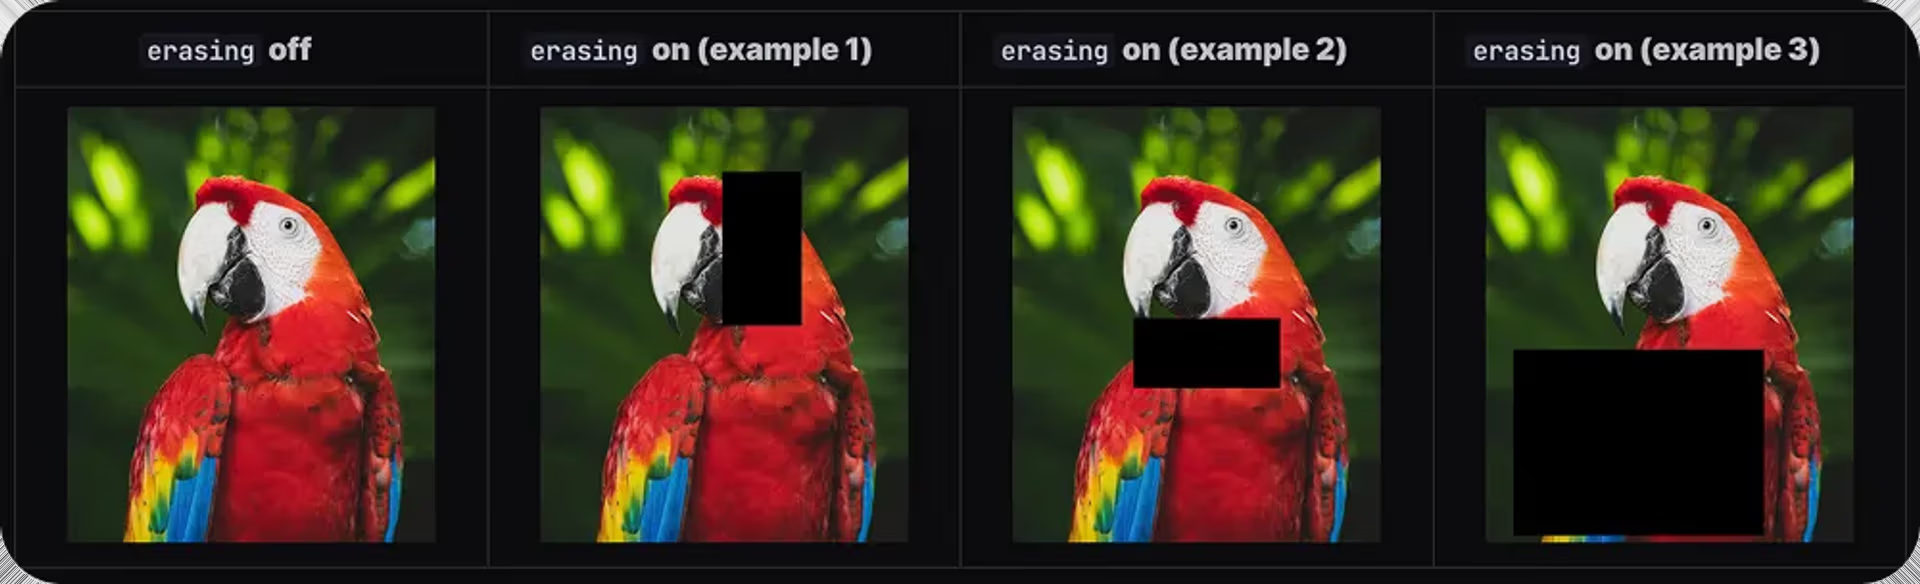
図2. ランダム消去ベースのデータ拡張の例(出典)
同じ画像のさまざまなバージョンを見ることで、モデルは完璧な1つの例に依存するのではなく、どの特徴が重要かを学習できます。この多様性によってAIモデルのロバスト性が高まり、実環境でもより安定した性能を発揮できるようになります。
一般的なデータ拡張手法#
トレーニング画像に多様性を加えるために使われるデータ拡張手法をいくつかご紹介します。
- 幾何学的変換: これらの手法では、画像内でのオブジェクトの空間的な見え方を変えます。画像の回転、反転、リサイズ、切り抜き、移動により、モデルはさまざまな角度や距離からオブジェクトを見た場合を理解できるようになります。
- 色と照明の調整: 実環境では、照明が一定であることはほとんどありません。環境や使用するカメラによって、画像が明るすぎたり暗すぎたり、色味が多少ずれたりすることがあります。明るさ、コントラスト、色相、彩度を調整すると、モデルはこうした視覚的な変化に対応し、さまざまなシーンで良好な性能を発揮できます。
- 画質の変化: ぼけや視覚ノイズによって、画像が不鮮明になることがあります。学習中にぼけやノイズを加えると、モデルはモーションブラー、低照度画像、低画質カメラの映像に対応できるようになり、不完全な視覚情報に対する感度が低下します。
- オクルージョンベースの拡張:実環境では、物体がほかの物体に部分的に隠れることがよくあります。これをオクルージョンと呼びます。トレーニング中に画像の小さな領域を隠したりマスクしたりすることで、一部しか見えていない物体も検出できるようにモデルを学習させられます。
- 複数画像のデータ拡張: これらの手法では、複数の画像の一部を組み合わせて1つの学習サンプルを作成します。これにより、画像内のオブジェクト数を増やし、複雑なシーンや混雑したシーンへのモデルの対応能力を高められます。
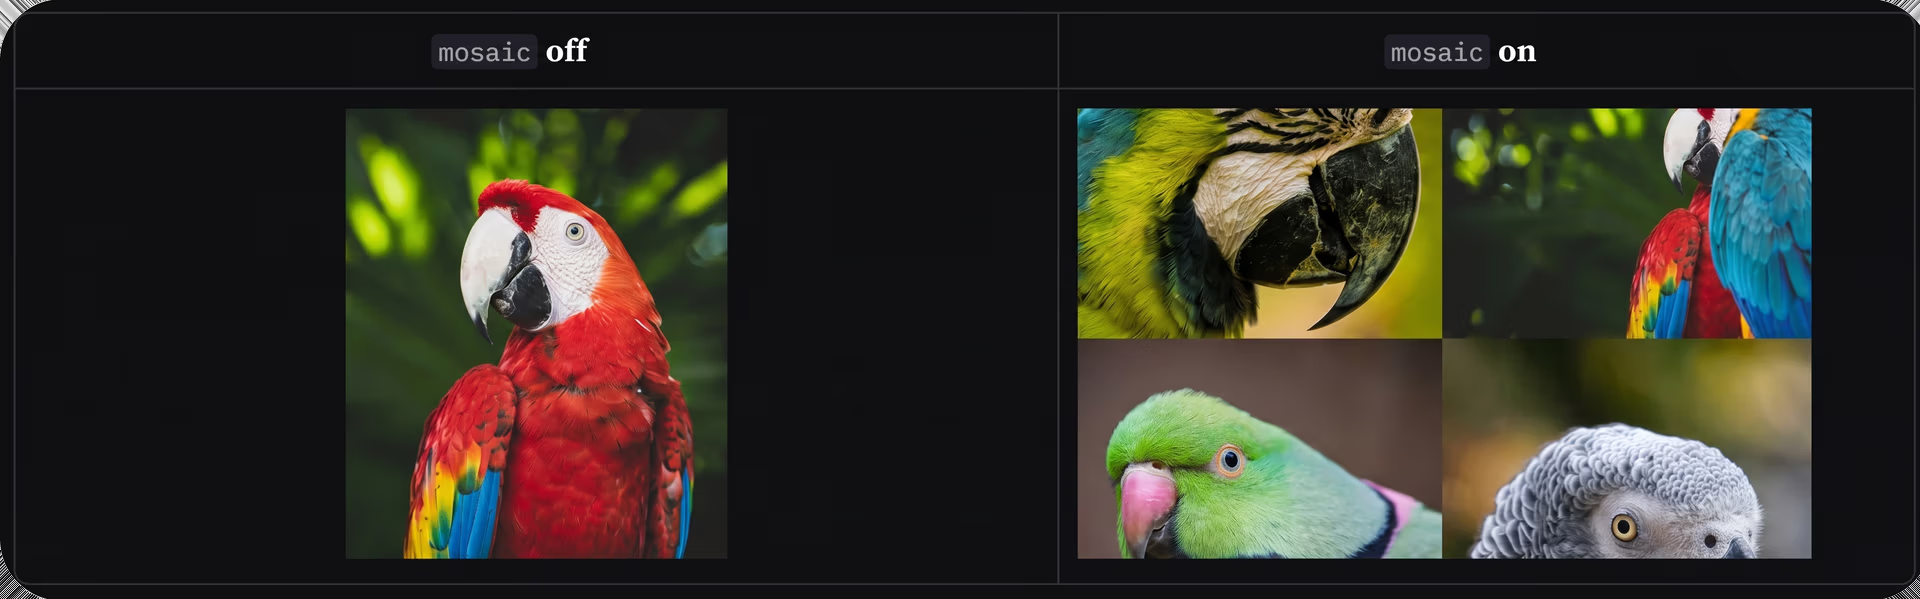
図3. 複数画像を使ったデータ拡張の例(出典)
Ultralytics Pythonパッケージでデータ拡張を簡単に実現#
データセットの管理、画像バリエーションの作成、変換コードの記述は、コンピュータービジョンアプリケーションの構築に追加の手順をもたらすことがあります。Ultralytics Pythonパッケージは、YOLO26などのUltralytics YOLOモデルの学習、実行、デプロイに対応する単一のインターフェースを提供し、こうした作業を簡素化します。学習ワークフローの効率化に向けた取り組みの一環として、このパッケージには、YOLOモデル向けに最適化された、Ultralyticsがテスト済みの組み込みデータ拡張機能が含まれています。
また、個別のツールやカスタムコードを不要にする便利なインテグレーションにも対応しています。具体的には、データ拡張に関して、広く利用されている画像拡張ライブラリのAlbumentationsと連携します。このインテグレーションにより、追加のスクリプトやカスタムコードを用意しなくても、学習中にデータ拡張を自動的に適用できます。
アノテーションと拡張データセットの管理#
モデルのロバスト性に影響するもう1つの要因は、アノテーションの品質です。Ultralytics PlatformやRoboflowなどのアノテーションツールを使って作成・管理された、明確で正確なラベルは、物体の位置や外観をモデルが理解するのに役立ちます。
学習中には、反転、切り抜き、回転などのデータ拡張が動的に適用され、アノテーションはこれらの変化に合わせて自動的に調整されます。ラベルが正確であれば、この処理はスムーズに行われ、同じシーンの現実的な例を多数モデルに提供できます。
アノテーションが不正確または一貫していない場合、その誤りが拡張画像にも繰り返し反映され、学習の効果が低下する可能性があります。正確なアノテーションから始めることで、こうした誤りの拡散を防ぎ、モデルのロバスト性向上につながります。
データ拡張でビジョンAIアプリケーションを強化#
次に、実環境のアプリケーションでデータ拡張がAIモデルのロバスト性にどのように貢献するか、例を見ていきましょう。
実環境での物体検出精度を向上#
実データが限られている場合、機密性が高い場合、または収集が難しい場合、物体検出システムの学習には合成画像がよく使用されます。合成画像を使えば、現実のあらゆる状況を撮影しなくても、製品、環境、カメラアングルのサンプルをチームが迅速に生成できます。
ただし、合成データセットは、照明の変化、オブジェクトの重なり、背景の雑然とした状態が見られる実世界の映像と比べて、きれいすぎる場合があります。データ拡張では、照明、ノイズ、オブジェクトの配置などに現実的な変化を加えてこの差を埋め、デプロイ後に遭遇する状況にモデルが対応できるよう学習させます。
たとえば、最近の研究では、Ultralytics YOLO11モデルをすべて合成画像でトレーニングし、さらなる多様性を加えるためにデータ拡張を適用しました。これにより、モデルはより幅広く物体を認識できるようになりました。トレーニング中に実世界のデータを一度も見ていなかったにもかかわらず、実画像でのテストでも優れた性能を示しました。
医用画像ソリューションの信頼性を高める#
医用画像データセットは限られていることが多く、スキャン画像は装置の種類、撮像設定、臨床環境によって異なる場合があります。患者の解剖学的特徴、角度、照明、視覚ノイズの違いにより、コンピュータービジョンモデルが患者や病院をまたいで汎化するパターンを学習するのが難しくなることがあります。
データ拡張では、ノイズの追加、画像のわずかな移動、小さな歪みの適用などによって、学習中に同じスキャン画像の複数のバリエーションを作成し、この問題に対処します。これらの変化により、学習データが実際の臨床環境をより反映するようになります。
たとえば、小児画像診断の研究では、研究者が解剖学的構造のセグメンテーションにUltralytics YOLO11を使用し、拡張した医用データで学習させました。画像をより現実的にするため、ノイズの追加、位置のわずかな移動、小さな歪みなどの変化を加えました。
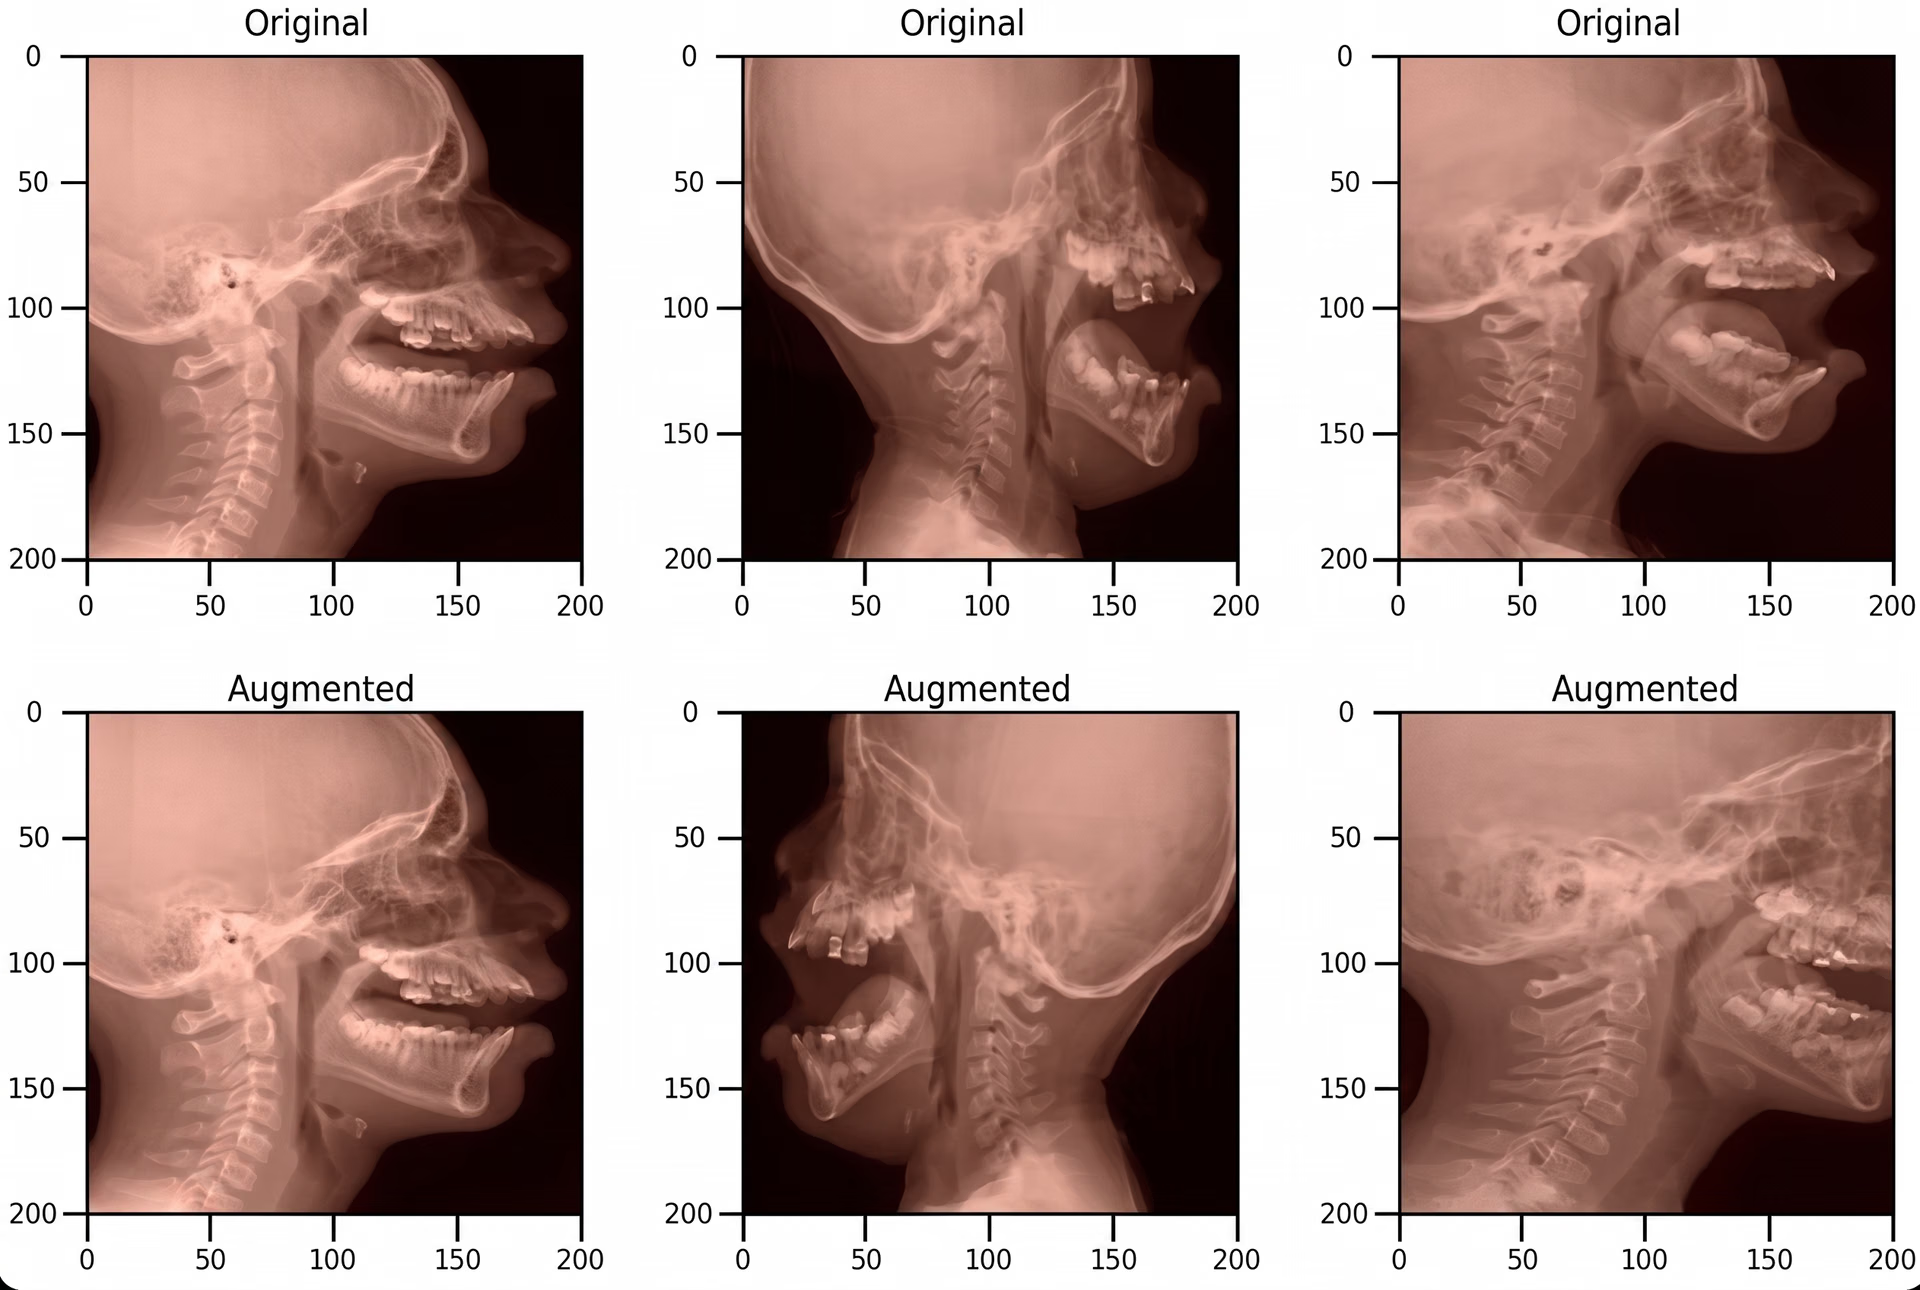
図4. 小児医用画像の元画像と拡張画像(出典)
こうした変化から学習することで、モデルは表面的な違いではなく、意味のある解剖学的特徴に注目しました。その結果、さまざまなスキャン画像や患者の症例に対して、より安定したセグメンテーション結果が得られました。
重要なポイント#
多様なデータの収集は困難ですが、データ拡張を使えば、より幅広い視覚条件からモデルが学習できます。その結果、遮蔽、照明の変化、混雑したシーンに対するモデルのロバスト性が高まります。全体として、管理された学習環境の外でも、モデルがより安定した性能を発揮できるようになります。
コミュニティに参加して、ビジョンAIの最新情報をGitHubリポジトリでご覧ください。製造業におけるAIやヘルスケアにおけるコンピュータービジョンなどのアプリケーションがどのように進歩を推進しているか、ソリューションページをご覧ください。また、次のAIソリューションに活用できるライセンスオプションもご確認ください。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









