ポーズ推定ツールの完全ガイド
ポーズ推定ツールを使用して画像や動画内の身体のキーポイントを検出し、2Dおよび3Dポーズを推定して、さまざまなVision AIアプリケーションを実現する方法を学びます。
人間は、動きを本能的に読み取ります。誰かが前かがみになったり、頭を向けたり、腕を上げたりすると、その人が何をしているのかをすぐに推測できます。これは静かで、ほとんど無意識に行われる能力であり、人との関わり方や世界の探索方法を形作っています。
テクノロジーが日常生活のより大きな部分を占めるようになるにつれ、私たちが動きをスムーズに理解するのと同じように、デバイスにも動きを理解してほしいと考えるのは自然なことです。人工知能、特に深層学習を基盤とする技術の最近の進歩により、それが可能になりつつあります。とりわけ、コンピュータビジョンは画像や動画から意味を抽出するのに役立ち、この進歩を推進しています。
例えば、ポーズ推定は一般的なコンピュータビジョンタスクであり、画像または動画フレーム内のあらかじめ定義された身体のキーポイント(肩、肘、腰、膝など)の位置を予測します。これらのキーポイントは、固定されたスケルトン定義を使用して接続し、簡略化されたポーズ表現を形成できます。
Ultralytics YOLO11や近日公開予定のUltralytics YOLO26などのコンピュータビジョンモデルは、ポーズ推定などのタスクに対応しており、フィットネスやスポーツでのフォームフィードバック、安全性モニタリング、インタラクティブな拡張現実体験など、リアルタイムアプリケーションを支えるために利用できます。
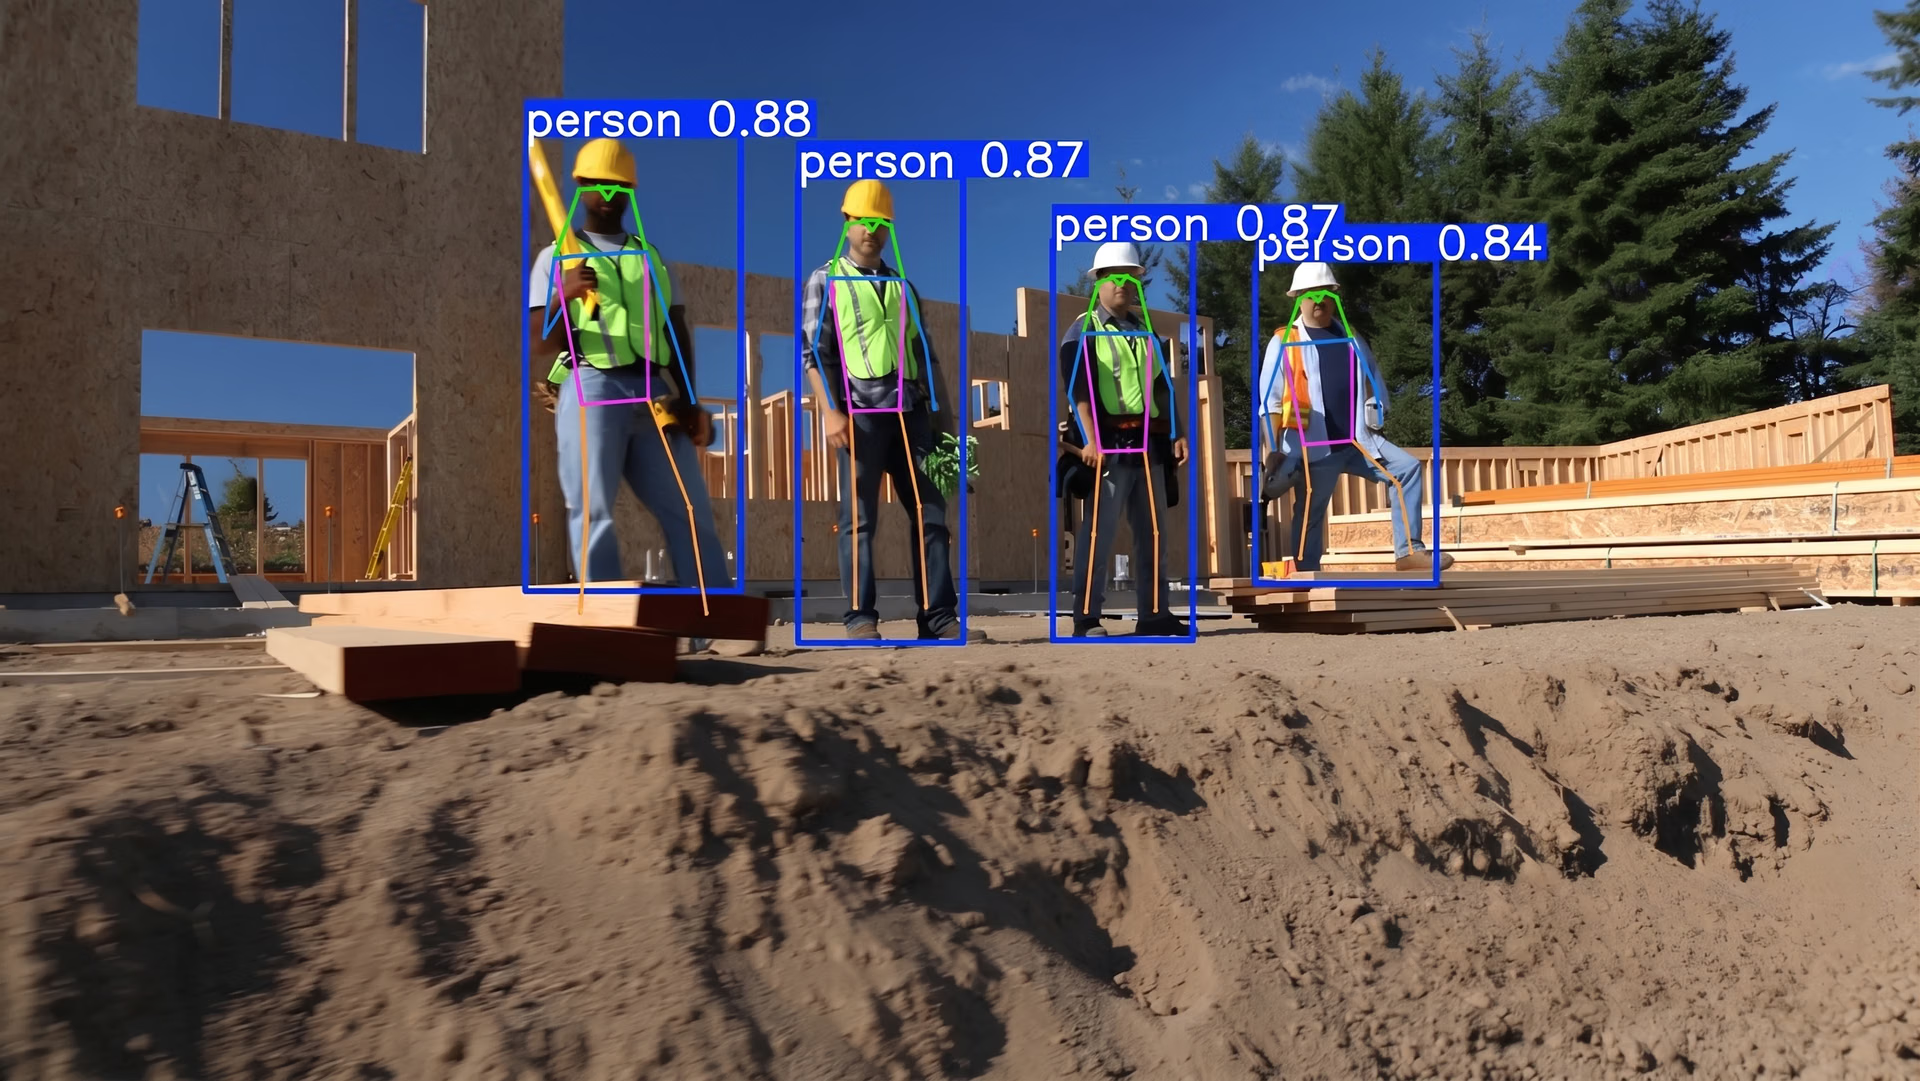
図1. ポーズ推定に Ultralytics YOLO11 を使用する様子(出典)
この記事では、ポーズ推定ツールについて詳しく掘り下げ、ポーズ推定の仕組み、用途、そして現在利用できる主要なモデルとライブラリを見ていきます。始めましょう。
姿勢推定とは何ですか?#
ポーズ推定は、画像や動画内で人や物体がどのような位置関係にあるかをシステムが理解するのに役立つコンピュータビジョン技術です。すべてのピクセルを均等に分析するのではなく、頭、肩、肘、腰、膝、足首など、一貫したランドマークのセットを予測します。
ほとんどのモデルは、これらのキーポイントの座標と、各予測が正しい可能性を示すスコアを出力します。その後、これらのキーポイントを定義済みのスケルトンレイアウトで接続し、単純なポーズ表現を形成できます。
動画にフレーム単位で適用すると、得られたキーポイントを時間経過に沿って関連付け、動きを推定できます。これにより、フォームチェック、動作分析、ジェスチャーベースのインタラクションなどのアプリケーションが可能になります。
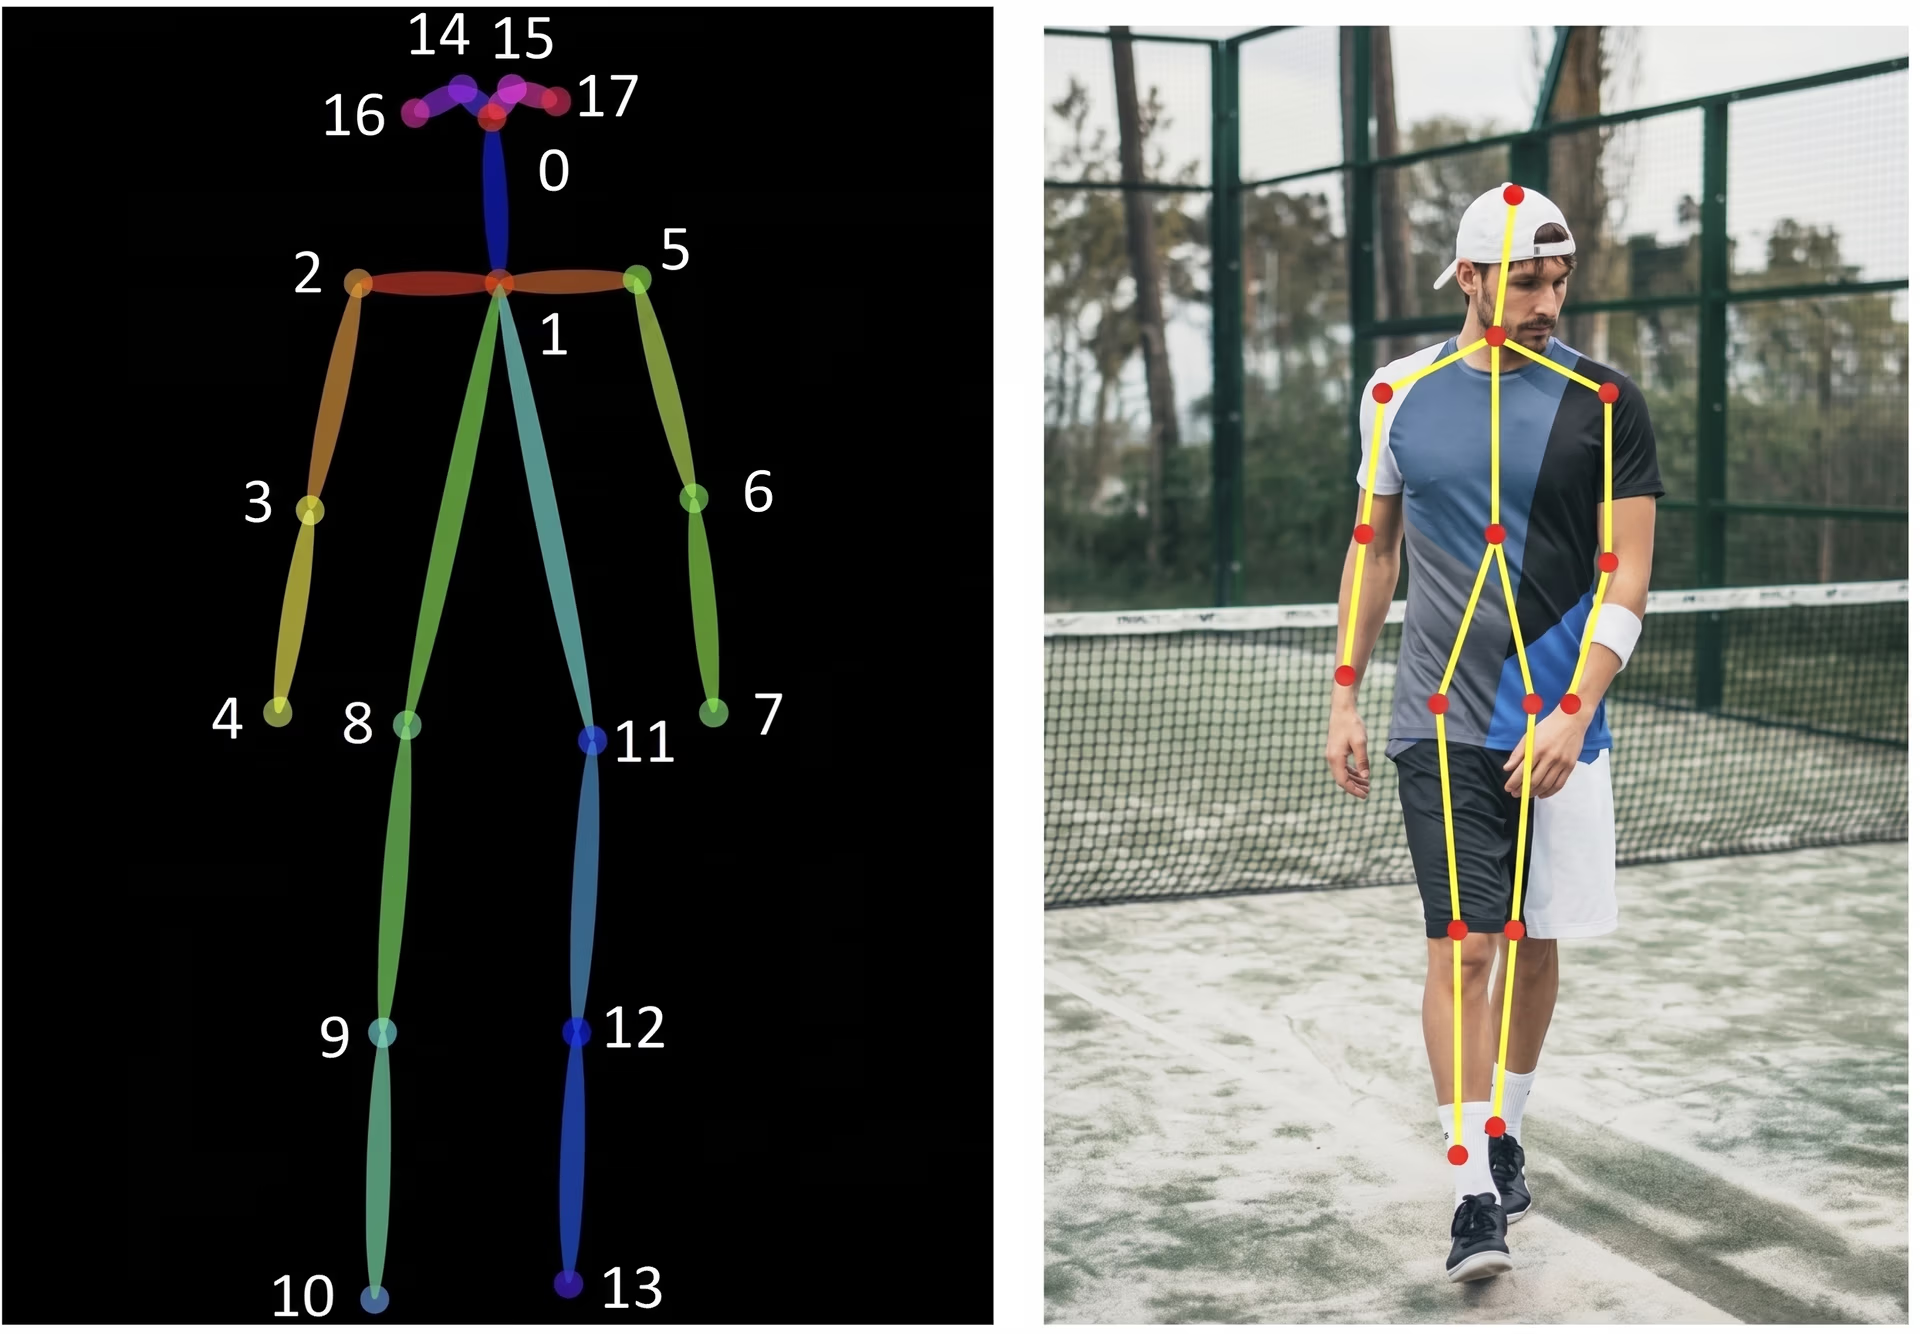
図2. ポーズ推定の例(出典)
ポーズ推定ツールの必要性#
人間の動きには多くの情報が含まれています。誰かがどのように体を曲げ、手を伸ばし、体重を移動するかによって、意図、努力、疲労、さらにはけがのリスクまで明らかになることがあります。最近まで、このレベルの詳細を捉えるには、通常、専用センサー、モーションキャプチャスーツ、または管理された実験環境が必要でした。
ポーズ推定はこの状況を変えます。通常の画像や動画から身体の主要なランドマークを抽出することで、コンピュータは標準的なカメラを使用して動きを分析できます。これにより、動作分析がより利用しやすく、スケーラブルで、実環境で実用的になります。
ポーズ推定が効果を生み出す方法をいくつか紹介します。
- より安全な職場:ビジョンベースのシステムを使用して、けがが発生する前に、危険な姿勢、反復的な負荷、または安全でない持ち上げ動作を検出できます。
- より良いフィットネスとスポーツトレーニング:ビジョンAIソリューションは、フォーム、バランス、テクニックをリアルタイムで評価し、ウェアラブルデバイスなしでユーザーに即時フィードバックを提供できます。
- 医療とリハビリテーション:臨床医は、簡単な動画録画を使用して、回復の進捗、姿勢、可動域を遠隔で追跡できます。
- インタラクティブな体験:ポーズ推定により、デジタルアバターや没入型環境が人間の動きを正確に追従し、反映しやすくなります。
ポーズ推定アルゴリズムの進化#
ポーズを推定するという考え方は、長年にわたって存在してきました。初期のアプローチでは、単純な幾何学モデルと人手で設計したルールが使用され、通常は管理された条件でのみ機能していました。
例えば、人物が固定された位置で静止している場合にはうまく機能しても、実世界のシーンで歩き始めたり、向きを変えたり、物体と взаимодействしたりすると機能しなくなることがあります。これらの手法は、自然な動き、変化するカメラアングル、複雑な背景、部分的なオクルージョンへの対応に苦労することがよくありました。
最新のポーズ推定は、深層学習によってこれらの課題に対応します。大規模なラベル付きデータセットで畳み込みニューラルネットワークを学習させることで、モデルはさまざまなポーズ、人物、環境でキーポイントをより確実に検出するための視覚パターンを学習します。
より多くの例を使用すると、モデルは予測を改善し、新しいシーンへの汎化能力を高めます。この進歩により、ポーズ推定は現在、職場のモニタリングや人間工学、コーチやアナリストがアスリートの動きを研究するスポーツ分析など、幅広い実用的なユースケースに対応しています。
ポーズ推定技術の種類#
ポーズ推定には、環境や測定したい対象に応じていくつかの形式があります。主な種類を紹介します。
- 2Dポーズ推定:このアプローチは、2次元画像または動画フレーム内の身体のキーポイントを検出します。標準的なカメラで適切に動作し、計算効率にも優れているため、基本的な動作追跡、姿勢分析、リアルタイムのフォームフィードバックなどのタスクに適しています。
- 3Dポーズ推定:画像座標に加えて深度を推定することで、3Dポーズ推定は身体の動きを空間的に理解できます。これは、スポーツ分析、リハビリテーション、生体力学、アニメーションなど、前後の動きが重要な場合に特に役立ちます。具体的には、3D人物ポーズ推定によって3D空間内の関節位置と動きを捉え、2D投影で生じる可能性のある曖昧さを軽減します。
- 単一人物ポーズ推定:これらのシステムは、一度に1人の人物を追跡するように設計されています。ガイド付きエクササイズアプリケーション、ビデオ通話、動作分析環境など、対象者が明確に見える管理された、または半管理された環境で最も高い性能を発揮する傾向があります。
- 複数人物ポーズ推定:複数の人物がいるシーン向けに構築されたこのアプローチでは、複数の人物のポーズを同時に検出・追跡します。対象者同士が重なったり、互いに遮蔽したりする職場、ジム、公共空間、グループ活動などの混雑した環境で特に役立ちます。
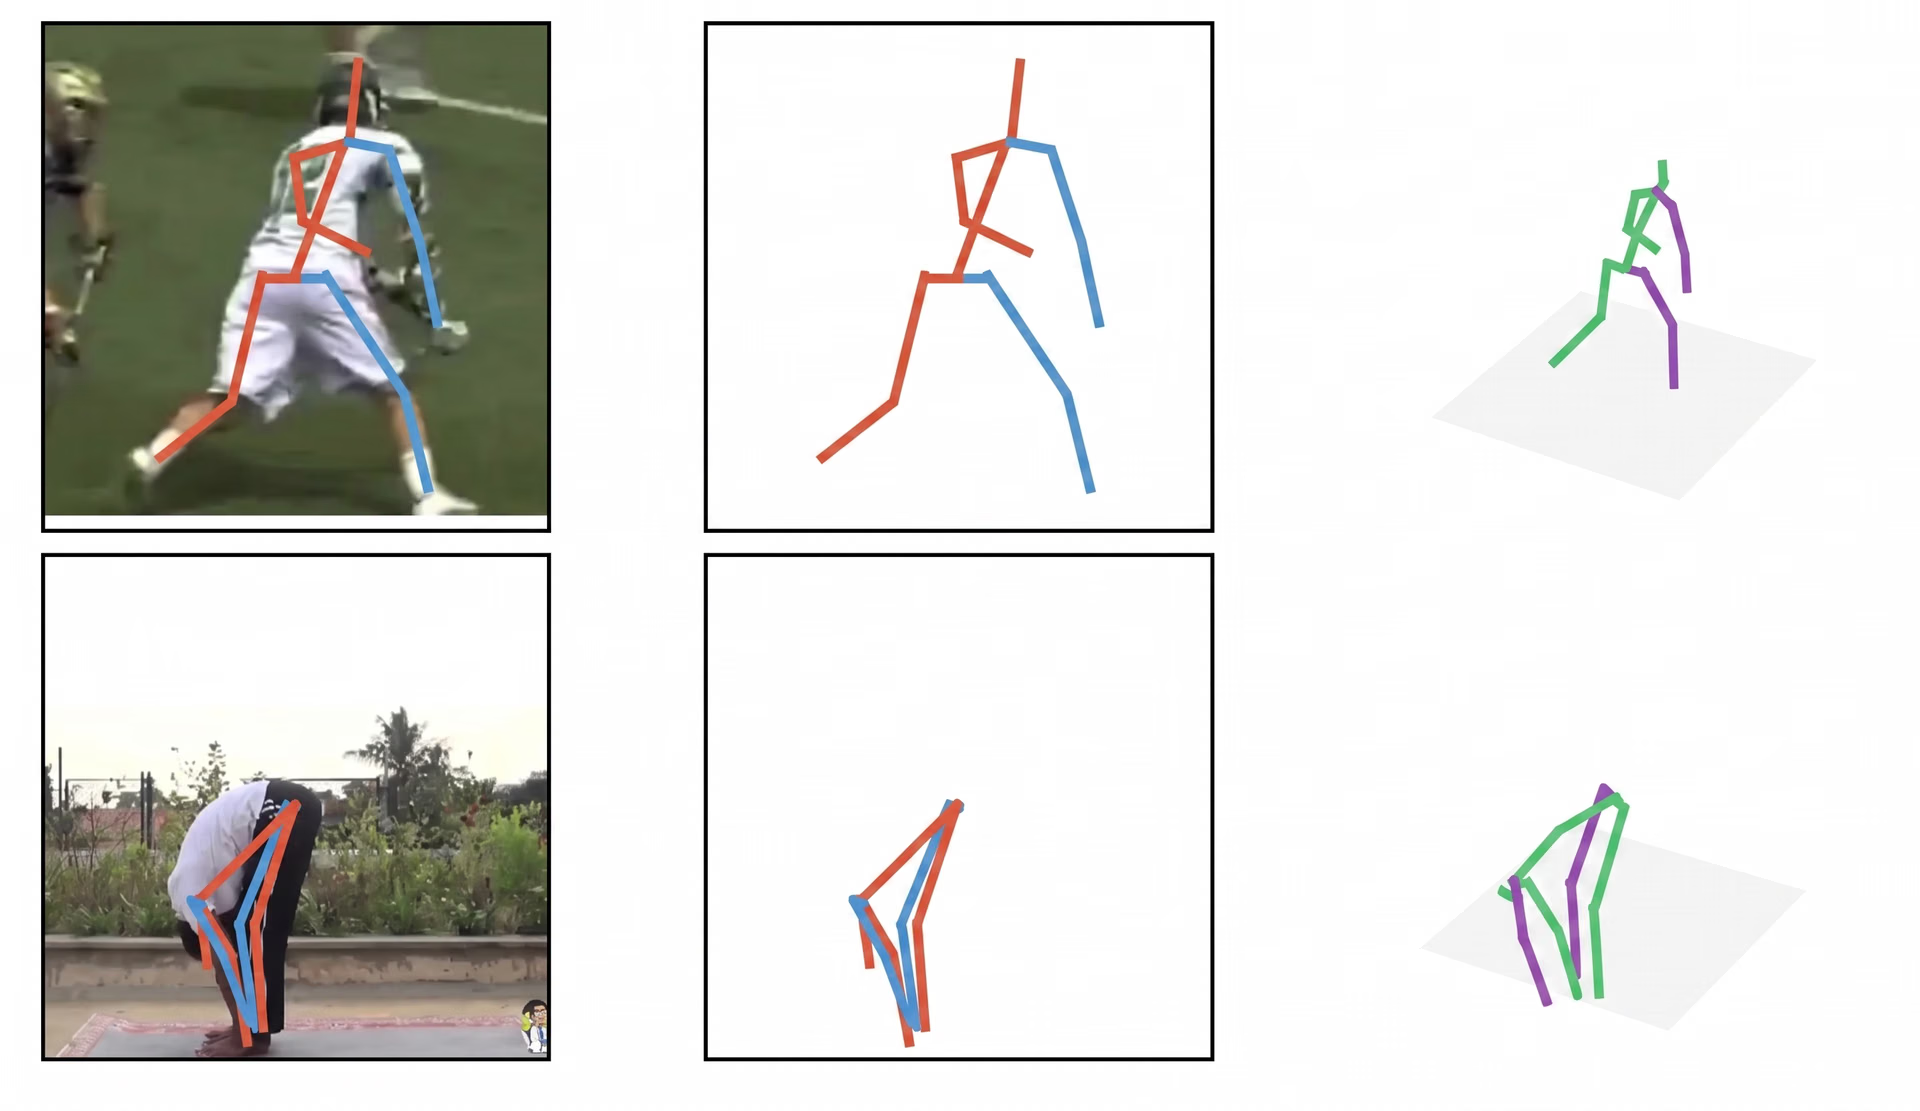
図3. 3D空間と2D画像空間における人間の動きの理解(出典)
人間のポーズ推定モデルの仕組みを理解する#
ポーズ推定はさまざまな種類の物体に適用できますが、ここでは話を簡単にするため、人間のポーズ推定に焦点を当てます。
ほとんどの人間ポーズ推定システムは、大規模な画像・動画フレームのコレクション全体で身体の主要部位にラベルを付けた、アノテーション済みデータセットで学習します。これらの例を使用して、モデルは肩、肘、腰、膝、足首などの身体のランドマークに関連する視覚パターンを学習し、新しいシーンでキーポイントを正確に予測できるようになります。
もう1つの重要な要素は、モデルの推論アーキテクチャです。これは、キーポイントをどのように検出し、完全なポーズに組み立てるかを決定します。人物を最初に検出してから各人物の領域内でキーポイントを推定するシステムもあれば、画像全体でキーポイントを検出してから個々の人物にグループ化するシステムもあります。より新しいシングルステージ設計では、1回のパスでポーズを予測でき、リアルタイム利用に適した速度と精度のバランスを実現します。
次に、さまざまなポーズ推定アプローチを詳しく見ていきます。
ボトムアップ型ポーズ推定#
ボトムアップ型アプローチでは、モデルが画像全体を確認し、まず頭、肩、肘、腰、膝、足首などの身体のキーポイントを見つけます。この段階では、人物を分離しようとはしません。シーン全体から、ポーズスケルトンで定義されたすべてのキーポイントまたは身体の関節を検出するだけです。
その後、システムは2番目のステップで各要素をつなぎ合わせます。関連するキーポイントを結び付け、人物ごとに完全なスケルトンへグループ化します。各人物を先に検出する必要がないため、ボトムアップ型手法は、人物同士が重なったり、異なる大きさで映ったり、一部が隠れていたりする混雑したシーンで適切に機能することがよくあります。
トップダウン型ポーズ検出#
これに対して、トップダウン型システムはまず画像内の各人物を検出します。すべての人物の周囲にバウンディングボックスを配置し、各ボックスを分析対象の独立した領域として扱います。
人物が分離されると、モデルはその領域内の身体のキーポイントを予測します。この段階的な構成は、特にシーン内の人物が少なく、一人ひとりが明確に見える場合に、非常に高精度な結果を生み出すことがよくあります。
シングルステージまたはハイブリッド型ポーズ推定#
シングルステージモデルは、ハイブリッドと呼ばれることもあり、1回のパスでポーズを予測します。最初に人物検出、次にキーポイント推定を実行するのではなく、人物の位置と身体のキーポイントを同時に出力します。
すべてが1つのモジュール内で行われるため、これらのモデルはより高速かつ効率的であることが多く、ライブ動作追跡やモーションキャプチャなどのリアルタイム用途に適しています。Ultralytics YOLO11などのモデルはこの考え方を中心に構築されており、速度と信頼性の高いキーポイント予測の両立を目指しています。
ポーズ推定モデルの学習と評価#
どのアプローチを使用する場合でも、ポーズ推定モデルが実世界で信頼できるものになるには、慎重な学習とテストが必要です。通常、身体のキーポイントにラベルを付けた大量の画像(場合によっては動画)から学習し、さまざまなポーズ、カメラアングル、環境に対応できるようにします。
よく知られたポーズ推定データセットには、COCO Keypoints、MPII Human Pose、CrowdPose、OCHumanなどがあります。これらのデータセットがモデルのデプロイ先の条件を反映していない場合、エンジニアは工場の現場、ジム、診療所など、対象環境から追加の画像を収集してラベル付けすることがよくあります。
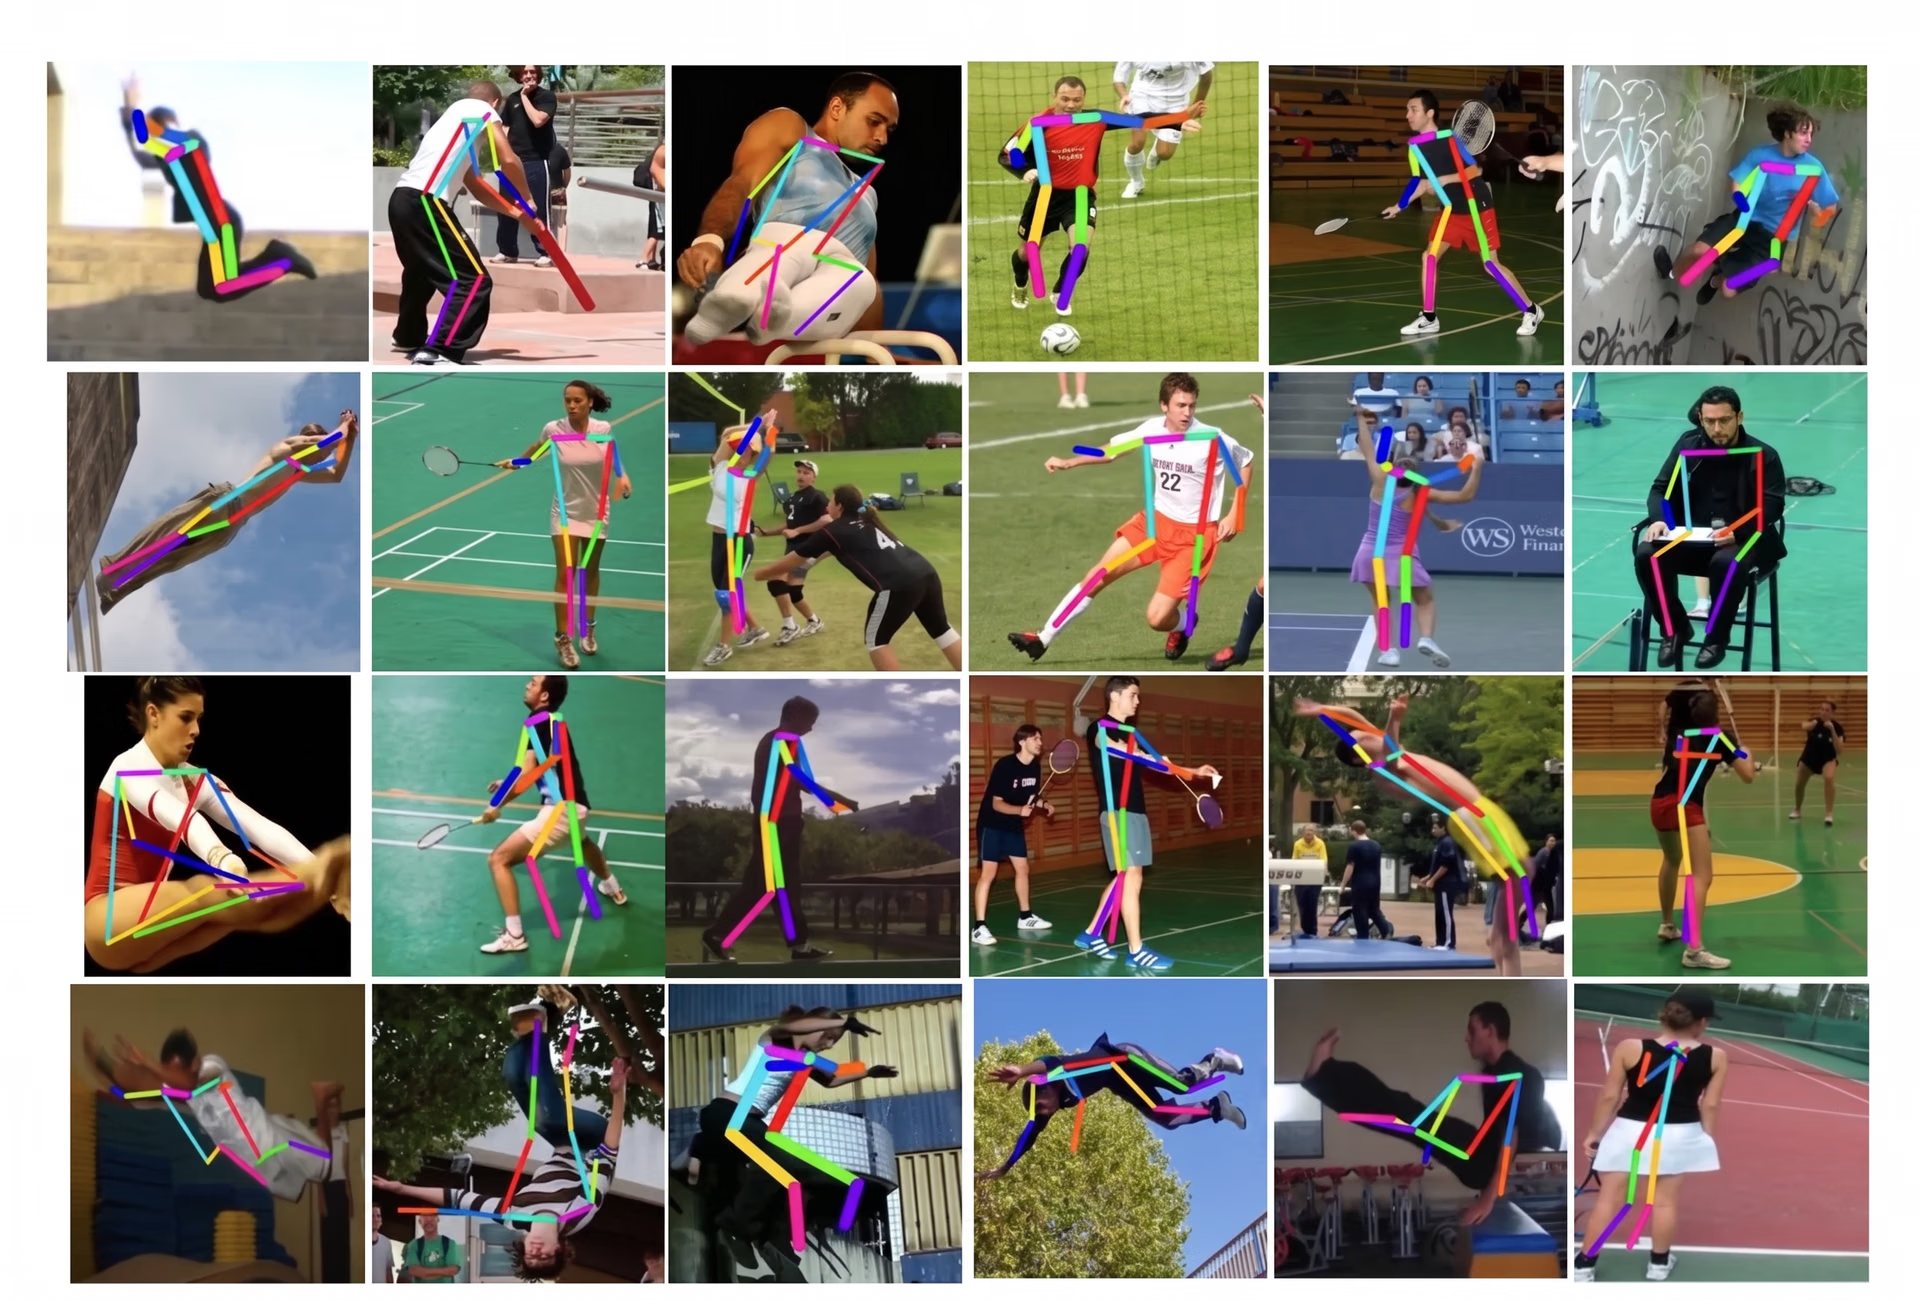
図4. コンピュータビジョンを使用して推定されたさまざまなポーズ(出典)
学習後、モデルの性能は標準ベンチマークで評価され、精度と堅牢性を測定するとともに、実環境での利用に向けたさらなる調整の指針とします。結果は、平均適合率(一般にmAPと呼ばれます)を使用して報告されることが多く、予測ポーズとラベル付けされた正解データを比較することで、さまざまな信頼度しきい値における性能を要約します。
多くのポーズベンチマークでは、Object Keypoint Similarity(OKS)を使用して予測ポーズと正解ポーズを対応付けます。OKSは、人物のスケールや各キーポイントに固有の一般的な位置特定の難しさなどを考慮しながら、予測されたキーポイントがアノテーション済みキーポイントにどれだけ近いかを測定します。
ポーズモデルは、検出された人物と個々のキーポイントについて信頼度スコアも出力します。これらのスコアはモデルの確信度を示し、予測のランキング付けやフィルタリングに使用されます。これは、オクルージョン、モーションブラー、通常とは異なるカメラアングルなど、困難な条件で特に重要です。
人気のポーズ推定ツールとライブラリ#
現在、多くのポーズ推定ツールが利用でき、それぞれ速度、精度、使いやすさのバランスが異なります。広く使用されているツールとライブラリをいくつか紹介します。
- Ultralytics YOLO11:最先端のオープンソースビジョンAIモデルとして開発されたYOLO11は、Ultralytics YOLOv8などの以前のモデルを基盤としています。ポーズ推定を含むさまざまなコンピュータビジョンタスクに対応しながら、速度、精度、全体的な効率を向上させています。ノートパソコンからエッジデバイスまで、幅広いプラットフォームで高い性能を発揮するYOLO11は、多くの実環境へのデプロイに適した選択肢です。
- Ultralytics YOLO26:この近日公開予定の次世代モデルは、高い精度を維持しながら、より軽量、小型、高速になるよう設計されています。リアルタイム利用と容易なデプロイを想定して構築されており、エッジデバイスから大規模システムまで、さまざまな用途に適したモデルサイズで、物体検出、インスタンスセグメンテーション、ポーズ推定などのタスクに対応します。
- MediaPipe:ビジョンおよび機械学習パイプラインを構築するためのクロスプラットフォームフレームワークです。軽量で、モバイルデバイス、タブレット、Webアプリ上で効率的に動作し、全身ポーズ、顔のランドマーク、ハンドトラッキング用のすぐに使えるソリューションとモデルを備えています。
- OpenPose**:このエンドツーエンドのオープンソースポーズ推定システムは、複数人物のキーポイント検出で広く知られています。身体、手、顔のキーポイントを同時に推定でき、研究、アニメーション、動作分析でよく使用されています。
- MMPose:MMPoseは、OpenMMLabエコシステムのPyTorchベースのポーズ推定ツールキットです。多数のモデル実装、学習ユーティリティ、設定オプションを提供しており、実験や高度なカスタマイズに役立ちます。
- HRNetとAlphaPose:これらは現在も研究で使用されている比較的古いポーズ推定モデルです。HRNetはネットワーク全体で高解像度の画像特徴を維持するポーズモデルアーキテクチャであり、キーポイントを正確に位置特定するのに役立ちます。AlphaPoseは広く使用されている複数人物ポーズ推定システムで、混雑した複雑なシーンで高い精度が必要な場合によく使用されます。
ポーズ分析と推定の実環境でのアプリケーション#
ポーズ推定は、一般的な動画を有用な動作に関する洞察へ変換するために、ますます利用されるようになっています。身体のキーポイントをフレームごとに追跡することで、これらのシステムはカメラ映像から姿勢、動き、身体的な行動を推測でき、この技術を多くの実環境で実用化できます。
例えば、医療やリハビリテーションでは、ポーズ追跡によって臨床医が治療や回復中の患者の動きを確認・測定できます。通常の動画録画から身体のランドマークを抽出することで、姿勢、可動域、時間経過に伴う全体的な動作パターンの評価に利用できます。これらの測定は従来の臨床評価を補完・最適化し、場合によってはウェアラブルセンサーや専用機器を使わずに進捗を追跡しやすくします。
同様に、スポーツや放送では、ポーズ推定によって動画映像から直接アスリートの動きを分析できます。興味深い例として、プロスポーツの判定や放送グラフィックスに使用されるカメラベースの追跡システム、Hawk-Eyeがあります。また、カメラ映像からアスリートの身体のキーポイントを推定し、スケルトン追跡も提供します。
適切なポーズ推定ツールの選択#
適切なポーズ推定ツールを選ぶには、まずコンピュータビジョンプロジェクトの要件を理解する必要があります。リアルタイム性を優先するアプリケーションもあれば、より高い精度と詳細さを必要とするアプリケーションもあります。
対象となるデプロイデバイスも影響します。モバイルアプリやエッジデバイスでは通常、軽量で効率的なモデルが必要ですが、サーバーやクラウド環境には大規模なモデルの方が適していることがよくあります。
これに加えて、使いやすさも重要な要素になります。優れたドキュメント、スムーズなデプロイ、カスタム学習への対応によって、プロジェクトを効率化できます。
簡単に言えば、ツールごとに得意な分野が異なります。例えば、Ultralytics YOLOモデルは、多くの実環境のポーズ推定アプリケーションにおいて、速度、精度、デプロイのしやすさを実用的なバランスで提供します。
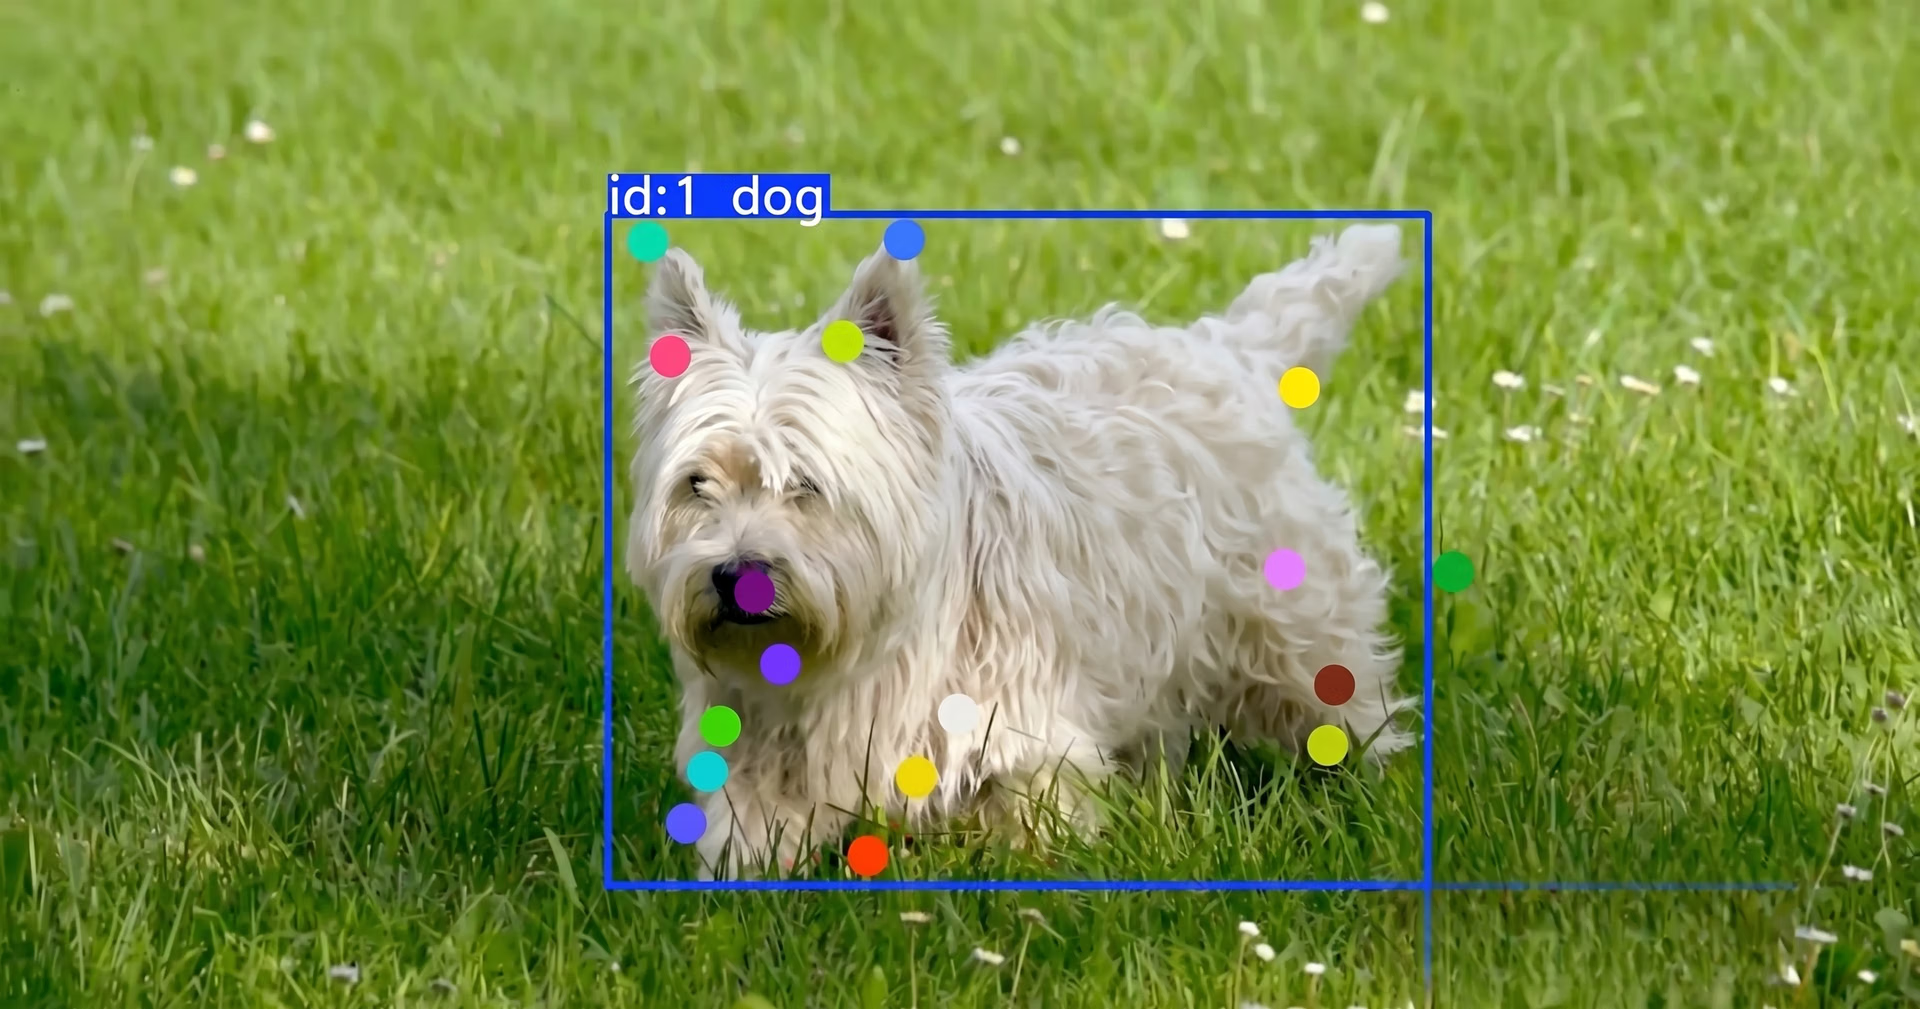
図5. Ultralytics YOLO11を使用した動物のポーズ推定(出典)
主なポイント#
ポーズ推定は、画像や動画内の身体のキーポイントを検出することで、コンピュータが人間の動きを理解するのに役立ちます。YOLO11やYOLO26などのモデルにより、スポーツ、医療、職場の安全、インタラクティブ体験などの分野で、リアルタイムアプリケーションを構築しやすくなります。モデルがさらに高速かつ高精度になるにつれ、ポーズ推定は多くのビジョンAIシステムで一般的な機能になる可能性があります。
AIについてさらに詳しく知りたいですか。コミュニティとGitHubリポジトリをご覧ください。ソリューションページで、ロボティクスにおけるAIと製造業におけるコンピュータビジョンについて学べます。ライセンスのオプションを確認し、今すぐコンピュータビジョンの構築を始めましょう。








