Ultralytics YOLO26がNMSを削除する理由とデプロイへの影響
Ultralytics YOLO26がNMSを使わない真のエンドツーエンド推論を実現する仕組みと、後処理の削除によってエクスポートやエッジへのデプロイが簡素化される理由をご紹介します。
 Abirami Vina11 分で読めます
2026年1月14日、コンピュータービジョンモデルの最新世代であるUltralytics YOLO26をリリースしました。YOLO26では、精度や速度を向上させるだけでなく、物体検出モデルの構築方法と実システムへのデプロイ方法を見直すことを目指しました。
コンピュータービジョンが研究段階から本番環境へと移行するにつれ、モデルにはCPU、エッジデバイス、カメラ、ロボット、組み込みハードウェア上での実行がますます求められています。こうした環境では、信頼性、低レイテンシ、デプロイの容易さも、性能と同じくらい重要です。
Ultralytics YOLO26は、この現状を考慮して設計されており、推論パイプラインから不要な複雑さを取り除いた、合理化されたエンドツーエンドのアーキテクチャを採用しています。YOLO26の最も重要な革新の一つは、一般にNMSと呼ばれる非最大値抑制を取り除けることです。
長年にわたり、NMSはオブジェクト検出システムの標準的な構成要素として、重複検出を整理する後処理ステップに使われてきました。効果的である一方、特にエッジハードウェアでは、追加の計算処理やデプロイ上の課題も発生していました。
YOLO26では、異なるアプローチを採用しました。予測の生成方法と学習方法を見直すことで、真のエンドツーエンドかつNMS不要の推論を実現します。モデルは、外部の整理処理や手作業で作成したルールに依存せず、最終検出結果を直接出力します。これにより、YOLO26は高速になり、エクスポートが容易になるとともに、幅広いハードウェアプラットフォームへのデプロイの信頼性も高まります。
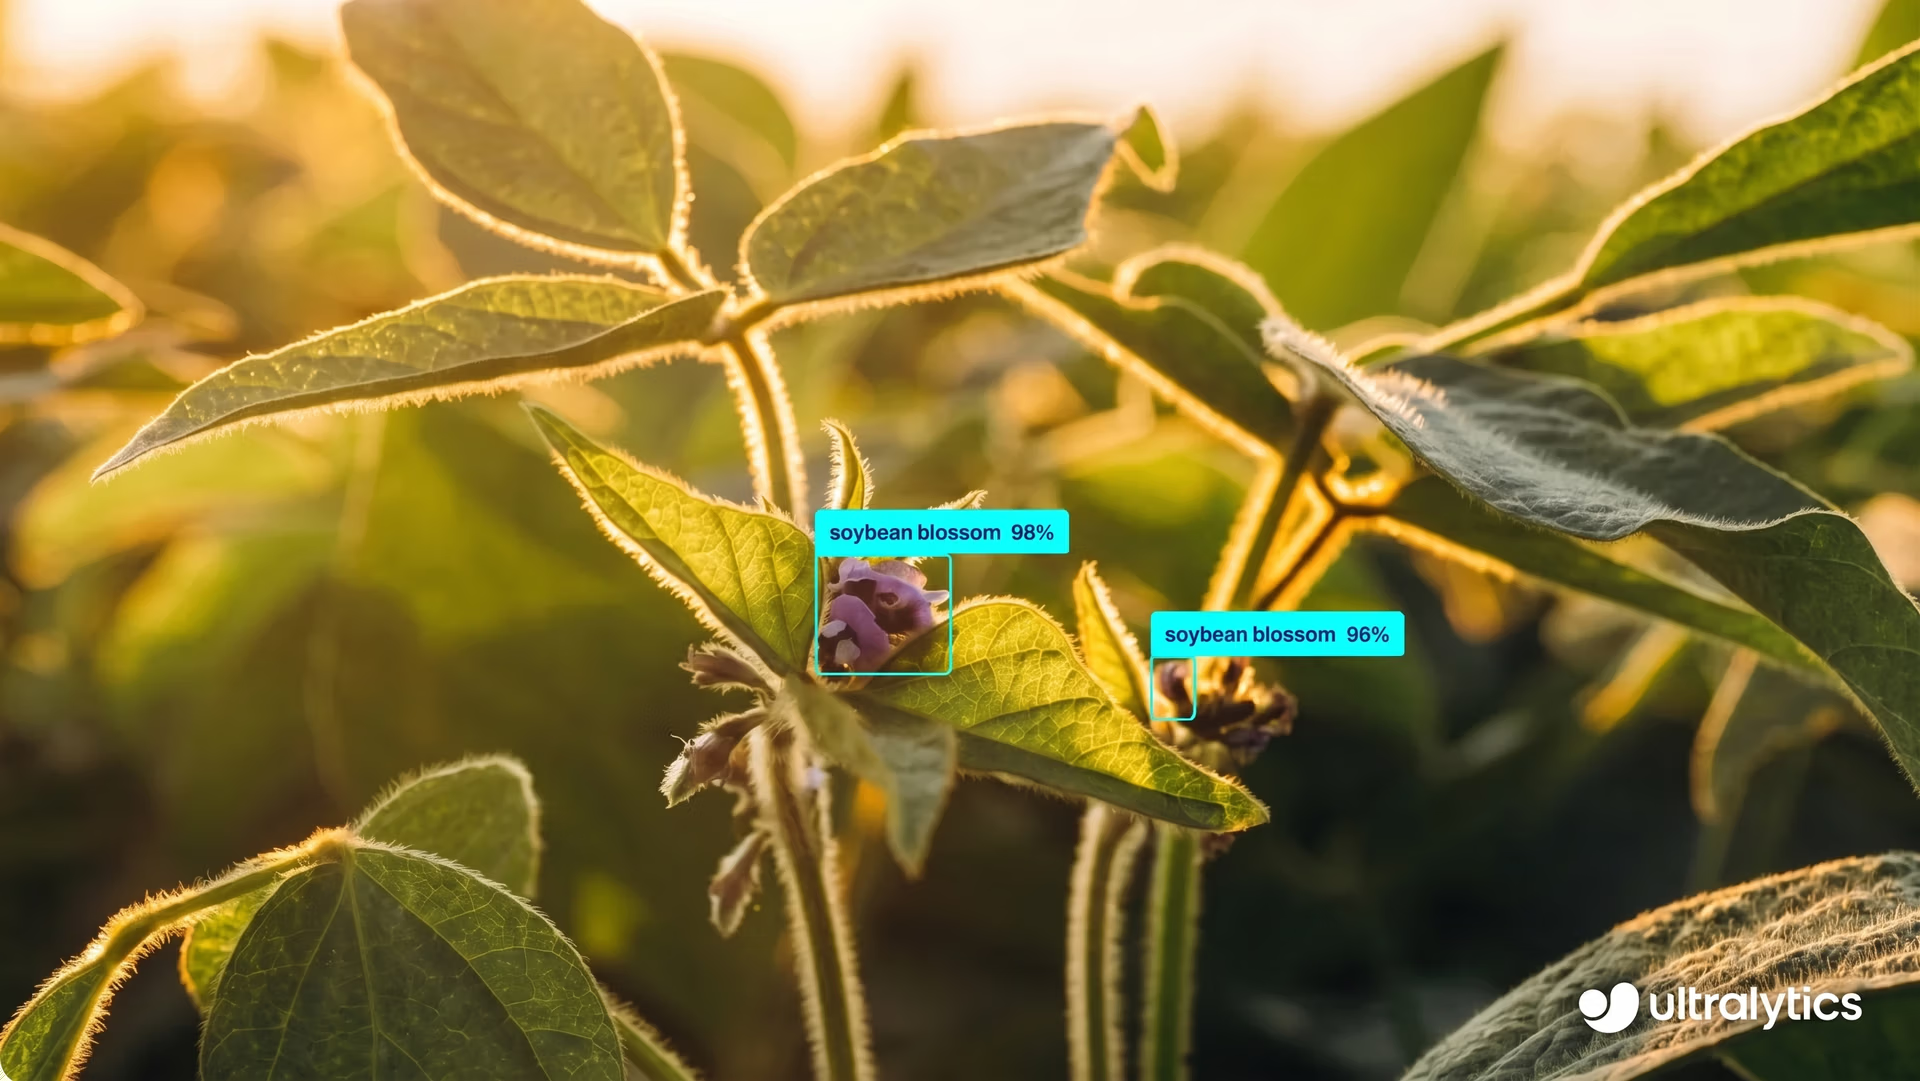
図1. Ultralytics YOLO26を使用した画像内の物体検出。
この記事では、従来の物体検出でNMSが必要とされていた理由、デプロイ時のボトルネックになった経緯、そしてUltralytics YOLO26が回避策を不要にする仕組みを詳しく解説します。
従来のオブジェクト検出では重複した検出結果が生成されます#
NMSとは何か、そしてUltralytics YOLO26でNMSを削除した理由を詳しく見る前に、少し立ち止まって、従来のオブジェクト検出モデルがどのように予測を生成するのかを確認しましょう。
従来のオブジェクト検出モデルは、同じ物体に対して、重なり合う複数のバウンディングボックスを生成することがよくあります。画像内の同じ物体を指していても、それぞれのボックスには個別の信頼度スコアが付与されます。
これにはいくつかの理由があります。まず、モデルは多くの空間位置と異なるスケールで、同時に予測を行います。これにより、さまざまなサイズの物体を検出できますが、近接する複数の位置が同じ物体をそれぞれ独立して識別することにもつながります。
次に、多くのオブジェクト検出システムはアンカーベースの手法を使用し、各位置の周辺に多数の候補ボックスを生成します。物体を正確に見つけられる可能性は高まりますが、重複する予測も増加します。
最後に、グリッドベースの検出自体が、構造上、重複を生みやすい仕組みです。物体が複数のグリッドセルの境界付近にあると、複数のセルがその物体のボックスを予測し、検出結果が重複することがあります。
そのため、モデルの生の出力には、1つの物体に対するボックスが複数含まれることがよくあります。結果を利用可能な状態にするには、冗長な予測をフィルタリングし、最終的な検出結果を1つだけ残す必要があります。
非最大値抑制について#
オブジェクト検出モデルが同じ物体に対して重なり合う複数のバウンディングボックスを生成した場合、結果を利用する前に整理する必要があります。ここで非最大値抑制を適用します。
非最大値抑制は、モデルが予測を終えた後に実行される後処理ステップです。その目的は、重複検出を減らし、各物体を最終的なバウンディングボックス1つで表現することです。
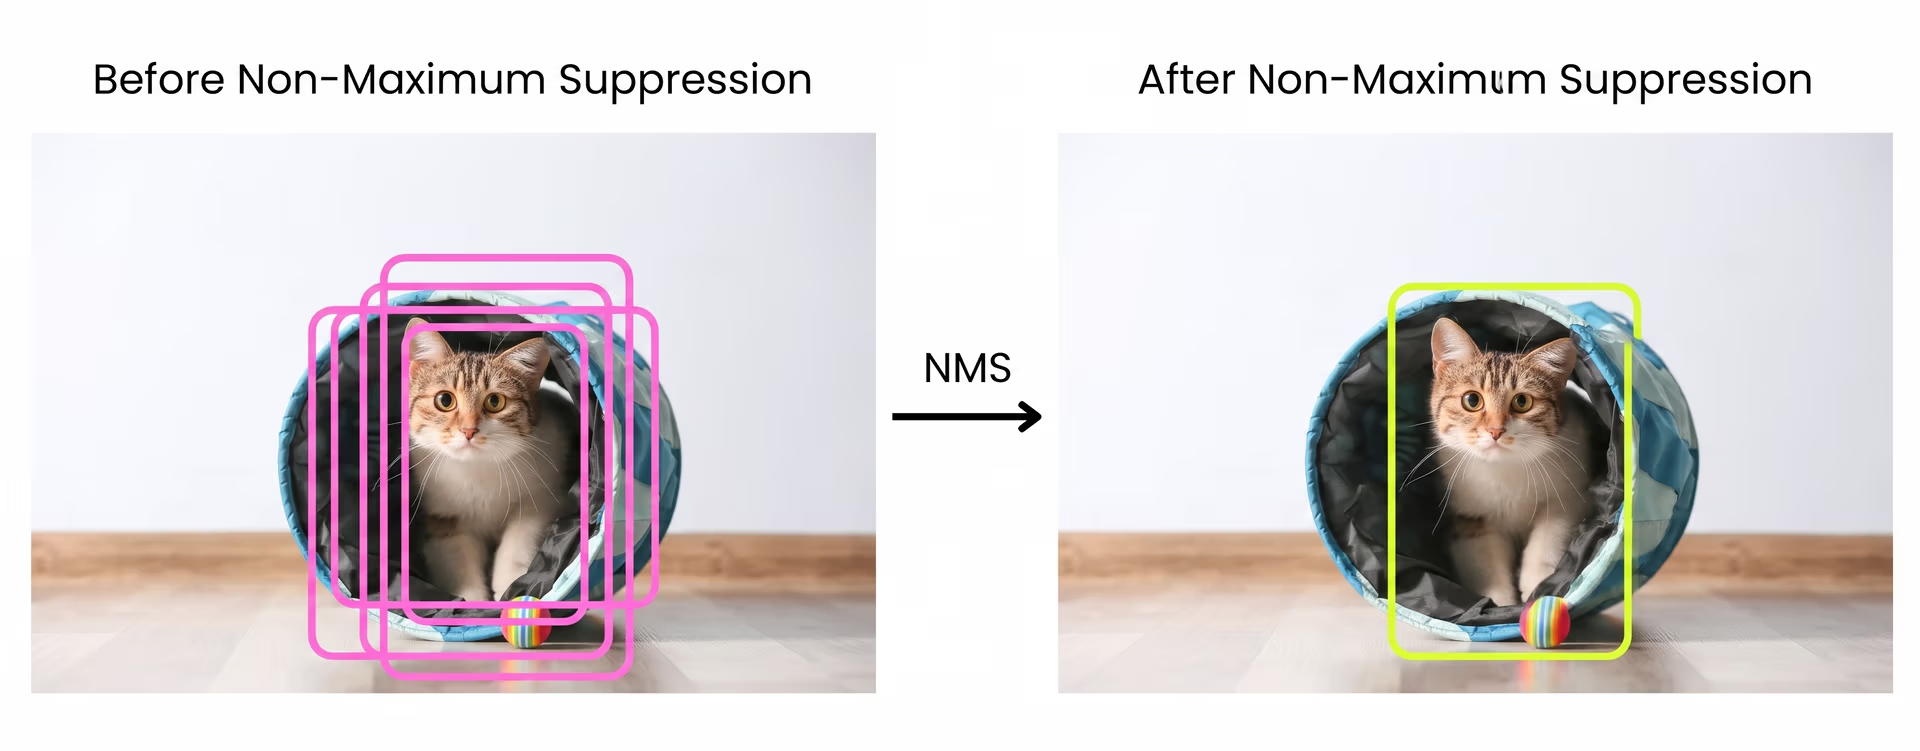
図2. NMSの概要。画像提供: 著者。
この処理では、信頼度スコアとボックスの重なり具合に基づいてバウンディングボックスを比較します。信頼度が非常に低い予測は、最初に削除されます。
次に、残ったボックスを信頼度順に並べ、最も高いスコアのボックスを最良の検出結果として選択します。選択したボックスを、ほかのボックスと比較します。
別のボックスが選択したボックスと過度に重なっている場合、そのボックスは抑制されて削除されます。重なり具合は通常、Intersection over Unionを使って測定します。これは、2つのボックスが共有する領域と、両方のボックスが覆う合計領域との比率を計算する指標です。この処理を繰り返し、信頼度が最も高く、互いに重ならない検出結果だけを残します。
NMSがデプロイを複雑にする理由#
非最大値抑制は重複検出のフィルタリングに役立つ一方、モデルが研究段階を離れて実環境にデプロイされると、より顕在化する課題ももたらします。
大きな課題の一つは性能です。NMSは推論後に実行され、保持するボックスを決定するために、バウンディングボックス同士を比較する必要があります。
この処理は計算コストが高く、効率的な並列化も困難です。エッジデバイスやCPUベースのシステムでは、この追加処理によってレイテンシが大幅に増加し、リアルタイム要件を満たしにくくなることがあります。
NMSはデプロイの複雑さも増加させます。モデル自体の一部ではないため、後処理コードとして別途実装する必要があります。
ランタイムやプラットフォームによってNMSの処理方法が異なるため、各ターゲット環境に合わせた独自実装を維持しなければならないことがよくあります。ある環境で機能するものが、別の環境ではわずかに異なる動作をする場合があり、デプロイの信頼性やスケーリングが難しくなります。
ハードウェア最適化も課題の一つです。NMSは、ニューラルネットワーク演算を効率よく実行するよう設計された専用AIアクセラレーターに適合しにくい処理です。その結果、最適化されたハードウェア上でモデルが高速に動作しても、NMSがボトルネックとなって全体の性能を制限することがあります。
こうした要因に加えて、NMSは信頼度しきい値や重なりしきい値など、手動で設定するパラメーターに依存します。これらの設定は結果に大きな影響を与えることがあり、データセット、アプリケーション、ハードウェアごとに調整が必要になる場合も少なくありません。そのため、本番システムでの動作が予測しにくくなり、設定に伴う負担も増加します。
エンドツーエンドのオブジェクト検出推論について#
非最大値抑制の制約を受け、推論時にオブジェクト検出モデルがどのように動作すべきかを見直しました。重複する予測を多数生成して後から整理するのではなく、より根本的な問いを立てました。
モデルが最終的な検出結果を直接生成できるとしたらどうでしょうか。この問いは、エンドツーエンドのオブジェクト検出推論の核心にあります。エンドツーエンドシステムでは、外部の整理処理に頼らず、検出プロセス全体を最初から最後まで処理できるようモデルを学習します。
推論後に多数の候補ボックスを生成してフィルタリングするのではなく、モデル自身が、信頼度が高く互いに重ならない少数の予測を生成するよう学習します。重複検出は後処理で削除するのではなく、ネットワーク内で解消されます。
より新しいモデルアーキテクチャにより、このアプローチが実現可能で実用的であることが示されました。適切な学習戦略を用いれば、モデルは多くの予測を競わせるのではなく、各物体に1つの予測を対応付けるよう学習でき、発生源から冗長性を減らせます。
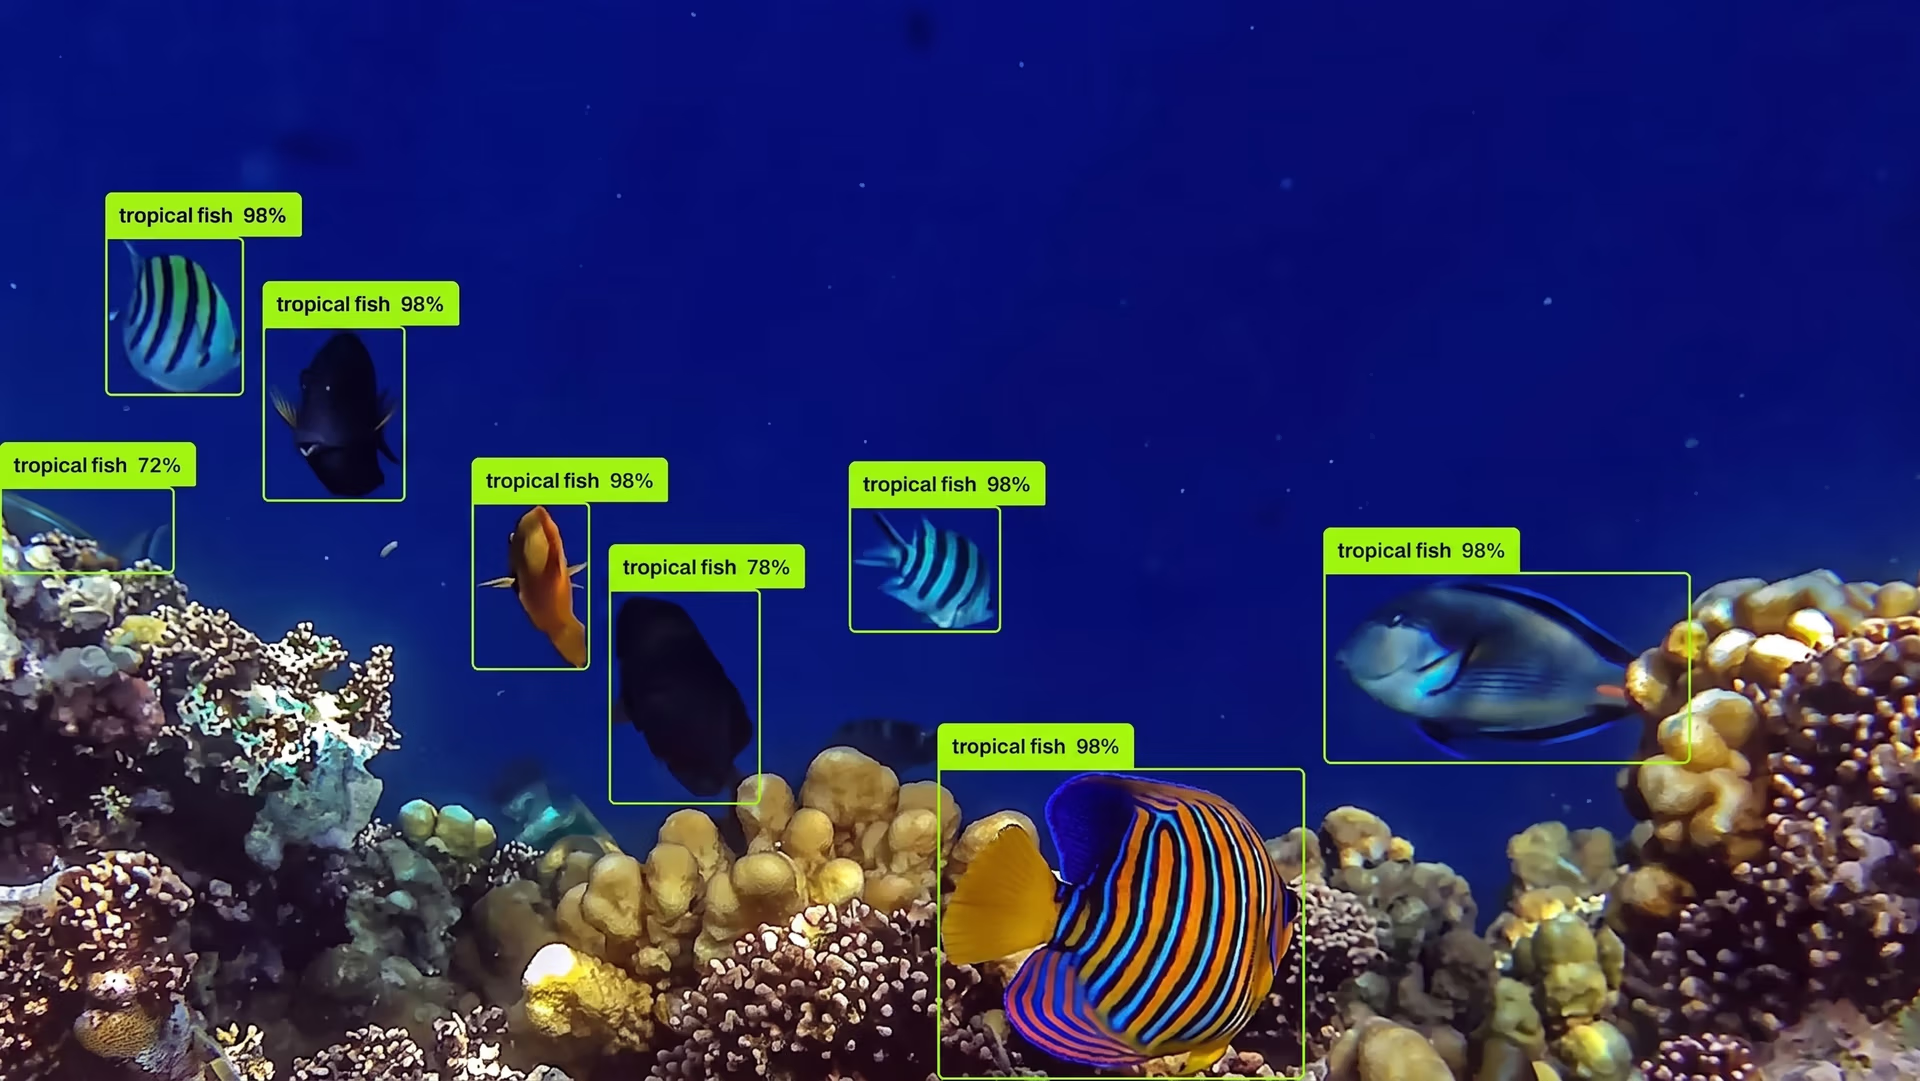
図3. Ultralytics YOLO26による物体検出の例。
この仕組みを機能させるには、学習方法も変える必要があります。多数の予測が同じ物体を取り合うのではなく、モデルは明確な判断を1つ行い、数は少なくても信頼度の高い検出結果を生成するよう学習します。
全体として、推論パイプラインがよりシンプルになります。重複はすでに内部で解消されるため、推論時に非最大値抑制を実行する必要はありません。モデルの出力が、そのまま最終的な検出結果になります。
このエンドツーエンド設計は、デプロイも容易にします。後処理ステップやプラットフォーム固有のNMS実装が不要なため、エクスポートしたモデルは完全に自己完結し、さまざまな推論フレームワークやハードウェアターゲットで一貫して動作します。
パートナーシップ担当リードエンジニアのFrancesco Mattioliは、次のように説明しています。「真のエンドツーエンド学習では、モデルがピクセルから予測まですべてを処理する必要があります。微分可能性を損ない、デプロイを複雑にする、手作業による後処理ステップに頼るべきではありません。」
Ultralytics YOLO26がNMSを取り除く仕組み#
Ultralytics YOLO26は、後処理で検出結果を整理するのではなく、検出結果の学習方法と生成方法を変えることで、非最大値抑制を取り除きます。同じ物体をめぐって多数の予測が競うのではなく、YOLO26は物体と出力の明確な1対1の対応関係を学習するよう訓練されています。
これは、従来のone-to-manyヘッドと並行して学習される専用のone-to-one検出ヘッドによって実現されます。このヘッドにより、モデルは多数の重複候補ではなく、各物体に対して信頼度の高い単一の予測を生成することに集中できます。各物体に一つの予測を対応付けるため、重複検出が自然に減少します。
学習中の一貫したマッチング戦略によってこの動作が強化され、重複する予測を生成するのではなく、物体ごとに信頼度の高い判断を1つ行うようモデルを促します。その結果、モデルの予測数は減りますが、それぞれが最終的な検出結果を表します。
DFLの削除によってNMS不要の検出が可能になった理由#
Ultralytics YOLO26のNMS不要の推論を可能にするもう一つの重要なイノベーションは、Distribution Focal Loss(DFL)の削除です。以前のYOLOモデルでは、単一の値ではなくボックス位置の分布を予測することで、バウンディングボックス回帰の精度を高めるためにDFLが使われていました。
このアプローチは位置推定の精度を高める一方で、検出パイプラインの複雑さも増していました。その複雑さが、真のエンドツーエンド推論を目指すうえで制約となりました。
DFLは追加の計算処理と固定された回帰範囲を導入するため、モデルが明確な1対1の物体割り当てを学習しにくくなり、非最大値抑制などの後処理への依存も高まっていました。Ultralytics YOLO26ではDFLを削除し、バウンディングボックス回帰をよりシンプルで直接的な方法に再設計しました。
分布ベースの出力に頼る代わりに、モデルは、数が少なく信頼度の高い検出結果を実現する方法で、正確なボックス座標を予測するよう学習します。この変更により、重複予測を発生源から減らし、バウンディングボックス回帰をUltralytics YOLO26のエンドツーエンドかつNMS不要の設計に合わせることができます。
Ultralytics YOLO26はNMS不要で、デプロイも容易です#
NMS不要の設計により、Ultralytics YOLO26は真のエンドツーエンドモデルになっています。これは、モデルのエクスポートにも大きな影響を与えます。
エクスポートとは、学習済みモデルをONNX、TensorRT、CoreML、OpenVINOなど、学習環境外で実行できる形式に変換することです。従来のパイプラインでは、非最大値抑制がモデル自体に含まれていないため、この処理で問題が発生することがよくあります。
NMSを廃止することで、Ultralytics YOLO26はこの問題を完全に回避します。エクスポートされたモデルには、最終的な検出結果の生成に必要なすべてが含まれています。現在のUltralyticsリリースでは、予測、検証、エクスポート時にnms=Falseを指定して、NMSフリーのone-to-oneヘッドを選択できます。一方、わずかに高い精度を得られる、NMSを使うデフォルトのone-to-manyヘッドも引き続き利用できます。エンドツーエンド検出ガイドでは、両方のオプションについて説明しています。
そのため、エクスポートしたモデルは完全に自己完結し、さまざまな推論フレームワークやハードウェアターゲットに対応しやすくなります。同じモデルが、サーバー、CPUのみのシステム、組み込みデバイス、エッジアクセラレーターのいずれにデプロイされても、一貫して動作します。エクスポートしたものがそのまま実行されるため、デプロイもより簡単です。
このシンプルさは、エッジアプリケーションで特に重要です。たとえばYOLO26は、ドローンに簡単にデプロイでき、作物のモニタリング、圃場の点検、植物の健康状態の分析などに利用できます。こうした用途では、計算資源や電力の制約から、複雑な後処理パイプラインは現実的ではありません。モデルが最終的な検出結果を直接出力するため、軽量なハードウェアでも追加の処理ステップなしで安定して動作します。
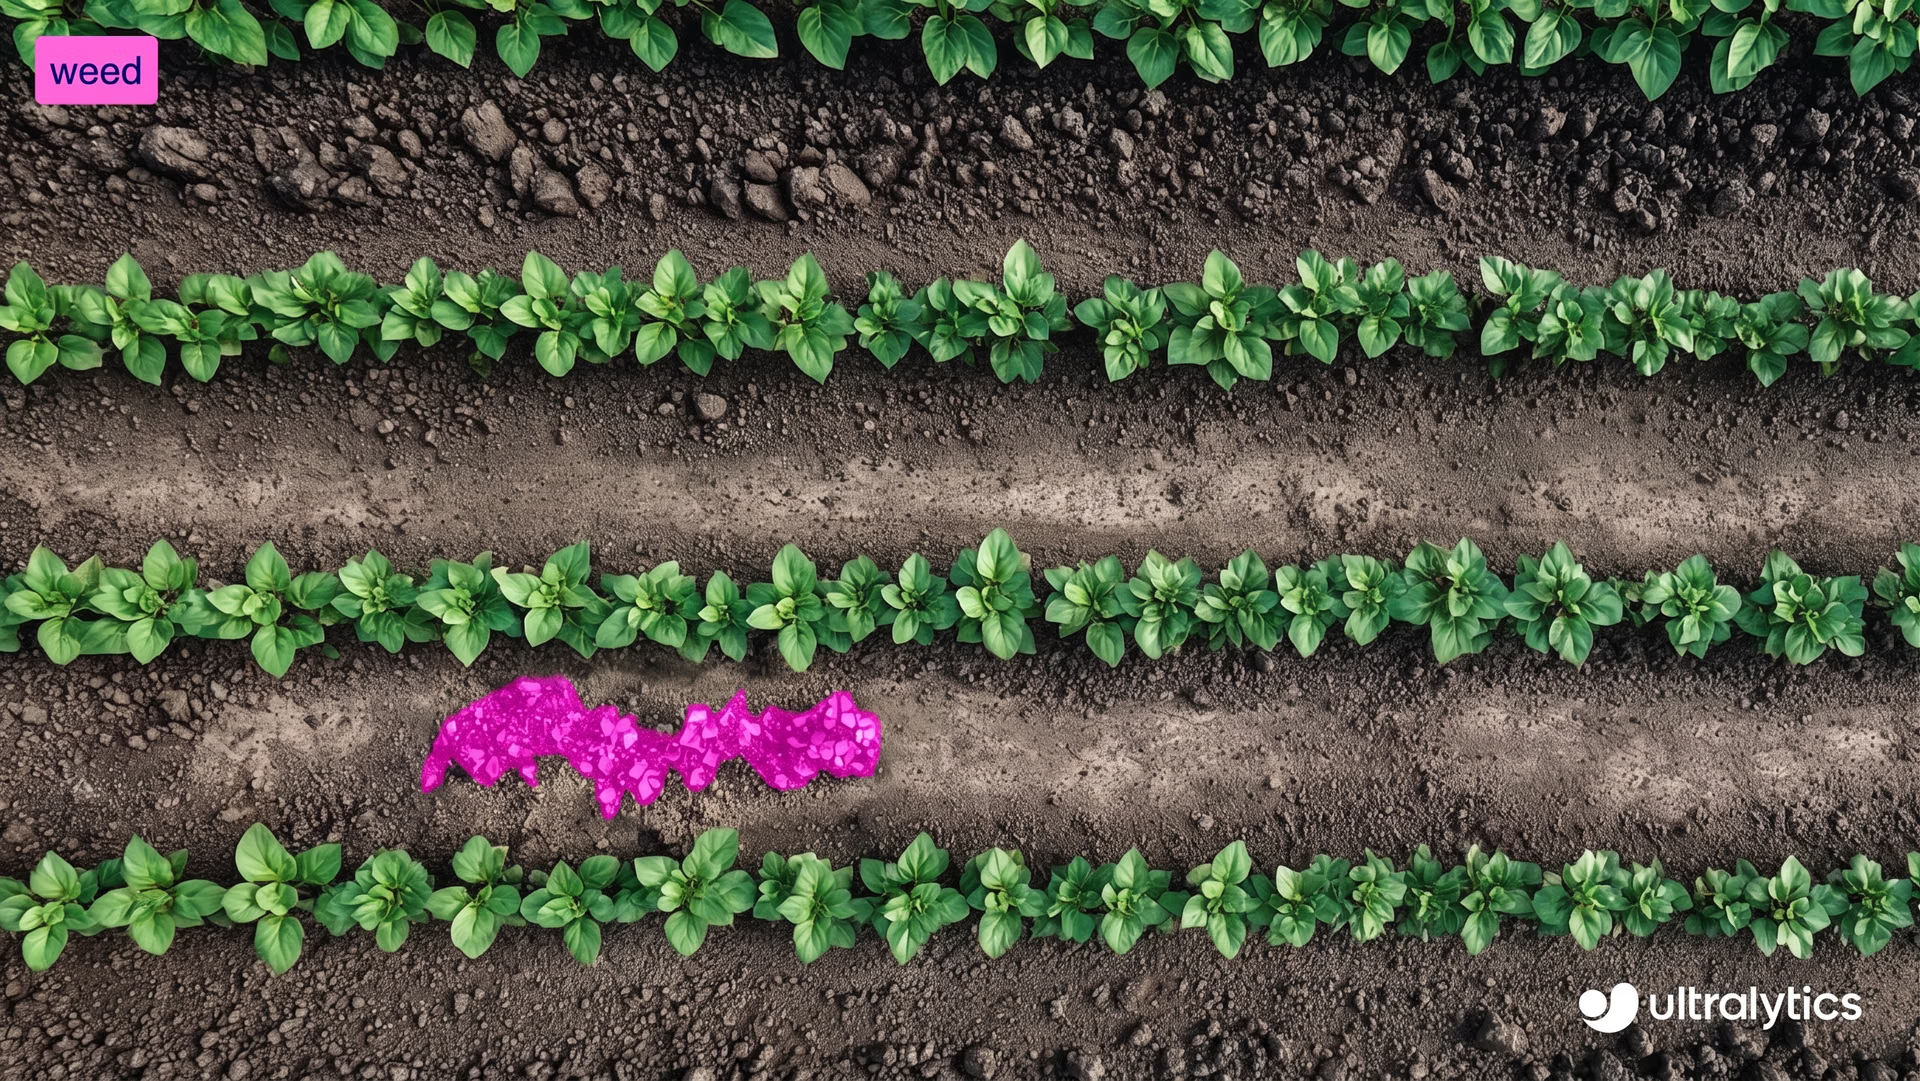
図4. Ultralytics YOLO26は、ドローンなどのエッジデバイスに簡単にデプロイできます。
つまり、NMS不要の推論は、エクスポートとデプロイの障壁を取り除き、よりシンプルで信頼性の高いビジョンシステムを実現します。NMSは回避策でした。Ultralytics YOLO26では、もはや回避策は必要ありません。
重要なポイント#
Ultralytics YOLO26は、重複検出を後から整理するのではなく、その根本的な問題を解決することで、非最大値抑制を取り除けます。エンドツーエンド設計により、モデルが最終的な検出結果を直接出力できるため、さまざまなハードウェアでのエクスポートとデプロイがより簡単かつ一貫性のあるものになります。NMSは以前のシステムで有用な回避策でしたが、YOLO26では不要です。
コミュニティに参加し、GitHubリポジトリを確認して、AIについてさらに学びましょう。農業におけるAIと小売業におけるコンピュータービジョンに関するソリューションのページをご覧ください。ライセンスオプションを確認して、今日からビジョンAIを始めましょう。
執筆者
コメント
質問したり、結果を共有したり、ほかの人をサポートしたりできます。









