Melhores modelos de detecção de objetos
Explora os melhores modelos de detecção de objetos de 2026, do Ultralytics YOLO ao RT-DETR, com comparações entre arquiteturas, compromissos de desempenho e fatores de implantação.
 Abirami Vina14 min de leitura
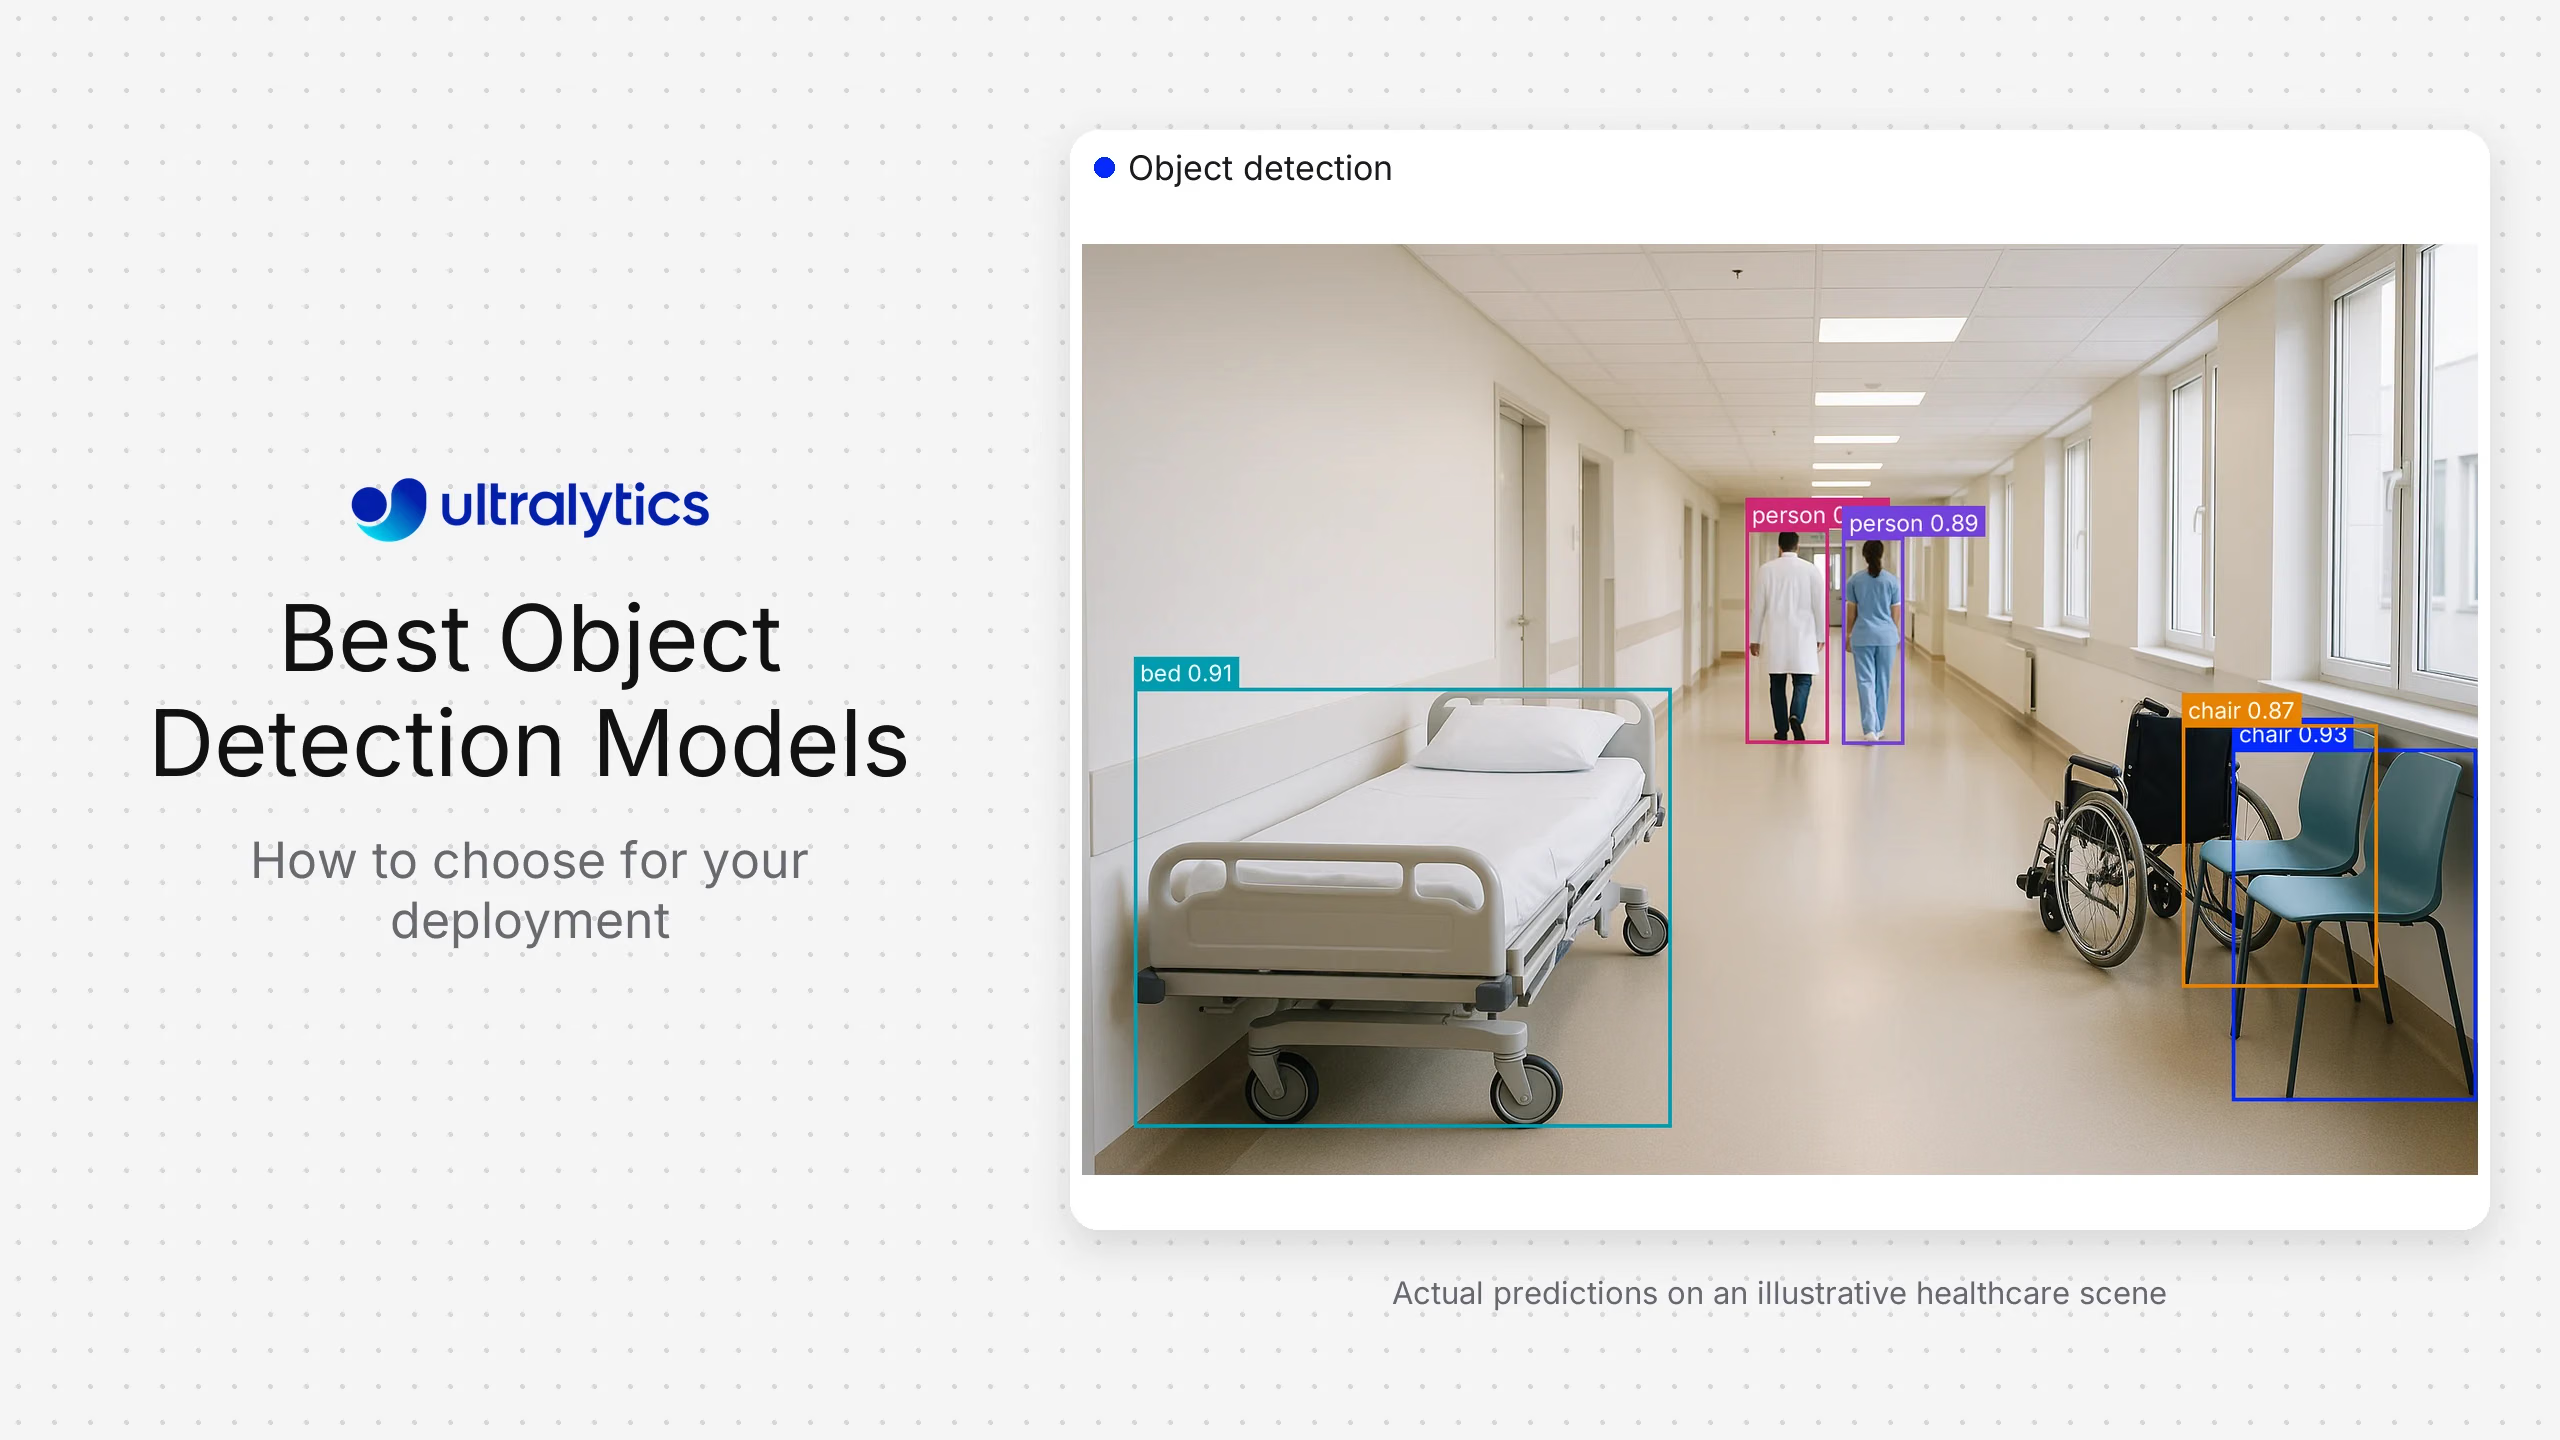
No início deste ano, Andrew Ng, pioneiro em IA e aprendizado de máquina, apresentou o conceito de detecção agentiva de objetos. Essa abordagem usa um agente de raciocínio para detectar objetos com base em uma solicitação de texto, sem exigir grandes volumes de dados de treinamento.
A capacidade de identificar objetos em imagens e vídeos sem precisar de enormes conjuntos de dados rotulados é um passo rumo a sistemas de visão computacional mais inteligentes e flexíveis. No entanto, a IA de visão agentiva ainda está nos estágios iniciais.
Embora possa lidar com tarefas gerais, como detectar pessoas ou placas de trânsito em uma imagem, aplicações mais precisas de visão computacional ainda dependem de modelos tradicionais de detecção de objetos. Esses modelos são treinados com grandes conjuntos de dados cuidadosamente rotulados para aprender exatamente o que procurar e onde os objetos estão localizados.
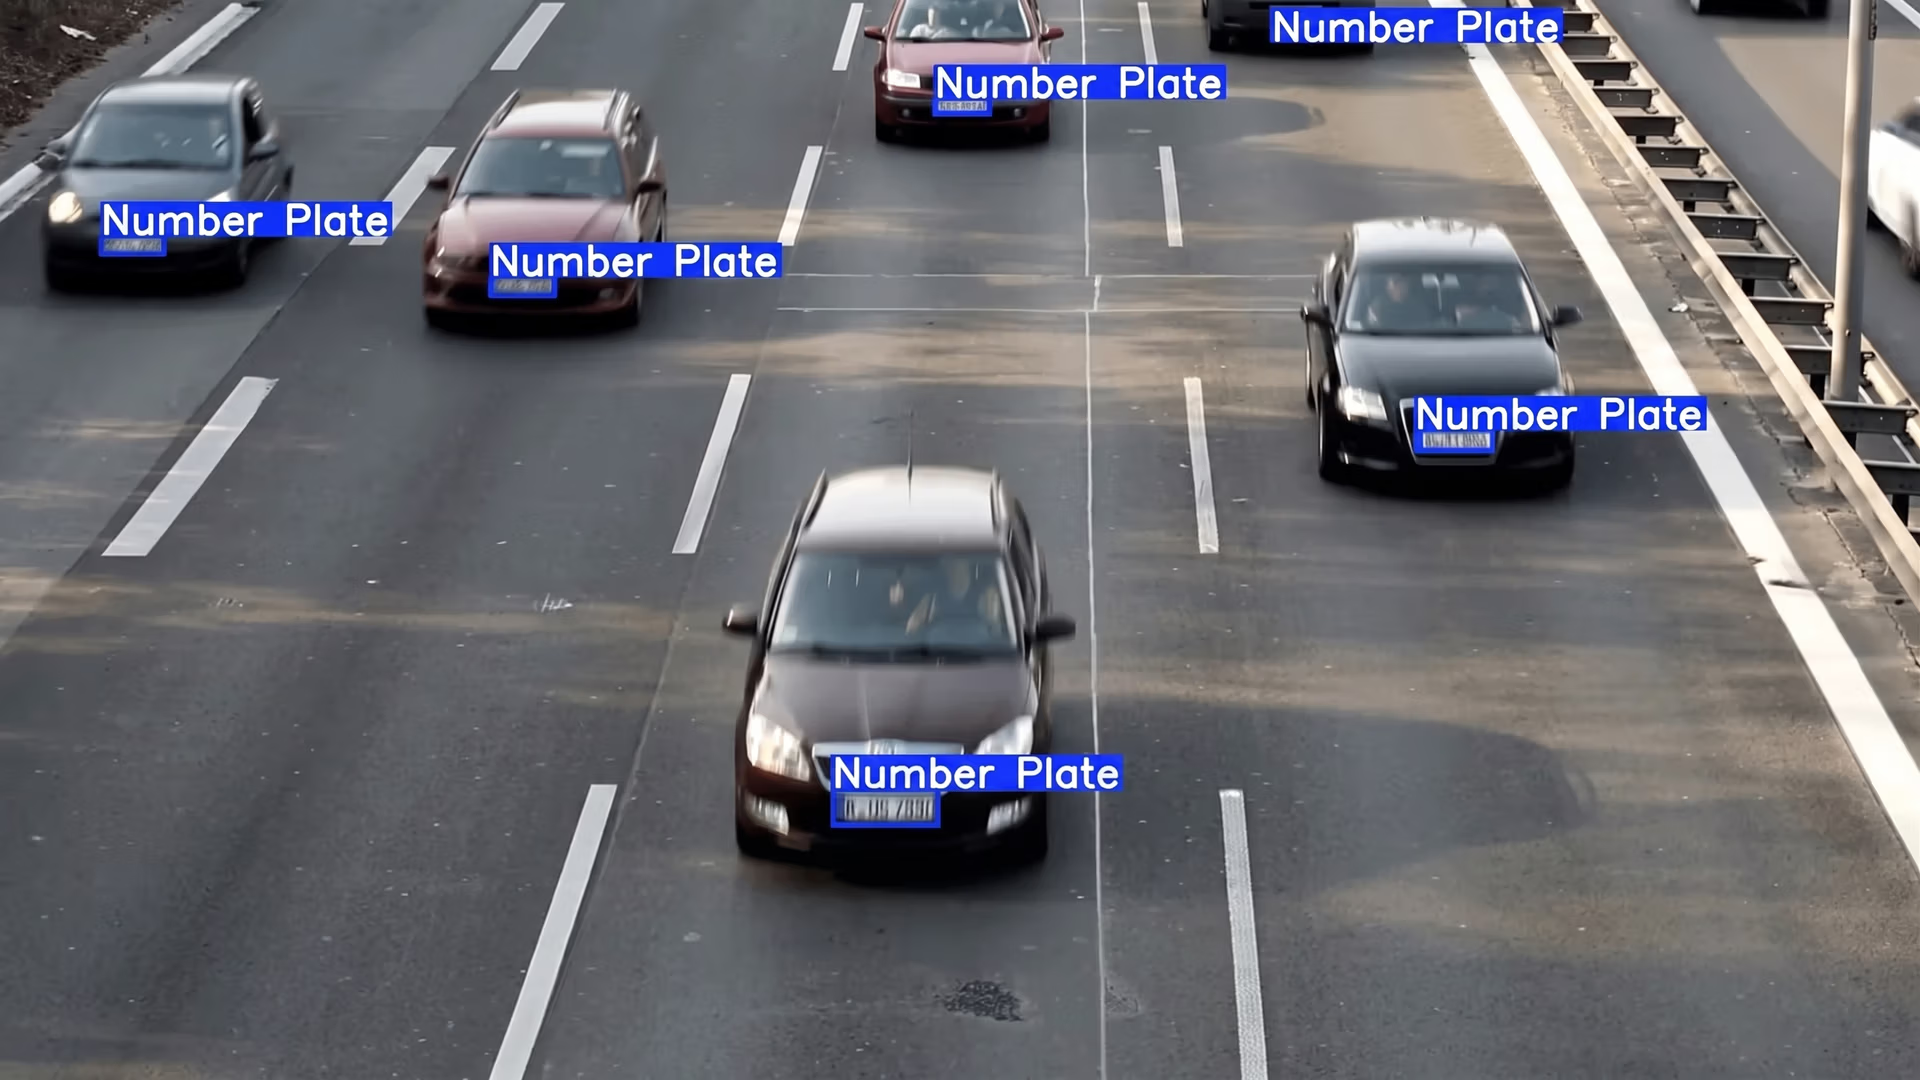
Fig. 1. Exemplo de detecção de objetos. (Fonte)
A detecção de objetos tradicional é essencial porque oferece tanto o reconhecimento, que identifica o objeto, quanto a localização, que determina exatamente onde ele está na imagem. Essa combinação permite que as máquinas realizem tarefas complexas do mundo real com confiabilidade, desde veículos autônomos até automação industrial e diagnósticos na área da saúde.
Os modelos de detecção de objetos continuam melhorando: ficam mais rápidos, mais precisos e mais adequados a ambientes reais. Neste artigo, vamos apresentar alguns dos melhores modelos de detecção de objetos disponíveis atualmente.
A necessidade da detecção de objetos#
Tarefas de visão computacional, como a classificação de imagens, podem ser usadas para determinar se uma imagem contém um carro, uma pessoa ou outro objeto. No entanto, elas não conseguem determinar onde o objeto está localizado na imagem.
É aí que entra a detecção de objetos. Os modelos de detecção de objetos conseguem identificar quais objetos estão presentes e também indicar suas localizações exatas. Esse processo, conhecido como localização, permite que as máquinas compreendam as cenas com mais precisão e reajam adequadamente, seja parando um carro autônomo, orientando o braço de um robô ou destacando uma área em imagens médicas.
O surgimento do aprendizado profundo transformou a detecção de objetos. Em vez de depender de regras escritas manualmente, os modelos modernos aprendem padrões diretamente de anotações e dados visuais. Esses conjuntos de dados ensinam aos modelos a aparência dos objetos, onde eles costumam aparecer e como lidar com desafios como objetos pequenos, cenas com muitos elementos ou condições de iluminação variáveis.
Na verdade, sistemas de detecção de objetos de última geração conseguem detectar vários objetos ao mesmo tempo com precisão. Isso faz da detecção de objetos uma tecnologia essencial em aplicações como direção autônoma, robótica, saúde e automação industrial.
Como funcionam as tarefas de detecção de objetos#
A entrada de um modelo de detecção de objetos é uma imagem, que pode vir de uma câmera, de um quadro de vídeo ou até mesmo de um exame médico. A imagem de entrada é processada por uma rede neural, normalmente uma rede neural convolucional (CNN), treinada para reconhecer padrões em dados visuais.
Dentro da rede, a imagem é analisada em etapas. Com base nas características que detecta, o modelo prevê quais objetos estão presentes e onde aparecem.
Essas previsões são representadas por caixas delimitadoras, que são retângulos desenhados ao redor de cada objeto detectado. Para cada caixa delimitadora, o modelo atribui um rótulo de classe (por exemplo, carro, pessoa ou cachorro) e uma pontuação de confiança que indica o quanto ele confia na previsão (também é possível interpretar essa pontuação como uma probabilidade).
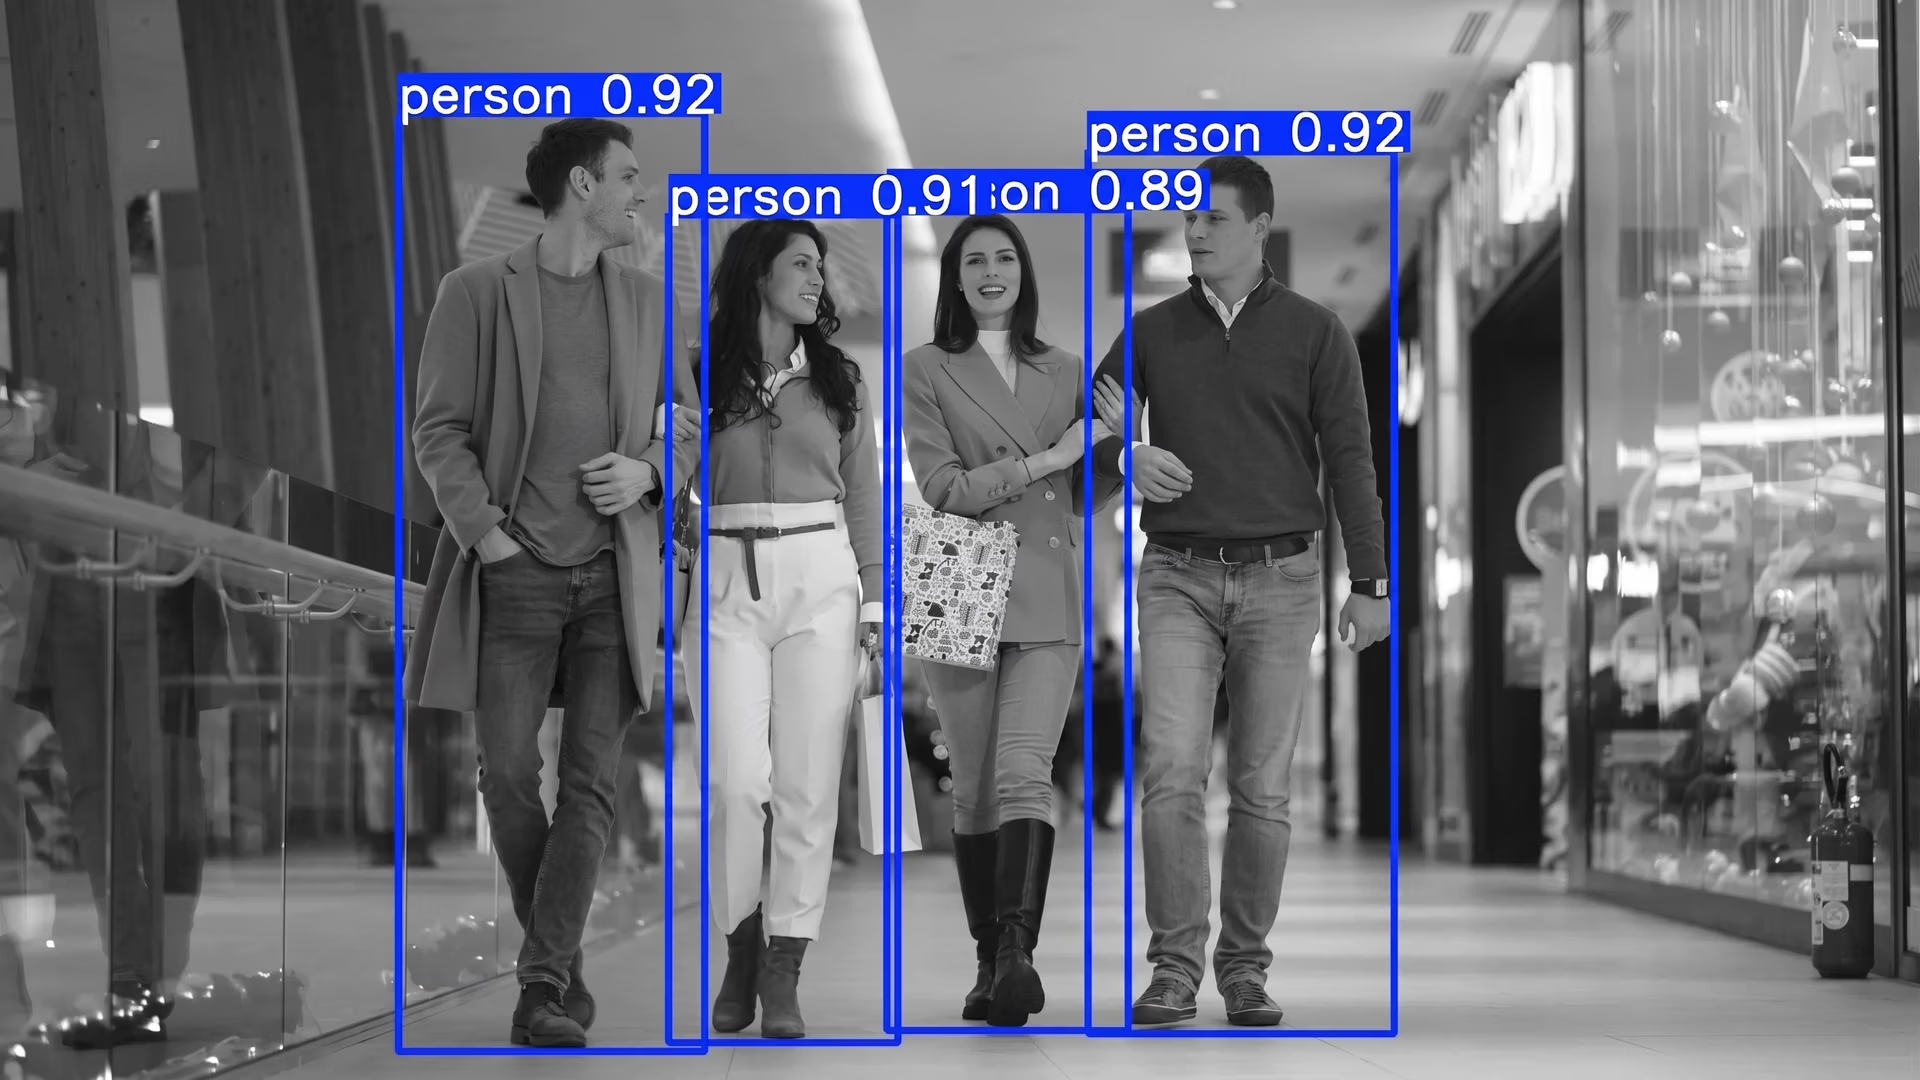
Fig. 2. As previsões de detecção de objetos podem ser visualizadas com caixas delimitadoras.
O processo como um todo depende muito da extração de características. O modelo aprende a identificar padrões visuais úteis, como bordas, formas, texturas e outras características distintivas. Esses padrões são codificados em mapas de características, que ajudam a rede a compreender a imagem em vários níveis de detalhe.
Detecção de objetos: em duas etapas e em uma etapa#
Dependendo da arquitetura do modelo, os detectores de objetos usam diferentes estratégias para localizar objetos, equilibrando velocidade, precisão e complexidade.
Muitos modelos de detecção de objetos, especialmente os detectores em duas etapas, como o Faster R-CNN, concentram-se em partes específicas da imagem chamadas regiões de interesse (ROIs). Ao focar nessas áreas, o modelo prioriza as regiões com maior probabilidade de conter objetos, em vez de analisar todos os pixels igualmente.
Por outro lado, os modelos de uma etapa, como os primeiros modelos YOLO, não selecionam ROIs específicas como os modelos de duas etapas. Em vez disso, dividem a imagem em uma grade e usam caixas predefinidas, chamadas caixas âncora, junto com mapas de características para prever objetos em toda a imagem em uma única passagem.
Muitos modelos modernos de detecção de objetos, incluindo os modelos Ultralytics YOLO mais recentes, usam abordagens sem âncoras. Ao contrário dos modelos tradicionais de estágio único, que dependem de caixas-âncora predefinidas, os modelos sem âncoras preveem diretamente a localização e o tamanho dos objetos a partir dos mapas de características. Isso pode simplificar a arquitetura, reduzir a sobrecarga computacional e melhorar o desempenho, principalmente na detecção de objetos de diferentes formas e tamanhos.
Conheça os melhores modelos de detecção de objetos#
Hoje, há muitos modelos de detecção de objetos, cada um criado com objetivos específicos. Alguns são otimizados para desempenho em tempo real, enquanto outros priorizam a maior precisão possível. A escolha do modelo certo para uma solução de visão computacional geralmente depende do seu caso de uso específico e dos requisitos de desempenho.
A seguir, vamos conhecer alguns dos melhores modelos de detecção de objetos de 2026.
1. Modelos Ultralytics YOLO#
Uma das famílias de modelos de deteção de objetos mais utilizadas atualmente é a família de modelos Ultralytics YOLO. YOLO, sigla de You Only Look Once, é popular em vários setores porque oferece um excelente desempenho de deteção, além de ser rápido, fiável e fácil de utilizar.
A família Ultralytics YOLO inclui o Ultralytics YOLOv5, o Ultralytics YOLOv8, o Ultralytics YOLO11 e o mais recente Ultralytics YOLO26, oferecendo várias opções para atender a diferentes requisitos de desempenho e casos de uso. Graças ao design leve e à otimização de velocidade, os modelos Ultralytics YOLO são ideais para detecção em tempo real e podem ser implantados em dispositivos de borda com poder computacional e memória limitados.
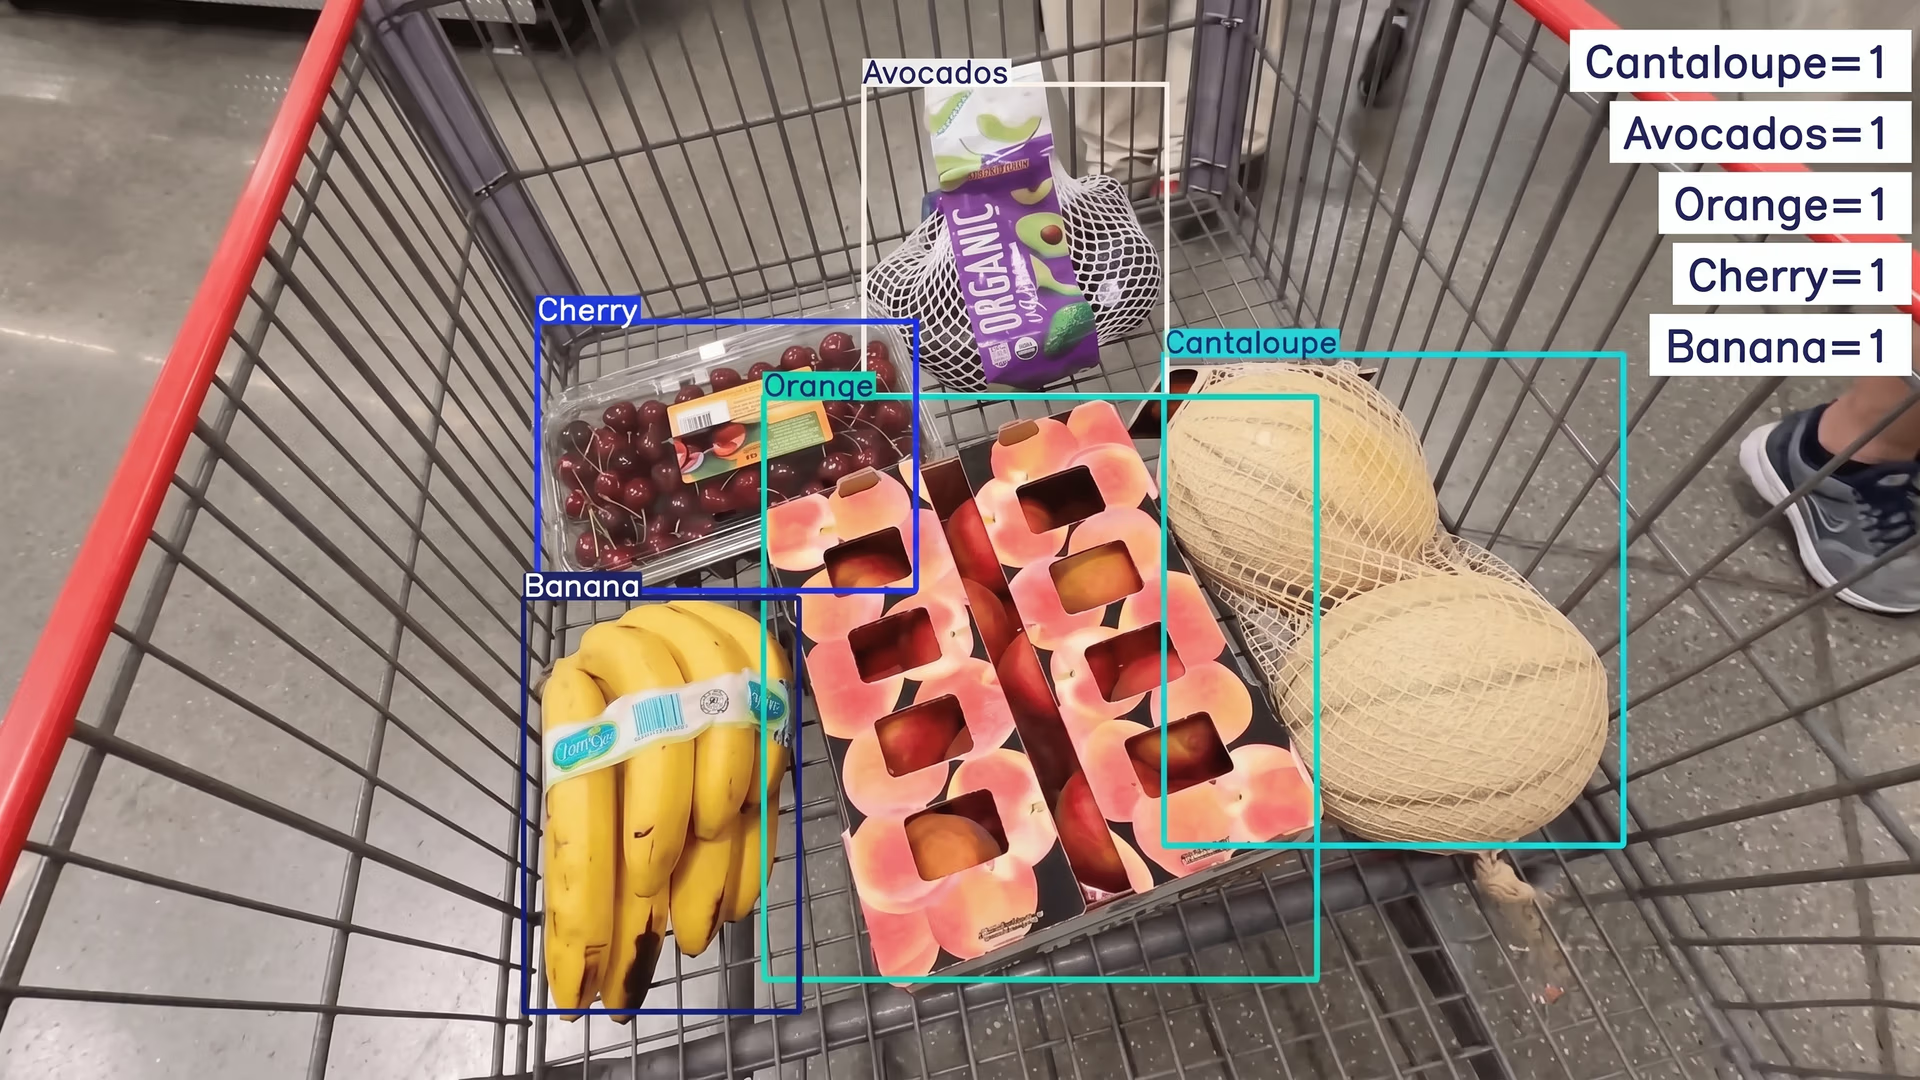
Fig. 3. Utilização do Ultralytics YOLO11 para deteção de objetos (Fonte)
Para além da deteção básica de objetos, estes modelos são muito versáteis. Também suportam tarefas como a segmentação de instâncias, que contorna objetos ao nível dos píxeis, e a estimativa de pose, que identifica pontos-chave em pessoas ou objetos. Esta flexibilidade faz dos modelos Ultralytics YOLO uma opção de eleição para uma vasta gama de aplicações, da agricultura e logística ao retalho e à indústria transformadora.
Outro motivo importante para a popularidade dos modelos Ultralytics YOLO é o pacote Python da Ultralytics, que oferece uma interface simples e intuitiva para treinar, ajustar e implantar modelos. Os desenvolvedores podem começar com pesos pré-treinados, personalizar os modelos para seus próprios conjuntos de dados e implantá-los com apenas algumas linhas de código.
2. RT-DETR e RT-DETRv2#
O RT‑DETR (Transformador de detecção em tempo real) e o RT‑DETRv2, mais recente, são modelos de detecção de objetos criados para uso em tempo real. Ao contrário de muitos modelos tradicionais, eles recebem uma imagem e geram diretamente as detecções finais, sem usar supressão não máxima (NMS).
A NMS é uma etapa que remove caixas sobrepostas redundantes quando um modelo prevê o mesmo objeto mais do que uma vez. Ao ignorar a NMS, o processo de deteção torna-se mais simples e rápido.
Estes modelos combinam CNNs com transformers. A CNN identifica detalhes visuais, como arestas e formas, enquanto o transformer é um tipo de rede neuronal que consegue analisar a imagem inteira de uma só vez e compreender a relação entre as diferentes partes. Esta compreensão abrangente permite ao modelo detetar objetos próximos uns dos outros ou sobrepostos.
O RT‑DETRv2 melhora o modelo original com funcionalidades como a deteção multiescala, que ajuda a encontrar objetos pequenos e grandes, e um melhor tratamento de cenas complexas. Estas alterações mantêm o modelo rápido e melhoram a precisão.
3. RF-DETR#
O RF‑DETR é um modelo em tempo real baseado em transformer, concebido para combinar a precisão das arquiteturas transformer com a velocidade necessária para aplicações do mundo real. Tal como o RT‑DETR e o RT‑DETRv2, utiliza um transformer para analisar a imagem inteira e uma CNN para extrair características visuais detalhadas, como arestas, formas e texturas.
O modelo prevê objetos diretamente a partir da imagem de entrada, dispensando caixas âncora e a supressão não máxima, o que simplifica o processo de deteção e mantém a inferência rápida. O RF‑DETR também suporta a segmentação de instâncias, permitindo-lhe contornar objetos ao nível dos píxeis, além de prever caixas delimitadoras.
4. EfficientDet#
Lançado no fim de 2019, o EfficientDet é um modelo de detecção de objetos projetado para oferecer escalabilidade eficiente e alto desempenho. O que diferencia o EfficientDet é a escalabilidade composta, um método que ajusta simultaneamente a resolução de entrada, a profundidade da rede e a largura da rede, em vez de alterar apenas um fator. Essa abordagem ajuda o modelo a manter uma precisão estável, tanto quando ampliado para tarefas de alto desempenho quanto quando reduzido para implantações leves.
Outro componente essencial do EfficientDet é a sua rede piramidal de características eficiente (FPN), que permite ao modelo analisar imagens em várias escalas. Esta análise multiescala é crucial para detetar objetos de diferentes dimensões, permitindo ao EfficientDet identificar de forma fiável objetos pequenos e grandes na mesma imagem.
5. PP-YOLOE+#
Lançado em 2022, o PP-YOLOE+ é um modelo de detecção de objetos no estilo YOLO, ou seja, detecta e classifica objetos em uma única passagem pela imagem. Essa abordagem o torna rápido e adequado para aplicações em tempo real, sem comprometer a alta precisão.
Uma das principais melhorias do PP-YOLOE+ é a aprendizagem alinhada com a tarefa, que ajuda a garantir que as pontuações de confiança do modelo refletem a precisão com que os objetos são localizados. Isto é particularmente útil para detetar objetos pequenos ou sobrepostos.
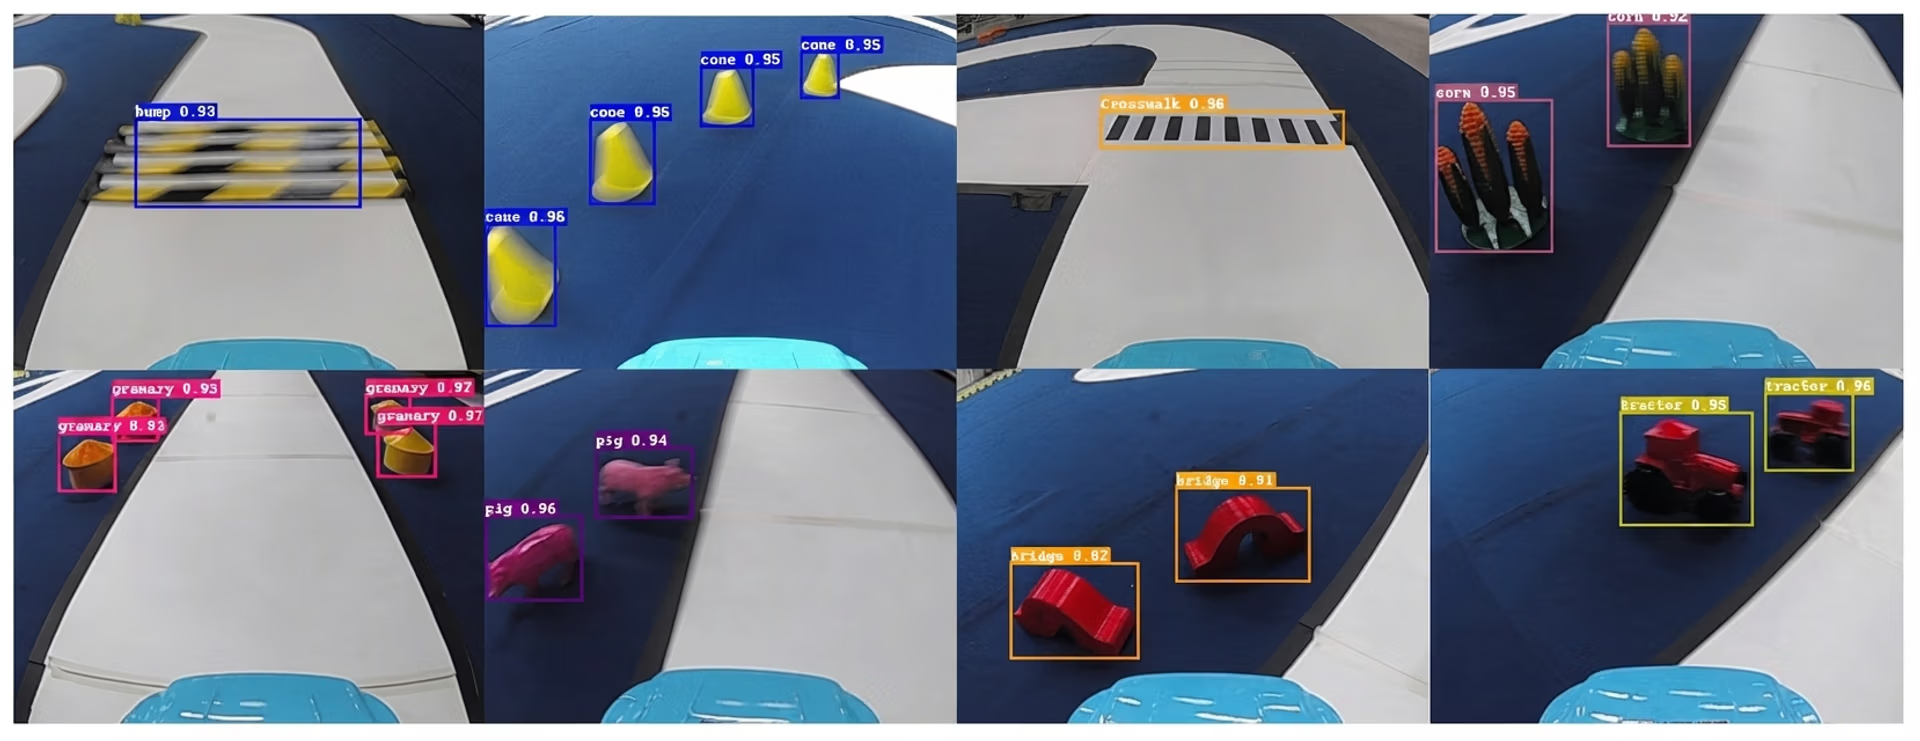
Fig. 4. Deteção de objetos com PP-YOLOE+ (Fonte)
O modelo também utiliza uma arquitetura de cabeça desacoplada, que separa as tarefas de previsão da localização dos objetos e dos rótulos de classe. Isto permite-lhe desenhar caixas delimitadoras com maior precisão e classificar corretamente os objetos.
6. GroundingDINO#
GroundingDINO é um modelo de detecção de objetos baseado em Transformer que combina visão e linguagem. Em vez de depender de um conjunto fixo de categorias, ele permite que os usuários detectem objetos usando prompts de texto em linguagem natural.
Ao alinhar características visuais de uma imagem a descrições de texto, o modelo consegue localizar objetos mesmo que esses rótulos exatos não estivessem nos dados de treinamento. Isso significa que você pode solicitar ao modelo descrições como “uma pessoa usando um capacete” ou “um carro vermelho perto de um prédio”, e ele desenhará caixas delimitadoras em torno dos objetos correspondentes.
Além disso, ao oferecer suporte à detecção zero-shot, o GroundingDINO reduz a necessidade de retreinar ou ajustar o modelo para cada novo caso de uso, tornando-o flexível para uma ampla variedade de aplicações. Para ver como ele se compara a outros detectores de vocabulário aberto e modelos de linguagem e visão em conjuntos de dados reais, confira o ranking de VLMs.
Métricas comuns para avaliar detetores de objetos#
Ao comparares vários modelos de deteção de objetos, podes perguntar-te como determinar qual deles tem realmente o melhor desempenho. É uma boa pergunta, porque, além da arquitetura do modelo e da qualidade dos dados, muitos fatores podem afetar o desempenho.
Os investigadores recorrem frequentemente a benchmarks partilhados e a métricas de desempenho padrão para avaliar modelos de forma consistente, comparar resultados e compreender as compensações entre velocidade e precisão. Os benchmarks padrão são especialmente importantes porque muitos modelos de deteção de objetos são avaliados nos mesmos conjuntos de dados, como o conjunto de dados COCO.
Medir a precisão e a velocidade da deteção#
Eis algumas das métricas comuns utilizadas para avaliar modelos de deteção de objetos:
- Interseção sobre união (IoU): Essa métrica mede quanto uma caixa delimitadora prevista se sobrepõe ao objeto real em uma imagem. Ela compara a caixa desenhada pelo modelo com a caixa de referência, que corresponde à localização do objeto conforme anotada no conjunto de dados. O IoU é calculado dividindo a área de sobreposição pela área da união das duas caixas. Um IoU mais alto indica que o modelo posicionou a caixa com mais precisão, enquanto um IoU mais baixo significa que a previsão é menos precisa. Em termos simples, o IoU mostra o quanto as previsões do modelo correspondem às localizações reais dos objetos.
- Precisão média média (mAP): É a principal métrica utilizada para avaliar o desempenho geral na deteção de objetos. Tem em conta tanto o número de objetos detetados corretamente pelo modelo como a precisão dessas deteções para diferentes níveis de confiança e categorias de objetos.
- Fotogramas por segundo (FPS) e latência: o FPS indica quantas imagens ou fotogramas de vídeo um modelo consegue processar num segundo. Por exemplo, um modelo que funciona a 30 FPS consegue processar 30 fotogramas por segundo. Um FPS mais elevado significa que o sistema pode responder mais rapidamente, o que é importante em casos de utilização como vídeo em direto, monitorização do trânsito ou robótica. A latência, por sua vez, mede o tempo que o modelo demora a processar uma única imagem ou fotograma, desde o momento em que é recebido até o resultado estar pronto.
Vantagens e desvantagens da utilização de algoritmos de deteção de objetos#
Eis algumas das principais vantagens da utilização de modelos de deteção de objetos em aplicações do mundo real:
- Aplicáveis a vários setores: A deteção de objetos pode ser aplicada a uma vasta gama de casos de utilização, desde a monitorização do trânsito e a análise do retalho até aos cuidados de saúde, à agricultura e à indústria transformadora.
- Reduzem o trabalho manual: A automatização de tarefas de inspeção visual e monitorização reduz a necessidade de supervisão humana constante e ajuda as equipas a concentrarem-se em trabalho de maior valor.
- Beneficiam de ecossistemas de código aberto: As comunidades ativas e os recursos de código aberto no GitHub facilitam o acesso a modelos pré-treinados, a experimentação e a personalização de soluções.
Apesar destas vantagens, existem limitações práticas que podem afetar o desempenho dos modelos de deteção de objetos. Eis alguns fatores importantes a considerar:
- Requisitos de dados de elevada qualidade: Os modelos de deteção de objetos dependem de conjuntos de dados de treino grandes e bem anotados. A criação e manutenção destes dados pode exigir muito tempo, ser dispendiosa e difícil de escalar.
- Exigências computacionais: Os modelos que oferecem maior precisão de deteção exigem frequentemente uma capacidade de processamento significativa, tanto durante o treino como na implementação em tempo real. Normalmente, isto implica utilizar GPUs de elevado desempenho, o que pode aumentar os custos de infraestrutura.
- Sensibilidade às condições do mundo real: Variações na iluminação, nos ângulos da câmara, nas condições meteorológicas e em cenas com muita gente podem afetar o desempenho da deteção, tornando necessários testes e ajustes contínuos.
Principais conclusões#
O melhor modelo de deteção de objetos para o teu projeto de visão por computador depende do teu caso de utilização, da configuração dos dados, dos requisitos de desempenho e das limitações do hardware. Alguns modelos são otimizados para a velocidade, enquanto outros se concentram na precisão, e a maioria das aplicações do mundo real precisa de um equilíbrio entre ambas. Graças às frameworks de código aberto e às comunidades ativas no GitHub, está cada vez mais fácil avaliar, adaptar e implementar estes modelos para utilização prática.
Para saberes mais, explora o nosso repositório do GitHub. Junta-te à nossa comunidade e consulta as páginas das nossas soluções para conheceres aplicações como a IA nos cuidados de saúde e a visão por computador no setor automóvel. Descobre as nossas opções de licenciamento para começares hoje a utilizar IA visual.
Escrito por
Criador de conteúdo · Ultralytics
Comentários
Faça uma pergunta, compartilhe seus resultados ou ajude alguém.









