Como escolher uma GPU na nuvem para treinar IA visual na Ultralytics Platform
Saiba como escolher a GPU na nuvem certa para treinar modelos de visão computacional na Ultralytics Platform, considerando fatores como tamanho do conjunto de dados, complexidade do modelo e custo.
No mês passado, apresentamos a Ultralytics Platform, um ambiente ponta a ponta projetado para simplificar todo o fluxo de trabalho de visão computacional, do gerenciamento de conjuntos de dados ao treinamento e à implantação de modelos. A Ultralytics Platform reúne tudo o que é necessário para criar e dimensionar modelos de IA de visão em uma experiência única e unificada.
Uma parte fundamental desse fluxo de trabalho é o treinamento de modelos, no qual as redes neurais aprendem padrões a partir dos dados para fazer previsões precisas; o acesso aos recursos computacionais adequados tem um papel crucial. Anteriormente, exploramos como a Ultralytics Platform oferece suporte ao treinamento de modelos na nuvem com unidades de processamento gráfico (GPU), permitindo que os usuários treinem modelos de visão computacional sem gerenciar a infraestrutura local.
Com acesso sob demanda a GPUs NVIDIA potentes, usuários que vão de estudantes e startups a pesquisadores e grandes organizações podem executar cargas de trabalho de IA com mais eficiência do que nunca. Embora começar a treinar na nuvem seja simples, escolher a GPU certa exige considerar fatores como o tamanho do conjunto de dados, a complexidade do modelo e o custo.
Com a ampla variedade de opções disponíveis hoje — de GPUs RTX econômicas ao hardware de alto desempenho NVIDIA H100 e à próxima geração de hardware Blackwell —, selecionar a configuração certa pode afetar significativamente tanto o desenvolvimento do modelo quanto o custo.
Neste artigo, vamos conhecer o treinamento em nuvem com GPU para visão computacional na Ultralytics Platform e como escolher o hardware adequado para sua carga de trabalho. Vamos começar!
Visão geral do treinamento na nuvem na Ultralytics Platform#
Antes de nos aprofundarmos em como selecionar uma GPU para treinamento na nuvem na Ultralytics Platform, vamos dar um passo atrás e entender como funciona o treinamento na nuvem.
O que é treinamento na nuvem com GPU?#
O treinamento na nuvem com GPU consiste em usar GPUs hospedadas em um ambiente de computação em nuvem para treinar modelos de aprendizado de máquina e aprendizado profundo, em vez de depender do seu próprio hardware local ou estação de trabalho. Na Ultralytics Platform, isso permite acessar GPUs potentes sob demanda e executar tarefas de treinamento remotamente, sem precisar configurar seu próprio ambiente.
Isso facilita o dimensionamento dos recursos de acordo com sua carga de trabalho. Você pode escolher GPUs mais potentes ou aumentar a capacidade conforme necessário, sem ficar limitado pelos recursos do seu sistema. Pense nisso como acessar máquinas potentes, ou nós, em centros de dados remotos, cuja capacidade pode ser aumentada ou reduzida conforme necessário.
Isso também elimina a necessidade de configurar e manter hardware caro. Você não precisa comprar GPUs, instalar drivers nem lidar com problemas de compatibilidade.
A Ultralytics Platform gerencia tudo por meio de serviços de nuvem gerenciados, desde o provisionamento de recursos até a configuração do ambiente, a orquestração e a execução de tarefas de treinamento, para que você possa se concentrar em treinar, experimentar e aprimorar seus modelos.
Como funciona o treinamento de modelos na Ultralytics Platform#
Na Ultralytics Platform, o fluxo de trabalho de treinamento acelerado por GPU é simples. Você pode começar adicionando seu conjunto de dados de várias maneiras.
Você pode enviar seus próprios dados, usar conjuntos de dados públicos disponíveis na plataforma ou clonar conjuntos de dados compartilhados pela comunidade para aproveitar trabalhos existentes. Ao clonar um conjunto de dados, você cria uma cópia no seu espaço de trabalho, que pode editar e expandir sem alterar o original.
Depois de selecionar um conjunto de dados, você pode revisar e organizar suas imagens e anotações para garantir que tudo esteja estruturado corretamente. A plataforma também inclui ferramentas de anotação integradas, permitindo rotular dados para tarefas como detecção de objetos, segmentação e classificação, ou acelerar o processo com recursos assistidos por IA.
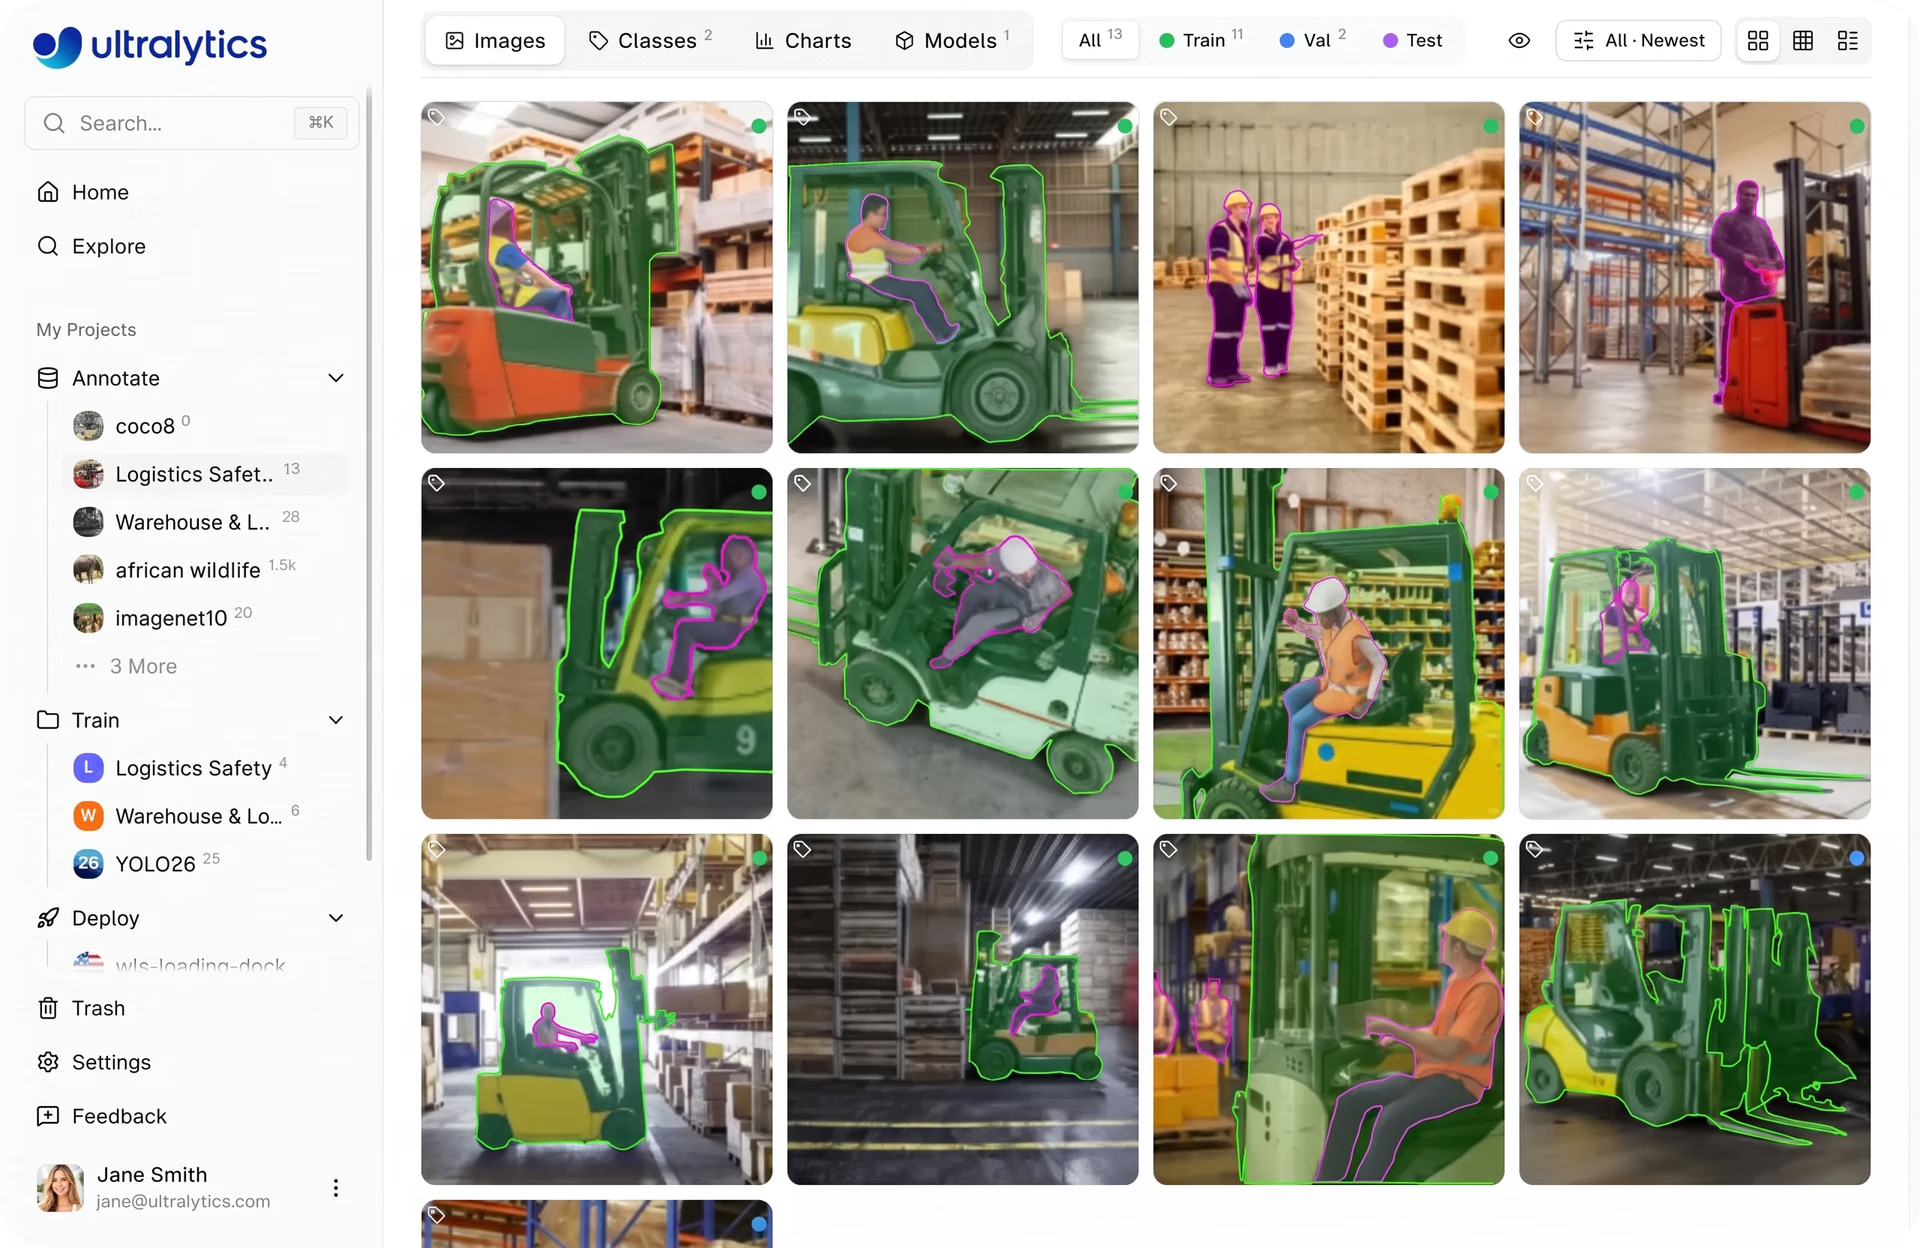
Fig. 1. Visualização de um conjunto de dados na Ultralytics Platform (Fonte)
Em seguida, você pode selecionar ou criar um projeto para gerenciar suas execuções de treinamento. Os projetos ajudam a organizar e comparar modelos, acompanhar métricas de desempenho e manter experimentos relacionados em um só lugar.
A partir daí, você pode acessar o treinamento na nuvem, onde escolhe um modelo, configura os parâmetros e seleciona uma GPU de acordo com suas necessidades de desempenho e orçamento. A plataforma gerencia a infraestrutura de nuvem subjacente para você.
A plataforma provisiona a instância de GPU selecionada, prepara seu conjunto de dados e executa a tarefa de treinamento na nuvem. À medida que o treinamento avança, você pode acompanhar métricas, registros e o desempenho do sistema em tempo real, sem precisar gerenciar a configuração, os ambientes CUDA, frameworks como PyTorch ou TensorFlow, nem o hardware.
Principais recursos de treinamento com GPU na Ultralytics Platform#
Veja alguns dos principais recursos do treinamento na nuvem com GPU na Ultralytics Platform:
- Treinamento com um clique: inicie tarefas de treinamento com o mínimo de configuração e passe rapidamente do conjunto de dados ao treinamento do modelo, sem configurações complexas.
- GPUs sob demanda: escolha entre várias opções de GPU de acordo com suas necessidades e dimensione os recursos conforme necessário, sem compromissos de longo prazo.
- Monitoramento em tempo real: acompanhe o progresso do treinamento com gráficos e registros ao vivo e veja métricas do sistema, como uso da GPU e memória, em tempo real.
- Pontos de verificação automáticos: o progresso do treinamento é salvo em intervalos regulares, facilitando a retomada ou recuperação do trabalho, se necessário.
- Implantação fácil: quando o treinamento estiver concluído, você poderá implantar seus modelos treinados e usá-los em aplicações ou fluxos de trabalho por meio de APIs de inferência compartilhadas, endpoints dedicados ou exportando-os para uso em sistemas externos. Essas opções de implantação permitem inferência com baixa latência, possibilitando aplicações em tempo real, como análise de vídeo, sistemas de automação e soluções interativas de IA.
Diferentes opções de GPU na Ultralytics Platform#
Agora que vimos como funciona o treinamento na plataforma, vamos conhecer as diferentes opções de GPU disponíveis. A GPU escolhida pode afetar a velocidade do treinamento do modelo, seu desempenho e o custo.
A Ultralytics Platform oferece uma ampla variedade de GPUs, começando por opções como a RTX 2000 Ada e a RTX A4500, passando por GPUs como a RTX 4000 Ada, a RTX A5000, a RTX 3090 e a RTX A6000, e chegando a opções mais potentes, como a RTX 4090 e a RTX PRO 6000.
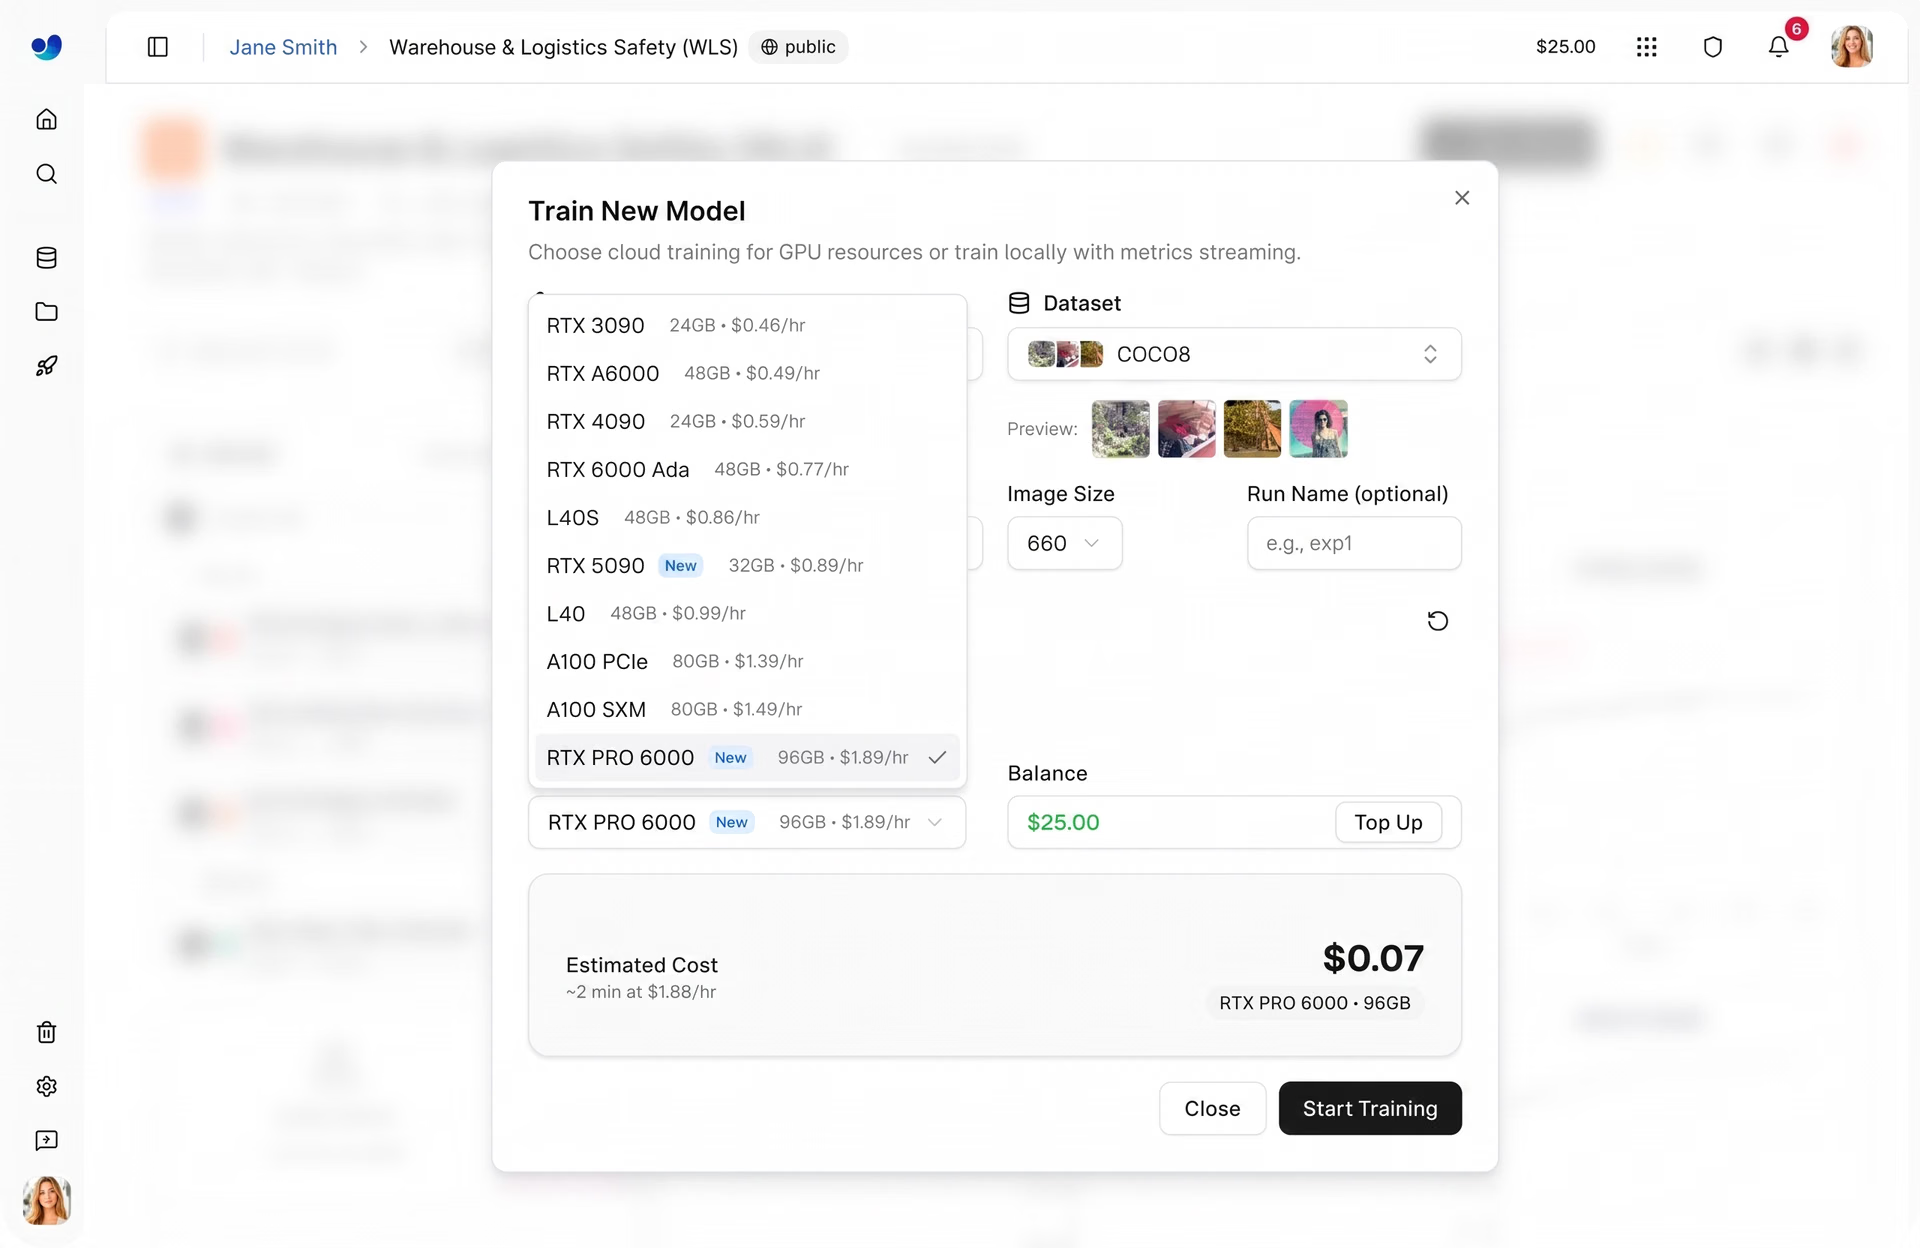
Fig. 2. Exemplo das diferentes opções de GPU compatíveis com a Ultralytics Platform (Fonte)
Para a maioria dos usuários, a RTX PRO 6000 é uma opção padrão equilibrada. Ela oferece desempenho confiável em uma variedade de cargas de trabalho sem exigir muitos ajustes. A RTX 4090 é outra opção popular, com ótimo desempenho pelo preço.
Para tarefas menores, como experimentos rápidos, prototipagem ou trabalho com conjuntos de dados leves, GPUs como a RTX 2000 Ada e a RTX A4500 são um bom ponto de partida. À medida que sua carga de trabalho cresce, opções como a RTX 4000 Ada, a RTX A5000 e a RTX 3090 oferecem desempenho mais consistente para treinamentos em geral.
Na categoria de alto desempenho, GPUs como a A100 (Ampere), a H100 e a H200 (Hopper) e a B200 (Blackwell) são desenvolvidas para cargas de trabalho em grande escala. Elas são mais indicadas para treinar modelos muito grandes, lidar com conjuntos de dados massivos ou executar tarefas em que velocidade e desempenho são fundamentais.
Entenda os diferentes tipos de GPU e seus casos de uso#
Em seguida, vamos ver como os diferentes tipos de GPU se comparam e para quais usos são mais indicados.
As GPUs RTX da NVIDIA geralmente são mais econômicas e são usadas com frequência em treinamentos do dia a dia, experimentação e cargas de trabalho de pequeno a médio porte. Elas equilibram desempenho e acessibilidade, o que as torna adequadas para uma ampla variedade de casos de uso.
Em comparação, GPUs como a A100, a A40 e a L40 são projetadas para cargas de trabalho mais pesadas e treinamentos em maior escala. Elas oferecem mais estabilidade e escalabilidade, especialmente ao trabalhar com conjuntos de dados maiores ou modelos mais complexos.
Na categoria de alto desempenho, GPUs como a H100 e as baseadas na arquitetura Blackwell da NVIDIA representam hardware de IA mais recente. Elas são projetadas para cargas de trabalho de alto desempenho e costumam ser usadas em treinamentos em grande escala, pesquisas avançadas ou tarefas com prazos críticos.
A variedade de opções de GPU disponíveis na Ultralytics Platform oferece flexibilidade para diferentes cargas de trabalho. De acordo com suas necessidades, você pode começar com configurações menores e ampliá-las conforme necessário.
Como escolher a GPU de nuvem certa para seu projeto#
Ao selecionar uma GPU para treinamento na nuvem na Ultralytics Platform, há vários fatores a considerar, como o tamanho do conjunto de dados, a complexidade do modelo e o custo. Vamos analisar cada um deles.
Como adequar a potência da GPU ao tamanho do conjunto de dados#
Um dos principais fatores para escolher uma GPU é o tamanho do conjunto de dados, pois ele afeta a duração do treinamento e a quantidade de recursos computacionais necessários.
Para conjuntos de dados pequenos, geralmente com menos de 1.000 imagens, uma GPU leve como a RTX 2000 costuma ser suficiente. Ela funciona bem para experimentos rápidos e treinamentos mais curtos.
Para conjuntos de dados médios, com cerca de 1.000 a 10.000 imagens, GPUs como a RTX 4090 ou a RTX A6000 oferecem um equilíbrio melhor entre desempenho e eficiência, ajudando você a treinar com mais fluidez e sem longas esperas.
Para conjuntos de dados maiores, com mais de 10.000 imagens, provavelmente você precisará de hardware mais potente para manter os tempos de treinamento razoáveis. GPUs como a H100 são mais adequadas para cargas de trabalho pesadas e para ampliar a capacidade com eficiência.
De modo geral, o objetivo é adequar o tamanho do conjunto de dados à potência computacional e à capacidade de processamento paralelo necessárias.
Como escolher uma GPU com base no tamanho e na complexidade do modelo#
Outro fator importante na escolha de uma GPU é o tamanho e a complexidade do seu modelo de IA de visão. Modelos de tamanhos diferentes exigem quantidades diferentes de potência computacional.
Por exemplo, modelos menores precisam de menos potência computacional da GPU e podem ser executados com eficiência em GPUs como a RTX 2000 Ada, a RTX A4500 ou até mesmo a RTX 4090, caso você queira resultados mais rápidos. Elas são ideais para experimentos rápidos, prototipagem e tarefas mais simples, permitindo iterar mais depressa e testar ideias sem altos custos computacionais.
Por outro lado, modelos maiores e mais complexos exigem muito mais memória e capacidade de processamento. GPUs como a RTX A6000, a RTX PRO 6000 e opções de alto desempenho como a H100 são mais adequadas para essas cargas de trabalho. Elas conseguem lidar com arquiteturas maiores, reduzir o tempo de treinamento e evitar problemas de memória, o que é especialmente importante ao trabalhar com imagens de alta resolução, tamanhos de lote grandes ou projetos de modelo mais avançados.
Comparação entre o tamanho do lote e a memória da GPU#
Da mesma forma, o tamanho do lote tem um papel importante no treinamento de modelos. Ele corresponde ao número de amostras de treinamento que o modelo processa de uma só vez em uma única etapa.
Lotes maiores podem melhorar a eficiência do treinamento ao processar mais dados de uma só vez, mas também exigem mais memória da GPU (VRAM). Em geral, GPUs com maior largura de banda de memória podem oferecer suporte a lotes maiores, enquanto GPUs com menos memória talvez precisem usar lotes menores.
Por exemplo, GPUs como a RTX A6000, a RTX PRO 6000 ou a A100 conseguem lidar com lotes maiores com mais facilidade graças à maior quantidade de memória, enquanto opções como a RTX 4090 ou a RTX 2000 Ada podem exigir lotes menores, dependendo da carga de trabalho.
No entanto, nem sempre é necessário usar a GPU mais potente. GPUs de alto desempenho podem aumentar a velocidade e a capacidade, mas também têm custos mais elevados. Em muitos casos, ajustar o tamanho do lote em uma GPU menor pode ser uma opção mais eficiente.
Em última análise, o objetivo é encontrar o equilíbrio certo entre o tamanho do lote, a memória disponível na GPU e o custo, considerando seu modelo e conjunto de dados.
O impacto da configuração de treinamento no desempenho da GPU#
Outro fator que afeta o desempenho da GPU é a configuração de treinamento. Ela inclui parâmetros como o número de épocas, o tamanho da imagem e outras definições que controlam o treinamento de um modelo.
Por exemplo, imagens maiores aumentam a quantidade de computação necessária por etapa. Isso pode tornar o treinamento mais lento e exigir mais potência computacional ou memória para manter um bom desempenho.
Da mesma forma, aumentar o número de épocas prolonga o tempo total de treinamento, especialmente em hardware menos potente. Uma época corresponde a uma passagem completa por todo o conjunto de dados durante o treinamento.
Técnicas como o aumento de dados também acrescentam processamento durante o treinamento. O aumento de dados aplica transformações como inversão, rotação ou redimensionamento para aumentar a diversidade dos dados e melhorar o desempenho do modelo. Embora isso possa aumentar a robustez do modelo, também pode reduzir a velocidade do treinamento.
Em geral, GPUs mais potentes conseguem lidar com essas demandas maiores com mais eficiência, mas o impacto depende da configuração geral e da carga de trabalho.
Equilíbrio entre custo e tempo de treinamento#
Ao escolher uma GPU para seu projeto, geralmente há uma relação de compromisso entre a velocidade do treinamento e o preço da GPU.
A Ultralytics Platform facilita a estimativa e a compreensão desses custos antes do início de uma tarefa de treinamento. Com base na sua configuração, incluindo o tamanho do conjunto de dados, o modelo e a GPU, você pode ver antecipadamente o custo e a duração estimados.
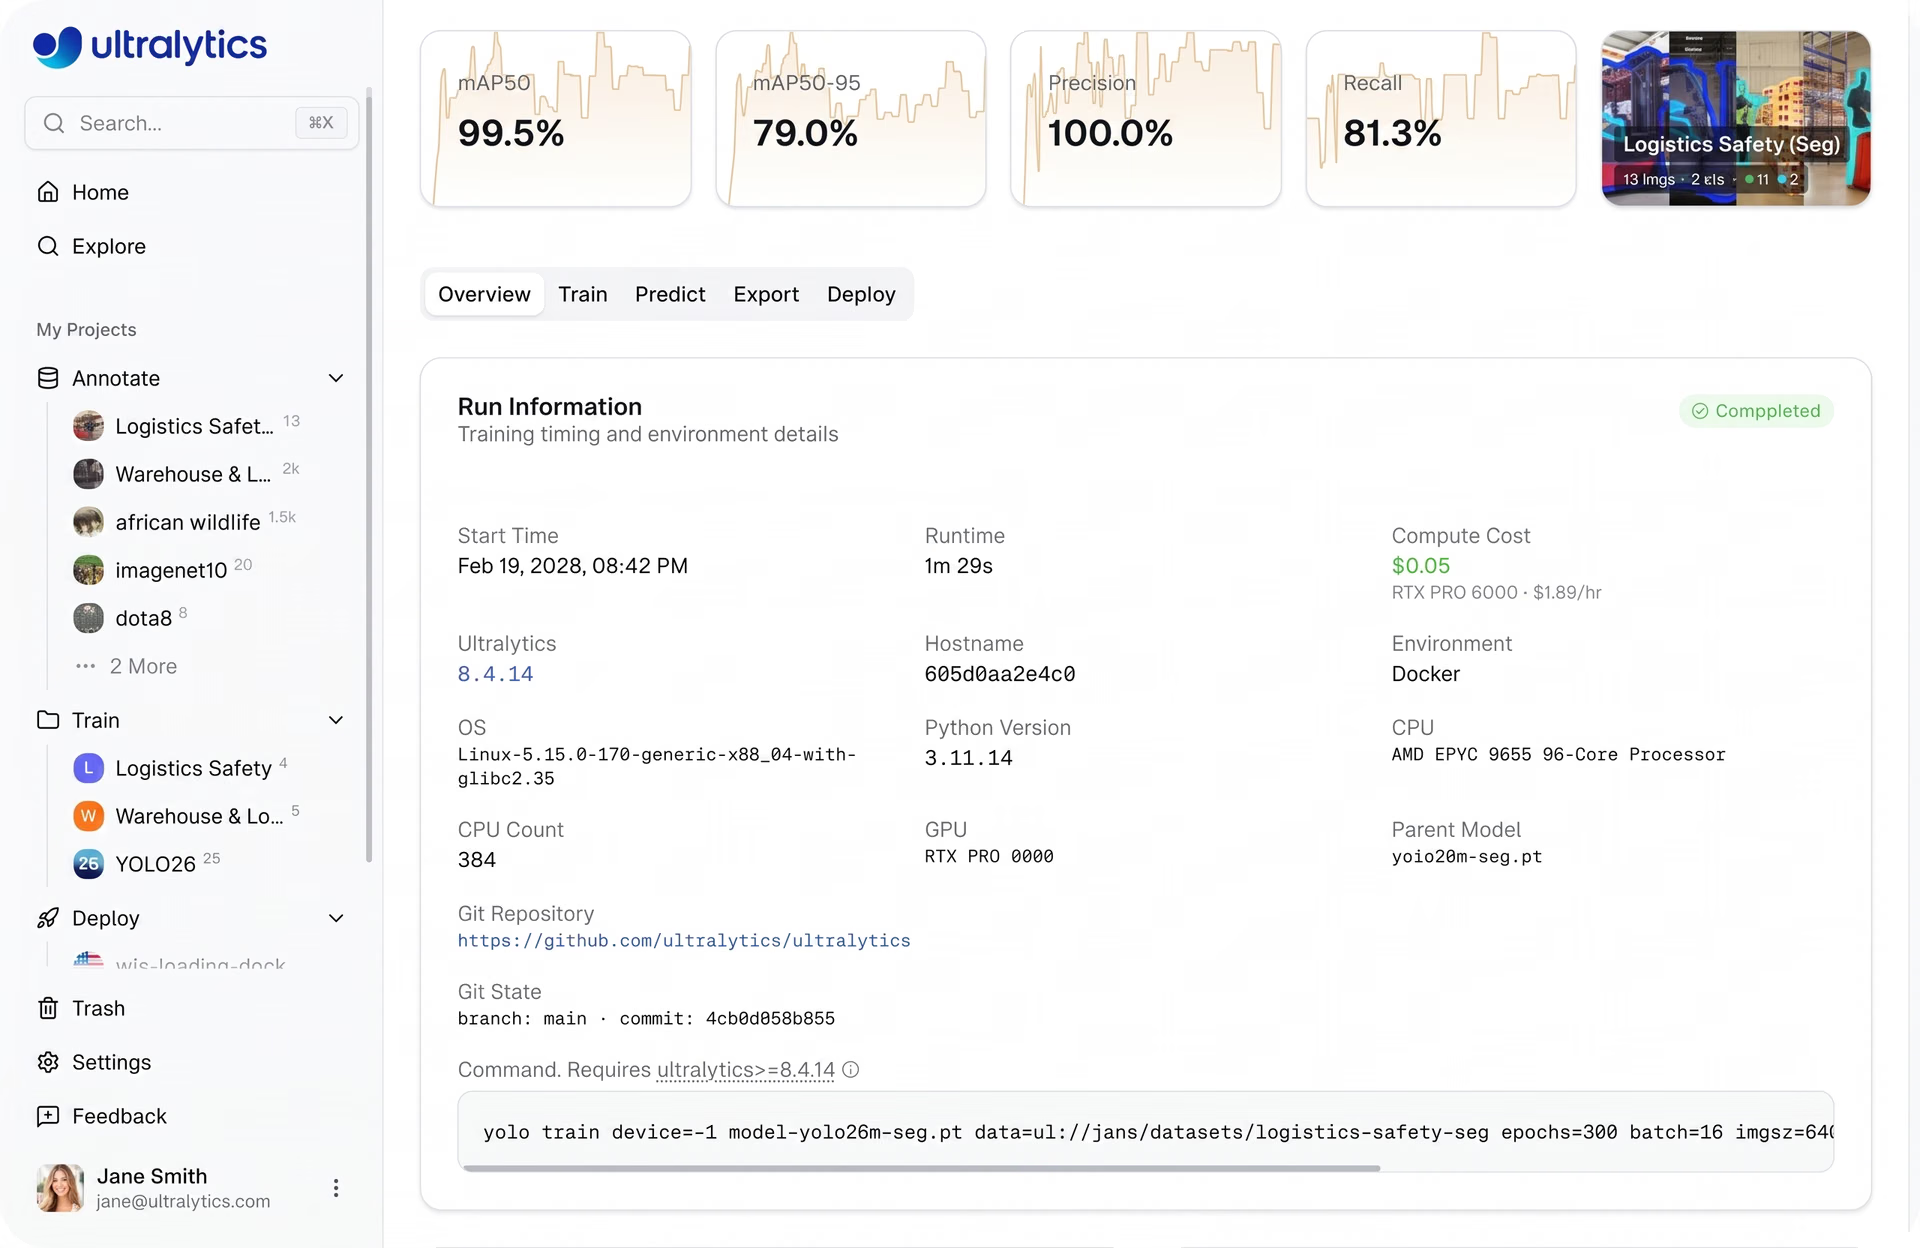
Fig. 3. A Ultralytics Platform facilita a estimativa e a compreensão dos custos da nuvem. (Fonte)
GPUs mais rápidas geralmente têm um custo por hora mais alto, mas podem reduzir o tempo total de treinamento. GPUs como a RTX 4090, a RTX PRO 6000 e a H100 geralmente concluem o treinamento mais rapidamente devido ao seu desempenho superior.
GPUs mais lentas tendem a ter um custo por hora menor, mas levam mais tempo para concluir o treinamento. Por exemplo, GPUs como a RTX 2000 Ada e a RTX A4500 costumam ser usadas em cargas de trabalho menores ou tarefas mais longas, nas quais se prioriza um custo menor.
Além disso, algumas das GPUs de mais alto desempenho, como a H200 e a B200, estão disponíveis apenas nos planos Pro ou Enterprise, enquanto a maioria das outras opções também está acessível no plano Free.
Uma análise das estratégias de otimização de custos#
Além de escolher a GPU certa, existem algumas maneiras práticas de manter os custos de treinamento sob controle. Uma das abordagens mais eficazes é começar com pequenas execuções de teste antes de ampliar a escala.
Em vez de partir direto para o treinamento completo, começa com menos épocas para garantir que a configuração funcione como esperado. Isso ajuda a validar rapidamente os dados, as anotações e a configuração do modelo, além de evitar gastar tempo e recursos computacionais em execuções que talvez não produzam resultados úteis.
À medida que o treinamento avança, acompanha as métricas e interrompe as execuções mais cedo se o desempenho estabilizar ou parar de melhorar. Monitorar as curvas de treinamento pode ajudar-te a decidir se deves continuar ou ajustar a configuração.
Também podes ajustar parâmetros como o tamanho do lote e o tamanho da imagem. Valores menores reduzem o uso de memória e de recursos computacionais, tornando mais prático experimentar, testar diferentes configurações ou executar simulações em pequena escala antes de aumentar a escala.
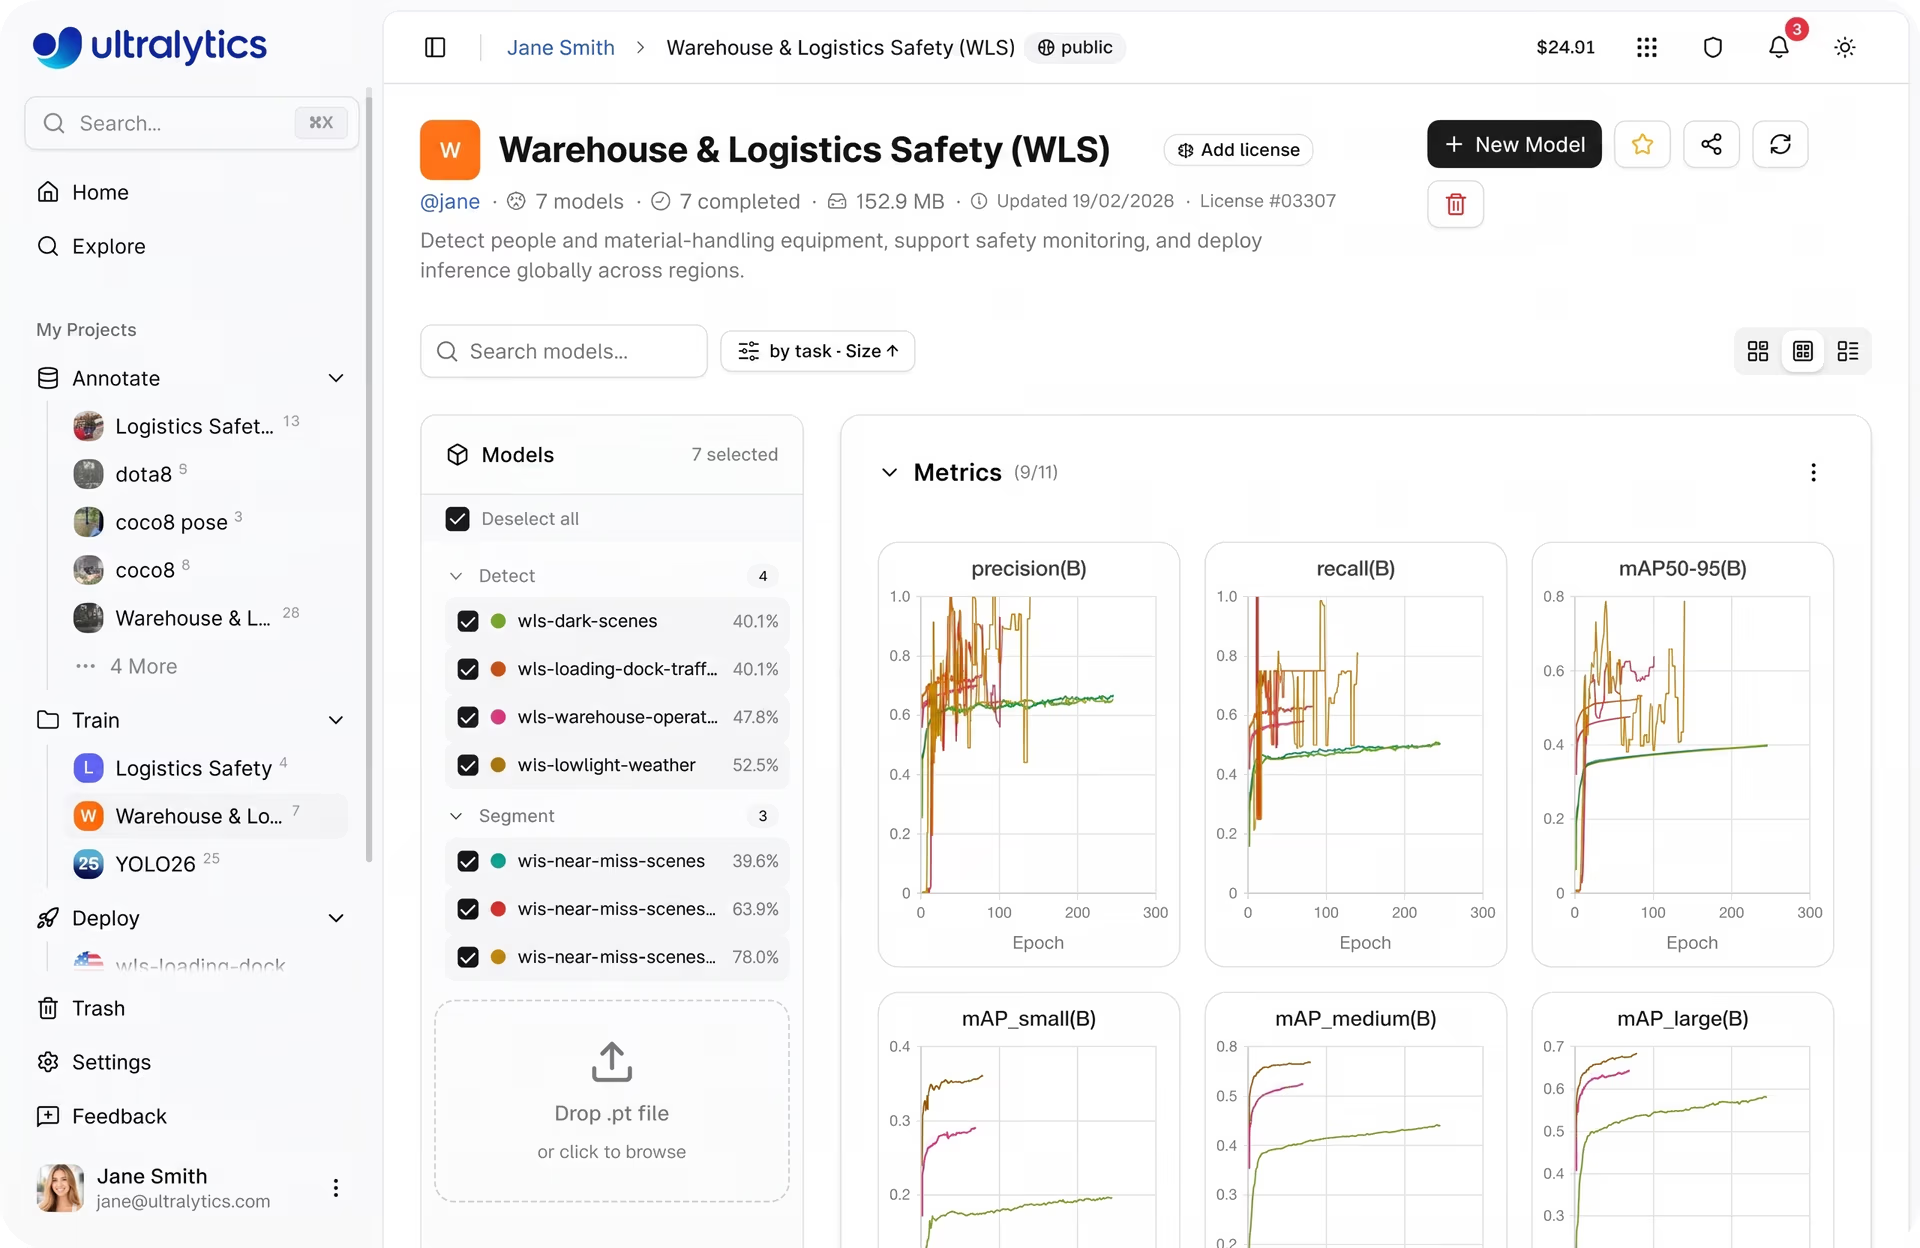
Fig. 4. Visualizações das métricas de treinamento na Ultralytics Platform (Fonte)
Além disso, a Ultralytics Platform ajuda a simplificar a gestão de custos. A plataforma oferece estimativas de custos integradas para que possas entender as despesas previstas antes de iniciar uma tarefa.
Com um sistema baseado em créditos e cobrança conforme o uso, pagas apenas pelo tempo de computação que realmente utilizas. Isso facilita manter os custos dentro do orçamento e aumentar a escala quando tiveres confiança na configuração de treinamento.
Práticas recomendadas para treinamento em GPU na nuvem em visão computacional#
Estas são algumas práticas recomendadas para ter em mente ao treinar em GPUs na nuvem com a Ultralytics Platform:
- Valida os conjuntos de dados antes do treinamento: garante que o conjunto de dados esteja limpo, bem anotado e consistente antes de começar. Identificar problemas desde o início ajuda a evitar desperdício de recursos computacionais e melhora o desempenho do modelo.
- Executa primeiro experimentos rápidos: começa com execuções de teste pequenas e menos épocas para verificar a configuração. Isso ajuda a identificar problemas desde o início, sem te comprometeres com tarefas de treinamento longas e dispendiosas. De certa forma, estás a criar um modelo que podes reutilizar e ampliar quando tudo estiver a funcionar como esperado.
- Monitora as métricas principais: acompanha métricas como loss, mAP, precisão e recall durante todo o treinamento. Essas métricas servem como referências para avaliar o desempenho do modelo e ajudam-te a decidir quando ajustar ou parar.
- Mantém os pipelines de processamento de dados eficientes: garante que o carregamento e o pré-processamento dos dados sejam eficientes, pois essas funções dependem dos recursos da CPU e podem tornar-se gargalos que afetam o desempenho geral do treinamento.
- Usa as ferramentas integradas: usa gráficos, registros do console e métricas do sistema para monitorar o treinamento em tempo real e tomar decisões informadas rapidamente.
Principais conclusões#
Escolher a GPU na nuvem certa para visão computacional na Ultralytics Platform depende de entender a tua carga de trabalho, incluindo o tamanho do conjunto de dados, a complexidade do modelo e a configuração de treinamento. Com diversas opções de GPU disponíveis, viabilizadas pela infraestrutura na nuvem e por máquinas virtuais, podes começar com uma opção equilibrada e aumentar a escala à medida que as necessidades de treinamento ou ajuste fino do modelo crescerem. Ao combinar o hardware certo com boas práticas, como monitoramento e controle de custos, podes treinar modelos de inteligência artificial de última geração com eficiência e aproveitar ao máximo a flexibilidade da computação de alto desempenho.
Conhece a nossa comunidade em crescimento e o nosso repositório do GitHub para saber mais sobre visão computacional. Se queres desenvolver soluções de visão computacional, consulta as nossas opções de licenciamento. Explora as páginas das nossas soluções para saber mais sobre os benefícios da visão computacional na indústria e da IA na agricultura.








