5 причин, по которым модели компьютерного зрения не справляются в рабочей среде
Узнай, почему модели компьютерного зрения не справляются в рабочей среде — от несоответствия данных до задержек — и как команды могут повысить их производительность в реальных системах компьютерного зрения на базе ИИ.
 Abirami Vina8 мин. чтения
Компьютерное зрение стало одной из ключевых технологий искусственного интеллекта, которую внедряют в большинстве отраслей. Оно позволяет машинам интерпретировать и анализировать визуальные данные для решения самых разных задач. Такие системы поддерживают множество приложений в реальном мире: от медицинской визуализации и робототехники до автоматизации производства и розничной торговли.
Однако создать систему компьютерного зрения не всегда просто. Обычно для этого нужно разработать модель ИИ для компьютерного зрения, обученную распознавать закономерности на изображениях и видео для решения таких задач, как обнаружение и отслеживание объектов.
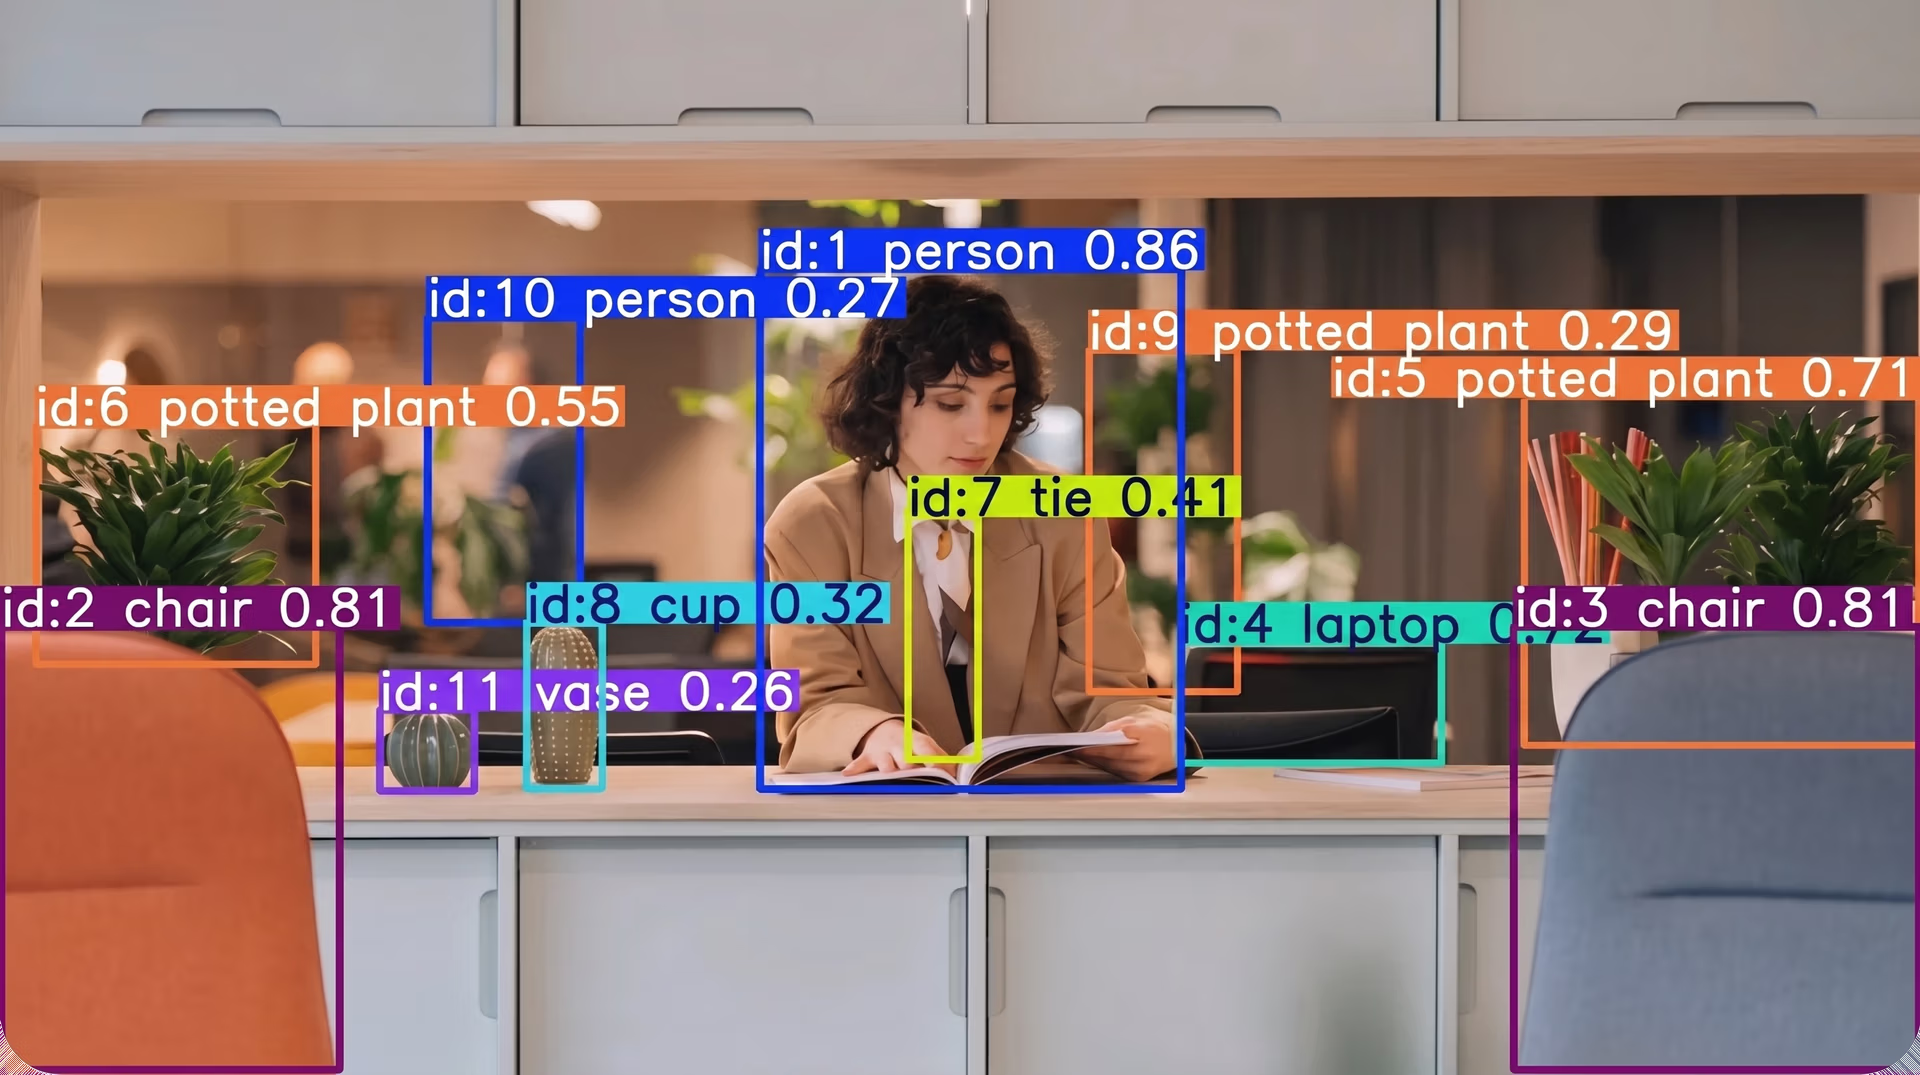
Рис. 1. Пример обнаружения и отслеживания объектов (Источник)
Несмотря на то что за прошедшие годы модели компьютерного зрения стали совершеннее, в процессе разработки они всё ещё могут вести себя иначе, чем после развёртывания в реальных условиях. Это происходит потому, что запуск моделей вне контролируемой среды разработки создаёт новые и часто неожиданные сложности.
Такие факторы, как недостаточное разнообразие датасетов, слабый мониторинг моделей и ограничения инфраструктуры, могут привести к тому, что одна и та же модель после развёртывания будет вести себя в реальных условиях иначе.
В этой статье мы рассмотрим пять распространенных причин, по которым модели компьютерного зрения могут плохо работать в производственной среде.
Разрыв между обучением модели и production#
Обучение моделей обычно проходит в контролируемой среде. На этом этапе разработчики ИИ работают с тщательно подготовленными обучающими датасетами.
Эти обширные коллекции визуальных данных содержат хорошо структурированные аннотации, или метки, описывающие содержимое каждого изображения. Обучение также проходит в стабильных условиях, что позволяет моделям ИИ для компьютерного зрения эффективно изучать визуальные закономерности.
Чтобы убедиться, что модели правильно усвоили эти закономерности, в процессе разработки их можно систематически оценивать с помощью стандартных метрик оценки и эталонных датасетов. Как и обучающие датасеты, эталонные датасеты также тщательно подготавливают.
Однако данные, с которыми сталкиваются системы компьютерного зрения в реальных условиях, могут сильно отличаться от данных, использованных при обучении и оценке. После развёртывания модели редко работают в контролируемых условиях.
Им может приходиться обрабатывать изображения и видео из непредсказуемой среды, где постоянно меняется освещение, смещаются углы съёмки и со временем меняется фон. Например, модель ИИ для компьютерного зрения, обученная обнаруживать дорожное движение, может с трудом распознавать автомобили ночью, если её обучали и оценивали преимущественно на дневных изображениях.
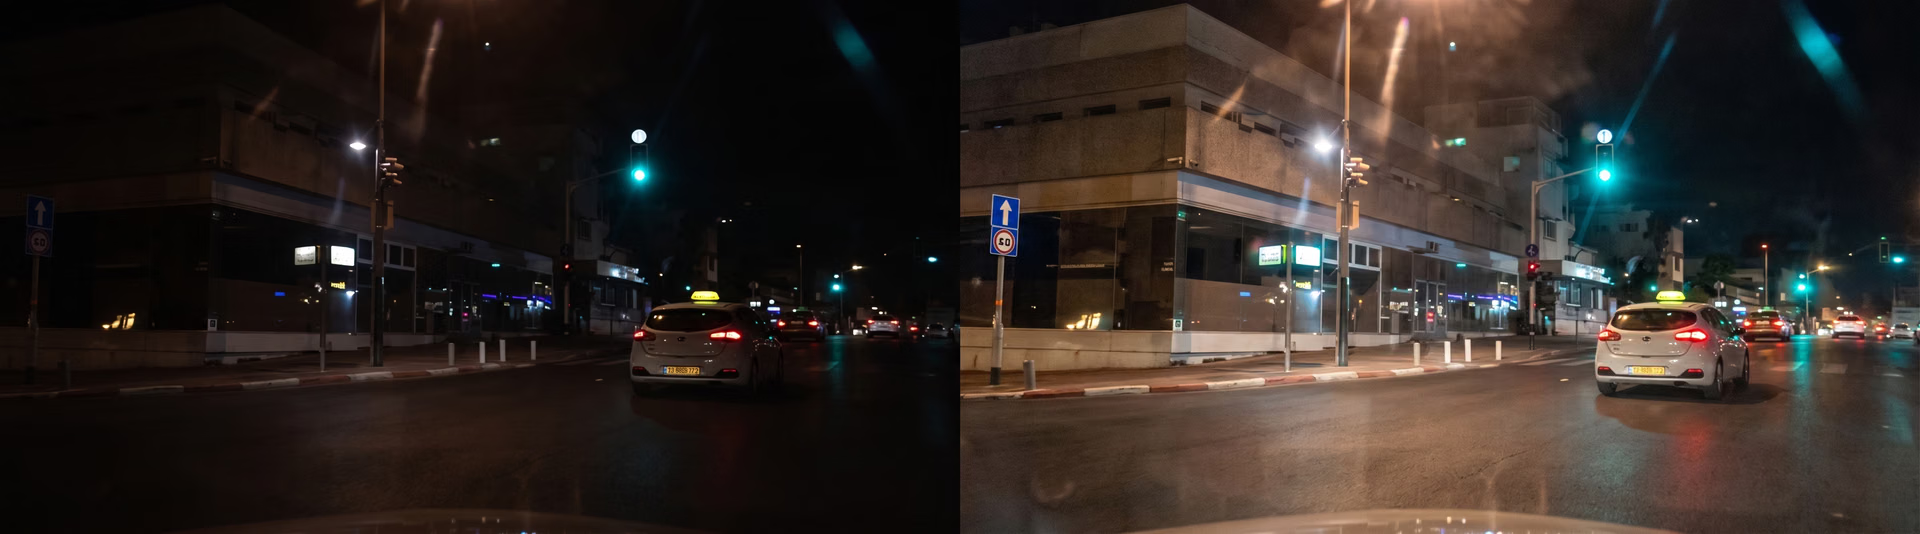
Рис. 2. Даже после улучшения качества ночные изображения трудно интерпретировать моделям, обученным на дневных снимках. (Источник)
Это различие между разработкой и развертыванием в реальных условиях называется разрывом между обучением и производственной средой. Из-за этого разрыва многие сбои моделей становятся заметны только после развертывания, поэтому понимание пути от лаборатории до производства — необходимое условие создания более надежных и устойчивых систем компьютерного зрения.
5 распространённых причин сбоев моделей компьютерного зрения в production#
Далее подробнее рассмотрим пять распространённых причин сбоев моделей компьютерного зрения в production.
1. Низкое качество обучающих датасетов#
Датасеты играют ключевую роль в обучении моделей компьютерного зрения: от них зависит, чему модель научится и как будет реагировать на входные данные из реальных условий после развёртывания. Это особенно важно при обучении с учителем, когда модели учатся на размеченных примерах, показывающих, что изображено на каждом снимке.
Многие модели глубокого обучения, включая свёрточные нейронные сети (CNNs), используют эти размеченные примеры для распознавания закономерностей в визуальных данных. Однако если обучающий датасет не отражает реальные условия, модель может усвоить закономерности, которые не вполне соответствуют тому, как объекты выглядят за пределами обучающих данных.
Например, модель, обученная на датасете с крупными трещинами и дефектами, может не обнаружить редкий тип мелких трещин в реальных производственных процессах. На поведение модели также влияет качество аннотаций. Непоследовательная разметка или отсутствие важных деталей в размеченных данных могут привести к тому, что модель усвоит неверную информацию во время обучения.
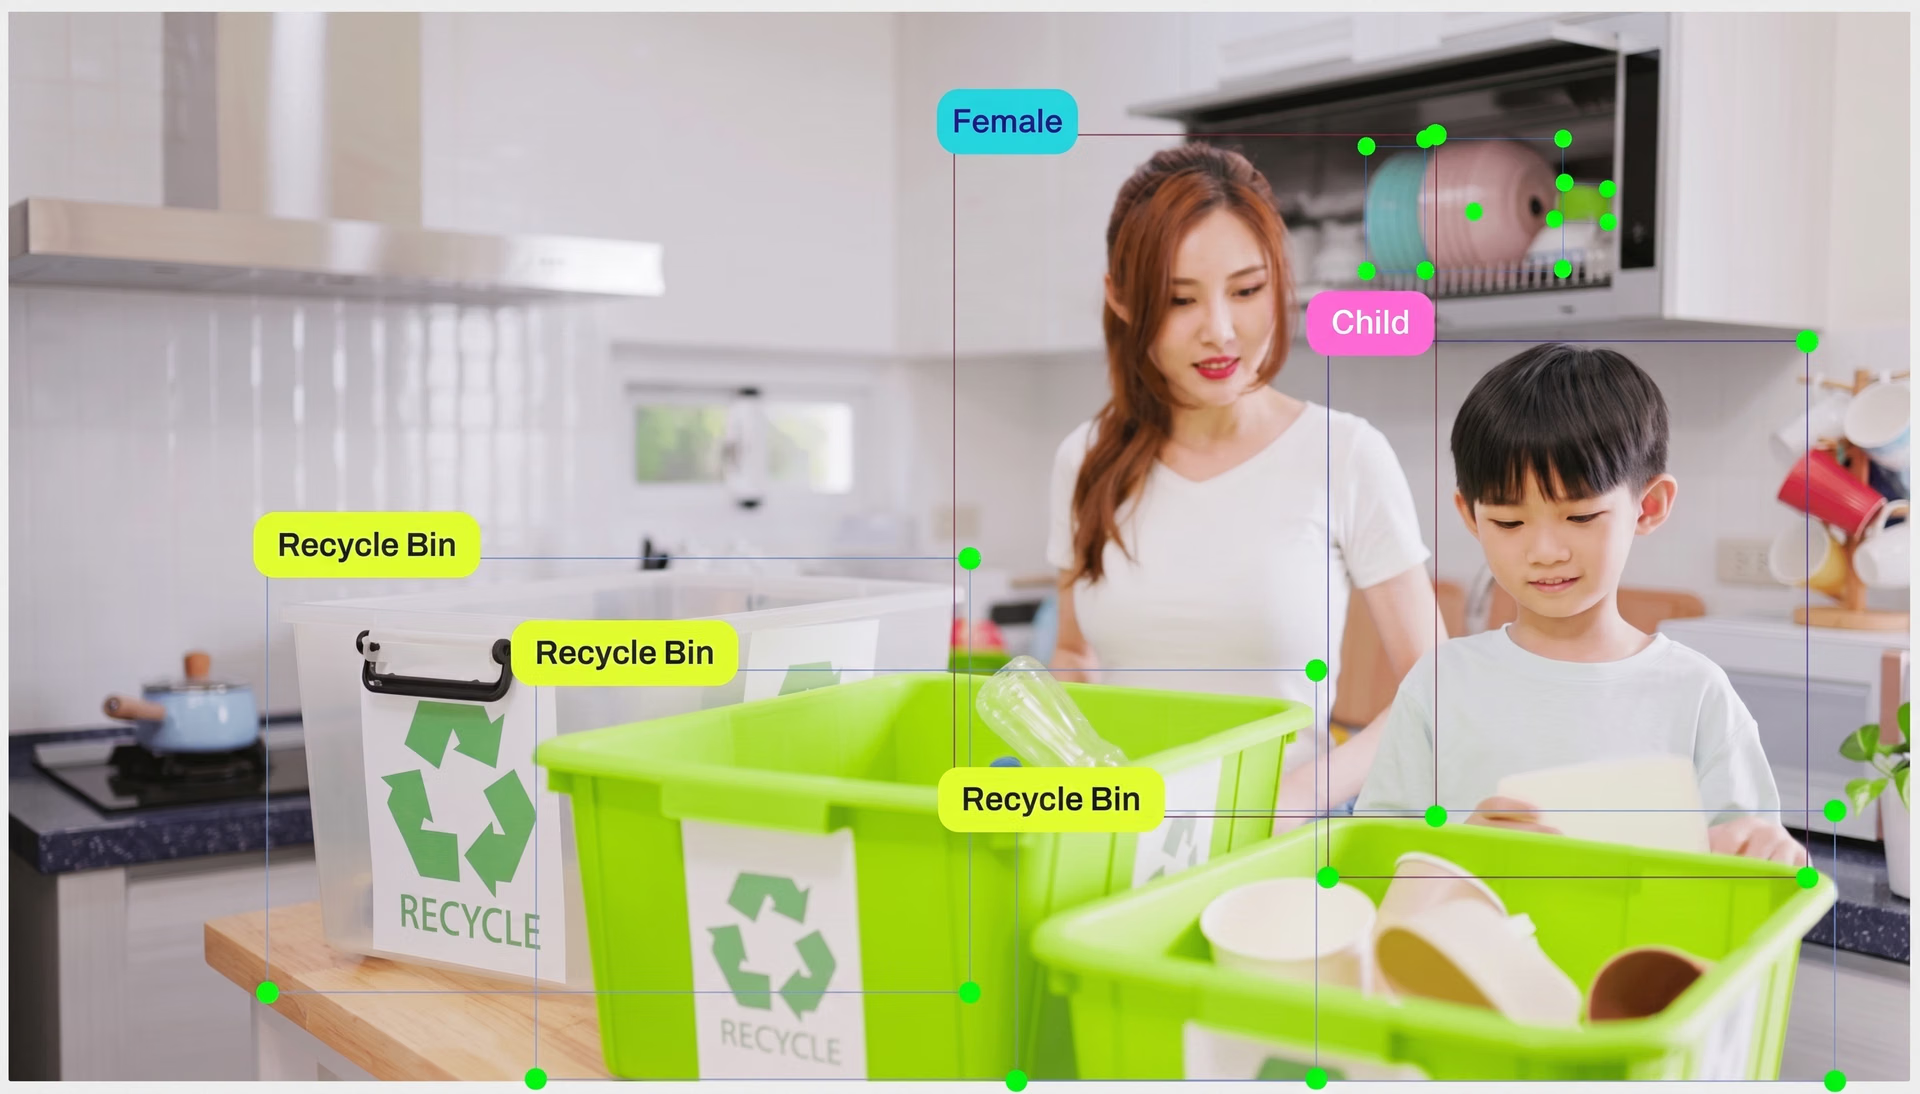
Рис. 3. Пример аннотаций изображений (Источник)
В целом качество и разнообразие обучающих данных имеют решающее значение и могут определять, насколько хорошо модель будет работать в реальных приложениях. Если датасеты репрезентативны и размечены точно, модель обычно работает надёжнее после развёртывания.
2. Переобучение и обобщающая способность#
Модели машинного обучения, в том числе модели компьютерного зрения, изучают закономерности на обучающих датасетах. Но иногда модель чрезмерно полагается на несколько таких закономерностей.
Вместо того чтобы изучать более общие визуальные взаимосвязи, модель может просто запомнить ограниченный набор закономерностей из обучающих данных. Такое поведение называют переобучением.
Переобучение обычно возникает, когда обучающие датасеты невелики или недостаточно разнообразны. В таких случаях модель хорошо распознаёт уже виденные изображения, но ей трудно интерпретировать новые данные или незнакомые входные данные.
В результате модель может хорошо работать на тестовых данных, поскольку они похожи на обучающие, но после развертывания вести себя иначе в новых условиях. Поэтому так важно обобщение. Проще говоря, это способность модели применять то, чему она научилась во время обучения, в новых сценариях.
Чтобы уменьшить переобучение, специалисты часто обучают модели на более разнообразных наборах данных и применяют аугментацию данных — метод, при котором обучающие изображения немного изменяют, чтобы разнообразить данные. Без учета этих факторов производительность модели может быстро снизиться после начала работы системы в реальных условиях.
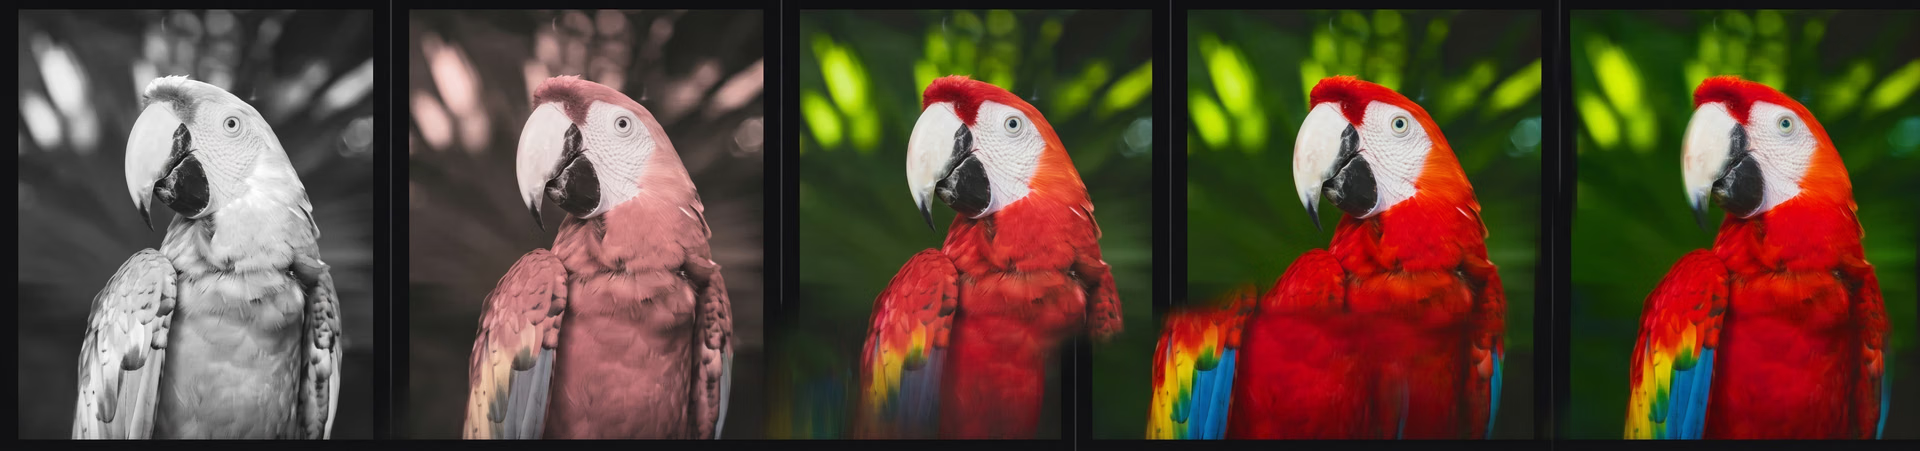
Рис. 4. Аугментация данных помогает создавать варианты одного изображения в датасете. (Источник)
3. Скрытые пограничные случаи в реальных условиях#
Даже если модели компьютерного зрения хорошо обобщают новые данные, в реальных условиях всё равно могут возникать неожиданные пограничные случаи. Это необычные ситуации, отличающиеся от типичных закономерностей, которые модель усваивает во время обучения.
Многие такие ситуации трудно учесть на этапе разработки: они возникают редко, их сложно воссоздать или сбор данных для обучения обходится дорого. Например, объекты могут иметь необычную форму, двигаться непредсказуемо или быть частично скрытыми за другими объектами.
Изменения освещения, угла съёмки или фона также могут усложнить распознавание. Такие пограничные случаи часто становятся заметны только после развёртывания системы в реальных приложениях.
Например, в робототехнике и автоматизации производства предметы могут располагаться не так, как ожидалось, создавая ситуации, к обработке которых модель не готова. В результате предсказания, казавшиеся надёжными во время тестирования, могут стать менее стабильными, когда система начнёт работать в реальных условиях.
4. Отсутствие мониторинга и отладки после развёртывания#
Помимо разработки модели ИИ для компьютерного зрения, важно отслеживать и улучшать её производительность. Однако после запуска системы внимание часто переключается на поддержание её работоспособности, а не на тщательный анализ производительности с течением времени. В результате изменения в поведении модели могут остаться незамеченными.
При этом такие факторы, как изменение входящих данных, настройки камер или условия эксплуатации, могут постепенно влиять на точность обнаружения или классификации объектов моделью. Эти изменения не всегда очевидны и могут оставаться незамеченными в ходе повседневной работы.
Мониторинг выходных данных модели и поведения системы в целом помогает командам раньше выявлять такие проблемы. Регулярные проверки, процедуры валидации и рабочие процессы отладки позволяют командам изучать необычные результаты и выяснять их возможные причины.
Например, на производстве модель может внезапно начать неверно распознавать объекты на сборочной линии после изменения конфигурации камеры. Отслеживание поведения развёрнутой системы ИИ для компьютерного зрения упрощает реакцию на такие изменения и помогает поддерживать стабильную работу в реальных условиях.
5. Ограничения инфраструктуры и задержки#
Многие системы компьютерного зрения должны работать в реальном времени, что создаёт значительную нагрузку на оборудование, сети и конвейеры обработки данных. При ограниченных ресурсах могут возникать задержки вычислений или сети, из-за которых предсказания приходят слишком поздно и снижается общая производительность системы.
В некоторых случаях сложные модели глубокого обучения также создают проблемы для инфраструктуры. Например, архитектуры на основе Transformer предназначены для обработки больших объёмов визуальных данных и изучения сложных взаимосвязей внутри изображений, но часто требуют значительных вычислительных ресурсов. Для запуска таких моделей может понадобиться более мощное или дорогостоящее оборудование.
Без надлежащей оптимизации даже модели, быстро работающие во время тестирования, могут замедлиться или начать работать нестабильно после развёртывания. Чтобы этого избежать, команды оптимизируют конвейеры, по возможности уменьшают сложность моделей и находят баланс между точностью и скоростью.
Для этого можно сжимать крупные модели, создавая более лёгкие версии, использовать эффективные архитектуры или обрабатывать изображения с более низким разрешением, чтобы система стабильно работала на доступном оборудовании. Во многих случаях команды также выбирают лёгкие и быстрые модели, например Ultralytics YOLO26, чтобы уложиться в ограничения среды развёртывания.
Рекомендации по предотвращению сбоев моделей компьютерного зрения#
Вот несколько рекомендаций, которые помогут снизить риск сбоев при развёртывании моделей компьютерного зрения в production:
- Используй поэтапное развёртывание: постепенно вводи модели в production, чтобы команды могли наблюдать за их поведением и при необходимости вносить изменения.
- Организуй циклы обратной связи: собирай новые изображения и анализируй ошибочные предсказания, чтобы переобучать модели на обновлённых датасетах и со временем улучшать их производительность.
- Документируй ограничения модели: чётко фиксируй ситуации, в которых модель может испытывать трудности, чтобы команды могли заранее предусмотреть возможные проблемы при развёртывании.
- Учитывай изменчивость реальных условий при проектировании: Заблаговременная подготовка к различиям в освещении, углах съемки, расположении объектов и условиях фона помогает моделям сохранять стабильность в разных сценариях эксплуатации.
Главные выводы#
Модели компьютерного зрения редко дают сбой из-за слабых алгоритмов. В большинстве случаев основная сложность связана со средой, в которой работают системы. Модели, хорошо показывающие себя во время обучения, часто сталкиваются с непредсказуемыми условиями реального мира, которые могут влиять на их поведение.
Поэтому для создания надёжных систем ИИ для компьютерного зрения недостаточно просто обучить модель. Нужно также тщательно подготовить датасеты, отслеживать производительность модели после развёртывания и постоянно адаптировать системы к реальным условиям.
Хочешь узнать больше об ИИ для компьютерного зрения? Присоединяйся к нашему сообществу и читай о таких приложениях, как ИИ в автомобильной отрасли и компьютерное зрение в логистике. Ознакомься с нашими вариантами лицензирования, чтобы начать проекты в области компьютерного зрения. Посети наш репозиторий GitHub, чтобы узнать больше.
Автор
Создатель контента · Ultralytics
Комментарии
Задай вопрос, поделись результатами или помоги кому-нибудь.









