Разбираемся в обучении с учителем и без учителя в компьютерном зрении
Узнай, чем отличаются обучение с учителем и обучение без учителя в компьютерном зрении и как выбрать подход к своим данным и целям проекта.
В основе искусственного интеллекта (AI) лежит идея обучения машин учиться и рассуждать так, чтобы это напоминало человеческий интеллект. Подобно тому как люди учатся разными способами — например, получая прямые инструкции или наблюдая за закономерностями и изучая опыт, — системы ИИ и машинного обучения созданы для работы по тем же принципам.
В частности, алгоритмы машинного обучения обучают системы на данных, а не программируют явно для выполнения каждой задачи. Вместо опоры на фиксированные правила модели машинного обучения выявляют закономерности в данных и используют их для прогнозов или принятия решений.
Например, компьютерное зрение — это область ИИ и машинного обучения, которая помогает системам интерпретировать и понимать визуальную информацию, например изображения и видео. От распознавания объектов до выявления скрытых закономерностей в больших наборах данных — работа таких систем во многом зависит от того, как их обучили.
Для обучения таких систем применяют разные методы обучения ИИ — выбор зависит от типа доступных данных и решаемой задачи.
Некоторые модели компьютерного зрения обучаются на размеченных данных: каждому входному примеру соответствует правильный ответ, то есть у каждого изображения или точки данных есть заранее заданная метка, указывающая, что именно представлено. Так модель учится связывать входные данные с ожидаемым результатом и точнее прогнозировать для новых, ранее не встречавшихся данных.
Другие модели компьютерного зрения обучаются на неразмеченных данных: правильные ответы заранее не предоставляются, и модели выявляют закономерности и связи непосредственно в самих данных. Эти подходы соответственно называются обучением с учителем и обучением без учителя и лежат в основе многих передовых систем компьютерного зрения.
В этой статье мы рассмотрим обучение с учителем и без учителя, их применение в компьютерном зрении и то, как выбрать подход для своего проекта в области визуального ИИ. Начнём!
Как методы обучения ИИ помогают развивать компьютерное зрение#
Представь, что искусственный интеллект — это зонтичное понятие, охватывающее различные технологии, которые позволяют машинам выполнять задачи, обычно требующие человеческого интеллекта. В эту область входит машинное обучение — важное направление, благодаря которому системы могут обучаться на данных, а не полагаться только на фиксированные правила.
В машинном обучении разные методы определяют, как модель учится и со временем совершенствуется. Обучение с учителем (обучение на размеченных данных с правильными ответами), обучение без учителя (выявление закономерностей в неразмеченных данных), обучение с подкреплением (обучение методом проб и ошибок с использованием обратной связи или вознаграждений) и обучение с частичным привлечением учителя (сочетание небольшого объёма размеченных данных с большим объёмом неразмеченных) определяют, как системы обрабатывают входные данные и формируют выходные.
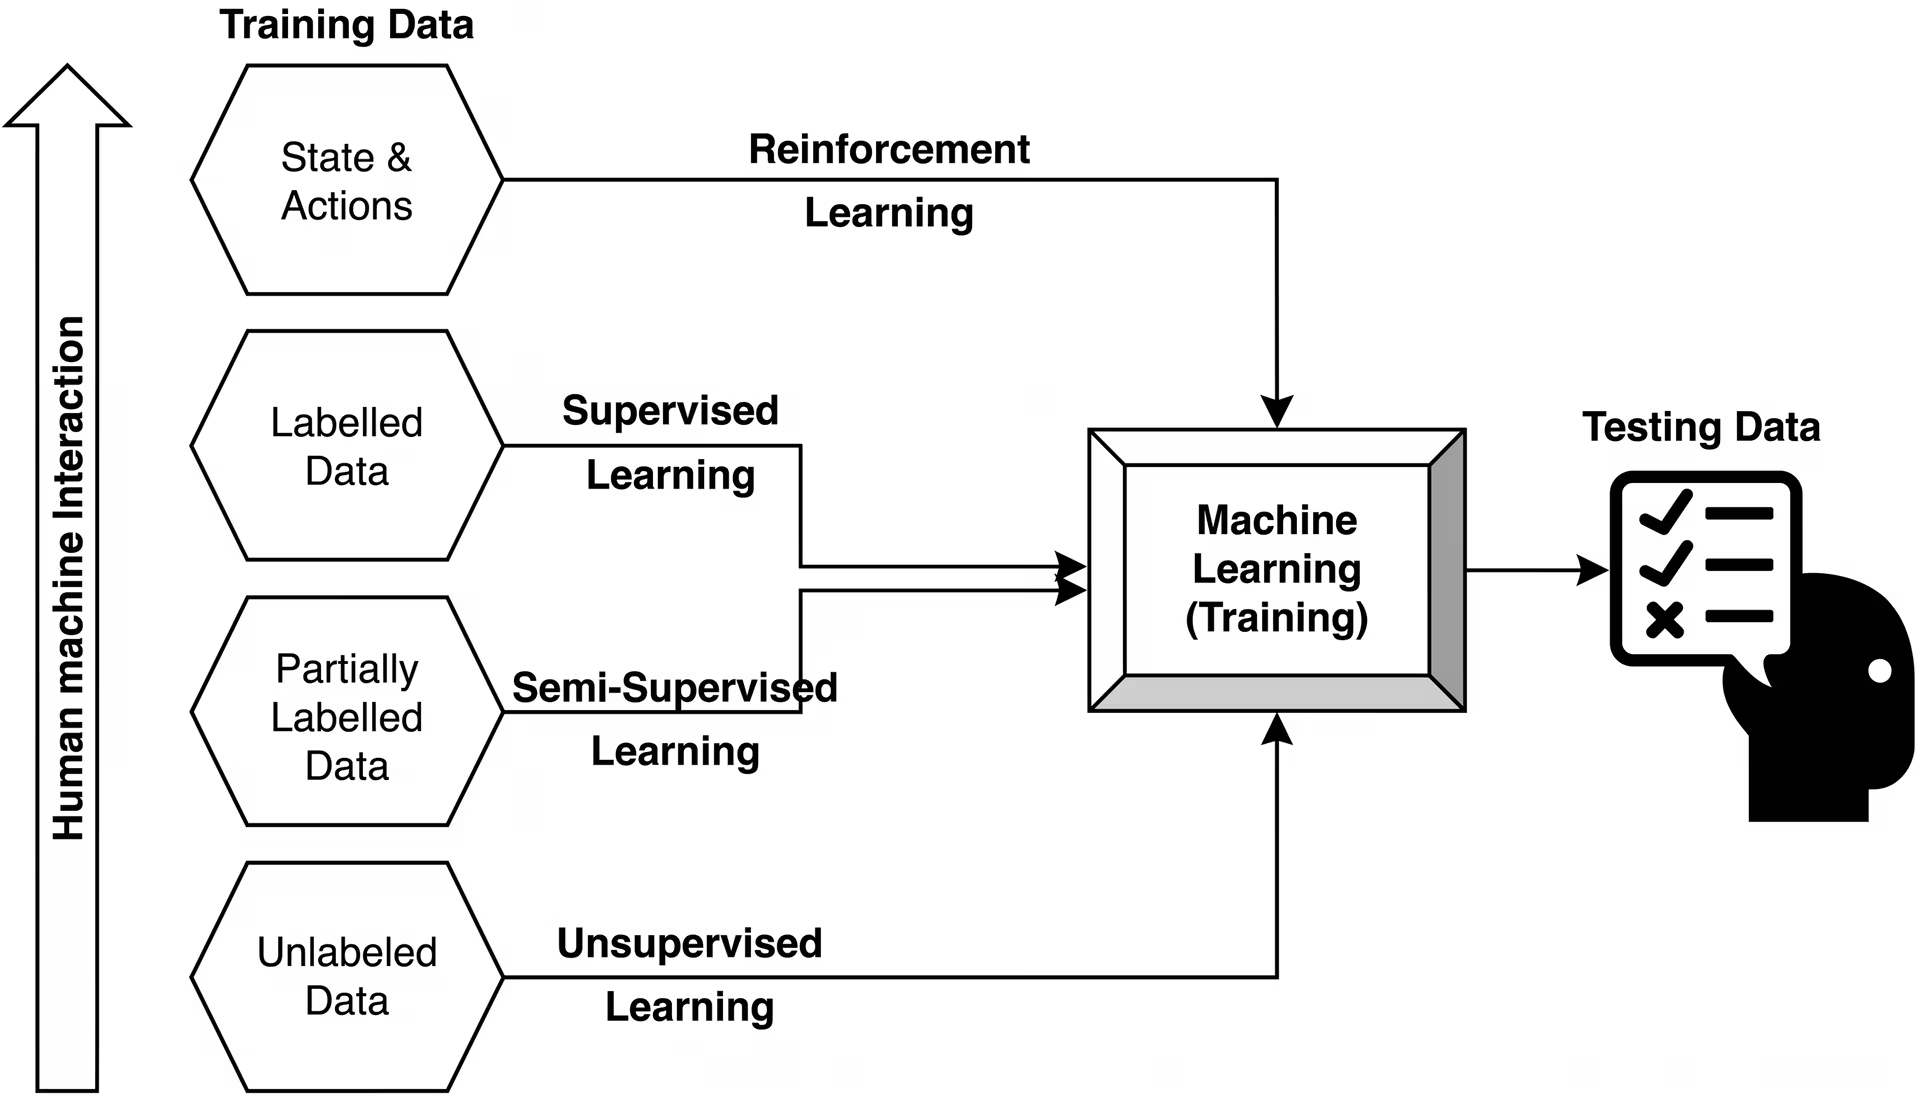
Рис. 1. Обзор методов обучения ИИ (Источник)
В частности, системы компьютерного зрения строятся с применением таких методов обучения, чтобы интерпретировать и понимать визуальные данные. Чаще всего используют обучение с учителем: оно позволяет моделям учиться на чётко размеченных примерах и выдавать точные и надёжные результаты.
Например, модель можно обучить на изображениях с метками «кошка» и «собака». Она научится распознавать такие признаки, как форма, уши и строение морды, и сможет правильно классифицировать новые изображения с помощью алгоритмов классификации. Обучение без учителя и обучение с частичным привлечением учителя также применяют в компьютерном зрении — часто для изучения закономерностей в данных или повышения качества работы при ограниченном количестве размеченных данных.
Применение моделей обучения с учителем в компьютерном зрении#
Алгоритмы обучения с учителем можно сравнить с обучением в классе: учитель приводит примеры и правильные ответы, чтобы ученики могли понять, что верно, а что нет. В машинном обучении модели учатся похожим образом на размеченных данных, где каждому входному примеру соответствует известный результат.
Представь, что ты создаёшь систему компьютерного зрения для автоматизации анализа бейсбольных матчей. Можно обучить модель, например Ultralytics YOLO26, на изображениях или кадрах видео с разметкой таких объектов, как мяч, бита и игроки.
Для каждого объекта указывают местоположение и категорию, благодаря чему модель учится распознавать нужные объекты. Со временем модель сможет обнаруживать эти объекты и определять их местоположение на новых видеозаписях, что пригодится, например, для отслеживания мяча и игроков в разных кадрах.
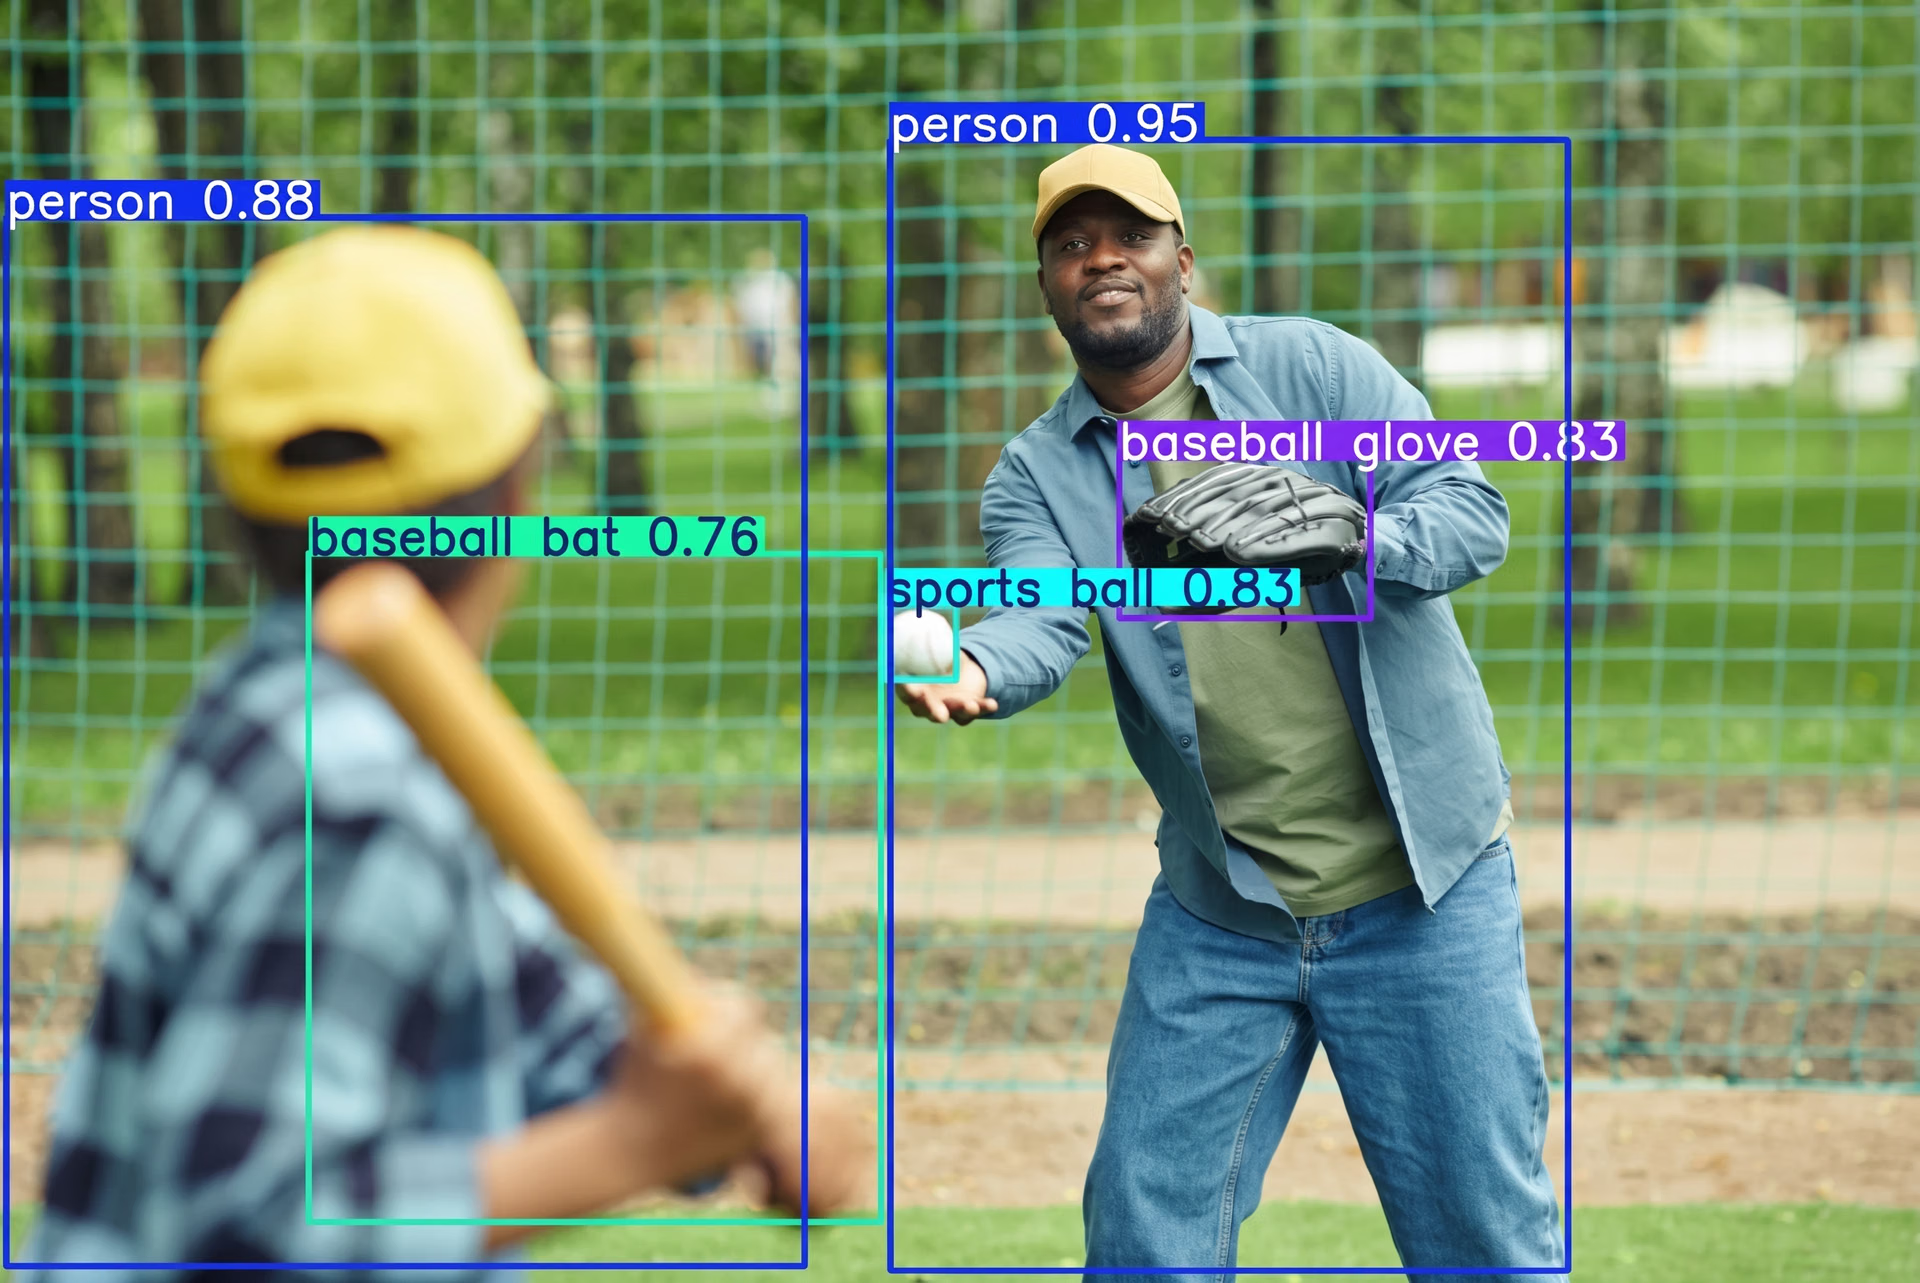
Рис. 2. Пример обнаружения объектов с помощью обучения с учителем (Источник)
Помимо обнаружения объектов, обучение с учителем широко применяют в различных задачах компьютерного зрения, таких как классификация изображений, сегментация экземпляров и оценка позы, где важны точность и стабильность. Во всех этих задачах модели учатся на размеченных данных выявлять определённые закономерности и надёжно прогнозировать результаты для новых входных данных.
Такие модели обычно создают с помощью глубокого обучения — разновидности машинного обучения, в которой нейронные сети изучают закономерности непосредственно в данных. Нейронные сети обрабатывают информацию по принципам, отчасти напоминающим работу человеческого мозга, благодаря чему модели могут изучать сложные визуальные признаки на больших наборах данных.
Ранние методы компьютерного зрения часто опирались на признаки, созданные вручную, и такие алгоритмы, как машины опорных векторов (SVM — модели, которые классифицируют данные, находя оптимальную границу между категориями) или деревья решений (модели, принимающие решения путём разделения данных на ветви).
Современные модели компьютерного зрения, напротив, используют глубокое обучение, чтобы автоматически извлекать эти признаки из данных. Благодаря этому они эффективнее справляются с масштабными и сложными задачами обработки визуальных данных.
Зачем в визуальном ИИ нужны модели обучения без учителя#
Обучение с учителем — основной подход в компьютерном зрении, однако в некоторых задачах размеченных данных нет либо их разметка обходится слишком дорого и занимает много времени.
В таких случаях полезной альтернативой могут стать алгоритмы обучения без учителя. Например, представь, что у тебя есть большая коллекция неразмеченных фотографий с фотоловушки.
На изображениях нет меток, указывающих, что на них изображено, но данные всё равно нужно систематизировать или изучить. Модель обучения без учителя может проанализировать изображения и объединить похожие: например, сгруппировать внешне схожих животных, даже не зная их точных меток.
Как работает обучение без учителя в компьютерном зрении#
Как же работает машинное обучение без учителя? Вместо того чтобы учиться на правильных ответах, модель самостоятельно выявляет закономерности и структуру в данных. Она ищет сходства и различия в данных, не полагаясь на размеченные примеры.
Распространённый пример применения — обнаружение аномалий: модель учится определять, как выглядят нормальные данные, а затем выявляет любые отклонения от нормы. Обнаружение аномалий и выбросов — одно из наиболее значимых промышленных применений. Например, можно выявлять дефектные изделия на производственной линии, помечать необычные медицинские снимки для проверки радиологом или обнаруживать подозрительную активность на записях камер наблюдения. Поскольку дефекты и аномалии часто редки и разнообразны, размечать каждый возможный случай непрактично, поэтому методы обучения без учителя здесь особенно уместны.
Для этого часто применяют такие методы, как кластеризация и снижение размерности, обычно к признакам, извлечённым из изображений, а не к исходным изображениям. Методы кластеризации, например кластеризация k-средних, объединяют похожие изображения по общим закономерностям, а методы снижения размерности, например метод главных компонент (PCA), упрощают данные, выделяя наиболее важные признаки.
Благодаря этому модели проще выявлять значимые закономерности и структуру в больших и сложных наборах данных. Главное преимущество обучения без учителя — эффективная работа с неразмеченными данными и способность обнаруживать неочевидные закономерности. Однако оценивать такие модели сложнее, а контролировать итоговый результат труднее, чем при обучении с учителем.
Самообучение и обучение с частичным привлечением учителя в компьютерном зрении#
Изучая обучение с учителем и без учителя, ты можешь задуматься, есть ли промежуточный вариант. Оказывается, самообучение и обучение с частичным привлечением учителя занимают промежуточное положение между этими подходами.
Эти подходы позволяют моделям эффективнее обучаться на неразмеченных данных. Вместо того чтобы полагаться только на размеченные примеры, модели либо самостоятельно создают учебные задачи на основе данных, либо объединяют небольшой размеченный набор с более крупным неразмеченным.
При самообучении модель учится, решая задачи, сформированные на основе самих данных. Например, ей могут показать изображение с пропущенной частью и предложить предсказать, чем заполнить пустое место, или научить распознавать разные ракурсы одного объекта. Это помогает модели изучать полезные признаки без ручной разметки.
При обучении с частичным привлечением учителя небольшой объём размеченных данных используют вместе с большим набором неразмеченных, чтобы повысить качество работы модели. В некоторых случаях модель может сама создавать метки для неразмеченных данных и продолжать обучение на их основе.
Главное преимущество этих подходов — сокращение потребности в больших размеченных наборах данных, создание которых часто требует много времени и средств. Однако проектировать и оценивать такие модели может быть сложнее, чем модели, полностью обученные с учителем.
Ключевые различия между обучением с учителем и без учителя#
Различие между обучением с учителем и без учителя сводится к тому, как учится модель и какую задачу она решает. Обучение с учителем опирается на размеченные данные и чёткие инструкции для решения конкретных задач, а обучение без учителя обходится без заранее заданных ответов и направлено на поиск закономерностей и структуры в данных.
Например, модель с обучением с учителем для системы мониторинга дорожного движения можно обучить на размеченных изображениях, чтобы обнаруживать автомобили, пешеходов и светофоры. Модель с обучением без учителя, напротив, может анализировать большие объёмы видеозаписей, группировать похожие дорожные ситуации или выявлять необычные события — например, неожиданные заторы или нестандартное движение — без явных указаний, что искать.
Когда использовать обучение с учителем в компьютерном зрении#
Обучение с учителем отлично подходит для задач компьютерного зрения с чётко определённой целью, где модель должна преобразовывать входные данные в точные результаты. Этот подход особенно эффективен, если у тебя есть надёжный размеченный набор данных и нужны стабильные, предсказуемые результаты.
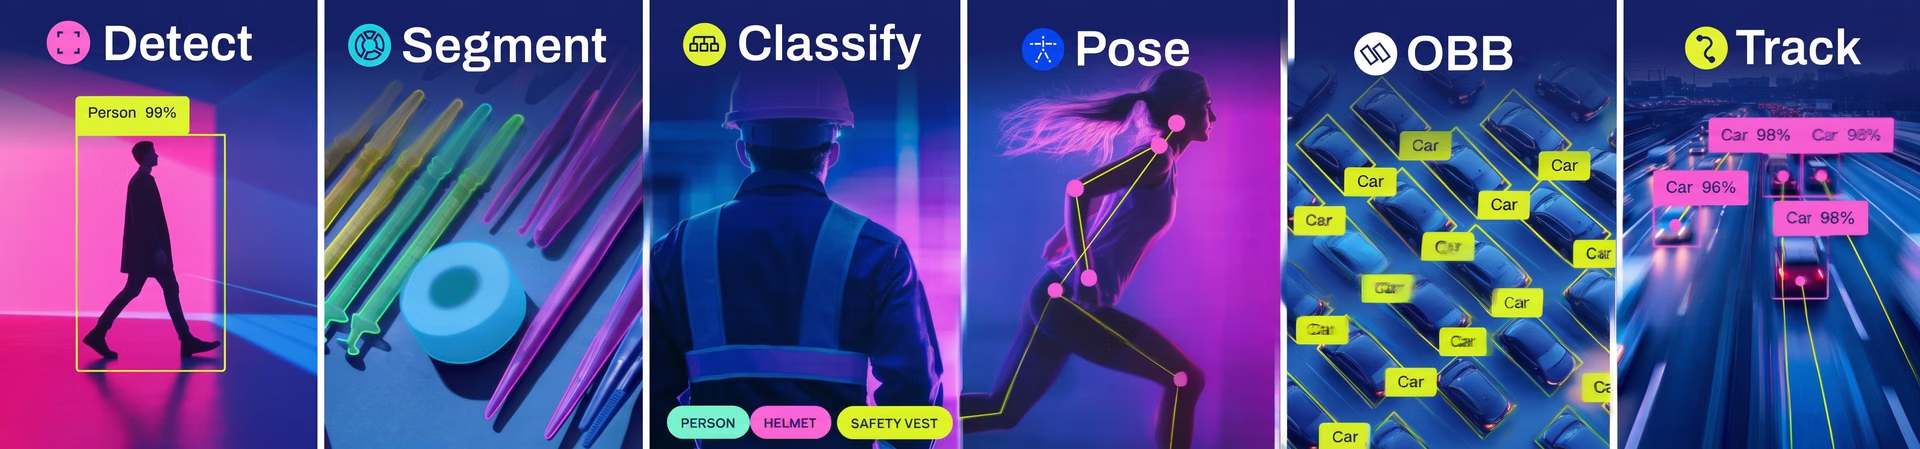
Рис. 3. Задачи компьютерного зрения на основе обучения с учителем (Источник)
Этот подход часто используют в задачах, где модель должна различать известные категории или прогнозировать конкретные результаты. Вместо поиска закономерностей здесь важно выявить точные зависимости в размеченных данных, чтобы направить модель к нужному результату.
Ещё одно важное преимущество — контроль. При обучении с учителем проще оценивать качество по чётким метрикам, настраивать модель и обеспечивать стабильную работу при развёртывании. Поэтому этот подход отлично подходит для систем, которым со временем нужна согласованность и надёжность.
Однако за это приходится платить: модель сильно зависит от качества и объёма размеченных данных, а сбор и аннотирование таких данных могут занять много времени.
Примеры применения обучения с учителем в компьютерном зрении#
Модели визуального ИИ, такие как модели Ultralytics YOLO, используют обучение с учителем для решения задач, например обнаружения объектов с высокой точностью, особенно в приложениях реального времени. Вот несколько распространённых примеров применения обучения с учителем в реальных задачах компьютерного зрения:
- Здравоохранение и медицинская визуализация: врачи могут использовать системы компьютерного зрения, обученные на размеченных снимках, например рентгеновских снимках или МРТ. Классификаторы помогают выявлять такие состояния, как опухоли или переломы, ускоряя и повышая точность диагностики.
- Контроль качества в промышленности: на производстве системы компьютерного зрения, обученные на размеченных данных, могут проверять изделия по различным характеристикам качества, например форме, дефектам поверхности, текстуре и размеру. Научившись различать подходящие и бракованные изделия, такие системы могут стабильно выявлять дефекты и поддерживать производственные стандарты.
- Автономное вождение: беспилотные системы полагаются на модели, обученные на размеченных данных о дорожном движении. Такие модели распознают полосы, автомобили, пешеходов и дорожные знаки, помогая транспортным средствам безопасно двигаться в режиме реального времени.
- Розничная торговля и системы оплаты: магазины используют модели, обученные на размеченных изображениях товаров, чтобы распознавать товары на полках и на кассе. Это позволяет автоматизировать расчёт стоимости и эффективнее управлять запасами. Если объединить такие системы с дополнительными данными, они смогут выполнять и другие задачи, например сегментацию покупателей, помогая компаниям лучше понимать покупательские привычки.
- Сельское хозяйство и мониторинг урожая: фермеры могут использовать модели, обученные на размеченных изображениях, для обнаружения и классификации сельскохозяйственных культур — например, для выявления и подсчёта здорового и повреждённого картофеля. Это повышает качество контроля и сокращает потери.
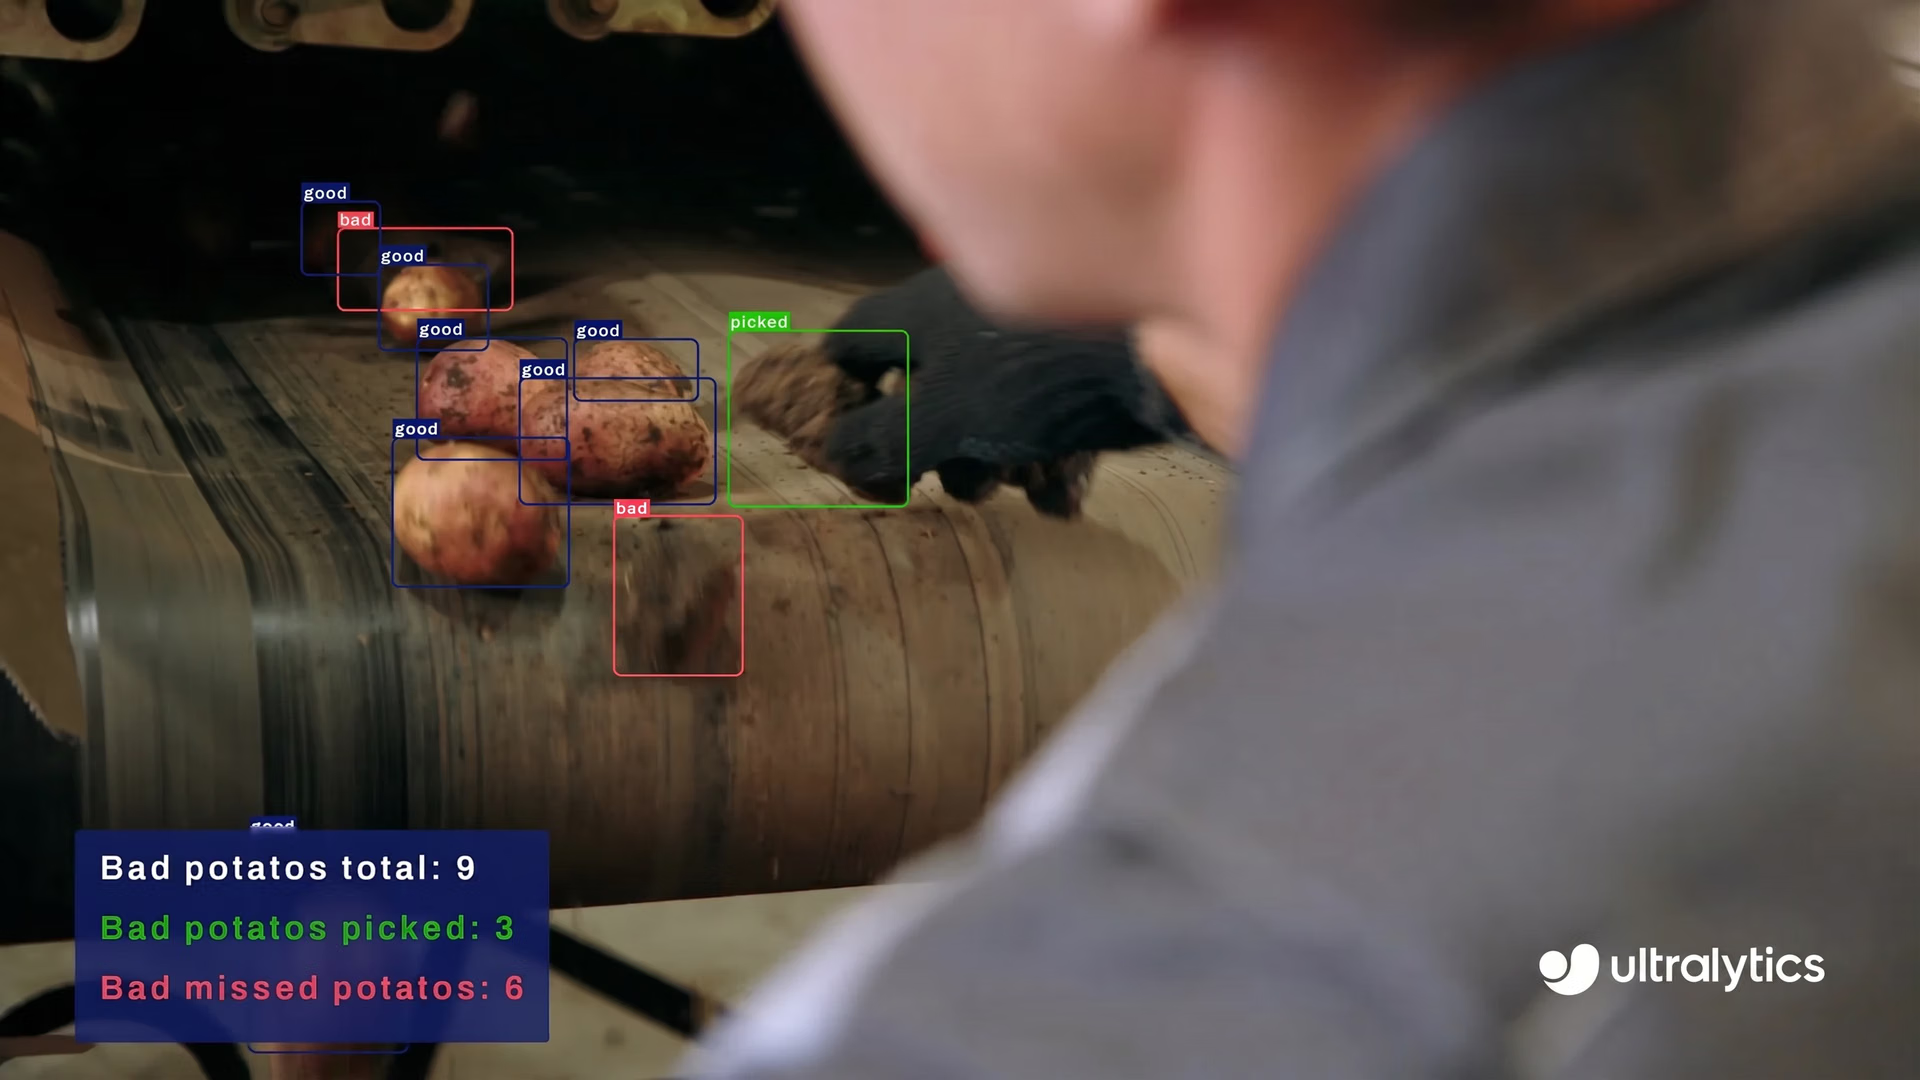
Рис. 4. Обнаружение и подсчёт здоровых и дефектных клубней картофеля с помощью YOLO
Какие задачи компьютерного зрения можно решать с помощью обучения без учителя#
Обучение без учителя полезно, если размеченных данных недостаточно или данные не содержат однозначных ответов. В таких случаях цель состоит не в точном прогнозировании, а в понимании закономерностей и структуры данных.
Его часто используют при первом изучении неразмеченного набора данных. Вместо того чтобы указывать модели, что искать, можно позволить ей самостоятельно выявлять сходства, группировать похожие изображения или отмечать необычные закономерности.
Если у тебя есть большая коллекция изображений, подход без учителя поможет сгруппировать похожие изображения или отметить выбросы, требующие дополнительного внимания. Это делает его хорошей отправной точкой для проектов в области науки о данных.
Генеративные модели, включая GAN, вариационные автокодировщики и диффузионные модели, изучают базовое распределение изображений, чтобы создавать совершенно новые. Эти модели лежат в основе таких приложений, как синтез изображений, заполнение пропусков, сверхвысокое разрешение и перенос стиля, а также современных генеративных систем ИИ.
При сегментации без учителя некоторые методы объединяют пиксели или области в целостные сегменты, не используя размеченные маски. Это полезно, когда аннотация обходится слишком дорого или нужно обнаружить структуру данных, а не распределить объекты по заранее заданным категориям.
Обучение без учителя также эффективно при работе с большими наборами данных, разметка которых требует много времени или практически невыполнима. В таких случаях оно позволяет получать полезные сведения из данных, не полагаясь на размеченные обучающие данные.
Этот подход также часто применяют в таких областях, как генеративный ИИ (модели, создающие новые данные — например, изображения, текст или аудио) и обучение представлений (модели, извлекающие полезные признаки или закономерности из исходных данных), где модели изучают общие признаки на больших объёмах данных. В целом, если твоя задача связана с исследованием, поиском закономерностей или работой с неразмеченными данными, обучение без учителя — гибкий и практичный вариант.
Примеры применения обучения без учителя в компьютерном зрении#
Вот несколько примеров применения обучения без учителя в компьютерном зрении:
- Обнаружение аномалий на производстве: модели могут выучить, как выглядят нормальные изделия, и выявлять дефекты или отклонения без размеченных примеров каждого возможного дефекта.
- Систематизация изображений и поиск: большие коллекции изображений, например фототеки или каталоги электронной торговли, можно автоматически группировать по визуальному сходству. Это упрощает специалистам по данным систематизацию, изучение и поиск по большим наборам данных.
- Видеонаблюдение и безопасность: системы могут анализировать видеозаписи, чтобы выявлять необычные закономерности или поведение, например неожиданное движение или изменения в толпе, без специального обучения на размеченных событиях.
- Предварительная обработка и изучение данных: методы обучения без учителя часто используют для изучения и структурирования исходных изображений перед обучением моделей с учителем. Это помогает повысить качество данных и сократить объём ручной работы.
Практические ограничения обучения с учителем и без учителя#
Несмотря на преимущества обоих подходов к обучению, важно учитывать и их ограничения. Вот несколько практических факторов, о которых стоит помнить при создании моделей компьютерного зрения:
- Переобучение моделей с учителем: при обучении с учителем модель может слишком точно запомнить обучающие данные вместо того, чтобы изучить общие закономерности. Часто это происходит, если набор данных небольшой или недостаточно разнообразный. Например, модель, обученная обнаруживать дефекты одного типа изделий, может не справиться с новыми данными, где изделия или условия освещения немного отличаются.
- Сложности с алгоритмами кластеризации: при обучении без учителя модель может объединять похожие точки данных. Однако этот подход может не сработать, если данные зашумлены, непоследовательны или не имеют чёткой структуры. Например, при группировке изображений картинки с похожими цветами, но разными объектами могут ошибочно попасть в одну группу.
- Важность правильной предварительной обработки: перед обучением данные нужно очистить и подготовить. Обычно для этого используют библиотеки Python для обработки изображений и преобразования данных. В компьютерном зрении это особенно важно, поскольку изображения могут различаться размером, качеством и условиями освещения. Без правильной предварительной обработки модели могут усваивать шум вместо значимых закономерностей, что приводит к низкому качеству работы.
Главные выводы#
В компьютерном зрении важную роль играют и обучение с учителем, и обучение без учителя. Выбор подхода зависит от типа данных — размеченные они или нет, — а также от решаемой задачи и требований к развёртыванию.
Если тебе нужны высокая точность и чётко определённые результаты, машинное обучение с учителем часто оказывается лучшим выбором. Если ты изучаешь данные или работаешь без разметки, лучше подойдёт обучение без учителя.
Хочешь узнать больше об ИИ? Загляни в наше сообщество и репозиторий GitHub. Изучи страницы наших решений, чтобы узнать об ИИ в робототехнике и компьютерном зрении в сельском хозяйстве. Ознакомься с вариантами лицензирования и начни создавать решения на основе компьютерного зрения уже сегодня!









