Xuất Ultralytics YOLO sang LiteRT
Tìm hiểu cách tích hợp xuất model LiteRT mới đưa inference Ultralytics YOLO đến môi trường di động, embedded, edge và trình duyệt bằng một định dạng thống nhất.
Tại Ultralytics, chúng tôi nhận thấy xu hướng ngày càng tăng là chạy model thị giác máy tính trực tiếp trên thiết bị cần sử dụng, thay vì phụ thuộc vào kết nối đám mây. Ứng dụng di động, hệ thống nhúng, cảm biến IoT và công cụ chạy trên trình duyệt ngày càng cần thực hiện inference cục bộ, thường trên phần cứng có ngân sách điện năng và năng lực tính toán hạn chế. Đó là lý do chúng tôi rất vui mừng thông báo rằng giờ đây có thể export trực tiếp model Ultralytics YOLO sang LiteRT.
Đáp ứng nhu cầu này đòi hỏi một định dạng model có thể hoạt động trên tất cả các môi trường đó mà không buộc developer phải duy trì pipeline export riêng cho từng môi trường.
Trước đây đã có khả năng này thông qua một package bên thứ ba không chính thức, nhưng tích hợp mới là kết quả của sự hợp tác chính thức với Google. Chúng tôi đã phối hợp chặt chẽ với đội ngũ LiteRT để xây dựng pipeline end-to-end export model Ultralytics YOLO sang TFLite thông qua LiteRT. Với tích hợp này, một model Ultralytics YOLO được export duy nhất có thể triển khai trên môi trường di động, nhúng, edge và trình duyệt, hợp nhất những gì trước đây các định dạng export TFLite và TF.js xử lý riêng lẻ thành một định dạng tinh gọn.
LiteRT là gì?#
LiteRT (viết tắt của Lite Runtime) là runtime hiệu năng cao của Google dành cho AI trên thiết bị. Đây là thế hệ tiếp theo và tên gọi mới của TensorFlow Lite (TFLite), đồng thời chạy cùng định dạng model .tflite mà developer đã quen thuộc.
LiteRT là framework mã nguồn mở được thiết kế riêng cho inference trên thiết bị, còn gọi là điện toán biên. Framework này cung cấp cho developer các công cụ để thực thi model đã huấn luyện trên thiết bị di động, thiết bị nhúng và IoT, máy tính thông thường, cũng như trực tiếp trên trình duyệt web và Node.js thông qua LiteRT.js. Định dạng export LiteRT tối ưu hóa model cho các tác vụ như phát hiện đối tượng, phân đoạn, ước lượng tư thế và phân loại, giúp model chạy nhanh và offline trên nhiều loại thiết bị.
Vì sao nên export model Ultralytics YOLO sang LiteRT?#
Giờ đây, một định dạng model đáp ứng mọi mục tiêu triển khai:
• Di động và nhúng. Android, iOS, máy tính để bàn, Linux nhúng và vi điều khiển (MCU).
• Bộ tăng tốc edge. Tương thích với Coral Edge TPU để tăng tốc hơn nữa.
• Trình duyệt và Node.js. LiteRT.js chạy cùng model .tflite trên web với khả năng tăng tốc WebGPU/WASM, thay thế nhu cầu export riêng sang TensorFlow.js.
• Máy tính để bàn
Việc hợp nhất này rất quan trọng vì loại bỏ một nguồn gây trở ngại thực sự trong quá trình triển khai production. Thay vì duy trì một pipeline export cho thiết bị di động, một pipeline khác cho trình duyệt và pipeline thứ ba cho bộ tăng tốc edge, giờ đây các nhóm có thể export một lần và triển khai ở mọi nơi LiteRT chạy được.
Các tính năng chính của model LiteRT#
• Tối ưu hóa trên thiết bị. Giảm độ trễ bằng cách xử lý dữ liệu cục bộ, tăng cường quyền riêng tư bằng cách không truyền dữ liệu cá nhân và giảm kích thước model để tiết kiệm dung lượng.
• Hỗ trợ nhiều nền tảng. Chạy trên Android, iOS, Linux nhúng, vi điều khiển và trình duyệt web hiện đại.
• Tăng tốc phần cứng. Tận dụng XNNPACK trên CPU và tăng tốc GPU thông qua OpenCL, Metal và WebGPU. Theo mặc định, tăng tốc GPU chạy ở FP16 để đạt tốc độ cao hơn.
• Lượng tử hóa. Hỗ trợ FP32, INT8 tĩnh, kích hoạt INT16 tĩnh và INT8 động để nén model và tăng tốc inference với mức suy giảm độ chính xác tối thiểu.
• Hỗ trợ đa dạng ngôn ngữ. Tương thích với Java/Kotlin, Swift, Objective-C, C++, Python và JavaScript.
Bắt đầu với tính năng export LiteRT#
Package Python Ultralytics và Ultralytics Platform cung cấp môi trường thống nhất, toàn diện để huấn luyện, đánh giá và triển khai model YOLO trên cả năm tác vụ thị giác máy tính. Định dạng export LiteRT hỗ trợ các chế độ Export, Predict và Validate, nhờ đó có thể export model rồi sử dụng ngay để inference hoặc xác thực độ chính xác cục bộ.
Chỉ cần một lệnh để export model:
from ultralytics import YOLO

# Tải model YOLO26
model = YOLO("yolo26n.pt")

# Export model sang định dạng LiteRT
model.export(format="litert") # tạo 'yolo26n.tflite'
Đối với các nhóm triển khai trên phần cứng hạn chế, LiteRT cũng hỗ trợ export lượng tử hóa, cho phép nén model để inference nhanh hơn với mức suy giảm độ chính xác tối thiểu:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# INT8 động: trọng số int8, kích hoạt FP32 - không cần dữ liệu hiệu chuẩn
model.export(format="litert", quantize="w8a32")

# INT8 tĩnh: trọng số int8 + kích hoạt int8 - cần dữ liệu hiệu chuẩn
model.export(format="litert", quantize=8, data="coco8.yaml")
Sau khi export, có thể tải model và chạy inference trực tiếp:
from ultralytics import YOLO

# Tải model LiteRT đã export
model = YOLO("yolo26n.tflite")

# Chạy suy luận
results = model("https://ultralytics.com/images/bus.jpg")
Hiện tại, tính năng export LiteRT được hỗ trợ trên Linux x86_64 và macOS. Bản thân model .tflite đã export có thể chạy trên mọi nền tảng LiteRT hỗ trợ, bao gồm di động, nhúng, edge và trình duyệt.
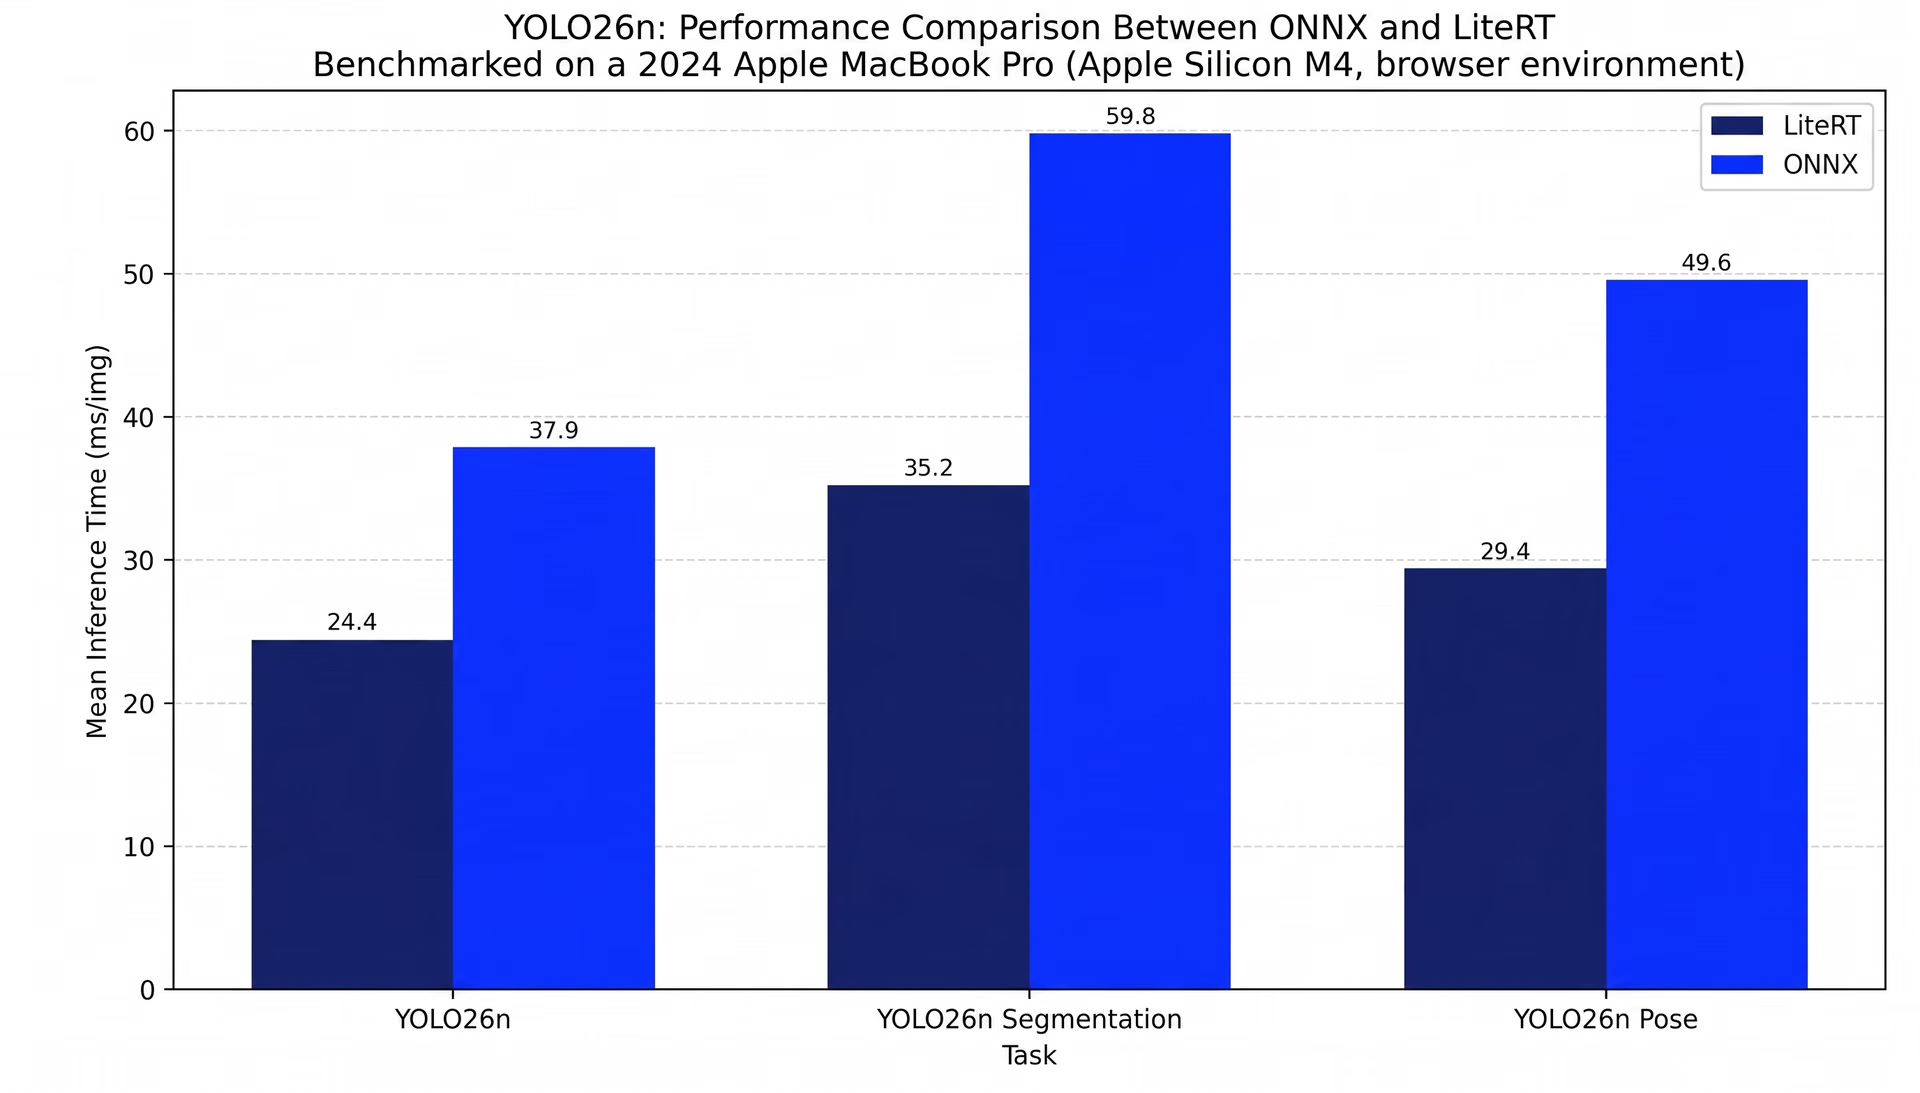 Hình 1. So sánh hiệu năng giữa ONNX và LiteRT.
Hình trên so sánh thời gian inference trung bình cho các tác vụ phát hiện, phân đoạn và ước lượng tư thế trên YOLO26n, chạy trong trình duyệt thông qua @ultralytics/yolo, package npm của Ultralytics dành cho inference phía client trên WebGPU/WASM thông qua ONNX Runtime Web. Được benchmark trong môi trường trình duyệt có kiểm soát trên Apple MacBook Pro 2024 (Apple Silicon M4).
Đưa Ultralytics YOLO đến edge#
Với LiteRT, việc triển khai model Ultralytics YOLO trên môi trường di động, nhúng, edge và trình duyệt không còn cần các pipeline export riêng cho từng mục tiêu. Một lần export, một định dạng model và một quy trình nhất quán từ huấn luyện đến production, ở bất cứ nơi nào cần chạy inference.
Bạn quan tâm đến AI thị giác? Khám phá các tùy chọn cấp phép để đưa thị giác máy tính vào dự án của bạn. Truy cập repository GitHub để khám phá đầy đủ các tích hợp export của Ultralytics, và xem Ultralytics Platform để bắt đầu xây dựng quy trình AI thị giác end-to-end của riêng bạn.









