如何为视觉 AI 训练选择云 GPU,并在 Ultralytics Platform 上开展训练
了解如何根据数据集大小、模型复杂度和成本等因素,为计算机视觉训练选择合适的云 GPU,并在 Ultralytics Platform 上开展训练。
上个月,我们推出了 Ultralytics Platform,这是一个端到端环境,旨在简化完整的计算机视觉工作流,涵盖从数据集管理到模型训练和部署的各个环节。Ultralytics Platform 将构建和扩展视觉 AI 模型所需的一切整合到统一体验中。
模型训练是这一工作流的重要环节,神经网络在此从数据中学习模式,以生成准确的预测,而获取合适的计算资源也至关重要。此前,我们介绍过 Ultralytics Platform 如何支持由云端图形处理器(GPU)驱动的模型训练,让用户无需管理本地基础设施即可训练计算机视觉模型。
借助按需使用的高性能 NVIDIA GPU,从学生、初创公司到研究人员和大型组织,各类用户都能比以往更高效地运行 AI 工作负载。虽然开始云端训练很简单,但选择合适的 GPU 时,需要考虑数据集大小、模型复杂度和成本等因素。
如今可选方案很多,从高性价比的 RTX GPU,到高性能 NVIDIA H100 和新一代 Blackwell 硬件,选择合适的配置会显著影响模型开发和成本。
本文将介绍如何在 Ultralytics Platform 上进行计算机视觉云端 GPU 训练,以及如何为你的工作负载选择合适的硬件。现在开始吧!
Ultralytics Platform 云端训练概览#
在深入了解如何为 Ultralytics Platform 云端训练选择 GPU 之前,我们先退一步看看云端训练的工作方式。
什么是云端 GPU 训练?#
云端 GPU 训练是指使用托管在云计算环境中的 GPU 来训练机器学习和深度学习模型,而不是依赖自己的本地硬件或工作站。在 Ultralytics Platform 上,你可以按需访问高性能 GPU,并远程运行训练任务,无需自行搭建环境。
这样,你就能根据工作负载轻松扩展资源。你可以按需选择更强大的 GPU 或提升容量,不受自身系统性能的限制。你可以把它理解为访问远程数据中心中的高性能机器或节点,并根据需要扩展或缩减资源。
这样也无需设置和维护昂贵的硬件。你不必购买 GPU、安装驱动程序,也不用处理兼容性问题。
从资源配置到环境设置、编排和运行训练任务,所有工作都由 Ultralytics Platform 通过托管云服务处理,因此你可以专注于训练、实验和改进模型。
模型在 Ultralytics Platform 上的训练方式#
在 Ultralytics Platform 上,GPU 加速训练工作流非常简单。你可以通过多种方式导入自己的数据集。
你可以上传自己的数据、使用平台上的公开数据集,或克隆社区分享的数据集,在现有成果的基础上继续开发。克隆数据集会在你的工作区中创建一个副本,让你能够编辑和扩展它,同时保持原始数据集不变。
选择数据集后,你可以检查并整理图像和标注,确保结构正确。平台还内置了标注工具,可为目标检测、分割和分类等任务标注数据,也可以使用 AI 辅助功能加快这一流程。
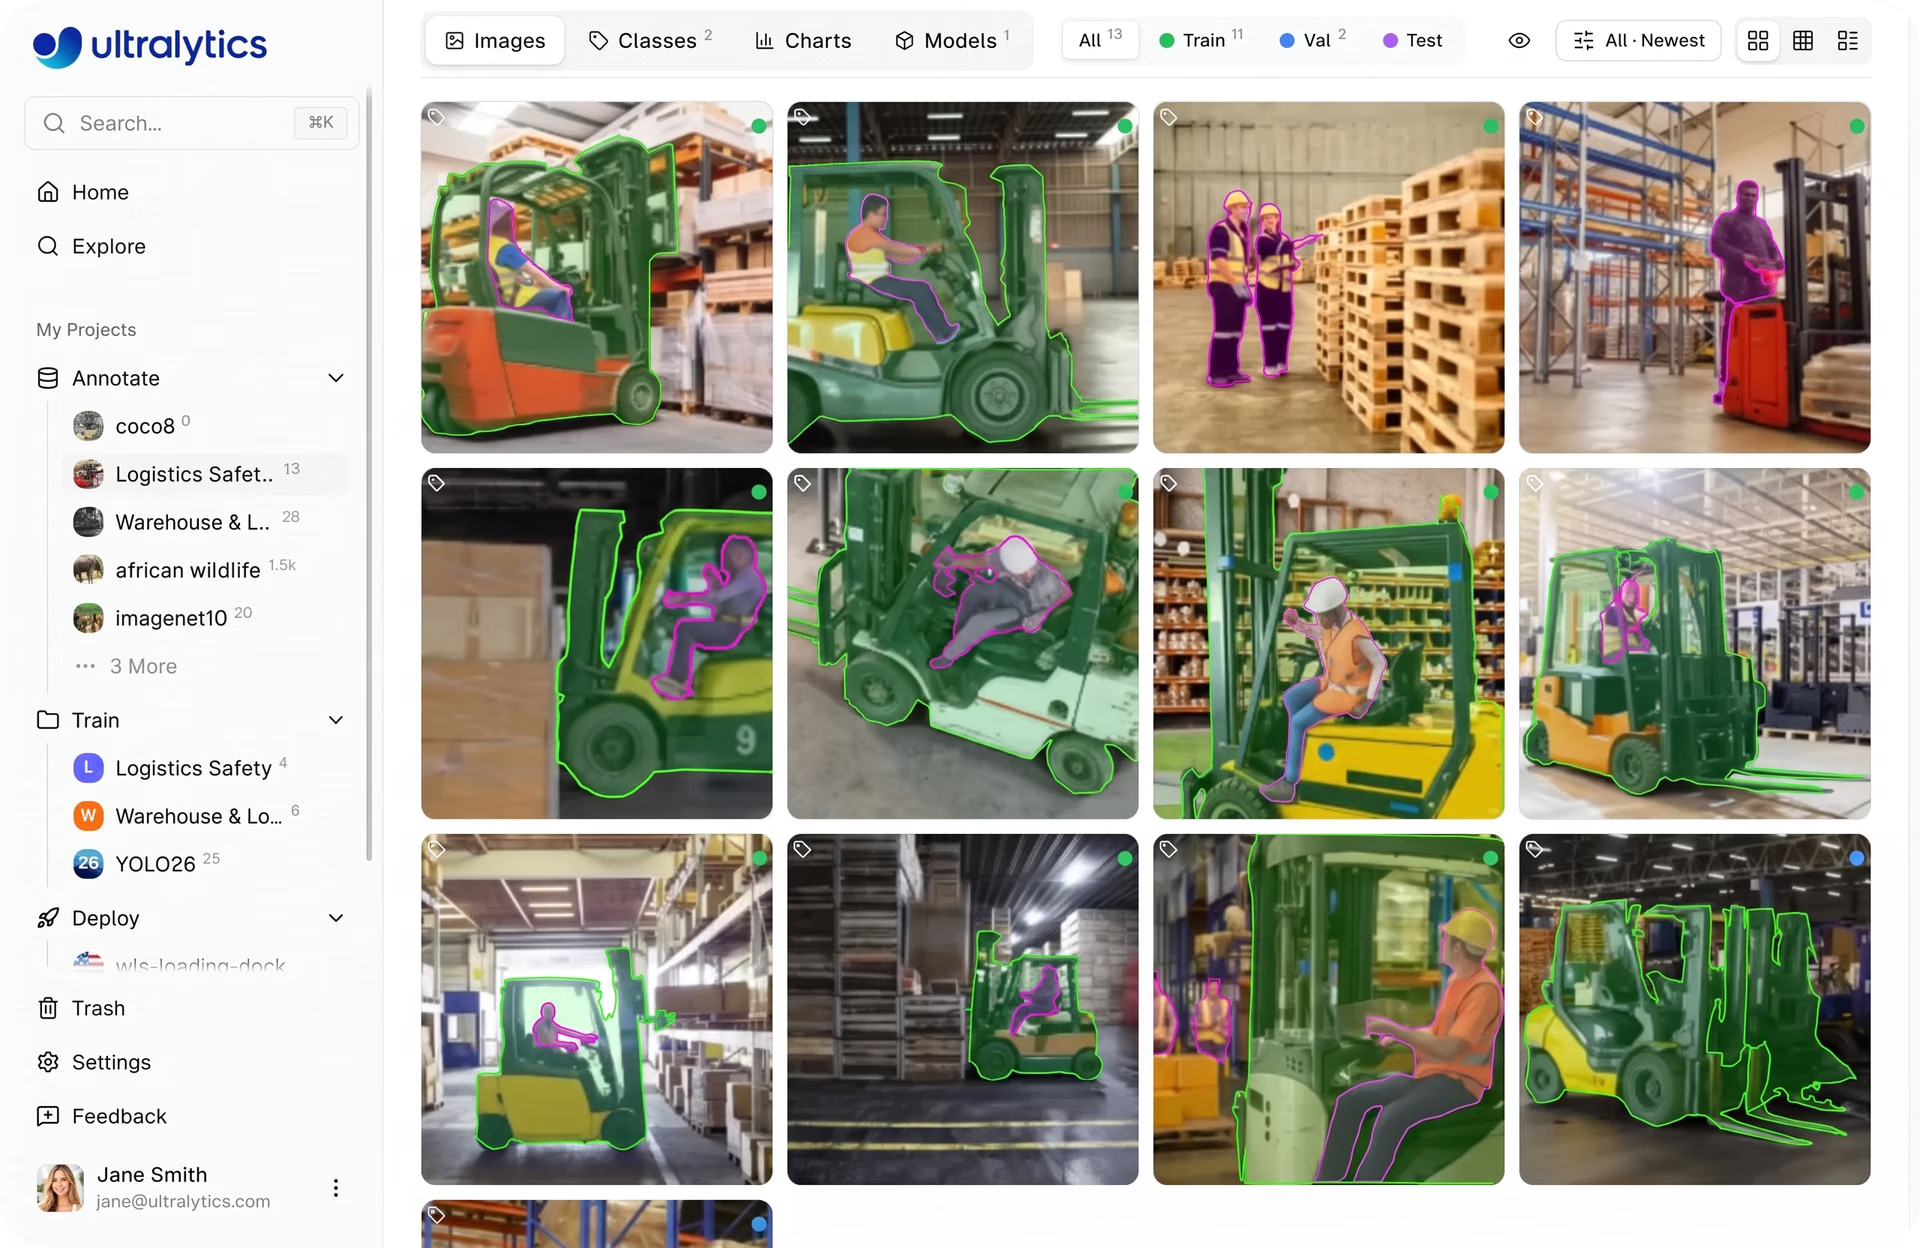
图 1. 在 Ultralytics Platform 中查看数据集(来源)
接下来,你可以选择或创建一个项目来管理训练任务。项目可帮助你整理和比较模型、跟踪性能指标,并将相关实验集中管理。
之后,你可以开始云端训练,选择模型、配置参数,并根据性能和预算需求选择 GPU。底层云基础设施由平台为你管理。
平台会配置你选择的 GPU 实例、准备数据集,并在云端运行训练任务。随着训练进行,你可以实时监控指标、日志和系统性能,无需管理环境设置、CUDA 环境、PyTorch 或 TensorFlow 等框架,也无需管理硬件。
Ultralytics Platform 的 GPU 训练关键功能#
以下是 Ultralytics Platform 上云端 GPU 训练的一些关键功能:
- 一键训练:只需进行少量设置即可启动训练任务,无需复杂配置,就能快速从数据集进入模型训练。
- 按需使用 GPU:根据需求从多种 GPU 选项中进行选择,并可按需扩展资源,无需长期承诺。
- 实时监控:通过实时图表和日志跟踪训练进度,并实时查看 GPU 使用率和内存等系统指标。
- 自动保存检查点:训练进度会定期保存,需要时可以轻松恢复或继续工作。
- 轻松部署:训练完成后,你可以部署训练好的模型,并通过共享推理 API、专用端点在应用或工作流中使用模型,也可以导出模型供外部系统使用。这些部署选项支持低延迟推理,可用于视频分析、自动化系统和交互式 AI 解决方案等实时应用。
Ultralytics Platform 提供的不同云端 GPU 选项#
了解平台上的训练方式后,我们来看看可用的不同 GPU 选项。你选择的 GPU 会影响模型训练速度、性能表现和成本。
Ultralytics Platform 提供丰富的 GPU 选择,从 RTX 2000 Ada 和 RTX A4500 等型号,到 RTX 4000 Ada、RTX A5000、RTX 3090 和 RTX A6000 等 GPU,再到 RTX 4090 和 RTX PRO 6000 等更强大的选项。
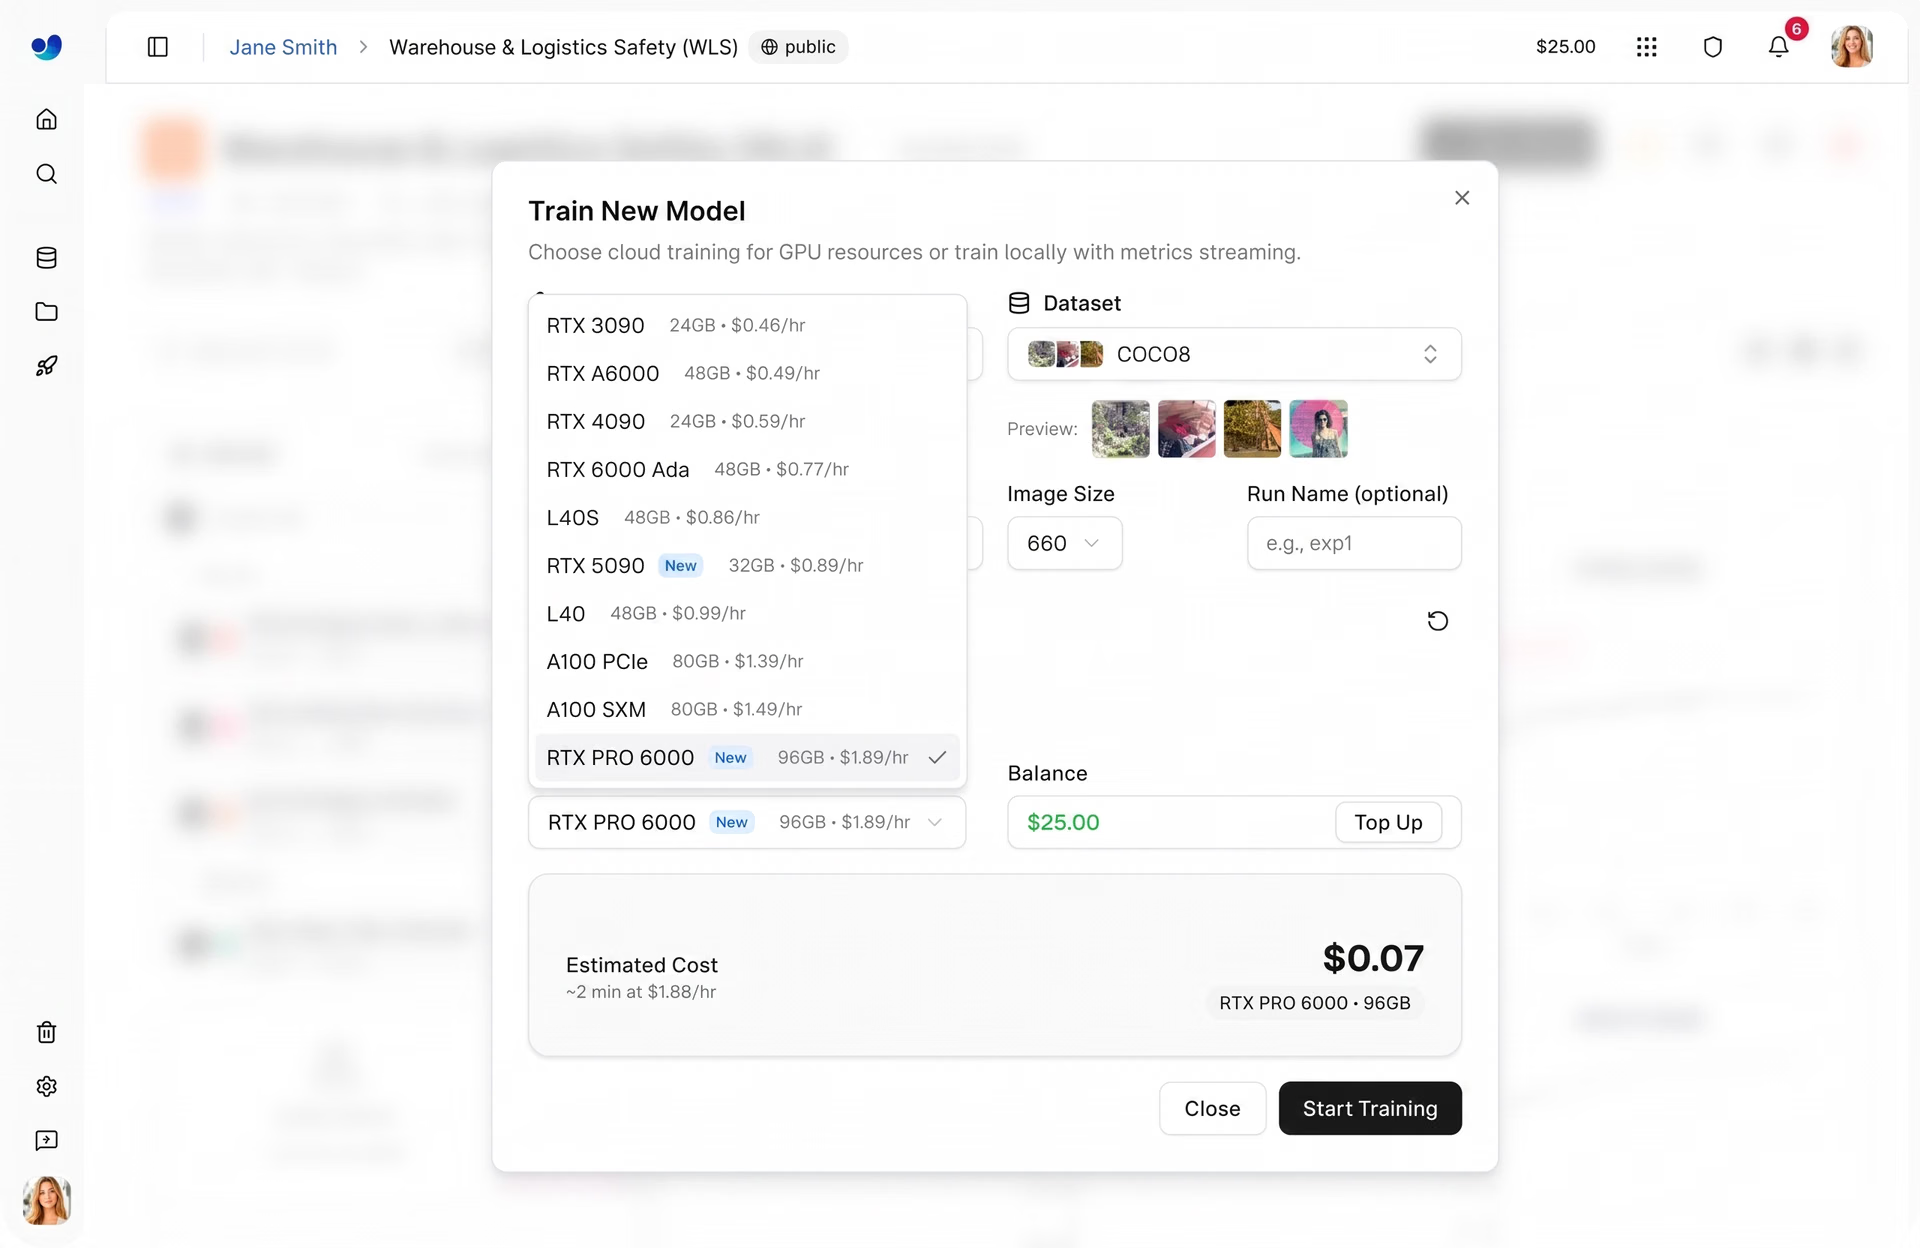
图 2. Ultralytics Platform 支持的不同 GPU 选项示例(来源)
对大多数用户来说,RTX PRO 6000 是一款均衡的默认选择。它无需太多调优,就能在各种工作负载下提供可靠的性能。RTX 4090 也是热门之选,性价比出色。
对于快速实验、原型开发或处理轻量级数据集等小型任务,RTX 2000 Ada 和 RTX A4500 等 GPU 是不错的入门选择。随着工作负载增加,RTX 4000 Ada、RTX A5000 和 RTX 3090 等选项能为常规训练提供更稳定的性能。
高端 GPU 中,A100(Ampere)、H100 和 H200(Hopper),以及 B200(Blackwell)专为大规模工作负载打造。这些 GPU 最适合训练超大型模型、处理海量数据集,或运行对速度和性能要求极高的任务。
了解不同 GPU 类型及其适用场景#
接下来,我们来比较不同类型的 GPU,看看它们分别适合哪些场景。
NVIDIA 的 RTX GPU 通常更具性价比,常用于日常训练、实验以及中小型工作负载。它们兼顾性能和易用性,适用于各种场景。
相比之下,A100、A40 和 L40 等 GPU 专为更繁重的工作负载和大规模训练而设计。它们稳定性和可扩展性更高,尤其适合处理更大的数据集或更复杂的模型。
在高端领域,H100 以及基于 NVIDIA Blackwell 架构的 GPU 代表了较新一代 AI 硬件。这些 GPU 专为高性能工作负载设计,通常用于大规模训练、前沿研究或对时间要求严格的任务。
Ultralytics Platform 提供多种 GPU 选项,可灵活适配不同工作负载。你可以根据需求从较小规模的配置开始,并在需要时扩展。
如何为项目选择合适的云端 GPU#
在 Ultralytics Platform 上为云端训练选择 GPU 时,需要考虑多个因素,包括数据集大小、模型复杂度和成本。下面逐一介绍这些因素。
根据数据集大小匹配 GPU 性能#
选择 GPU 时,数据集大小是主要考量因素之一,因为它会影响训练耗时和所需的计算资源。
对于通常少于 1,000 张图像的小型数据集,RTX 2000 这类轻量级 GPU 往往就够用了。它很适合快速实验和较短的训练任务。
对于约有 1,000 到 10,000 张图像的中型数据集,RTX 4090 或 RTX A6000 等 GPU 能更好地兼顾性能与效率,帮助你更顺畅地训练,避免长时间等待。
对于超过 10,000 张图像的大型数据集,你可能需要更强大的硬件,才能将训练时间控制在合理范围内。H100 等 GPU 更适合处理繁重的工作负载并有效扩展。
总的来说,关键是让数据集大小与你所需的计算能力和并行处理能力相匹配。
根据模型大小和复杂度选择 GPU#
选择 GPU 的另一个重要因素是视觉 AI 模型的大小和复杂度。不同规模的模型需要不同的计算能力。
例如,小型模型所需的 GPU 计算能力较低,可以在 RTX 2000 Ada、RTX A4500 等 GPU 上高效运行;如果你想更快得到结果,RTX 4090 也可以胜任。这些 GPU 非常适合快速实验、原型开发和简单任务,让你无需承担高昂的计算成本,就能更快迭代并测试想法。
另一方面,更大、更复杂的模型需要显著更多的内存和处理能力。RTX A6000、RTX PRO 6000 和 H100 等高端 GPU 更适合这类工作负载。它们能够处理更庞大的架构、缩短训练时间并避免内存问题;在处理高分辨率图像、大批量数据或更先进的模型设计时,这一点尤其重要。
比较批量大小与 GPU 内存#
同样,批量大小在模型训练中也发挥着重要作用。它指的是模型在单个步骤中一次处理的训练样本数量。
较大的批量大小可以一次处理更多数据,从而提升训练效率,但也需要更多 GPU 内存(显存)。通常,内存带宽更高的 GPU 能够支持更大的批量大小,而内存较少的 GPU 可能需要使用较小的批量。
例如,RTX A6000、RTX PRO 6000 或 A100 等 GPU 的内存更大,因此更容易处理较大的批量;而 RTX 4090 或 RTX 2000 Ada 等选项可能需要根据工作负载使用较小的批量。
不过,并非总是需要使用最大规格的 GPU。高端 GPU 能提升速度和容量,但成本也更高。在很多情况下,在较小的 GPU 上调整批量大小会更高效。
归根结底,目标是根据模型和数据集,在批量大小、可用 GPU 内存和成本之间找到合适的平衡。
训练配置对 GPU 性能的影响#
影响 GPU 性能的另一个因素是训练配置,其中包括训练轮数、图像尺寸以及其他控制模型训练方式的设置。
例如,增大图像尺寸会增加每个步骤所需的计算量。这会减慢训练速度,也可能需要更多计算能力或内存才能保持良好的性能。
同样,增加训练轮数会延长总训练时间,尤其是在性能较弱的硬件上。一个训练轮次指训练期间完整遍历整个数据集一次。
数据增强等技术也会增加训练期间的处理量。数据增强通过翻转、旋转或缩放等变换来增加数据多样性并提升模型性能。虽然这能增强模型的鲁棒性,但也可能降低训练速度。
通常,更强大的 GPU 能更高效地应对这些额外需求,但具体影响取决于整体配置和工作负载。
平衡成本与训练时间#
为项目选择 GPU 时,训练速度和 GPU 价格之间往往需要权衡。
Ultralytics Platform 让你能够在启动训练任务之前轻松估算并了解成本。根据数据集大小、模型和 GPU 等配置,你可以提前查看预计费用和训练时长。
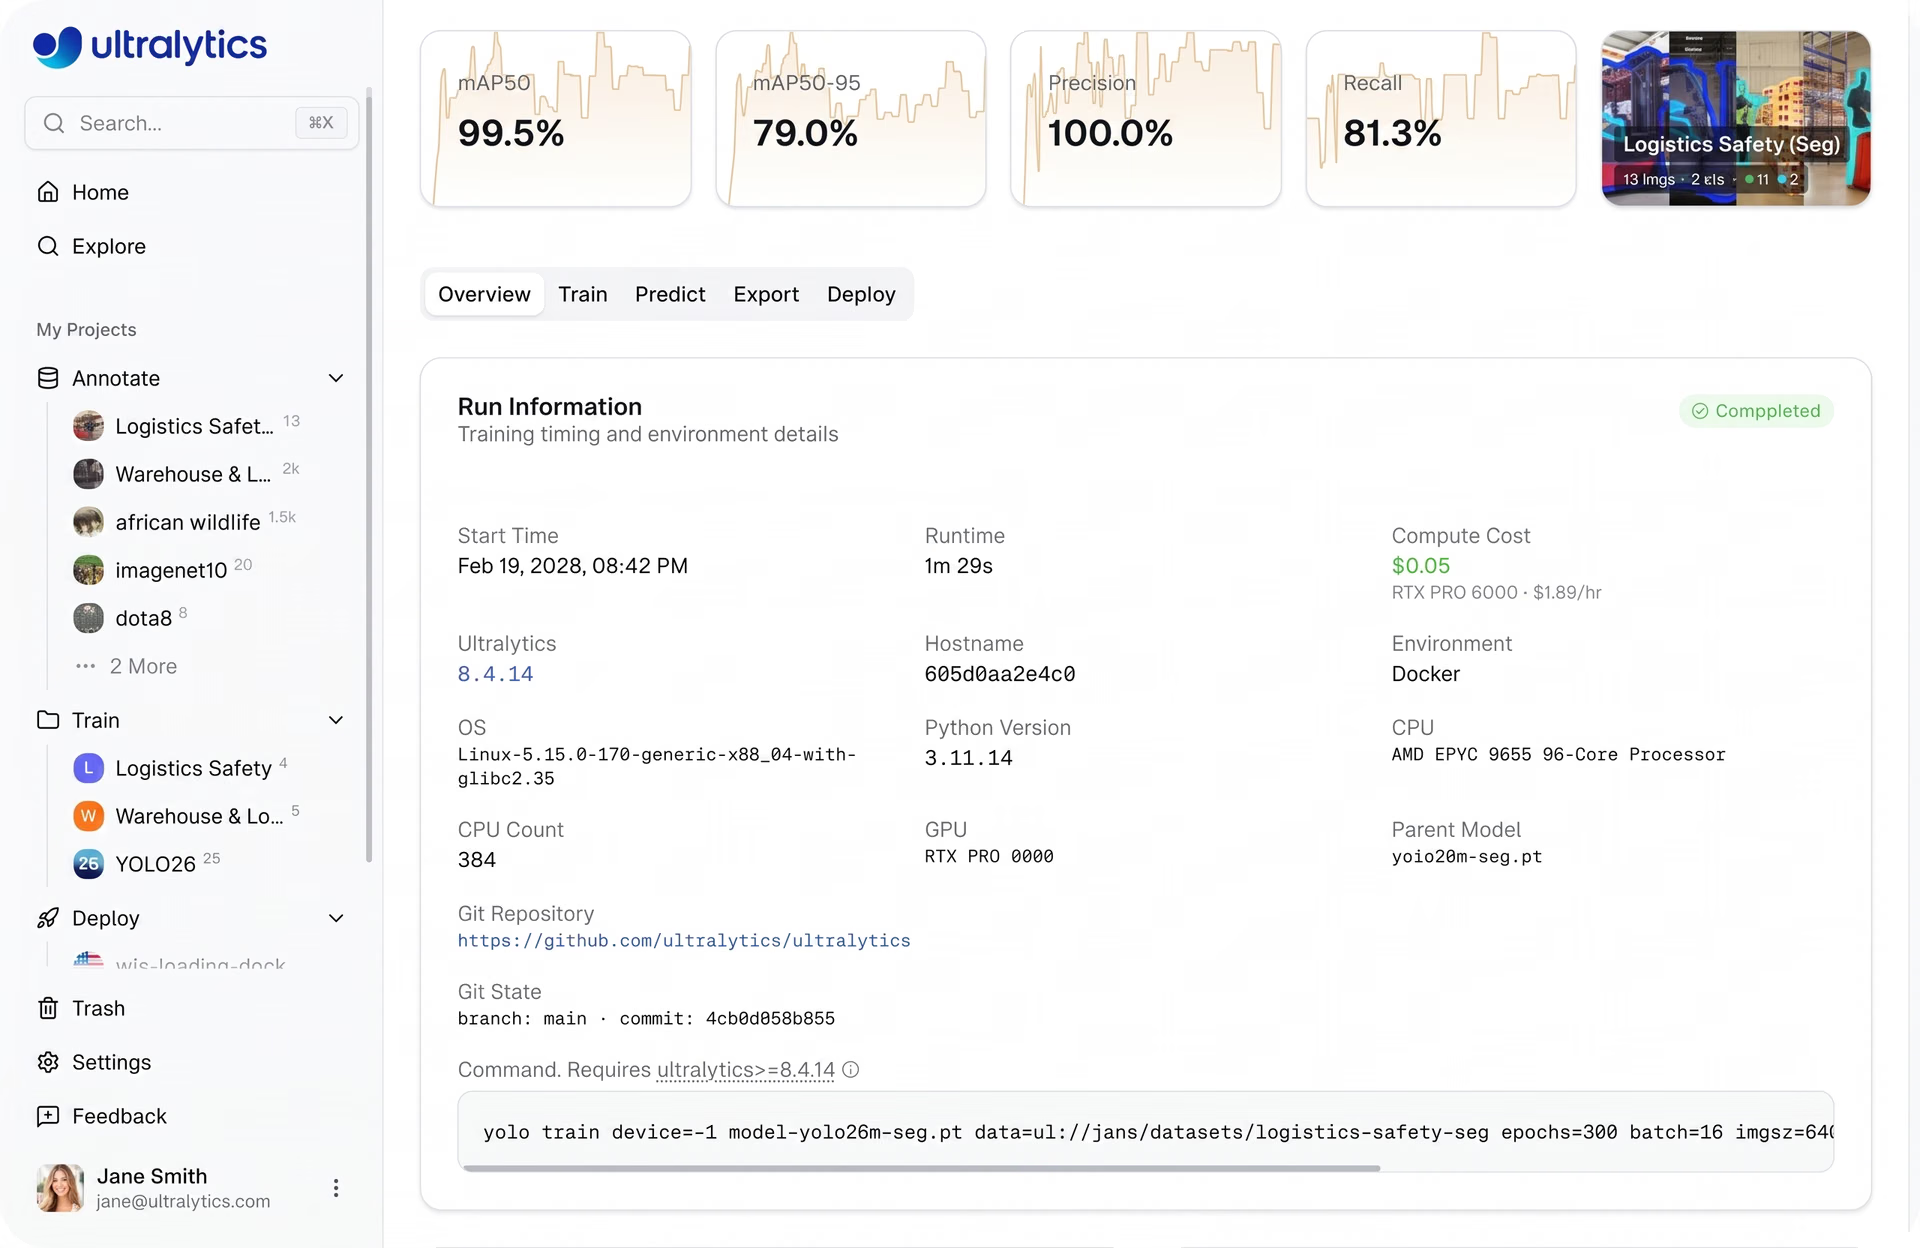
图 3. Ultralytics Platform 让云端成本易于估算和了解。(来源)
速度更快的 GPU 通常每小时费用更高,但能缩短整体训练时间。RTX 4090、RTX PRO 6000 和 H100 等 GPU 通常性能更强,因此能够更快完成训练。
速度较慢的 GPU 通常每小时费用较低,但完成训练需要更长时间。例如,RTX 2000 Ada 和 RTX A4500 等 GPU 常用于较小的工作负载或运行时间较长、优先考虑低成本的任务。
此外,H200 和 B200 等部分顶级 GPU 仅向 Pro 或 Enterprise 方案用户提供,而大多数其他选项在 Free 方案中也可以使用。
了解成本优化策略#
除了选择合适的 GPU,还有一些实用方法可以控制训练成本。最有效的方法之一是在扩大规模之前,先进行小规模测试运行。
与其直接开始完整训练,不如先减少 epoch 数,确认设置符合预期。这有助于你快速验证数据、标注和模型配置,并避免在可能无法产生有用结果的运行上浪费时间和计算资源。
随着训练推进,密切关注各项指标;如果性能趋于平稳或不再提升,就提前停止运行。监控训练曲线有助于你决定是继续训练还是调整设置。
你还可以调整批次大小和图像尺寸等参数。较小的取值会降低内存和计算资源用量,让你更便于进行实验、测试不同配置,或在扩展规模前运行小规模模拟。
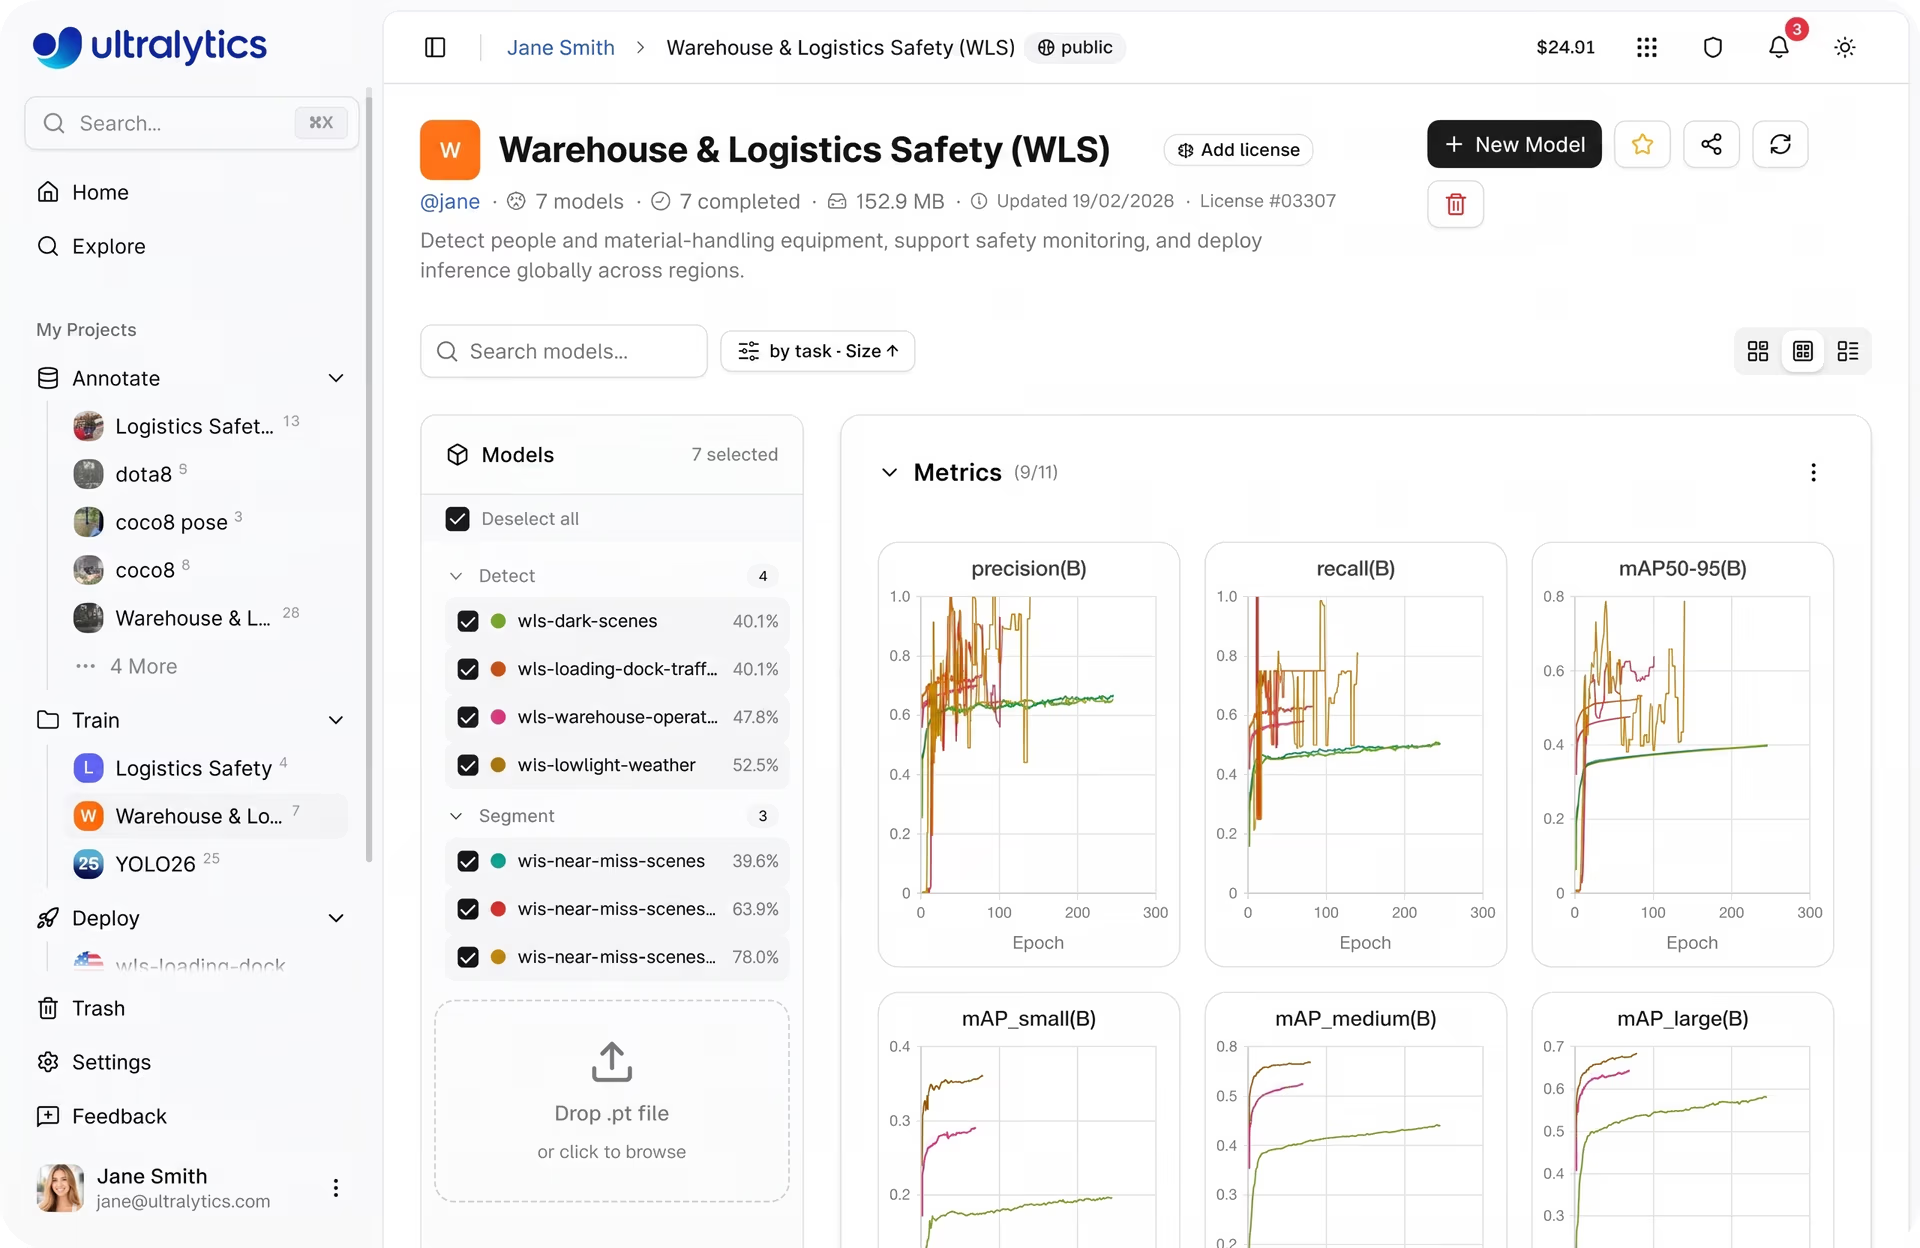
图 4. Ultralytics Platform 上的训练指标可视化(来源)
此外,Ultralytics Platform 还可以简化成本管理。平台内置成本估算功能,让你在启动任务前了解预期费用。
平台采用按使用量付费的积分制,你只需为实际使用的计算时长付费。这样更容易控制在预算范围内,并在确认训练设置可靠后扩展规模。
计算机视觉云 GPU 训练的最佳实践#
以下是在 Ultralytics Platform 上进行云 GPU 训练时值得牢记的一些最佳实践:
- 训练前验证数据集:开始训练前,确保数据集干净、标注完善且一致。及早发现问题有助于避免浪费计算资源,并提升模型性能。
- 先进行快速实验:先用较少的 epoch 运行小规模测试,验证设置是否正确。这样可以及早发现问题,无需投入耗时且昂贵的训练任务。从某种意义上说,你是在创建一个可复用的模板;一切按预期运行后,就可以据此扩展规模。
- 监控关键指标:在训练过程中跟踪 loss、mAP、precision 和 recall 等指标。这些指标可作为评估模型性能的基准,并帮助你决定何时调整或停止训练。
- 保持数据处理流水线高效:确保数据加载和预处理过程高效,因为这些操作依赖 CPU 资源,可能成为影响整体训练性能的瓶颈。
- 使用内置工具:利用图表、控制台日志和系统指标实时监控训练,并迅速做出明智决策。
要点#
要在 Ultralytics Platform 上为计算机视觉选择合适的云 GPU,关键在于了解你的工作负载,包括数据集大小、模型复杂度和训练配置。平台提供多种由云基础设施和虚拟机驱动的 GPU 选项,你可以先选择均衡的配置,并随着模型训练或微调需求增长逐步扩展。将合适的硬件与监控和成本控制等良好实践结合起来,你就能高效训练先进的人工智能模型,同时充分利用高性能计算的灵活性。
访问不断壮大的社区和我们的 GitHub 代码库,了解更多计算机视觉知识。如果你想构建视觉解决方案,可以查看我们的许可选项。浏览我们的解决方案页面,进一步了解计算机视觉在制造业中的应用和 AI 在农业中的应用所带来的益处。








