如何使用 Ultralytics Platform 在 Amazon S3 数据上训练 YOLO 并部署托管 API
与 SageMaker 相比,逐步了解如何使用 Ultralytics Platform 在 Amazon S3 存储桶中的图像上训练 Ultralytics YOLO26,并将其部署为托管 API。
 Miles Deans9 分钟阅读
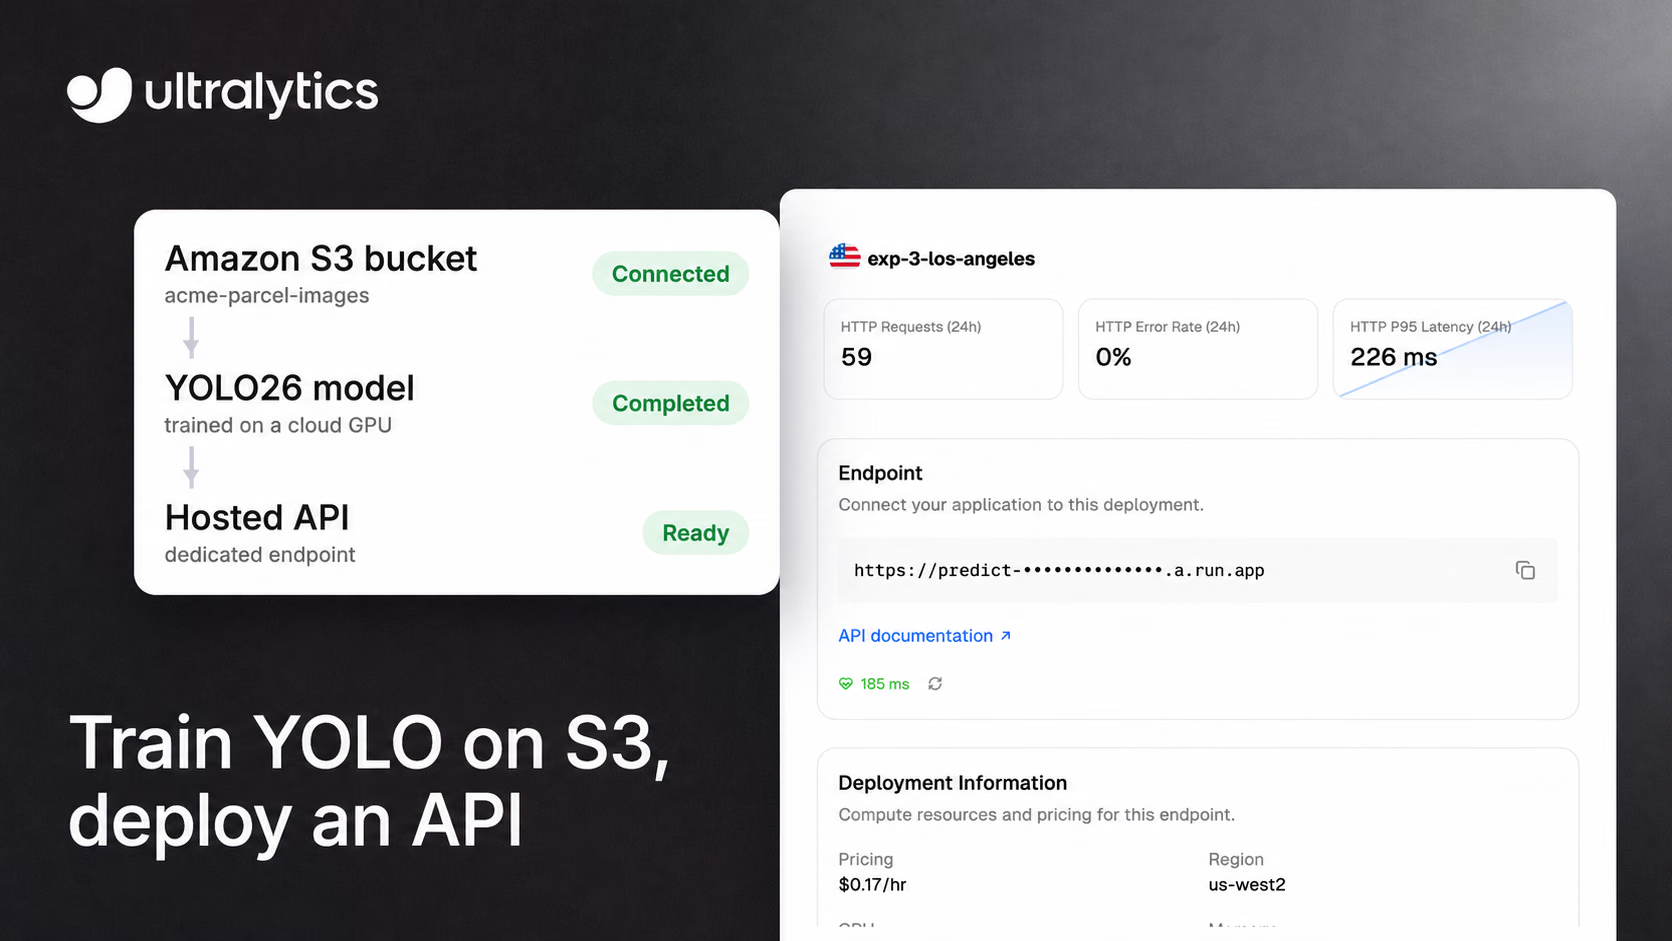
如果你的图像已经存放在 Amazon S3 存储桶中,你可以直接在这些图像上训练 Ultralytics YOLO 模型,并将其部署为托管 API,无需再上传一份数据集副本。Ultralytics Platform 会就地索引存储桶,让你在云 GPU 上标注并训练 YOLO26,还能将训练好的模型部署到专用端点,通过 HTTPS 调用。本指南将带你逐步完成整个流程,从 IAM 策略到首次预测,并将这一工作流程与 Amazon SageMaker、Google Vertex AI 和 Azure Machine Learning 进行比较。
同样的流程也适用于 Google Cloud Storage 和 Azure Blob Storage,只需用服务账户 JSON 密钥或账户访问密钥连接字符串替代 AWS 访问密钥。
工作流程如何衔接#
整个流程分为五个阶段。原始图像保留在你的存储桶中,云端训练期间会使用临时副本:
- 连接一个使用只读 IAM 用户的 S3 存储桶。
- 索引一个文件夹作为 Platform 数据集。Platform 会读取图像尺寸和找到的 YOLO 标签,不会另存一份图像副本。
- 标注浏览器中的图像,或保留存储桶中已有的 YOLO 标签。
- 训练在云 GPU 上训练 YOLO26 模型。训练期间会使用图像的临时副本。
- 部署将模型部署到 42 个区域之一的专用端点,并使用 API 密钥向其发送图像。
系统会根据标签的形式识别检测、分割、姿态和有向边界框(OBB)数据集,因此同样的步骤适用于每种计算机视觉任务。
开始之前:套餐、权限和数据边界#
你需要准备三项内容:
- Pro 或 Enterprise 工作区。 Amazon S3、Google Cloud Storage 和 Azure Blob Storage 数据集需要Pro 或 Enterprise 套餐。Pro 每个席位每月收费 $29,并每月为每个席位提供 $30 的额度,用于云端训练等按量计费的计算。
- 工作区管理员或所有者角色,连接云存储时需要此角色。
- 一个 AWS IAM 用户,能够列出并读取存储桶。
连接之前,最好先了解哪些数据会离开存储桶。Platform 会按需传输原始图像以供浏览和标注,索引的图像不会计入 Platform 存储配额。每个连接都有一个默认开启的 AI 功能开关。开启时,Ultralytics GPU 可以读取图像,用于标注、相似图像搜索和云端训练。外部 AI 提供商也可能使用你工作区的提供商密钥处理付费标注模型的图像;启用写入权限后,也可能处理图像生成任务。云端训练期间会使用临时副本;相似图像搜索会保留嵌入,直到图像从 Platform 中移除。关闭开关后,不会启动新的 AI 任务(已在运行的任务会继续完成),但手动标注和本地训练仍可使用。Platform 绝不会修改或删除你的对象。
步骤 1:创建只读 IAM 用户#
在 AWS 控制台中,前往 IAM > Users,创建一个没有控制台访问权限的用户,并附加一项授予存储桶列表和读取权限的策略:
{
    "Version": "2012-10-17",
    "Statement": [
        { "Effect": "Allow", "Action": "s3:ListAllMyBuckets", "Resource": "*" },
        {
            "Effect": "Allow",
            "Action": ["s3:ListBucket", "s3:GetObject"],
            "Resource": ["arn:aws:s3:::my-bucket", "arn:aws:s3:::my-bucket/*"]
        }
    ]
}
s3:ListAllMyBuckets 是可选项。它能让 Platform 发现你的存储桶,这样你就不必手动输入存储桶名称。
然后打开该用户的 Security credentials 选项卡并创建访问密钥。Platform 需要长期有效的 IAM 用户密钥:它会拒绝临时 AWS STS 凭证,包括角色会话凭证和 IAM Identity Center 密钥,因为数据集仍处于连接状态时,这些凭证可能会过期。请为此创建专用用户,绝不要使用根用户凭证。Platform 使用 AES-256-GCM 对静态密钥进行加密,绝不会将其暴露给训练工作负载;你也可以随时在 IAM 中停用该密钥以撤销访问权限。
步骤 2:将存储桶连接到 Ultralytics Platform#
- 在 Platform 中,前往 Settings > Integrations,然后选择 Amazon S3。
- 输入访问密钥 ID、秘密访问密钥和存储桶区域,例如
us-east-1。 - 点击 Find available buckets 并选择要连接的存储桶;如果策略不允许发现存储桶,也可以输入存储桶名称。
- 点击 Connect。Platform 会先检查是否能够列出并读取每个存储桶,然后才保存任何内容。
一个连接只能读取一个区域中的存储桶,因此如果数据分布在多个区域,请为每个区域分别连接。Amazon S3 集成指南介绍了图像生成所需的可选写入权限。
步骤 3:从存储桶创建数据集#
点击 New Dataset,打开 Cloud 选项卡,选择存储桶,浏览到包含数据的文件夹,然后创建数据集。Platform 会列出该文件夹并对找到的内容进行索引:
- 图像:
.jpg、.jpeg、.png、.webp和.avif对象。 - 标签: YOLO
.txt文件,按标准的images/到labels/目录结构匹配,或作为与每张图像同目录的文件匹配。 - 类别:
data.yaml文件提供类别名称,与常规 YOLO 数据集相同。 - 数据划分:
train、val和test文件夹名称会自动指定数据划分。
单次导入最多可索引 500,000 个对象,因此较大的存储桶应拆分到多个数据集中。请将已索引对象视为不可变对象:每张图像都会绑定到其 S3 对象 ETag,若对象被覆盖,Platform 就会停止提供该图像。由于数据集创建时只构建一次索引,之后若要添加数据,请上传新对象并创建新数据集。
步骤 4:标注或检查图像#
打开数据集,在标注编辑器中检查导入的标签。如果存储桶中还没有标签,你可以手动绘制框和掩码;或者在启用 AI 功能后,使用智能标注(SAM 用于检测、分割和 OBB,YOLO 用于姿态)及自动标注来加快处理。标签会存储在 Platform 中,存储桶对象则保持不变。
步骤 5:在云 GPU 上训练 YOLO26#
在数据集或项目中点击 New Model,选择基础模型并启动云端运行:
- 基础模型:选择官方 Ultralytics 模型(推荐使用 YOLO26),也可以选择自己的模型进行微调。列表中只会显示与数据集任务兼容的模型。
- 参数:设置训练轮数、图像尺寸和批量大小,或保留默认值。
- GPU:从 Ultralytics Cloud 中选择 GPU。启动前,对话框会显示每小时费率,并估算运行时长和总成本。我们的云 GPU 选择指南有助于你权衡取舍。
运行期间,指标、控制台输出和系统图表会持续传输到浏览器,检查点也会自动保存。训练完成后,模型页面会显示其指标;如果已有验证结果,还会显示详细分析,例如混淆矩阵。
步骤 6:将模型部署为托管 API#
打开模型的 Deploy 选项卡。地图和表格会列出 42 个区域,并按测得的地理位置延迟排序。在所需区域点击 Deploy,查看 CPU、内存和价格,然后点击 Create Deployment。
你选择的规格决定计费方式:
- 默认规格(1 vCPU、2 GiB):免费,空闲时会缩容至零。
- 自定义规格(最高 8 vCPU 和 32 GiB):会保留一个预热实例,并按显示的区域每小时费率计费,从服务就绪开始,直到你停止端点为止,包括空闲时间。
每个专用端点都是独立租户服务,拥有自己的 URL 和监控功能,并绑定到你工作区的一个 API 密钥。免费工作区最多可运行 3 个部署,Pro 最多 10 个,Enterprise 则没有数量限制。如需了解何时应选择专用端点而非共享推理,请参阅我们的专用推理与共享推理指南。
步骤 7:调用端点#
使用 python -m pip install requests 安装 Requests,并将图像保存为 image.jpg。将示例 URL 替换为你复制的部署 URL,并在末尾添加 /predict;然后将 YOUR_API_KEY 替换为绑定到该部署的密钥:
import requests

url = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
headers = {"Authorization": "Bearer YOUR_API_KEY"}
data = {"conf": 0.25, "iou": 0.5, "imgsz": 640}

with open("image.jpg", "rb") as f:
    response = requests.post(url, headers=headers, data=data, files={"file": f})

print(response.json())
使用 cURL 发送相同请求:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -F "file=@image.jpg" \
  -F "conf=0.25" \
  -F "iou=0.5" \
  -F "imgsz=640"
每个端点还会在 /docs 提供交互式 API 参考,并提供 /health 检查。直接请求不受 Platform API 速率限制,但每个端点只有一个实例:无法及时处理的请求会收到带有 Retry-After 标头的 429,请求正文限制为 32 MB。端点上线后,你可以在部署页面监控请求、错误和延迟。
成本、限制和安全性一览#
| 项目 | 预期情况 |
|---|---|
| 套餐 | S3、Google Cloud Storage 和 Azure Blob 数据集需要 Pro(每席位每月 $29)或 Enterprise 套餐 |
| 存储 | 已索引的图像保留在你的存储桶中,不占用 Platform 存储配额 |
| 训练 | 按 GPU 使用时长从额度中扣费;启动前,对话框会估算费用 |
| 端点 | 默认规格免费并缩容至零;自定义规格在运行期间按小时计费 |
| 导入规模 | 每次导入最多 500,000 个对象 |
| 凭证 | 长期有效的 IAM 用户密钥,静态加密,绝不暴露给训练工作负载 |
| S3 数据集不支持 | 克隆数据集、创建版本快照、模糊处理人脸、从其他数据集粘贴图像 |
Ultralytics Platform 与 SageMaker、Vertex AI 和 Azure ML 对比#
通用云 ML 平台也可以在其自有存储中的数据上训练模型并提供模型服务。下方的存储和服务方式列依据各平台文档整理;最后一列是我们的评估。
| 平台 | 训练数据所在位置 | 服务选项 | 适用场景建议(我们的评估) |
|---|---|---|---|
| 搭配 Ultralytics YOLO 使用的 Ultralytics Platform | 直接从 S3、Google Cloud Storage 或 Azure Blob 就地索引 | 在 42 个区域提供专用单实例端点;默认规格可缩容至零 | 希望无需编写训练或服务代码,即可从存储桶到 API 完成 YOLO 检测、分割、姿态或 OBB 的团队 |
| Amazon SageMaker AI | 训练任务从 Amazon S3、Amazon EFS 或 Amazon FSx for Lustre 读取数据 | 提供实时端点、自动扩缩、无服务器和异步推理 | 已在 AWS 上运行 ML 流水线,并希望自行选择容器和服务选项的团队 |
| Google Vertex AI | 无服务器训练任务会将可访问的 Cloud Storage 存储桶挂载到 /gcs/ 下 | 用于在线推理的托管端点 | 已采用 Google Cloud 数据和工具链的团队 |
| Azure Machine Learning | 数据存储会引用现有 Azure 存储,例如 Blob Storage | 用于实时推理的托管在线端点 | 已采用 Azure 的团队 |
SageMaker 的训练数据文档列出了 S3、EFS 和 FSx for Lustre 作为数据源,并提供流式和下载两种输入模式。无服务器推理会自动管理扩缩,适合存在空闲时段且能够容忍冷启动的流量;你可以使用 SageMaker 提供的容器,也可以自行提供容器。Vertex AI支持在预构建容器或自定义容器中通过 Python 应用运行自定义训练;Azure Machine Learning则通过数据存储连接现有 Azure 存储,并使用托管在线端点提供模型服务。通用平台的优势正在于这种广泛的能力。我们的评估是,自定义 YOLO 工作流程需要更多配置;容器要求取决于所选的训练和服务选项。如果你想继续使用 AWS,我们的 SageMaker 部署指南介绍了如何在那里部署 YOLO 模型。
Ultralytics Platform 的设计目标更为专注。它围绕 Ultralytics YOLO 模型构建,因此上述步骤可以替代训练脚本和服务容器。如果你的组织要求每个集成都使用临时 STS 凭证,或者单个端点必须在高并发负载下扩展到多个实例,那么它就不太适合。如果你还在考虑推理应在哪里运行,我们的云端与自托管指南会比较成本、延迟和数据控制。
常见问题
Ultralytics Platform 可连接 S3 存储桶、就地索引图像、在云 GPU 上训练 YOLO26,并将模型部署到专用 HTTPS 端点。Amazon SageMaker AI 也支持从 S3 训练,并提供实时、无服务器和异步推理;具体使用 SageMaker 提供的容器还是自定义容器,取决于服务选项。Google Vertex AI 和 Azure Machine Learning 也提供类似的工作流程,但围绕各自的存储构建:Vertex AI 使用 Cloud Storage,Azure Machine Learning 使用 Azure 存储,而不是现有的 S3 存储桶。
Platform 不会保留另一份数据集副本:它会索引图像,并按需传输原始图像。启用 AI 功能后,云端训练期间会在存储桶之外使用临时副本,相似图像搜索则会保留每张图像的嵌入。Platform 绝不会修改或删除你的对象。
目前不行。Platform 需要来自专用 IAM 用户的长期有效访问密钥,并会拒绝 STS 凭证,因为数据集保持连接期间这些凭证可能会过期。请将该用户的权限限制为仅能列出和读取,并在 IAM 中停用密钥以撤销访问权限。
S3 数据集需要 Pro(每席位每月 $29,并为每个席位提供 $30 的月度额度)或 Enterprise 套餐。训练按 GPU 使用时长计费,训练对话框会在启动前估算费用。默认端点规格免费,并会缩容至零;自定义规格在运行期间按小时计费。
可以。Google Cloud Storage 使用服务账号 JSON 密钥和 Storage Object Viewer 角色进行连接,Azure Blob Storage 则使用 HTTPS 账户访问密钥连接字符串进行连接(不接受 SAS 令牌字符串)。数据集、训练和部署步骤都相同。
数据集创建时只会建立一次索引,因此不会自动纳入新对象。请添加新对象,而不要覆盖现有对象,然后创建一个包含这些对象的新数据集,再次训练或微调模型。
可以。在模型页面下载权重,或将模型导出为 ONNX、TensorRT 和 CoreML 等格式,然后使用 Ultralytics Python 包在自己的服务器或边缘设备上运行模型。
作者
评论
提出问题、分享你的结果,或帮助其他人。









