أفضل نماذج اكتشاف الكائنات
استكشف أفضل نماذج اكتشاف الكائنات في عام 2026، من Ultralytics YOLO إلى RT-DETR، مع مقارنة البنى ومفاضلات الأداء وعوامل النشر.
 Abirami Vina11 دقيقة قراءة
في وقت سابق من هذا العام، قدم Andrew Ng، الرائد في مجال الذكاء الاصطناعي والتعلم الآلي، مفهوم اكتشاف الأجسام بالوكلاء. ويستخدم هذا النهج وكيلًا استدلاليًا لاكتشاف الأجسام استنادًا إلى مطالبة نصية، من دون الحاجة إلى كميات هائلة من بيانات التدريب.
إن القدرة على تحديد الأجسام في الصور ومقاطع الفيديو دون الحاجة إلى مجموعات بيانات موسومة ضخمة تمثل خطوة نحو أنظمة رؤية حاسوبية أذكى وأكثر مرونة. غير أن ذكاء الرؤية الاصطناعي القائم على الوكلاء لا يزال في مراحله الأولى.
مع أنه قادر على التعامل مع مهام عامة، مثل اكتشاف الأشخاص أو لافتات الشوارع في صورة ما، فإن تطبيقات الرؤية الحاسوبية الأكثر دقة لا تزال تعتمد على نماذج اكتشاف الأجسام التقليدية. وتُدرّب هذه النماذج على مجموعات بيانات كبيرة وموصوفة بعناية لتتعلم بدقة ما ينبغي البحث عنه ومواقع الأجسام.
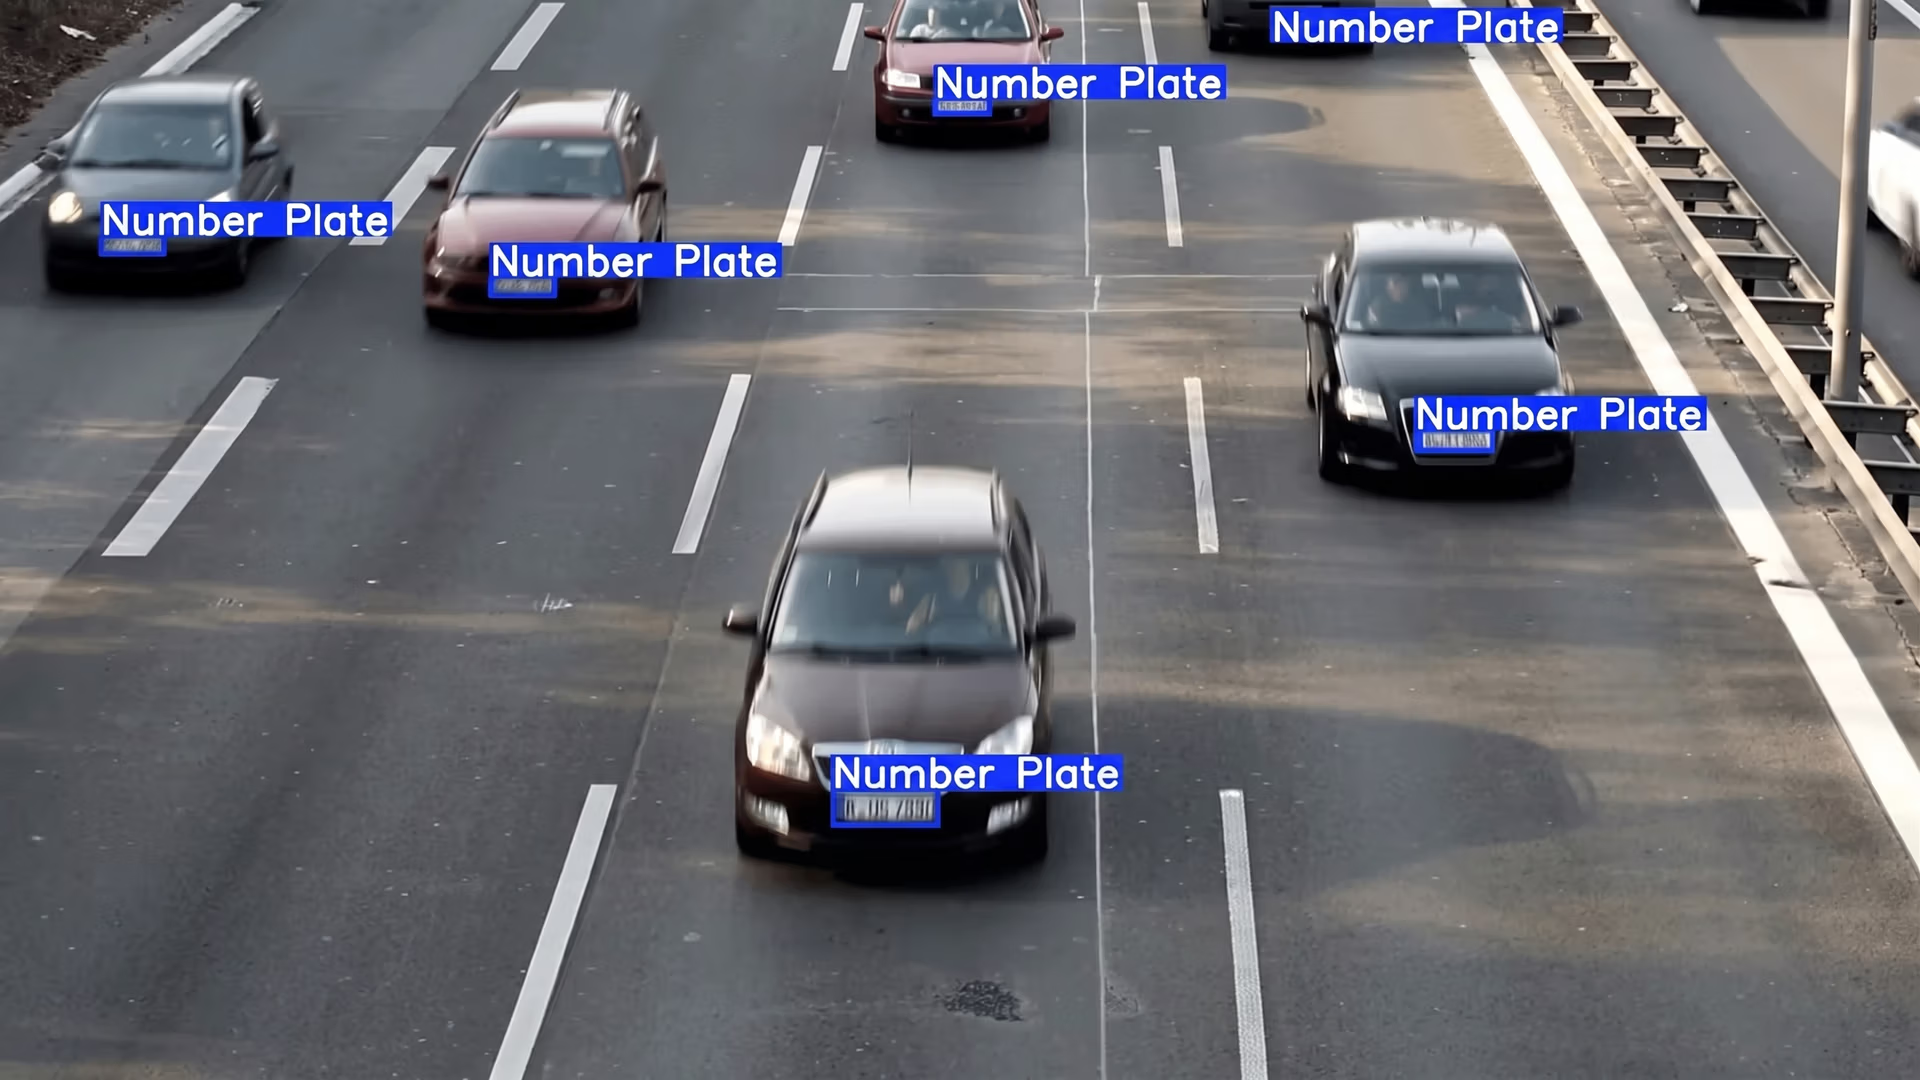
الشكل 1. مثال على اكتشاف الأجسام. (المصدر)
يكتسب اكتشاف الأجسام التقليدي أهمية أساسية لأنه يجمع بين التعرف، أي تحديد ماهية الجسم، وتحديد الموقع، أي معرفة موقعه الدقيق في الصورة. ويتيح هذا الجمع للآلات تنفيذ مهام معقدة في العالم الحقيقي بموثوقية، بدءًا من المركبات ذاتية القيادة وصولًا إلى الأتمتة الصناعية والتشخيص الطبي.
تواصل نماذج اكتشاف الأجسام التحسن، فتصبح أسرع وأدق وأكثر ملاءمة للبيئات الواقعية. وسنتناول في هذه المقالة بعضًا من أفضل نماذج اكتشاف الأجسام المتاحة اليوم.
الحاجة إلى اكتشاف الأجسام#
يمكن استخدام مهام الرؤية الحاسوبية مثل تصنيف الصور لمعرفة ما إذا كانت الصورة تحتوي على سيارة أو شخص أو جسم آخر. لكنها لا تستطيع تحديد موقع الجسم داخل الصورة.
هنا يأتي دور اكتشاف الأجسام. إذ تستطيع نماذج اكتشاف الأجسام تحديد الأجسام الموجودة ومواقعها الدقيقة أيضًا. وتتيح هذه العملية، المعروفة باسم تحديد الموقع، للآلات فهم المشاهد بدقة أكبر والاستجابة على نحو مناسب، سواء أكان ذلك بإيقاف سيارة ذاتية القيادة أم بتوجيه ذراع روبوتية أم بإبراز منطقة في صورة طبية.
أحدث ظهور التعلم العميق تحولًا في اكتشاف الأجسام. فبدلًا من الاعتماد على قواعد مكتوبة يدويًا، تتعلم النماذج الحديثة الأنماط مباشرةً من التعليقات التوضيحية والبيانات المرئية. وتعلّم مجموعات البيانات هذه النماذج أشكال الأجسام، والمواضع التي تظهر فيها عادةً، وكيفية التعامل مع تحديات مثل الأجسام الصغيرة والمشاهد المزدحمة وظروف الإضاءة المتغيرة.
وفي الواقع، تستطيع أنظمة اكتشاف الأجسام المتطورة اكتشاف عدة أجسام بدقة في الوقت نفسه. وهذا يجعل اكتشاف الأجسام تقنية أساسية في تطبيقات مثل القيادة الذاتية والروبوتات والرعاية الصحية والأتمتة الصناعية.
آلية عمل مهام اكتشاف الأجسام#
مدخل نموذج اكتشاف الأجسام هو صورة، قد تأتي من كاميرا أو إطار فيديو أو حتى تصوير طبي. وتُعالج الصورة المُدخلة عبر شبكة عصبية، عادةً ما تكون شبكة عصبية التفافية (CNN)، مدرّبة على التعرف على الأنماط في البيانات المرئية.
تُحلل الصورة داخل الشبكة على مراحل. وبناءً على السمات التي يكتشفها، يتنبأ النموذج بالأجسام الموجودة ومواضع ظهورها.
تُمثّل هذه التنبؤات باستخدام مربعات الإحاطة، وهي مستطيلات تُرسم حول كل جسم مكتشف. ويُسند النموذج إلى كل مربع إحاطة تصنيفًا للفئة (مثل سيارة أو شخص أو كلب) ودرجة ثقة تشير إلى مدى يقينه من التنبؤ (ويمكن أيضًا اعتبارها احتمالًا).
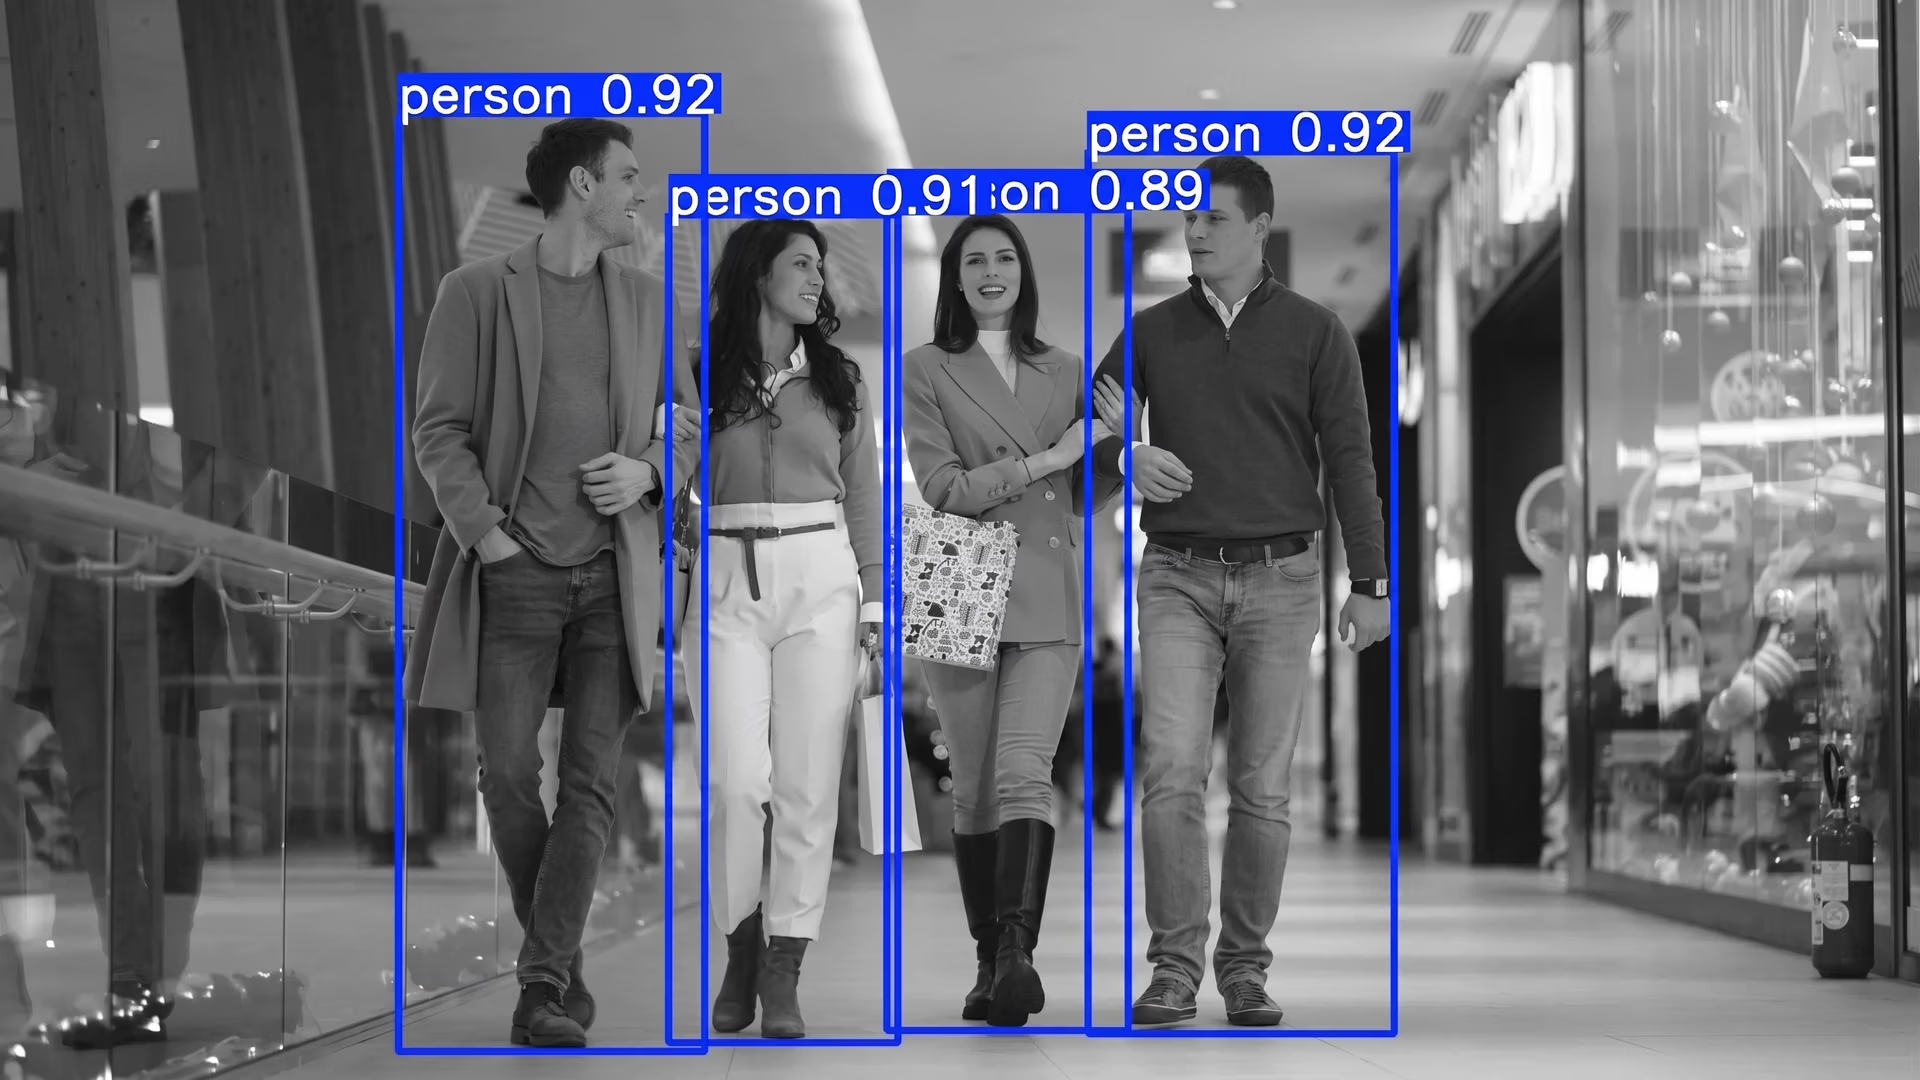
الشكل 2. يمكن تصور تنبؤات اكتشاف الأجسام باستخدام مربعات الإحاطة.
تعتمد العملية برمتها بدرجة كبيرة على استخلاص السمات. إذ يتعلم النموذج تحديد الأنماط المرئية المفيدة، مثل الحواف والأشكال والأنسجة وغيرها من الخصائص المميزة. وتُرمّز هذه الأنماط في خرائط السمات، التي تساعد الشبكة على فهم الصورة بمستويات متعددة من التفاصيل.
اكتشاف الأجسام: على مرحلتين أو مرحلة واحدة#
تستخدم كاشفات الأجسام استراتيجيات مختلفة لتحديد مواقع الأجسام، بحسب بنية النموذج، مع تحقيق توازن بين السرعة والدقة والتعقيد.
تركز العديد من نماذج اكتشاف الأجسام، ولا سيما الكاشفات ذات المرحلتين مثل Faster R-CNN، على أجزاء محددة من الصورة تُسمى مناطق الاهتمام (ROIs). ومن خلال التركيز على هذه المناطق، يعطي النموذج الأولوية للمناطق الأرجح احتواءً على أجسام بدلًا من تحليل كل بكسل بالقدر نفسه.
من ناحية أخرى، لا تختار النماذج ذات المرحلة الواحدة، مثل نماذج YOLO الأولى، مناطق اهتمام محددة كما تفعل النماذج ذات المرحلتين. بل تقسم الصورة إلى شبكة وتستخدم مربعات محددة مسبقًا تُسمى المراسي، إلى جانب خرائط السمات، للتنبؤ بالأجسام في الصورة بأكملها ضمن تمريرة واحدة.
تستخدم نماذج حديثة كثيرة لاكتشاف الأجسام، ومنها نماذج Ultralytics YOLO الحديثة، أساليب لا تعتمد على المراسي. وعلى خلاف النماذج التقليدية أحادية المرحلة التي تعتمد على مربعات مراسي محددة مسبقًا، تتنبأ النماذج غير المعتمدة على المراسي بمواقع الأجسام وأحجامها مباشرةً من خرائط السمات. ويمكن لذلك تبسيط البنية وتقليل العبء الحسابي وتحسين الأداء، ولا سيما عند اكتشاف أجسام بأشكال وأحجام متفاوتة.
نظرة على أفضل نماذج اكتشاف الأجسام#
تتوفر اليوم نماذج كثيرة لاكتشاف الأجسام، صُمم كل منها لتحقيق أهداف محددة. فبعضها مُحسّن للأداء في الوقت الفعلي، بينما يركز بعضها الآخر على تحقيق أعلى دقة. وغالبًا ما يعتمد اختيار النموذج المناسب لحل قائم على الرؤية الحاسوبية على حالة الاستخدام ومتطلبات الأداء الخاصة بك.
والآن، لنستكشف بعضًا من أفضل نماذج اكتشاف الأجسام لعام 2026.
1. نماذج Ultralytics YOLO#
تُعد عائلة نماذج Ultralytics YOLO من أكثر عائلات نماذج اكتشاف الكائنات استخدامًا اليوم. وتحظى YOLO، وهي اختصار لعبارة «You Only Look Once» (ترى مرة واحدة فقط)، بشعبية في مختلف القطاعات لأنها تقدم أداءً قويًا في الاكتشاف، مع كونها سريعة وموثوقة وسهلة الاستخدام.
تضم عائلة Ultralytics YOLO نماذج Ultralytics YOLOv5 وUltralytics YOLOv8 وUltralytics YOLO11 وأحدثها Ultralytics YOLO26، ما يوفر خيارات متنوعة لمتطلبات الأداء وحالات الاستخدام المختلفة. وبفضل تصميمها خفيف الوزن وتحسينها للسرعة، تعد نماذج Ultralytics YOLO مثالية للاكتشاف الآني، ويمكن نشرها على الأجهزة الطرفية ذات القدرة الحاسوبية والذاكرة المحدودتين.
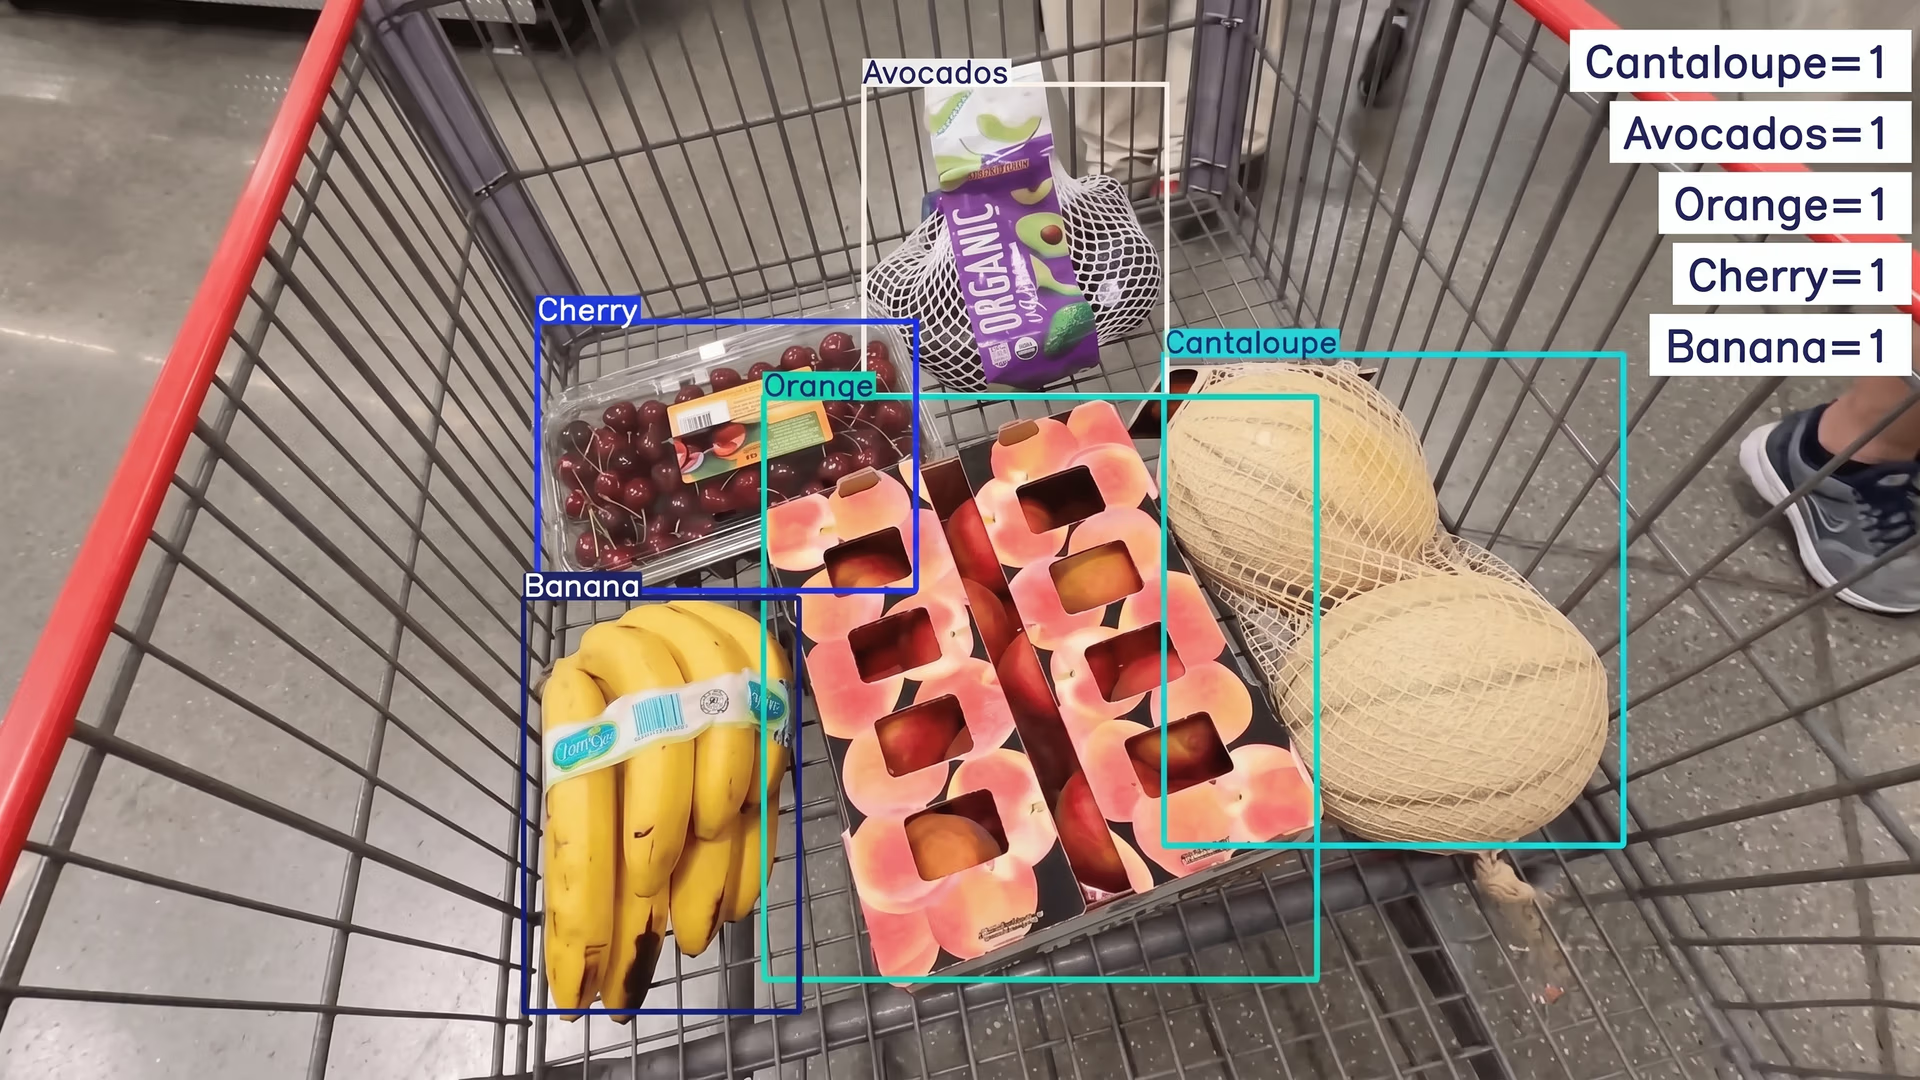
الشكل 3. استخدام Ultralytics YOLO11 لاكتشاف الكائنات (المصدر)
إلى جانب اكتشاف الكائنات الأساسي، تتميز هذه النماذج بتعدد استخداماتها. فهي تدعم أيضًا مهامًا مثل تجزئة الكائنات، التي تحدد حدود الكائنات على مستوى البكسل، وتقدير الوضعية، الذي يحدد النقاط الرئيسية على الأشخاص أو الكائنات. تجعل هذه المرونة نماذج Ultralytics YOLO خيارًا مفضلًا لمجموعة واسعة من التطبيقات، من الزراعة والخدمات اللوجستية إلى البيع بالتجزئة والتصنيع.
ومن الأسباب الرئيسية الأخرى لشعبية نماذج Ultralytics YOLO حزمة Ultralytics Python، التي توفر واجهة بسيطة وسهلة الاستخدام لتدريب النماذج وضبطها بدقة ونشرها. ويمكن للمطورين البدء باستخدام أوزان مدرّبة مسبقًا، وتخصيص النماذج لتناسب مجموعات بياناتهم، ثم نشرها ببضعة أسطر من التعليمات البرمجية.
2. RT-DETR وRT-DETRv2#
إن RT‑DETR (Transformer للكشف الآني) وRT‑DETRv2 الأحدث منه نموذجان لاكتشاف الأجسام صُمما للاستخدام الآني. وعلى خلاف كثير من النماذج التقليدية، يمكنهما تلقي صورة وإخراج الاكتشافات النهائية مباشرةً من دون استخدام كبت غير القيم القصوى (NMS).
تمثل NMS خطوةً تزيل الصناديق المتداخلة الزائدة عندما يتنبأ النموذج بالكائن نفسه أكثر من مرة. يؤدي تجاوز NMS إلى جعل عملية الاكتشاف أبسط وأسرع.
تجمع هذه النماذج بين الشبكات العصبية الالتفافية (CNNs) والمحوّلات. تستخرج الشبكة العصبية الالتفافية التفاصيل المرئية، مثل الحواف والأشكال، بينما المحوّل نوع من الشبكات العصبية يمكنه النظر إلى الصورة كاملةً دفعة واحدة وفهم العلاقات بين أجزائها المختلفة. ويتيح هذا الفهم الشامل للنموذج اكتشاف الكائنات المتقاربة أو المتداخلة.
يحسّن RT‑DETRv2 النموذج الأصلي بميزات مثل الاكتشاف متعدد المقاييس، الذي يساعد على العثور على الكائنات الصغيرة والكبيرة، والتعامل الأفضل مع المشاهد المعقدة. وتحافظ هذه التحسينات على سرعة النموذج مع رفع دقته.
3. RF-DETR#
RF‑DETR نموذج آني قائم على المحوّل، صُمم للجمع بين دقة بنيات المحوّلات والسرعة اللازمة للتطبيقات الواقعية. وعلى غرار RT‑DETR وRT‑DETRv2، يستخدم محوّلًا لتحليل الصورة كاملةً وشبكة عصبية التفافية لاستخراج السمات المرئية الدقيقة مثل الحواف والأشكال والأنسجة.
يتنبأ النموذج بالكائنات مباشرةً من صورة الإدخال، متجاوزًا الصناديق الارتكازية وكبت غير الأعظمية، ما يبسّط عملية الاكتشاف ويحافظ على سرعة الاستدلال. كما يدعم RF‑DETR تجزئة الكائنات، ما يتيح له تحديد حدود الكائنات على مستوى البكسل، بالإضافة إلى التنبؤ بالصناديق المحيطة.
4. EfficientDet#
صدر EfficientDet في أواخر عام 2019، وهو نموذج لاكتشاف الأجسام صُمم لتوسيع النطاق بكفاءة وتحقيق أداء عالٍ. وما يميز EfficientDet هو التحجيم المركب، وهو أسلوب يوسّع دقة الإدخال وعمق الشبكة وعرضها في الوقت نفسه، بدلًا من ضبط عامل واحد فقط. ويساعد هذا النهج النموذج على الحفاظ على دقة مستقرة، سواء وُسّع لمهام عالية الأداء أم صُغّر للنشر خفيف الوزن.
ومن المكونات الرئيسية الأخرى في EfficientDet شبكة هرمية فعّالة للسمات (FPN)، تتيح للنموذج تحليل الصور بمقاييس متعددة. ويُعد هذا التحليل متعدد المقاييس ضروريًا لاكتشاف الكائنات بأحجام مختلفة، ما يمكّن EfficientDet من تحديد الكائنات الصغيرة والكبيرة في الصورة نفسها بموثوقية.
5. PP-YOLOE+#
صدر PP-YOLOE+ في عام 2022، وهو نموذج لاكتشاف الأجسام بأسلوب YOLO، أي إنه يكتشف الأجسام ويصنفها في مرور واحد على الصورة. ويجعله هذا النهج سريعًا ومناسبًا للتطبيقات الآنية، مع الحفاظ على دقة عالية.
ومن التحسينات الرئيسية في PP-YOLOE+ التعلم المتوافق مع المهمة، الذي يساعد على جعل درجات الثقة في النموذج تعكس مدى دقة تحديد مواقع الكائنات. وهذا مفيد بوجه خاص لاكتشاف الكائنات الصغيرة أو المتداخلة.
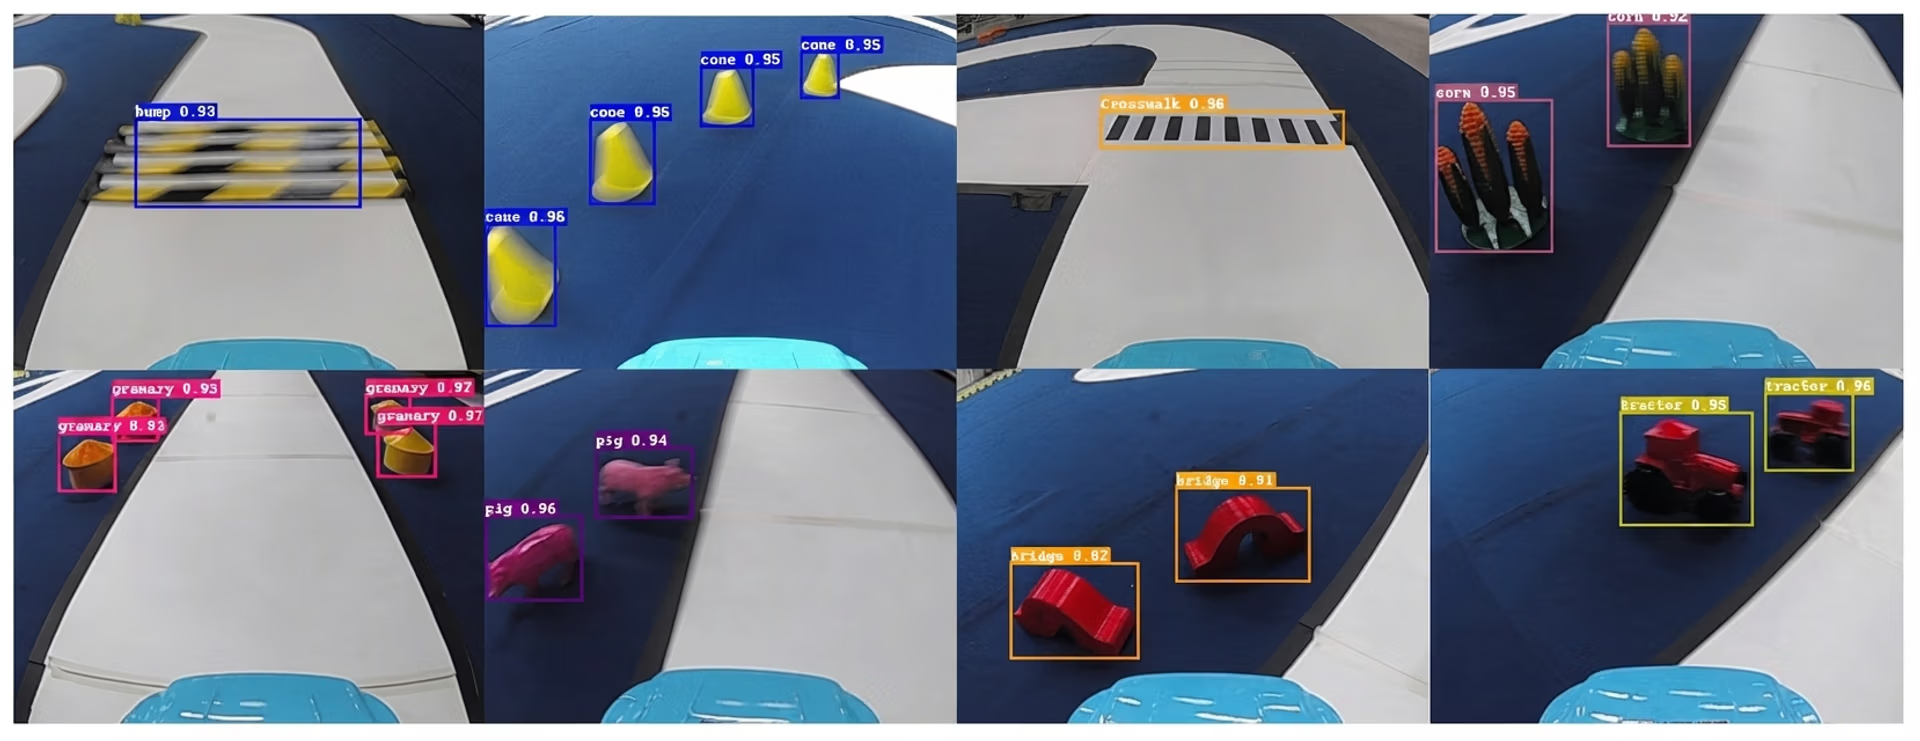
الشكل 4. اكتشاف الكائنات باستخدام PP-YOLOE+ (المصدر)
يستخدم النموذج أيضًا بنية رأس مفككة تفصل بين مهمتي التنبؤ بمواقع الكائنات وتسميات الفئات. ويتيح له ذلك رسم الصناديق المحيطة بدقة أكبر، مع تصنيف الكائنات تصنيفًا صحيحًا.
6. GroundingDINO#
GroundingDINO نموذج لكشف الأجسام قائم على Transformer يجمع بين الرؤية واللغة. وبدلًا من الاعتماد على مجموعة ثابتة من الفئات، يتيح للمستخدمين كشف الأجسام باستخدام مطالبات نصية باللغة الطبيعية.
من خلال محاذاة السمات المرئية في الصورة مع الأوصاف النصية، يستطيع النموذج تحديد مواقع الأجسام حتى إن لم تكن تسمياتها الدقيقة ضمن بيانات التدريب. وهذا يعني أنه يمكنك توجيه النموذج بأوصاف مثل «شخص يرتدي خوذة» أو «سيارة حمراء بالقرب من مبنى»، وسيرسم مربعات إحاطة حول الأجسام المطابقة.
كذلك، يقلل GroundingDINO، بدعمه للاكتشاف من دون أمثلة مسبقة، الحاجة إلى إعادة تدريب النموذج أو ضبطه بدقة لكل حالة استخدام جديدة، ما يجعله مرنًا في مجموعة واسعة من التطبيقات. ولمعرفة كيفية مقارنته بكواشف المفردات المفتوحة ونماذج الرؤية واللغة الأخرى على مجموعات بيانات واقعية، راجع لوحة ترتيب نماذج VLM.
المقاييس الشائعة لتقييم نماذج اكتشاف الكائنات#
عند مقارنة نماذج اكتشاف الكائنات المختلفة، قد تتساءل عن كيفية تحديد النموذج الأفضل أداءً فعليًا. وهذا سؤال وجيه، لأن الأداء يتأثر بعوامل كثيرة، إلى جانب بنية النموذج وجودة بياناتك.
غالبًا ما يعتمد الباحثون على معايير مشتركة ومقاييس أداء موحدة لتقييم النماذج بطريقة متسقة، ومقارنة النتائج، وفهم المفاضلات بين السرعة والدقة. وتكتسب المعايير الموحدة أهمية خاصة لأن كثيرًا من نماذج اكتشاف الكائنات تُقيّم على مجموعات البيانات نفسها، مثل مجموعة بيانات COCO.
قياس دقة الاكتشاف وسرعته#
إليك نظرة أقرب إلى بعض المقاييس الشائعة المستخدمة لتقييم نماذج اكتشاف الكائنات:
- التقاطع على الاتحاد (IoU): يقيس هذا المقياس مقدار تداخل مربع الإحاطة المتوقع مع الجسم الفعلي في الصورة. ويقارن المربع الذي يرسمه النموذج بمربع الحقيقة الأرضية، أي موقع الجسم كما وُسِم في مجموعة البيانات. ويُحسب IoU بقسمة مساحة التداخل على مساحة اتحاد المربعين. وتشير قيمة IoU الأعلى إلى أن النموذج يحدد موقع المربع بدقة أكبر، بينما تعني القيمة الأقل أن التنبؤ أقل دقة. وببساطة، يوضح IoU مدى تطابق تنبؤات النموذج مع المواقع الحقيقية للأجسام.
- متوسط الدقة (mAP): هو المقياس الأساسي المستخدم لتقييم الأداء الإجمالي لاكتشاف الكائنات. ويأخذ في الحسبان عدد الكائنات التي يكتشفها النموذج على نحو صحيح ودقة عمليات الاكتشاف تلك عبر مستويات الثقة وفئات الكائنات المختلفة.
- الإطارات في الثانية (FPS) وزمن الاستجابة: يوضح FPS عدد الصور أو إطارات الفيديو التي يستطيع النموذج معالجتها في ثانية واحدة. فعلى سبيل المثال، يمكن لنموذج يعمل بمعدل 30 FPS معالجة 30 إطارًا في كل ثانية. ويعني ارتفاع FPS استجابة النظام بسرعة أكبر، وهو أمر مهم لحالات الاستخدام مثل الفيديو المباشر ومراقبة حركة المرور والروبوتات. أما زمن الاستجابة فيقيس المدة التي يستغرقها النموذج لمعالجة صورة أو إطار واحد، بدءًا من لحظة استلامه وحتى جهوزية النتيجة.
إيجابيات وسلبيات استخدام خوارزميات اكتشاف الكائنات#
فيما يلي بعض المزايا الرئيسية لاستخدام نماذج اكتشاف الكائنات في التطبيقات الواقعية:
- قابلة للتطبيق في مختلف القطاعات: يمكن استخدام اكتشاف الكائنات في مجموعة واسعة من حالات الاستخدام، من مراقبة حركة المرور وتحليلات البيع بالتجزئة إلى الرعاية الصحية والزراعة والتصنيع.
- تقلل الجهد اليدوي: تقلل أتمتة مهام الفحص والمراقبة المرئية الحاجة إلى الإشراف البشري المستمر، وتساعد الفرق على التركيز على الأعمال الأعلى قيمة.
- تستفيد من منظومات المصادر المفتوحة: تسهّل مجتمعات المصادر المفتوحة النشطة والموارد المتاحة على GitHub الوصول إلى النماذج المدرّبة مسبقًا، وإجراء التجارب، وتخصيص الحلول.
على الرغم من هذه المزايا، توجد قيود عملية قد تؤثر في أداء نماذج اكتشاف الكائنات. وفيما يلي عوامل مهمة ينبغي أخذها في الحسبان:
- الحاجة إلى بيانات عالية الجودة: تعتمد نماذج اكتشاف الكائنات على مجموعات بيانات كبيرة وموسومة بعناية للتدريب. وقد يكون إنشاء هذه البيانات وصيانتها مستهلكًا للوقت ومكلفًا وصعب التوسع.
- المتطلبات الحاسوبية: غالبًا ما تتطلب النماذج التي تحقق دقة أعلى في الاكتشاف قدرة معالجة كبيرة، سواء أثناء التدريب أو النشر في الوقت الفعلي. ويعني ذلك عادةً استخدام وحدات GPU عالية الأداء، ما قد يزيد تكاليف البنية التحتية.
- الحساسية لظروف العالم الحقيقي: قد تؤثر التغيرات في الإضاءة وزوايا الكاميرا والطقس والمشاهد المزدحمة في أداء الاكتشاف، ما يجعل الاختبار والضبط المستمرين ضروريين.
أبرز النقاط#
يعتمد اختيار أفضل نموذج لاكتشاف الكائنات لمشروع الرؤية الحاسوبية على حالة الاستخدام وإعداد البيانات ومتطلبات الأداء وقيود الأجهزة. فبعض النماذج محسّن للسرعة، بينما يركز بعضها الآخر على الدقة، وتحتاج معظم التطبيقات الواقعية إلى تحقيق توازن بينهما. وبفضل أطر العمل مفتوحة المصدر والمجتمعات النشطة على GitHub، أصبح تقييم هذه النماذج وتكييفها ونشرها للاستخدام العملي أسهل.
لمعرفة المزيد، استكشف مستودع GitHub. انضم إلى مجتمعنا واطّلع على صفحات حلولنا لقراءة المزيد عن تطبيقات مثل الذكاء الاصطناعي في الرعاية الصحية والرؤية الحاسوبية في قطاع السيارات. تعرّف على خيارات الترخيص للبدء باستخدام ذكاء الرؤية الاصطناعي اليوم.
بقلم
منشئ محتوى · Ultralytics
التعليقات
اطرح سؤالًا، أو شارك نتائجك، أو ساعد شخصًا آخر.









