Exporta y optimiza Ultralytics YOLOv8 para inferencia en Intel OpenVINO
Optimiza tu modelo Ultralytics YOLOv8 para la inferencia con OpenVINO. Sigue nuestra guía para convertir modelos de PyTorch a ONNX y optimizarlos para aplicaciones en tiempo real.
En esta publicación, veremos cómo puedes exportar y optimizar tu modelo Ultralytics YOLOv8 preentrenado o entrenado con tus propios datos para realizar inferencias con OpenVINO. Si utilizas un sistema basado en Intel, ya sea con CPU o GPU, esta guía te mostrará cómo acelerar significativamente tu modelo con un esfuerzo mínimo.
¿Por qué optimizar Ultralytics YOLOv8 con OpenVINO?#
Optimizar tu modelo Ultralytics YOLOv8 con OpenVINO puede proporcionar un aumento de velocidad de hasta 3 veces en tareas de inferencia, especialmente si utilizas una CPU Intel. Esta mejora de rendimiento puede marcar una gran diferencia en aplicaciones en tiempo real, desde la detección de objetos hasta la segmentación y los sistemas de seguridad.
Pasos para exportar y optimizar tu modelo Ultralytics YOLOv8#
Cómo funciona el proceso#
Lo primero es desglosar el proceso. Vamos a convertir un modelo de PyTorch a ONNX y, después, a optimizarlo con OpenVINO. Este proceso consta de unos sencillos pasos y se puede aplicar a varios modelos y formatos, incluidos TensorFlow, PyTorch, Caffe y ONNX.
Exportar el modelo#
Al consultar la documentación de Ultralytics, vemos que para exportar un modelo YOLOv8 hay que utilizar el método export del framework de Ultralytics. Este método nos permite convertir nuestro modelo de PyTorch a ONNX y, por último, optimizarlo para OpenVINO. El resultado es un modelo que se ejecuta mucho más rápido y aprovecha el potente hardware de Intel.
Instalar las dependencias#
Antes de ejecutar el script de exportación, tendrás que asegurarte de que todas las dependencias necesarias estén instaladas. Entre ellas se incluyen la biblioteca Ultralytics, ONNX y OpenVINO. Instalar estos paquetes es un proceso sencillo que se puede realizar mediante pip, el instalador de paquetes de Python.
Ejecutar el script de exportación#
Una vez configurado el entorno, puedes ejecutar tu script de exportación. Este script convertirá tu modelo de PyTorch a ONNX y, después, a OpenVINO. El proceso es sencillo y consiste en llamar a una única función que se encargará de la exportación. El framework de Ultralytics facilita la conversión y optimización de tus modelos para que obtengas el mejor rendimiento con las mínimas complicaciones.
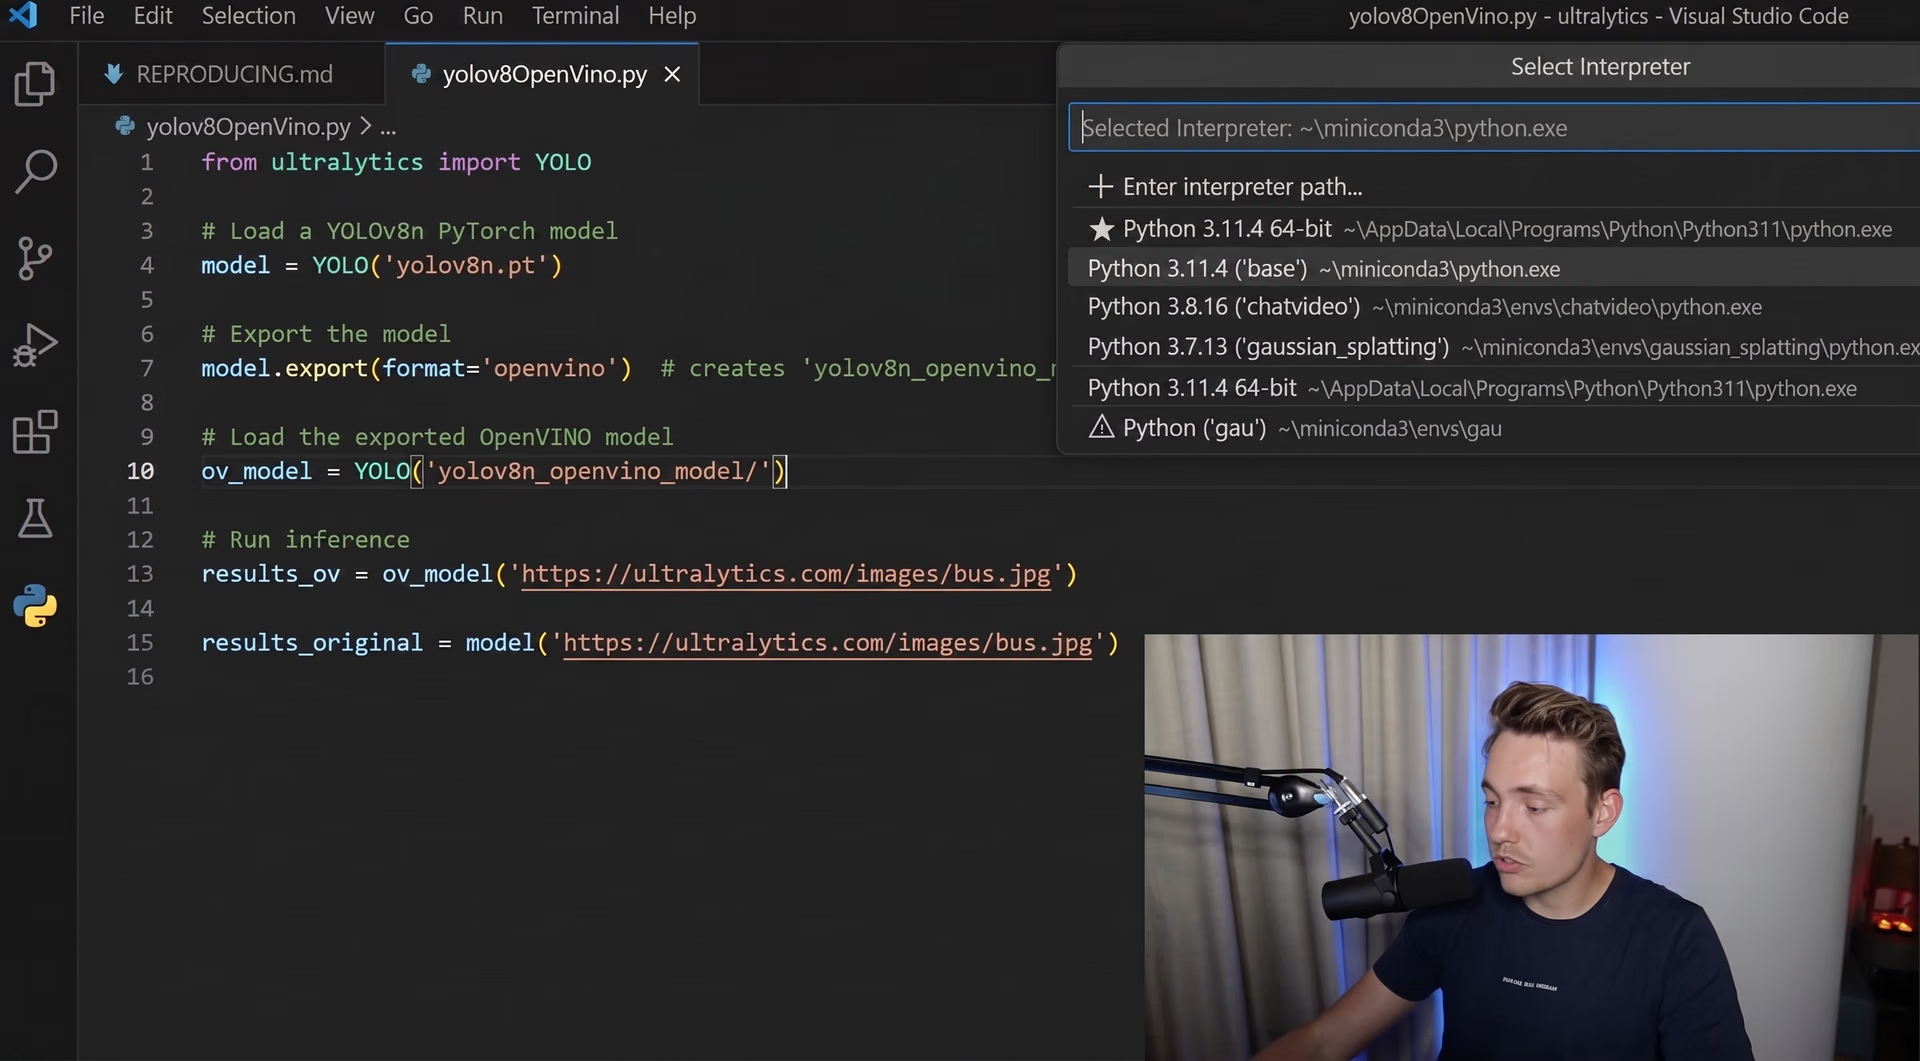
Fig. 1. Nicolai Nielsen explica cómo ejecutar el script de exportación.
Comparar el rendimiento#
Después de la exportación, es fundamental comparar el rendimiento de los modelos original y optimizado. Al medir el tiempo de inferencia de ambos modelos, podrás ver claramente las mejoras de rendimiento. Normalmente, el modelo de OpenVINO mostrará una reducción significativa del tiempo de inferencia en comparación con el modelo original de PyTorch. Esto es especialmente cierto en los modelos más grandes, en los que la mejora de rendimiento resulta más evidente.
Aplicaciones y ventajas en el mundo real#
Optimizar modelos Ultralytics YOLOv8 con OpenVINO resulta especialmente beneficioso para aplicaciones que requieren procesamiento en tiempo real. Estos son algunos ejemplos:
- Sistemas de seguridad: La detección de objetos en tiempo real puede alertar de inmediato al personal de seguridad, mejorando la seguridad y la capacidad de respuesta.
- Vehículos automatizados: Una mayor velocidad de inferencia mejora la capacidad de respuesta de los sistemas de conducción autónoma, haciéndolos más seguros y fiables.
- Sanidad: El procesamiento rápido de imágenes para herramientas de diagnóstico puede salvar vidas al proporcionar resultados más rápidamente y permitir intervenciones oportunas.
Al implementar estas optimizaciones, no solo mejoras el rendimiento, sino también la fiabilidad y la eficiencia de tus aplicaciones. Esto puede traducirse en una mejor experiencia de usuario, una mayor productividad y soluciones más innovadoras.
Conclusiones#
Exportar y optimizar un modelo Ultralytics YOLOv8 para OpenVINO es una forma eficaz de aprovechar el hardware de Intel para crear aplicaciones de IA más rápidas y eficientes. Con solo unos sencillos pasos, puedes transformar el rendimiento de tu modelo y aplicarlo eficazmente a situaciones del mundo real.
No te pierdas más tutoriales y guías de Ultralytics para seguir mejorando tus proyectos de IA. Visita nuestro repositorio de GitHub y únete a la comunidad de Ultralytics para obtener más información y novedades. ¡Innovemos juntos!
Recuerda que optimizar tus modelos no consiste solo en ganar velocidad: se trata de desbloquear nuevas posibilidades y garantizar que tus soluciones de IA sean sólidas, eficientes y estén preparadas para el futuro.








