Mejora la robustez de los modelos de IA con el aumento de datos
Descubre cómo añadir variaciones realistas a los datos de entrenamiento mediante el aumento de datos ayuda a mejorar la robustez de los modelos de IA y su rendimiento en el mundo real.
 Abirami Vina10 min de lectura
Las pruebas son una parte fundamental del desarrollo de cualquier solución tecnológica. Muestran a los equipos cómo funciona realmente un sistema antes de ponerlo en marcha y les permiten solucionar los problemas pronto. Esto se aplica a muchos campos, incluida la IA, donde se espera que los modelos gestionen condiciones impredecibles del mundo real una vez implementados.
Por ejemplo, la visión artificial es una rama de la IA que enseña a las máquinas a entender imágenes y vídeos. Los modelos de visión artificial, como Ultralytics YOLO26, permiten realizar tareas como la detección de objetos, la segmentación de instancias y la clasificación de imágenes.
Se pueden utilizar en muchos sectores en aplicaciones como la supervisión de pacientes, el análisis del tráfico, el pago automatizado y el control de calidad en la fabricación. Sin embargo, incluso con modelos avanzados y datos de entrenamiento de alta calidad, las soluciones de IA visual pueden tener dificultades ante variaciones del mundo real, como los cambios de iluminación, el movimiento o los objetos parcialmente ocultos.
Esto ocurre porque los modelos aprenden a partir de los ejemplos que reciben durante el entrenamiento. Si no han visto antes condiciones como reflejos, desenfoque por movimiento o visibilidad parcial, es menos probable que reconozcan correctamente los objetos en esas situaciones.
Una forma de mejorar la robustez de los modelos es mediante el aumento de datos. En lugar de recopilar grandes cantidades de datos nuevos, los ingenieros pueden hacer pequeños cambios significativos en las imágenes existentes, como ajustar la iluminación, recortarlas o combinarlas. Esto ayuda al modelo a aprender a reconocer los mismos objetos en una mayor variedad de situaciones.
En este artículo veremos cómo el aumento de datos mejora la robustez de los modelos y la fiabilidad de los sistemas de IA visual cuando se implementan fuera de entornos controlados. ¡Empecemos!
Cómo comprobar la robustez de un modelo#
Antes de profundizar en el aumento de datos, veamos cómo saber si un modelo de visión artificial está realmente listo para utilizarse en el mundo real.
Un modelo robusto sigue funcionando bien aunque cambien las condiciones, en lugar de funcionar únicamente con imágenes limpias y perfectamente etiquetadas. Estos son algunos factores prácticos que conviene tener en cuenta al evaluar la robustez de un modelo de IA:
- Cambios de iluminación: Los modelos pueden comportarse de forma distinta con luz intensa o tenue, reflejos o sombras, lo que puede afectar a la confianza con la que detectan los objetos.
- Oclusión parcial: En las escenas cotidianas, otros elementos suelen tapar los objetos o estos solo son parcialmente visibles. Un modelo más robusto puede reconocerlos incluso cuando falta información visual.
- Escenas concurridas: Los entornos con muchos objetos superpuestos pueden dificultar la detección. Los modelos que funcionan bien en estos casos suelen ser más fiables en situaciones complejas.
Los buenos resultados en imágenes limpias y captadas en condiciones perfectas no siempre se traducen en un buen rendimiento en el mundo real. Las pruebas periódicas en condiciones variadas permiten ver cómo responde un modelo una vez implementado.
¿Qué es el aumento de datos?#
La apariencia de un objeto en una foto puede cambiar según la iluminación, el ángulo, la distancia o el fondo. Al entrenar un modelo de visión artificial, el conjunto de datos del que aprende debe incluir este tipo de variaciones para que pueda funcionar bien en entornos impredecibles.
El aumento de datos amplía un conjunto de datos de entrenamiento al crear ejemplos adicionales a partir de las imágenes que ya tienes. Para ello, se aplican cambios intencionados, como girar o voltear una imagen, ajustar su brillo o recortar una parte.
Por ejemplo, imagina que solo tienes una foto de un gato. Si giras la imagen o cambias el brillo, puedes crear varias versiones nuevas a partir de esa única foto. Cada versión tiene un aspecto ligeramente distinto, pero sigue siendo una foto del mismo gato. Estas variaciones ayudan a enseñar al modelo que un objeto puede tener distinto aspecto y seguir siendo el mismo.
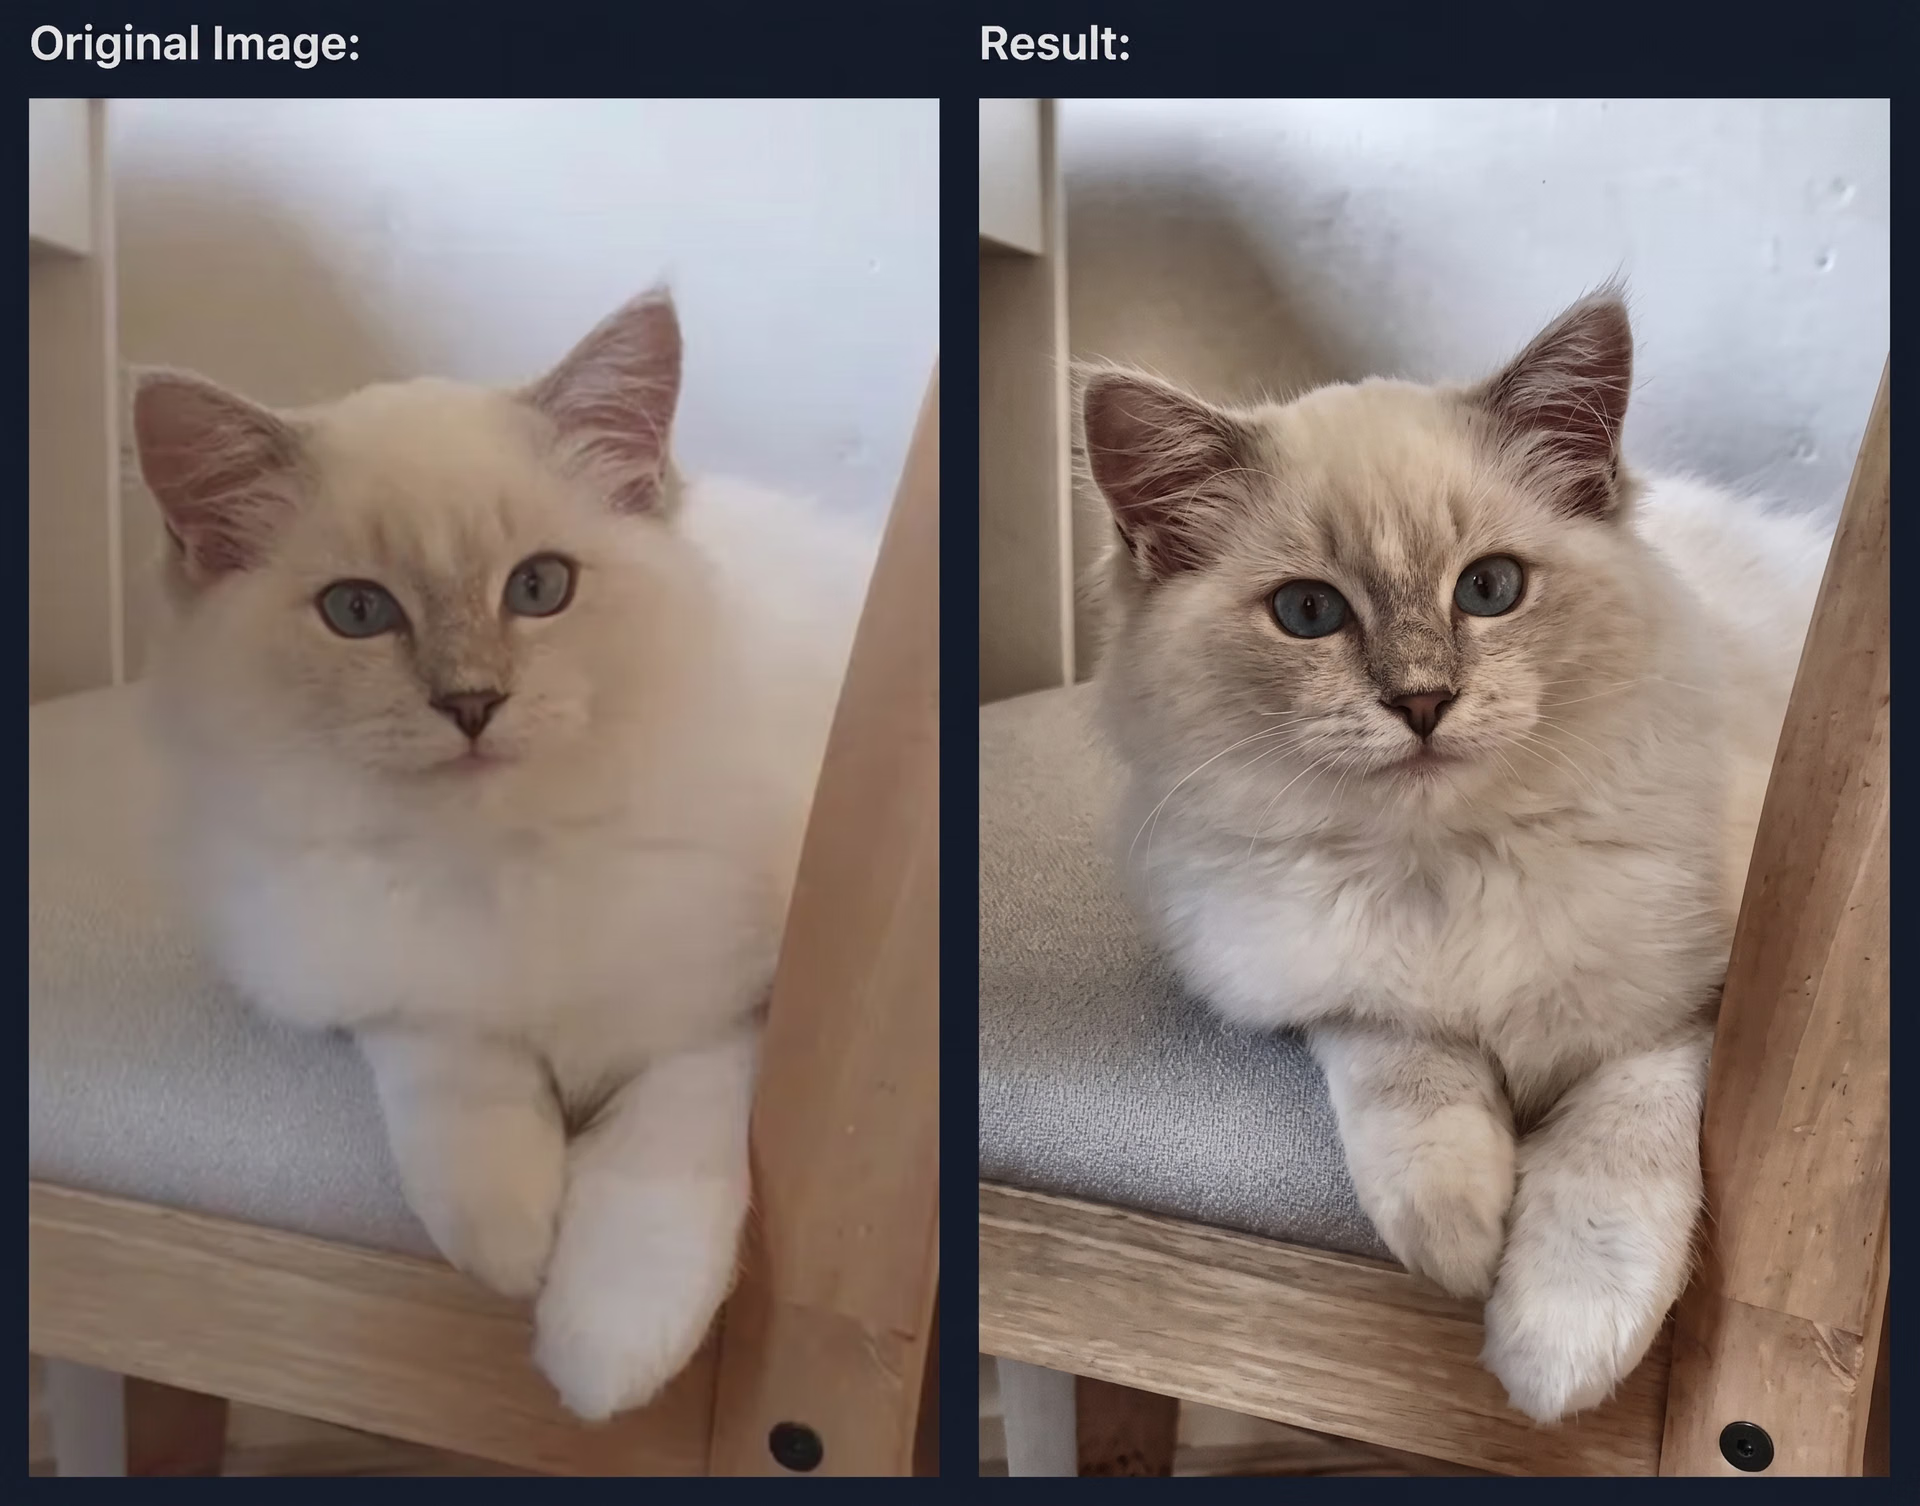
Fig. 1. Ejemplo del aumento de datos en una imagen de un gato (Fuente)
Cómo mejora el rendimiento de los modelos el aumento de datos#
Durante el entrenamiento del modelo, el aumento de datos puede integrarse directamente en el flujo de entrenamiento. En lugar de crear y almacenar manualmente nuevas copias de las imágenes, se pueden aplicar transformaciones aleatorias cada vez que se carga una imagen.
Esto significa que el modelo ve una versión ligeramente distinta de la imagen cada vez, ya sea más luminosa, volteada o parcialmente oculta. Algunas técnicas, como el borrado aleatorio, incluso pueden eliminar pequeñas regiones de la imagen para simular situaciones del mundo real en las que un objeto está tapado o solo es parcialmente visible.
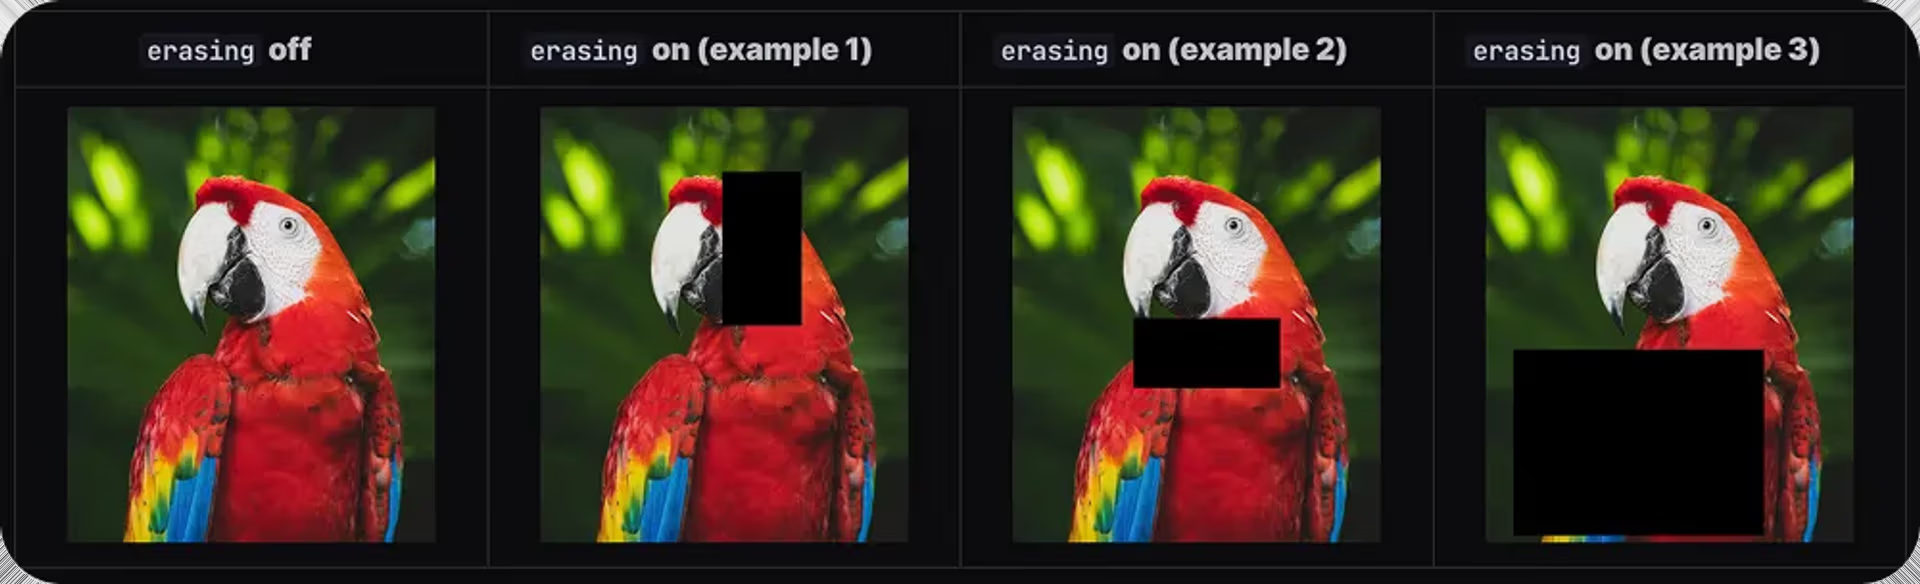
Fig. 2. Ejemplos de aumento de datos mediante borrado aleatorio (Fuente)
Ver muchas versiones diferentes de una misma imagen permite que el modelo aprenda qué características son importantes, en lugar de depender de un único ejemplo perfecto. Esta variedad refuerza la robustez del modelo de IA para que pueda rendir de forma más fiable en condiciones reales.
Técnicas habituales de aumento de datos#
Estas son algunas técnicas de aumento de datos que se utilizan para introducir variaciones en las imágenes de entrenamiento:
- Transformaciones geométricas: Estas técnicas cambian la apariencia espacial de un objeto dentro de una imagen. Girar, voltear, cambiar el tamaño, recortar o desplazar una imagen permite que el modelo entienda cómo se puede ver un objeto desde distintos ángulos o distancias.
- Ajustes de color e iluminación: La iluminación en el mundo real rara vez es uniforme. Las imágenes pueden ser demasiado claras, demasiado oscuras o tener ligeras desviaciones de color, según el entorno o la cámara utilizada. Ajustar el brillo, el contraste, el tono y la saturación permite que los modelos gestionen estos cambios visuales y rindan bien en distintas escenas.
- Variaciones de calidad de imagen: El desenfoque o el ruido visual pueden hacer que las imágenes no se vean nítidas. Añadir desenfoque o ruido durante el entrenamiento ayuda al modelo a lidiar con el desenfoque por movimiento, las imágenes con poca luz o los resultados de cámaras de menor calidad, para que sea menos sensible a las imperfecciones visuales.
- Aumentos basados en oclusiones: En entornos reales, otros objetos suelen bloquear parcialmente los objetos. Esto se denomina oclusión. Ocultar o enmascarar pequeñas zonas de una imagen durante el entrenamiento ayuda al modelo a aprender a detectar objetos aunque solo sean parcialmente visibles.
- Aumentos con varias imágenes: Estas técnicas combinan partes de varias imágenes en un único ejemplo de entrenamiento, lo que puede aumentar el número de objetos visibles y mejorar la capacidad del modelo para gestionar escenas complejas o abarrotadas.
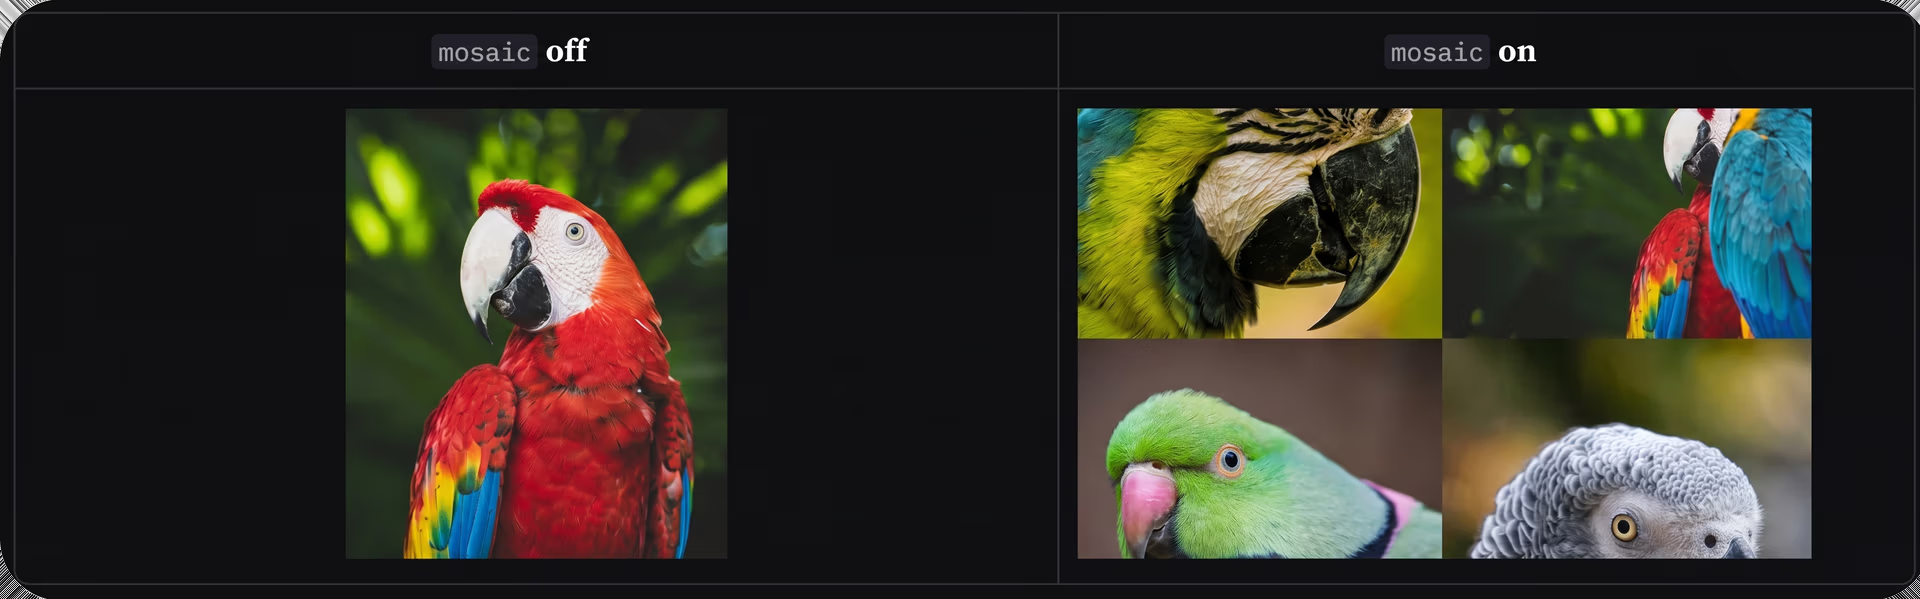
Fig. 3. Ejemplo de aumento con varias imágenes (Fuente)
Aumento de datos fácil con el paquete Python de Ultralytics#
Gestionar conjuntos de datos, crear variaciones de imágenes y escribir código de transformación puede añadir pasos adicionales al desarrollo de una aplicación de visión artificial. El paquete Python de Ultralytics ayuda a simplificar este proceso al ofrecer una única interfaz para entrenar, ejecutar e implementar modelos Ultralytics YOLO como YOLO26. Como parte de este esfuerzo por agilizar los flujos de trabajo de entrenamiento, el paquete incluye aumentos de datos integrados, probados por Ultralytics y optimizados para los modelos YOLO.
También admite integraciones útiles que evitan tener que recurrir a herramientas independientes o código personalizado. En concreto, para el aumento de datos, el paquete se integra con Albumentations, una biblioteca de aumento de imágenes muy utilizada. Esta integración permite aplicar aumentos automáticamente durante el entrenamiento, sin necesidad de scripts adicionales ni código personalizado.
Gestión de anotaciones y conjuntos de datos aumentados#
Otro factor que influye en la robustez del modelo es la calidad de la anotación. Las etiquetas limpias y precisas, creadas y gestionadas con herramientas de anotación como Ultralytics Platform o Roboflow, ayudan al modelo a entender dónde están los objetos y qué aspecto tienen.
Durante el entrenamiento, los aumentos de datos, como los volteos, los recortes y las rotaciones, se aplican de forma dinámica, y las anotaciones se ajustan automáticamente para reflejar estos cambios. Cuando las etiquetas son precisas, este proceso funciona sin problemas y proporciona al modelo muchos ejemplos realistas de una misma escena.
Si las anotaciones son imprecisas o incoherentes, esos errores pueden repetirse en las imágenes aumentadas, lo que puede reducir la eficacia del entrenamiento. Empezar con anotaciones precisas evita que estos errores se propaguen y contribuye a mejorar la robustez del modelo.
Mejora de las aplicaciones de IA visual con el aumento de datos#
A continuación, veremos ejemplos de cómo el aumento de datos contribuye a la robustez de los modelos de IA en aplicaciones del mundo real.
Mejora de la precisión de la detección de objetos en entornos reales#
Las imágenes sintéticas se utilizan a menudo para entrenar sistemas de detección de objetos cuando los datos reales son limitados, confidenciales o difíciles de recopilar. Permiten a los equipos generar rápidamente ejemplos de productos, entornos y ángulos de cámara sin tener que capturar en la vida real todas las situaciones posibles.
Sin embargo, los conjuntos de datos sintéticos a veces pueden parecer demasiado limpios en comparación con las imágenes del mundo real, donde la iluminación cambia, los objetos se solapan y las escenas incluyen elementos de fondo que las recargan. El aumento de datos ayuda a salvar esta diferencia al introducir variaciones realistas, como cambios de iluminación, ruido o distintas ubicaciones de los objetos, para que el modelo aprenda a gestionar las condiciones que encontrará una vez implementado.
Por ejemplo, en un estudio reciente se entrenó un modelo Ultralytics YOLO11 exclusivamente con imágenes sintéticas y se añadió aumento de datos para introducir más variaciones. Esto contribuyó a que el modelo aprendiera a reconocer objetos de forma más general. Obtuvo buenos resultados al probarlo con imágenes reales, aunque nunca había visto datos del mundo real durante el entrenamiento.
Soluciones de imagen médica más fiables#
Los conjuntos de datos de imagen médica suelen ser limitados, y las propias exploraciones pueden variar en función del tipo de equipo, los ajustes de imagen o el entorno clínico. Las diferencias en la anatomía de los pacientes, los ángulos, la iluminación o el ruido visual pueden dificultar que los modelos de visión artificial aprendan patrones que se generalicen bien a distintos pacientes y hospitales.
El aumento de datos ayuda a abordar este problema al crear varias versiones de una misma exploración durante el entrenamiento, por ejemplo, añadiendo ruido, desplazando ligeramente la imagen o aplicando pequeñas distorsiones. Estos cambios hacen que los datos de entrenamiento representen mejor las condiciones clínicas reales.
Por ejemplo, en un estudio de imagen pediátrica, los investigadores utilizaron Ultralytics YOLO11 para la segmentación anatómica y lo entrenaron con datos médicos aumentados. Introdujeron variaciones como ruido añadido, ligeros cambios de posición y pequeñas distorsiones para que las imágenes fueran más realistas.
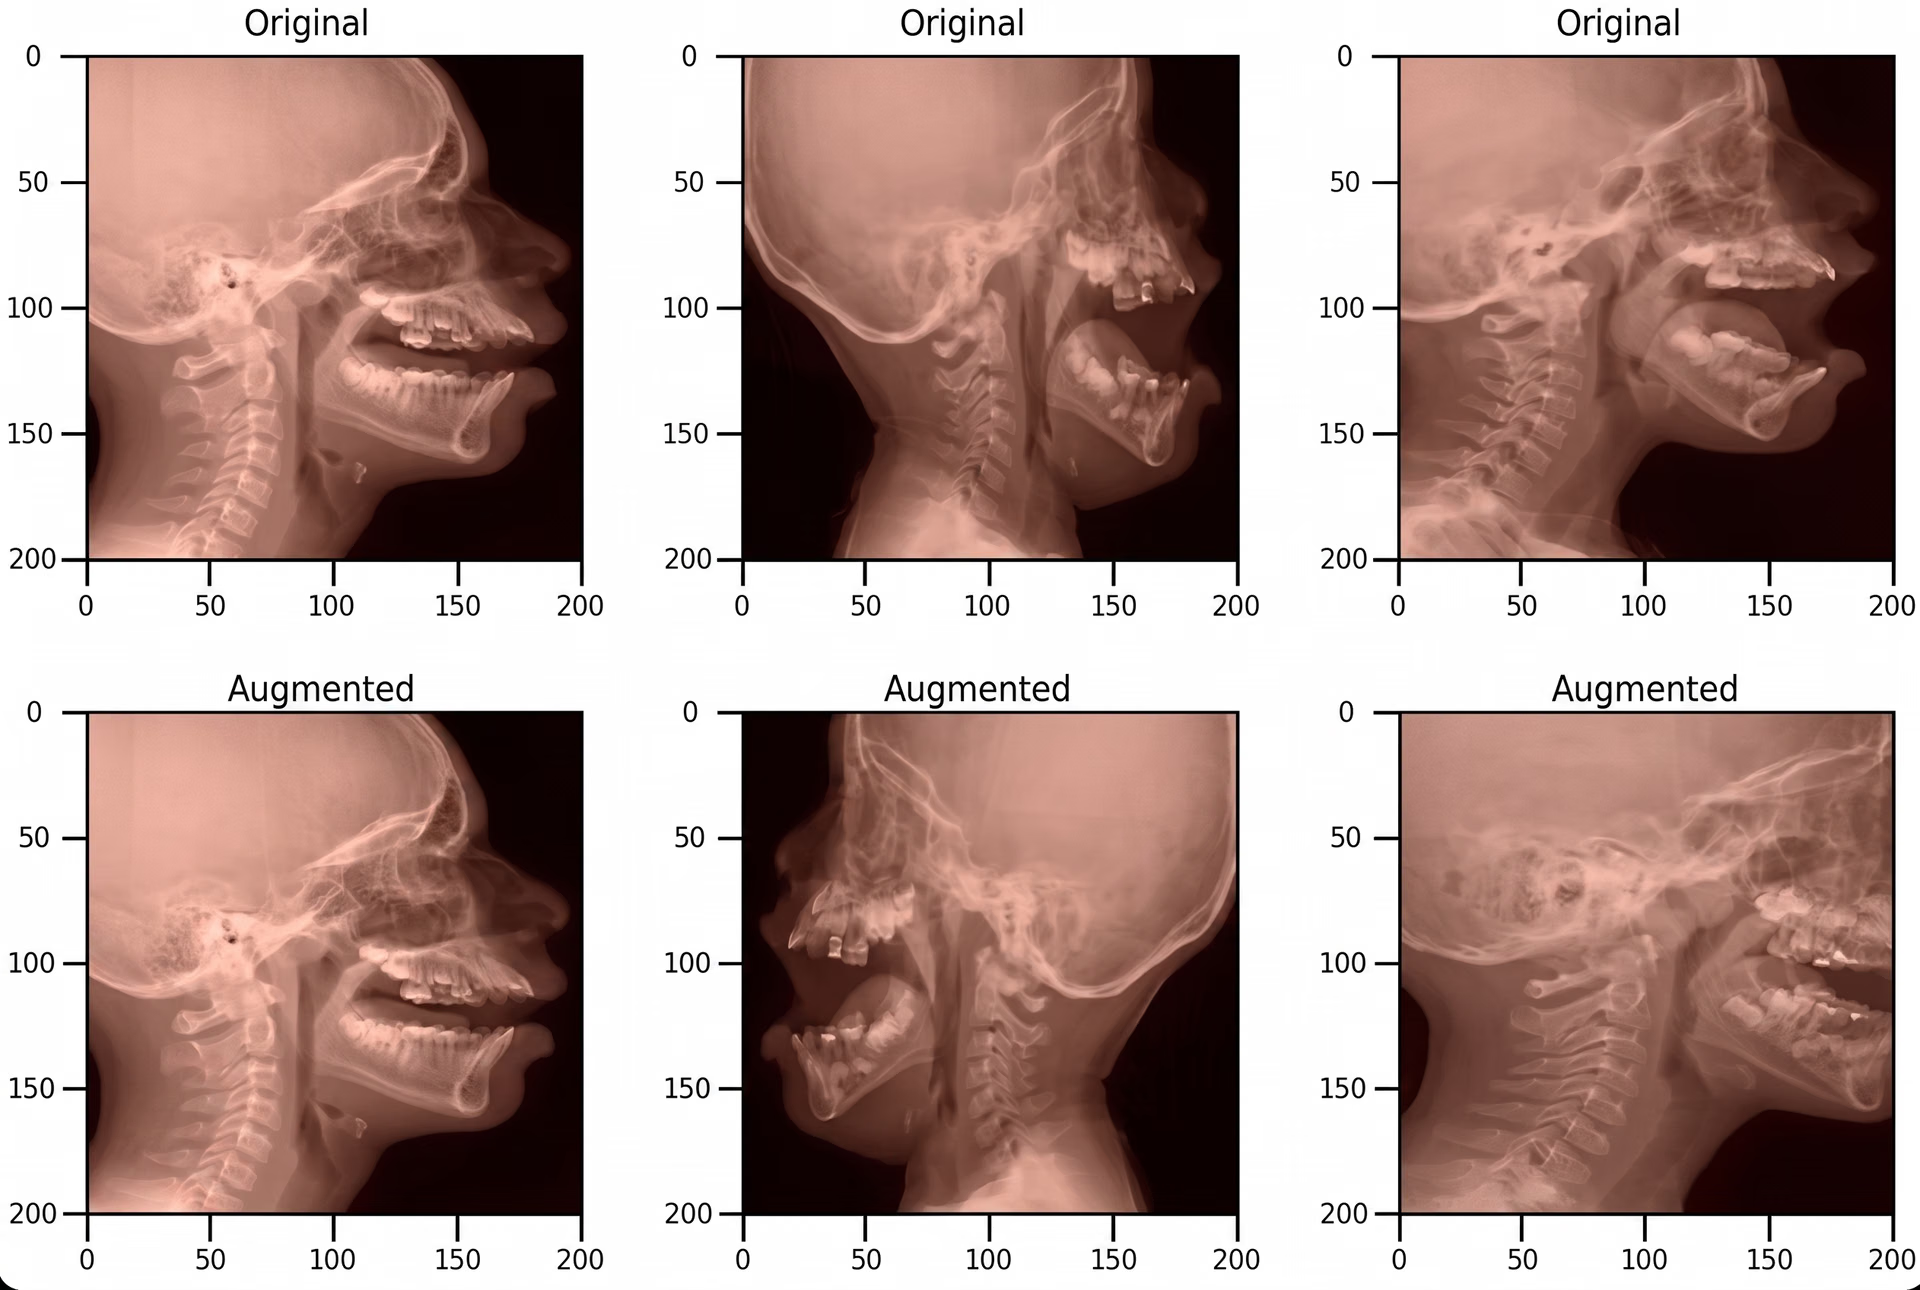
Fig. 4. Imágenes médicas pediátricas originales y aumentadas (Fuente)
Al aprender a partir de estas variaciones, el modelo se centró en características anatómicas relevantes, en lugar de en diferencias superficiales. Esto hizo que los resultados de segmentación fueran más estables en distintas exploraciones y casos de pacientes.
Conclusiones clave#
Recopilar datos diversos es difícil, pero el aumento de datos permite que los modelos aprendan a partir de un abanico más amplio de condiciones visuales. Esto mejora la robustez del modelo al enfrentarse a oclusiones, cambios de iluminación y escenas abarrotadas. En conjunto, esto les ayuda a rendir de forma más fiable fuera de entornos de entrenamiento controlados.
Únete a nuestra comunidad y descubre las últimas novedades en IA visual en nuestro repositorio de GitHub. Visita nuestras páginas de soluciones para saber cómo aplicaciones como la IA en la fabricación y la visión artificial en la atención sanitaria impulsan el progreso, y consulta nuestras opciones de licencia para impulsar tu próxima solución de IA.
Escrito por
Creador de contenido · Ultralytics
Comentarios
Haz una pregunta, comparte tus resultados o ayuda a otra persona.









