Florence-2 : le dernier modèle vision-langage de Microsoft
Découvre Florence-2, le modèle vision-langage de Microsoft pour la détection et la segmentation d’objets, le sous-titrage et l’ancrage, avec de solides performances en zero-shot.
 Abirami Vina9 min de lecture
En juin 2024, Microsoft a présenté Florence-2, un modèle de vision-langage multimodal (VLM) conçu pour gérer un large éventail de tâches, notamment la détection d’objets, la segmentation, le sous-titrage d’images et l’ancrage. Florence-2 établit une nouvelle référence en matière de performances en apprentissage sans exemple, c’est-à-dire qu’il peut effectuer des tâches sans entraînement spécifique préalable, et sa taille est inférieure à celle d’autres modèles de vision-langage de pointe.
Florence-2 n’est pas un modèle comme les autres. Sa polyvalence et ses performances améliorées pourraient avoir un impact important sur différents secteurs en améliorant la précision et en réduisant le besoin d’un entraînement approfondi. Dans cet article, nous allons examiner les principales fonctionnalités de Florence-2, comparer ses performances à celles d’autres VLM et aborder ses applications potentielles.
Qu’est-ce que Florence-2 ?#
Florence-2 peut effectuer différentes tâches dans un cadre unifié unique. Ses capacités sont en partie dues à son vaste jeu de données d’entraînement, appelé FLD-5B. Celui-ci comprend 5,4 milliards d’annotations réparties sur 126 millions d’images. Ce jeu de données exhaustif a été créé spécialement pour donner à Florence-2 les capacités nécessaires à l’exécution efficace et précise d’un large éventail de tâches de vision.
Voici un aperçu plus détaillé des tâches prises en charge par Florence-2 :
- Détection d’objets : le modèle peut identifier et localiser des objets dans des images avec une grande précision.
- Segmentation : cette tâche consiste à diviser une image en segments pertinents afin d’en faciliter l’analyse et l’interprétation.
- Sous-titrage d’images : Florence-2 peut générer des légendes descriptives pour les images, qui en apportent le contexte et les détails.
- Ancrage visuel : le modèle peut associer des expressions ou des mots spécifiques d’une légende aux régions correspondantes de l’image.
- Performances zero-shot : le modèle peut effectuer des tâches sans entraînement spécifique.
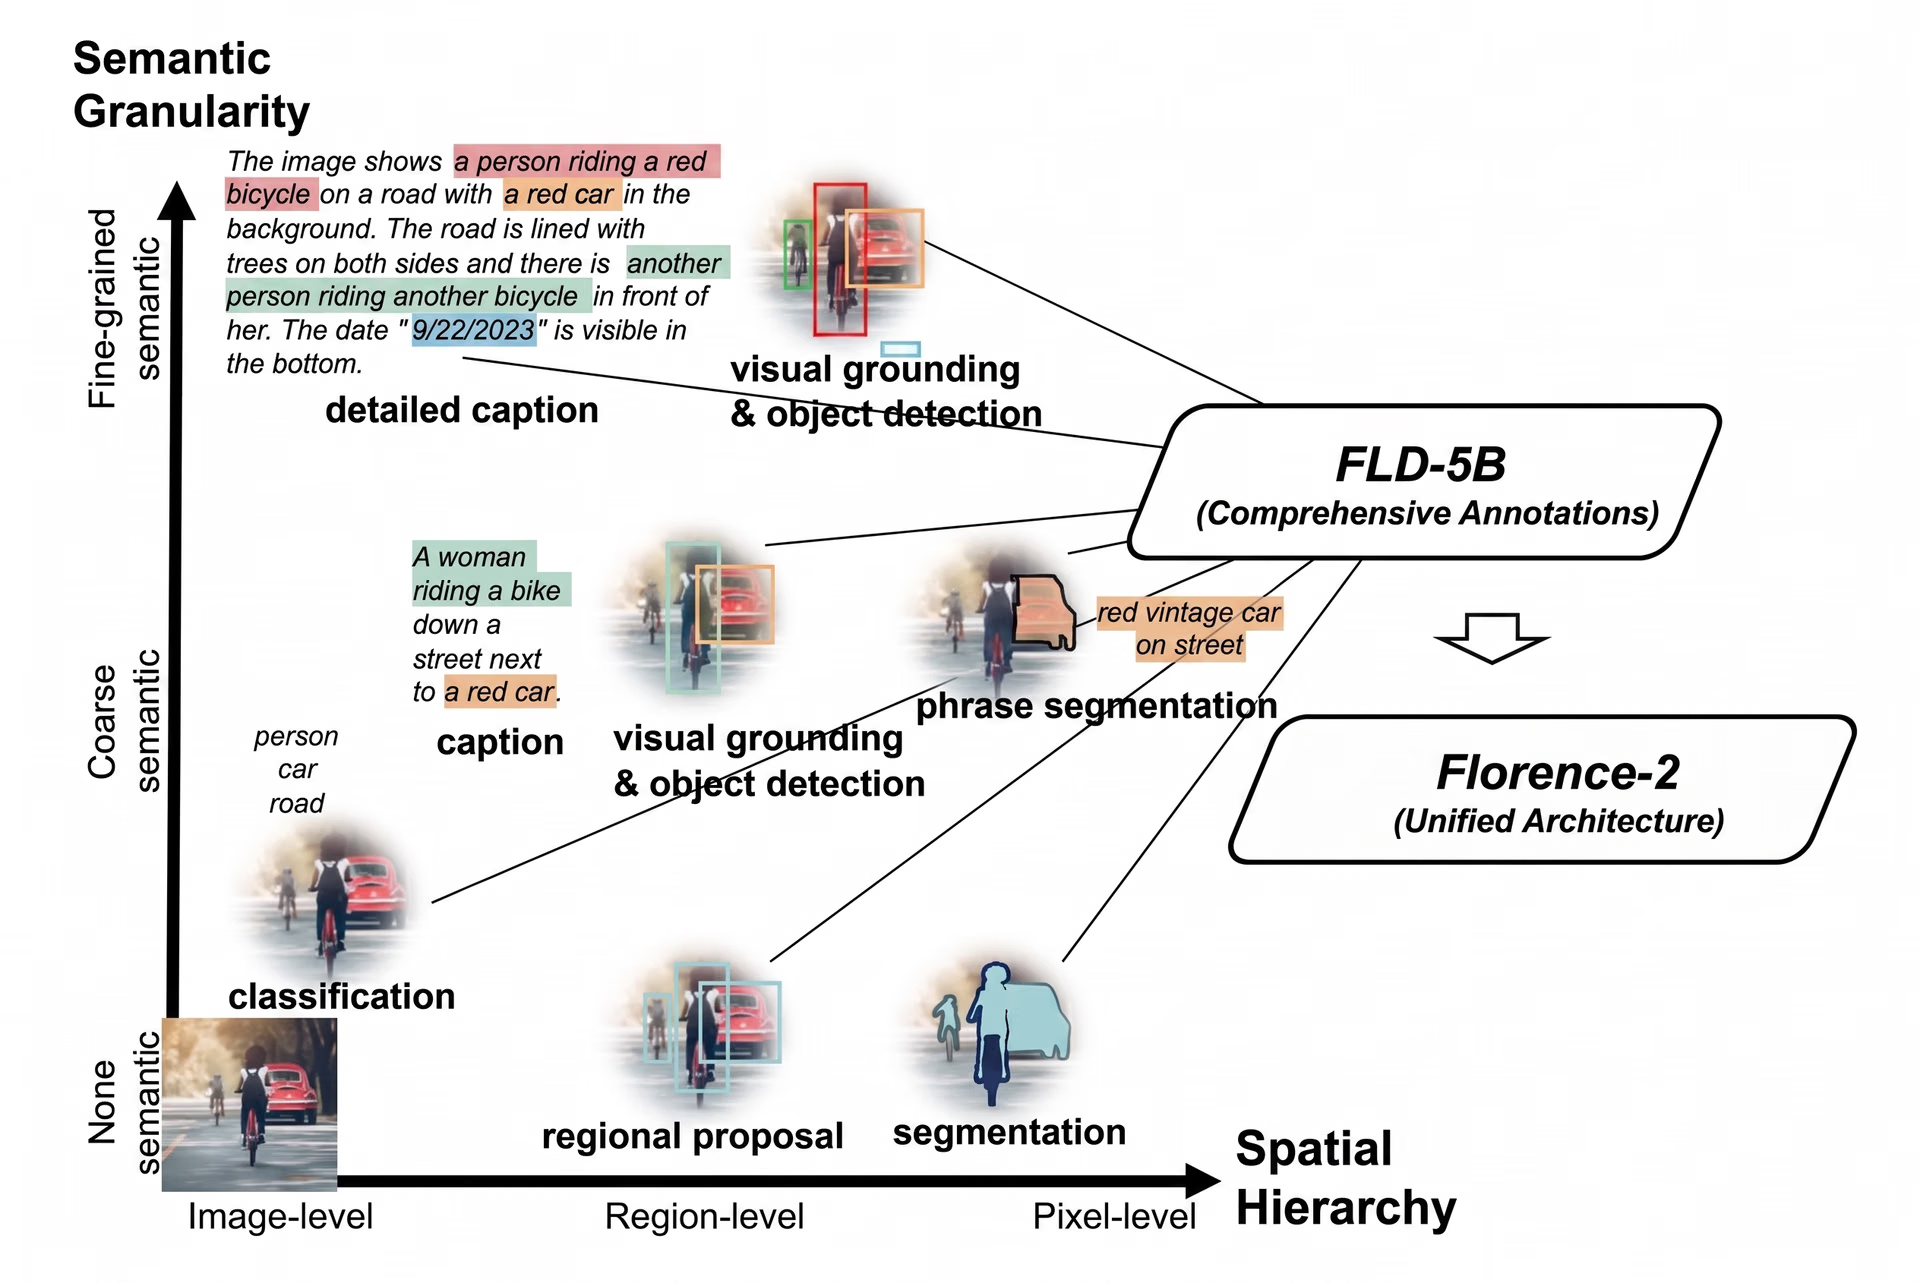
Fig. 1. Comprendre comment Florence-2 a été entraîné.
Le modèle prend en charge les tâches basées sur le texte et celles basées sur des régions. Des jetons de localisation spéciaux sont ajoutés au vocabulaire du modèle pour les tâches portant sur des régions spécifiques d’une image. Ces jetons aident le modèle à comprendre différentes formes, comme les rectangles autour des objets (représentation par boîte), les formes à quatre côtés (représentation par quadrilatère) et les formes à plusieurs côtés (représentation par polygone). Le modèle est entraîné avec une fonction de perte d’entropie croisée standard, qui lui permet d’apprendre en comparant ses prédictions aux réponses correctes et en ajustant ses paramètres internes en conséquence.
Création du jeu de données FLD-5B#
Le jeu de données FLD-5B comprend différents types d’annotations : des descriptions textuelles, des paires de régions et de textes, ainsi que des combinaisons de textes, d’expressions et de régions. Il a été créé selon un processus en deux étapes comprenant la collecte et l’annotation des données. Les images proviennent de jeux de données populaires comme ImageNet-22k, Objects365, Open Images, Conceptual Captions et LAION. Les annotations du jeu de données FLD-5B sont principalement synthétiques, c’est-à-dire qu’elles ont été générées automatiquement plutôt qu’annotées manuellement.
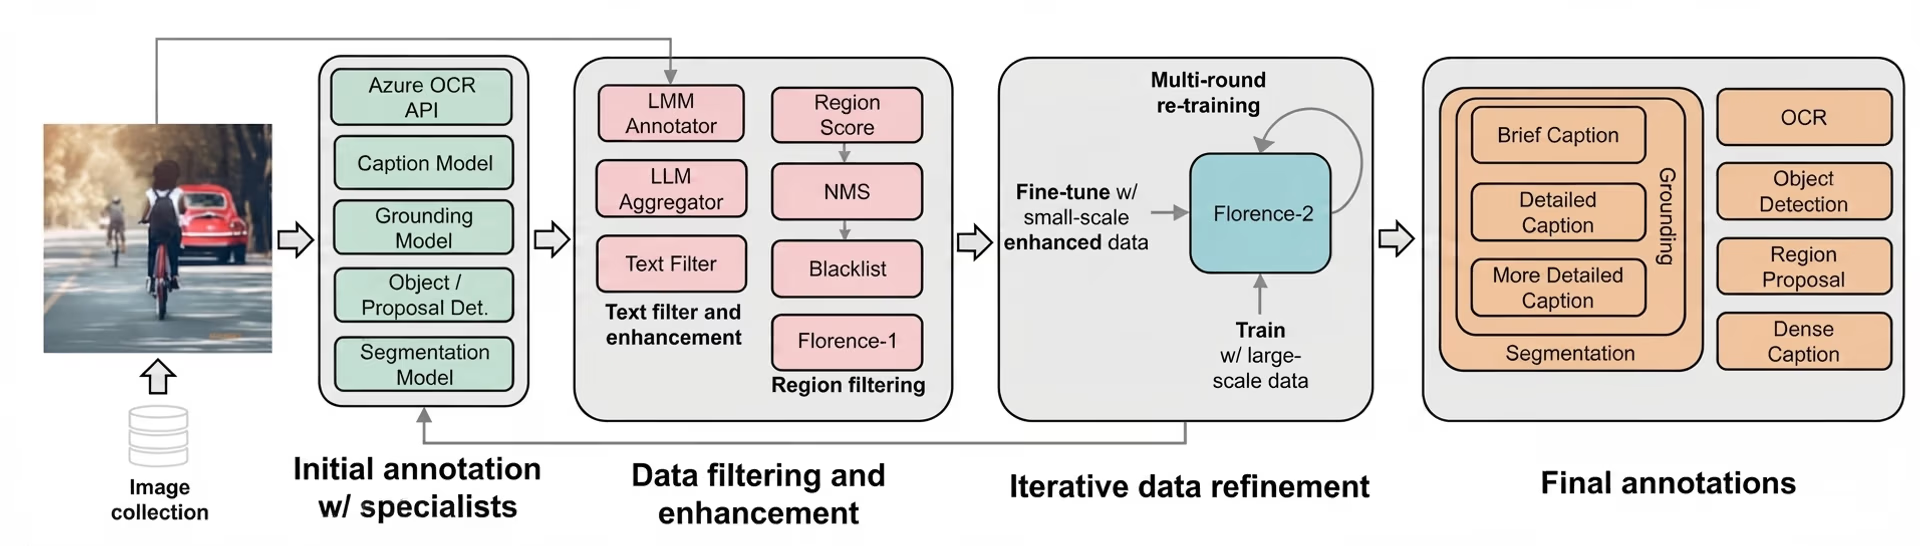
Fig. 2. Création du jeu de données FLD-5B.
Au départ, des modèles spécialisés dans des tâches spécifiques, comme la détection d’objets ou la segmentation, ont créé ces annotations. Un processus de filtrage et d’amélioration a ensuite été utilisé pour garantir que les annotations étaient détaillées et exactes. Après l’élimination du bruit, le jeu de données a fait l’objet d’un affinage itératif, au cours duquel les sorties de Florence-2 ont été utilisées pour mettre à jour et améliorer continuellement les annotations.
Comprendre l’architecture du modèle Florence-2#
L’architecture du modèle Florence-2 repose sur une approche d’apprentissage séquence-à-séquence. Cela signifie que le modèle traite une séquence d’entrée (comme une image accompagnée d’une invite textuelle) et génère une séquence de sortie (comme une description ou une étiquette) étape par étape. Dans le cadre séquence-à-séquence, chaque tâche est traitée comme un problème de traduction : le modèle reçoit une image d’entrée et une invite propre à la tâche, puis génère la sortie correspondante.
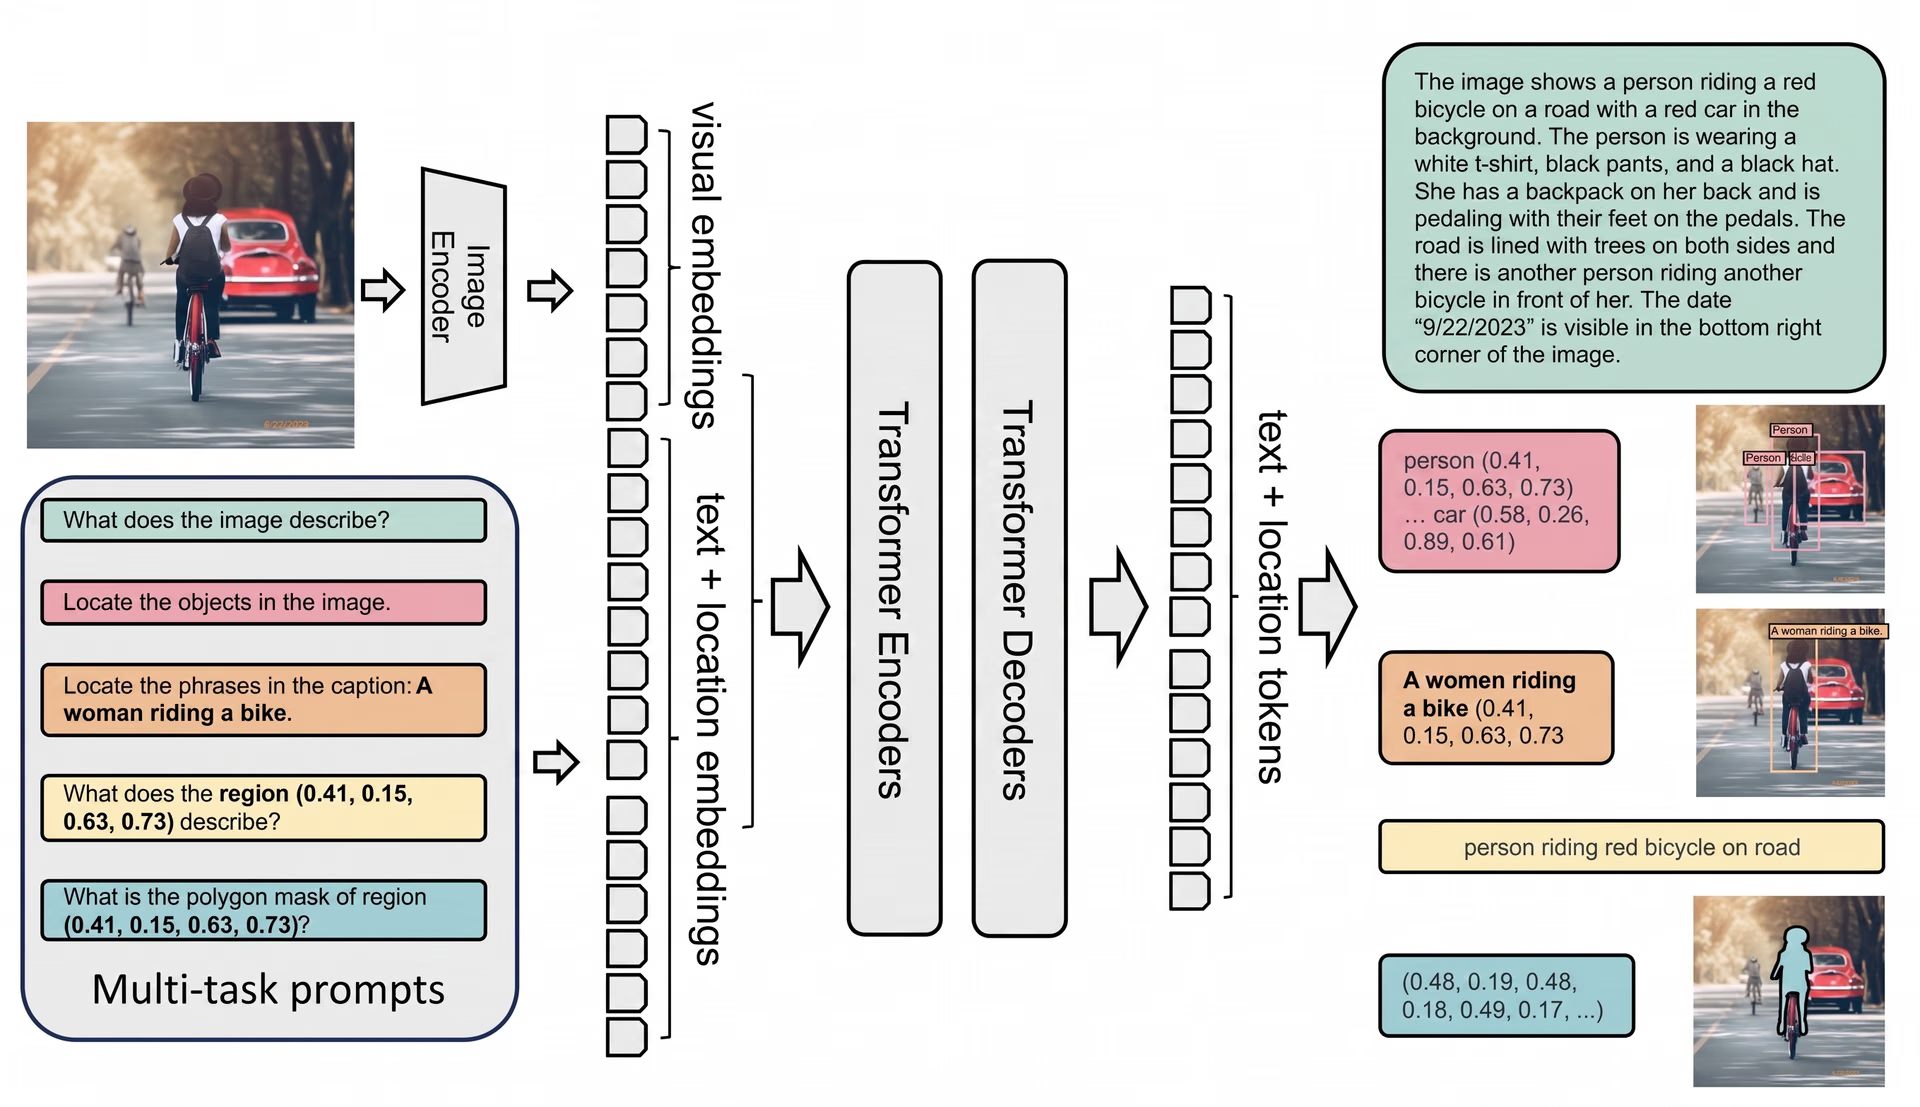
Fig. 3. Architecture du modèle de vision-langage Florence-2.
L’architecture du modèle repose sur un Transformer encodeur-décodeur multimodal qui combine un encodeur d’images et un encodeur-décodeur multimodal. L’encodeur d’images, appelé DaViT (Dual Attention Vision Transformer), traite les images d’entrée en les convertissant en plongements de tokens visuels, c’est-à-dire des représentations compactes de l’image qui capturent les informations spatiales (où se trouvent les éléments) et sémantiques (ce que sont ces éléments). Ces tokens visuels sont ensuite combinés à des plongements textuels (représentations du texte), ce qui permet au modèle de fusionner les données textuelles et visuelles.
Comparaison de Florence-2 avec d’autres VLM#
Florence-2 se distingue des autres modèles de vision-langage par ses solides capacités d’apprentissage sans exemple. Contrairement à des modèles comme PaliGemma, qui reposent sur un affinage approfondi pour s’adapter à différentes tâches, Florence-2 fonctionne efficacement dès sa mise en service. Florence-2 peut également rivaliser avec des modèles plus grands comme GPT-4V et Flamingo, qui disposent souvent de bien plus de paramètres sans pour autant toujours égaler ses performances. Par exemple, Florence-2 obtient de meilleurs résultats en apprentissage sans exemple que Kosmos-2, bien que ce dernier compte plus de deux fois plus de paramètres.
Lors des tests de référence, Florence-2 a montré de solides performances pour des tâches comme le sous-titrage sur COCO et la compréhension d’expressions référentielles. Il a surpassé des modèles comme PolyFormer et UNINEXT pour les tâches de détection et de segmentation d’objets sur le jeu de données COCO. C’est un choix très compétitif pour les applications réelles où les performances et l’efficacité des ressources sont essentielles. Tu peux annoter automatiquement des jeux de données de détection avec Florence-2 sur Ultralytics Platform et comparer ses résultats à ceux d’autres modèles de vision-langage dans le classement des VLM.
Applications de Florence-2#
Florence-2 peut être utilisé dans de nombreux secteurs, comme le divertissement, l’accessibilité, l’éducation, etc. Passons en revue quelques exemples pour mieux comprendre.
Applications du sous-titrage d’images#
Lorsque tu es sur une plateforme de streaming et que tu cherches quoi regarder, tu peux lire le résumé d’un film pour t’aider à choisir. Et si la plateforme pouvait aussi fournir une description détaillée de l’affiche du film ? Florence-2 peut le faire grâce au sous-titrage d’images, qui génère des textes descriptifs à partir d’images. Florence-2 peut générer des descriptions détaillées d’affiches de films, rendant les plateformes de streaming plus inclusives pour les personnes malvoyantes. En analysant les éléments visuels d’une affiche, comme les personnages, le décor et le texte, Florence-2 peut créer des descriptions détaillées qui en transmettent le contenu et l’ambiance. L’image ci-dessous montre le niveau de détail que Florence-2 peut fournir dans sa description.
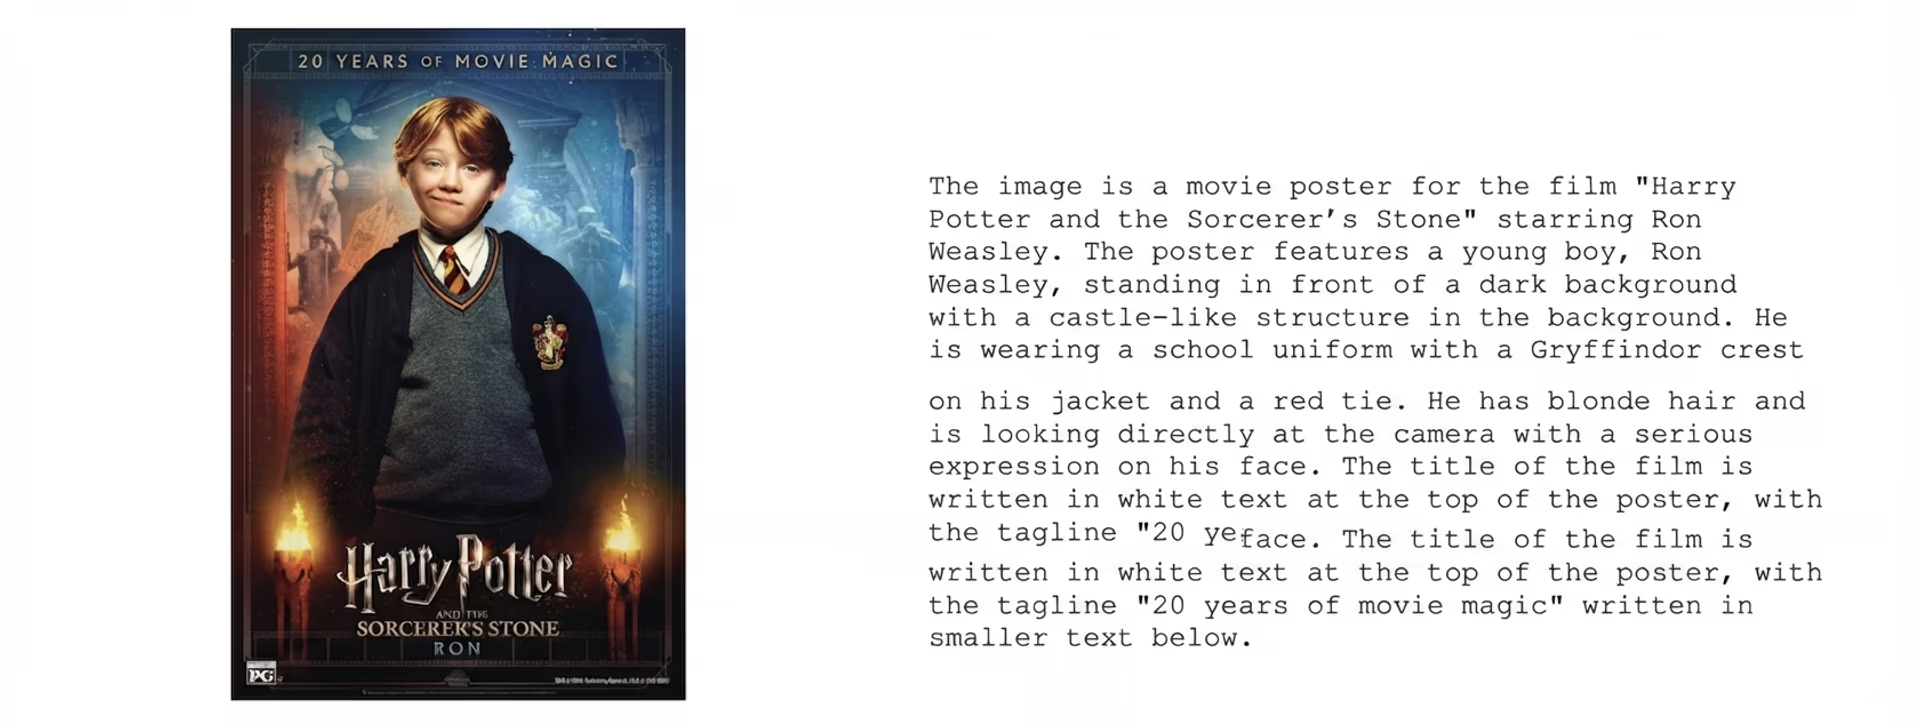
Fig. 4 Exemple de légende d’image générée par Florence-2.
Voici d’autres exemples d’utilité du sous-titrage d’images :
- Commerce en ligne : le sous-titrage d’images peut fournir des descriptions détaillées des images de produits et aider les clients à mieux comprendre leurs caractéristiques et leurs détails.
- Voyages et tourisme : Il peut fournir des descriptions détaillées de monuments et de sites touristiques dans les guides et les applications de voyage.
- Éducation : Le sous-titrage d’images peut étiqueter et décrire des images et des schémas pédagogiques, facilitant l’enseignement et l’apprentissage.
- Immobilier : Il peut fournir des descriptions détaillées d’images de biens immobiliers qui mettent en valeur leurs caractéristiques et leurs équipements pour les acheteurs potentiels.
Utiliser l’ancrage visuel en cuisine#
Florence-2 peut également enrichir les expériences culinaires. Par exemple, un livre de recettes en ligne pourrait utiliser Florence-2 pour ancrer visuellement et étiqueter les différentes parties d’une image de recette complexe. L’ancrage visuel est utile ici, car il associe des parties spécifiques de l’image au texte descriptif correspondant. Chaque ingrédient et chaque étape peuvent être étiquetés et expliqués avec précision, ce qui permet aux cuisiniers amateurs de suivre plus facilement la recette et de comprendre le rôle de chaque élément dans le plat.
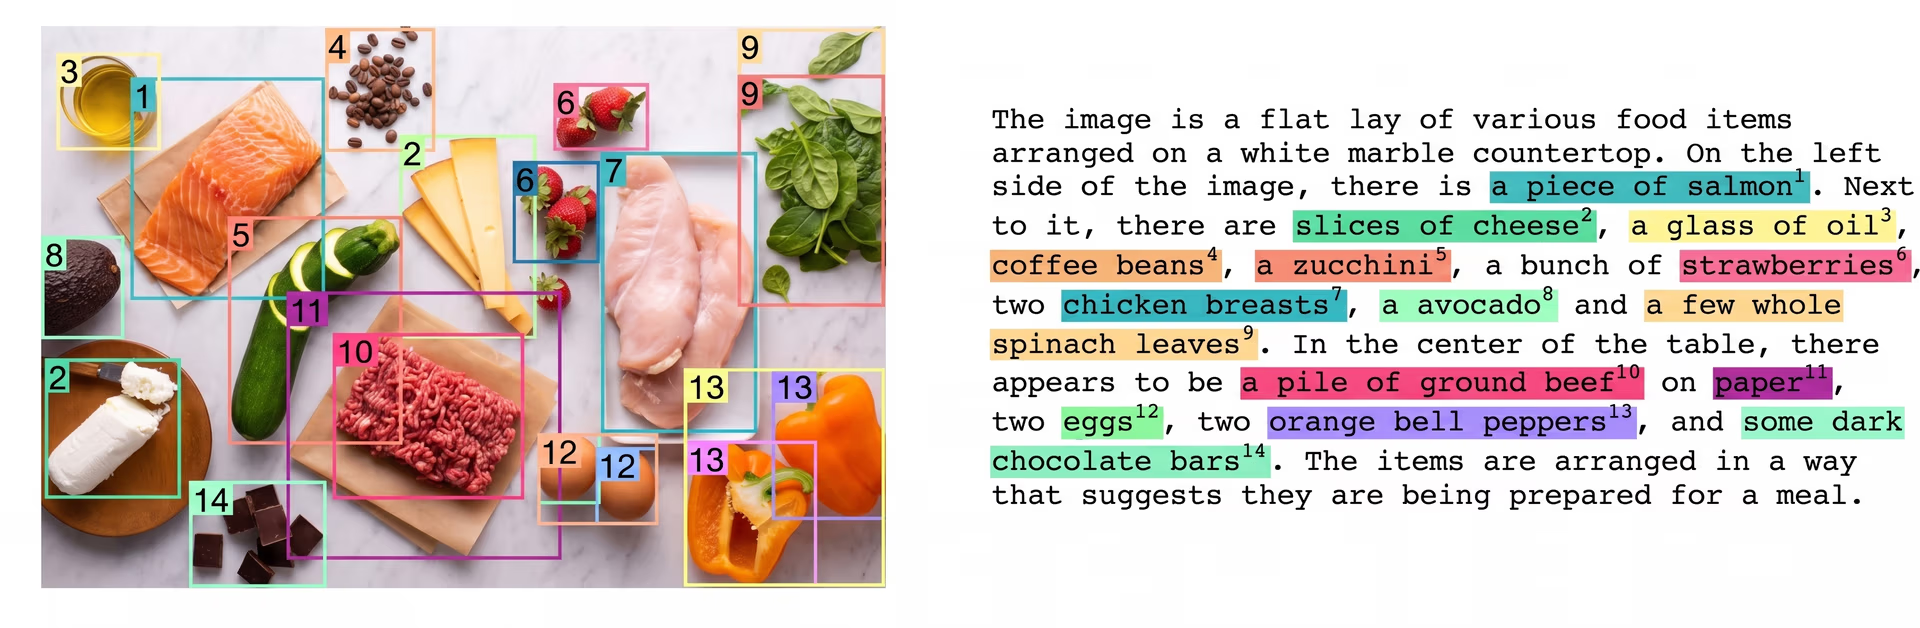
Fig. 5 Exemple d’ancrage visuel avec Florence-2.
OCR par région pour les documents financiers#
L’OCR avec traitement par région, qui vise à extraire du texte de zones spécifiques d’un document, peut s’avérer utile dans des domaines comme la comptabilité. Des zones définies de documents financiers peuvent être analysées afin d’extraire automatiquement des informations importantes, telles que les détails des transactions, les numéros de compte et les dates d’échéance. En réduisant le besoin de saisie manuelle des données, cette méthode limite les erreurs et accélère le traitement. Les institutions financières peuvent l’utiliser pour rationaliser des tâches comme le traitement des factures, le rapprochement des reçus et la compensation des chèques, ce qui accélère les transactions et améliore le service client.
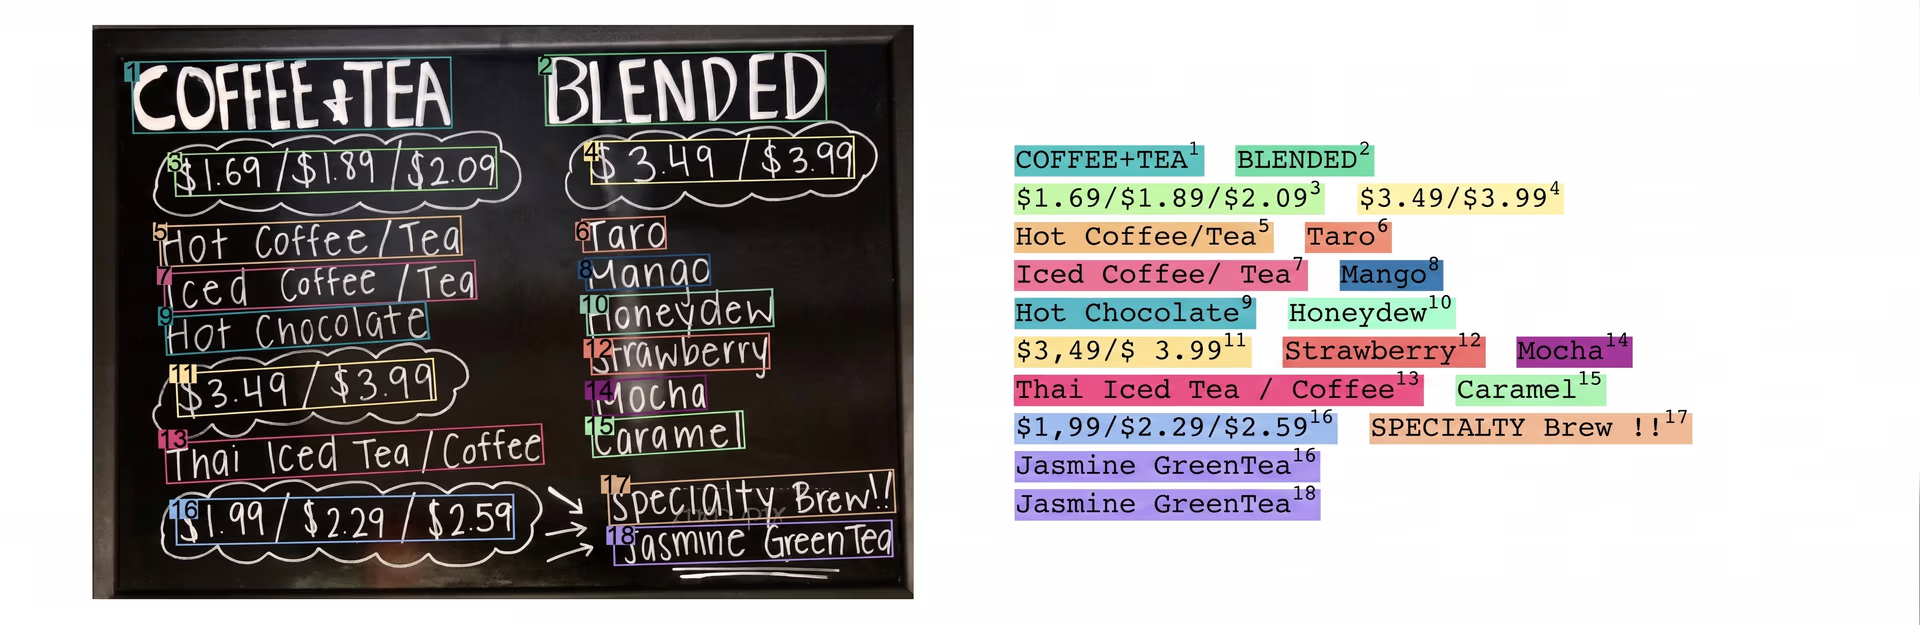
Fig. 6 Exemple d’extraction OCR par région avec Florence-2.
Segmentation par région dans les applications industrielles#
La segmentation par région, qui consiste à diviser une image en parties pertinentes pour effectuer une analyse ciblée et une inspection détaillée, peut alimenter des applications industrielles qui améliorent la précision et l’efficacité de divers processus. En se concentrant sur des zones spécifiques d’une image, cette technologie permet d’inspecter et d’analyser en détail les composants et les produits. Dans le cadre du contrôle qualité, elle peut détecter des défauts ou des irrégularités dans les matériaux, comme des fissures ou des problèmes d’alignement, afin de garantir que seuls des produits de qualité supérieure arrivent sur le marché.
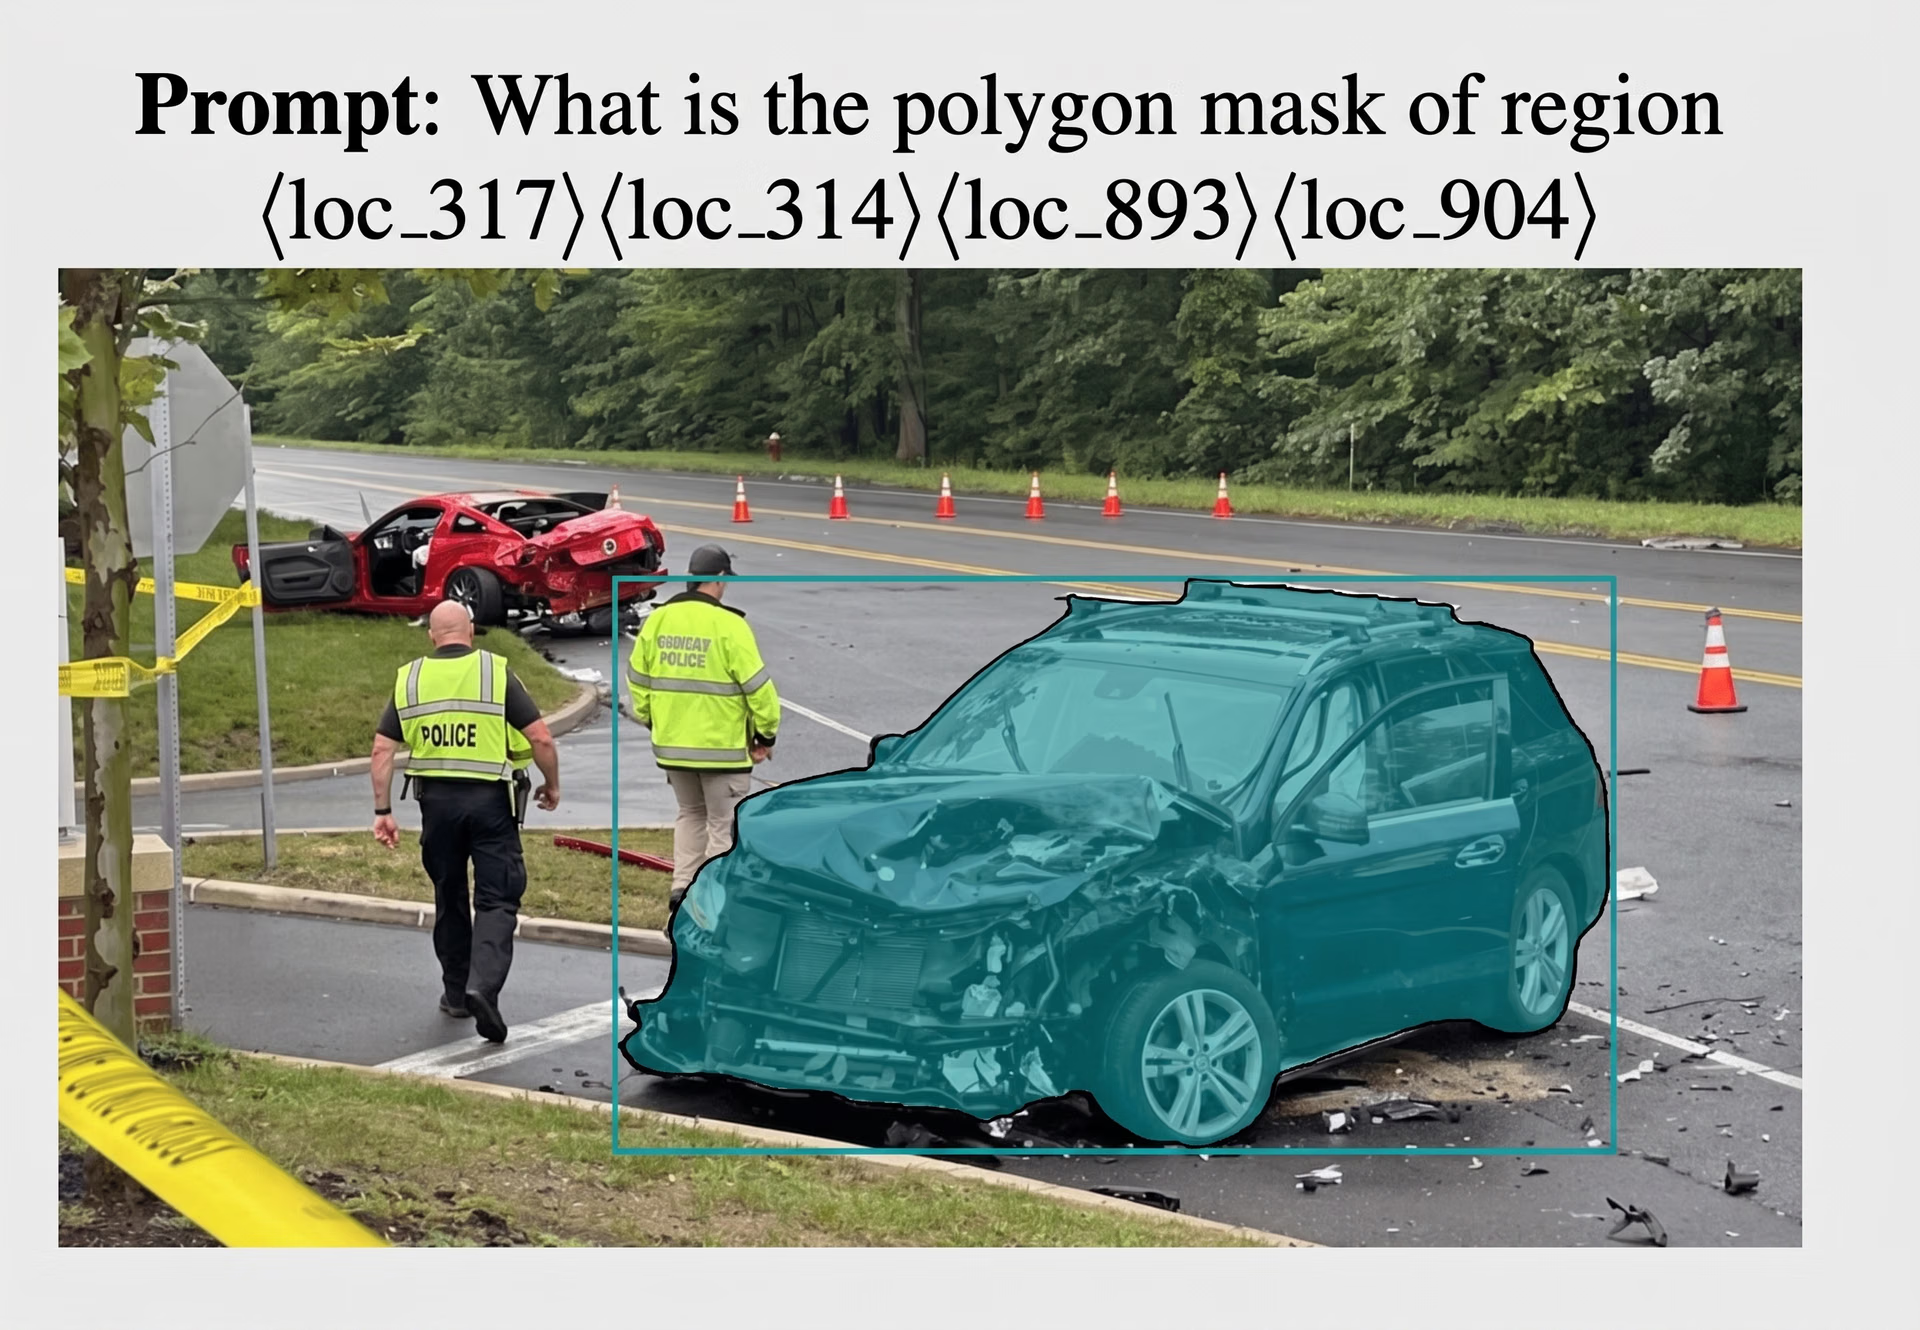
Fig. 7 Exemple de segmentation par région avec Florence-2.
Cette méthode améliore également les chaînes d’assemblage automatisées en guidant les bras robotiques vers des pièces spécifiques et en optimisant le positionnement et l’assemblage des composants. De même, dans la gestion des stocks, elle aide à suivre et à surveiller l’état et l’emplacement des marchandises, ce qui rend la logistique plus efficace et réduit les temps d’arrêt. Dans l’ensemble, la segmentation par région améliore la précision et la productivité, ce qui permet de réduire les coûts et d’accroître la qualité des produits dans les environnements industriels.
Points clés à retenir#
Nous commençons à observer une tendance : les modèles d’IA deviennent plus légers tout en maintenant des performances élevées. Florence-2 marque une avancée majeure pour les modèles de vision-langage. Il peut effectuer diverses tâches, comme la détection d’objets, la segmentation, le sous-titrage d’images et l’ancrage, avec d’impressionnantes performances en apprentissage sans exemple. Malgré sa taille réduite, Florence-2 est efficace et polyvalent, ce qui le rend utile dans différents secteurs. Des modèles comme Florence-2 ouvrent de nouvelles possibilités et élargissent le potentiel des innovations en IA.
Découvre d’autres sujets liés à l’IA en consultant notre dépôt GitHub et en rejoignant notre communauté. Consulte nos pages de solutions pour en savoir plus sur les applications de l’IA dans l’industrie manufacturière et l’agriculture.
Écrit par
Créateur de contenu · Ultralytics
Commentaires
Pose une question, partage tes résultats ou aide quelqu’un.









